Le 28 octobre 2026, Anthropic a annoncé dans son journal officiel une mise à jour de son API Claude propriétaire : la taille maximale du corps des requêtes pour les API Messages et Token Counting passe de 32 MB à 128 MB, soit quatre fois la limite précédente. Depuis cette annonce, de nombreux responsables techniques se posent une question pratique : faut-il revoir les processus de découpage, de téléversement et de prétraitement des fichiers volumineux conçus pour contourner la limite de 32 MB ?
Cette mise à jour ne rend pas le modèle plus puissant : elle modifie la taille maximale du corps des requêtes HTTP, sans changer la fenêtre de contexte du modèle ni la longueur de ses réponses. Beaucoup d’erreurs d’interprétation viennent de la confusion entre 128 MB, 128K tokens et 1M de tokens.
L’essentiel : cet article précise d’abord quelle limite a changé dans l’API Claude, puis propose trois catégories de décision, A/B/C, selon les usages. Il présente enfin un plan de validation à faible coût et une liste de vérification. Les recommandations d’architecture reposent sur une analyse technique des informations officielles : elles ne constituent pas des instructions de migration officielles d’Anthropic.
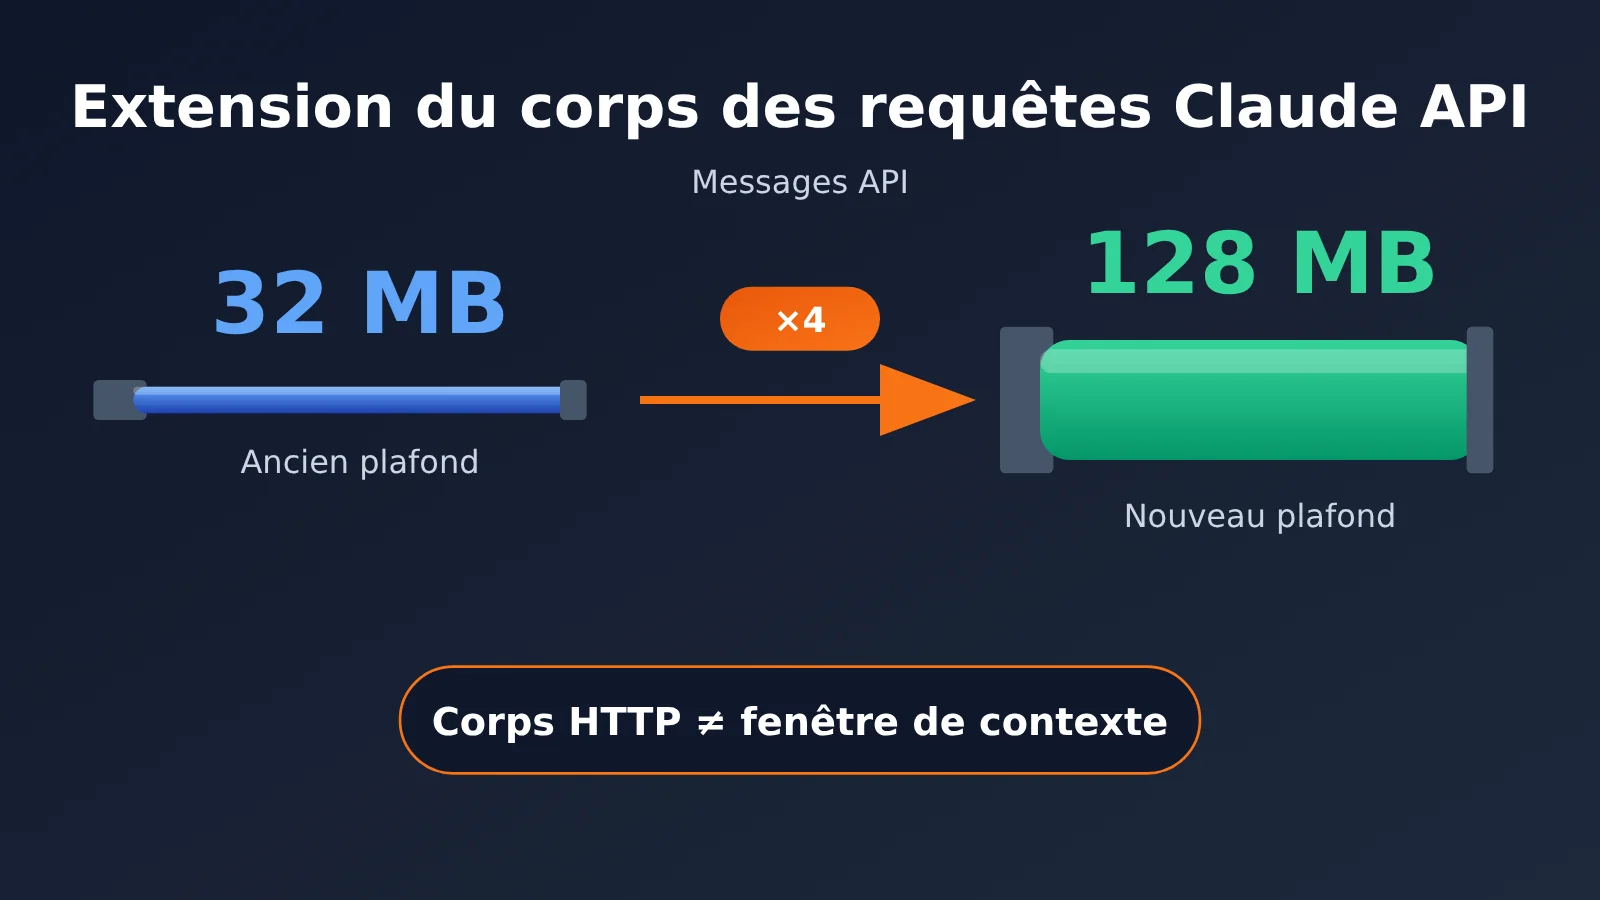
Augmentation de la taille des requêtes Claude API : l’essentiel
Voici d’abord les faits concernant cette mise à jour de Claude API. Ils serviront de base à la suite de l’analyse.
| Information | Détails | Source |
|---|---|---|
| Date de publication | 28 octobre 2026 | Journal des mises à jour officiel (S1) |
| Éditeur | Anthropic | Journal des mises à jour officiel (S1) |
| Points de terminaison concernés | Messages API et Token Counting API de Claude API, en accès direct | S1, S2 |
| Changement principal | Taille maximale du corps de requête portée de 32 Mo à 128 Mo | S1, S2 |
| Ce qui ne change pas | La fenêtre de contexte du modèle et la longueur des réponses ne sont pas augmentées | S2, S5 |
| En cas de dépassement | Erreur HTTP 413 request_too_large |
S2 |
| Facturation | Toujours basée sur l’utilisation de tokens ; une limite plus élevée ne rend pas le traitement des fichiers gratuit | S6 |
Les limites de taille varient selon les points de terminaison de Claude API
Attention : tous les points de terminaison de Claude API en accès direct n’ont pas la même limite de taille de requête. Cette mise à jour ne concerne que Messages et Token Counting. Les autres conservent leurs propres limites : il faut donc tenir compte de chacune dans les choix d’architecture.
| Point de terminaison | Taille maximale actuelle des requêtes | Remarque |
|---|---|---|
| Messages API | 128 Mo | Augmentée de 32 Mo à 128 Mo |
| Token Counting API | 128 Mo | Augmentée de 32 Mo à 128 Mo, comme pour Messages |
| Batch API | 256 Mo | Traitement asynchrone par lots |
| Files API | 500 Mo | Limite de stockage de 500 Mo par fichier |
| Sessions / Agents / Environments | 32 Mo | Limite inchangée |
Source : documentation officielle de présentation de l’API (S2). Si votre application utilise à la fois Messages et des points de terminaison comme Agents, prévoyez une limite de taille distincte pour chacun : vous ne pouvez pas appliquer les 128 Mo à tous.
Quelle limite l’augmentation de la taille des requêtes Claude API change-t-elle vraiment ?
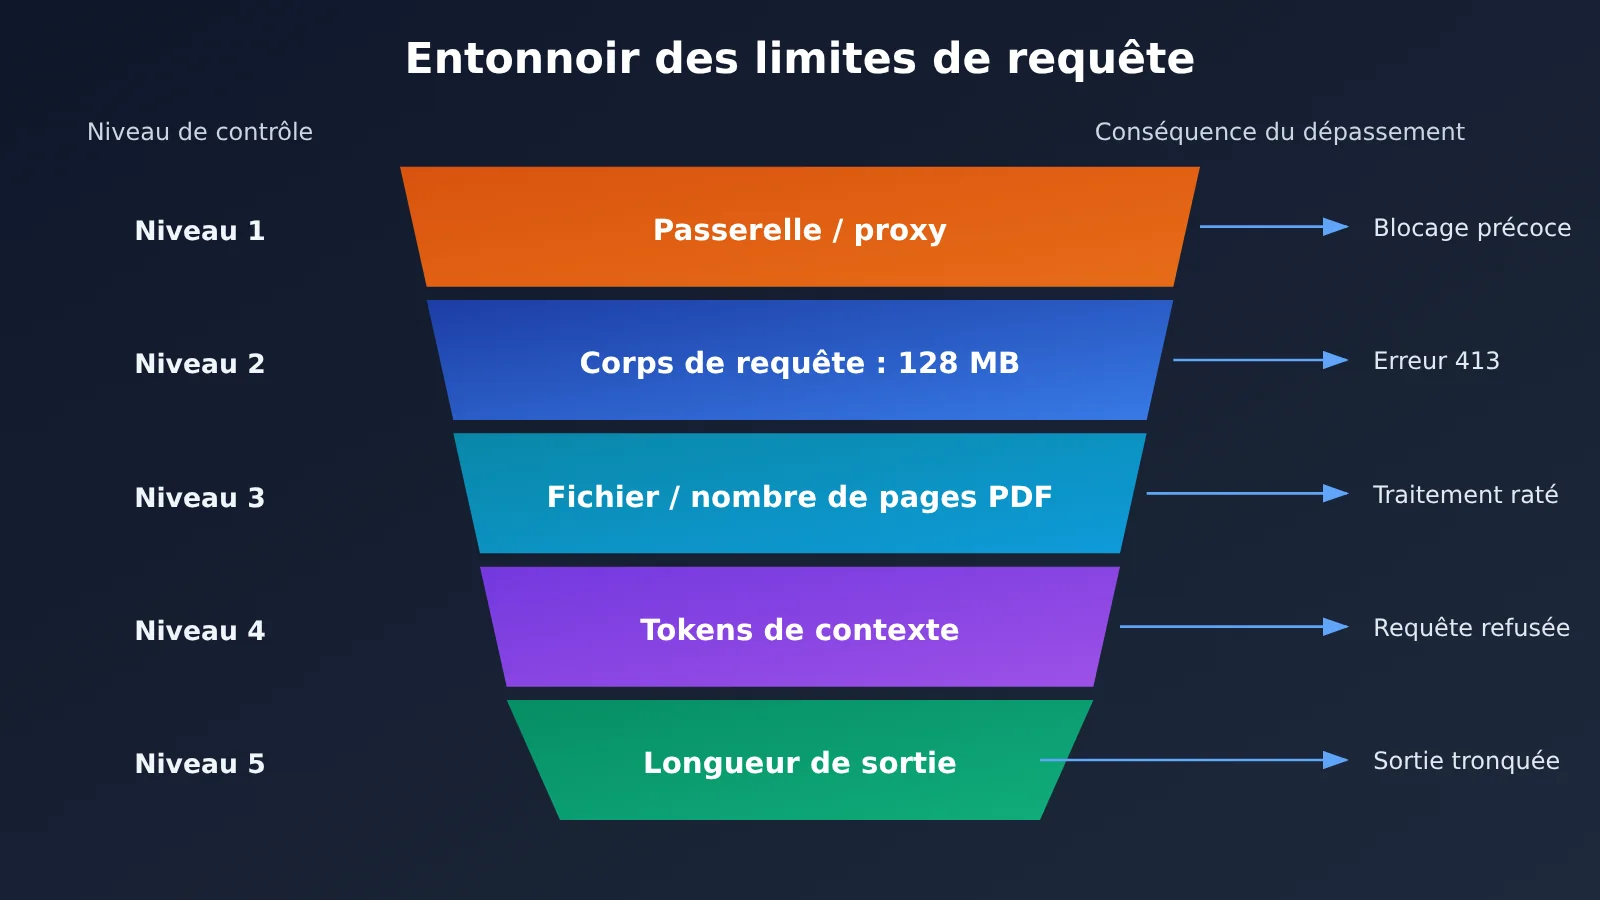
Un appel à Claude API doit franchir plusieurs « barrières », et la taille du corps de la requête n’est que la première. Bien distinguer ces limites est indispensable pour savoir s’il faut modifier son architecture.
| Type de limite | Unité de mesure | Changement | Conséquence en cas de dépassement |
|---|---|---|---|
| Taille du corps de la requête HTTP | Octets (MB) | Oui, 128 MB pour Messages et Token Counting | HTTP 413 request_too_large |
| Fenêtre de contexte du modèle | Tokens | Non | Requête rejetée ou contenu à tronquer |
| Limites des fichiers et des PDF | Taille des fichiers, nombre de pages | Corps de la requête PDF limité à 128 MB, avec une limite distincte pour le nombre de pages | Le fichier ne peut pas être traité en entier |
| Longueur de la sortie | Tokens | Non | Sortie tronquée |
Un corps de requête de 128 MB ne signifie pas que le modèle peut « comprendre » 128 MB
La taille du corps de la requête mesure le nombre d’octets transmis sur le réseau, tandis que la fenêtre de contexte mesure le nombre de tokens que le modèle peut traiter en une fois. Une image haute résolution peut peser plusieurs MB sans pour autant représenter beaucoup de tokens ; à l’inverse, un texte brut de quelques centaines de KB peut rapprocher directement du plafond de la fenêtre de contexte. « Envoyer plus d’octets » et « permettre au modèle de comprendre plus de contenu » sont donc deux choses différentes.
Par ailleurs, les contenus binaires comme les images et les PDF doivent généralement être encodés en base64 dans une requête JSON. Leur taille passe alors à environ 4/3 de leur taille d’origine. Autrement dit, un corps de requête de 128 MB peut contenir nettement moins de 128 MB de fichiers binaires avant encodage. Il faut tenir compte de ce surcoût dans les estimations.
Le lien entre la taille des requêtes Claude API et le nombre de pages PDF
La documentation officielle sur les PDF (S3) précise que, pour le traitement des PDF via l’interface directe, le corps de la requête est limité à 128 MB. Le nombre de pages est soumis à une limite distincte, qui dépend de la fenêtre de contexte du modèle utilisé. Autrement dit, même si un contrat numérisé de 100 MB passe sans problème la couche HTTP, il peut ne pas être traité en entier si son nombre de pages ou de tokens dépasse la fenêtre de contexte.
Quelles applications d’entreprise pourraient bénéficier de l’augmentation de la taille des requêtes Claude API ?
L’analyse qui suit repose sur une hypothèse : ces applications étaient réellement freinées par la limite de 32 Mo du corps des requêtes. Même dans ce cas, cela ne signifie pas qu’il ne sera plus nécessaire de découper les données.
- Analyse de PDF volumineux et de contrats : les services juridiques et d’audit doivent souvent soumettre des contrats numérisés ou des rapports accompagnés de nombreuses pièces jointes. Ces documents peuvent être volumineux tout en contenant relativement peu de texte. Si le principal obstacle était la taille des fichiers, supérieure à 32 Mo, il pourrait désormais être possible de les soumettre en une seule fois. En revanche, si la limite venait du nombre de pages ou de tokens, le gain sera limité.
- Envoi de plusieurs images ou documents de plusieurs pages : dans le traitement des réclamations d’assurance ou les inspections qualité, une même requête peut contenir de nombreuses photos prises sur le terrain. Leur taille cumulée peut facilement dépasser l’ancienne limite. L’augmentation réduit donc potentiellement le risque de recevoir une erreur 413, mais le nombre d’images reste soumis aux contraintes du modèle et de sa fenêtre de contexte.
- Applications d’IA qui transmettent de longues données structurées : certains systèmes placent directement de grandes quantités de JSON, de journaux ou de tableaux dans leurs requêtes. La marge en octets augmente, mais ces données ont souvent une forte densité de tokens. Elles risquent donc d’atteindre la limite de la fenêtre de contexte avant celle des 128 Mo.
- Applications qui découpaient les données uniquement à cause de la limite de 32 Mo : ce sont les bénéficiaires les plus directs. Si le découpage servait uniquement à contourner la limite du corps des requêtes, il vaut maintenant la peine de vérifier s’il est encore nécessaire.
🎯 Conseil technique : pour évaluer ces cas, mesurez d’abord la taille en octets et le nombre de tokens sur des échantillons réels, puis déterminez où se situe le goulot d’étranglement. Avec APIYI apiyi.com, vous pouvez utiliser une même clé API pour appeler Claude et d’autres modèles courants afin de les comparer. Attention toutefois : la limite de taille des requêtes d’une plateforme tierce peut différer de celle de l’API officielle. Vérifiez la limite actuellement prise en charge avant toute mise en production.
Faut-il modifier votre architecture après l’augmentation de la limite de taille des requêtes Claude API ? Trois cas de figure
Voici la grille de décision centrale de cet article. La nécessité de modifier votre architecture ne dépend pas de l’augmentation de la limite officielle, mais du problème que votre conception initiale cherchait à résoudre.
| Situation | Caractéristiques typiques | Action recommandée | Priorité |
|---|---|---|---|
| A. Jamais proche de 32 Mo | Les requêtes ne font généralement que quelques Mo, sans erreur 413 dans les journaux | Ne rien changer, simplement documenter cette évolution | Faible |
| B. Erreurs 413 fréquentes liées à la taille des requêtes | Les erreurs 413 request_too_large représentent une part importante dans les données de surveillance |
Tester et optimiser le processus d’envoi, puis évaluer s’il est possible de réduire le découpage | Élevée |
| C. Découpage lié au contexte, à la précision, aux performances ou aux coûts | Les données sont découpées pour améliorer la précision de la recherche, maîtriser les coûts ou réduire la latence | Conserver le découpage, la recherche et la mise en cache | Inchangée |
Situation A : les systèmes qui n’ont jamais approché les 32 Mo
Dans la plupart des applications de conversation textuelle, de questions-réponses pour le service client ou d’assistance au code, chaque requête reste bien en dessous de 32 Mo. Ces systèmes n’ont généralement aucune raison immédiate de changer d’architecture : une modification forcée ne ferait qu’introduire de nouveaux risques. Il suffit de mettre à jour les limites des points de terminaison dans la documentation technique pour faciliter les futurs diagnostics.
Situation B : les systèmes qui rencontrent souvent des erreurs 413 liées à la taille des requêtes
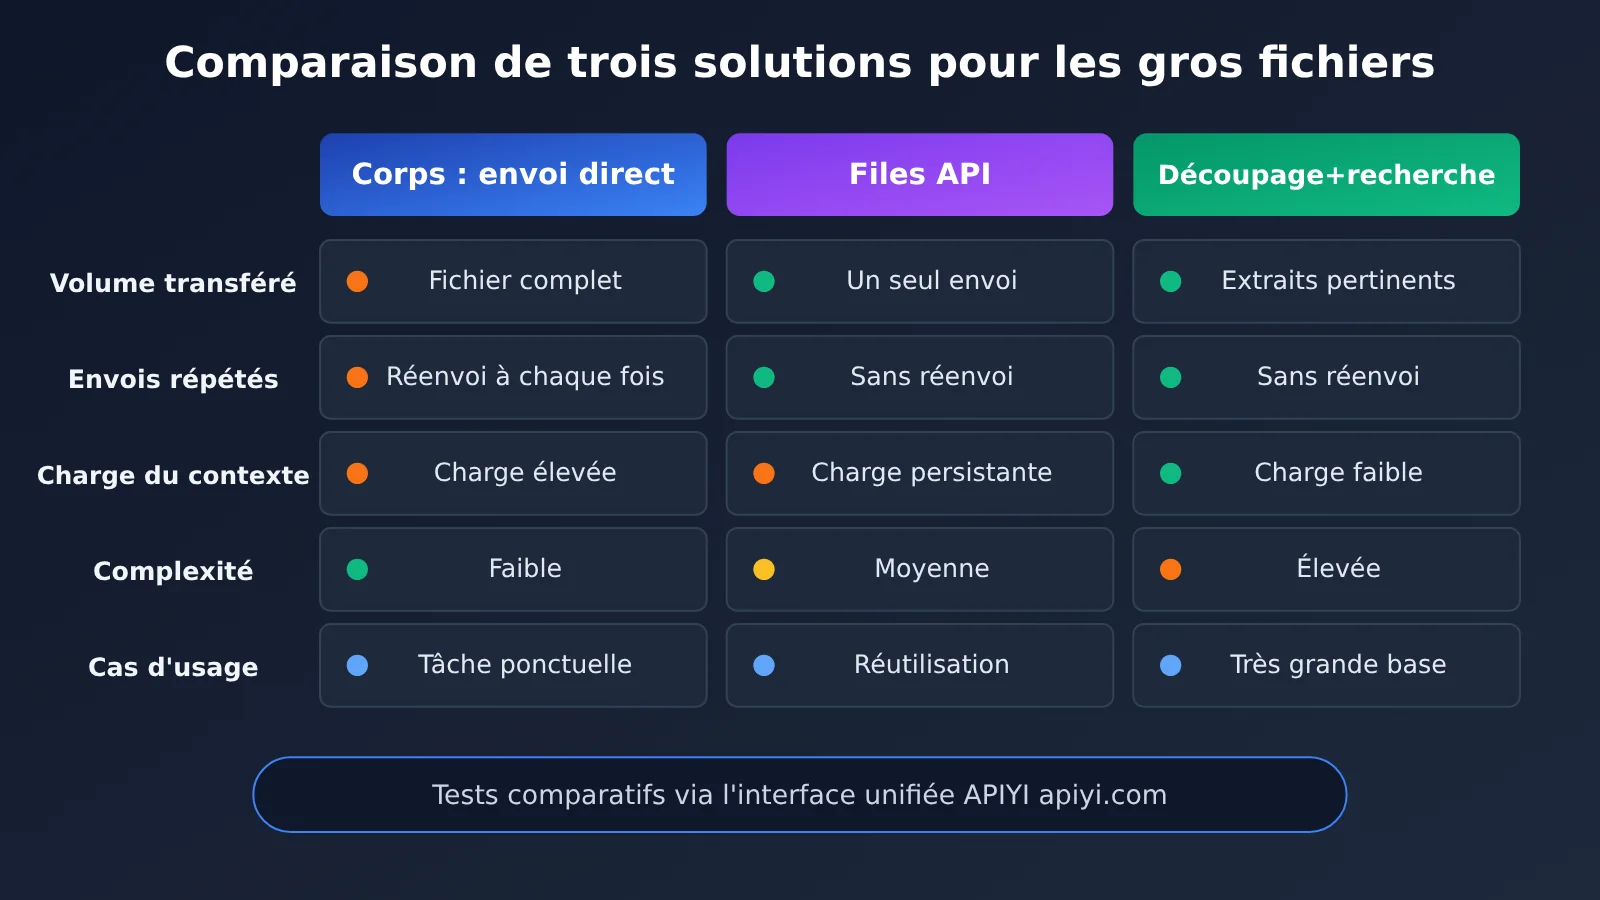
Si la surveillance révèle de nombreuses erreurs 413 et que vous avez confirmé qu’elles sont dues au dépassement de la limite de taille des requêtes sur le point de terminaison Messages, cette mise à jour mérite d’être testée. Vous pouvez envisager de remplacer une partie de la logique de découpage par un envoi unique, ou de passer aux références file_id de la Files API pour éviter les transferts répétés.
Situation C : le découpage sert à améliorer la qualité, les coûts ou les performances
De nombreux systèmes RAG découpent les données non pas parce que les requêtes sont trop volumineuses pour être envoyées, mais pour rendre la recherche plus précise, réduire le nombre de tokens par invocation et accélérer les réponses. L’augmentation de la limite de taille des requêtes ne change rien à ces objectifs. Supprimer le découpage pourrait au contraire augmenter les coûts et diminuer la qualité des réponses. Ces systèmes doivent donc conserver le découpage, la recherche et la mise en cache nécessaires.
Claude API : 5 vérifications d’architecture avant d’augmenter la taille du corps des requêtes
Même dans le cas B, mieux vaut vérifier chaque couche dans l’ordre ci-dessous. Si de nombreuses équipes rencontrent encore des erreurs après le relèvement de la limite officielle, c’est souvent à cause d’un maillon intermédiaire.
- Confirmer la limite officielle du point de terminaison Anthropic ciblé : elle est de 128 MB pour Messages, mais reste à 32 MB pour Sessions / Agents / Environments. Elle est de 256 MB pour Batch et de 500 MB pour Files (S2).
- Vérifier les limites de requête de la passerelle API et du proxy inverse : les passerelles internes, Nginx, les répartiteurs de charge et les WAF ont souvent leurs propres limites par défaut, parfois bien inférieures à 128 MB. Vérifiez-les une par une.
- Vérifier le client, le SDK et le mode de transfert : les délais d’expiration du client HTTP, la mise en mémoire tampon et la méthode d’envoi peuvent tous déterminer si une requête volumineuse aboutit. Il faut aussi tenir compte de l’augmentation de taille liée à l’encodage base64.
- Vérifier les contraintes propres aux tokens, au contexte et aux fichiers : utilisez la Token Counting API pour estimer le nombre de tokens, puis vérifiez les limites de pages PDF et de fenêtre de contexte (S3, S5).
- Évaluer la latence, les délais d’expiration, les coûts et la gestion des erreurs : les requêtes volumineuses prennent plus de temps à envoyer et leurs tentatives après échec coûtent plus cher. La facturation reste basée sur les tokens (S6) : il faut donc revoir les délais d’expiration et la stratégie de nouvelle tentative.
Autres stratégies possibles pour Claude API
Au lieu de placer directement un gros fichier dans le corps de la requête, plusieurs options méritent d’être évaluées :
- Files API et références par
file_id: chargez d’abord le fichier, puis référencez-le dans les messages avec sonfile_id. Vous évitez ainsi de transférer le même fichier à chaque requête (S4). La limite de stockage est de 500 MB par fichier, mais son traitement par le modèle reste soumis notamment à la capacité du contexte. - Mise en cache des invites : activer le cache pour le préfixe d’un long document réutilisé dans plusieurs requêtes peut aider à maîtriser le coût des entrées répétées. Consultez la page officielle des tarifs (S6) pour connaître les règles de facturation.
- Conserver le découpage en fragments + la recherche : pour une base documentaire très volumineuse, rechercher les passages pertinents et n’envoyer que ceux-ci reste souvent un bon compromis entre qualité et coût.
Il ne faut pas non plus négliger le risque lié à l’isolation des fichiers entre locataires. Avec Files API, les fichiers sont stockés au niveau du compte API. Si plusieurs clients partagent un même compte, les droits d’accès aux file_id doivent être strictement isolés au niveau de l’application, afin d’éviter qu’une requête du locataire A référence un fichier du locataire B.
Comment évaluer à faible coût les avantages de l’augmentation de la taille des requêtes Claude API
Il n’existe actuellement aucune donnée de test publiable permettant de démontrer que cette augmentation améliore la vitesse de traitement ou réduit les coûts. Le plus fiable est donc de réaliser un test avec vos propres données métier. Voici un plan de test, et non des résultats.
| Niveau de test | Taille du corps de la requête | Points à observer |
|---|---|---|
| Niveau 1 | Nettement inférieure à 32 Mo | Servir de référence et noter les délais et le nombre de tokens habituels |
| Niveau 2 | Proche de 32 Mo | Vérifier la stabilité de la chaîne de traitement près de l’ancienne limite |
| Niveau 3 | Supérieure à 32 Mo | Vérifier si la passerelle et le SDK laissent passer la requête et si une erreur 413 apparaît |
| Niveau 4 | Proche de 128 Mo | Vérifier les délais d’expiration, l’utilisation de la mémoire et le coût des nouvelles tentatives après un échec |
Chaque niveau doit être testé dans le respect des limites applicables au modèle et aux fichiers. Il faut également relever les indicateurs suivants : taille du corps de la requête HTTP, nombre de tokens, code d’état, durée, coût et qualité du résultat. Testez ensuite le même jeu de données avec trois approches : « envoi direct », « référence via la Files API » et « traitement par blocs ». Les données recueillies vous permettront de décider s’il faut adapter votre processus actuel.
Exemple minimal de mesure du corps d’une requête Claude API
Le code ci-dessous mesure la taille du corps de la requête en octets avant son envoi et intercepte les erreurs 413, pour faciliter l’enregistrement des données pendant les tests :
import json, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

messages = [{"role": "user", "content": "请总结这份长文档的要点:" + open("doc.txt").read()}]
body_mb = len(json.dumps({"messages": messages}).encode("utf-8")) / 1024 / 1024
print(f"请求体约 {body_mb:.2f} MB")

resp = client.chat.completions.create(model="YOUR_CLAUDE_MODEL", messages=messages)
print(resp.usage)  # 记录 Token 用量
Voir le script complet d’enregistrement des tests
import json
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 通过 APIYI 统一接口调用
)

MODEL = "YOUR_CLAUDE_MODEL"  # 替换为平台模型列表中的 Claude 模型名

def run_case(case_name: str, messages: list) -> dict:
    """记录单次请求的体积、Token、状态、耗时,用于方案对比"""
    body = json.dumps({"model": MODEL, "messages": messages}).encode("utf-8")
    record = {
        "case": case_name,
        "body_mb": round(len(body) / 1024 / 1024, 2),
        "status": None,
        "latency_s": None,
        "prompt_tokens": None,
        "completion_tokens": None,
    }
    start = time.time()
    try:
        resp = client.chat.completions.create(model=MODEL, messages=messages)
        record["status"] = 200
        record["prompt_tokens"] = resp.usage.prompt_tokens
        record["completion_tokens"] = resp.usage.completion_tokens
    except openai.APIStatusError as e:
        record["status"] = e.status_code  # 413 即请求体超限
    except Exception as e:
        record["status"] = f"error: {e}"
    record["latency_s"] = round(time.time() - start, 2)
    return record

if __name__ == "__main__":
    text = open("doc.txt", encoding="utf-8").read()
    cases = {
        "baseline": [{"role": "user", "content": "总结要点:" + text[:20000]}],
        "full_direct": [{"role": "user", "content": "总结要点:" + text}],
    }
    results = [run_case(name, msgs) for name, msgs in cases.items()]
    for r in results:
        print(r)
🚀 Pour démarrer rapidement : si votre équipe souhaite d’abord valider le processus de test, vous pouvez vous inscrire sur APIYI apiyi.com pour obtenir un crédit de test, puis utiliser le script ci-dessus pour enregistrer les données à différentes tailles de requête. Attention : lorsqu’une requête passe par une plateforme tierce, la limite du corps de requête de sa passerelle peut être inférieure à la limite officielle de 128 Mo. Consultez la documentation de la plateforme avant de tester des volumes importants.
Questions fréquentes (FAQ)
Q1 : Que signifie exactement le passage à 128 MB pour le corps des requêtes Claude API ?
La taille maximale d’une requête HTTP individuelle envoyée aux API Messages et Token Counting officielles de Claude passe de 32 MB à 128 MB (S1, S2). Ce chiffre ne désigne ni la fenêtre de contexte ni la longueur de sortie.
Q2 : Quelle différence entre un corps de requête de 128 MB et un contexte de 128K ou 1M de tokens ?
Le premier mesure en octets la quantité de données transférées sur le réseau ; le second mesure en tokens la capacité de traitement du modèle. Ce sont deux unités complètement différentes. Pouvoir envoyer une requête ne signifie pas que tout son contenu tiendra dans la fenêtre de contexte : il faut toujours estimer séparément le budget de tokens avec l’API Token Counting.
Q3 : Cette augmentation rend-elle le traitement plus rapide ou moins coûteux ?
Aucune donnée officielle ni aucun test public ne permet de l’affirmer. Les frais restent calculés selon le nombre de tokens utilisés (S6), et un corps de requête plus volumineux peut aussi prendre plus de temps à téléverser. Pour savoir si vous y gagnez, il faut tester avec des échantillons représentatifs de votre activité.
Q4 : Comment vérifier rapidement par API l’impact de cette modification sur son activité ?
Vous pouvez suivre le plan de test à quatre niveaux présenté dans cet article. Après vous être inscrit sur APIYI apiyi.com pour obtenir une clé API, définissez `base_url` sur `https://api.apiyi.com/v1`, puis utilisez le script de test pour consigner la taille, le nombre de tokens, le code d’état et le temps écoulé. Les limites de la plateforme pouvant différer des limites officielles, vérifiez d’abord le plafond pris en charge avant de tester les volumes les plus élevés.
Q5 : Faut-il supprimer un système de découpage RAG déjà en place ?
En général, non. Si le découpage sert à améliorer la précision de la recherche, à maîtriser les coûts en tokens ou à réduire la latence, ces raisons restent valables malgré l’augmentation de la taille des requêtes. Il ne vaut la peine de réévaluer ce choix que si le découpage servait uniquement à contourner la limite de 32 MB.
Q6 : Quelles sont les limites connues de cette augmentation de la taille des requêtes Claude API ?
Il y en a principalement trois : les points de terminaison Sessions / Agents / Environments restent limités à 32 MB ; le nombre de pages PDF et la fenêtre de contexte sont soumis à leurs propres contraintes ; enfin, les passerelles d’entreprise, les proxys et les plateformes tierces peuvent imposer des plafonds plus bas. Pour comparer les performances de plusieurs modèles sur des documents volumineux, vous pouvez utiliser l’interface unifiée d’APIYI apiyi.com, en tenant compte des limites réellement prises en charge par la plateforme.
Les points clés de l’augmentation de la taille des requêtes Claude API
- Ce qui change : la limite du corps des requêtes Messages et Token Counting passe de 32 Mo à 128 Mo. C’est un changement au niveau HTTP.
- Ce qui ne change pas : la fenêtre de contexte, la longueur de sortie et le mode de facturation des tokens restent inchangés.
- Des limites propres à chaque point de terminaison : 256 Mo pour Batch, 500 Mo pour Files et toujours 32 Mo pour les points de terminaison Agents.
- Le critère de décision : déterminez si le découpage existant sert à contourner une limite de taille ou à répondre à des besoins de qualité, de coût et de performance.
- Vérification de la chaîne : les limites des passerelles, proxys et SDK se déclenchent souvent avant la limite officielle.
- Méthode de validation : comparez l’envoi direct, la référence à un fichier et le découpage sur quatre niveaux de taille. L’interface unifiée d’APIYI apiyi.com peut faciliter ces tests.
Conclusion : l’augmentation de la taille des requêtes Claude API n’impose pas de revoir tout votre système
L’essentiel de cette évolution tient en trois points :
- La limite d’entrée augmente : l’interface Messages officielle accepte davantage d’octets par requête, ce qui donne plus de marge aux applications jusque-là bloquées par des erreurs 413.
- Les autres limites ne changent pas : la fenêtre de contexte, le nombre de pages PDF, la facturation des tokens et les limites des autres points de terminaison doivent être évalués séparément.
- La décision dépend du problème à résoudre : les changements d’architecture doivent répondre aux contraintes réelles de votre activité, de qualité des résultats, de coût et de sécurité, plutôt qu’à cette annonce seule.
Pour la plupart des entreprises, le plus prudent est de commencer par consulter les journaux, puis de tester des échantillons avant de décider quoi modifier. Voici une liste de vérification prête à l’emploi :
- [ ] Mesurer la fréquence des erreurs 413
request_too_largerécentes et identifier les points de terminaison concernés - [ ] Confirmer les points de terminaison utilisés et leurs limites officielles (Messages / Batch / Files / Agents)
- [ ] Vérifier les limites de taille des requêtes des passerelles internes, proxys inverses, WAF et répartiteurs de charge
- [ ] Vérifier les délais d’expiration et la configuration des tampons du SDK et du client HTTP, en tenant compte de l’augmentation de taille due à base64
- [ ] Utiliser la Token Counting API pour estimer le nombre de tokens des requêtes volumineuses et la marge restante dans la fenêtre de contexte
- [ ] Comparer l’envoi direct, les références via la Files API et le découpage sur quatre niveaux de taille
- [ ] Évaluer l’isolation des
file_identre locataires et les règles de sécurité des données - [ ] Décider des éventuelles modifications à partir des résultats, puis mettre à jour la documentation technique interne
APIYI apiyi.com permet de mettre rapidement en place un environnement de test comparatif : une seule clé API suffit pour appeler plusieurs modèles populaires et évaluer les différentes options sur des échantillons réels.
📚 Références
- Notes de version officielles d’Anthropic : annonce du relèvement de la limite du corps des requêtes du 28 octobre 2026
- Lien :
platform.claude.com/docs/en/release-notes/overview -
Détails : source originale de l’augmentation de 32 Mo à 128 Mo (S1)
-
Vue d’ensemble de l’API Claude et limites des endpoints : taille maximale des requêtes par endpoint et explication de l’erreur 413
- Lien :
platform.claude.com/docs/en/api/overview -
Détails : comparaison des limites des endpoints Messages, Batch, Files et Agents (S2)
-
Documentation sur la prise en charge des PDF : limites du corps des requêtes PDF et du nombre de pages
- Lien :
platform.claude.com/docs/en/build-with-claude/pdf-support -
Détails : à lire avant de traiter des PDF volumineux (S3)
-
Documentation de la Files API : téléversement de fichiers, référence par
file_id, stockage et permissions - Lien :
platform.claude.com/docs/en/build-with-claude/files -
Détails : pour évaluer l’utilisation de références de fichiers et l’isolation entre tenants (S4)
-
Documentation sur la fenêtre de contexte : capacité en tokens des modèles
- Lien :
platform.claude.com/docs/en/build-with-claude/context-windows -
Détails : pour distinguer la limite en octets de la limite en tokens (S5)
-
Tarification officielle et mise en cache : facturation des tokens et mise en cache des invites
- Lien :
platform.claude.com/docs/en/about-claude/pricing - Détails : pour évaluer les effets sur les coûts (S6)
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site APIYI apiyi.com. Retrouvez plus de ressources sur l’intégration dans le centre de documentation docs.apiyi.com.