Nota do autor: ao chamar um Modelo de Linguagem Grande por uma API de terceiros, a qualidade das respostas sozinha não permite saber qual modelo está realmente rodando. Este artigo analisa o FlashProve, projeto open source da Anthropic: como ele usa zkSNARK para vincular o resultado da inferência a pesos específicos, quanto isso custa, o que ele consegue (e não consegue) provar, e quão longe estamos de usar isso em chamadas de API do dia a dia.
Em 2 de novembro de 2026, o Frontier Red Team da Anthropic, junto com pesquisadores da EPFL, do MIT e de outras instituições, lançou o FlashProve: um protótipo open source de inferência comprovável para Modelos de Linguagem Grandes. No Llama 4 Maverick, com 400B de parâmetros, ele gera a prova em uma única GPU H100. Cada prova tem cerca de 19 MB e pode ser verificada em uma CPU comum em poucas dezenas de segundos.
Isto não é uma demo conceitual nem um produto de PowerPoint. A Anthropic publicou ao mesmo tempo o relatório técnico, a especificação do protocolo, o código executável do lado que gera a prova, duas implementações do lado verificador e as provas formais em Lean, tudo sob a licença Apache 2.0. Ainda assim, ela deixa claro que este é só um avanço intermediário da pesquisa, e que ainda falta bastante chão até o objetivo completo.
O que você leva daqui: por que é tão difícil confirmar a “identidade do modelo” em chamadas de API de terceiros, qual mecanismo o FlashProve usa para resolver isso, onde ficam o custo real e os limites da técnica, e o que você, como usuário de API, já pode fazer hoje.
Por que existe um problema de confiança na identidade do modelo em chamadas de API de terceiros
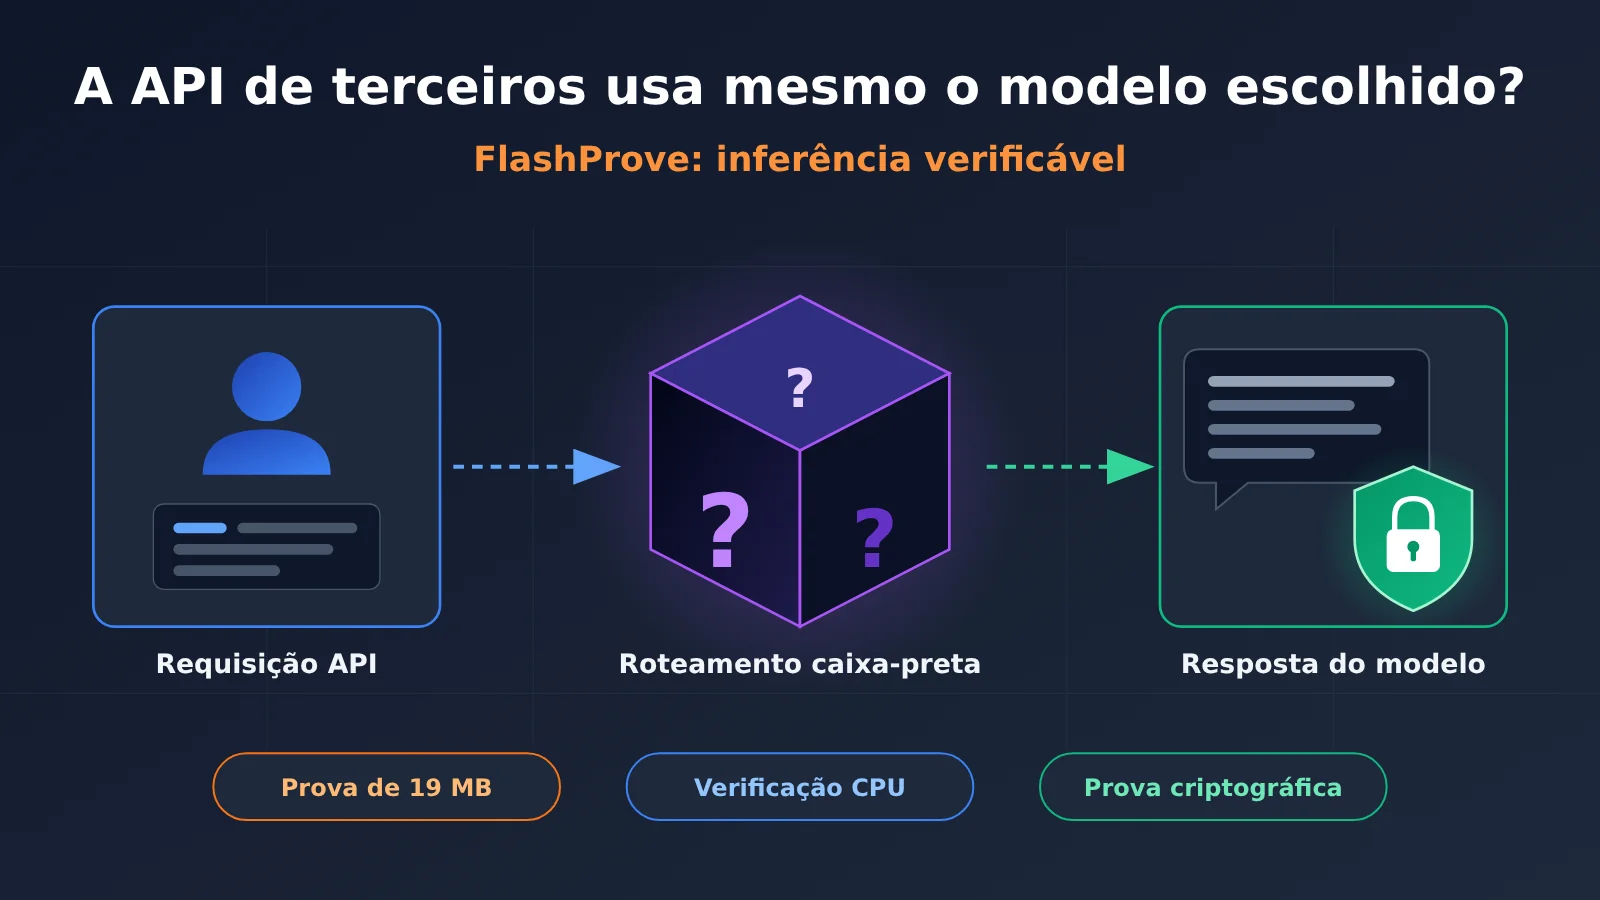
Quando você manda uma requisição por qualquer API, o que volta é só um trecho de texto e um campo com o nome do modelo. A Anthropic afirma sem rodeios, em seu blog de pesquisa, que hoje os usuários não têm como confirmar que a resposta realmente veio do modelo que o provedor diz estar usando. Ela pode ter sido trocada em silêncio por um serviço de roteamento, por motivo de custo, ou adulterada por um atacante no fluxo de tokens.
O ponto mais importante: resposta de boa qualidade não significa que a identidade do modelo seja autêntica. Um modelo barato também pode se sair bem em certas perguntas, e uma versão rebaixada nem sempre é identificável a olho nu. Mesmo que o histórico completo da conversa seja divulgado, em teoria ele poderia ser forjado com um modelo mais barato, então esse tipo de evidência não tem valor de prova absoluta.
Verificar isso de forma fundamental também é difícil. Os pesos dos modelos de fronteira, em sua maioria, não são públicos. E, mesmo que alguém tivesse acesso a eles, o poder computacional necessário para refazer a inferência estaria muito além do que um usuário comum, ou até uma instituição de avaliação, consegue bancar. A Anthropic mapeou alguns cenários típicos desse problema de confiança:
- Serviços de roteamento de terceiros: o cliente quer ter certeza de que os tokens recebidos vêm do modelo que ele escolheu e pagou para usar.
- Avaliação independente: as instituições avaliadoras precisam confirmar que o modelo testado antes do lançamento é o mesmo que está de fato em operação.
- Detecção de adulteração: se o servidor de inferência for comprometido, o atacante pode misturar respostas maliciosas e até instalar malware no computador do usuário.
- Regulação e conformidade: os reguladores podem exigir que só sejam implantados modelos aprovados em revisões de segurança, ou confirmar que o hardware está mesmo rodando inferência e não treinando às escondidas.
O objetivo da inferência comprovável (Provable Inference) é permitir que um usuário com poder computacional limitado, e sem conhecer os pesos, consiga verificar que uma resposta veio de fato do modelo solicitado.
FlashProve: visão geral dos pontos principais
| Item | Detalhes |
|---|---|
| Data de lançamento | 2 de novembro de 2026 |
| Desenvolvedor | Anthropic Frontier Red Team, em parceria com pesquisadores da EPFL, MIT, StarkWare, Succinct e outras instituições |
| Tecnologia central | zkSNARK (argumento de conhecimento sucinto de conhecimento zero), construído sobre funções hash e com segurança pós-quântica |
| Modelo testado | Llama 4 Maverick, MoE de 400B parâmetros, com cerca de 17B parâmetros ativados por token e pesos quantizados em 4 bits disponíveis publicamente |
| O que foi publicado | Blog de pesquisa, relatório técnico, especificação do protocolo escrita pelo Claude, código do provador e de dois verificadores (C++ e Lean), provas em Lean e ferramentas de visualização |
| Licença | Apache 2.0 |
| Posicionamento atual | Protótipo de pesquisa que compartilha o progresso até aqui e aceita melhorias externas |
Vale destacar que, segundo a Anthropic, boa parte das otimizações do sistema foi feita pelo Claude. Para lidar com as “decisões difíceis de avaliar” que uma IA pode tomar em sistemas grandes e complexos, a equipe escreveu em Lean uma declaração de segurança de alto nível que pode ser auditada, como forma de se proteger contra esse risco.
Como o FlashProve prova que a inferência veio do modelo especificado
O FlashProve tem apenas dois papéis: o provedor do modelo atua como provador (Prover) e o usuário atua como verificador (Verifier). O processo se divide em uma fase offline e uma fase online, mais a checagem do lado do verificador.
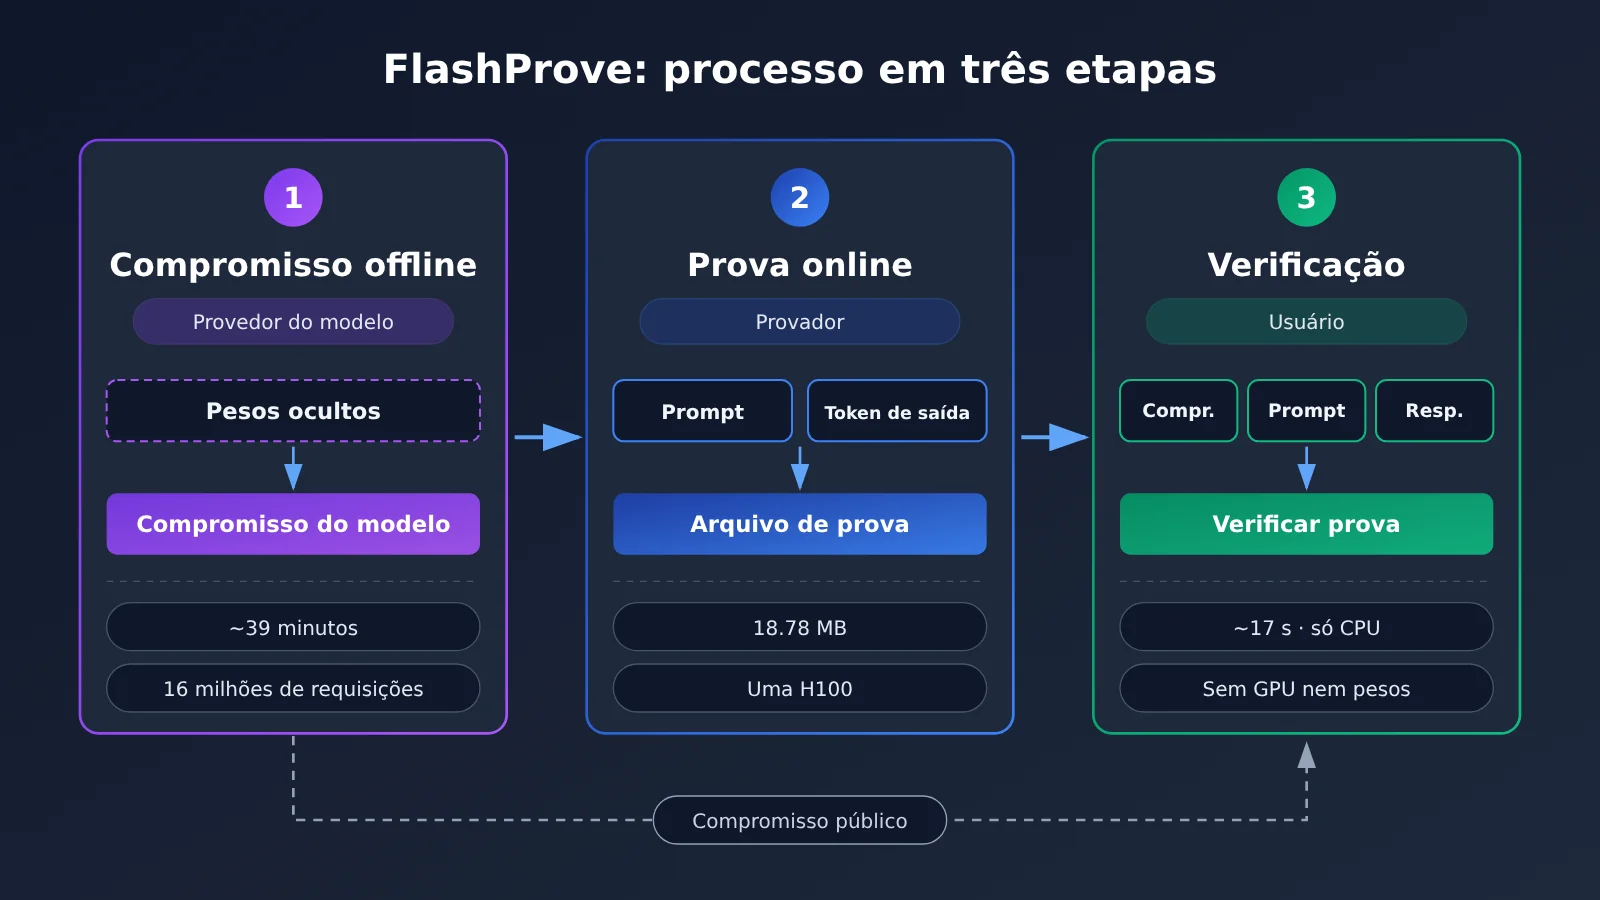
Os três passos do mecanismo do FlashProve
- Compromisso offline do modelo (Model Commitment): o provador publica um compromisso sobre os pesos do modelo, que você pode imaginar como uma “impressão digital” bem curta. Ele trava um conjunto exato de pesos, mas os pesos em si continuam ocultos. Nos testes, esse passo é executado uma única vez por modelo, leva cerca de 39 minutos, e o compromisso gerado sustenta aproximadamente 16 milhões de requisições, depois das quais é preciso refazê-lo.
- Geração da prova online: ao receber a requisição do verificador (o Prompt e os tokens de saída correspondentes), o provador gera um arquivo de prova. O que ele prova é a seguinte afirmação: “o modelo comprometido, ao ser executado, produz exatamente esses tokens de saída”.
- Checagem no lado do verificador: qualquer pessoa que tenha o compromisso, o Prompt e a resposta consegue checar a prova. Não precisa dos pesos e basta uma capacidade de processamento limitada para ter certeza de que os pesos comprometidos produziram exatamente esses tokens para esse Prompt.
As quatro propriedades de segurança do FlashProve
As duas primeiras propriedades (completude e confiabilidade) um verificador que conhecesse os pesos e tivesse poder de processamento suficiente conseguiria obter sozinho, recalculando tudo. O que realmente dá sentido ao sistema são as duas últimas:
- Completude (Completeness): uma prova gerada por um provador honesto sempre será aceita.
- Confiabilidade (Soundness): forjar uma prova válida de uma afirmação falsa é tão difícil quanto quebrar suposições criptográficas amplamente aceitas, então o verificador não precisa confiar no provador.
- Conhecimento zero (Zero Knowledge): o verificador não consegue descobrir os pesos, os valores intermediários dos cálculos, nem quais especialistas foram ativados em cada camada, mas a arquitetura do modelo em si não é escondida.
- Concisão (Succinctness): o que se prova é uma execução de um modelo quantizado de cerca de 232 GB, mas o verificador recebe apenas um arquivo de cerca de 19 MB, que pode ser checado em poucos segundos numa CPU de 24 núcleos.
Como a arquitetura MoE reduz o custo da prova no FlashProve
Boa parte do ganho de velocidade do FlashProve vem de aproveitar a estrutura MoE (Mixture of Experts, ou mistura de especialistas). No Llama 4 Maverick, cada token usa apenas cerca de 17B dos 400B de parâmetros, e o trabalho do provador também é proporcional a esses ~17B, enquanto a prova continua escondendo quais especialistas foram escolhidos.
Há ainda dois outros truques de engenharia igualmente importantes. O primeiro é a prova em lote a posteriori: o provador lê em paralelo, de uma vez só, o texto já concluído, como acontece no Prefill, e abre o compromisso dos pesos uma única vez por lote. O segundo é a adaptação para uma única GPU: os pesos são divididos em segmentos por camada e provados segmento a segmento, sendo carregados em streaming a partir da memória comum. Assim, uma GPU de 80 GB com cerca de 290 GB de memória no host já é suficiente para rodar tudo.
Dados medidos de custo de prova do FlashProve
O custo é a métrica central para saber se o raciocínio comprovável consegue sair do papel. O ambiente de teste da Anthropic foi o seguinte: o lado da prova usa uma única H100 com 24 núcleos de CPU, o lado da verificação usa só CPU, e cada requisição é uma janela de 1024 tokens.
| Etapa | Métrica | Valor medido |
|---|---|---|
| Compromisso offline | Duração / validade | cerca de 39 minutos / cerca de 16 milhões de requisições |
| Prova online | Tempo de um lote de 24 requisições | cerca de 223 segundos |
| Prova online | Vazão de processamento | cerca de 110 tokens/s |
| Arquivo de prova | Tamanho de cada prova | 18,78 MB |
| Download no lado da verificação | Tamanho do compromisso dos pesos | cerca de 6,5 MB |
| Tempo de verificação | 24 threads / thread única | 17 s / 21 s (incluindo a checagem da etapa offline) |
| Comparação com vLLM | Múltiplo de tempo de GPU única | cerca de 72x (66-77x), chegando a cerca de 94x na carga máxima |
A linha de base da comparação é o mesmo modelo, em versão FP8, rodando com vLLM em 8 GPUs H100. Em outras palavras, o tempo de GPU gasto para provar um lote de requisições é aproximadamente 70 a 95 vezes o de uma inferência normal desse mesmo lote, ou seja, um overhead extra de cerca de duas ordens de grandeza.
110 tokens/s não significa provar respostas completas em tempo real
Este é o ponto que mais gera leitura equivocada do FlashProve. O relatório técnico deixa claro: cada prova checa na prática apenas um Token depois do Prompt, e os 110 tokens/s são a vazão com que o lado da prova processa a janela da requisição, não a velocidade de verificar a resposta completa token a token.
| Critério de medição | Vazão | Descrição |
|---|---|---|
| Lote de 24 requisições, contando pelo volume de janela processado | cerca de 110 tokens/s | O número de destaque do blog; cada prova checa um Token |
| Checando cada Token da resposta, contando pelos tokens verificados | 39,1 tokens/s | Mais próximo do cenário de “verificar a resposta inteira” |
| Prova de uma única requisição isolada | 17,6 tokens/s | Cada prova leva cerca de 58 segundos, perdendo a vantagem do processamento em lote |
Por isso, dizer que “o FlashProve já consegue provar respostas completas em tempo real” não é correto. A formulação mais rigorosa é: em condições de processamento em lote, contexto curto e prova posterior (post-hoc), ele reduziu o custo do raciocínio comprovável a um nível que antes parecia inimaginável.
FlashProve vs. soluções existentes de inferência verificável
No meio acadêmico, a inferência verificável costuma ser chamada de zkML. A Anthropic revisou os avanços da área em seu blog, e a comparação de números é bem direta.
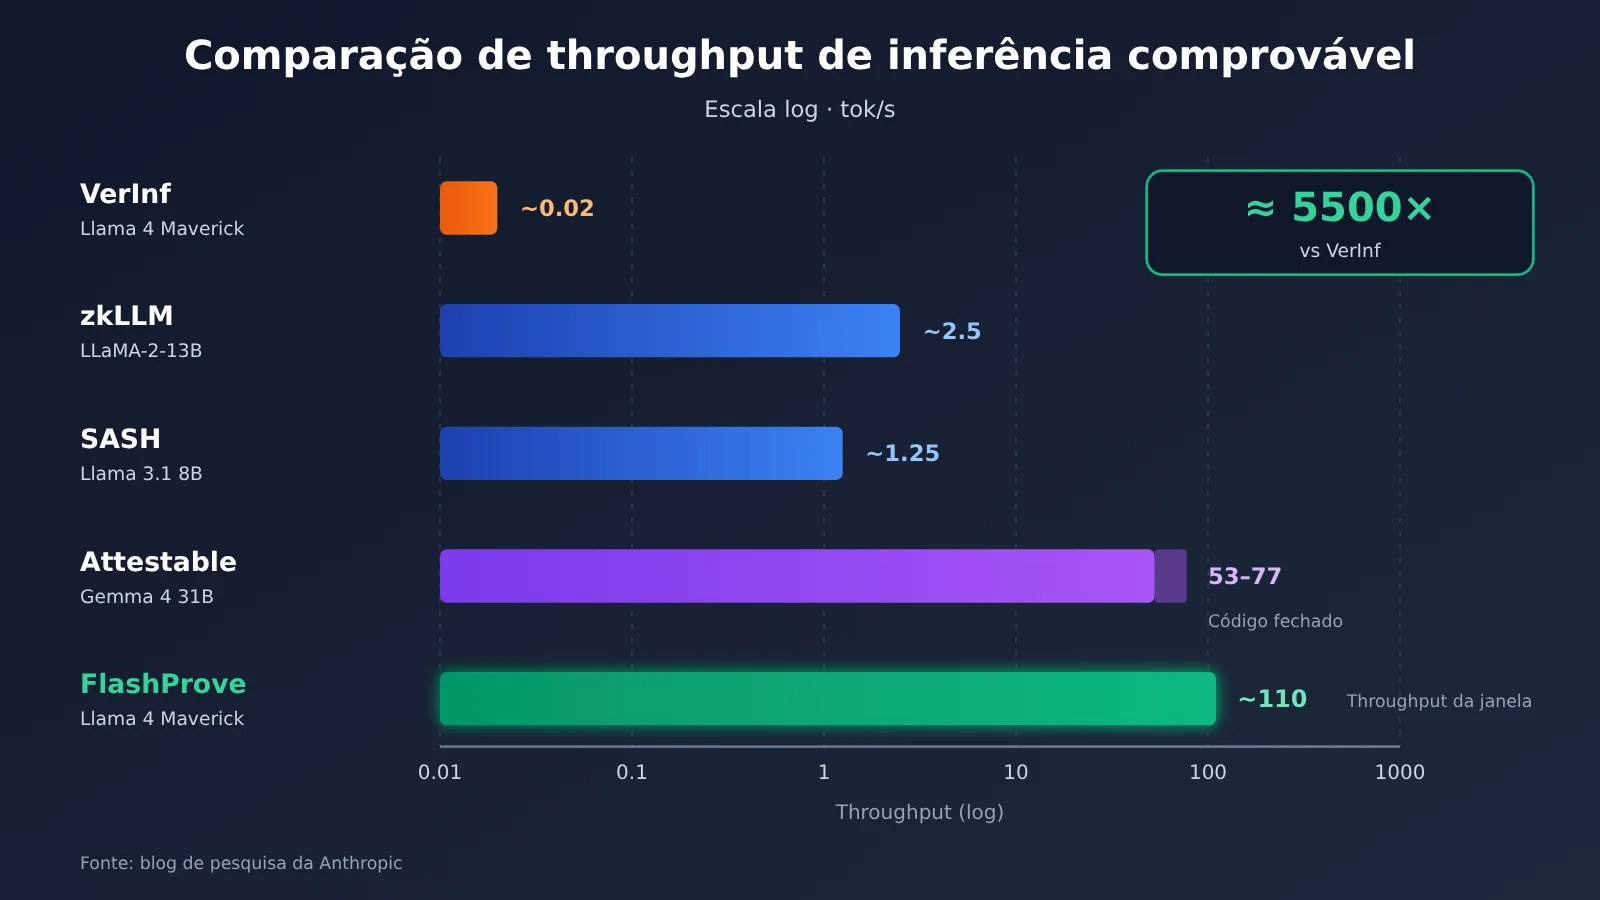
| Solução | Objeto da prova | Vazão / tempo | Observações |
|---|---|---|---|
| VerInf | Llama 4 Maverick (MoE de 400B) | cerca de 0,02 tok/s; 1000 tokens levam 14,3 horas | Prova de 93,6 GB, verificação leva quase um dia |
| zkLLM (2024) | LLaMA-2-13B | cerca de 2,5 tok/s em lote | Uma única A100 |
| SASH (2026) | Llama 3.1 8B | cerca de 1,25 tok/s | Uma única H100 |
| Attestable | Gemma 4 31B (modelo denso) | 53-77 tok/s | Solução comercial, ainda sem código aberto |
| FlashProve | Llama 4 Maverick (MoE de 400B) | cerca de 110 tok/s | Prova de cerca de 19 MB, verificação em segundos, código aberto |
Comparação com o VerInf: o VerInf era a única solução conhecida até então que havia provado o mesmo modelo, mas a prova chega a 93,6 GB e a verificação leva quase um dia, o que a torna praticamente inviável no uso real. Já o FlashProve reduz a prova para cerca de 19 MB e a verificação para uns dez e poucos segundos. Com isso, pela primeira vez, auditorias de terceiros em CPUs comuns se tornam viáveis.
Comparação com o Attestable: o Attestable apresentou números comerciais impressionantes em modelos densos, mas, até a data do blog, ainda não havia publicado uma biblioteca de código aberto correspondente. A vantagem do FlashProve é que o código, as provas em Lean e a documentação são totalmente abertos, então qualquer pessoa pode reproduzir e melhorar o trabalho. O preço a pagar é que, por enquanto, ele depende fortemente da arquitetura MoE.
O que o FlashProve prova e o que ele não prova
Para quem usa APIs de terceiros, entender os limites é tão importante quanto entender as capacidades. A tabela abaixo resume as principais ressalvas apontadas no blog de pesquisa e no relatório técnico:
| Dimensão | O que o FlashProve consegue fazer | O que o FlashProve ainda não consegue fazer |
|---|---|---|
| Identidade do modelo | Prova a vinculação a um compromisso (commitment) de pesos específico, confirmando que é “o modelo que foi comprometido” | Não prova que o compromisso corresponde ao modelo de um nome comercial específico; é preciso publicar um compromisso à parte |
| Correção da saída | Prova que os Tokens verificados são o resultado da decodificação gananciosa (greedy) do modelo em versão inteira (quantizada para inteiros) | Não cobre diretamente a implementação em ponto flutuante nem saídas com amostragem aleatória (temperature maior que 0) |
| Proteção de privacidade | A prova em si não vaza os pesos | Não esconde a arquitetura do modelo; ataques por canais laterais, como o tempo de geração, estão fora do escopo |
| Comprimento de contexto | Suporta contextos de até 1024 Tokens | Muito menor que as centenas de milhares ou até milhões de Tokens comuns em cenários de chat |
| Momento da proteção | Detecta problemas de integridade depois que eles acontecem | Não impede que uma resposta adulterada chegue ao usuário primeiro |
| Arquitetura do modelo | Funciona com modelos MoE | Modelos densos e outras arquiteturas ainda precisam de mais pesquisa |
Limitações de detecção da prova a posteriori do FlashProve
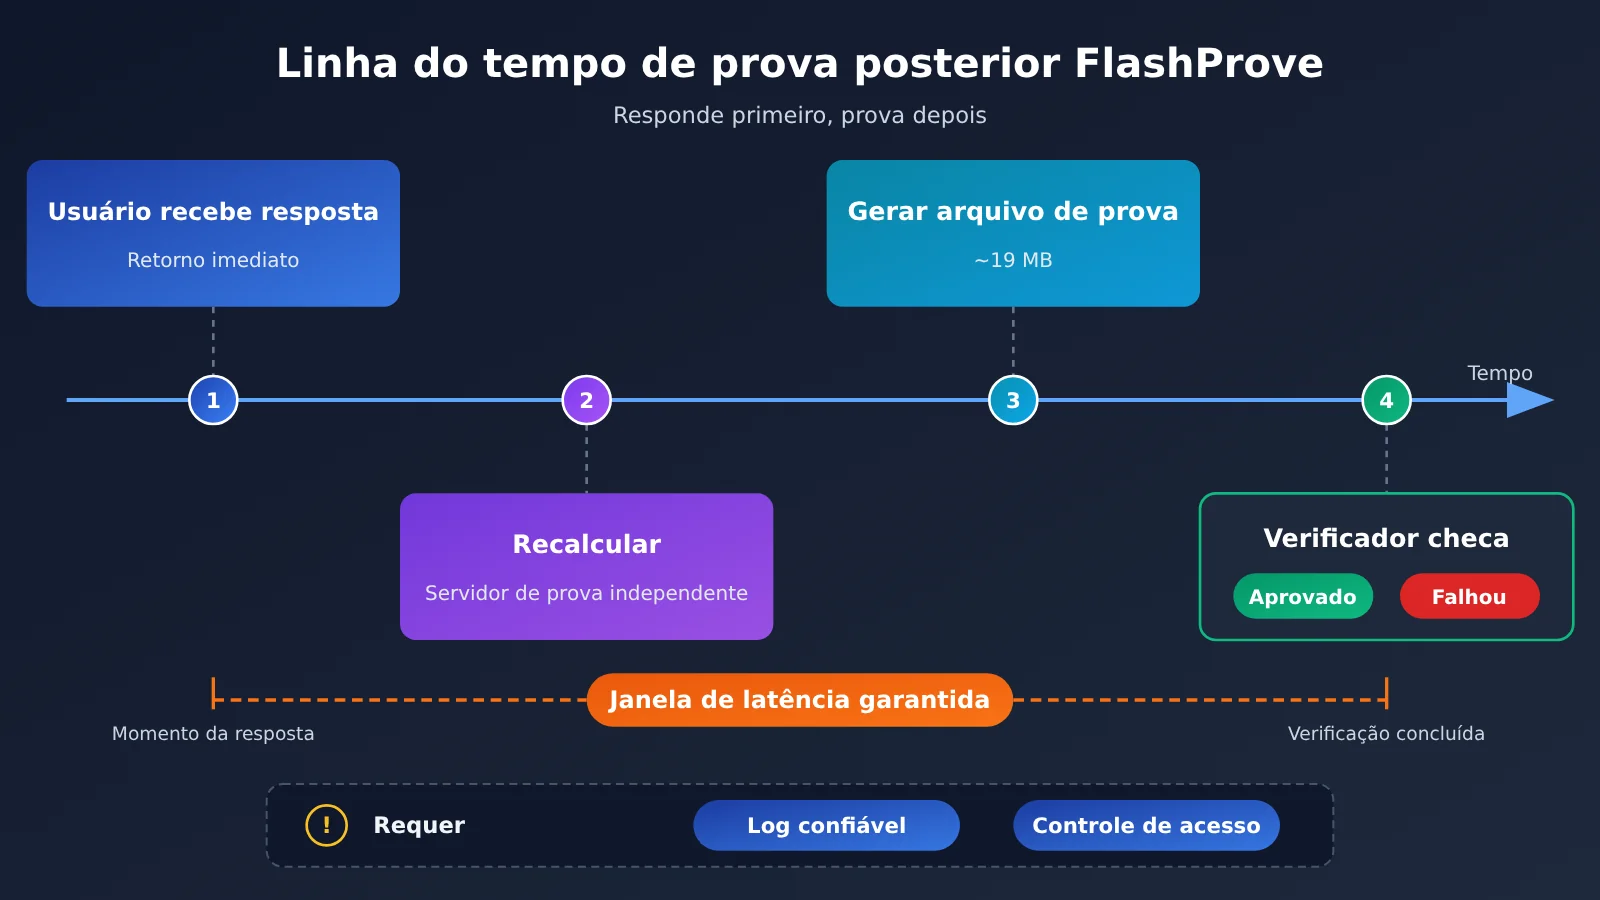
O FlashProve usa prova a posteriori (Post-hoc Proving): o usuário recebe a resposta primeiro, depois um servidor de prova independente refaz o cálculo e gera a prova, e por fim um verificador confere o resultado. Esse esquema permite que a prova seja mais lenta, em troca de não precisar abrir mão de segurança nem de eficiência. O preço é que a garantia chega com atraso: se a prova falhar, ela só revela o problema, mas não protege o usuário antes de ele receber a resposta.
O relatório técnico também alerta para um cenário: se o próprio sistema de logs estiver sob controle do atacante, ele pode enviar conteúdo adulterado ao usuário e, ao mesmo tempo, fazer o log registrar só o resultado correto. Por isso, o FlashProve precisa ser usado junto com outras medidas de segurança, como logs confiáveis e controle de acesso.
O que ainda falta na verificação formal do FlashProve
Dizer que “a prova formal foi feita em Lean” pode facilmente levar à ideia de que “o sistema inteiro foi provado correto”, mas não é bem assim. Os limites listados no relatório técnico incluem:
- A prova em Lean da propriedade de conhecimento zero (zero-knowledge) cobre hoje apenas a prova de uma única requisição, e ainda não a prova em lote.
- O código do lado do provador em GPU foi gerado por IA a partir da representação em Lean, e ainda não foi provado que ele é equivalente a essa representação.
- O verificador rápido em C++ usado no dia a dia também foi gerado por IA e não tem garantia formal; nos testes, apenas suas conclusões coincidiram em todos os casos com as do verificador em Lean.
- O documento mais longo de especificação do protocolo foi gerado por IA e não foi revisado em detalhe pelos autores, então deve ser tratado de forma diferente do relatório técnico escrito por eles.
Essas limitações não invalidam a pesquisa. Elas mostram que a verificação formal hoje fixa as propriedades matemáticas da camada do protocolo, e que a distância entre o código executável e o protocolo ainda precisa ser coberta por auditoria humana ou por agentes.
Análise de impacto: quão longe o FlashProve está das chamadas diárias a APIs de terceiros
Impacto para desenvolvedores e usuários de API
- Não vai aparecer no fluxo de chamadas do dia a dia tão cedo: o custo de GPU cerca de duas ordens de magnitude maior, os cerca de 19 MB de arquivo de prova por requisição e o limite de 1024 tokens de contexto tornam difícil usá-lo diretamente em APIs de conversação de alta frequência.
- Aplicabilidade limitada: o sistema pressupõe arquitetura MoE, modelos em aritmética inteira e decodificação gulosa (greedy). A maioria das chamadas em produção usa amostragem aleatória e inferência em ponto flutuante, então ele não pode ser aplicado diretamente.
- O maior valor está no plano conceitual: pela primeira vez, “verificar a identidade de um modelo” deixa de ser algo impossível e vira um problema de engenharia. Vale ter em mente que o campo com o nome do modelo na resposta, o ID do modelo ou os logs comuns de requisição não equivalem a uma prova criptográfica.
💡 Dica de escolha: enquanto a inferência verificável não amadurece, ao escolher um serviço de terceiros vale mais a pena prestar atenção à transparência de cobrança, à rastreabilidade dos logs de chamada e à consistência nos seus próprios testes. Ao usar plataformas agregadoras como a APIYI (apiyi.com), você pode requisitar vários modelos ao mesmo tempo e manter o registro completo das chamadas, o que facilita fazer comparações cruzadas e auditorias por conta própria.
Impacto para a indústria e a regulação
- A caixa de ferramentas de avaliação e conformidade ganha uma opção a mais: os órgãos reguladores podem exigir que o provedor anexe provas às requisições de inferência de um determinado período, confirmando que o hardware realmente está servindo o modelo especificado, sem ter acesso aos pesos proprietários. Mas a própria Anthropic reconhece que isso não prova que o hardware não esteja sendo usado em paralelo para treinamento.
- Soluções em software e hardware confiável se complementam: os ambientes de execução confiáveis (TEEs) dependem de hardware resistente a adulteração do fabricante, enquanto o zkSNARK depende da dificuldade de problemas computacionais, de modo que não é possível forjar a prova nem se o hardware e o sistema operacional forem comprometidos. Cada um deve se mostrar útil em cenários diferentes.
- A verificação em produção da Anthropic segue outro caminho: no Frontier Safety Roadmap, atualizado em 19 de outubro de 2026, a Anthropic menciona que seu projeto de verificação de inferência já tem um protótipo rodando sobre tráfego real de inferência em produção. Ele funciona com assinaturas cobrindo o tráfego interno de tokens e recalculando a inferência em servidores confiáveis, e chegou a capturar uma anomalia de integridade extremamente rara e não maliciosa. O projeto foi renomeado para inference verification e é um projeto relacionado, mas independente, do FlashProve, então não devem ser confundidos.
{“role”: “user”, “content”: “用一句话解释零知识证明”}
Perguntas frequentes (FAQ)
Q1: O que é o FlashProve?
O FlashProve é um protótipo de pesquisa de inferência verificável, lançado como código aberto pela Anthropic em novembro de 2026. Ele se baseia em zkSNARK: o provedor do modelo primeiro faz um compromisso criptográfico com os pesos e, depois, gera uma prova para o resultado da inferência. Assim, o usuário consegue verificar se a resposta veio mesmo do modelo comprometido, sem precisar dos pesos e usando apenas CPU.
Q2: Qual é a diferença entre o FlashProve e o projeto de verificação de inferência (inference verification) da Anthropic?
Os dois têm objetivos parecidos, mas funcionam de forma diferente. O projeto de verificação de inferência já tem protótipo rodando em tráfego de produção: ele assina o tráfego interno de tokens e recalcula tudo em um servidor confiável. O FlashProve, por outro lado, é uma solução puramente de software, baseada em provas criptográficas, e por enquanto continua sendo um protótipo de pesquisa. Não vale confundir um com o outro.
Q3: Os 110 tokens/s do FlashProve significam que dá para provar uma resposta completa em tempo real?
Não. Os 110 tokens/s são a vazão de processamento de janelas em lote, e cada prova verifica apenas um token. Quando se verifica cada token da resposta, a vazão cai para 39,1 tokens/s. Em uma prova de requisição única, cai para 17,6 tokens/s. Além disso, todo o processo é uma prova feita a posteriori.
Q4: O APIYI já oferece provas do FlashProve para cada resposta?
Não. Até agora, nenhum material indica que o APIYI (apiyi.com) tenha implantado o FlashProve ou ofereça provas criptográficas em nível de pesos. O nome do modelo retornado pela plataforma e os logs de invocação também não equivalem a uma prova criptográfica. No momento, o mais prático é aproveitar a interface unificada e o histórico de chamadas da plataforma para fazer seus próprios testes repetidos e comparações cruzadas.
Q5: Como fazer rapidamente um teste de consistência entre vários modelos via API?
Recomendo usar uma plataforma agregadora que suporte vários modelos:
1. Acesse o APIYI (apiyi.com), crie uma conta e pegue sua chave API e a cota gratuita de testes
2. Configure o `base_url` do código deste artigo como `https://api.apiyi.com/v1`
3. Fixe `temperature=0`, rode periodicamente comandos de sondagem e registre o hash das saídas
Esse método ajuda a detectar oscilações anormais, mas é uma auditoria de engenharia, não uma prova de identidade do modelo.
Q6: Quais são as limitações conhecidas do FlashProve?
As principais são:
– O custo de GPU fica em torno de 70 a 95 vezes o de uma inferência normal.
– O limite de contexto é de 1024 tokens.
– Depende de arquitetura MoE, modelo quantizado em inteiros e decodificação gulosa (greedy).
– Não esconde a arquitetura do modelo, e ataques de canal lateral estão fora do escopo.
– Por ser uma prova a posteriori, não impede que um conteúdo adulterado chegue ao usuário antes da verificação.
– Ainda não existe prova formal de equivalência entre o código executável e o protocolo em Lean.
Pontos-chave do FlashProve (Key Takeaways)
- A lacuna de confiança é real: em chamadas a APIs de terceiros, uma resposta de boa qualidade não prova que o modelo é realmente o que se diz ser.
- Mecanismo central: um compromisso offline com os pesos do modelo, somado a uma prova zkSNARK online, que o usuário consegue verificar só com CPU.
- Queda grande de custo: em uma única H100, a vazão em janela é de cerca de 110 tokens/s, com prova de aproximadamente 19 MB e verificação em cerca de 17 segundos.
- Separe bem as métricas: a vazão com verificação token a token é de 39,1 tokens/s, e em uma requisição única cai para só 17,6 tokens/s.
- Limites bem definidos: só funciona com MoE, decodificação gulosa em aritmética de inteiros, contexto de 1024 tokens e detecção a posteriori.
- Como começar: por enquanto, dá para usar a interface unificada de vários modelos do APIYI (apiyi.com) para fazer seus próprios testes de reprodução e auditorias.
Resumo
O que torna o FlashProve relevante pode ser resumido em três pontos:
- Transforma a verificação de identidade do modelo em um problema de engenharia: antes, provar que se tratava do mesmo modelo exigia mais de dez horas e quase 100 GB de prova. Agora, o processamento em lote chega à casa das centenas de tokens/s, com provas de 19 MB.
- Ainda está longe de uso em produção: o custo adicional de duas ordens de grandeza, o contexto curto, as restrições de arquitetura e de método de decodificação e a cobertura incompleta da verificação formal fazem dele, por enquanto, um protótipo de pesquisa.
- Precisa ser combinado com outros mecanismos de segurança: a prova a posteriori só detecta o problema e não consegue bloqueá-lo, então é preciso associá-la a logs confiáveis e controle de acesso.
Para quem usa APIs de terceiros hoje, a postura mais pé no chão é esta: não trate o campo com o nome do modelo como prova de nada, mas também não precisa entrar em pânico. Primeiro, deixe bem feitos o registro das chamadas, os testes de reprodução com sondas e a validação cruzada entre vários modelos. Ao mesmo tempo, continue acompanhando a evolução da inferência verificável. Uma boa saída é usar o APIYI (apiyi.com) para comparar vários modelos com uma única chave API e montar, com os dados do seu próprio negócio, uma linha de base de qualidade rastreável.
📚 Referências
- Blog de pesquisa da Anthropic – Progress on provable inference for large language models: artigo original de lançamento do FlashProve
- Link:
anthropic.com/research/provable-inference -
Descrição: traz o design do sistema, dados medidos, comparação com soluções existentes e as limitações
-
Relatório técnico do FlashProve: detalhes técnicos completos, anexados ao blog de pesquisa
- Link:
anthropic.com/research/provable-inference(acesse pelo botão “Read the technical report” dentro da página) -
Descrição: inclui o critério de medição de throughput, as limitações da prova posterior (post-hoc) e os limites da verificação formal
-
Anthropic Frontier Safety Roadmap: andamento do projeto de verificação de inferência
- Link:
anthropic.com - Descrição: ajuda a entender a diferença entre inference verification e o FlashProve
Autor: equipe técnica da APIYI
Troca de experiências: fale com a gente na página inicial do site da APIYI. Para mais materiais de integração, acesse a central de documentação em docs.apiyi.com