Catatan penulis: saat memanggil Model Bahasa Besar lewat API pihak ketiga, kualitas jawaban saja tidak cukup untuk memastikan model mana yang sebenarnya berjalan. Artikel ini membahas FlashProve, proyek open source dari Anthropic: bagaimana ia memakai zkSNARK untuk mengikat hasil inferensi ke bobot model tertentu, berapa biayanya, apa yang bisa dan tidak bisa dibuktikannya, dan seberapa jauh ia dari pemanggilan API sehari-hari.
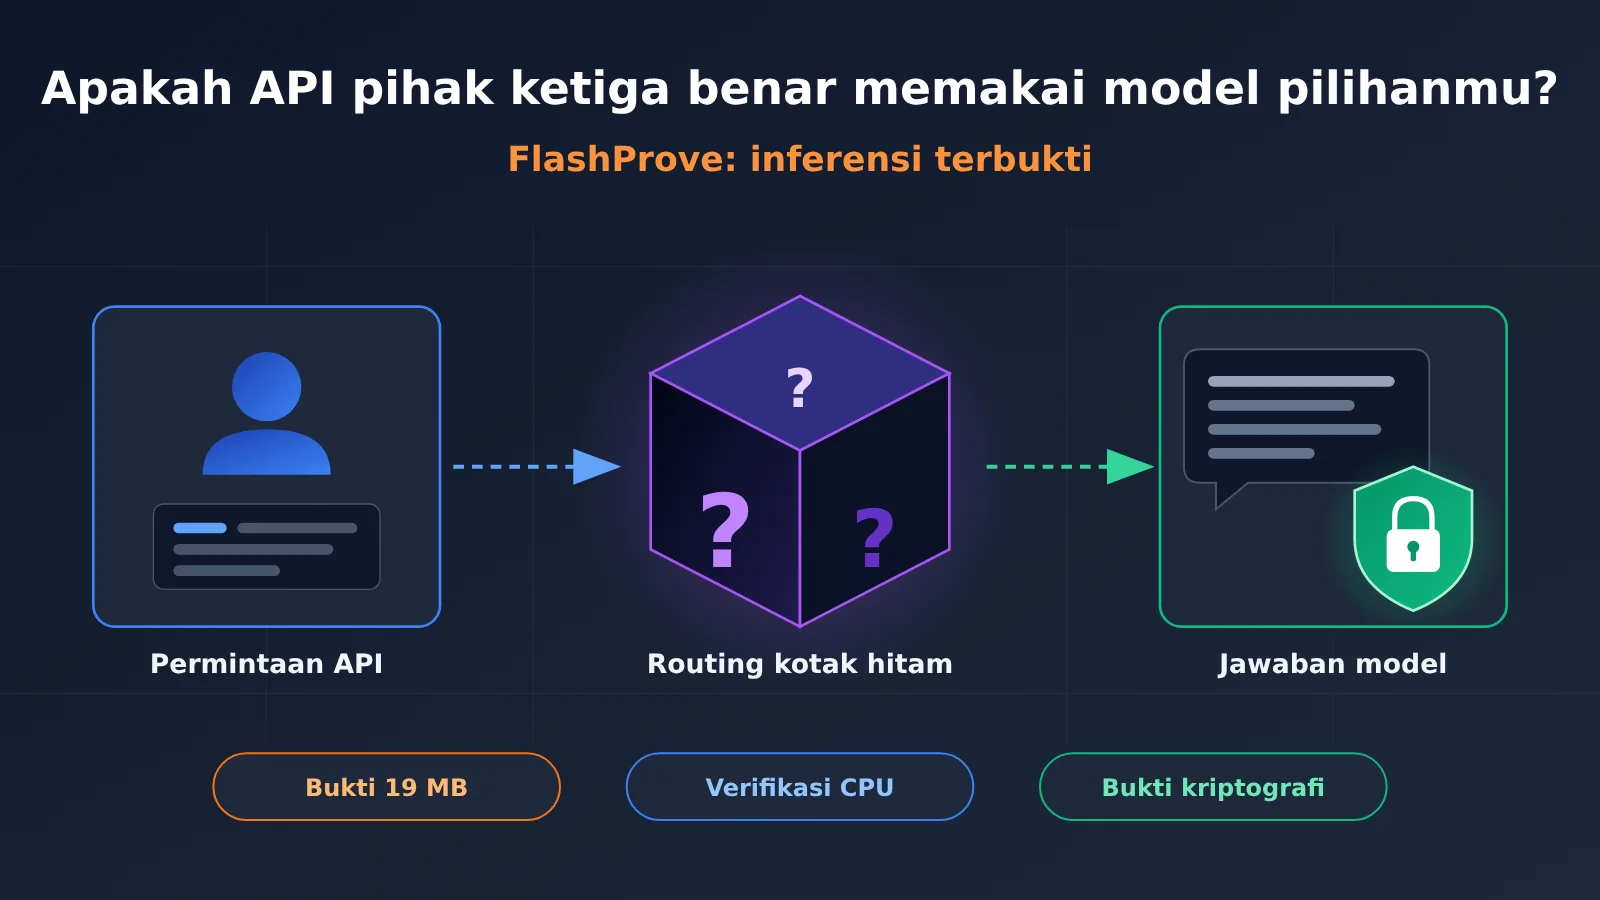
Pada 2 November 2026, para peneliti dari Anthropic Frontier Red Team bersama EPFL, MIT, dan institusi lain merilis FlashProve: prototipe open source inferensi yang dapat dibuktikan (provable inference) untuk Model Bahasa Besar. Pada Llama 4 Maverick dengan 400B parameter, FlashProve membuat bukti hanya dengan satu GPU H100. Satu bukti berukuran sekitar 19 MB, dan CPU biasa bisa memverifikasinya dalam belasan detik.
Ini bukan sekadar demo konsep atau produk di atas slide. Anthropic merilis laporan teknis, dokumen spesifikasi protokol, sisi prover yang bisa dijalankan, dua implementasi sisi verifier, serta bukti formal dalam Lean, semuanya dengan lisensi Apache 2.0. Meski begitu, Anthropic menegaskan bahwa ini baru kemajuan riset tahap awal, dan masih banyak jalan menuju tujuan riset yang utuh.
Nilai utama: setelah membaca artikel ini, kamu akan paham mengapa “identitas model” sulit dipastikan pada pemanggilan API pihak ketiga, mekanisme apa yang dipakai FlashProve untuk menyelesaikannya, di mana batas dan biaya sebenarnya, serta apa yang bisa kamu lakukan sekarang sebagai pengguna API.
Mengapa Ada Masalah Kepercayaan terhadap Identitas Model pada Pemanggilan API Pihak Ketiga
Ketika Anda mengirim permintaan lewat API apa pun, yang kembali hanyalah sepotong teks dan satu kolom nama model. Anthropic menyatakan terang-terangan di blog risetnya bahwa pengguna saat ini tidak bisa memastikan jawaban yang diterima benar-benar berasal dari model yang diklaim pengembangnya. Bisa jadi layanan proksi API diam-diam menggantinya demi menekan biaya, atau penyerang mengutak-atik aliran token.
Yang lebih penting, kualitas output yang bagus tidak berarti identitas model itu asli. Model murah pun bisa menjawab sangat baik untuk pertanyaan tertentu, dan versi yang sudah diturunkan kualitasnya (downgrade) belum tentu bisa dikenali dengan mata telanjang. Bahkan jika seluruh riwayat obrolan dipublikasikan, secara teori riwayat itu tetap bisa dipalsukan dengan model yang lebih murah, sehingga bukti semacam ini tidak punya kekuatan pembuktian yang mutlak.
Verifikasi secara mendasar juga sulit dilakukan. Bobot model-model terdepan umumnya tidak dipublikasikan. Seandainya bobotnya pun didapat, daya komputasi yang dibutuhkan untuk menghitung ulang inferensinya jauh melampaui kemampuan pengguna biasa, bahkan lembaga evaluasi sekalipun. Anthropic merangkum beberapa skenario khas dari masalah kepercayaan ini:
- Layanan proksi API pihak ketiga: pelanggan ingin memastikan token yang diterima berasal dari model yang memang mereka pilih dan bayar.
- Evaluasi independen: lembaga evaluasi perlu memastikan model yang diuji sebelum dan sesudah rilis adalah model yang benar-benar melayani pengguna di lingkungan produksi.
- Deteksi manipulasi: setelah server inferensi dibobol, penyerang bisa menyisipkan jawaban berbahaya, bahkan mengirimkan malware ke komputer pengguna.
- Regulasi dan kepatuhan: regulator bisa saja mewajibkan hanya model yang lolos persetujuan keamanan yang boleh dijalankan, atau meminta bukti bahwa perangkat keras memang dipakai untuk inferensi, bukan diam-diam untuk pelatihan.
Tujuan dari inferensi yang dapat dibuktikan (Provable Inference) adalah memungkinkan pengguna yang daya komputasinya terbatas dan tidak mengetahui bobot model untuk memverifikasi bahwa suatu jawaban benar-benar berasal dari model yang diminta.
Ringkasan Inti FlashProve
| Item | Detail |
|---|---|
| Tanggal rilis | 2 November 2026 |
| Perilis | Anthropic Frontier Red Team, bersama para peneliti dari EPFL, MIT, StarkWare, Succinct, dan institusi lainnya |
| Teknologi inti | zkSNARK (zero-knowledge succinct non-interactive argument of knowledge), dibangun di atas fungsi hash dan memiliki keamanan pasca-kuantum |
| Model uji | Llama 4 Maverick, MoE 400B parameter, sekitar 17B parameter aktif per token, bobot kuantisasi 4-bit yang tersedia untuk publik |
| Konten yang dirilis | Blog riset, laporan teknis, spesifikasi protokol yang ditulis Claude, kode sisi prover serta dua sisi verifier (C++/Lean), bukti Lean, dan alat visualisasi |
| Lisensi | Apache 2.0 |
| Posisi saat ini | Prototipe riset, membagikan kemajuan tahap awal, dan terbuka untuk perbaikan dari pihak luar |
Yang menarik, Anthropic menyebutkan bahwa sebagian besar pekerjaan optimisasi dalam sistem ini dikerjakan oleh Claude. Untuk mengantisipasi “keputusan yang sulit dievaluasi” yang bisa dibuat AI dalam sistem besar dan kompleks, tim menulis pernyataan keamanan tingkat atas yang dapat diaudit dalam Lean sebagai langkah lindung nilai.
Bagaimana FlashProve Membuktikan Inferensi Berasal dari Model yang Ditentukan
FlashProve hanya punya dua peran: penyedia model sebagai pembukti (Prover) dan pengguna sebagai pemverifikasi (Verifier). Prosesnya terbagi menjadi tahap offline dan tahap online, ditambah pemeriksaan di sisi verifikasi.
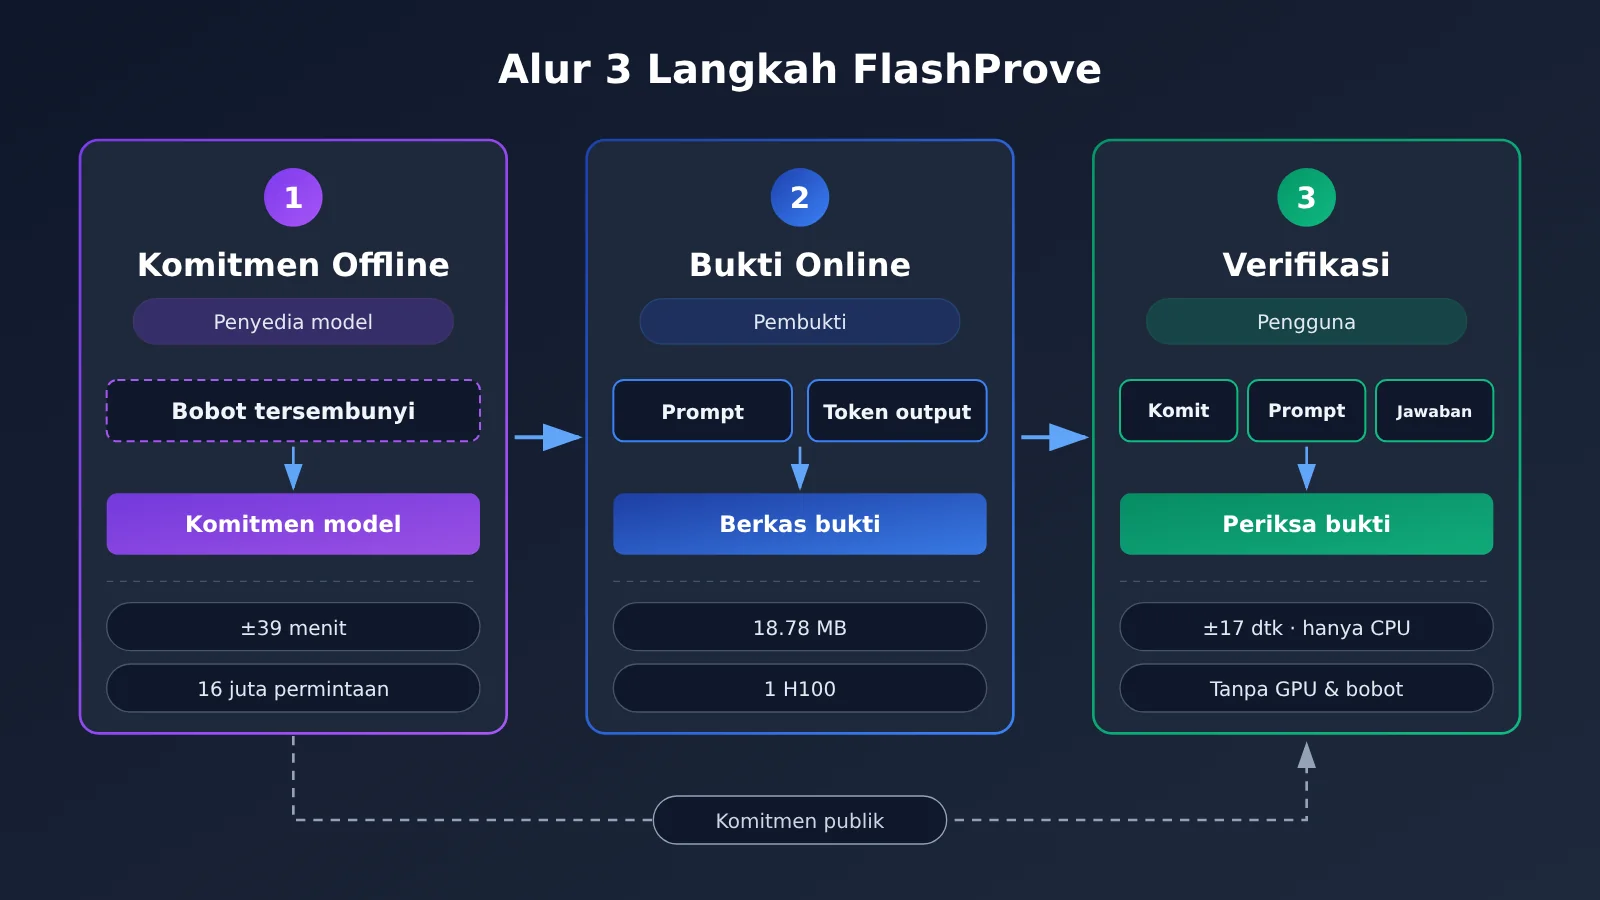
Mekanisme Tiga Langkah FlashProve
- Komitmen model secara offline (Model Commitment): pembukti menerbitkan komitmen atas bobot model, yang bisa dibayangkan sebagai “sidik jari” yang sangat singkat. Komitmen ini mengunci satu set bobot yang pasti, sementara bobotnya sendiri tetap tersembunyi. Dalam pengujian, langkah ini cukup dilakukan sekali per model dan memakan waktu sekitar 39 menit. Komitmen yang dihasilkan bisa mendukung sekitar 16 juta permintaan sebelum perlu dibuat ulang.
- Pembuatan bukti secara online: setelah menerima permintaan dari pemverifikasi (prompt beserta token keluarannya), pembukti membuat satu berkas bukti. Pernyataan yang dibuktikan adalah “model yang telah dikomitmenkan akan menghasilkan token keluaran ini saat dijalankan”.
- Pemeriksaan di sisi verifikasi: siapa pun yang memegang komitmen, prompt, dan jawaban bisa memeriksa bukti tersebut. Tanpa bobot dan hanya dengan daya komputasi terbatas, pemeriksa bisa yakin bahwa bobot yang dikomitmenkan memang menghasilkan token-token ini untuk prompt tersebut.
Empat Sifat Keamanan FlashProve
Dua sifat pertama (kelengkapan dan kesahihan) sebenarnya bisa dicapai oleh pemverifikasi yang tahu bobot dan punya daya komputasi cukup dengan menghitung ulang sendiri. Dua sifat berikutnyalah yang membuat sistem ini benar-benar bermakna:
- Kelengkapan (Completeness): bukti yang dibuat pembukti yang jujur pasti diterima.
- Kesahihan (Soundness): memalsukan bukti valid untuk pernyataan yang salah sama sulitnya dengan menembus asumsi kriptografi yang sudah dipercaya luas, sehingga pemverifikasi tidak perlu memercayai pembukti.
- Pengetahuan nol (Zero Knowledge): pemverifikasi tidak bisa mengetahui bobot, nilai-nilai antara dalam komputasi, maupun pakar (expert) mana yang aktif di tiap lapisan. Namun, arsitektur modelnya sendiri tidak disembunyikan.
- Keringkasan (Succinctness): yang dibuktikan adalah satu kali eksekusi model terkuantisasi berukuran sekitar 232 GB, tetapi pemverifikasi hanya menerima berkas sekitar 19 MB yang bisa diperiksa dalam hitungan detik di CPU 24 inti.
Bagaimana Arsitektur MoE Menekan Biaya Pembuktian FlashProve
Percepatan FlashProve sebagian besar memanfaatkan struktur MoE (Mixture of Experts). Di Llama 4 Maverick, setiap token hanya memakai sekitar 17B dari 400B parameter. Beban kerja pembukti pun hanya sebanding dengan sekitar 17B itu, sementara bukti tetap menyembunyikan pakar mana saja yang dipilih.
Ada dua rancangan rekayasa lain yang sama pentingnya. Pertama, pembuktian massal setelah kejadian: pembukti membaca teks yang sudah selesai secara paralel sekaligus, seperti Prefill, sehingga komitmen bobot hanya dibuka sekali per batch. Kedua, kecocokan dengan satu GPU: bobot dipotong per lapisan dan dibuktikan bagian demi bagian, lalu dimuat bertahap (streaming) dari memori biasa. Dengan begitu, satu GPU 80 GB ditambah sekitar 290 GB memori host sudah cukup untuk menjalankannya.
Data Biaya Pembuktian FlashProve dari Hasil Pengujian
Biaya adalah indikator utama untuk menilai apakah inferensi yang dapat dibuktikan (provable inference) layak diterapkan. Lingkungan pengujian Anthropic seperti ini: sisi pembukti memakai satu GPU H100 plus 24 inti CPU, sisi verifikator hanya memakai CPU, dan setiap permintaan berupa satu jendela 1024 Token.
| Tahap | Metrik | Nilai Terukur |
|---|---|---|
| Komitmen offline | Durasi / masa berlaku | Sekitar 39 menit / sekitar 16 juta permintaan |
| Pembuktian online | Durasi satu batch berisi 24 permintaan | Sekitar 223 detik |
| Pembuktian online | Throughput pemrosesan | Sekitar 110 tokens/s |
| Berkas bukti | Ukuran per berkas | 18,78 MB |
| Unduhan sisi verifikator | Ukuran komitmen bobot | Sekitar 6,5 MB |
| Waktu verifikasi | 24 thread / satu thread | 17 detik / 21 detik (termasuk pemeriksaan tahap offline) |
| Perbandingan dengan vLLM | Kelipatan waktu GPU tunggal | Sekitar 72 kali (66-77 kali), sekitar 94 kali pada beban tertinggi |
Pembanding yang dipakai adalah model yang sama versi FP8, dijalankan dengan vLLM di 8 GPU H100. Artinya, waktu GPU yang dibutuhkan untuk membuktikan satu batch permintaan kira-kira 70-95 kali lipat dibandingkan inferensi biasa untuk batch yang sama, alias overhead tambahan sekitar dua orde magnitudo.
110 tokens/s Bukan Berarti Jawaban Lengkap Dibuktikan Secara Real-Time
Bagian ini paling sering disalahpahami saat membaca FlashProve. Laporan teknisnya menyebutkan dengan jelas: setiap berkas bukti sebenarnya hanya memeriksa satu Token setelah Prompt. Angka 110 tokens/s adalah throughput sisi pembukti dalam memproses jendela permintaan, bukan kecepatan memverifikasi jawaban lengkap Token demi Token.
| Cara Pengukuran | Throughput | Keterangan |
|---|---|---|
| Batch 24 permintaan, dihitung per volume jendela yang diproses | Sekitar 110 tokens/s | Angka yang tampil di judul blog; setiap bukti memeriksa satu Token |
| Memeriksa setiap Token dalam jawaban, dihitung per Token yang diperiksa | 39,1 tokens/s | Lebih mendekati skenario “memverifikasi seluruh jawaban” |
| Satu permintaan dibuktikan sendiri | 17,6 tokens/s | Satu bukti butuh sekitar 58 detik, keunggulan batching hilang |
Jadi, klaim bahwa “FlashProve sudah bisa membuktikan jawaban lengkap secara real-time” kurang tepat. Rumusan yang lebih akurat: dalam kondisi batch, konteks pendek, dan pembuktian setelah kejadian (post-hoc), FlashProve menekan biaya inferensi yang dapat dibuktikan hingga level yang sebelumnya sulit dibayangkan.
FlashProve dan Perbandingannya dengan Solusi Penalaran Terbukti yang Sudah Ada
Penalaran terbukti (provable inference) di dunia akademik biasanya disebut zkML. Anthropic mengulas perkembangan bidang ini di blognya, dan perbandingan angkanya cukup gamblang.
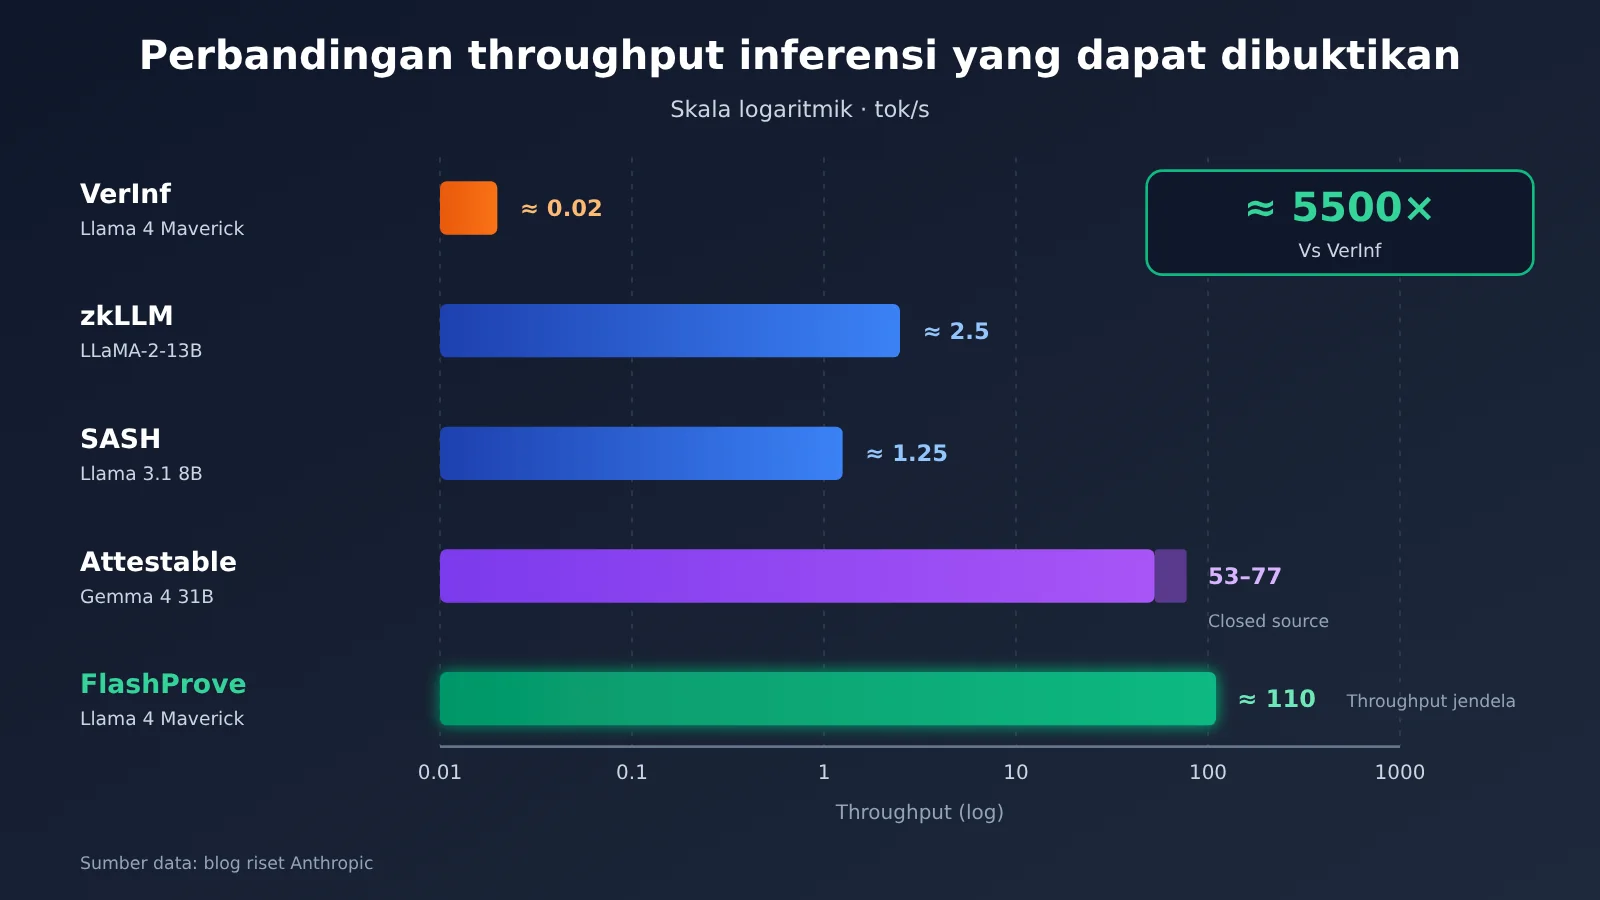
| Solusi | Objek yang dibuktikan | Throughput / waktu | Catatan |
|---|---|---|---|
| VerInf | Llama 4 Maverick (MoE 400B) | Sekitar 0,02 tok/s, 1000 token butuh 14,3 jam | Bukti 93,6 GB, verifikasi hampir sehari |
| zkLLM (2024) | LLaMA-2-13B | Pemrosesan batch sekitar 2,5 tok/s | Satu GPU A100 |
| SASH (2026) | Llama 3.1 8B | Sekitar 1,25 tok/s | Satu GPU H100 |
| Attestable | Gemma 4 31B (model dense) | 53-77 tok/s | Solusi komersial, belum open source |
| FlashProve | Llama 4 Maverick (MoE 400B) | Sekitar 110 tok/s | Bukti sekitar 19 MB, verifikasi dalam hitungan detik, open source |
Perbandingan dengan VerInf: VerInf adalah satu-satunya solusi yang sebelumnya diketahui pernah membuktikan model yang sama. Namun ukuran buktinya mencapai 93,6 GB dan verifikasinya memakan waktu hampir sehari, sehingga nyaris mustahil dipakai dalam praktik. Sebaliknya, FlashProve menekan ukuran bukti menjadi sekitar 19 MB dan memangkas waktu verifikasi menjadi belasan detik. Dengan begitu, audit oleh pihak ketiga di CPU biasa untuk pertama kalinya menjadi layak dilakukan.
Perbandingan dengan Attestable: Attestable meraih angka komersial yang mengesankan pada model dense, tetapi sampai blog ini ditulis, pustaka open source-nya belum dirilis. Keunggulan FlashProve ada pada keterbukaan penuh: kode, bukti Lean, dan dokumentasinya terbuka sehingga siapa pun bisa mereproduksi dan memperbaikinya. Harganya, saat ini FlashProve sangat bergantung pada arsitektur MoE.
Apa yang Bisa dan Tidak Bisa Dibuktikan FlashProve
Bagi pengguna API pihak ketiga, memahami batasan sama pentingnya dengan memahami kemampuan. Tabel berikut merangkum batasan utama dari blog riset dan laporan teknisnya:
| Dimensi | Yang bisa dilakukan FlashProve | Yang belum bisa dilakukan FlashProve |
|---|---|---|
| Identitas model | Membuktikan keterikatan pada komitmen bobot (weight commitment) tertentu, memastikan bahwa itu adalah “model yang dijanjikan” | Tidak bisa membuktikan bahwa komitmen tersebut sesuai dengan model yang memakai nama komersial tertentu, sehingga perlu komitmen publik terpisah |
| Kebenaran keluaran | Membuktikan bahwa Token yang diperiksa adalah hasil greedy decoding dari model yang sudah diubah ke bilangan bulat | Tidak langsung mencakup keluaran dari implementasi floating point maupun sampling acak (temperature lebih dari 0) |
| Perlindungan privasi | Buktinya sendiri tidak membocorkan bobot | Tidak menyembunyikan arsitektur model; serangan side-channel seperti waktu generasi berada di luar cakupan |
| Panjang konteks | Mendukung konteks hingga 1024 Token | Jauh lebih pendek dari skenario chat yang lazim, yaitu ratusan ribu hingga jutaan Token |
| Waktu perlindungan | Mendeteksi masalah integritas setelah kejadian | Tidak bisa mencegah jawaban yang dimanipulasi sampai lebih dulu ke pengguna |
| Arsitektur model | Berlaku untuk model MoE | Arsitektur lain seperti model dense masih butuh riset lanjutan |
Keterbatasan Deteksi pada Pembuktian Pasca-Kejadian FlashProve
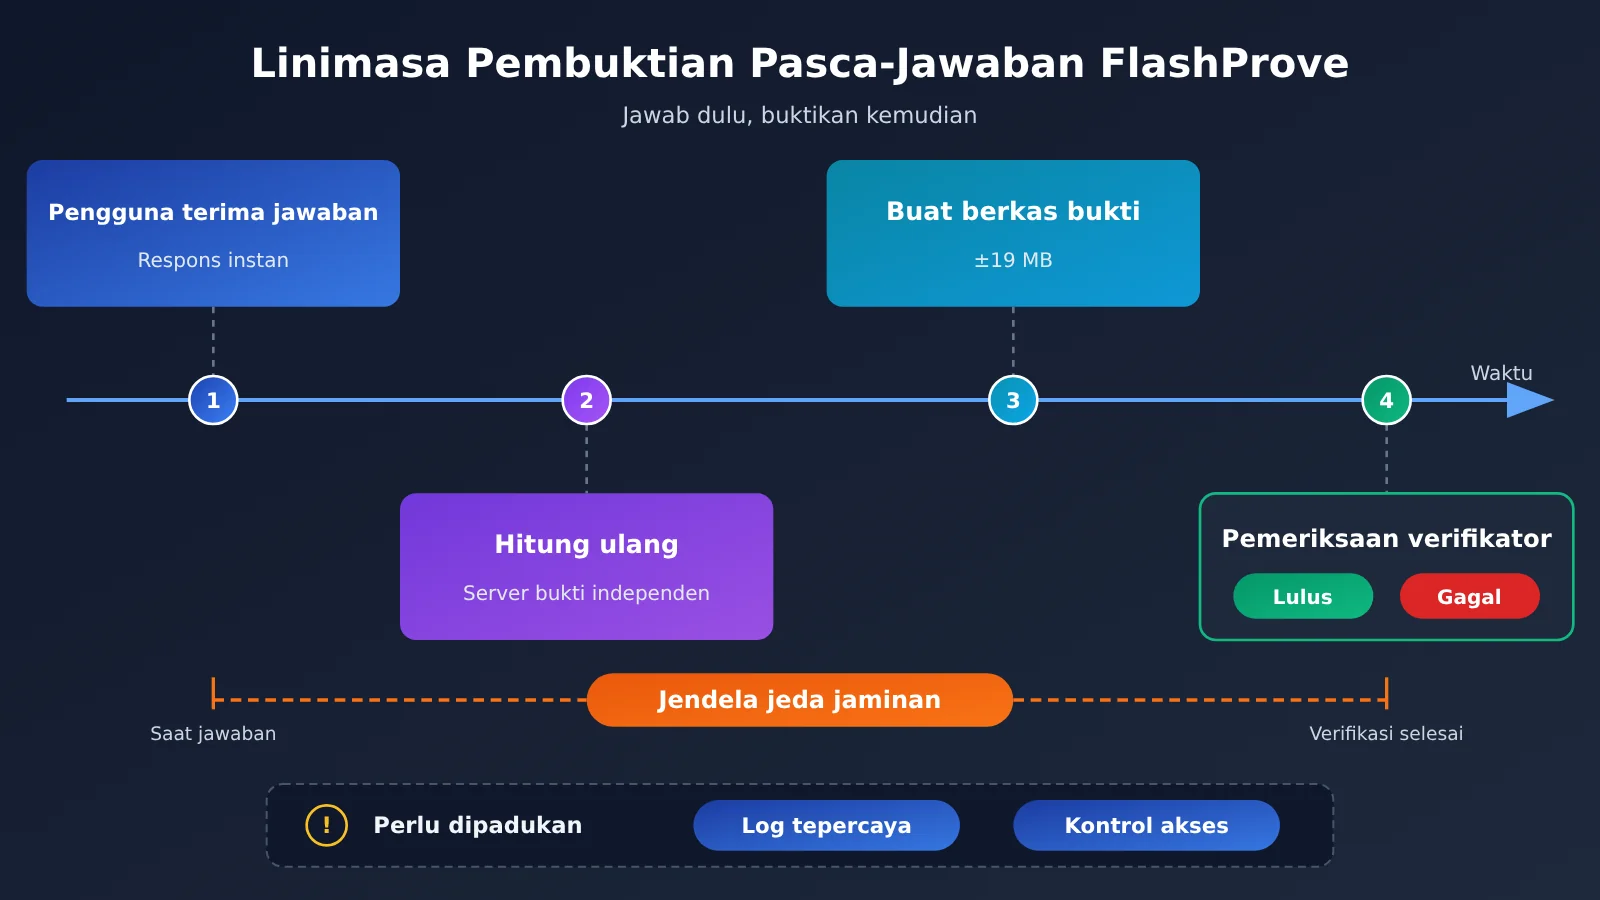
FlashProve memakai pembuktian pasca-kejadian (Post-hoc Proving): pengguna menerima respons lebih dulu, lalu server pembukti independen menghitung ulang dan membuat bukti, dan terakhir bukti itu diperiksa oleh verifier. Cara ini membolehkan proses pembuktian berjalan lebih lambat, sehingga kita tidak perlu mengorbankan keamanan demi efisiensi atau sebaliknya. Konsekuensinya, perlindungan datang terlambat: kalau pembuktian gagal, hasilnya hanya mengungkap adanya masalah, dan pengguna tidak terlindungi sebelum menerima jawaban.
Laporan teknisnya juga mengingatkan bahwa kalau sistem log dikuasai penyerang, penyerang bisa mengirim konten yang sudah dimanipulasi kepada pengguna sambil membuat log hanya mencatat hasil yang benar. Karena itu, FlashProve harus dipakai bersama langkah keamanan lain seperti log tepercaya dan kontrol akses.
Bagian Verifikasi Formal FlashProve yang Belum Selesai
Kalimat “dibuktikan secara formal dengan Lean” mudah disalahartikan sebagai “seluruh sistem terbukti benar”, padahal kenyataannya tidak demikian. Batasan yang tercantum dalam laporan teknis meliputi:
- Pembuktian sifat zero-knowledge di Lean saat ini baru mencakup bukti untuk satu permintaan, belum mencakup bukti batch.
- Kode sisi pembukti di GPU dibuat oleh AI berdasarkan representasi Lean, dan kesetaraannya dengan representasi Lean belum dibuktikan.
- Verifier cepat berbasis C++ yang dipakai sehari-hari juga dibuat oleh AI dan tidak punya jaminan formal. Yang ada hanyalah hasil pengujian yang kesimpulannya selalu cocok dengan verifier Lean.
- Dokumen spesifikasi protokol yang panjang dibuat oleh AI dan tidak ditinjau secara rinci oleh penulisnya, jadi perlu dibedakan dari laporan teknis yang ditulis sendiri oleh penulis.
Keterbatasan ini tidak berarti risetnya tidak berguna. Artinya, verifikasi formal saat ini mengunci sifat matematis di level protokol, sementara kesenjangan antara kode yang dijalankan dan protokolnya masih harus dijembatani lewat audit manual atau audit oleh agen.
Analisis Dampak: Seberapa Jauh FlashProve dari Pemanggilan API Pihak Ketiga Sehari-hari
Dampak bagi Developer dan Pengguna API
- Dalam waktu dekat belum akan masuk ke alur pemanggilan sehari-hari: Biaya GPU yang membengkak sekitar dua orde magnitudo, ukuran berkas bukti sekitar 19 MB per permintaan, dan batas jendela konteks 1024 Token membuatnya sulit dipakai langsung untuk API percakapan yang frekuensinya tinggi.
- Cakupan penerapannya terbatas: Sistem ini mengasumsikan arsitektur MoE, model berbasis bilangan bulat (integer), dan decoding greedy. Sebagian besar pemanggilan di lingkungan produksi memakai sampling acak dan inferensi floating point, sehingga belum bisa langsung diterapkan.
- Nilai terbesarnya ada di tataran pemahaman: Untuk pertama kalinya, “memverifikasi identitas model” berubah dari hal yang mustahil menjadi persoalan rekayasa. Developer perlu sadar bahwa kolom nama model yang dikembalikan, ID model, atau log permintaan biasa tidak setara dengan bukti kriptografis.
💡 Saran memilih: Selama inferensi yang dapat dibuktikan (provable inference) belum matang, hal yang lebih layak diperhatikan saat memilih layanan pihak ketiga adalah transparansi penagihan, keterlacakan log pemanggilan, dan konsistensi hasil uji mandiri. Saat memanggil lewat platform agregator seperti APIYI (apiyi.com), Anda bisa meminta beberapa model sekaligus dan menyimpan catatan pemanggilan secara lengkap, sehingga mudah melakukan perbandingan silang dan audit sendiri.
Dampak bagi Industri dan Regulasi
- Perangkat evaluasi dan kepatuhan bertambah satu opsi: Regulator bisa meminta penyedia layanan melampirkan bukti untuk permintaan inferensi dalam suatu periode, guna memastikan perangkat keras memang menjalankan model yang dimaksud, tanpa perlu mengetahui bobot (weights) yang bersifat proprietari. Namun Anthropic juga mengakui bahwa ini tidak bisa membuktikan bahwa perangkat keras tidak dipakai untuk pelatihan secara diam-diam di jalur lain.
- Solusi perangkat lunak dan perangkat keras tepercaya saling melengkapi: Trusted execution environment bergantung pada perangkat keras antipalsu dari vendor, sedangkan zkSNARK bergantung pada sulitnya masalah komputasi tertentu, sehingga bukti tidak bisa dipalsukan meski perangkat keras dan sistem operasi berhasil dibobol. Keduanya akan berperan di skenario yang berbeda.
- Verifikasi produksi Anthropic menempuh jalur lain: Dalam pembaruan Frontier Safety Roadmap tanggal 19 Oktober 2026, Anthropic menyebutkan bahwa proyek verifikasi inferensinya sudah membangun prototipe pada lalu lintas inferensi produksi. Caranya dengan tanda tangan yang mencakup lalu lintas Token internal, lalu menghitung ulang inferensi di server tepercaya. Proyek ini juga pernah menangkap satu anomali integritas yang sangat langka dan tidak berniat jahat. Proyek tersebut kini bernama inference verification, dan merupakan proyek yang terkait tetapi terpisah dari FlashProve, jadi keduanya tidak boleh dicampuradukkan.
Apa yang Bisa Dilakukan Pengguna API Pihak Ketiga Saat Ini: Membuat Catatan Audit Pemanggilan Sendiri
Karena bukti kriptografis belum bisa dipakai dalam waktu dekat, yang bisa dilakukan developer sekarang adalah memastikan “keterlacakan” (traceability) sudah beres. Contoh di bawah ini mengatur temperature=0 saat pemanggilan, lalu menulis waktu permintaan, ID permintaan, kolom model yang dikembalikan, dan hash jawaban ke log lokal, sehingga memudahkan uji ulang konsistensi di kemudian hari. Perlu ditekankan, ini hanya catatan audit di level engineering, bukan bukti kriptografis atas identitas model.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka APIYI yang kompatibel dengan OpenAI
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "用一句话解释零知识证明"}],
    temperature=0
)
print(resp.model, resp.id)
print(resp.choices[0].message.content)
Lihat kode lengkap implementasi log audit
import hashlib
import json
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Satu kunci untuk memanggil banyak model
)

def audited_call(prompt: str, model: str, log_path: str = "audit.jsonl") -> str:
    """Memanggil model dan mencatat informasi keterlacakan (bukan bukti kriptografis)"""
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        temperature=0,
        max_tokens=512,
    )
    content = resp.choices[0].message.content or ""
    record = {
        "ts": int(start),
        "latency_s": round(time.time() - start, 3),
        "requested_model": model,
        "returned_model": resp.model,   # Hanya kolom klaim yang dikembalikan oleh server
        "request_id": resp.id,
        "prompt_sha256": hashlib.sha256(prompt.encode()).hexdigest(),
        "output_sha256": hashlib.sha256(content.encode()).hexdigest(),
        "usage": resp.usage.model_dump() if resp.usage else None,
    }
    with open(log_path, "a", encoding="utf-8") as f:
        f.write(json.dumps(record, ensure_ascii=False) + "\n")
    return content

# Tetapkan sekumpulan petunjuk probe, uji ulang secara berkala, lalu bandingkan hash output dan distribusi latensi
probes = ["计算 37*43 并只输出结果", "列出三种排序算法的时间复杂度"]
for p in probes:
    for m in ["gpt-4o-mini", "claude-sonnet-4-5"]:
        print(m, audited_call(p, m)[:60])
🚀 Mulai Cepat: Kamu bisa mendapatkan kuota uji coba gratis lewat APIYI (apiyi.com), lalu memakai skrip probe di atas untuk menguji ulang beberapa model secara berkala. Perlu dicatat, metode seperti ini hanya meningkatkan keterlacakan dan tidak bisa menggantikan bukti tingkat bobot (weight-level) seperti FlashProve.
Selain itu, ada beberapa praktik yang bisa dipadukan: pakai ID model yang tetap, bukan alias yang kabur; simpan sekumpulan petunjuk probe untuk memantau perubahan output dan latensi dalam jangka panjang; untuk kebutuhan bisnis yang kritis, kirim permintaan ke beberapa model sekaligus untuk validasi silang; serta pantau perkembangan apakah penyedia layanan membuka komitmen terhadap bobot atau mekanisme yang bisa diverifikasi.
Pertanyaan yang Sering Diajukan (FAQ)
Q1: Apa itu FlashProve?
FlashProve adalah prototipe riset inferensi yang dapat dibuktikan (provable inference) yang dibuka sumbernya oleh Anthropic pada November 2026. Prototipe ini berbasis zkSNARK. Penyedia model terlebih dahulu membuat komitmen terhadap bobot model, lalu membuat bukti untuk hasil inferensi. Pengguna tidak perlu memiliki bobot model dan cukup memakai CPU untuk memverifikasi apakah sebuah jawaban benar-benar berasal dari model yang sudah dikomitmenkan.
Q2: Apa bedanya FlashProve dengan proyek verifikasi inferensi (inference verification) milik Anthropic?
Tujuan keduanya mirip, tetapi cara kerjanya berbeda. Proyek verifikasi inferensi sudah dibuatkan prototipenya pada lalu lintas produksi, dengan cara menandatangani lalu lintas Token internal dan menghitung ulang di server tepercaya. Sementara itu, FlashProve adalah solusi bukti kriptografi murni berbasis perangkat lunak yang saat ini masih berupa prototipe riset. Jadi, keduanya jangan dicampuradukkan.
Q3: Apakah 110 tokens/s pada FlashProve berarti jawaban lengkap bisa dibuktikan secara real-time?
Tidak. Angka 110 tokens/s adalah throughput pemrosesan jendela dalam mode batch, dan setiap bukti hanya memeriksa satu Token. Jika setiap Token dalam jawaban diperiksa, throughput-nya 39,1 tokens/s. Untuk bukti satu permintaan, angkanya turun lagi menjadi 17,6 tokens/s. Selain itu, seluruh prosesnya berupa pembuktian setelah kejadian (post-hoc).
Q4: Apakah APIYI sudah menyediakan bukti FlashProve untuk setiap respons?
Belum. Saat ini tidak ada materi yang menunjukkan bahwa APIYI (apiyi.com) sudah men-deploy FlashProve atau menyediakan bukti kriptografi tingkat bobot. Nama model yang dikembalikan platform dan log pemanggilan juga tidak setara dengan bukti kriptografi. Untuk saat ini, langkah yang lebih realistis adalah memanfaatkan antarmuka terpadu dan catatan pemanggilan dari platform untuk melakukan uji ulang mandiri dan perbandingan silang.
Q5: Bagaimana cara cepat menjalankan uji konsistensi multi-model lewat API?
Disarankan memakai platform agregator yang mendukung banyak model:
1. Kunjungi APIYI (apiyi.com), daftar akun, lalu dapatkan kunci API beserta kuota uji coba gratis
2. Atur base_url pada kode di artikel ini ke `https://api.apiyi.com/v1`
3. Tetapkan `temperature=0`, lalu uji ulang secara berkala dengan petunjuk probe dan catat hash keluarannya
Cara ini memudahkan Anda menemukan fluktuasi yang tidak wajar, tetapi sifatnya audit teknis, bukan pembuktian identitas model.
Q6: Apa saja keterbatasan FlashProve yang sudah diketahui?
Keterbatasan utamanya: overhead GPU sekitar 70-95 kali lipat dibanding inferensi biasa; batas jendela konteks 1024 Token; bergantung pada arsitektur MoE, model berbasis bilangan bulat (integer), dan decoding greedy; arsitektur model tidak disembunyikan, dan serangan side-channel tidak termasuk cakupan; karena pembuktiannya dilakukan setelah kejadian, konten yang sudah dimanipulasi tetap bisa sampai ke pengguna lebih dulu; dan belum ada bukti formal bahwa kode yang dapat dieksekusi setara dengan protokol Lean.
Poin Utama FlashProve (Key Takeaways)
- Celah kepercayaan itu nyata: pada pemanggilan API pihak ketiga, jawaban berkualitas tinggi tidak membuktikan bahwa identitas model benar-benar asli.
- Mekanisme inti: komitmen bobot secara offline ditambah bukti zkSNARK secara online, sehingga pengguna cukup memakai CPU untuk memverifikasi.
- Biaya turun drastis: throughput satu jendela pada satu H100 sekitar 110 token/detik, ukuran bukti sekitar 19 MB, dan waktu verifikasi sekitar 17 detik.
- Bedakan cara pengukurannya: throughput pemeriksaan per token adalah 39,1 token/detik, sedangkan untuk satu permintaan tunggal hanya 17,6 token/detik.
- Batasannya jelas: hanya untuk MoE, dekode greedy berbasis bilangan bulat, konteks 1024 token, dan deteksi setelah kejadian (post-hoc).
- Cara memulai: untuk saat ini, Anda bisa memakai antarmuka terpadu multimodel dari APIYI (apiyi.com) untuk melakukan uji ulang dan audit sendiri.
Kesimpulan
Makna utama FlashProve bisa diringkas menjadi tiga hal:
- Verifikasi identitas model menjadi masalah rekayasa: sebelumnya, membuktikan bahwa sebuah model adalah model yang sama membutuhkan belasan jam dan bukti hingga hampir 100 GB. Kini angkanya turun ke kisaran ratusan token/detik dalam pemrosesan batch, dengan bukti sebesar 19 MB.
- Masih jauh dari siap produksi: biaya tambahan sekitar dua orde magnitudo, konteks yang pendek, batasan arsitektur dan metode dekode, serta cakupan verifikasi formal yang belum lengkap membuatnya masih sebatas prototipe riset.
- Perlu dipadukan dengan mekanisme keamanan lain: bukti setelah kejadian hanya bisa mendeteksi, bukan mencegah, sehingga harus dikombinasikan dengan log tepercaya dan kontrol akses.
Bagi pengguna API pihak ketiga hari ini, sikap yang paling realistis adalah: jangan menjadikan kolom nama model sebagai bukti, tetapi juga tidak perlu terlalu cemas. Mulailah dengan membenahi catatan pemanggilan, uji ulang dengan probe, dan validasi silang antarmodel, sambil terus memantau perkembangan inferensi yang dapat dibuktikan (provable inference). Kami menyarankan memakai APIYI (apiyi.com) agar Anda bisa membandingkan beberapa model dengan satu kunci API, lalu membangun baseline kualitas yang dapat dilacak pada data bisnis Anda sendiri.
📚 Referensi
- Blog Riset Anthropic – Progress on provable inference for large language models: Artikel rilis asli FlashProve
- Tautan:
anthropic.com/research/provable-inference -
Keterangan: Berisi desain sistem, data hasil pengujian, perbandingan dengan solusi yang sudah ada, serta penjelasan keterbatasannya
-
Laporan Teknis FlashProve: Detail teknis lengkap yang dilampirkan pada blog riset
- Tautan:
anthropic.com/research/provable-inference(lihat tombol Read the technical report di dalam halaman) -
Keterangan: Berisi batasan-batasan penting, seperti cara penghitungan throughput, keterbatasan pembuktian pasca-kejadian (post-hoc), dan batas verifikasi formal
-
Anthropic Frontier Safety Roadmap: Penjelasan perkembangan proyek verifikasi inferensi
- Tautan:
anthropic.com - Keterangan: Untuk memahami perbedaan antara inference verification dan FlashProve
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami lewat beranda resmi APIYI. Materi integrasi lainnya bisa diakses di pusat dokumentasi docs.apiyi.com