저자 주석: 제3자 API로 대규모 언어 모델을 호출할 때는 답변 품질만으로는 실제로 어떤 모델이 돌아가고 있는지 확인할 수 없어요. 이 글에서는 Anthropic이 오픈소스로 공개한 FlashProve를 살펴봐요. zkSNARK로 추론 결과를 지정된 가중치에 묶는 방식, 비용은 얼마나 드는지, 무엇을 증명할 수 있고 무엇은 증명할 수 없는지, 그리고 일상적인 API 호출에 적용되기까지 얼마나 남았는지를 정리했어요.
2026년 11월 2일, Anthropic Frontier Red Team은 EPFL, MIT 등 기관의 연구자들과 함께 FlashProve: 대규모 언어 모델을 위한 오픈소스 증명 가능 추론 프로토타입을 발표했어요. 400B 파라미터의 Llama 4 Maverick에서 단일 H100으로 증명을 생성하고, 증명 1건은 약 19MB이며 일반 CPU라면 10여 초 만에 검증할 수 있어요.
이건 개념 시연이나 PPT용 제품이 아니에요. Anthropic은 기술 보고서, 프로토콜 명세 문서, 실행 가능한 증명 생성단과 두 종류의 검증단 코드, 그리고 Lean 형식 증명까지 모두 Apache 2.0 라이선스로 함께 공개했어요. 다만 이는 단계적인 연구 성과이며, 완전한 연구 목표까지는 아직 갈 길이 적지 않다고 분명히 밝혔어요.
핵심 가치: 이 글을 다 읽고 나면 제3자 API 호출에서 ‘모델 신원’이 왜 확인하기 어려운지, FlashProve가 어떤 메커니즘으로 이 문제를 푸는지, 실제 비용과 한계는 어디에 있는지, 그리고 API 사용자로서 지금 무엇을 할 수 있는지를 알게 될 거예요.
서드파티 API 호출에서 모델 신원 신뢰 문제가 생기는 이유
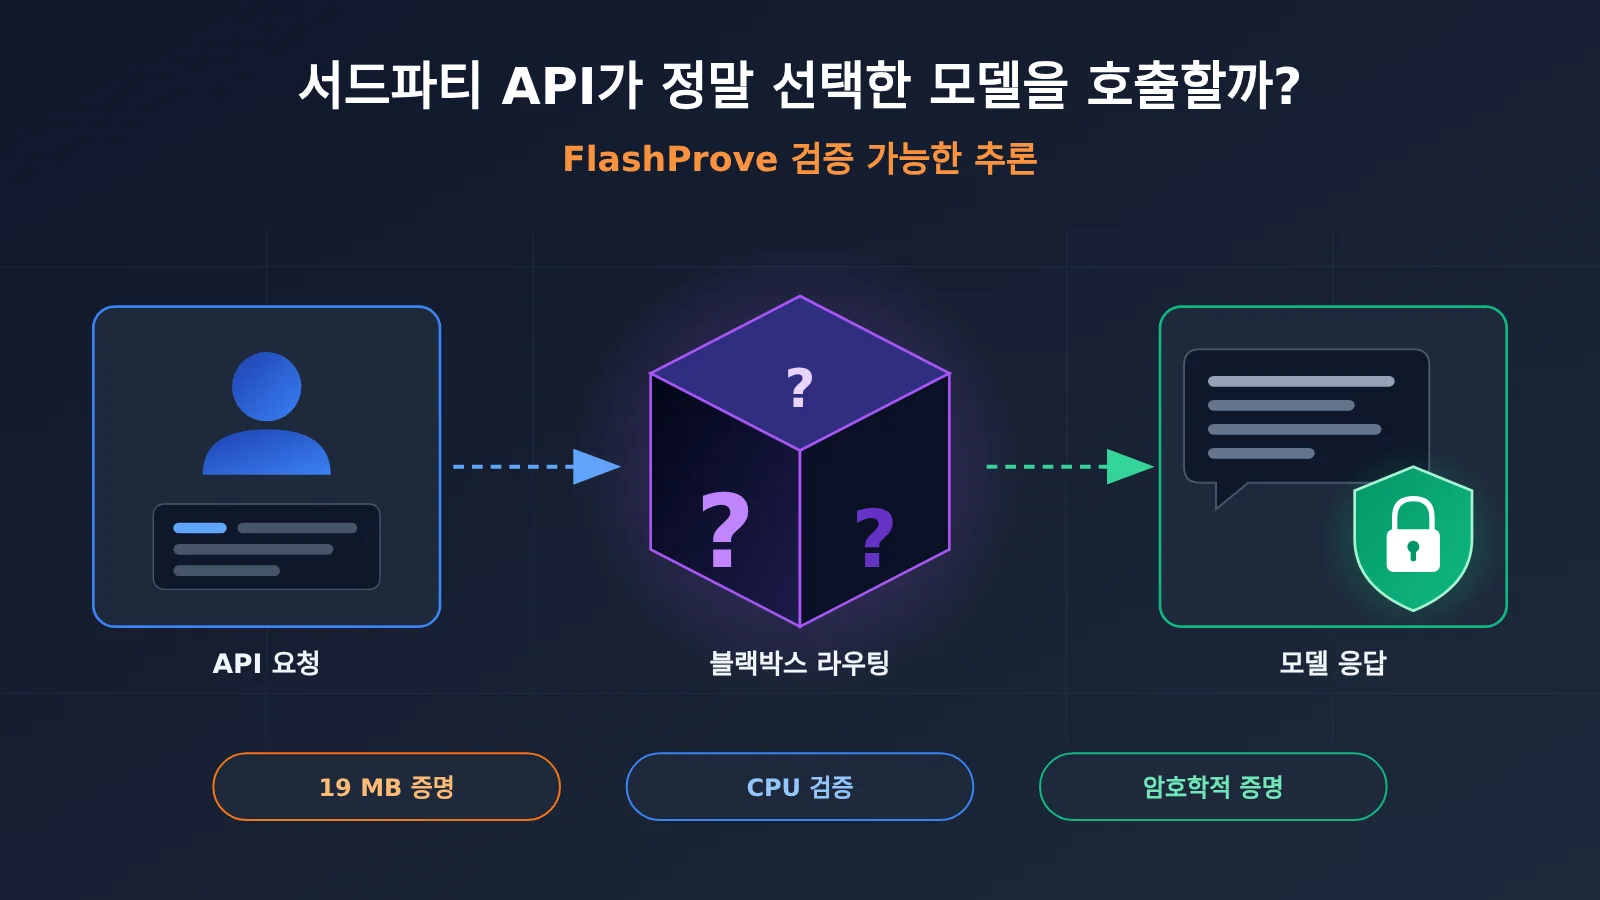
어떤 API로 요청을 보내든 돌아오는 건 텍스트 한 덩어리와 모델 이름 필드뿐이에요. Anthropic은 연구 블로그에서 지금의 사용자는 받은 답변이 정말 개발사가 내세우는 그 모델에서 나왔는지 확인할 방법이 없다고 분명하게 말했어요. 비용을 아끼려는 라우팅 서비스가 몰래 모델을 바꿔치기할 수도 있고, 공격자가 토큰 스트림을 조작할 수도 있어요.
더 중요한 건 출력 품질이 높다고 해서 모델 신원이 진짜라는 보장은 없다는 점이에요. 저렴한 모델도 특정 질문에서는 충분히 좋은 답을 내놓을 수 있고, 성능이 낮아진 다운그레이드 버전을 눈으로 가려내기도 어려워요. 전체 대화 기록을 공개하더라도, 이론적으로는 더 저렴한 모델로 얼마든지 위조할 수 있어서 그런 증거만으로는 절대적인 증명력을 갖기 어려워요.
근본적으로 검증하기도 쉽지 않아요. 최신 프런티어 모델은 대부분 가중치를 공개하지 않아요. 설령 가중치를 손에 넣더라도 추론을 처음부터 다시 계산하는 데 필요한 연산량은 일반 사용자는 물론 평가 기관이 감당할 수준을 훨씬 넘어요. Anthropic은 이런 신뢰 문제가 나타나는 대표적인 상황을 다음과 같이 정리했어요.
- 서드파티 라우팅 서비스: 고객은 자신이 비용을 내고 선택한 모델에서 나온 토큰을 받았는지 확인하고 싶어 해요.
- 독립 평가: 평가 기관은 출시 전후에 테스트한 모델이 실제로 서비스 중인 모델과 같은지 확인해야 해요.
- 변조 탐지: 추론 서버가 침해당하면 공격자가 악의적인 답변을 끼워 넣거나, 심지어 사용자 컴퓨터에 악성 소프트웨어를 심을 수도 있어요.
- 규제 및 컴플라이언스: 규제 당국이 안전성 승인을 받은 모델만 배포하도록 요구하거나, 하드웨어가 몰래 학습을 하지 않고 정말 추론만 하고 있는지 확인하려 할 수 있어요.
증명 가능한 추론(Provable Inference)의 목표는 연산 능력이 제한적이고 가중치도 모르는 사용자가, 어떤 답변이 요청한 모델에서 실제로 나온 것인지 검증할 수 있게 하는 거예요.
FlashProve 핵심 정보 한눈에 보기
| 항목 | 상세 내용 |
|---|---|
| 발표 시기 | 2026년 11월 2일 |
| 발표 주체 | Anthropic Frontier Red Team, EPFL·MIT·StarkWare·Succinct 등 기관 연구자와 공동 진행 |
| 핵심 기술 | zkSNARK(영지식 간결한 지식 증명), 해시 함수 기반 구성으로 양자 내성 보안 확보 |
| 테스트 모델 | Llama 4 Maverick, 400B 파라미터 MoE, 토큰당 약 17B 파라미터 활성화, 4비트 양자화 가중치 공개 |
| 공개 내용 | 연구 블로그, 기술 보고서, Claude가 작성한 프로토콜 사양, 증명 측 코드와 C++/Lean 이중 검증 측 코드, Lean 증명 및 시각화 도구 |
| 오픈소스 라이선스 | Apache 2.0 |
| 현재 위상 | 연구 프로토타입. 단계적 진행 상황을 공유하며 외부의 개선을 환영해요 |
특히 눈여겨볼 점은, Anthropic이 시스템의 상당수 최적화 작업을 Claude가 수행했다고 밝혔다는 거예요. 대규모의 복잡한 시스템에서 AI가 “평가하기 어려운 결정”을 내릴 수 있다는 우려에 대비해, 팀은 Lean으로 감사 가능한 최상위 보안 명제를 작성해 이를 보완하는 장치로 삼았어요.
FlashProve는 어떻게 추론이 지정된 모델에서 나왔음을 증명할까요
FlashProve에는 역할이 두 가지뿐이에요. 모델 제공자가 증명자(Prover)가 되고, 사용자가 검증자(Verifier)가 돼요. 전체 과정은 오프라인 단계와 온라인 단계로 나뉘고, 여기에 검증 쪽 확인 단계가 더해져요.
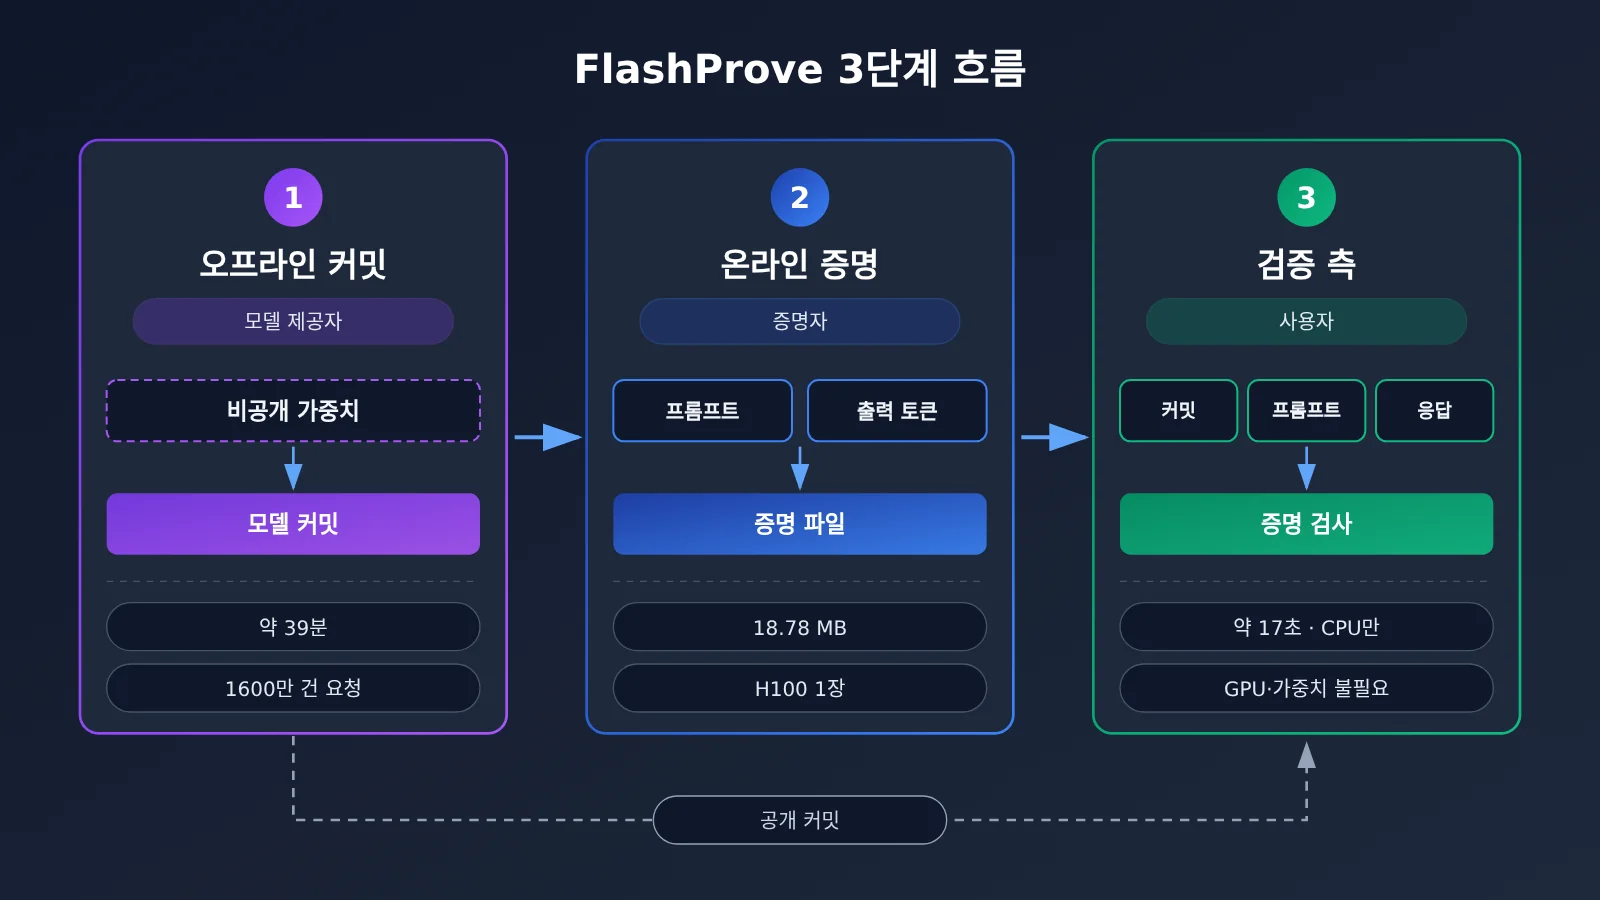
FlashProve의 3단계 메커니즘
- 오프라인 모델 커밋먼트(Model Commitment): 증명자가 모델 가중치에 대한 커밋먼트를 공개해요. 아주 짧은 “지문”이라고 생각하면 돼요. 이 지문은 정확히 어떤 가중치인지를 확정해 주지만, 가중치 자체는 숨겨져 있어요. 테스트에서 이 단계는 모델당 한 번만 실행하면 됐고, 약 39분이 걸렸어요. 생성된 커밋먼트 하나로 약 1,600만 건의 요청을 처리할 수 있고, 그 이후에는 다시 커밋해야 해요.
- 온라인 증명 생성: 검증자의 요청(프롬프트와 그에 대응하는 출력 토큰)을 받으면, 증명자가 증명 파일을 생성해요. 이 파일이 증명하는 명제는 “커밋된 모델이 실행되면 이 출력 토큰들이 나온다”는 거예요.
- 검증 단계의 확인: 커밋먼트, 프롬프트, 응답을 가진 사람이라면 누구나 증명을 검사할 수 있어요. 가중치가 필요 없고 연산 자원도 많이 들지 않아요. 그런데도 커밋된 가중치가 이 프롬프트에서 정확히 이 토큰들을 만들어 냈다고 확신할 수 있어요.
FlashProve의 네 가지 보안 속성
앞의 두 속성(완전성과 건전성)은 사실 가중치를 알고 연산 자원도 충분한 검증자라면 직접 다시 계산해서도 확인할 수 있어요. 이 시스템을 진짜 의미 있게 만드는 건 뒤의 두 속성이에요.
- 완전성(Completeness): 정직한 증명자가 만든 증명은 반드시 받아들여져요.
- 건전성(Soundness): 거짓 명제에 대한 유효한 증명을 위조하는 일은 널리 신뢰받는 암호학적 가정을 깨는 것만큼 어려워요. 그래서 검증자가 증명자를 믿을 필요가 없어요.
- 영지식(Zero Knowledge): 검증자는 가중치도, 중간 계산값도 알 수 없고, 각 레이어에서 어떤 전문가(expert)가 활성화됐는지도 알 수 없어요. 다만 모델 아키텍처 자체는 숨기지 않아요.
- 간결성(Succinctness): 증명 대상은 약 232 GB짜리 양자화 모델의 한 번의 실행인데, 검증자가 받는 건 약 19 MB의 파일뿐이에요. 이 파일은 24코어 CPU에서 몇 초 만에 검사할 수 있어요.
MoE 아키텍처가 FlashProve의 증명 비용을 줄이는 방법
FlashProve가 빨라진 데는 MoE(Mixture of Experts, 혼합 전문가 모델) 구조가 크게 기여했어요. Llama 4 Maverick은 토큰 하나를 처리할 때 400B 파라미터 중 약 17B만 사용해요. 증명자의 작업량도 이 약 17B에 비례하고, 그러면서도 어떤 전문가가 선택됐는지는 증명에서 여전히 숨겨져요.
엔지니어링 설계 두 가지도 마찬가지로 중요해요. 첫째는 사후 배치 증명이에요. 증명자가 Prefill처럼 이미 완성된 텍스트를 한 번에 병렬로 읽고, 배치마다 가중치 커밋먼트를 한 번만 열어요. 둘째는 단일 GPU 적합화예요. 가중치를 레이어 단위로 나눠 구간별로 증명하고, 일반 메모리에 올려 둔 가중치를 스트리밍 방식으로 불러와요. 덕분에 80 GB GPU 한 장과 약 290 GB의 호스트 메모리만 있으면 실행할 수 있어요.
FlashProve 증명 비용 실측 데이터
증명 가능한 추론을 실제로 도입할 수 있을지 판단하는 핵심 지표는 비용이에요. Anthropic의 테스트 환경은 다음과 같아요. 증명 측은 H100 한 장에 CPU 코어 24개, 검증 측은 CPU만 사용하고, 요청 하나는 1024 토큰짜리 윈도우예요.
| 단계 | 지표 | 실측값 |
|---|---|---|
| 오프라인 커밋 | 소요 시간 / 유효 기간 | 약 39분 / 약 1,600만 건의 요청 |
| 온라인 증명 | 요청 24개를 한 배치로 처리하는 시간 | 약 223초 |
| 온라인 증명 | 처리량 | 약 110 tokens/s |
| 증명 파일 | 증명 1건당 크기 | 18.78 MB |
| 검증 측 다운로드 | 가중치 커밋 크기 | 약 6.5 MB |
| 검증 소요 시간 | 24스레드 / 단일 스레드 | 17초 / 21초 (오프라인 단계 검사 포함) |
| vLLM 대비 | 단일 GPU 시간 배수 | 약 72배 (66~77배), 최대 부하에서는 약 94배 |
비교 기준은 H100 8장에서 vLLM으로 같은 모델의 FP8 버전을 돌린 결과예요. 쉽게 말해 요청 한 배치를 증명하는 데 드는 GPU 시간은, 같은 배치를 일반 추론으로 처리할 때보다 대략 70~95배 많아요. 약 두 자릿수 배(두 orders of magnitude)의 추가 오버헤드인 셈이에요.
110 tokens/s는 완전한 답변을 실시간으로 증명한다는 뜻이 아니에요
FlashProve를 해석할 때 가장 오해하기 쉬운 부분이에요. 기술 보고서는 증명 1건이 실제로 검사하는 대상이 프롬프트 뒤의 토큰 하나라고 분명히 한정하고 있어요. 110 tokens/s는 증명 측이 요청 윈도우를 처리하는 처리량일 뿐, 완전한 답변을 토큰 단위로 하나하나 검증하는 속도가 아니에요.
| 산정 기준 | 처리량 | 설명 |
|---|---|---|
| 24개 요청 배치 처리, 윈도우 처리량 기준 | 약 110 tokens/s | 블로그 제목에 쓰인 수치이고, 증명 1건당 토큰 하나를 검사해요 |
| 답변의 모든 토큰을 검사, 검사한 토큰 기준 | 39.1 tokens/s | “답변 전체를 검증하는” 상황에 더 가까워요 |
| 단일 요청을 따로 증명 | 17.6 tokens/s | 증명 1건에 약 58초가 걸려 배치 처리의 이점이 사라져요 |
따라서 “FlashProve는 이미 완전한 답변을 실시간으로 증명할 수 있다”는 말은 정확하지 않아요. 더 엄밀하게 표현하면, 배치 처리·짧은 컨텍스트·사후 증명이라는 조건에서 증명 가능한 추론의 비용을 예전에는 상상하기 어려웠던 수준까지 낮췄다고 할 수 있어요.
FlashProve와 기존 증명 가능 추론 방식 비교
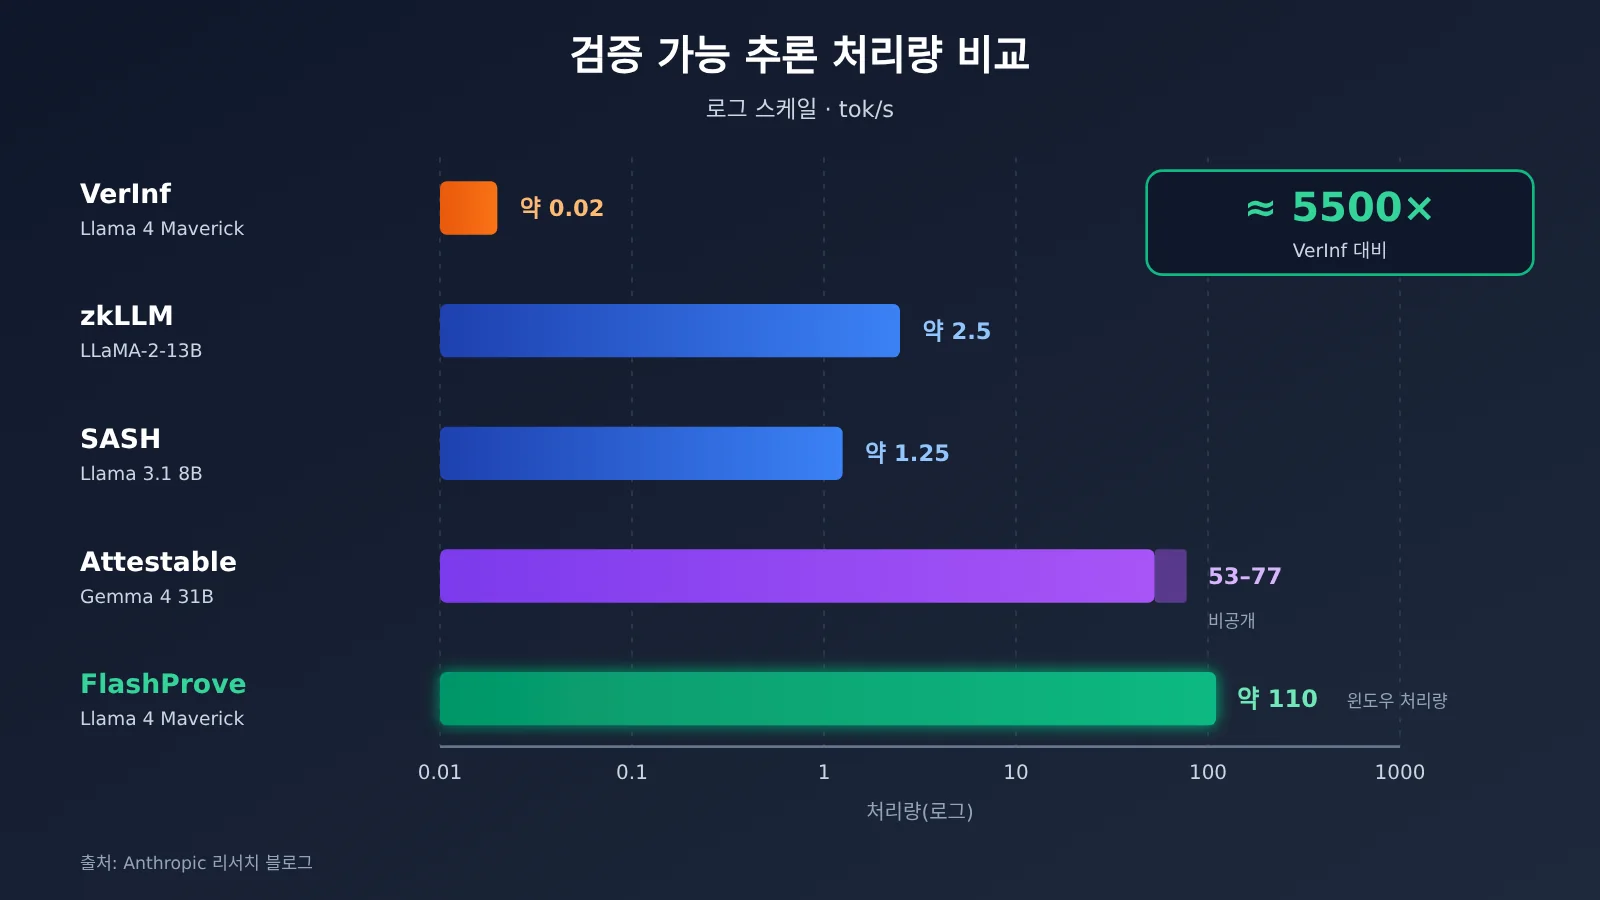
증명 가능한 추론은 학계에서 보통 zkML이라고 불러요. Anthropic은 블로그에서 관련 진전을 정리했는데, 수치만 놓고 봐도 차이가 확실히 드러나요.
| 방식 | 증명 대상 | 처리량 / 소요 시간 | 비고 |
|---|---|---|---|
| VerInf | Llama 4 Maverick (400B MoE) | 약 0.02 tok/s, 1000토큰에 14.3시간 소요 | 증명 크기 93.6 GB, 검증에 거의 하루 소요 |
| zkLLM (2024) | LLaMA-2-13B | 배치 처리 시 약 2.5 tok/s | A100 1장 |
| SASH (2026) | Llama 3.1 8B | 약 1.25 tok/s | H100 1장 |
| Attestable | Gemma 4 31B (밀집 모델) | 53-77 tok/s | 상용 방식, 아직 비공개 |
| FlashProve | Llama 4 Maverick (400B MoE) | 약 110 tok/s | 증명 크기 약 19 MB, 몇 초 만에 검증, 오픈소스 |
VerInf와 비교하면: VerInf는 지금까지 알려진 방식 중 같은 모델을 증명한 유일한 사례예요. 하지만 증명 크기가 93.6 GB에 달하고 검증에도 거의 하루가 걸려서 실제로 쓰기는 어려워요. 반면 FlashProve는 증명 크기를 약 19 MB로 줄이고 검증 시간도 십여 초로 단축했어요. 덕분에 일반 CPU에서 제3자가 감사하는 일이 처음으로 현실적인 선택지가 됐어요.
Attestable과 비교하면: Attestable은 밀집 모델에서 인상적인 상용화 수치를 냈지만, 블로그 작성 시점까지 대응하는 오픈소스 라이브러리는 공개되지 않았어요. FlashProve의 강점은 코드, Lean 증명, 문서가 모두 공개되어 있어서 누구나 재현하고 개선할 수 있다는 점이에요. 대신 현재는 MoE 아키텍처에 크게 의존한다는 한계가 있어요.
FlashProve가 증명하는 것과 증명하지 못하는 것
서드파티 API를 쓰는 사용자라면 기능만큼이나 한계도 알아 두는 것이 중요해요. 아래 표는 연구 블로그와 기술 보고서에 나온 핵심 제약을 정리한 거예요.
| 항목 | FlashProve가 할 수 있는 것 | FlashProve가 아직 못 하는 것 |
|---|---|---|
| 모델 신원 | 특정 가중치 커밋먼트에 증명이 묶여 있음을 보여 주고, “커밋된 바로 그 모델”임을 확인해요 | 커밋먼트가 특정 상용 모델 이름의 모델과 일치하는지는 증명할 수 없어요. 별도로 커밋먼트를 공개해야 해요 |
| 출력 정확성 | 검사한 토큰이 정수화된 모델의 그리디 디코딩 결과임을 증명해요 | 부동소수점 구현과 무작위 샘플링(temperature가 0보다 큰 경우)의 출력은 직접 다루지 않아요 |
| 프라이버시 보호 | 증명 자체는 가중치를 유출하지 않아요 | 모델 아키텍처는 숨기지 못해요. 생성 소요 시간 같은 사이드 채널 공격은 범위 밖이에요 |
| 컨텍스트 길이 | 최대 1024 토큰의 컨텍스트를 지원해요 | 채팅 환경에서 흔한 수십만~수백만 토큰에 비하면 훨씬 짧아요 |
| 보호 시점 | 사후에 무결성 문제를 탐지해요 | 변조된 답변이 사용자에게 먼저 전달되는 것은 막지 못해요 |
| 모델 아키텍처 | MoE 모델에 적용할 수 있어요 | 밀집(dense) 모델 등 다른 아키텍처는 추가 연구가 필요해요 |
FlashProve 사후 증명의 탐지 한계
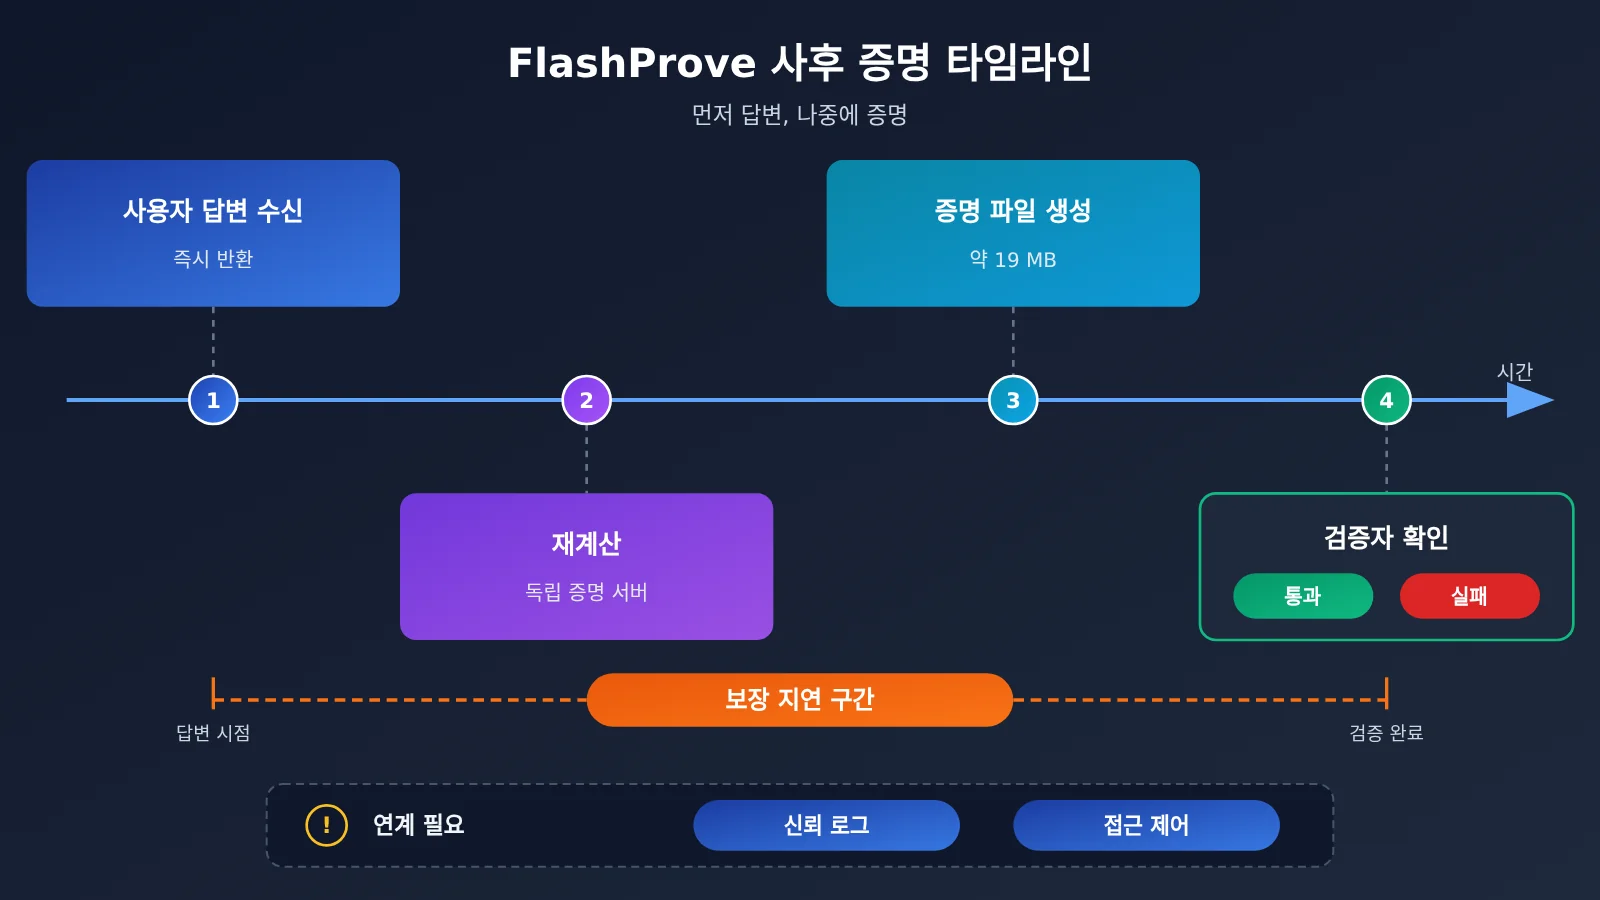
FlashProve는 사후 증명(Post-hoc Proving) 방식을 써요. 사용자가 먼저 응답을 받으면, 독립된 증명 서버가 다시 계산해서 증명을 만들고, 마지막으로 검증자가 그 증명을 확인해요. 이 방식은 증명이 조금 느려도 괜찮은 대신, 보안과 효율 사이에서 타협하지 않아도 돼요. 다만 그만큼 보장이 늦게 도착해요. 증명이 실패하면 문제가 있었다는 사실만 드러날 뿐, 사용자가 답변을 받기 전에 미리 보호해 주지는 못해요.
기술 보고서는 다음 경고도 덧붙여요. 로그 시스템 자체를 공격자가 장악하면, 사용자에게는 변조된 내용을 보내면서 로그에는 올바른 결과만 기록하게 만들 수 있어요. 그래서 FlashProve는 신뢰할 수 있는 로그, 접근 제어 같은 다른 보안 수단과 함께 써야 해요.
FlashProve 형식 검증의 미완성 부분
“Lean으로 형식 증명을 했다”는 말은 “시스템 전체가 올바르다고 증명됐다”로 오해하기 쉬워요. 하지만 실제로는 그렇지 않아요. 기술 보고서가 밝힌 한계는 다음과 같아요.
- Lean으로 증명한 영지식(zero-knowledge) 성질은 현재 단일 요청 증명만 다루고, 배치 증명은 아직 다루지 않아요.
- GPU 증명 측 코드는 AI가 Lean 표현을 바탕으로 생성했고, Lean 표현과 동등한지는 아직 증명되지 않았어요.
- 평소에 쓰는 C++ 고속 검증 측도 AI가 생성했어요. 형식적 보장은 없고, 테스트에서 Lean 검증 측과 결론이 모두 일치했다는 것뿐이에요.
- 분량이 긴 프로토콜 명세 문서는 AI가 생성했고 저자가 자세히 검토하지 않았어요. 저자가 직접 쓴 기술 보고서와는 구분해서 봐야 해요.
이런 한계가 연구가 무효라는 뜻은 아니에요. 지금의 형식 검증은 프로토콜 계층의 수학적 성질을 대상으로 하고, 실행 코드와 프로토콜 사이의 간극은 사람이나 에이전트의 감사로 메워야 한다는 뜻이에요.
영향 분석: FlashProve, 서드파티 API 일상 호출까지 얼마나 남았을까
개발자와 API 사용자에게 미치는 영향
- 당분간 일상적인 호출 경로에는 등장하지 않아요: GPU 오버헤드가 약 100배(두 자릿수 차이) 수준이고, 요청당 증명 파일이 약 19 MB이며, 컨텍스트 상한이 1024 토큰이라 빈번하게 호출하는 대화형 API에는 그대로 적용하기 어려워요.
- 적용 범위가 제한적이에요: 이 시스템은 MoE 아키텍처, 정수화된 모델, 그리디 디코딩을 전제로 해요. 대부분의 실제 서비스는 확률적 샘플링과 부동소수점 추론을 쓰기 때문에 그대로 가져다 쓸 수 없어요.
- 인식 측면의 가치가 더 커요: “모델 신원 검증”을 불가능한 일에서 엔지니어링 문제로 바꿔 놓은 첫 사례예요. 응답에 담긴 모델 이름 필드, 모델 ID, 일반적인 요청 로그는 암호학적 증명과 같지 않다는 점을 개발자도 알아 둘 필요가 있어요.
💡 선택 가이드: 증명 가능한 추론 기술이 성숙하기 전까지는 서드파티 서비스를 고를 때 과금 투명성, 호출 로그의 추적 가능성, 직접 해 보는 일관성 테스트 결과를 더 눈여겨보는 게 좋아요. APIYI(apiyi.com) 같은 통합 플랫폼으로 호출하면 여러 모델에 동시에 요청을 보내고 전체 호출 기록을 남길 수 있어서, 직접 교차 비교와 감사를 하기에 편해요.
업계와 규제에 미치는 영향
- 평가·컴플라이언스 도구가 하나 더 늘었어요: 규제 기관은 제공자에게 일정 기간의 추론 요청에 증명을 첨부하도록 요구할 수 있어요. 이렇게 하면 독점 가중치를 공개하지 않고도 하드웨어가 지정된 모델을 실제로 서비스하고 있는지 확인할 수 있어요. 다만 Anthropic도 인정했듯이, 하드웨어가 한편에서 몰래 학습을 돌리고 있지 않다는 점까지는 증명할 수 없어요.
- 소프트웨어 방식과 신뢰 하드웨어는 서로 보완해요: 신뢰 실행 환경(TEE)은 제조사의 변조 방지 하드웨어에 의존하고, zkSNARK는 계산 난제의 어려움에 의존해요. 하드웨어와 운영체제가 뚫려도 증명을 위조할 수 없다는 점이 zkSNARK의 강점이라, 두 방식은 각기 다른 상황에서 제 역할을 하게 될 거예요.
- Anthropic의 프로덕션 검증은 다른 길을 택했어요: Anthropic은 2026년 10월 19일에 업데이트한 Frontier Safety Roadmap에서, 추론 검증 프로젝트가 이미 실제 프로덕션 추론 트래픽을 대상으로 프로토타입을 구축했다고 밝혔어요. 내부 토큰 트래픽에 서명을 적용하고 신뢰할 수 있는 서버에서 추론을 다시 계산하는 방식이며, 악의는 없지만 극히 드문 무결성 이상 사례를 한 번 포착하기도 했어요. 이 프로젝트의 이름은 inference verification으로 바뀌었고, FlashProve와는 관련은 있지만 별개의 프로젝트예요. 둘을 같은 것으로 혼동하면 안 돼요.
서드파티 API 호출자가 지금 할 수 있는 일: 직접 호출 감사 기록 만들기
암호학적 증명은 아직 현실적으로 쓰기 어려우니, 개발자가 먼저 할 수 있는 건 “추적 가능성”을 확실히 챙기는 거예요. 아래 예제는 호출할 때 temperature=0으로 고정하고, 요청 시간, 요청 ID, 응답에 담긴 모델 필드, 답변 해시를 로컬 로그에 기록해요. 나중에 일관성을 다시 테스트할 때 도움이 되죠. 다만 이건 어디까지나 엔지니어링 차원의 감사 기록일 뿐, 모델 신원에 대한 암호학적 증명은 아니라는 점을 꼭 강조하고 싶어요.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 인터페이스
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "用一句话解释零知识证明"}],
    temperature=0
)
print(resp.model, resp.id)
print(resp.choices[0].message.content)
전체 감사 로그 구현 코드 보기
import hashlib
import json
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 키 하나로 여러 모델 호출
)

def audited_call(prompt: str, model: str, log_path: str = "audit.jsonl") -> str:
    """모델을 호출하고 추적 가능한 정보를 기록합니다(암호학적 증명 아님)"""
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        temperature=0,
        max_tokens=512,
    )
    content = resp.choices[0].message.content or ""
    record = {
        "ts": int(start),
        "latency_s": round(time.time() - start, 3),
        "requested_model": model,
        "returned_model": resp.model,   # 서버가 반환한 선언 필드일 뿐임
        "request_id": resp.id,
        "prompt_sha256": hashlib.sha256(prompt.encode()).hexdigest(),
        "output_sha256": hashlib.sha256(content.encode()).hexdigest(),
        "usage": resp.usage.model_dump() if resp.usage else None,
    }
    with open(log_path, "a", encoding="utf-8") as f:
        f.write(json.dumps(record, ensure_ascii=False) + "\n")
    return content

# 프로브 프롬프트를 고정해 두고, 주기적으로 재테스트하며 출력 해시와 지연 시간 분포를 비교
probes = ["计算 37*43 并只输出结果", "列出三种排序算法的时间复杂度"]
for p in probes:
    for m in ["gpt-4o-mini", "claude-sonnet-4-5"]:
        print(m, audited_call(p, m)[:60])
🚀 빠르게 시작하기: APIYI(apiyi.com)에서 무료 테스트 크레딧을 받아, 위의 프로브 스크립트로 여러 모델을 주기적으로 재테스트해 보세요. 다만 이런 방법은 추적 가능성을 높여 줄 뿐, FlashProve 같은 가중치 수준의 증명을 대체할 수는 없어요.
여기에 몇 가지 실용적인 방법을 더해 볼 수 있어요. 모호한 별칭 대신 모델 ID를 고정해서 쓰고, 프로브 프롬프트 세트를 두고 출력과 지연 시간 변화를 장기적으로 추적하세요. 핵심 업무라면 여러 모델에 동시에 요청해서 교차 검증하는 것도 좋아요. 그리고 서비스 제공자가 가중치 관련 약속이나 검증 가능한 메커니즘을 공개하는지도 계속 지켜보세요.
자주 묻는 질문 FAQ
Q1: FlashProve가 무엇인가요?
FlashProve는 Anthropic이 2026년 11월에 오픈소스로 공개한, 증명 가능한 추론(provable inference)을 다루는 연구 프로토타입이에요. zkSNARK를 기반으로 하며, 모델 제공자가 먼저 가중치에 대한 커밋먼트(commitment)를 만들고 추론 결과에 대한 증명을 생성해요. 사용자는 가중치 없이 CPU만으로 답변이 커밋된 모델에서 나온 것인지 검증할 수 있어요.
Q2: FlashProve와 Anthropic의 추론 검증(inference verification) 프로젝트는 어떻게 다른가요?
두 프로젝트는 목표가 비슷하지만 구현 방식이 달라요. 추론 검증 프로젝트는 실제 프로덕션 트래픽에서 프로토타입을 구축했고, 서명된 내부 토큰 트래픽을 신뢰할 수 있는 서버에서 다시 계산하는 방식을 써요. 반면 FlashProve는 순수 소프트웨어 기반의 암호학적 증명 방식이고 아직 연구 프로토타입 단계예요. 두 프로젝트를 같은 것으로 보면 안 돼요.
Q3: FlashProve의 110 tokens/s는 전체 답변을 실시간으로 증명할 수 있다는 뜻인가요?
아니에요. 110 tokens/s는 배치 처리 시 윈도우 처리 처리량이고, 증명 하나당 토큰 하나만 검사해요. 답변의 모든 토큰을 검사하면 처리량은 39.1 tokens/s이고, 단일 요청 증명은 17.6 tokens/s까지 떨어져요. 게다가 전체 과정이 사후 증명 방식이에요.
Q4: APIYI는 모든 응답에 FlashProve 증명을 제공하나요?
아니에요. 현재 APIYI(apiyi.com)가 FlashProve를 도입했거나 가중치 수준의 암호학적 증명을 제공한다고 확인할 수 있는 자료는 없어요. 플랫폼이 반환하는 모델 이름과 호출 로그도 암호학적 증명과 같지 않아요. 현 단계에서는 플랫폼의 통합 인터페이스와 호출 기록을 활용해 직접 재테스트하고 교차 비교하는 편이 현실적이에요.
Q5: API로 여러 모델의 일관성 테스트를 빠르게 하려면 어떻게 하나요?
여러 모델을 지원하는 통합 플랫폼을 쓰는 것을 추천해요.
1. APIYI(apiyi.com)에서 계정을 만들고 API 키와 무료 테스트 크레딧을 받아요
2. 이 글의 코드에서 base_url을 `https://api.apiyi.com/v1`로 설정해요
3. `temperature=0`으로 고정하고, 탐지용 프롬프트로 주기적으로 재테스트하면서 출력 해시를 기록해요
이 방법은 이상 변동을 찾아내는 데 도움이 되지만, 엔지니어링 차원의 감사일 뿐 모델 신원을 증명하는 방법은 아니에요.
Q6: FlashProve에는 어떤 한계가 있나요?
주요 한계는 다음과 같아요. GPU 오버헤드가 일반 추론의 약 70~95배예요. 컨텍스트 길이는 최대 1024토큰이에요. MoE 아키텍처, 정수화된 모델, 그리디 디코딩에 의존해요. 모델 아키텍처를 숨기지 않으며, 사이드 채널 공격은 범위에 포함되지 않아요. 사후 증명이라 변조된 내용이 먼저 사용자에게 전달되는 것을 막을 수 없어요. 마지막으로 실행 가능한 코드와 Lean 프로토콜 사이의 형식적 동치 증명도 아직 없어요.
FlashProve 핵심 요약 Key Takeaways
- 신뢰 격차는 실제로 존재해요: 서드파티 API를 호출할 때 답변 품질이 좋다고 해서 모델의 신원이 진짜라는 증거가 되지는 않아요.
- 핵심 메커니즘: 오프라인 가중치 커밋먼트와 온라인 zkSNARK 증명을 결합했어요. 사용자는 CPU만으로 검증할 수 있어요.
- 비용이 크게 줄었어요: H100 한 장 기준 윈도우 처리량은 약 110 tokens/s, 증명 크기는 약 19 MB, 검증 시간은 약 17초예요.
- 측정 기준을 구분해야 해요: 토큰별 검사 처리량은 39.1 tokens/s이고, 단일 요청은 17.6 tokens/s에 불과해요.
- 적용 범위가 명확해요: MoE, 정수화된 그리디 디코딩, 1024 토큰 컨텍스트, 사후 검출로 한정돼요.
- 시작하는 방법: 지금은 APIYI(apiyi.com)의 멀티 모델 통합 인터페이스를 활용해 직접 재검증하고 감사해 볼 수 있어요.
정리
FlashProve의 핵심 의의는 세 가지로 요약할 수 있어요.
- 모델 신원 검증을 엔지니어링 문제로 바꿨어요: 이전에는 동일한 모델임을 증명하는 데 십수 시간과 100GB에 가까운 증명이 필요했어요. 이제는 배치 처리 기준 수백 tokens/s 수준과 19 MB 증명으로 줄었어요.
- 프로덕션에서 쓰기에는 아직 거리가 있어요: 두 자릿수 배(두 자릿수 오더)의 오버헤드, 짧은 컨텍스트, 아키텍처와 디코딩 방식의 제약, 그리고 형식 검증이 완전히 커버되지 않는다는 점 때문에 아직은 연구 프로토타입이에요.
- 다른 보안 메커니즘과 함께 써야 해요: 사후 증명은 검출만 할 수 있을 뿐 차단하지는 못해요. 그래서 신뢰할 수 있는 로그와 접근 제어를 반드시 함께 갖춰야 해요.
오늘날 서드파티 API를 쓰는 사용자에게 가장 현실적인 자세는 이래요. 모델 이름 필드를 증명으로 믿어서는 안 되지만, 그렇다고 지나치게 불안해할 필요도 없어요. 먼저 호출 기록, 프로브 재검증, 멀티 모델 교차 검증을 탄탄하게 갖추고, 증명 가능한 추론 기술이 얼마나 성숙해지는지 계속 지켜보면 돼요. APIYI(apiyi.com)를 통해 키 하나로 여러 모델을 비교하면서, 자신의 업무 데이터를 기준으로 추적 가능한 품질 기준선을 만들어 보세요.
📚 참고 자료
- Anthropic 연구 블로그 – Progress on provable inference for large language models: FlashProve 원문 발표 글
- 링크:
anthropic.com/research/provable-inference -
설명: 시스템 설계, 실측 데이터, 기존 방식과의 비교, 한계점 설명이 담겨 있어요
-
FlashProve 기술 보고서: 연구 블로그에 함께 공개된 전체 기술 세부 내용
- 링크:
anthropic.com/research/provable-inference(페이지 내 Read the technical report 버튼) -
설명: 처리량 산정 기준, 사후 증명의 한계, 형식 검증의 범위 등 핵심 제약 조건이 정리되어 있어요
-
Anthropic Frontier Safety Roadmap: 추론 검증 프로젝트의 진행 상황 안내
- 링크:
anthropic.com - 설명: inference verification과 FlashProve의 차이를 이해하는 데 도움이 돼요
작성자: APIYI 기술팀
기술 교류: APIYI 공식 홈페이지에서 언제든 문의해 주세요. 더 많은 연동 자료는 docs.apiyi.com 문서 센터에서 확인하실 수 있어요