作者注:通过第三方 API 调用大規模言語モデルを使う場合、回答の品質だけでは、実際にどのモデルが動いているのかを確認できません。本記事では、Anthropic がオープンソース化した FlashProve を取り上げます。zkSNARK を使って推論結果を指定した重みに結びつける仕組み、そのコスト、証明できること・できないこと、そして日常的な API 呼び出しに使えるようになるまでの距離を解説します。
2026 年 11 月 2 日、Anthropic Frontier Red Team は EPFL や MIT などの研究者と共同で、FlashProve:大規模言語モデル向けのオープンソースの検証可能推論(Provable Inference)プロトタイプを公開しました。400B パラメータの Llama 4 Maverick では、H100 1 枚で証明を生成でき、証明 1 件あたりのサイズは約 19 MB、通常の CPU で十数秒あれば検証できます。
これはコンセプトデモでも、スライド上だけの製品でもありません。Anthropic は技術レポート、プロトコル仕様書、実行可能な証明側(Prover)のコード、2 種類の検証側(Verifier)のコード、そして Lean による形式証明を同時に公開しており、すべて Apache 2.0 ライセンスのオープンソースです。ただし Anthropic 自身も、これはあくまで研究の途中経過であり、最終的な研究目標まではまだ道のりがあると明言しています。
この記事で得られること:第三方 API 呼び出しで「モデルの身元」を確認するのがなぜ難しいのか、FlashProve がどんな仕組みでそれを解決するのか、実際のコストと限界はどこにあるのか、そして API 利用者として今できることを整理します。
サードパーティAPIでモデルの身元が信頼できない理由
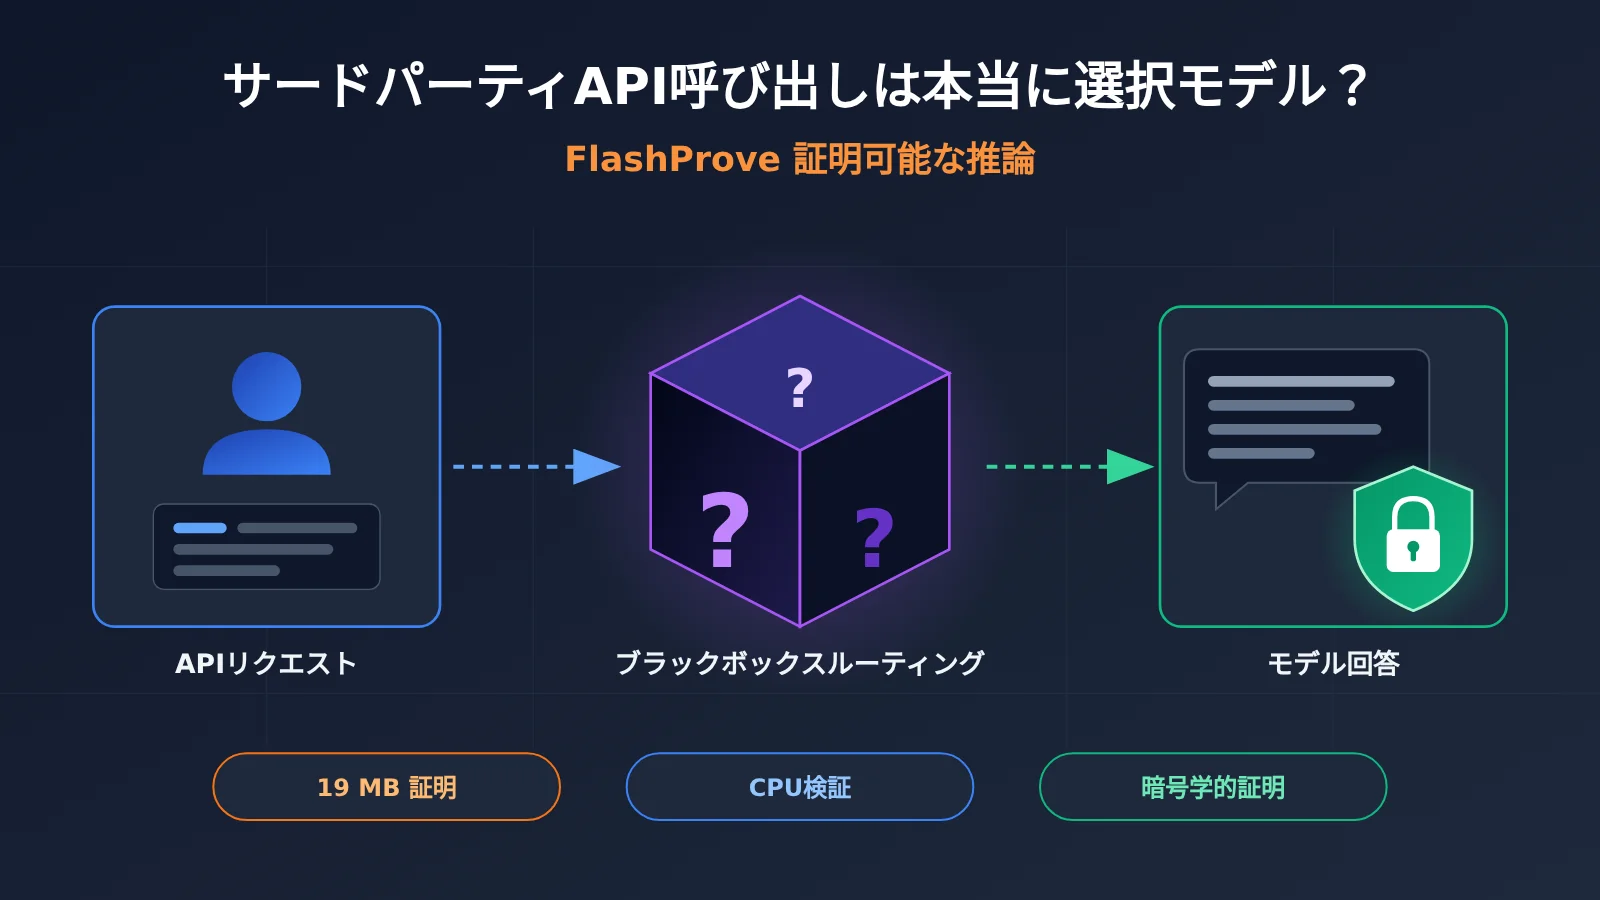
どのAPIにリクエストを送っても、返ってくるのはテキストとモデル名のフィールドだけです。Anthropicはリサーチブログで、今のユーザーには「回答が開発者の言うモデルから本当に返ってきたのか」を確認する手段がない、とはっきり述べています。ルーティングサービスがコスト削減のためにこっそりモデルをすり替えたり、攻撃者がトークンストリームを改ざんしたりする可能性があるためです。
さらに重要なのは、出力の品質が高いことは、モデルの身元が本物であることの証明にならないという点です。安価なモデルでも、特定の質問にはとてもよく答えることがあります。ダウングレードされたバージョンを、目で見て見分けられるとも限りません。チャット履歴を丸ごと公開したとしても、理論上はより安いモデルで偽造できてしまうので、そうした証拠には決定的な証明力がありません。
根本的な検証も簡単ではありません。最先端モデルのウェイトはほとんど公開されていません。仮にウェイトを入手できたとしても、推論をもう一度計算し直すのに必要な計算資源は、一般ユーザーはもちろん、評価機関にとっても負担できない規模です。Anthropicは、この種の信頼問題が生じる代表的なシナリオを次のように整理しています。
- サードパーティのルーティングサービス:顧客は、受け取ったトークンが、自分が料金を払って選んだモデルのものであることを確認したいと考えます。
- 独立評価:評価機関は、リリース前後にテストしたモデルが、実際にオンラインで提供されているモデルと同一であることを確認する必要があります。
- 改ざん検知:推論サーバーが侵害されると、攻撃者が悪意のある回答を紛れ込ませたり、ユーザーのコンピューターにマルウェアを送り込んだりするおそれがあります。
- 規制とコンプライアンス:規制当局は、安全審査を通過したモデルだけをデプロイするよう求めたり、ハードウェアが密かに学習ではなく本当に推論を実行していることの確認を求めたりする可能性があります。
証明可能な推論(Provable Inference)が目指すのは、計算資源が限られていて、ウェイトも知らないユーザーでも、ある回答が本当にリクエストしたモデルから返ってきたものかどうかを検証できるようにすることです。
FlashProve コア情報 早見表
| 項目 | 詳細 |
|---|---|
| 公開日 | 2026年11月2日 |
| 公開元 | Anthropic Frontier Red Team(EPFL、MIT、StarkWare、Succinct などの研究機関の研究者と共同) |
| 中核技術 | zkSNARK(ゼロ知識簡潔知識引数)。ハッシュ関数ベースの構成で、ポスト量子安全性を備える |
| 検証対象モデル | Llama 4 Maverick。400B パラメータの MoE で、トークンあたり約 17B パラメータを活性化。4-bit 量子化重みを公開 |
| 公開内容 | 研究ブログ、技術レポート、Claude が執筆したプロトコル仕様、証明側および C++/Lean のデュアル検証側コード、Lean 証明と可視化ツール |
| オープンソースライセンス | Apache 2.0 |
| 現在の位置づけ | 研究プロトタイプ。段階的な進捗を共有するもので、外部からの改善を歓迎 |
特筆すべき点として、Anthropic はシステム内の最適化作業の多くを Claude が担ったと述べています。AI が大規模で複雑なシステムの中で下す「評価が難しい意思決定」に対処するため、チームは Lean で監査可能なトップレベルの安全宣言を記述し、その対抗策としました。
FlashProveが「指定モデルによる推論」を証明する仕組み
FlashProveの登場人物は2人だけです。モデル提供者が証明者(Prover)、ユーザーが検証者(Verifier)を務めます。全体の流れはオフラインとオンラインの2段階で、そこに検証側のチェックが加わります。
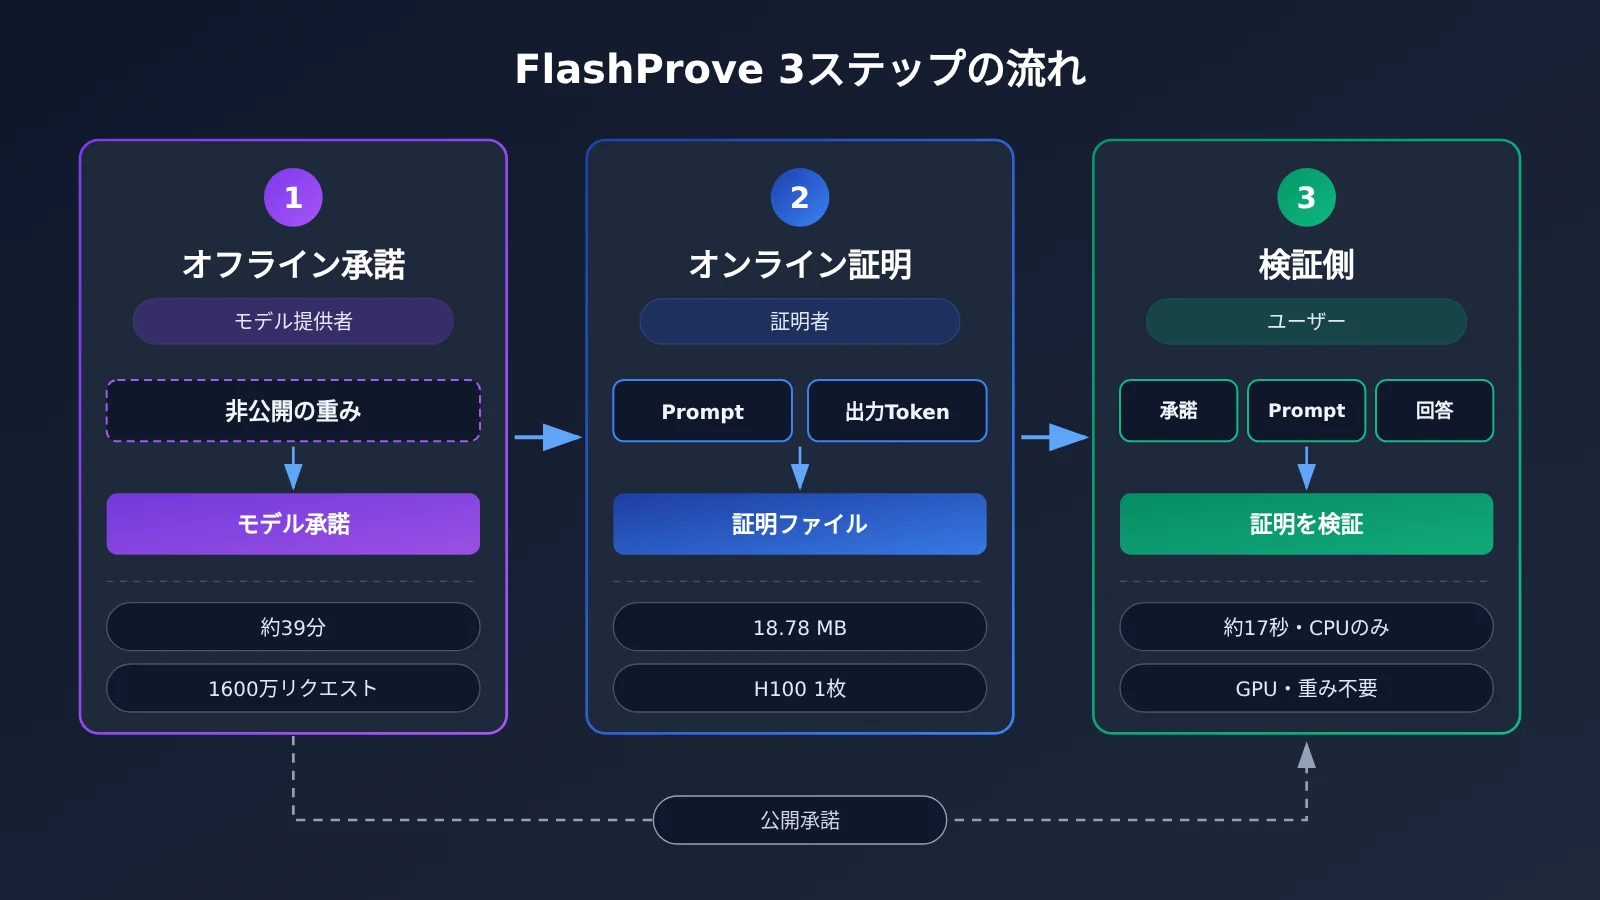
FlashProveの3ステップの仕組み
- オフラインでのモデルコミットメント(Model Commitment):証明者は、モデルの重みに対するコミットメントを公開します。ごく短い「フィンガープリント」のようなものだと考えてください。これにより、特定の重みの組み合わせが確定しますが、重みそのものは隠されたままです。テストでは、この処理はモデルごとに1回だけ実行すれば済み、所要時間は約39分でした。生成されたコミットメントは約1600万リクエストを支えられ、それを超えたら再度コミットメントが必要になります。
- オンラインでの証明生成:検証者からリクエスト(プロンプトと対応する出力トークン)を受け取ると、証明者は証明ファイルを生成します。この証明が示すのは「コミットされたモデルを実行すると、これらの出力トークンが生成される」という命題です。
- 検証側でのチェック:コミットメント、プロンプト、回答を持っていれば、誰でも証明をチェックできます。重みは必要なく、必要な計算資源もわずかです。それでも、コミットされた重みがこのプロンプトに対して確かにそれらのトークンを生成したと確信できます。
FlashProveの4つのセキュリティ特性
最初の2つ(完全性と健全性)は、重みを知っていて計算資源も十分にある検証者なら、自分で再計算すれば実現できます。このシステムを意味あるものにしているのは、後半の2つです。
- 完全性(Completeness):正直な証明者が生成した証明は、必ず受理されます。
- 健全性(Soundness):虚偽の命題に対して有効な証明を偽造するのは、広く信頼されている暗号学的仮定を破るのと同じくらい困難です。そのため、検証者は証明者を信頼する必要がありません。
- ゼロ知識(Zero Knowledge):検証者は、重みや中間計算値を知ることができず、各層でどのエキスパートが活性化したかも分かりません。ただし、モデルのアーキテクチャ自体は秘匿されません。
- 簡潔性(Succinctness):証明の対象は約232 GBの量子化モデルによる1回の実行ですが、検証者が受け取るのは約19 MBのファイルだけです。24コアCPUなら数秒でチェックできます。
MoEアーキテクチャがFlashProveの証明コストを下げる理由
FlashProveの高速化は、MoE(Mixture of Experts、混合エキスパートモデル)の構造を大いに活用しています。Llama 4 Maverickでは、1トークンあたり400Bパラメータのうち約17Bしか使われません。証明者の作業量もこの約17Bに比例し、それでいて、どのエキスパートが選ばれたかは証明の中でも隠されたままです。
ほかに、2つの工夫も重要です。1つ目は事後バッチ証明です。証明者は、Prefillのように生成済みのテキストを一度に並列で読み込み、バッチごとに重みのコミットメントを1回だけ開きます。2つ目は単一GPUへの対応です。重みをレイヤーごとに分割して順番に証明し、通常のメモリからストリーミングで読み込みます。これにより、80 GBのGPU 1枚と約290 GBのホストメモリで動作します。
FlashProve の証明コスト実測データ
可証明推論(Provable Inference)が実用に耐えるかどうかを判断するうえで、コストは最も重要な指標です。Anthropic のテスト環境は次のとおりです。証明側は H100 1枚と CPU 24コア、検証側は CPU のみ、各リクエストは 1024 トークンのウィンドウです。
| 工程 | 指標 | 実測値 |
|---|---|---|
| オフラインコミットメント | 所要時間 / 有効期間 | 約 39 分 / 約 1,600 万リクエスト |
| オンライン証明 | 24 リクエスト 1 バッチの所要時間 | 約 223 秒 |
| オンライン証明 | 処理スループット | 約 110 tokens/s |
| 証明ファイル | 1 件あたりのサイズ | 18.78 MB |
| 検証側のダウンロード | 重みコミットメントのサイズ | 約 6.5 MB |
| 検証時間 | 24 スレッド / シングルスレッド | 17 秒 / 21 秒(オフライン段階のチェックを含む) |
| vLLM との比較 | 単一 GPU 時間の倍率 | 約 72 倍(66〜77 倍)、最大負荷時は約 94 倍 |
比較のベースラインは、H100 を 8 枚使い、vLLM で同じモデルの FP8 版を動かした場合です。言い換えると、1 バッチ分のリクエストを証明するのにかかる GPU 時間は、通常の推論で同じバッチを処理する場合の 70〜95 倍、つまり約 2 桁分のオーバーヘッドがかかることになります。
110 tokens/s は「回答全体をリアルタイムで証明できる」という意味ではない
FlashProve を読み解くうえで、ここは特に誤解されやすいポイントです。技術レポートでは、各証明が実際にチェックするのはプロンプトの後ろにある1 トークンだけだと明記されています。110 tokens/s は、証明側がリクエストのウィンドウを処理するスループットであり、回答全体をトークンごとに検証する速度ではありません。
| 算出基準 | スループット | 説明 |
|---|---|---|
| 24 リクエストのバッチ処理、ウィンドウ処理量で計算 | 約 110 tokens/s | ブログのタイトルに載るような数字。各証明で 1 トークンをチェック |
| 回答中のすべてのトークンをチェック、チェック済みトークンで計算 | 39.1 tokens/s | 「回答全体を検証する」場面により近い |
| 1 リクエストを単独で証明 | 17.6 tokens/s | 1 件の証明に約 58 秒かかり、バッチ処理の利点が失われる |
したがって、「FlashProve はすでに回答全体をリアルタイムで証明できる」という言い方は正確ではありません。より厳密に言うなら、バッチ処理・短いコンテキスト・事後証明という条件のもとで、可証明推論のコストをこれまで想像できなかった水準まで引き下げた、ということになります。
FlashProve と既存の検証可能推論方式の比較
検証可能推論(provable inference)は、学術界では一般に zkML と呼ばれています。Anthropic はブログでこれまでの進展を振り返っており、数値を並べると違いがよくわかります。
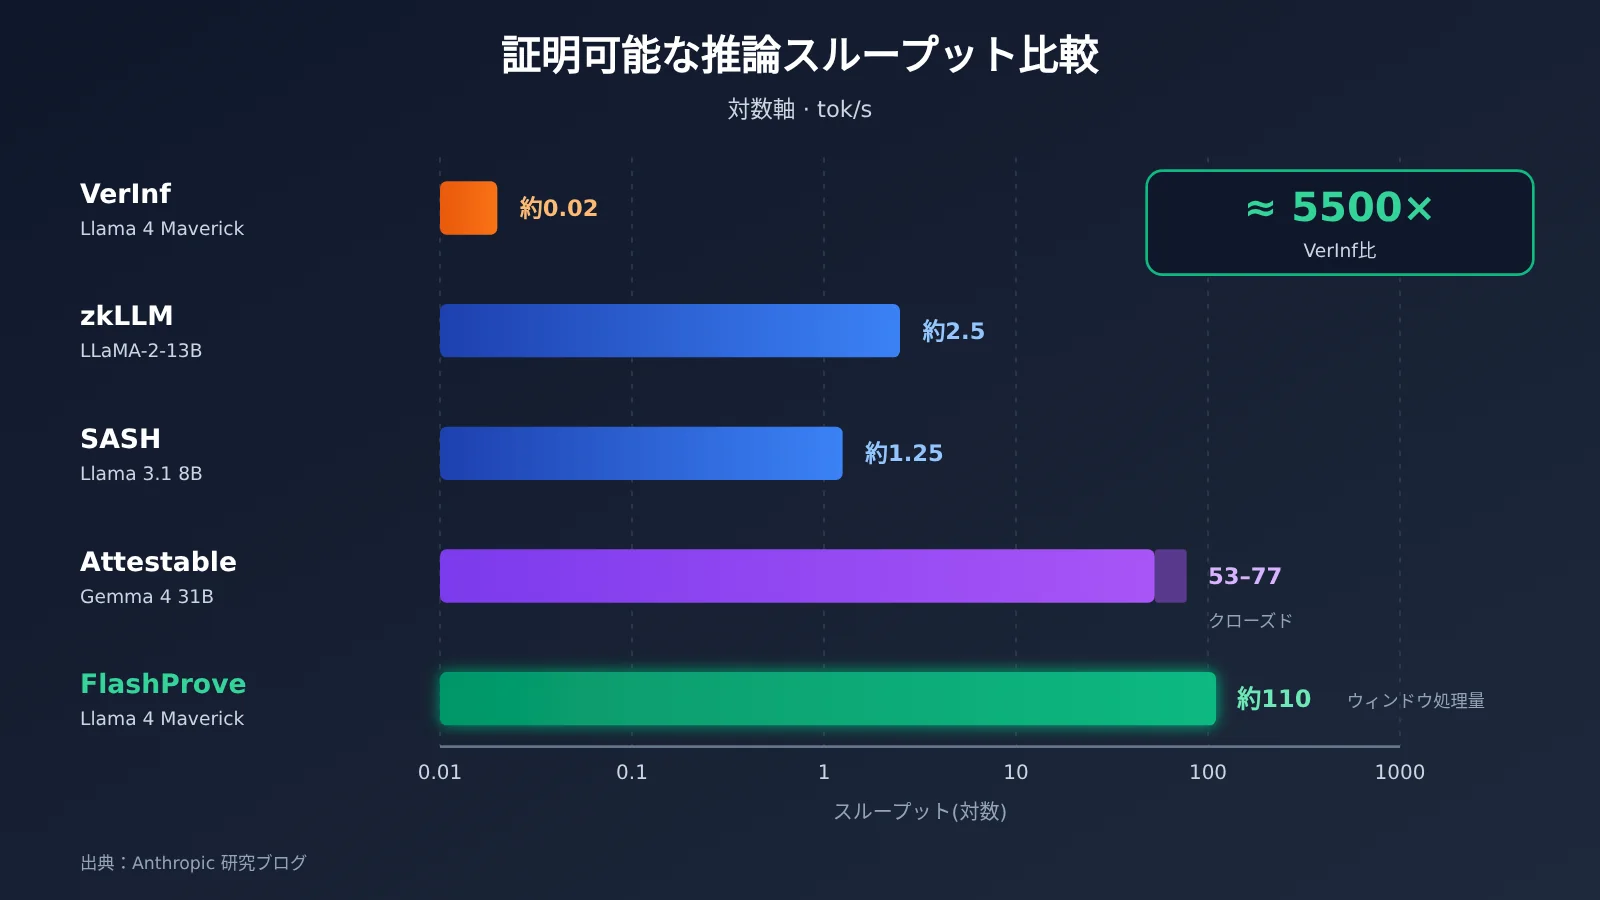
| 方式 | 証明対象 | スループット / 所要時間 | 備考 |
|---|---|---|---|
| VerInf | Llama 4 Maverick(400B MoE) | 約 0.02 tok/s、1000 トークンに 14.3 時間 | 証明サイズ 93.6 GB、検証にほぼ丸一日 |
| zkLLM(2024) | LLaMA-2-13B | バッチ処理で約 2.5 tok/s | A100 1 枚 |
| SASH(2026) | Llama 3.1 8B | 約 1.25 tok/s | H100 1 枚 |
| Attestable | Gemma 4 31B(Dense モデル) | 53〜77 tok/s | 商用方式、現時点では非公開 |
| FlashProve | Llama 4 Maverick(400B MoE) | 約 110 tok/s | 証明サイズ約 19 MB、数秒で検証可能、オープンソース |
VerInf との比較:VerInf は、これまでに同じモデルの証明を実現した唯一の方式として知られています。ただし証明サイズは 93.6 GB にもなり、検証にはほぼ丸一日かかるため、実用はほぼ不可能でした。これに対して FlashProve は、証明サイズを約 19 MB まで圧縮し、検証時間も十数秒まで短縮しています。一般的な CPU でも第三者による監査が現実的になったのは、これが初めてです。
Attestable との比較:Attestable は Dense モデルで商用レベルの優れた数値を出していますが、ブログ執筆時点では対応するオープンソースライブラリが公開されていません。FlashProve の強みは、コード・Lean の証明・ドキュメントがすべて公開されており、誰でも再現や改良ができる点です。その代わり、現状は MoE アーキテクチャへの依存度が高いという制約があります。
FlashProve が証明できること、できないこと
サードパーティAPIのユーザーにとって、できることと同じくらい、その限界を理解しておくことも大切です。下の表は、研究ブログと技術レポートに書かれている主な制約をまとめたものです。
| 観点 | FlashProve にできること | FlashProve に現状できないこと |
|---|---|---|
| モデルの身元 | 具体的な重みのコミットメントに紐づけて証明し、「コミットされたそのモデル」であることを確認できる | コミットメントが特定の商用名のモデルに対応していることまでは証明できない。別途、公開コミットメントが必要 |
| 出力の正しさ | 検査対象のトークンが、整数化モデルによる貪欲デコーディングの結果であることを証明できる | 浮動小数点による実装や、ランダムサンプリング(temperature が 0 より大きい場合)の出力は直接の対象外 |
| プライバシー保護 | 証明そのものから重みが漏れない | モデルアーキテクチャは隠せない。生成時間などのサイドチャネル攻撃も対象外 |
| コンテキスト長 | 最長 1024 トークンのコンテキストに対応 | チャットでよく使われる数十万〜100万トークン超には遠く及ばない |
| 防御のタイミング | 事後に完全性の問題を検出できる | 改ざんされた回答が先にユーザーへ届くのを防ぐことはできない |
| モデルアーキテクチャ | MoE モデルに対応 | 密(Dense)モデルなどほかのアーキテクチャは今後の研究課題 |
FlashProve の事後証明が抱える検出の限界
FlashProve が採用しているのは事後証明(Post-hoc Proving)です。ユーザーが先にレスポンスを受け取り、そのあとで独立した証明サーバーが再計算して証明を生成し、最後に検証者がそれをチェックします。この方式では証明にある程度時間をかけられるため、安全性と効率のどちらかを犠牲にせずに済みます。一方で、保証が得られるまでに遅延が生じます。証明の失敗は問題を明らかにするだけで、ユーザーが回答を受け取る前に守ってくれるわけではありません。
技術レポートでは、次の点にも注意が促されています。ログシステム自体を攻撃者が掌握している場合、ユーザーには改ざんした内容を送りつつ、ログには正しい結果だけを記録させることが可能になります。そのため、FlashProve は信頼できるログやアクセス制御などのセキュリティ対策と組み合わせて使う必要があります。
FlashProve の形式検証で未完了の部分
「Lean で形式的に証明した」と聞くと、「システム全体の正しさが証明された」と受け取りがちですが、実際はそうではありません。技術レポートに挙げられている範囲の限界は次のとおりです。
- ゼロ知識性に関する Lean での証明は、現時点では単一リクエストの証明のみが対象で、バッチ証明には及んでいません。
- GPU 側の証明器のコードは、Lean での表現をもとに AI が生成したもので、Lean の表現と等価であることはまだ証明されていません。
- 日常的に使う C++ の高速検証器も AI が生成したもので、形式的な保証はありません。テストで Lean 側の検証器とすべて同じ結論になったという段階です。
- 長めのプロトコル仕様書は AI が生成したもので、著者が詳しく確認したわけではありません。著者自身が書いた技術レポートとは分けて読む必要があります。
これらの制約があるからといって、研究に意味がないわけではありません。現時点の形式検証が押さえているのはプロトコル層の数学的性質であり、実行されるコードとプロトコルのあいだは、人間やエージェントによる監査で埋める必要がある、ということです。
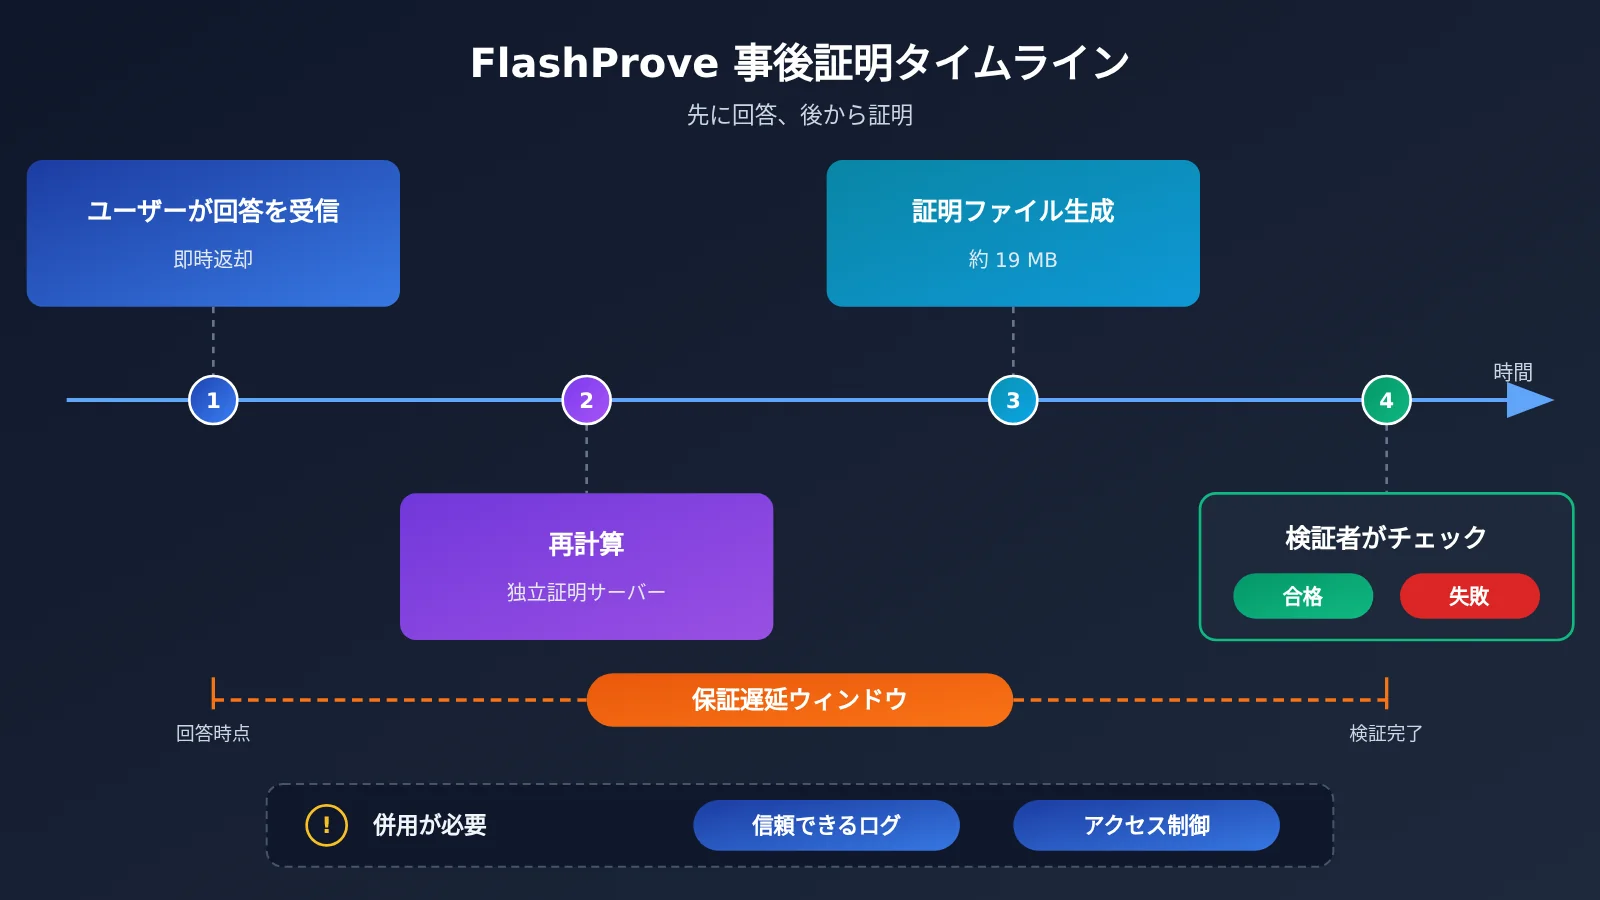
影響分析:FlashProve はサードパーティAPIの日常的な呼び出しにどこまで近づいたのか
開発者・API利用者への影響
- 当面は日常的な呼び出しフローには登場しません:GPUのオーバーヘッドが約2桁も増えること、リクエストごとに約19 MBの証明ファイルが必要になること、コンテキストウィンドウが1024トークンに限られることから、頻度の高い対話型APIにそのまま使うのは困難です。
- 適用範囲が限られます:このシステムはMoEアーキテクチャ、整数化されたモデル、貪欲デコーディングを前提としています。一方、本番環境の呼び出しの多くはランダムサンプリングと浮動小数点推論を使っているため、そのまま適用することはできません。
- 認識面での価値のほうが大きいといえます:「モデルの身元を検証する」ことが、不可能な話から工学的に取り組める課題へと初めて変わりました。レスポンスに含まれるモデル名のフィールド、モデルID、通常のリクエストログは、いずれも暗号学的な証明と同じものではない点に、開発者は注意しておく必要があります。
💡 選び方のヒント:証明可能な推論が成熟するまでは、サードパーティのサービスを選ぶ際に、課金の透明性、呼び出しログの追跡可能性、自分で試したときの出力の一貫性を重視するのがおすすめです。APIYI(apiyi.com)のような集約プラットフォーム経由で呼び出せば、複数のモデルに同時にリクエストを送り、呼び出し記録を完全な形で残せます。そのため、自分で相互比較や監査を行いやすくなります。
業界・規制への影響
- 評価とコンプライアンスのツールボックスに選択肢が1つ増えました:規制当局は、一定期間の推論リクエストに証明を付けるようプロバイダーに求めることで、指定されたモデルを実際にハードウェアが提供していることを確認できます。その際、独自の重みを知られることもありません。ただしAnthropicは、ハードウェアが裏でトレーニングを行っていないことまでは証明できないとも認めています。
- ソフトウェア方式と信頼できるハードウェアは補完関係にあります:信頼実行環境(TEE)はベンダーの耐タンパーハードウェアに依存し、zkSNARKは計算問題の困難性に依存します。zkSNARKは、ハードウェアやOSが侵害されても証明を偽造できません。両者はそれぞれ異なる場面で力を発揮するでしょう。
- Anthropicの本番環境での検証は別のアプローチです:Anthropicは2026年10月19日に更新したFrontier Safety Roadmapで、推論検証プロジェクトが本番の推論トラフィック上でプロトタイプ化されていると述べています。内部のトークントラフィックに署名を付け、信頼できるサーバー上で推論を再計算する仕組みで、極めてまれで悪意のない整合性の異常を1件検出したこともあるそうです。このプロジェクトは名称がinference verificationに変更されており、FlashProveとは関連はあるものの独立した別のプロジェクトです。混同しないようにしてください。
サードパーティAPI利用者が今できること:呼び出し監査ログを自作する
暗号学的な証明はまだ実用段階にありません。そこで開発者としては、まず「追跡可能性」をしっかり確保しておきましょう。以下のサンプルでは、呼び出し時に temperature=0 を固定し、リクエスト時刻・リクエストID・返却されたモデルフィールド・回答のハッシュ値をローカルのログに書き込みます。後から一貫性を再テストするときに役立ちます。ただし、これはあくまでエンジニアリング面での監査記録であり、モデルの同一性を暗号学的に証明するものではありません。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の OpenAI 互換インターフェース
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "用一句话解释零知识证明"}],
    temperature=0
)
print(resp.model, resp.id)
print(resp.choices[0].message.content)
監査ログの完全な実装コードを見る
import hashlib
import json
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 1つのキーで複数社のモデルを呼び出せる
)

def audited_call(prompt: str, model: str, log_path: str = "audit.jsonl") -> str:
    """モデルを呼び出し、追跡可能な情報を記録する(暗号学的証明ではない)"""
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        temperature=0,
        max_tokens=512,
    )
    content = resp.choices[0].message.content or ""
    record = {
        "ts": int(start),
        "latency_s": round(time.time() - start, 3),
        "requested_model": model,
        "returned_model": resp.model,   # サーバー側が返した申告フィールドにすぎない
        "request_id": resp.id,
        "prompt_sha256": hashlib.sha256(prompt.encode()).hexdigest(),
        "output_sha256": hashlib.sha256(content.encode()).hexdigest(),
        "usage": resp.usage.model_dump() if resp.usage else None,
    }
    with open(log_path, "a", encoding="utf-8") as f:
        f.write(json.dumps(record, ensure_ascii=False) + "\n")
    return content

# 固定のプローブ用プロンプトを用意し、定期的に再テストして出力ハッシュとレイテンシ分布を比較する
probes = ["计算 37*43 并只输出结果", "列出三种排序算法的时间复杂度"]
for p in probes:
    for m in ["gpt-4o-mini", "claude-sonnet-4-5"]:
        print(m, audited_call(p, m)[:60])
🚀 クイックスタート:APIYI(apiyi.com)で無料のテスト枠を入手し、上記のプローブスクリプトで複数のモデルを定期的に再テストしてみましょう。なお、この方法で高められるのは追跡可能性だけで、FlashProve のような重みレベルの証明の代わりにはなりません。
これに加えて、次のような実践的な工夫も組み合わせられます。
- あいまいなエイリアスではなく、モデルIDを固定して指定する
- プローブ用プロンプトを一組残しておき、出力とレイテンシの変化を長期的に追跡する
- 重要な業務では、複数のモデルに同時にリクエストして相互検証する
- サービス提供元が重みに関するコミットメントや検証可能な仕組みを公開していないか、動向をチェックする
よくある質問 FAQ
Q1:FlashProve とは何ですか?
FlashProve は、Anthropic が 2026 年 11 月にオープンソース化した、証明可能な推論(provable inference)に関する研究プロトタイプです。zkSNARK をベースにしており、モデル提供者がまず重みに対するコミットメントを行い、そのうえで推論結果の証明を生成します。ユーザーは重みを持っていなくても、CPU だけで、回答がコミット済みのモデルから得られたものかどうかを検証できます。
Q2:FlashProve と Anthropic の推論検証(inference verification)プロジェクトは何が違いますか?
目指す方向は近いものの、実現方法が異なります。推論検証プロジェクトは、本番トラフィックでプロトタイプが構築済みで、署名付きの内部 Token トラフィックを信頼できるサーバーで再計算する方式を採っています。一方、FlashProve は純粋にソフトウェアで完結する暗号学的証明方式で、現時点ではあくまで研究プロトタイプです。この 2 つは混同しないようにしましょう。
Q3:FlashProve の 110 tokens/s は、回答全体をリアルタイムで証明できるという意味ですか?
いいえ、そうではありません。110 tokens/s はバッチ処理でのウィンドウ処理スループットで、1 つの証明が確認するのは 1 つの Token だけです。回答内のすべての Token を検証する場合のスループットは 39.1 tokens/s、単一リクエストの証明では 17.6 tokens/s まで下がります。また、証明は回答を返した後に行う「事後証明」です。
Q4:APIYI は、すべてのレスポンスに FlashProve の証明を付けていますか?
いいえ。現時点では、APIYI(apiyi.com)が FlashProve を導入している、あるいは重みレベルの暗号学的証明を提供しているといった情報は確認できていません。プラットフォームが返すモデル名や呼び出しログも、暗号学的な証明と同じものではありません。現段階で現実的なのは、プラットフォームの統一インターフェースと呼び出し記録を活用して、自分で再テストしたり、結果を相互に比較したりする方法です。
Q5:API を使って複数モデルの一貫性テストを手早く行うには?
複数のモデルに対応したアグリゲーションプラットフォームの利用がおすすめです。
1. APIYI(apiyi.com)でアカウントを登録し、APIキーと無料のテスト枠を取得します
2. 本文のコード内にある base_url を `https://api.apiyi.com/v1` に設定します
3. `temperature=0` に固定し、検証用のプローブプロンプトで定期的に再テストして、出力のハッシュを記録します
この方法は異常な変動を見つけるのに役立ちますが、あくまでエンジニアリング上の監査であり、モデルの身元を証明するものではありません。
Q6:FlashProve には、どのような既知の制限がありますか?
主な制限は次のとおりです。
– GPU のオーバーヘッドが通常の推論の約 70〜95 倍かかる
– コンテキストの上限が 1024 Token
– MoE アーキテクチャ、整数化されたモデル、貪欲デコーディングに依存する
– モデルアーキテクチャは秘匿されず、サイドチャネル攻撃は対象外
– 事後証明のため、改ざんされた内容が先にユーザーへ届くのを防げない
– 実行可能なコードと Lean プロトコルの間に、形式的な等価性の証明がまだない
FlashProve の重要ポイント Key Takeaways
- 信頼のギャップは実在する:サードパーティ API の呼び出しでは、回答の品質が高いからといって、モデルの身元が本物だと証明されるわけではありません。
- 基本の仕組み:オフラインの重みコミットメントと、オンラインの zkSNARK 証明を組み合わせます。ユーザーは CPU だけで検証できます。
- コストが大幅に低下:H100 1 枚のウィンドウスループットは約 110 tokens/s、証明サイズは約 19 MB、検証時間は約 17 秒です。
- 数値の基準を区別する:トークンごとのチェックのスループットは 39.1 tokens/s で、単一リクエストでは 17.6 tokens/s にとどまります。
- 適用範囲は限定的:対象は MoE、整数化した貪欲デコーディング、1024 トークンのコンテキスト、そして事後検出に限られます。
- 始め方:現時点では、APIYI(apiyi.com)のマルチモデル統合インターフェースを使えば、自分で再テストや監査を行えます。
まとめ
FlashProve の意義は、次の 3 点に整理できます。
- モデルの身元確認をエンジニアリングの問題に変えた:これまで同一モデルであることを証明するには、十数時間と100 GB 近い証明サイズが必要でした。それがバッチ処理で100 tokens/s 前後のスループットと、19 MB の証明まで圧縮されました。
- 本番利用にはまだ距離がある:オーバーヘッドが2桁も大きいこと、コンテキストが短いこと、アーキテクチャやデコード方式に制約があることに加え、形式検証のカバー範囲も不完全です。こうした点から、現状はあくまで研究プロトタイプといえます。
- ほかのセキュリティ機構との併用が必要:事後証明でできるのは検出だけで、不正をその場で止めることはできません。信頼できるログやアクセス制御と組み合わせる必要があります。
今日サードパーティ API を使う方にとって、最も現実的な姿勢は次のとおりです。モデル名のフィールドを証明として扱わないこと。かといって、必要以上に不安になることもありません。まずは呼び出し記録、プローブによる再テスト、複数モデルでのクロスチェックをしっかり固めましょう。そのうえで、検証可能な推論技術が成熟していく様子を引き続き見守るのがおすすめです。APIYI(apiyi.com)なら 1 つのキーで複数のモデルを比較できるので、自社の業務データを使って、追跡可能な品質のベースラインを築くことができます。
📚 参考資料
- Anthropic 研究ブログ – Progress on provable inference for large language models:FlashProve の公式発表記事
- リンク:
anthropic.com/research/provable-inference -
説明: システム設計、実測データ、既存手法との比較、制約事項が掲載されています
-
FlashProve 技術レポート:研究ブログに添付されている詳細な技術資料
- リンク:
anthropic.com/research/provable-inference(ページ内の Read the technical report から参照) -
説明: スループットの算出基準、事後証明の限界、形式検証の適用範囲など、重要な前提条件が記載されています
-
Anthropic Frontier Safety Roadmap:推論検証プロジェクトの進捗に関する説明
- リンク:
anthropic.com - 説明: inference verification と FlashProve の違いを把握できます
著者: APIYI 技術チーム
技術交流: APIYI 公式サイトのトップページからお気軽にお問い合わせください。接続に関する資料は docs.apiyi.com のドキュメントセンターでご覧いただけます