ملاحظة المؤلف: عند استدعاء نموذج لغة كبير عبر واجهة API تابعة لجهة خارجية، لا تكفي جودة الإجابة وحدها لمعرفة أي نموذج يعمل فعلًا خلف الكواليس. يشرح هذا المقال مشروع FlashProve مفتوح المصدر من Anthropic: كيف يربط نتيجة الاستدلال بأوزان محددة باستخدام zkSNARK، وكم تبلغ تكلفته، وما الذي يستطيع إثباته وما لا يستطيع، وكم تبعد هذه التقنية عن استدعاءات API اليومية.
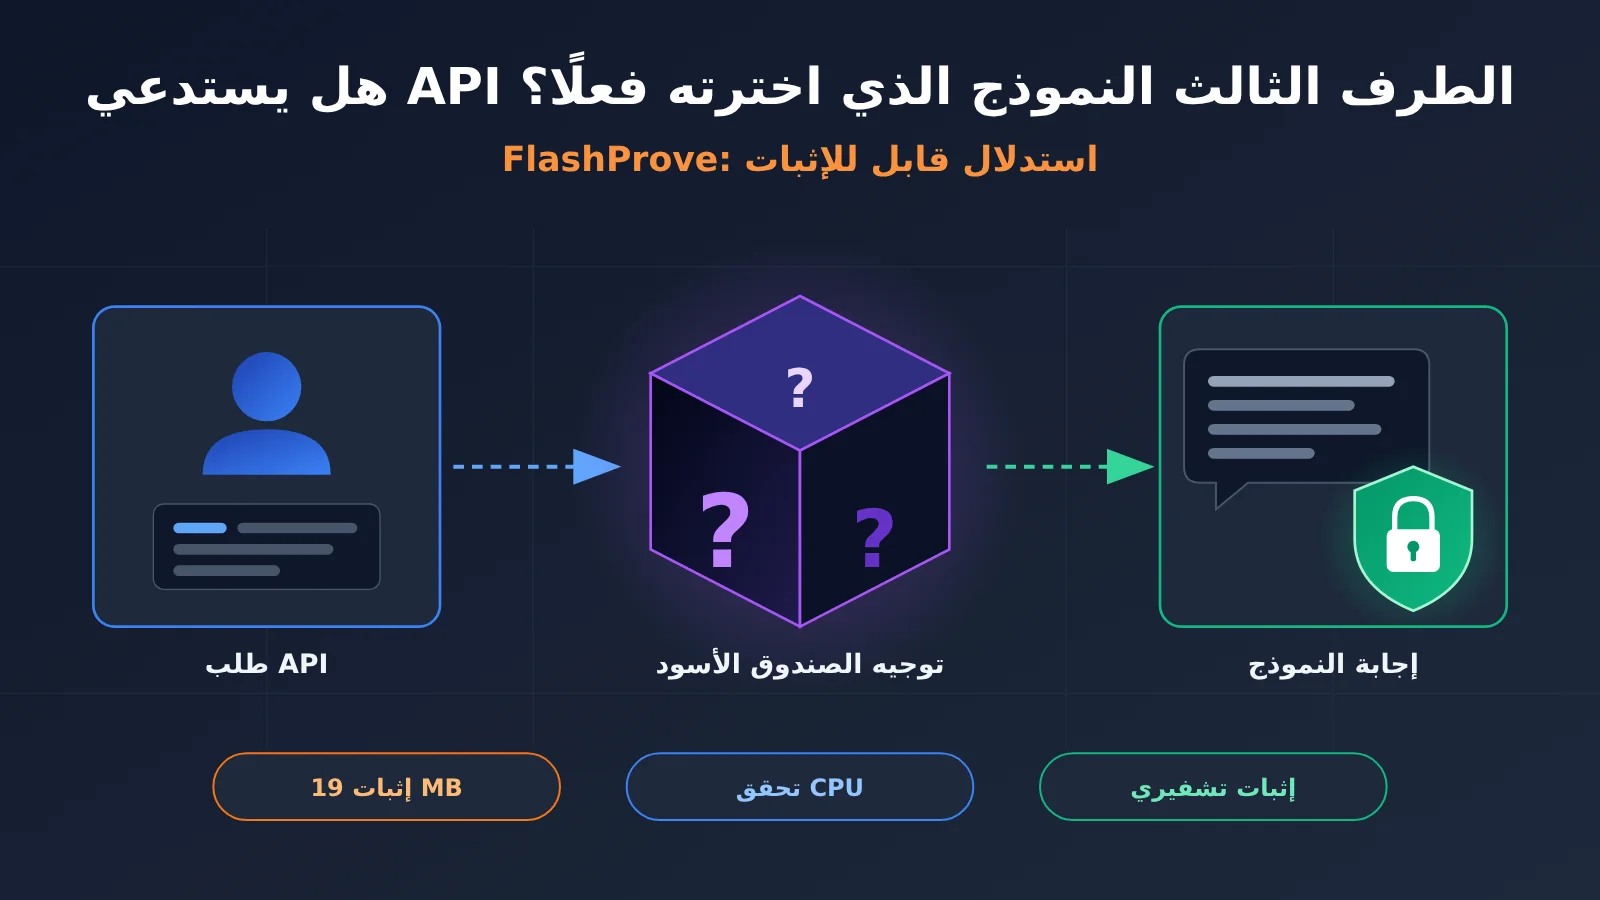
في 2 نوفمبر 2026، أصدر باحثو Anthropic Frontier Red Team بالتعاون مع EPFL وMIT وجهات أخرى FlashProve: نموذجًا أوليًا مفتوح المصدر للاستدلال القابل للإثبات في نماذج اللغة الكبيرة. على نموذج Llama 4 Maverick بحجم 400 مليار معامل، يولّد النظام الإثبات بوحدة H100 واحدة. يبلغ حجم الإثبات الواحد نحو 19 ميغابايت، ويمكن التحقق منه على معالج CPU عادي في بضع عشرة ثانية.
هذا ليس عرضًا نظريًا ولا منتج عروض تقديمية. نشرت Anthropic في الوقت نفسه التقرير الفني ووثيقة مواصفات البروتوكول وشفرة الطرف المُثبِت القابلة للتنفيذ وشفرتين للطرف المُتحقِّق، إضافةً إلى إثباتات Lean الصورية، وكلها مفتوحة المصدر بترخيص Apache 2.0. لكن Anthropic تصرّح أيضًا بأن هذا تقدّم بحثي مرحلي، وما زال أمامه طريق طويل قبل بلوغ الهدف البحثي الكامل.
القيمة الأساسية: بعد قراءة هذا المقال ستفهم لماذا يصعب التأكد من «هوية النموذج» في استدعاءات API الخارجية، وما الآلية التي يعتمدها FlashProve لحل ذلك، وما تكلفته الفعلية وحدوده، وما الذي يمكنك فعله الآن بصفتك مستخدمًا لـ API.
لماذا توجد مشكلة ثقة في هوية النموذج عند استخدام واجهات API من جهات خارجية
عندما ترسل طلبًا عبر أي واجهة API، لا يصلك سوى نص وحقل يحمل اسم النموذج. وتقول Anthropic صراحةً في مدونتها البحثية إن المستخدم اليوم لا يستطيع التأكد من أن الإجابة صدرت فعلًا عن النموذج الذي يدّعيه المطوّر. فقد تستبدله خدمة التوجيه بنموذج آخر بصمت لتوفير التكاليف، وقد يتلاعب مهاجم بتدفق الرموز (Tokens).
والأهم من ذلك أن جودة المخرجات العالية لا تعني أن هوية النموذج حقيقية. فقد يجيب نموذج رخيص إجابة جيدة جدًا عن بعض الأسئلة، وقد لا يكون من السهل اكتشاف أن النسخة المقدَّمة نسخة مخفَّضة المستوى بمجرد النظر. وحتى لو نُشر سجل المحادثة كاملًا، فمن الناحية النظرية يمكن تزويره باستخدام نموذج أرخص، ولذلك فإن هذا النوع من الأدلة لا يملك قوة إثبات مطلقة.
والتحقق من الأساس صعب أيضًا. فأوزان النماذج المتقدمة في معظمها غير معلنة، وحتى لو توفرت الأوزان، فإن القدرة الحسابية اللازمة لإعادة تشغيل الاستدلال تفوق بكثير ما يستطيع المستخدم العادي، بل وحتى جهات التقييم، تحمّله. وقد استعرضت Anthropic عدة سيناريوهات نموذجية لمشكلة الثقة هذه:
- خدمات التوجيه من جهات خارجية: يريد العميل أن يتأكد من أن الرموز التي تصله صادرة عن النموذج الذي دفع ثمنه واختاره.
- التقييم المستقل: تحتاج جهات التقييم إلى التأكد من أن النموذج الذي اختبرته قبل الإصدار وبعده هو نفسه النموذج الذي يخدم المستخدمين فعليًا على الإنترنت.
- كشف التلاعب: إذا اختُرق خادم الاستدلال، فقد يدسّ المهاجم إجابات خبيثة بين الإجابات السليمة، بل قد يوصل برمجيات خبيثة إلى جهاز المستخدم.
- الرقابة والامتثال: قد تشترط الجهات التنظيمية ألا تُنشر إلا نماذج اجتازت الموافقة الأمنية، أو أن تتحقق من أن العتاد يُستخدم فعلًا في الاستدلال لا في تدريب سري.
أما هدف الاستدلال القابل للإثبات (Provable Inference) فهو تمكين مستخدم محدود القدرة الحسابية، ولا يعرف شيئًا عن الأوزان، من التحقق من أن إجابة معيّنة صدرت فعلًا عن النموذج الذي طلبه.
FlashProve: نظرة سريعة على أهم المعلومات
| البند | التفاصيل |
|---|---|
| تاريخ الإصدار | 2 نوفمبر 2026 |
| الجهة المطلِقة | فريق Anthropic Frontier Red Team، بالتعاون مع باحثين من EPFL وMIT وStarkWare وSuccinct وجهات أخرى |
| التقنية الأساسية | zkSNARK (حجة معرفة موجزة بدون إفصاح عن المعلومات)، مبنية على دوال التجزئة، وتتمتع بأمان ما بعد الكم |
| النموذج المختبَر | Llama 4 Maverick، بنية MoE بحجم 400 مليار معامل، ويُفعَّل منها نحو 17 مليار معامل لكل Token، وأوزانه المكمّمة بدقة 4 بت متاحة للعموم |
| محتوى الإصدار | مدونة بحثية، وتقرير تقني، ومواصفات البروتوكول التي كتبها Claude، وشفرة جهة الإثبات وجهتَي التحقق (C++ وLean)، وإثباتات Lean، وأداة للتصور المرئي |
| رخصة المصدر المفتوح | Apache 2.0 |
| الوضع الحالي | نموذج بحثي أولي، يشارك فيه الفريق ما أنجزه حتى الآن، ويرحّب بتحسينات الجهات الخارجية |
ومن الجدير بالذكر أن Anthropic تقول إن Claude أنجز جزءًا كبيرًا من أعمال التحسين في النظام. ولأن الذكاء الاصطناعي قد يتخذ في الأنظمة الكبيرة والمعقدة «قرارات يصعب تقييمها»، كتب الفريق بلغة Lean ادعاءات أمان عليا قابلة للتدقيق، لتكون وسيلة تحوّط.
كيف يثبت FlashProve أن الاستدلال صادر عن النموذج المحدد
يقوم FlashProve على دورين فقط: مزوّد النموذج بصفته المُثبِت (Prover)، والمستخدم بصفته المُتحقِّق (Verifier). تنقسم العملية إلى مرحلتين، إحداهما غير متصلة بالإنترنت والأخرى متصلة، يضاف إليهما فحص من جهة المُتحقِّق.
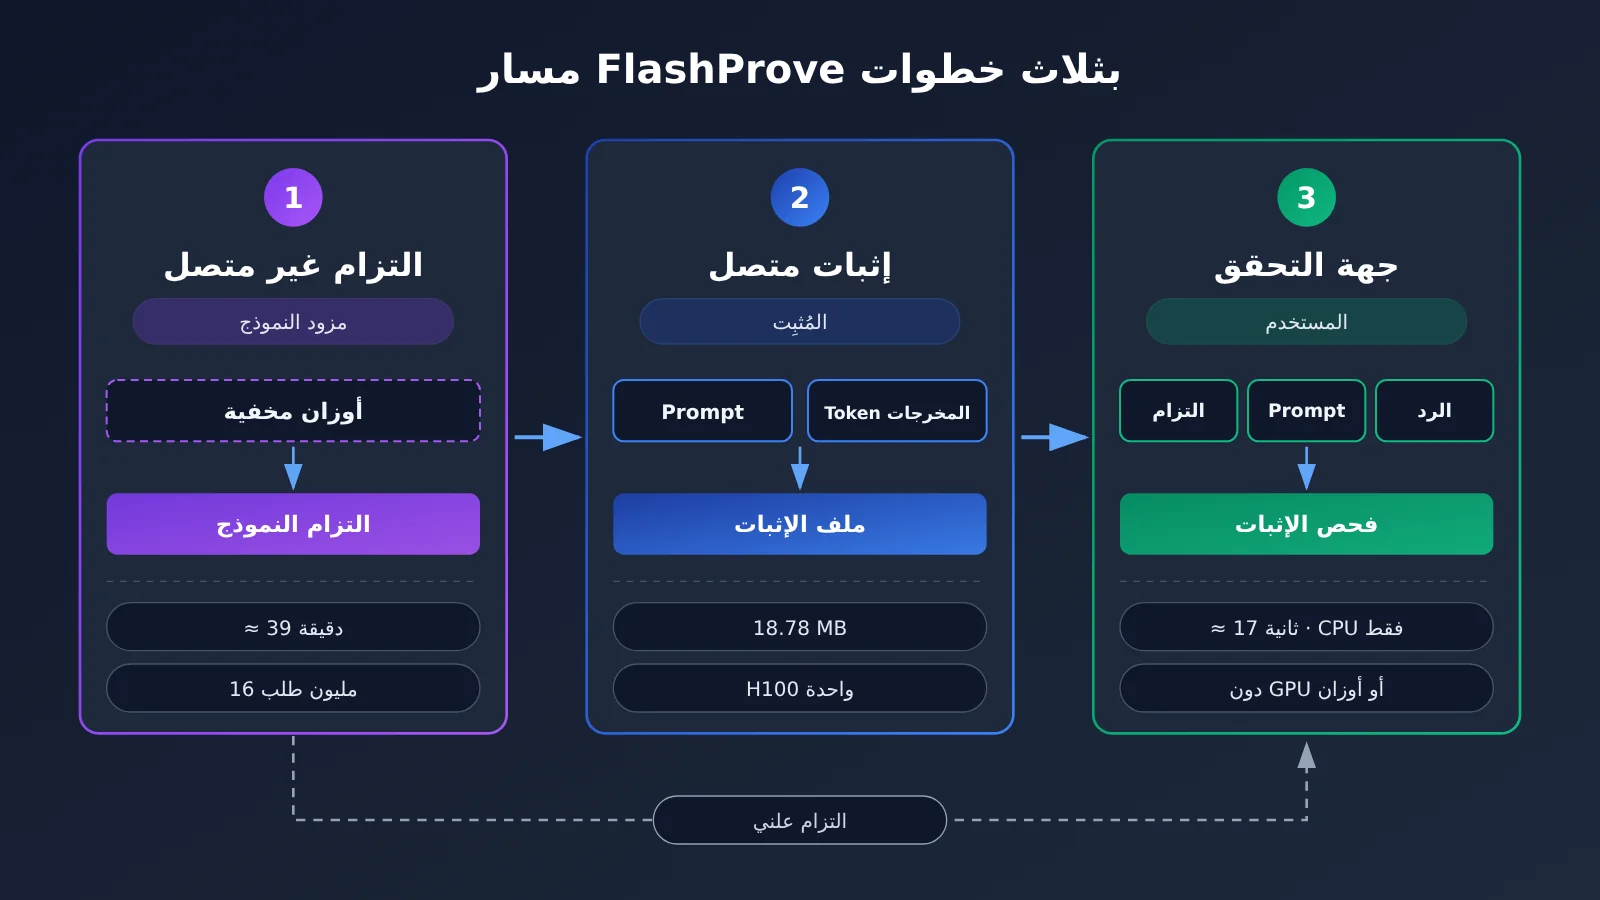
آلية FlashProve في ثلاث خطوات
- الالتزام بالنموذج (Model Commitment) في المرحلة غير المتصلة: ينشر المُثبِت التزامًا بأوزان النموذج، ويمكن تشبيهه ببصمة قصيرة جدًا. هذه البصمة تثبّت مجموعة محددة من الأوزان، بينما تبقى الأوزان نفسها مخفية. في الاختبارات تُنفَّذ هذه الخطوة مرة واحدة لكل نموذج، وتستغرق نحو 39 دقيقة، ويكفي الالتزام الناتج لنحو 16 مليون طلب تقريبًا، ثم يلزم تجديد الالتزام.
- توليد الإثبات في المرحلة المتصلة: عند استلام طلب المُتحقِّق (الموجه ورموز المخرجات المقابلة له)، يولّد المُثبِت ملف إثبات. والمقولة التي يثبتها هذا الملف هي: “النموذج الملتزَم به ينتج رموز المخرجات هذه عند تشغيله”.
- الفحص من جهة المُتحقِّق: يستطيع أي شخص يملك الالتزام والموجه والإجابة أن يفحص الإثبات. لا يحتاج إلى الأوزان، ولا يحتاج إلا إلى قدرة حوسبة محدودة، ليتأكد أن الأوزان الملتزَم بها أنتجت هذه الرموز بالضبط عند هذا الموجه.
الخصائص الأمنية الأربع في FlashProve
أول خاصيتين (الاكتمال والمتانة) يمكن تحقيقهما أصلًا إذا أعاد مُدقِّق يعرف الأوزان ويملك قدرة حسابية كافية تنفيذ الحساب بنفسه. أما ما يمنح النظام قيمته الحقيقية فهو الخاصيتان الأخيرتان:
- الاكتمال (Completeness): أي إثبات يولّده مُثبِت أمين سيقبله المُدقِّق دائمًا.
- المتانة (Soundness): تزوير إثبات صالح لادعاء كاذب يتطلب كسر افتراض تشفيري واسع الثقة، ولذلك لا يحتاج المُدقِّق إلى الوثوق بالمُثبِت.
- المعرفة الصفرية (Zero Knowledge): لا يستطيع المُدقِّق معرفة الأوزان ولا القيم الوسيطة في الحساب، ولا الخبراء الذين جرى تفعيلهم في كل طبقة. أما بنية النموذج نفسها فليست مخفية.
- الإيجاز (Succinctness): ما يُثبَت هو تشغيل واحد لنموذج مكمَّم حجمه نحو 232 جيجابايت، بينما لا يتلقى المُدقِّق سوى ملف بحجم نحو 19 ميجابايت، ويمكنه فحصه خلال بضع ثوانٍ على معالج بـ 24 نواة.
كيف تقلل بنية MoE تكلفة الإثبات في FlashProve
يعتمد تسريع FlashProve بدرجة كبيرة على بنية MoE (مزيج الخبراء). في نموذج Llama 4 Maverick يستخدم كل توكن (Token) نحو 17 مليار معامل فقط من أصل 400 مليار، ويتناسب عمل المُثبِت مع هذه الـ 17 مليارًا تقريبًا، ومع ذلك يظل الإثبات يخفي الخبراء الذين وقع عليهم الاختيار.
وهناك تصميمان هندسيان آخران لا يقلان أهمية. الأول هو الإثبات الدفعي بعد الحدث: يقرأ المُثبِت النص المكتمل دفعة واحدة وبالتوازي كما في مرحلة Prefill، ولا يفتح التزام الأوزان إلا مرة واحدة لكل دفعة. والثاني هو الملاءمة لبطاقة واحدة: تُقسَّم الأوزان إلى مقاطع بحسب الطبقات ويُثبَت كل مقطع على حدة، وتُحمَّل تدريجيًا من الذاكرة العادية، وبذلك يكفي تشغيل النظام على بطاقة GPU واحدة بسعة 80 جيجابايت مع نحو 290 جيجابايت من ذاكرة المضيف.
بيانات التكلفة الفعلية لإثبات FlashProve
التكلفة هي المقياس الأساسي للحكم على إمكانية تطبيق الاستدلال القابل للإثبات عمليًا. بيئة الاختبار التي استخدمتها Anthropic كانت كالتالي: جهة الإثبات تعمل على بطاقة H100 واحدة مع 24 نواة معالج (CPU)، وجهة التحقق تعتمد على المعالج فقط، وكل طلب عبارة عن نافذة بطول 1024 رمزًا (Token).
| المرحلة | المقياس | القيمة المقاسة |
|---|---|---|
| الالتزام دون اتصال | المدة / مدة الصلاحية | نحو 39 دقيقة / نحو 16 مليون طلب |
| الإثبات المباشر | زمن دفعة من 24 طلبًا | نحو 223 ثانية |
| الإثبات المباشر | معدل المعالجة | نحو 110 رموز/ثانية |
| ملف الإثبات | حجم الملف الواحد | 18.78 ميغابايت |
| التنزيل لدى جهة التحقق | حجم التزام الأوزان | نحو 6.5 ميغابايت |
| زمن التحقق | 24 خيط معالجة / خيط واحد | 17 ثانية / 21 ثانية (مع فحص مرحلة ما قبل الاتصال) |
| المقارنة مع vLLM | نسبة وقت GPU الواحد | نحو 72 ضعفًا (66-77 ضعفًا)، وعند أعلى حمل نحو 94 ضعفًا |
خط الأساس في المقارنة هو تشغيل النسخة FP8 من النموذج نفسه عبر vLLM على 8 بطاقات H100. بعبارة أخرى، وقت GPU اللازم لإثبات دفعة من الطلبات يعادل نحو 70-95 ضعف ما يلزم لمعالجة الدفعة نفسها بالاستدلال العادي، أي تكلفة إضافية بحجم يقارب رتبتين من الحجم.
110 رموز/ثانية لا تعني إثبات الإجابة الكاملة في الوقت الفعلي
هذه هي النقطة الأكثر عرضة لسوء الفهم عند قراءة FlashProve. يحدد التقرير التقني بوضوح أن كل ملف إثبات يفحص فعليًا رمزًا واحدًا فقط يلي الموجّه (Prompt)، وأن 110 رموز/ثانية هي معدل معالجة نوافذ الطلبات في جهة الإثبات، وليست سرعة التحقق من الإجابة الكاملة رمزًا برمز.
| طريقة القياس | معدل المعالجة | ملاحظات |
|---|---|---|
| معالجة دفعة من 24 طلبًا، محسوبًا بحجم النوافذ المعالجة | نحو 110 رموز/ثانية | الرقم المذكور في عنوان المدونة، وكل إثبات يفحص رمزًا واحدًا |
| فحص كل رمز في الإجابة، محسوبًا بالرموز المفحوصة | 39.1 رمزًا/ثانية | أقرب إلى سيناريو «التحقق من الإجابة كاملة» |
| إثبات طلب واحد منفردًا | 17.6 رمزًا/ثانية | يحتاج الإثبات الواحد إلى نحو 58 ثانية، وتضيع ميزة المعالجة الدفعية |
لذلك فإن القول إن «FlashProve قادر الآن على إثبات الإجابات الكاملة في الوقت الفعلي» غير دقيق. الصياغة الأدق هي: في ظروف المعالجة الدفعية والسياق القصير والإثبات اللاحق، نجح النظام في خفض تكلفة الاستدلال القابل للإثبات إلى مستوى كان يصعب تخيله من قبل.
مقارنة FlashProve مع حلول الاستدلال القابل للإثبات القائمة
يُعرف “الاستدلال القابل للإثبات” في الأوساط الأكاديمية عادةً باسم zkML. وقد استعرضت Anthropic التطورات في هذا المجال عبر مدونة لها، وجاءت المقارنة الرقمية معبّرة إلى حد بعيد.
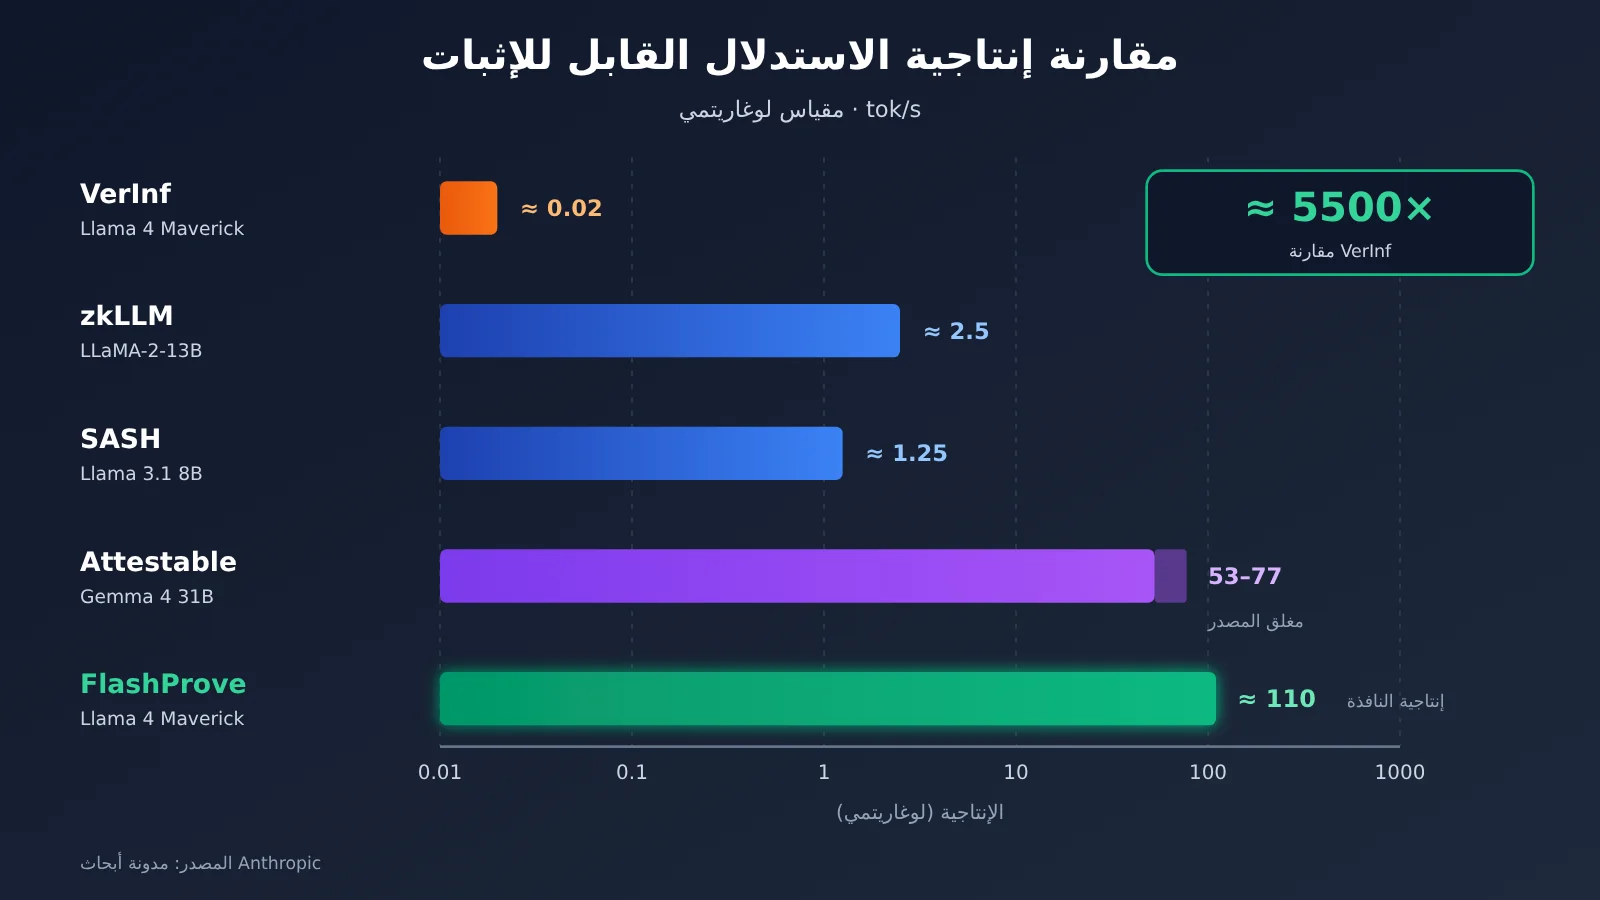
| الطريقة | موضوع الإثبات | الإنتاجية / الزمن | ملاحظات |
|---|---|---|---|
| VerInf | Llama 4 Maverick (400B MoE) | نحو 0.02 tok/s، و1000 توكن تستغرق 14.3 ساعة | حجم الإثبات 93.6 GB، والتحقق يستغرق يومًا كاملًا تقريبًا |
| zkLLM (2024) | LLaMA-2-13B | نحو 2.5 tok/s عند المعالجة على دفعات | بطاقة A100 واحدة |
| SASH (2026) | Llama 3.1 8B | نحو 1.25 tok/s | بطاقة H100 واحدة |
| Attestable | Gemma 4 31B (نموذج كثيف) | 53-77 tok/s | حل تجاري، لم يُفتح مصدره بعد |
| FlashProve | Llama 4 Maverick (400B MoE) | نحو 110 tok/s | حجم الإثبات نحو 19 MB، تحقق في ثوانٍ، مفتوح المصدر |
تحليل المقارنة مع VerInf: كان VerInf هو الحل الوحيد المعروف سابقًا الذي أثبت النموذج نفسه، لكن حجم إثباته بلغ 93.6 GB واستغرق التحقق منه يومًا كاملًا تقريبًا، ما يجعله غير قابل للاستخدام عمليًا. في المقابل، نجح FlashProve في تقليص حجم الإثبات إلى نحو 19 MB وتقصير مدة التحقق إلى بضع عشرة ثانية، ليصبح التدقيق المستقل من طرف ثالث على معالج عادي أمرًا ممكنًا للمرة الأولى.
تحليل المقارنة مع Attestable: حقّق Attestable أرقامًا تجارية لافتة على النماذج الكثيفة، لكنه لم يكن قد أطلق مكتبة مفتوحة المصدر مقابلة وقت كتابة المدونة. وتكمن ميزة FlashProve في أن الشفرة البرمجية وإثبات Lean والتوثيق مفتوحة بالكامل، بحيث يستطيع أي شخص إعادة إنتاجها وتحسينها، وإن كان الثمن هو الاعتماد القوي الحالي على بنية MoE.
ما الذي يستطيع FlashProve إثباته وما الذي لا يستطيع
بالنسبة لمستخدمي واجهات API التابعة لجهات خارجية، فهم حدود الأداة لا يقل أهمية عن فهم قدراتها. يلخّص الجدول التالي أهم القيود الواردة في المدونة البحثية والتقرير التقني:
| الجانب | ما يستطيع FlashProve فعله | ما لا يستطيع FlashProve فعله حاليًا |
|---|---|---|
| هوية النموذج | يثبت الارتباط بالتزام محدد بالأوزان، ويؤكد أن النموذج هو «النموذج الذي جرى الالتزام به» | لا يستطيع إثبات أن هذا الالتزام يخص نموذجًا بعينه يحمل اسمًا تجاريًا معينًا، ويتطلب ذلك التزامًا علنيًا منفصلًا |
| صحة المخرجات | يثبت أن الرموز (Tokens) التي خضعت للفحص هي نتيجة فك الترميز الجشع (greedy decoding) لنموذج محوَّل إلى أعداد صحيحة | لا يغطي مباشرةً المخرجات الناتجة عن تنفيذ بالأعداد العشرية ولا عن أخذ العينات العشوائي (عندما تكون قيمة temperature أكبر من 0) |
| حماية الخصوصية | الإثبات نفسه لا يكشف الأوزان | لا يخفي بنية النموذج، كما أن هجمات القنوات الجانبية، مثل قياس زمن التوليد، خارج نطاقه |
| طول السياق | يدعم سياقًا يصل إلى 1024 رمزًا (Token) | أقصر بكثير مما هو شائع في سيناريوهات المحادثة، حيث يتراوح بين مئات الآلاف وملايين الرموز |
| توقيت الحماية | يكشف مشكلات سلامة المخرجات بعد وقوعها | لا يمنع وصول إجابة تم التلاعب بها إلى المستخدم أولًا |
| بنية النموذج | ينطبق على نماذج MoE (مزيج الخبراء) | البنى الأخرى، مثل النماذج الكثيفة، تحتاج إلى مزيد من البحث |
حدود الكشف في الإثبات اللاحق لدى FlashProve
يعتمد FlashProve على الإثبات اللاحق (Post-hoc Proving). يتلقى المستخدم الاستجابة أولًا، ثم يعيد خادم إثبات مستقل إجراء الحساب وتوليد الإثبات، وأخيرًا يفحصه المُتحقِّق. تسمح هذه الطريقة بأن يكون الإثبات أبطأ، مقابل ألا نضطر إلى المفاضلة بين الأمان والكفاءة. لكن الثمن هو تأخر الضمان: فشل الإثبات لا يكشف المشكلة إلا بعد وقوعها، ولا يحمي المستخدم قبل أن يتلقى الإجابة.
ويحذّر التقرير التقني أيضًا من أن المهاجم إذا سيطر على نظام السجلات نفسه، فقد يرسل إلى المستخدم محتوى معدَّلًا ويجعل السجل يسجّل النتيجة الصحيحة فقط. لذلك لا بد من استخدام FlashProve مع إجراءات أمنية أخرى، مثل السجلات الموثوقة وضوابط الوصول.
الأجزاء غير المكتملة في التحقق الصوري لدى FlashProve
قد يُفهم من عبارة «أُجري إثبات صوري باستخدام Lean» أن النظام بأكمله ثبتت صحته، لكن الواقع ليس كذلك. فالحدود التي يوردها التقرير التقني هي:
- إثبات Lean لخاصية المعرفة الصفرية يغطي حاليًا إثبات الطلب الواحد فقط، ولا يغطي الإثبات الدفعي.
- شفرة طرف الإثبات على وحدة معالجة الرسومات (GPU) ولّدها الذكاء الاصطناعي اعتمادًا على تمثيل Lean، ولم يثبت بعد أنها مكافئة لذلك التمثيل.
- طرف التحقق السريع المكتوب بلغة C++ والمستخدم يوميًا ولّده الذكاء الاصطناعي أيضًا، وليس له ضمان صوري. كل ما في الأمر أن نتائجه تطابقت بالكامل مع نتائج طرف التحقق في Lean أثناء الاختبارات.
- وثيقة مواصفات البروتوكول الأطول ولّدها الذكاء الاصطناعي، ولم يراجعها المؤلفون بالتفصيل، لذا ينبغي التعامل معها بمعزل عن التقرير التقني الذي كتبه المؤلفون بأنفسهم.
هذه القيود لا تعني أن البحث بلا قيمة. هي تبيّن أن التحقق الصوري يركّز حاليًا على الخصائص الرياضية لطبقة البروتوكول، وأن سد الفجوة بين الشفرة القابلة للتنفيذ والبروتوكول ما زال يتطلب تدقيقًا بشريًا أو تدقيقًا بواسطة وكلاء ذكاء اصطناعي.
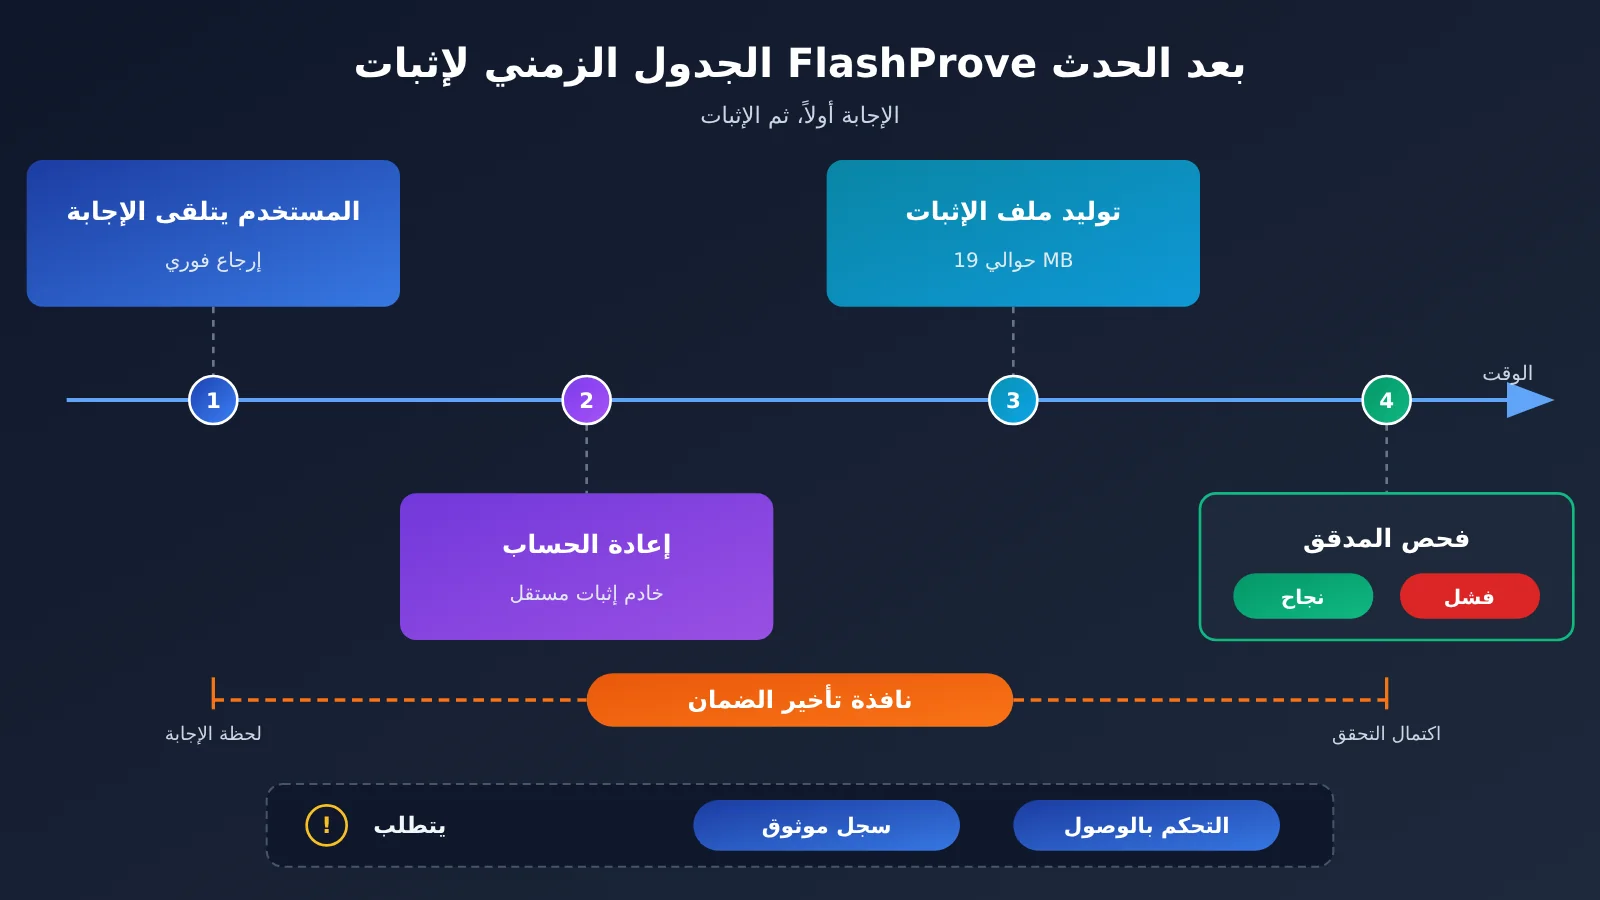
تحليل الأثر: ما المسافة التي تفصل FlashProve عن الاستدعاء اليومي لواجهات API من الأطراف الثالثة؟
الأثر على المطورين ومستخدمي API
- لن يظهر في مسار الاستدعاء اليومي على المدى القريب: تكلفة GPU أعلى بنحو مرتبتين من الحجم، وملف إثبات يبلغ حجمه نحو 19 ميغابايت لكل طلب، وسقف سياق لا يتجاوز 1024 رمزًا (Token). كلها عوامل تجعل استخدامه المباشر في واجهات API عالية التكرار، مثل المحادثات، أمرًا صعبًا.
- نطاق التطبيق محدود: يفترض النظام بنية MoE، ونموذجًا بأعداد صحيحة، وفك تشفير جشعًا (greedy decoding). أما معظم الاستدعاءات في بيئات الإنتاج فتعتمد على أخذ العينات العشوائي والاستدلال بالأعداد العشرية، ولذلك لا يمكن تطبيقه عليها مباشرة.
- قيمته الأكبر على مستوى الوعي: هذه أول مرة يتحول فيها “التحقق من هوية النموذج” من أمر مستحيل إلى مشكلة هندسية. وعلى المطورين أن يدركوا أن حقل اسم النموذج في الاستجابة، أو معرّف النموذج، أو سجلات الطلبات العادية، لا تعادل إثباتًا تشفيريًا.
💡 نصيحة للاختيار: إلى أن يصل الاستدلال القابل للإثبات إلى مرحلة النضج، فالأجدر بالانتباه عند اختيار خدمة من طرف ثالث هو شفافية الفوترة، وإمكانية تتبع سجلات الاستدعاء، واتساق النتائج في اختباراتك الذاتية. وعند الاستدعاء عبر منصة تجميع مثل APIYI (apiyi.com) يمكنك طلب عدة نماذج في آن واحد والاحتفاظ بسجل كامل للاستدعاءات، مما يسهّل إجراء المقارنات المتقاطعة والتدقيق بنفسك.
الأثر على القطاع والجهات التنظيمية
- أداة جديدة في صندوق أدوات التقييم والامتثال: تستطيع الجهات التنظيمية أن تطلب من مزوّد الخدمة إرفاق إثبات بطلبات الاستدلال خلال فترة معينة، للتأكد من أن العتاد يخدم فعلًا النموذج المحدد، دون الاطلاع على الأوزان المملوكة. لكن Anthropic تقرّ بأن هذا لا يثبت أن العتاد لا يُستخدم في الخفاء لأغراض التدريب.
- الحلول البرمجية وتقنيات العتاد الموثوق يكمّل بعضها بعضًا: تعتمد بيئات التنفيذ الموثوقة على عتاد مقاوم للعبث من جهة المصنّع، بينما يعتمد zkSNARK على صعوبة مسائل حسابية معينة، فلا يمكن تزوير الإثبات حتى لو اختُرق العتاد ونظام التشغيل. وسيؤدي كل منهما دوره في سيناريوهات مختلفة.
- التحقق الإنتاجي لدى Anthropic يسلك مسارًا آخر: ذكرت Anthropic في تحديث Frontier Safety Roadmap بتاريخ 19 أكتوبر 2026 أن مشروع التحقق من الاستدلال لديها بنى بالفعل نموذجًا أوليًا على حركة الاستدلال الإنتاجية الفعلية. يعتمد هذا النموذج على توقيعات تغطي حركة الرموز الداخلية، وعلى إعادة حساب الاستدلال في خادم موثوق، وقد رصد مرة واحدة خللًا نادرًا جدًا في السلامة لم يكن خبيثًا. وقد أُعيدت تسمية المشروع إلى inference verification، وهو مشروع مرتبط بـ FlashProve لكنه مستقل عنه، فلا ينبغي الخلط بينهما.
ما الذي يستطيع مستدعو واجهات API الخارجية فعله الآن: بناء سجل تدقيق خاص بالاستدعاءات
بما أن الإثباتات التشفيرية لا يمكن الاعتماد عليها حاليًا، فأفضل ما يمكن للمطوّرين فعله هو ضمان “قابلية التتبع”. يثبّت المثال التالي temperature=0 عند الاستدعاء، ويكتب في سجل محلي وقت الطلب ومعرّف الطلب وحقل النموذج المُعاد وتجزئة الإجابة، ليسهل لاحقًا إجراء اختبارات الاتساق. ويجب التأكيد على أن هذا مجرد سجل تدقيق على المستوى الهندسي، وليس إثباتًا تشفيريًا لهوية النموذج.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI المتوافقة مع OpenAI
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "用一句话解释零知识证明"}],
    temperature=0
)
print(resp.model, resp.id)
print(resp.choices[0].message.content)
عرض الشفرة الكاملة لتنفيذ سجل التدقيق
import hashlib
import json
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # مفتاح واحد لاستدعاء نماذج عدة شركات
)

def audited_call(prompt: str, model: str, log_path: str = "audit.jsonl") -> str:
    """استدعاء النموذج وتسجيل معلومات قابلة للتتبع (وليست إثباتًا تشفيريًا)"""
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        temperature=0,
        max_tokens=512,
    )
    content = resp.choices[0].message.content or ""
    record = {
        "ts": int(start),
        "latency_s": round(time.time() - start, 3),
        "requested_model": model,
        "returned_model": resp.model,   # مجرد حقل مُعلَن يعيده الخادم
        "request_id": resp.id,
        "prompt_sha256": hashlib.sha256(prompt.encode()).hexdigest(),
        "output_sha256": hashlib.sha256(content.encode()).hexdigest(),
        "usage": resp.usage.model_dump() if resp.usage else None,
    }
    with open(log_path, "a", encoding="utf-8") as f:
        f.write(json.dumps(record, ensure_ascii=False) + "\n")
    return content

# تثبيت مجموعة من موجهات الاختبار، وإعادة الفحص دوريًا ومقارنة تجزئة المخرجات وتوزيع زمن الاستجابة
probes = ["计算 37*43 并只输出结果", "列出三种排序算法的时间复杂度"]
for p in probes:
    for m in ["gpt-4o-mini", "claude-sonnet-4-5"]:
        print(m, audited_call(p, m)[:60])
🚀 بداية سريعة: يمكنك الحصول على رصيد تجريبي مجاني عبر APIYI على apiyi.com، ثم استخدام سكربت الاختبار أعلاه لإعادة فحص عدة نماذج بشكل دوري. وللتوضيح، هذه الطريقة لا تفعل أكثر من تحسين قابلية التتبع، ولا يمكن أن تحل محل الإثباتات على مستوى الأوزان مثل FlashProve.
وإلى جانب ذلك، هناك بعض الممارسات العملية التي يمكن اعتمادها: تثبيت معرّف النموذج بدل استخدام أسماء مستعارة غامضة؛ والاحتفاظ بمجموعة من موجهات الاختبار لتتبع تغيّر المخرجات وزمن الاستجابة على المدى الطويل؛ وطلب الإجابة من عدة نماذج في الوقت نفسه للتحقق المتقاطع في الأعمال الحساسة؛ ومتابعة ما إذا كان مزوّدو الخدمة يعلنون التزامات بشأن الأوزان أو آليات يمكن التحقق منها.
الأسئلة الشائعة FAQ
س1: ما هو FlashProve؟
FlashProve هو نموذج بحثي أولي مفتوح المصدر للاستدلال القابل للإثبات، أطلقته Anthropic في نوفمبر 2026. يعتمد على zkSNARK، فيلتزم مزوّد النموذج أولًا بالأوزان (weight commitment)، ثم يولّد إثباتًا لنتيجة الاستدلال. وبذلك يستطيع المستخدم التحقق من أن الإجابة صادرة فعلًا عن النموذج الملتزَم به، دون الحاجة إلى الأوزان، وباستخدام وحدة المعالجة المركزية (CPU) فقط.
س2: ما الفرق بين FlashProve ومشروع التحقق من الاستدلال (inference verification) لدى Anthropic؟
الهدف متقارب، لكن طريقة التنفيذ مختلفة. فمشروع التحقق من الاستدلال أُنشئ له نموذج أولي يعمل على حركة بيانات إنتاجية فعلية، ويعتمد على توقيع تدفق الرموز (Token) الداخلي وإعادة حسابه على خادم موثوق. أما FlashProve فهو حل إثبات تشفيري برمجي بحت، وما زال نموذجًا بحثيًا أوليًا. لذلك لا ينبغي الخلط بينهما.
س3: هل تعني سرعة 110 tokens/s في FlashProve أنه يستطيع إثبات إجابة كاملة في الوقت الفعلي؟
لا. فسرعة 110 tokens/s هي معدل معالجة النوافذ في وضع الدفعات، وكل إثبات يفحص رمزًا (Token) واحدًا فقط. وعند فحص كل رمز في الإجابة ينخفض معدل المعالجة إلى 39.1 tokens/s، وعند إثبات طلب واحد ينخفض إلى 17.6 tokens/s. كما أن العملية كلها إثبات لاحق بعد انتهاء التوليد.
س4: هل توفّر APIYI إثبات FlashProve لكل استجابة؟
لا. لا توجد حاليًا أي مواد تشير إلى أن APIYI (apiyi.com) نشرت FlashProve أو توفّر إثباتًا تشفيريًا على مستوى الأوزان. كما أن اسم النموذج الذي تعيده المنصة وسجلات الاستدعاء لا يُعدّان إثباتًا تشفيريًا. والأسلوب الأكثر واقعية في الوقت الحالي هو الاستفادة من الواجهة الموحدة وسجلات الاستدعاء في المنصة لإجراء اختبارات ذاتية متكررة ومقارنات متقاطعة.
س5: كيف أجري اختبار اتساق لعدة نماذج بسرعة عبر API؟
يُنصح باستخدام منصة تجميع تدعم عدة نماذج:
1. زر APIYI (apiyi.com) وسجّل حسابًا واحصل على مفتاح API ورصيد اختبار مجاني
2. اضبط `base_url` في الشفرة الواردة في هذا المقال على `https://api.apiyi.com/v1`
3. ثبّت `temperature=0`، واستخدم موجهات (Prompt) اختبارية لإعادة الفحص بشكل دوري، وسجّل تجزئة (hash) المخرجات
تساعد هذه الطريقة على اكتشاف التقلبات غير الطبيعية، لكنها تندرج ضمن التدقيق الهندسي، وليست إثباتًا لهوية النموذج.
س6: ما القيود المعروفة لـ FlashProve؟
أبرزها: كلفة GPU تبلغ نحو 70-95 ضعف الاستدلال العادي؛ وحد أقصى لنافذة السياق يبلغ 1024 رمزًا (Token)؛ والاعتماد على بنية MoE ونماذج محوّلة إلى أعداد صحيحة وفك ترميز جشع (greedy decoding)؛ كما أنه لا يخفي بنية النموذج، وهجمات القنوات الجانبية (side-channel) خارج نطاقه؛ والإثبات اللاحق لا يمنع وصول المحتوى المتلاعب به إلى المستخدم أولًا؛ ولا يوجد حتى الآن إثبات رسمي لتكافؤ الشفرة التنفيذية مع بروتوكول Lean.
FlashProve: النقاط الأساسية (Key Takeaways)
- فجوة الثقة حقيقية: عند استدعاء واجهات API من أطراف ثالثة، لا تثبت جودة الإجابة العالية أن النموذج المستخدم هو النموذج المُعلَن.
- الآلية الأساسية: التزام بالأوزان يُنجَز دون اتصال، يليه إثبات zkSNARK أثناء التشغيل، ويستطيع المستخدم التحقق منه بوحدة CPU فقط.
- انخفاض كبير في التكلفة: الإنتاجية على وحدة H100 واحدة في نافذة المعالجة نحو 110 tokens/s، وحجم الإثبات نحو 19 ميغابايت، وزمن التحقق نحو 17 ثانية.
- يجب التمييز بين طريقتي القياس: إنتاجية الفحص توكنًا بتوكن هي 39.1 tokens/s، أما الطلب الواحد فلا يتجاوز 17.6 tokens/s.
- حدود واضحة: يقتصر الأسلوب على نماذج MoE، وفك الترميز الجشع بالأعداد الصحيحة، وسياق بطول 1024 توكن، والكشف اللاحق فقط.
- كيف تبدأ: يمكنك حاليًا الاستعانة بالواجهة الموحدة لعدة نماذج عبر APIYI (apiyi.com) لإجراء اختبارات مستقلة وتدقيق النتائج بنفسك.
الخلاصة
يمكن تلخيص أهمية FlashProve في ثلاث نقاط:
- تحويل التحقق من هوية النموذج إلى مسألة هندسية: كان إثبات استخدام النموذج نفسه يتطلب سابقًا بضع عشرة ساعة وإثباتًا بحجم يقارب مئة غيغابايت. أما الآن فقد انخفض ذلك إلى مستوى مئة tokens/s تقريبًا في المعالجة الدفعية، مع إثبات بحجم 19 ميغابايت.
- لا يزال بعيدًا عن الاستخدام الإنتاجي: تكلفة إضافية تبلغ نحو مرتبتين من حيث الحجم، وسياق قصير، وقيود على البنية وطريقة فك الترميز، مع تغطية غير مكتملة للتحقق الصوري. كل ذلك يجعله حتى الآن نموذجًا بحثيًا أوليًا.
- يحتاج إلى آليات أمان أخرى تعمل معه: الإثبات اللاحق يكشف المخالفة ولا يمنعها، لذا لا بد من دعمه بسجلات موثوقة وضوابط للوصول.
أما مستخدم واجهات الأطراف الثالثة اليوم، فأنسب موقف له هو ألا يعدّ حقل اسم النموذج دليلًا على شيء، وألا يبالغ في القلق أيضًا. ابدأ بإحكام الأساسيات: سجلات الاستدعاء، وإعادة الاختبار بأسئلة استكشافية، والمقارنة بين عدة نماذج. وتابع في الوقت نفسه تطور تقنيات الاستدلال القابل للإثبات. ننصحك باستخدام مفتاح واحد عبر APIYI (apiyi.com) لمقارنة نماذج عدة جهات، وبناء خط أساس للجودة يمكن تتبعه على بيانات عملك.
📚 المراجع
- مدونة أبحاث Anthropic – Progress on provable inference for large language models: المقال الأصلي الذي أُعلن فيه عن FlashProve
- الرابط:
anthropic.com/research/provable-inference -
الوصف: يتضمن تصميم النظام، والبيانات المقاسة عمليًا، ومقارنة بالحلول القائمة، وبيانًا بحدود الطريقة
-
التقرير التقني لـ FlashProve: التفاصيل التقنية الكاملة المرفقة بمدونة الأبحاث
- الرابط:
anthropic.com/research/provable-inference(مدخل Read the technical report داخل الصفحة) -
الوصف: يتضمن القيود الأساسية مثل معيار قياس الإنتاجية، وحدود الإثبات اللاحق، ونطاق التحقق الصوري
-
Anthropic Frontier Safety Roadmap: عرض لتقدّم مشروع التحقق من الاستدلال
- الرابط:
anthropic.com - الوصف: لفهم الفرق بين inference verification وFlashProve
المؤلف: فريق APIYI التقني
التواصل التقني: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI، وللمزيد من مواد الربط والتكامل يمكنكم زيارة مركز التوثيق docs.apiyi.com