Nota do autor: a partir da dúvida de um usuário do opencode sobre por que “a memória só funciona dentro da sessão”, este artigo explica o significado e os limites da memória por sessão e apresenta 6 critérios para escolher uma solução de memória entre sessões.
Se você usa ferramentas de programação com IA como o opencode, talvez já tenha passado por isso: ontem você discutiu as convenções do projeto com a IA durante horas; hoje, ao abrir uma nova sessão, ela faz as mesmas perguntas, como se fosse o primeiro encontro. Em novembro de 2026, um usuário do V2EX contou que, depois de ler outra discussão, descobriu que a memória do opencode funciona por sessão e perguntou qual plugin de memória as pessoas usavam.
Isso não é impressão de um usuário isolado, nem um problema de uma única ferramenta. A memória por sessão é o padrão em muitas ferramentas de programação com IA. Vale esclarecer que a postagem original tem apenas uma frase, a discussão citada nela está fora do material consultado e a documentação oficial do opencode é a referência para entender o mecanismo de memória por completo. Por isso, este artigo não recomenda plugins específicos: ele apresenta as perguntas que você deve fazer ao escolher uma solução de memória entre sessões.
O que você vai aprender: ao terminar a leitura, você saberá avaliar se realmente precisa de memória entre sessões e usar 6 critérios para analisar qualquer plugin de memória ou alternativa, evitando instalar algo que acabe bagunçando ainda mais o contexto.
O que é memória em nível de sessão em ferramentas de programação com IA
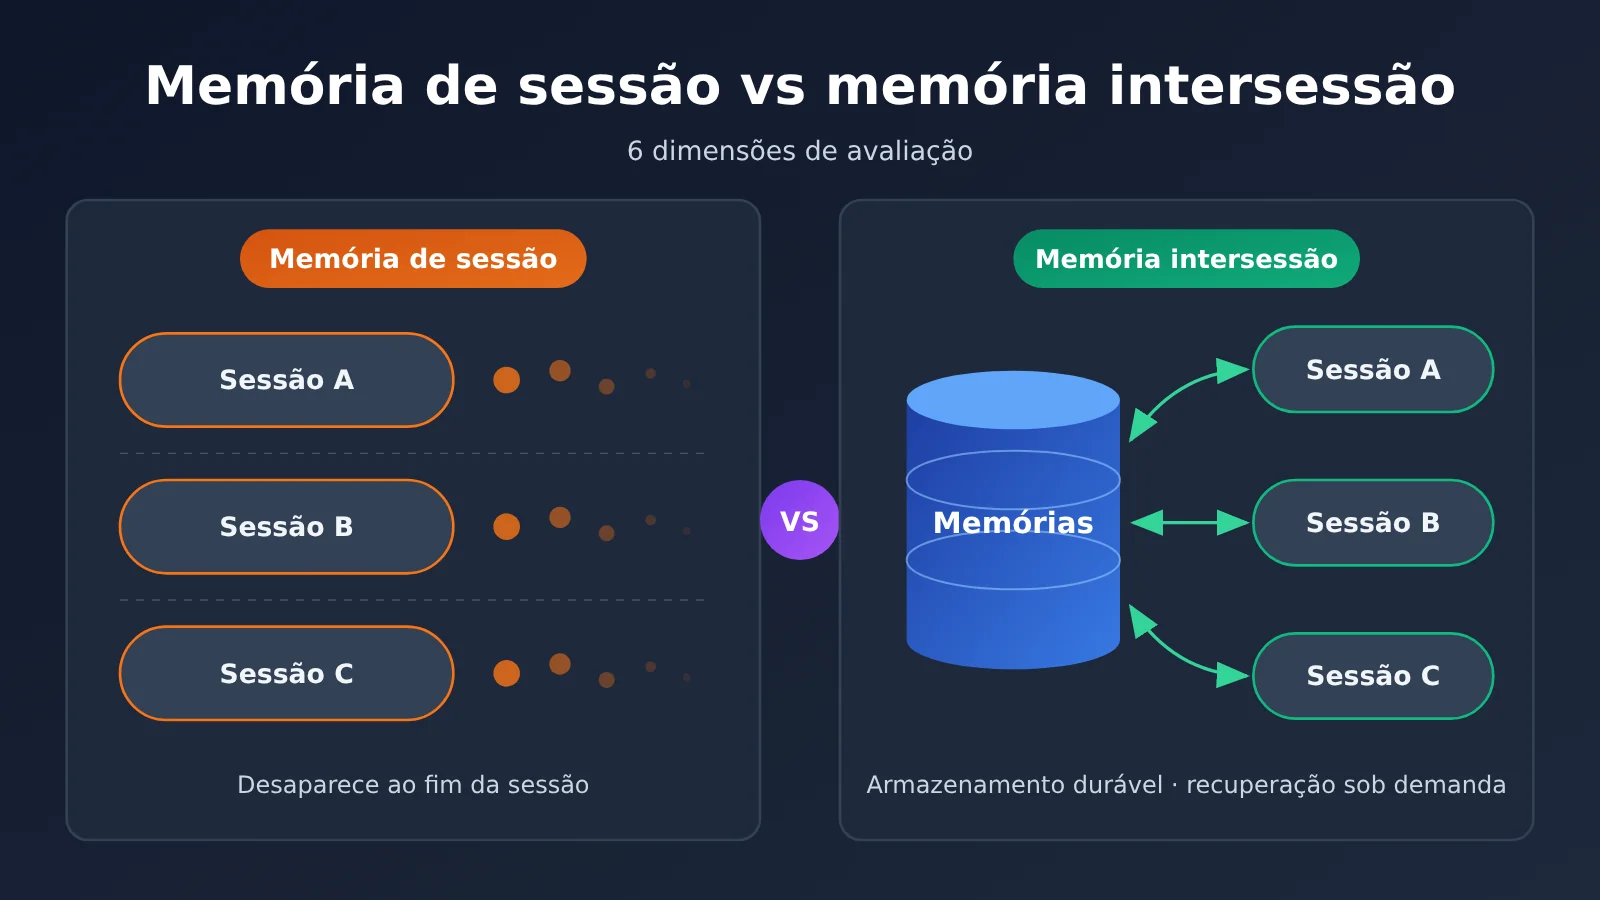
“Memória em nível de sessão” não é um termo técnico rigoroso. A comunidade costuma usá-lo para descrever uma situação: a IA se lembra do que você disse durante uma conversa, mas essas informações não são automaticamente levadas para uma nova sessão. Para entender isso, vale primeiro distinguir alguns tipos de “memória” que costumam ser confundidos.
| Camada de memória | Descrição | O que significa para o usuário |
|---|---|---|
| Janela de contexto | Todo o conteúdo que o modelo consegue ver em uma única requisição, incluindo mensagens anteriores e arquivos lidos | É a base do que a IA “lembra” na sessão e tem um limite de tamanho |
| Histórico da sessão | Mensagens que a ferramenta salva na mesma sessão, permitindo consultá-las ou retomar a conversa | Permite recuperar uma sessão, mas não afeta automaticamente as novas |
| Instruções em nível de projeto | Arquivos de regras no projeto que a ferramenta lê ao iniciar | São os “acordos de longo prazo” mais estáveis, mas exigem manutenção manual |
| Memória entre sessões | Informações extraídas, armazenadas e recuperadas de forma automática ou semiautomática | Leva experiências anteriores para novas sessões, mas exige escolha e governança da solução |
Como funciona a memória em nível de sessão
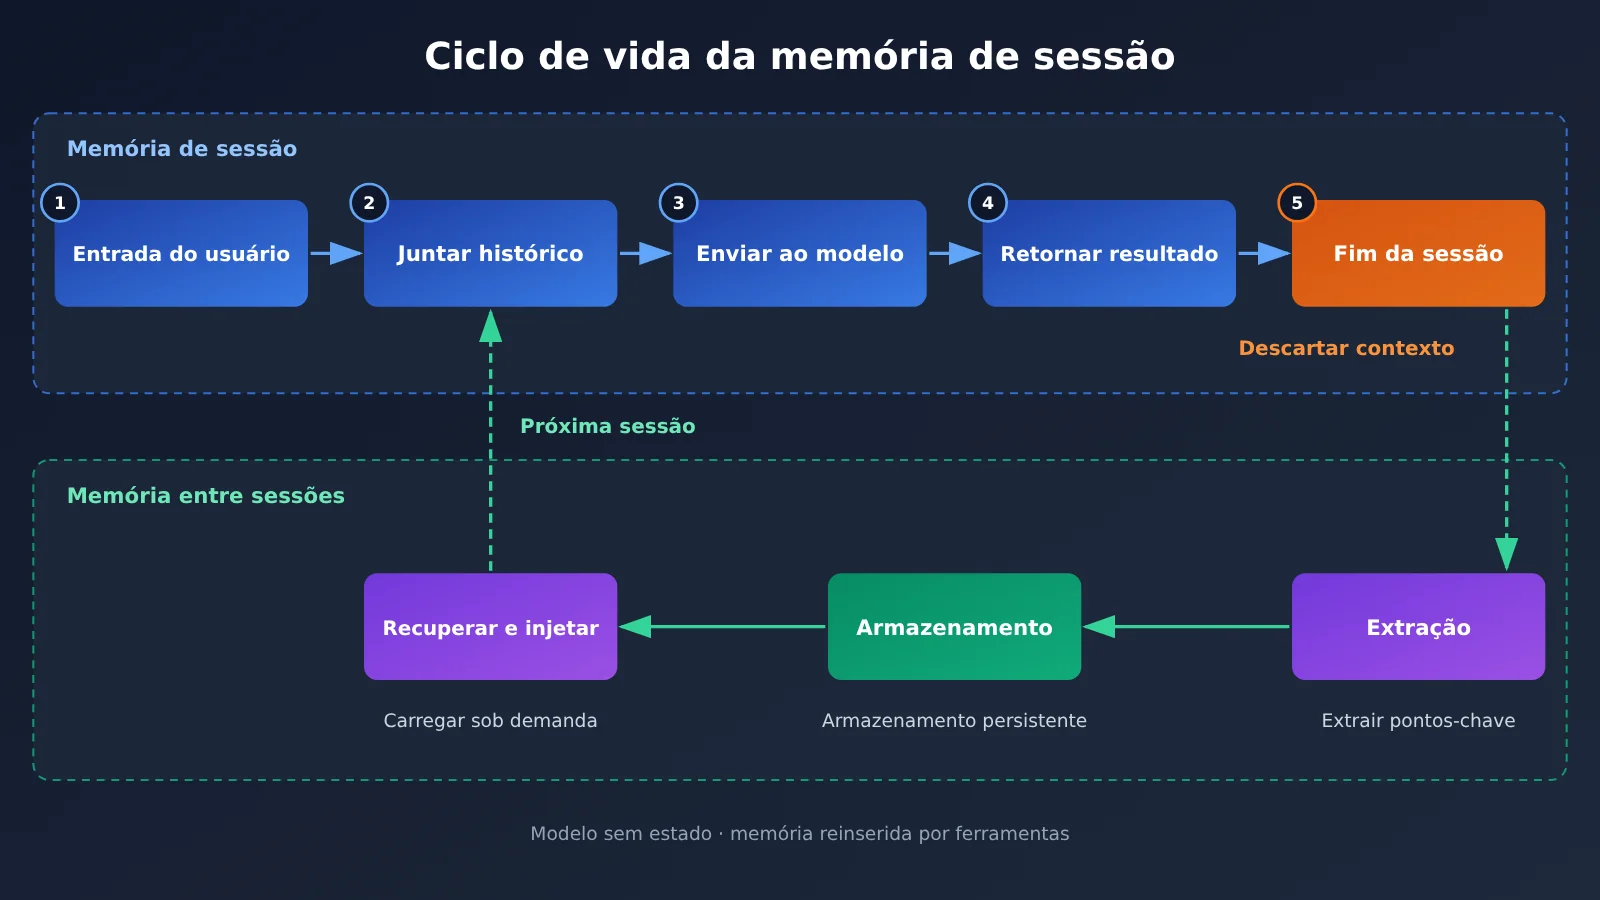
Modelos de Linguagem Grandes não mantêm estado por conta própria. A cada requisição, a ferramenta precisa enviar ao modelo o histórico da conversa, as instruções de sistema e o conteúdo dos arquivos relevantes para que ele “saiba” o que aconteceu antes. Em outras palavras, a memória dentro da sessão existe porque a ferramenta continua incluindo o histórico na janela de contexto.
Isso significa que, quando a sessão termina, a próxima começa do zero — a menos que a ferramenta salve algumas informações em outro lugar e as recupere na próxima inicialização. Além disso, quanto mais longa a sessão, maior o histórico. Por isso, a ferramenta costuma comprimir ou truncar o conteúdo, e detalhes do início podem ser “esquecidos” mesmo dentro da mesma sessão.
Limitações da memória em nível de sessão
Os problemas da memória em nível de sessão se concentram em três pontos. O primeiro é a comunicação repetitiva: a cada nova sessão, você precisa explicar novamente a stack tecnológica, as convenções de nomenclatura e as dependências proibidas. O segundo é que o aprendizado não fica registrado: a solução descoberta depois de um problema não estará disponível para a IA quando ela encontrar uma situação parecida. O terceiro é o custo de alternar entre tarefas: ao abrir várias sessões para trabalhar em diferentes módulos do mesmo projeto, elas não compartilham o contexto entre si.
Por outro lado, a memória em nível de sessão também tem vantagens: o contexto fica limpo, hipóteses antigas e incorretas não contaminam novas tarefas e os limites de privacidade são mais claros. Esses são justamente os pontos a considerar na hora de escolher uma solução.
Por que usar memória entre sessões: primeiro, avalie se você realmente precisa
Nem todo mundo precisa de um plugin de memória entre sessões. Muita gente descobre que “a memória vale apenas para a sessão” e corre para instalar um plugin. No fim, ganha mais um sistema para manter, sem benefícios claros. Antes de decidir, confira os sinais abaixo.
| Sinal de uso | Precisa de memória entre sessões? | Abordagem mais adequada |
|---|---|---|
| Você precisa explicar as regras do projeto a cada nova sessão | Não necessariamente | Comece criando um arquivo de instruções do projeto |
| Você mantém um projeto grande por muito tempo e acumula experiência com problemas recorrentes | Sim | Considere uma solução de memória pesquisável |
| A maioria das tarefas envolve scripts pontuais ou pequenos problemas independentes | Não | Mantenha a memória limitada à sessão |
| Várias pessoas da equipe compartilham as mesmas convenções para uso de IA | Em parte | Coloque as convenções no repositório e mantenha-as sob controle de versão |
| Você lida com informações sensíveis, como código de clientes e chaves | É preciso cautela | Priorize o armazenamento local ou registre apenas informações anonimizadas |
| Você quer que a IA lembre suas preferências pessoais de programação | Sim | Use uma memória no nível do usuário, separada da memória do projeto |
Na prática, “explicar as regras do projeto repetidamente” é a dor mais comum, mas um arquivo de instruções bem mantido resolve boa parte do problema. A memória automatizada entre sessões costuma ser mais útil para experiências dispersas em projetos de longo prazo, difíceis de registrar antecipadamente — como o comportamento estranho de uma interface ou a verdadeira causa de uma falha de build.
Há também um detalhe fácil de ignorar: quanto mais memórias, mais conteúdo é inserido no contexto a cada vez e mais tokens são consumidos. Recuperar e resumir memórias entre sessões geralmente exige invocações adicionais do modelo. Se você quiser avaliar primeiro a qualidade e o custo dos resumos gerados por diferentes modelos, pode usar a interface unificada da APIYI apiyi.com para comparar vários modelos populares com a mesma forma de invocação.
4 abordagens para memória entre sessões
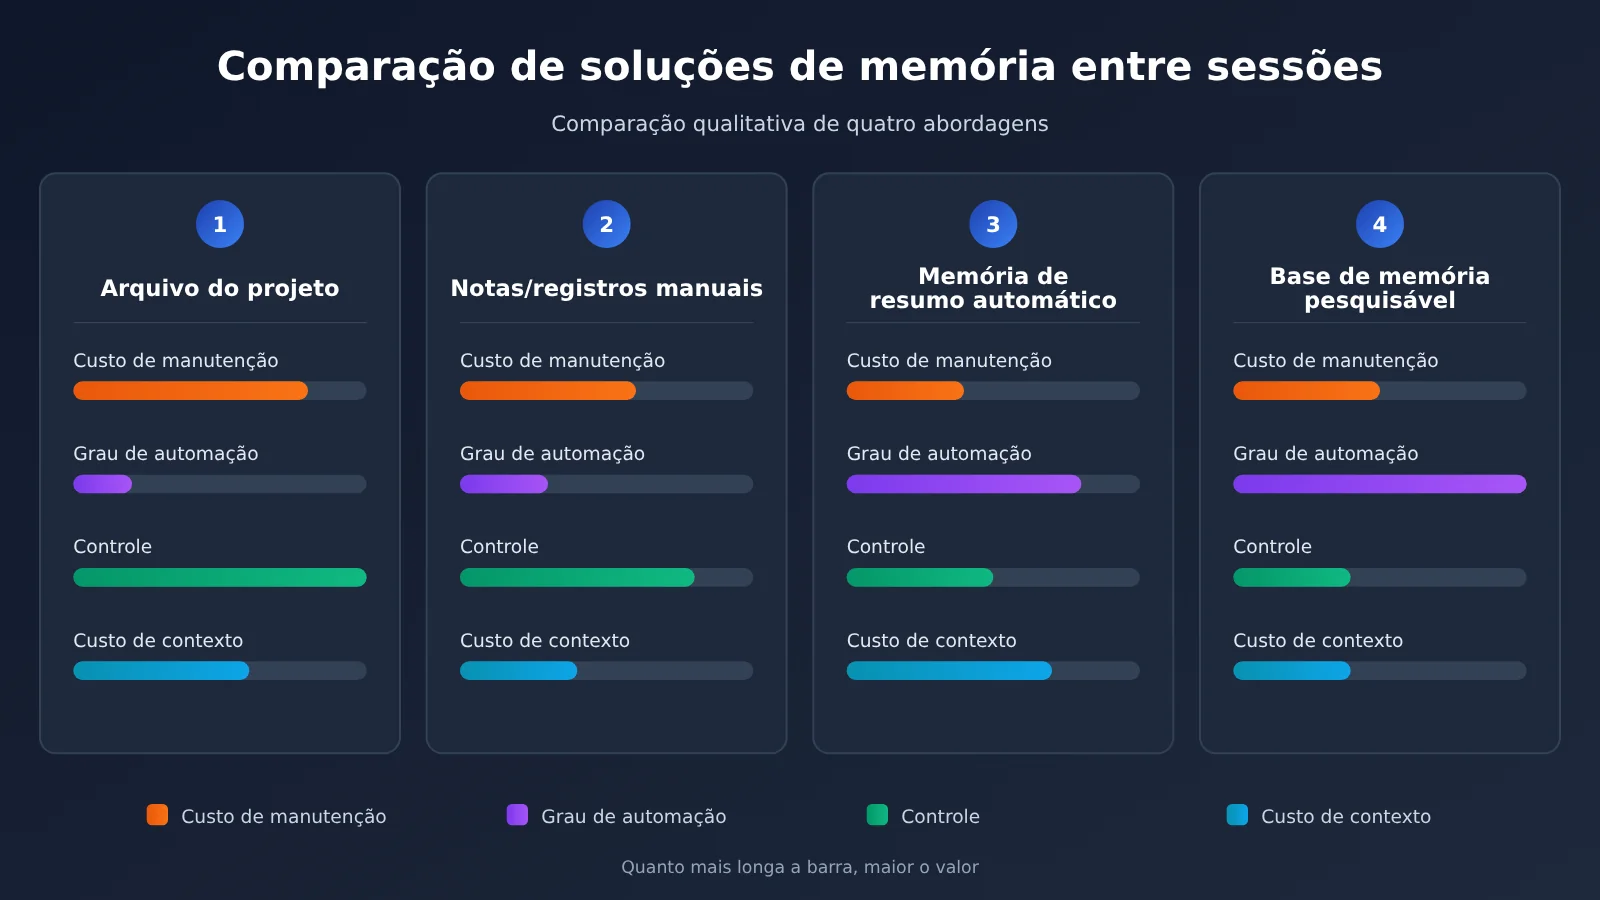
Como as respostas da comunidade ao post original e os detalhes de plugins específicos não fazem parte do material deste artigo, dividimos as soluções comuns em quatro categorias, de acordo com a forma de implementação. Ao avaliar um plugin de memória, você pode primeiro identificar a qual categoria ele pertence e depois analisar as escolhas feitas dentro dela.
| Tipo de solução | Característica principal | Cenário de uso | Recursos necessários |
|---|---|---|---|
| Arquivo de instruções do projeto | Regras escritas manualmente e carregadas por completo na inicialização | Normas estáveis, compartilhamento em equipe | Ferramenta capaz de ler arquivos de regras |
| Notas manuais / registro de trabalho | A IA escreve um resumo ao fim da sessão, que é referenciado manualmente na próxima | Projetos pessoais, necessidades simples | Capacidade de resumo do modelo |
| Memória por resumo automático | Uma ferramenta ou plugin extrai e armazena os pontos principais automaticamente | Uso frequente, sem manutenção manual | Modelo de resumo, acessível por plataformas como a APIYI |
| Base de memória com recuperação | Memórias armazenadas como vetores e recuperadas por relevância | Projetos grandes e de longo prazo, com muito conhecimento acumulado | Modelo de embeddings e armazenamento, geralmente integrados por extensões como MCP |
Sobre o gráfico: a comparação acima é qualitativa e ilustra as abordagens, sem representar dados de testes de plugins específicos. Para testar na prática os modelos usados no resumo automático ou na recuperação de memórias, você pode usar a APIYI apiyi.com para alternar entre modelos e compará-los.
Comparação das soluções de memória entre sessões
Arquivo de instruções do projeto: esse tipo de arquivo se destaca em controle e transparência. O conteúdo fica no repositório, onde pode ser revisado, revertido e compartilhado com a equipe. Por outro lado, exige manutenção ativa e não registra experiências pontuais que ninguém pensou em escrever. As soluções de memória automatizada são mais adequadas para acumular informações que você não imaginava precisar registrar.
Notas manuais: pedir à IA que escreva um registro de trabalho ao fim da sessão e usá-lo como referência na próxima é a opção de menor custo e sem dependências adicionais. Mas ela depende da disciplina de quem usa, e os registros precisam ser organizados conforme se acumulam. Para quem acabou de perceber as limitações da memória restrita à sessão e ainda não sabe exatamente do que precisa, é o ponto de partida mais seguro.
Memória por resumo automático e base de memória com recuperação: essas duas categorias oferecem mais automação e são adequadas para usuários frequentes. Porém, a qualidade da recuperação varia, e elas podem inserir memórias desatualizadas ou incorretas em uma nova sessão, com problemas mais difíceis de investigar do que em um arquivo de instruções. Ao escolher uma dessas soluções, é especialmente importante verificar se as memórias podem ser visualizadas e excluídas, como veremos adiante.
Como escolher uma solução de memória entre sessões: 6 critérios
Independentemente do plugin recomendado pela comunidade, você pode avaliá-lo usando os seis critérios abaixo. O ecossistema de plugins muda rapidamente, então consulte a documentação mais recente de cada projeto para conferir os recursos disponíveis.
| Critério | Pergunta | Cenário ideal |
|---|---|---|
| 1. Local de armazenamento | A memória fica no computador, no diretório do projeto ou em um serviço remoto? | Projetos sensíveis podem usar armazenamento local, com destino dos dados claro |
| 2. Forma de gravação | A extração é automática, a IA invoca uma ferramenta para gravar ou há confirmação manual? | Memórias importantes podem ser confirmadas manualmente |
| 3. Mecanismo de recuperação | Todas as memórias são inseridas no contexto ou são buscadas por relevância? É possível controlar quantas são recuperadas? | Recuperação sob demanda, sem lotar o contexto |
| 4. Observabilidade | É possível visualizar, editar e excluir memórias existentes? | As memórias são textos legíveis e podem ser corrigidas a qualquer momento |
| 5. Escopo | Há distinção entre memórias de usuário, projeto e sessão? | As memórias de projetos diferentes não se misturam |
| 6. Custo e compatibilidade | Há invocações adicionais de modelos? O plugin pode deixar de funcionar após atualizações da ferramenta? | Custos estimáveis e manutenção ativa |
Armazenamento e gravação de memórias entre sessões
O local de armazenamento define os limites de privacidade. Se você trabalha com código de empresas ou clientes, as memórias podem conter lógica de negócio, caminhos internos e até detalhes de configuração. Guardá-las em um serviço remoto sem saber claramente onde os dados vão parar traz riscos. Já a forma de gravação determina a qualidade das memórias: a gravação totalmente automática é prática, mas também é a que mais tende a acumular informações irrelevantes.
Recuperação e gerenciamento de memórias entre sessões
O mecanismo de recuperação é fundamental para uma boa experiência. Inserir todas as memórias no contexto funciona bem quando há poucas, mas, à medida que elas se acumulam, passam a ocupar espaço na janela de contexto e podem interferir na tarefa atual. A observabilidade, por sua vez, é essencial para o gerenciamento: se uma memória incorreta não puder ser identificada e excluída, ela continuará induzindo a IA ao erro em cada nova sessão.
O custo costuma ser subestimado. Tanto os resumos automáticos quanto a busca vetorial podem gerar invocações adicionais de modelos. Para avaliar esse impacto, experimente a solução em pequena escala e contabilize o consumo extra de tokens durante uma semana. Ao usar uma interface agregadora como a APIYI apiyi.com, você pode comparar os gastos com diferentes modelos de resumo na mesma conta e descobrir qual combinação compensa mais.
Como começar com memória entre sessões sem trocar de ferramenta
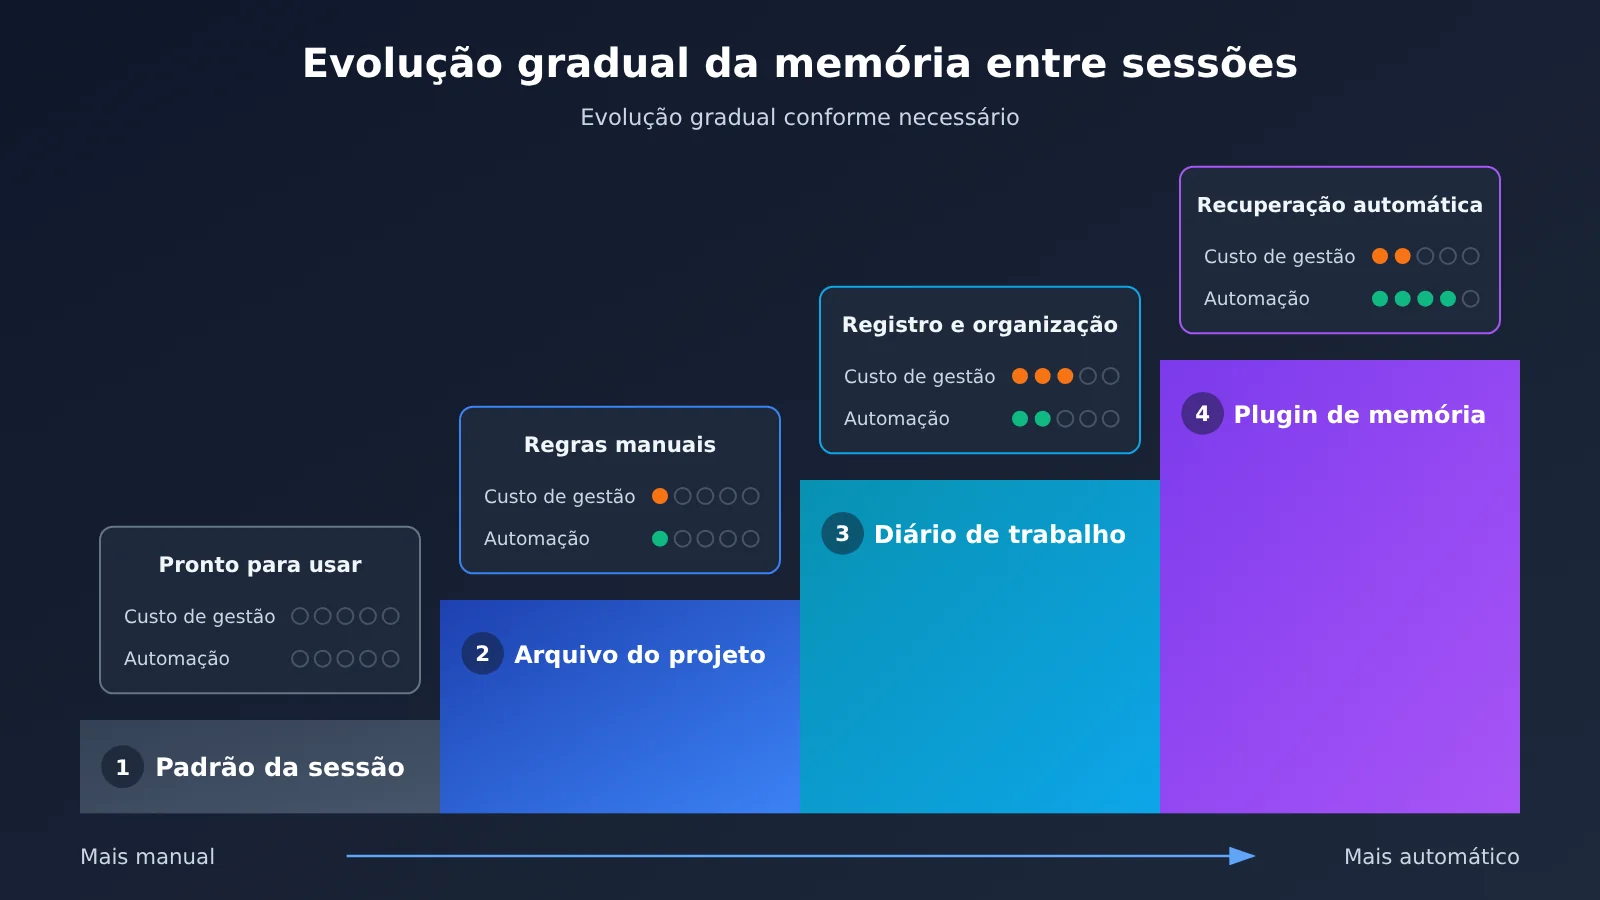
Antes de escolher um plugin de memória, vale testar a abordagem gradual abaixo. Ela não exige código nem depende de um plugin específico e funciona com a maioria das ferramentas de programação com IA.
- Confira os recursos que sua ferramenta já oferece: consulte a documentação oficial para verificar se ela aceita arquivos de regras no nível do projeto, retomada de sessões, extensões como MCP e outros recursos. Assim, você evita reinventar a roda.
- Crie um arquivo de instruções do projeto: reúna em um documento conciso a stack tecnológica, a estrutura de diretórios, as convenções de nomenclatura e o que não deve ser feito. Coloque-o no projeto e inclua-o no controle de versão.
- Crie o hábito de encerrar as sessões com um resumo: sempre que concluir uma tarefa relevante, peça à IA que resuma em um formato fixo as decisões tomadas, os problemas encontrados e as pendências. Acrescente o resumo ao diário de trabalho.
- Faça revisões periódicas: de tempos em tempos, leve para o arquivo de instruções as informações que aparecem com frequência no diário e continuam válidas a longo prazo. Exclua o que estiver desatualizado.
- Reavalie a necessidade de um plugin: depois de uma ou duas semanas de teste, se a manutenção manual estiver dando muito trabalho, use os seis critérios apresentados anteriormente para escolher um plugin de memória automatizado.
Vale registrar o conteúdo do diário de trabalho seguindo a estrutura abaixo. Assim, ele fica fácil de ler e permite que a IA entenda rapidamente o contexto em uma nova sessão.
| Item | Exemplo | Vale incluir no arquivo de instruções? |
|---|---|---|
| Decisão | Escolha de uma solução de gerenciamento de estado e seus motivos | Sim, se for válida a longo prazo |
| Problema encontrado | Falha de build de uma dependência em uma versão específica e como resolvê-la | Depende; transfira quando a solução estiver estável |
| Convenção | Formato padronizado de retorno de erros da API | Sim |
| Pendência | Testes unitários de um módulo ainda não concluídos | Não, mantenha no diário |
| Informações sensíveis | Chaves, endereços internos | Não registre; use uma descrição com placeholder |
🚀 Dica para começar: tanto o resumo da sessão na etapa 3 quanto a organização do diário na etapa 4 podem ser feitos por modelos de menor custo. Experimente alguns modelos pela interface unificada da APIYI em apiyi.com, compare a qualidade dos resumos e escolha qual configurar na ferramenta de programação ou no plugin de memória.
Perguntas frequentes (FAQ)
Q1: O que é memória limitada à sessão em ferramentas de programação com IA?
É quando a IA se lembra das conversas anteriores e do conteúdo que leu apenas durante a sessão atual. Ao abrir uma nova sessão, essas informações não são transferidas automaticamente. Isso acontece porque o modelo, por si só, não mantém estado: a ferramenta recria a “memória” inserindo o histórico novamente na janela de contexto.
Q2: Qual é a diferença entre memória limitada à sessão e memória entre sessões?
A memória limitada à sessão tem a vantagem de manter o contexto limpo e os limites de privacidade bem definidos, mas não acumula aprendizados. Já a memória entre sessões permite que uma nova sessão aproveite experiências anteriores, em troca da necessidade de escolher e manter uma solução e do risco de informações incorretas serem recuperadas repetidamente.
Q3: A memória do opencode realmente só funciona dentro da sessão?
Um usuário publicou no V2EX, em novembro de 2026, que descobriu, depois de ler outra discussão, que a memória do opencode é limitada à sessão. No entanto, a discussão original não faz parte das fontes deste artigo, e a ferramenta continua sendo atualizada. Por isso, consulte a documentação oficial do opencode e verifique o comportamento da versão que você usa.
Q4: Para quais situações a memória entre sessões é mais indicada?
Ela é especialmente útil nos seguintes casos:
– **Projetos grandes mantidos por longos períodos**: há muitas lições aprendidas, espalhadas e difíceis de registrar antecipadamente em regras
– **Preferências pessoais**: você quer que a IA se lembre do seu estilo e dos seus hábitos de programação a longo prazo
– **Desenvolvimento paralelo em várias sessões**: vários módulos do mesmo projeto avançam ao mesmo tempo e precisam compartilhar contexto
Scripts pontuais e pequenos problemas independentes normalmente não precisam desse recurso.
Q5: Como testar e alternar com facilidade os modelos de resumo ou embedding usados pelos plugins de memória?
Muitas soluções de memória precisam de modelos adicionais para gerar resumos ou vetores. Você pode usar uma plataforma que reúne vários modelos, como a APIYI apiyi.com, para comparar os resultados e os custos de diferentes modelos com uma interface de chamada unificada. Depois de escolher o mais adequado, configure-o no plugin. Para os parâmetros de integração, consulte a documentação da plataforma em docs.apiyi.com e as instruções do plugin.
Q6: A memória entre sessões pode aumentar significativamente o custo em tokens?
Pode. As memórias recuperadas ocupam espaço no contexto a cada uso, e os resumos automáticos também geram chamadas adicionais. Comece limitando a quantidade de memórias recuperadas e acompanhe o consumo extra durante o período de teste. Com a visão unificada de faturamento da APIYI apiyi.com, fica mais fácil comparar o custo de diferentes combinações de modelos.
Q7: Quais são os riscos ou limitações conhecidos da memória entre sessões?
Há três pontos principais: memórias incorretas ou desatualizadas podem continuar orientando mal as novas sessões; informações sensíveis, como chaves e caminhos internos, podem acabar nas memórias; e plugins podem deixar de funcionar após atualizações da ferramenta. Para reduzir esses riscos, escolha uma solução que permita visualizar e excluir memórias, faça limpezas periódicas e evite registrar conteúdo sensível.
Pontos principais sobre memória de sessão e entre sessões
- A essência da memória de sessão: o modelo não mantém estado; a ferramenta reproduz o histórico para que ele “lembre” dentro da sessão.
- Avalie antes de instalar: se o problema é repetir as mesmas orientações, um arquivo de instruções muitas vezes resolve.
- Quatro tipos de solução: arquivos de instruções, registros manuais, resumos automáticos e bases de memória com recuperação têm vantagens e limitações diferentes.
- Seis critérios de avaliação: local de armazenamento, forma de gravação, mecanismo de recuperação, observabilidade, escopo, custo e compatibilidade.
- Poder apagar é mais importante que automatizar tudo: uma memória incorreta que não pode ser corrigida repetirá o erro em cada nova sessão.
- Implementação gradual: comece com um arquivo de instruções, adicione um registro de trabalho e, se necessário, evolua para um plugin de memória.
- Teste os modelos antes de escolher: compare modelos de resumo e de embeddings pela interface unificada da APIYI apiyi.com.
Resumo
Estes são os principais pontos sobre memória de sessão em ferramentas de programação com IA:
- Entenda a limitação: a memória limitada à sessão não é um defeito, mas uma escolha padrão. Ela mantém o contexto limpo, ao custo de não acumular experiências automaticamente.
- Comece com soluções de baixo custo: um arquivo de instruções do projeto e um registro de trabalho resolvem a maioria dos problemas de ter que explicar tudo de novo.
- Avalie os plugins por critérios: se você realmente precisar automatizar a memória entre sessões, avalie armazenamento, gravação, recuperação, observabilidade, escopo, custo e compatibilidade.
Para quem usa ferramentas como o opencode e está em dúvida sobre qual plugin de memória instalar, mais importante que uma lista de plugins é saber o que precisa ser lembrado, onde guardar e como apagar. O ecossistema de plugins muda rápido, então consulte a documentação oficial e as experiências reais da comunidade antes de escolher.
Se a solução de memória precisar de modelos de resumo ou de embeddings, vale fazer um teste comparativo em pequena escala pela APIYI apiyi.com antes de definir a configuração final.
📚 Referências
- Perguntas e respostas no V2EX: quem usa opencode, qual plugin de memória vocês instalaram?: a pergunta que inspirou este artigo
- Link:
v2ex.com/t/1254245 -
Observação: o usuário pergunta por que a memória do opencode é limitada à sessão. A publicação original contém apenas a pergunta; confira as respostas da comunidade na página do tópico.
-
Documentação oficial do opencode: informações sobre memória, arquivos de regras e recursos de extensão
- Link: consulte a documentação mais recente no site oficial ou no repositório de código aberto do opencode
- Observação: este artigo não cobre toda a documentação oficial sobre o mecanismo de memória. Recomendamos consultá-la antes de escolher uma solução.
Autoria: equipe técnica da APIYI
Troca de experiências: entre em contato conosco pela página inicial da APIYI em apiyi.com para trocar experiências sobre ferramentas de programação com IA e escolha de modelos. Para mais conteúdos, acesse a central de documentação em docs.apiyi.com.