著者注:opencode ユーザーが「記憶はセッション内でしか有効でない」と気づいたことをきっかけに、セッション単位の記憶の意味と限界を解説し、セッションをまたぐ記憶の方法を選ぶ際の6つの判断基準を紹介します。
opencode のような AI コーディングツールをよく使っていると、こんな経験があるかもしれません。昨日は AI とプロジェクトのルールについて長時間話し合ったのに、今日新しいセッションを始めると、まるで初対面のように同じことを聞かれる。2026 年 11 月、V2EX のユーザーが別の議論を読んでopencode の記憶はセッション単位だと知り、どの記憶プラグインを入れればよいか質問を投稿しました。
これは一部のユーザーの思い違いでも、特定のツールだけの問題でもありません。 セッション単位の記憶は、多くの AI コーディングツールのデフォルトの仕組みです。ただし、元の投稿は一文だけで、そこで参照されている議論も今回の資料には含まれていません。また、opencode の記憶の仕組みについて詳しくは、公式ドキュメントをご確認ください。そこでこの記事では、特定のプラグインをおすすめするのではなく、セッションをまたぐ記憶の方法を選ぶ際に確認すべき点を整理します。
この記事でわかること:自分に本当にセッションをまたぐ記憶が必要かを判断し、6つの基準を使って記憶プラグインや代替手段を評価できるようになります。プラグインを入れた結果、かえってコンテキストが混乱する事態を避けましょう。
AIコーディングツールの会話単位の記憶とは
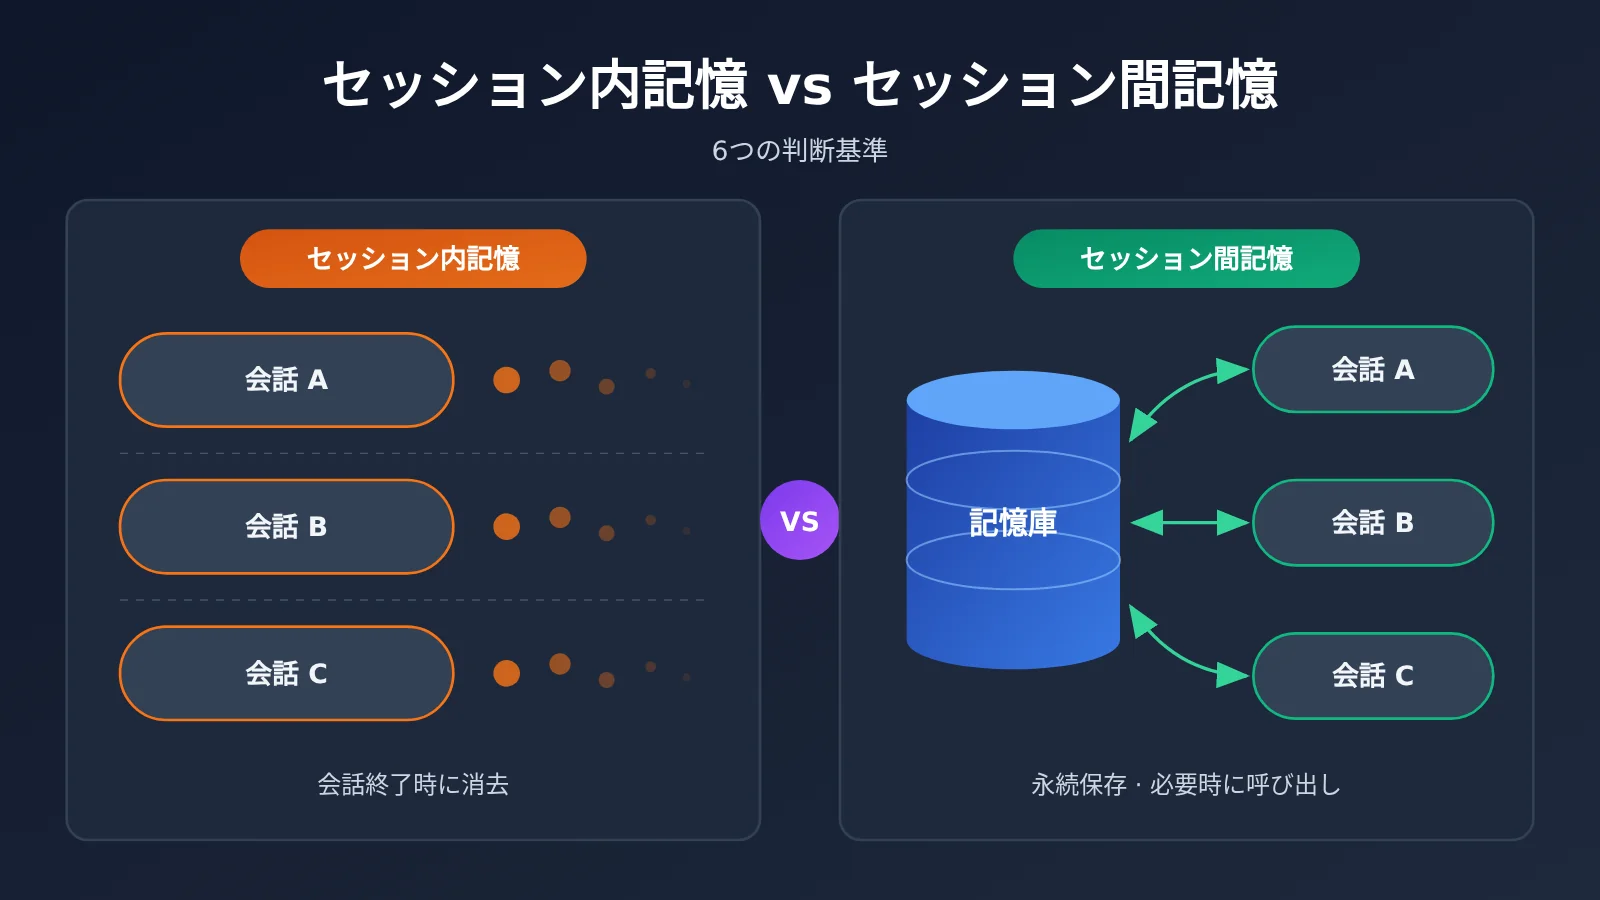
「会話単位の記憶」は厳密な技術用語ではありません。コミュニティでは通常、AIが同じ会話の中ではユーザーの発言を覚えているものの、新しい会話を始めると、その内容が自動では引き継がれない現象を指します。これを理解するために、まずは混同されがちな「記憶」の種類を整理しましょう。
| 記憶の階層 | 説明 | ユーザーにとっての意味 |
|---|---|---|
| コンテキストウィンドウ | モデルが1回のリクエストで参照できるすべての内容。過去のメッセージや読み込んだファイルを含む | 会話内で「覚えている」ことの基本となる仕組み。長さには上限がある |
| 会話履歴 | ツールが同じ会話のメッセージを保存し、後から見返したり続きを再開したりできる | 特定の会話を復元できるが、新しい会話には自動では反映されない |
| プロジェクト単位の指示 | プロジェクト内に書かれたルールファイルを、ツールの起動時に読み込む | 最も安定した「長期的な取り決め」。手動でのメンテナンスが必要 |
| 会話をまたぐ記憶 | 自動または半自動で抽出・保存・呼び出しされる情報 | 新しい会話に過去の経験を引き継げるが、仕組みの選定と管理が必要 |
会話単位の記憶の仕組み
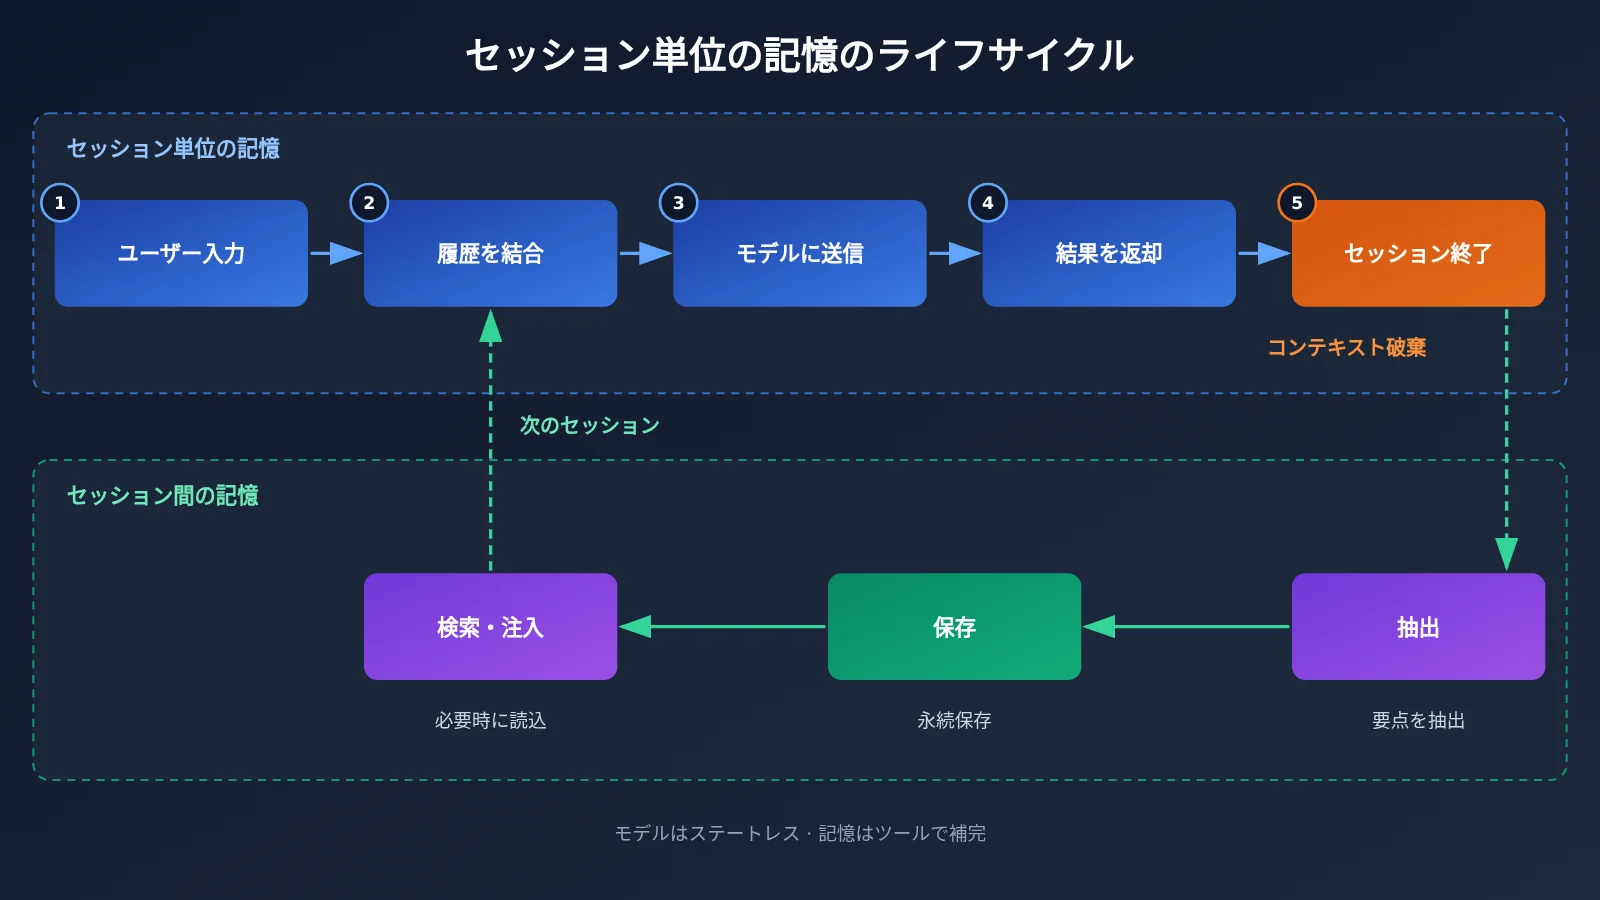
大規模言語モデル自体はステートレスです。ツールがリクエストごとに会話履歴、システムプロンプト、関連ファイルの内容をまとめてモデルに送ることで、モデルは初めてそれまでの経緯を「知る」ことができます。会話内で覚えているというのは、実際にはツールが履歴を繰り返しコンテキストウィンドウに入れているからです。
つまり、会話が終わると、ツールが情報の一部を別の場所に保存し、次回の起動時に取り出さない限り、新しい会話は白紙の状態から始まります。また、会話が長くなって履歴が増えると、ツールは内容を圧縮したり切り詰めたりすることが多く、同じ会話の中でも初期の細かい情報が「忘れられる」ことがあります。
会話単位の記憶の限界
会話単位の記憶には、主に3つの課題があります。1つ目は説明の繰り返しです。新しい会話を始めるたびに、技術スタックや命名規則、使用禁止の依存関係を伝え直す必要があります。2つ目は経験を蓄積できないことです。ある問題で得た解決策をまとめても、次に同じような問題が起きたとき、AIはそれを知りません。3つ目は、複数のタスクを切り替えるコストが高いことです。同じプロジェクトで複数の会話を開き、それぞれ別のモジュールを扱う場合、会話間で背景情報は共有されません。
一方で、会話単位の記憶にはメリットもあります。コンテキストがまっさらなので、過去の誤った前提が新しいタスクに影響せず、プライバシーの境界も明確です。この点は、後で仕組みを選ぶ際に考慮する必要があります。
セッションをまたぐ記憶はなぜ必要?まずは本当に必要か判断しよう
セッションをまたぐ記憶のプラグインは、誰にでも必要なわけではありません。「記憶がセッション単位でしか保持されない」と聞いて急いでプラグインを導入したものの、管理するシステムが増えただけで、効果はあまり感じられなかった――ということもあります。まずは、以下の表を参考に判断してみましょう。
| 利用状況 | セッションをまたぐ記憶は必要? | より適した方法 |
|---|---|---|
| 新しいセッションのたびにプロジェクトの規約を説明し直している | 必ずしも必要ではない | まずはプロジェクト単位の説明ファイルを作成する |
| 同じ大規模プロジェクトを長期的に維持し、つまずいた経験が多い | 必要 | 検索可能な記憶の仕組みを検討する |
| タスクの大半が使い捨てスクリプトや独立した小さな問題である | 不要 | セッション単位の記憶にとどめる |
| チームの複数人で同じAI向けの取り決めを使っている | 一部必要 | 取り決めをリポジトリに置き、バージョン管理する |
| 顧客のコードやキーなど、機密情報を扱う | 慎重に判断 | ローカル保存を優先するか、機密情報を除いた内容だけを記録する |
| 個人のコーディングの好みをAIに覚えてほしい | 必要 | ユーザー単位の記憶をプロジェクトの記憶と分ける |
実際のところ、「プロジェクトの規約を何度も説明する」という悩みは最もよくありますが、適切に管理された説明ファイルがあれば、その大部分を解決できます。セッションをまたぐ記憶の自動化が本当に役立つのは、長期プロジェクトで蓄積される、断片的で事前には書き残しにくい経験です。例えば、あるインターフェースの特殊な挙動や、ビルドが失敗した本当の原因などが挙げられます。
もう一つ見落としがちなのは、記憶が増えるほど、毎回コンテキストに追加される内容も増え、消費するトークンも多くなることです。セッションをまたぐ記憶の検索や要約には、追加のモデル呼び出しが必要になることもあります。異なるモデルの要約性能やコストを先に評価したい場合は、APIYI apiyi.com の統一インターフェースを使えば、同じ呼び出し方法で複数の主要モデルを比較できます。
セッションをまたぐ記憶を実現する4つのアプローチ
元の投稿に寄せられたコミュニティの返信や、具体的なプラグインの情報は本記事の資料に含まれていないため、ここでは一般的な方法を実装方針に沿って4種類に分けます。記憶プラグインを評価するときは、まずどの種類に属するかを判断し、そのうえで各方式のトレードオフを確認するとよいでしょう。
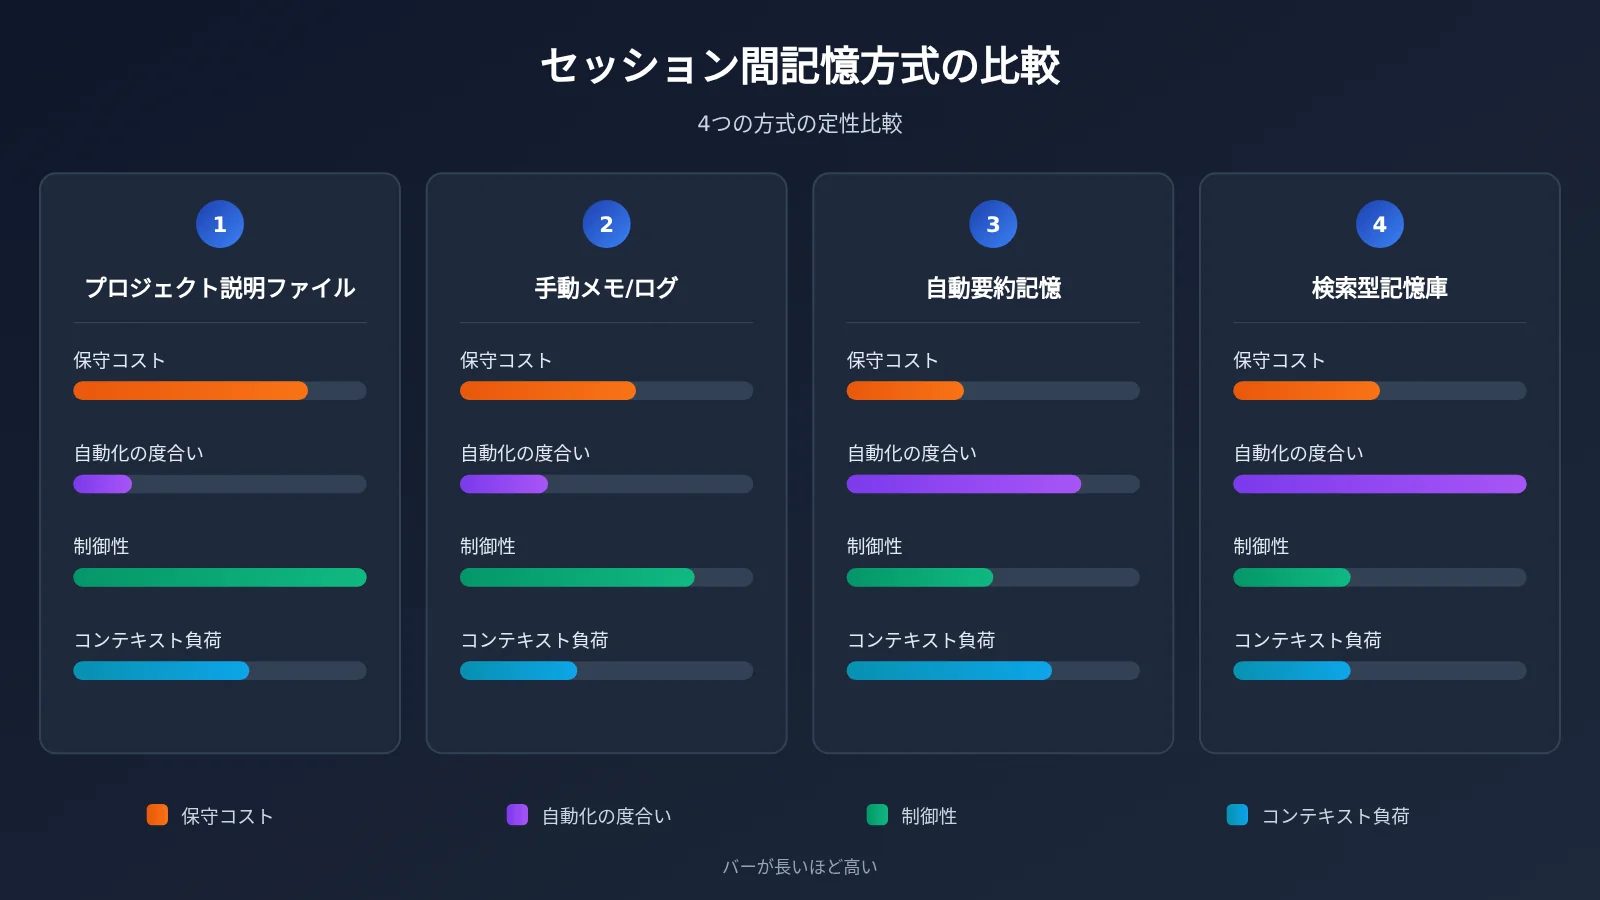
| 方式 | 主な特徴 | 適した場面 | 必要な機能 |
|---|---|---|---|
| プロジェクト説明ファイル | ルールを手動で記述し、起動時にまとめて読み込む | ルールが安定している場合、チームで共有する場合 | ツールによるルールファイルの読み込み |
| 手動メモ / 作業ログ | セッション終了時にAIに要約を書かせ、次回手動で参照する | 個人プロジェクト、手軽に使いたい場合 | モデルの要約能力 |
| 自動要約による記憶 | ツールやプラグインが要点を自動で抽出して保存する | 頻繁に利用する場合、手動での管理を省きたい場合 | 要約モデル。APIYIなどのプラットフォーム経由で利用可能 |
| 検索型記憶ベース | 記憶をベクトル化して保存し、関連性に応じて取り出す | 長期にわたる大規模プロジェクト、蓄積した経験が多い場合 | 埋め込みモデルとストレージ。MCPなどの拡張機能として導入されることが多い |
図の説明:上図は各方式の考え方を定性的に比較したものであり、特定のプラグインを実測したデータではありません。「自動要約」や「検索による記憶の取り出し」に使うモデルの実際の性能を試したい場合は、APIYI apiyi.com を通じて複数のモデルを切り替え、横並びで比較できます。
セッションをまたぐ記憶方式の比較と解説
プロジェクト説明ファイル:制御のしやすさと透明性に優れています。内容はリポジトリ内にあるため、レビューやロールバックができ、チームでも共有できます。ただし、人が自発的にメンテナンスする必要があり、書き留めなかった細かな経験は記憶できません。一方、自動記憶方式は「事前には書くべきだと思いつかなかった」情報を蓄積するのに向いています。
手動メモ:セッション終了時にAIに作業ログを書かせ、次のセッションで参照する方法は、追加のツールに依存せず、最も手軽です。ただし、利用者が忘れずに実行する必要があり、ログが増えれば整理もしなければなりません。セッション単位の記憶の限界に気づいたばかりで、どの程度の機能が必要かまだ分からない人にとって、最も無難な出発点です。
自動要約と検索型記憶:この2種類は自動化の程度が高く、利用頻度の高いユーザーに向いています。ただし、記憶を取り出す精度にはばらつきがあり、古い情報や誤った情報が新しいセッションに持ち込まれることもあります。その場合、原因の調査は説明ファイルよりも困難です。これらの方式を選ぶ際は、後述する「内容を確認できるか、削除できるか」という点が特に重要になります。
セッションをまたぐ記憶の仕組みを選ぶ:6つの判断基準
コミュニティでどのプラグインが勧められていても、以下の6つの基準で評価できます。プラグインを取り巻く環境は変化が速いため、具体的な機能は各プロジェクトの最新ドキュメントを確認してください。
| 判断基準 | 確認すること | 理想的な状態 |
|---|---|---|
| 1. 保存場所 | 記憶はローカル、プロジェクトディレクトリ、リモートサービスのどこに保存されるか? | 機密性の高いプロジェクトではローカルを選べ、データの保存先が明確 |
| 2. 書き込み方法 | 自動抽出、AIによる能動的なツール呼び出し、手動確認のどれで書き込むか? | 重要な記憶は手動で確認できる |
| 3. 呼び出しの仕組み | すべてを注入するか、関連性に基づいて検索するか?呼び出す件数を制御できるか? | 必要に応じて呼び出し、コンテキストを圧迫しない |
| 4. 可観測性 | 保存済みの記憶を確認、編集、削除できるか? | 記憶が読めるテキストとして保存され、いつでも修正できる |
| 5. 適用範囲 | ユーザー、プロジェクト、セッションの各レベルを区別できるか? | 異なるプロジェクトの記憶が混ざらない |
| 6. コストと互換性 | 追加のモデル呼び出しが発生するか?ツールのバージョン更新で使えなくならないか? | コストを見積もることができ、活発にメンテナンスされている |
セッションをまたぐ記憶の保存と書き込み
保存場所によって、プライバシーの境界が決まります。会社や顧客のコードを扱う場合、記憶にはビジネスロジックや内部パス、さらには設定の詳細が含まれる可能性があります。保存先が不明なリモートサービスに保存するのはリスクがあります。また、書き込み方法は記憶の品質を左右します。全自動の書き込みは手軽ですが、ノイズも蓄積しやすくなります。
セッションをまたぐ記憶の呼び出しと管理
呼び出しの仕組みは、使い勝手を左右する重要な要素です。すべてを注入する方法は記憶が少ないうちは便利ですが、記憶が増えるとコンテキストウィンドウを圧迫し、現在のタスクにも悪影響を及ぼします。また、可観測性は管理の前提です。誤った記憶を発見して削除できなければ、新しいセッションを開くたびにAIを繰り返し誤った方向へ導いてしまいます。
コストも見落とされがちなポイントです。自動要約やベクトル検索では追加のモデル呼び出しが発生することがあるため、評価時にはまず小規模に試し、1週間の追加トークン消費量を集計するとよいでしょう。APIYI(apiyi.com)のような統合APIを使えば、同じアカウントで異なる要約モデルの費用を比較でき、どの組み合わせがお得か判断しやすくなります。
セッションをまたぐ記憶の始め方:ツールを変えずに実践できるステップ
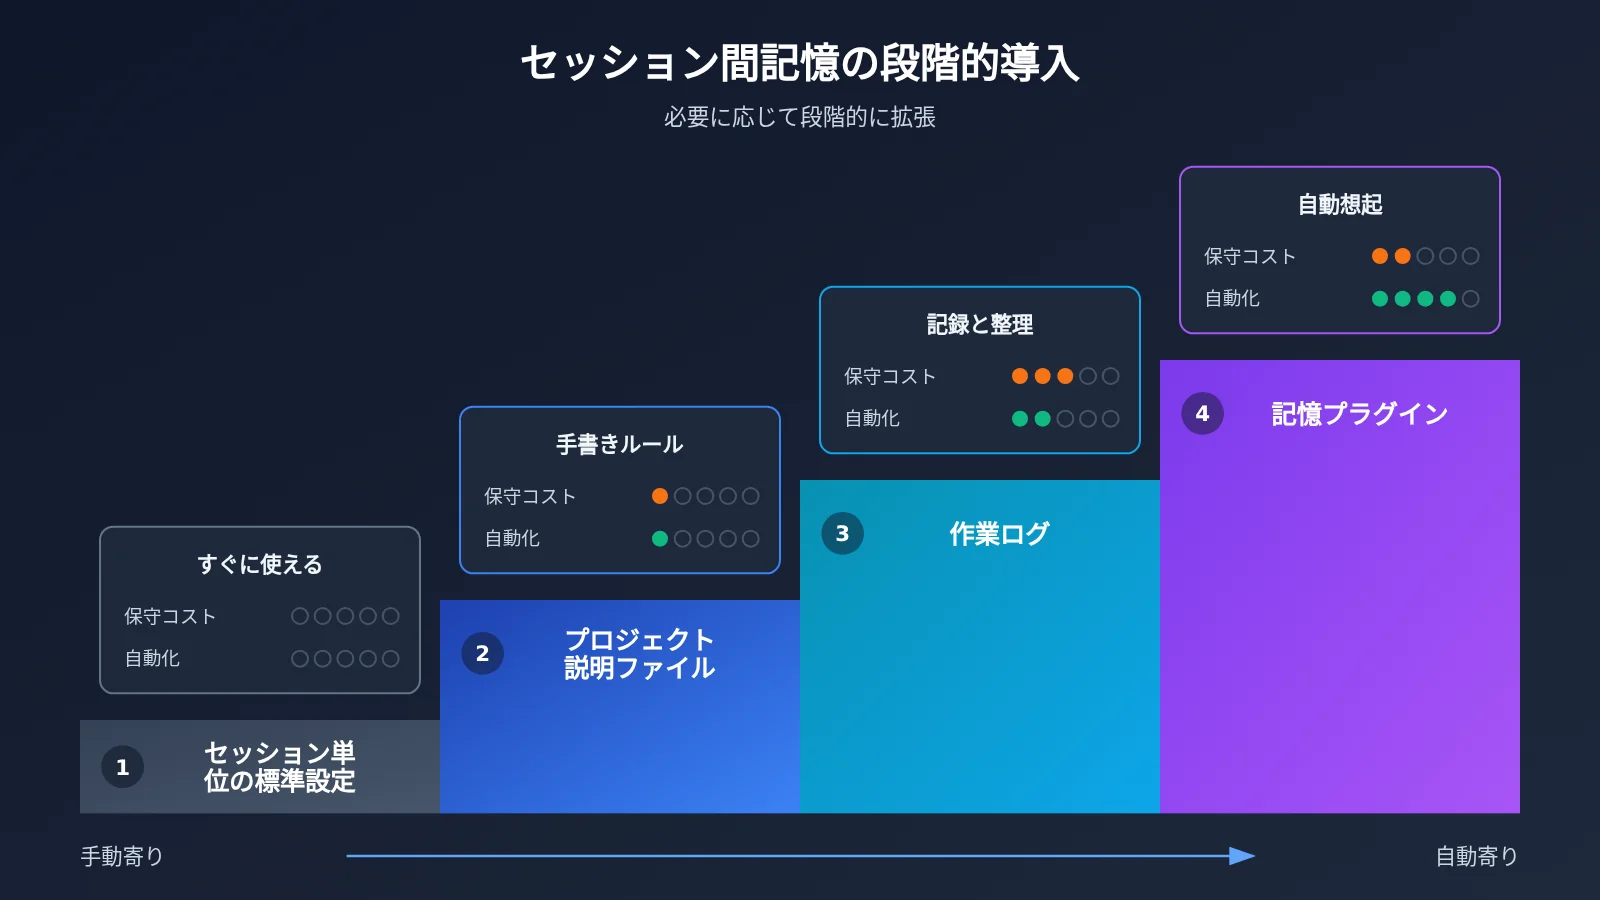
記憶プラグインを選ぶ前に、まずは以下の方法を段階的に試してみましょう。コードを書く必要はなく、特定のプラグインにも依存しません。ほとんどのAIコーディングツールで実践できます。
- ツールに備わっている機能を確認する:使用しているツールの公式ドキュメントを確認し、プロジェクト単位のルールファイル、セッションの復元、MCPなどの拡張機能に対応しているか調べます。同じ機能を重複して用意する手間を省けます。
- プロジェクトの説明ファイルを作る:技術スタック、ディレクトリ構成、命名規則、禁止事項を簡潔にまとめ、プロジェクト内に置いてバージョン管理に含めます。
- セッションの終わりに振り返る習慣をつける:価値のあるタスクを終えるたびに、今回の決定事項、つまずいた点、未完了の項目をAIに決まった形式でまとめてもらい、作業ログに追記します。
- 定期的に整理する:一定期間ごとに、ログに繰り返し登場する長期的に有効な内容を説明ファイルに移し、古くなった内容を削除します。
- プラグインを改めて検討する:1〜2週間試してみて、手動での管理が明らかに負担になるようなら、前述の6つの観点を使って自動化できる記憶プラグインを選びましょう。
作業ログは、以下の表のような構成で記録するのがおすすめです。人が読みやすいだけでなく、AIも新しいセッションで内容をすばやく把握できます。
| 記録項目 | 内容の例 | 説明ファイルへの記載 |
|---|---|---|
| 決定事項 | 採用した状態管理の方式とその理由 | 適している。長期的に有効 |
| つまずいた点 | 特定バージョンの依存ライブラリでビルドが失敗した原因と解決方法 | 状況による。安定したら移す |
| 取り決め | APIのエラーレスポンスの共通フォーマット | 適している |
| 未完了の項目 | あるモジュールのユニットテストが未完成 | 適していない。ログに残す |
| 機密情報 | キー、内部アドレス | 記録禁止。代わりにプレースホルダーで記述 |
🚀 手軽に始めるヒント:ステップ3のセッションの要約とステップ4のログ整理は、比較的低コストのモデルに任せるのに適しています。APIYI apiyi.com の統一インターフェースを通じて複数のモデルの要約品質を試し、どれをコーディングツールや記憶プラグインに設定するか決めるのがおすすめです。
よくある質問 FAQ
Q1:AIコーディングツールのセッション単位の記憶とは何ですか?
AIが現在のセッション内でのみ、それまでの会話や読み取った内容を覚えていることです。新しいセッションを始めると、これらの情報は自動的には引き継がれません。モデル自体は状態を持たないため、ツールが会話履歴をコンテキストウィンドウに再び入力することで「覚えている」状態を実現しています。
Q2:セッション単位の記憶とセッションをまたぐ記憶はどう違いますか?
セッション単位の記憶は、コンテキストをクリーンに保ち、プライバシーの境界を明確にしやすい一方、経験を蓄積できません。セッションをまたぐ記憶は、過去の経験を新しいセッションに引き継げますが、ツールの選定やメンテナンスが必要になり、誤った記憶が繰り返し呼び出されるリスクもあります。
Q3:opencodeの記憶は本当にセッション内でしか有効ではないのですか?
V2EXでは、2026年11月に、別の議論を読んでopencodeの記憶がセッション単位だと気づいたというユーザーの投稿がありました。ただし、その主張の元となった議論は本記事の資料範囲に含まれておらず、ツールも継続的に更新されています。opencodeの公式ドキュメントと、現在使用しているバージョンの実際の動作を確認することをおすすめします。
Q4:セッションをまたぐ記憶はどのような場面に適していますか?
主に次のような場面に適しています。
– **長期的に保守する大規模プロジェクト**:つまずいた経験が多く、あちこちに散らばっているため、あらかじめルールに書き込むのが難しい
– **個人の好みの定着**:自分のコーディングスタイルや習慣をAIに長期的に覚えてほしい
– **複数セッションでの並行開発**:同じプロジェクトの複数のモジュールを同時に進めるため、背景情報を共有する必要がある
使い捨てのスクリプトや、それ単体で完結する小さな問題には、通常は必要ありません。
Q5:記憶プラグインで使う要約モデルや埋め込みモデルを、手軽にテスト・切り替えするにはどうすればよいですか?
多くの記憶ソリューションでは、要約やベクトル化のために別途モデルが必要です。APIYI apiyi.comのような複数モデルの集約プラットフォームを使えば、統一された呼び出し方法でモデルごとの効果やコストを比較し、適切なものを確認してからプラグインに設定できます。具体的な接続パラメータは、プラットフォームのドキュメント docs.apiyi.com とプラグインの説明を確認してください。
Q6:セッションをまたぐ記憶によって、トークンコストは大幅に増えますか?
増える可能性があります。呼び出された記憶は毎回コンテキストを消費し、自動要約にも追加のモデル呼び出しが発生します。まずは呼び出す記憶の件数を抑え、試用期間中に追加の消費量を計測することをおすすめします。APIYI apiyi.comの統一された請求画面を活用すれば、異なるモデルの組み合わせによるコストをより直感的に比較できます。
Q7:セッションをまたぐ記憶には、どのようなリスクや欠点がありますか?
主に3つあります。1つ目は、誤った記憶や古い記憶が新しいセッションを継続的に誤った方向へ導くことです。2つ目は、記憶にキーや内部パスなどの機密情報が混入する可能性があることです。3つ目は、ツールのバージョン更新によってプラグインが動作しなくなる可能性があることです。対策として、記憶を確認・削除できる方法を選び、定期的に整理するとともに、機密情報を記録しないようにしましょう。
セッション内メモリとセッションをまたぐメモリの要点 Key Takeaways
- セッション内メモリの仕組み:モデルはステートレスであり、ツールが履歴を再送することで、セッション内で「覚えている」状態を実現する
- 導入前に課題を見極める:規約を何度も説明する手間は、説明ファイルだけで解消できることが多い
- 4つのアプローチ:説明ファイル、手動ログ、自動要約、検索型メモリストアにはそれぞれトレードオフがある
- 6つの評価軸:保存場所、書き込み方法、想起の仕組み、可観測性、適用範囲、コストと互換性
- 全自動より削除できることが重要:修正できない誤った記憶は、新しいセッションでも繰り返し問題を引き起こす
- 段階的に導入する:説明ファイルから始め、作業ログを追加し、必要に応じてメモリプラグインへ移行する
- モデルは試してから選べる:要約モデルと埋め込みモデルは、APIYI apiyi.com の統一インターフェースを使って比較できる
まとめ
AIコーディングツールのセッション内メモリについて、押さえておきたいポイントは次のとおりです。
- 限界を理解する:セッション内メモリは欠陥ではなく、デフォルトの設計です。クリーンなコンテキストを得られる一方、経験は自動的には蓄積されません。
- まずは低コストな方法を試す:プロジェクトの説明ファイルと作業ログを組み合わせれば、「毎回説明し直す」という悩みの多くに対応できます。
- 評価軸に沿ってプラグインを選ぶ:セッションをまたぐメモリの自動化が本当に必要になったら、保存場所、書き込み、想起、可観測性、適用範囲、コストの6つの軸で評価しましょう。
opencodeのようなツールを使っていて、「どのメモリプラグインを入れよう」と迷っているなら、プラグインの一覧を見るよりも、何を覚えさせ、どこに保存し、どう削除するかを考えることが大切です。プラグインのエコシステムは変化が速いため、選ぶ前に公式ドキュメントやコミュニティの実際の利用報告も確認しましょう。
メモリの仕組みに要約モデルや埋め込みモデルを組み込む場合は、APIYI apiyi.com を通じて小規模な比較テストを行ってから、最終的な構成を決めることをおすすめします。
📚 参考資料
- V2EX 質問と回答:opencode を使っている皆さん、どのメモリプラグインを入れていますか?:この記事のきっかけとなった質問
- リンク:
v2ex.com/t/1254245 -
説明:ユーザーが opencode のメモリはセッション単位なのかという疑問を投稿しています。元の投稿には質問のみが掲載されており、コミュニティからの回答は投稿ページをご確認ください。
-
opencode 公式ドキュメント:メモリ、ルールファイル、拡張機能に関する説明
- リンク:opencode 公式サイトまたはオープンソースリポジトリの最新ドキュメントをご確認ください。
- 説明:この記事では公式のメモリ機構に関する説明をすべて網羅しているわけではありません。選定前に公式ドキュメントを確認することをおすすめします。
著者:APIYI 技術チーム
技術交流:AI コーディングツールやモデル選定に関する情報交換は、APIYI apiyi.com のトップページからお気軽にお問い合わせください。詳しい資料は docs.apiyi.com のドキュメントセンターをご覧ください。