Примечание автора: пользователь opencode обнаружил, что «память работает только в рамках сессии», и задался вопросом, как это исправить. Разберём, что такое память на уровне сессии, в чём её ограничения и по каким 6 критериям выбирать решение для памяти между сессиями.
Если вы часто пользуетесь AI-инструментами для программирования вроде opencode, вам может быть знакома такая ситуация: вчера вы долго обсуждали с AI правила проекта, а сегодня открыли новую сессию — и он снова задаёт те же вопросы, словно видит вас впервые. В ноябре 2026 года пользователь V2EX написал, что после прочтения другой дискуссии обнаружил: память opencode действует только в рамках сессии. И спросил, какой плагин памяти стоит установить.
Это не показалось одному пользователю — и проблема касается не только одного инструмента. Память на уровне сессии — стандартный принцип работы многих AI-инструментов для программирования. Стоит уточнить: исходный пост состоял всего из одного предложения, обсуждение, на которое он ссылался, не входит в наши материалы, а за полным описанием механизма памяти opencode лучше обратиться к официальной документации. Поэтому мы не будем рекомендовать конкретные плагины, а разберём вопросы, которые стоит задать при выборе решения для памяти между сессиями.
Главная польза: прочитав статью, вы сможете понять, действительно ли вам нужна память между сессиями, и оценить любой плагин памяти или альтернативное решение по 6 критериям. Это поможет избежать ситуации, когда установленный плагин только запутывает контекст.
Что такое память на уровне сессии в инструментах для AI-программирования
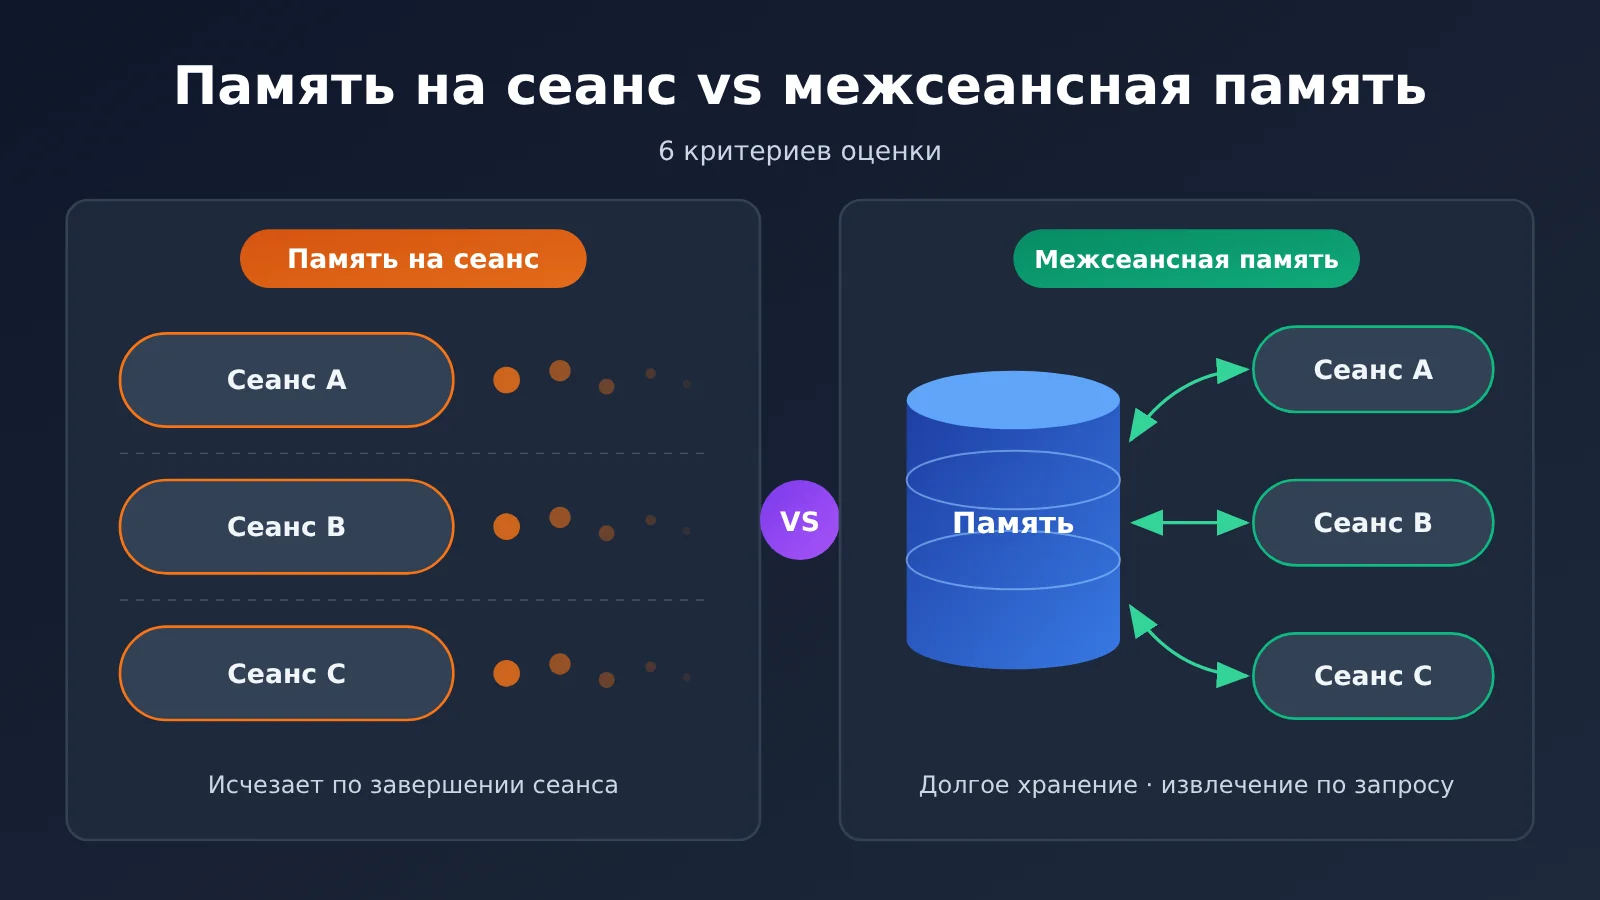
«Память на уровне сессии» — не строгий технический термин. В сообществе им обычно описывают ситуацию, когда AI помнит сказанное в рамках одного диалога, но не переносит эти сведения автоматически в новую сессию. Чтобы разобраться, сначала разделим несколько видов «памяти», которые часто путают.
| Уровень памяти | Как работает | Что это значит для пользователя |
|---|---|---|
| Контекстное окно | Всё содержимое, которое модель видит в рамках одного запроса, включая историю сообщений и прочитанные файлы | Главный источник «памяти» внутри сессии; его размер ограничен |
| История сессии | Инструмент сохраняет сообщения одной сессии, чтобы их можно было просмотреть или продолжить диалог | Позволяет восстановить отдельную сессию, но автоматически не влияет на новые |
| Инструкции уровня проекта | Файлы с правилами внутри проекта, которые инструмент читает при запуске | Самый надёжный способ задать «долгосрочные договорённости», но их нужно поддерживать вручную |
| Память между сессиями | Информация, которая извлекается, сохраняется и возвращается автоматически или полуавтоматически | Позволяет использовать прошлый опыт в новых сессиях, но требует выбора решения и управления им |
Как работает память на уровне сессии
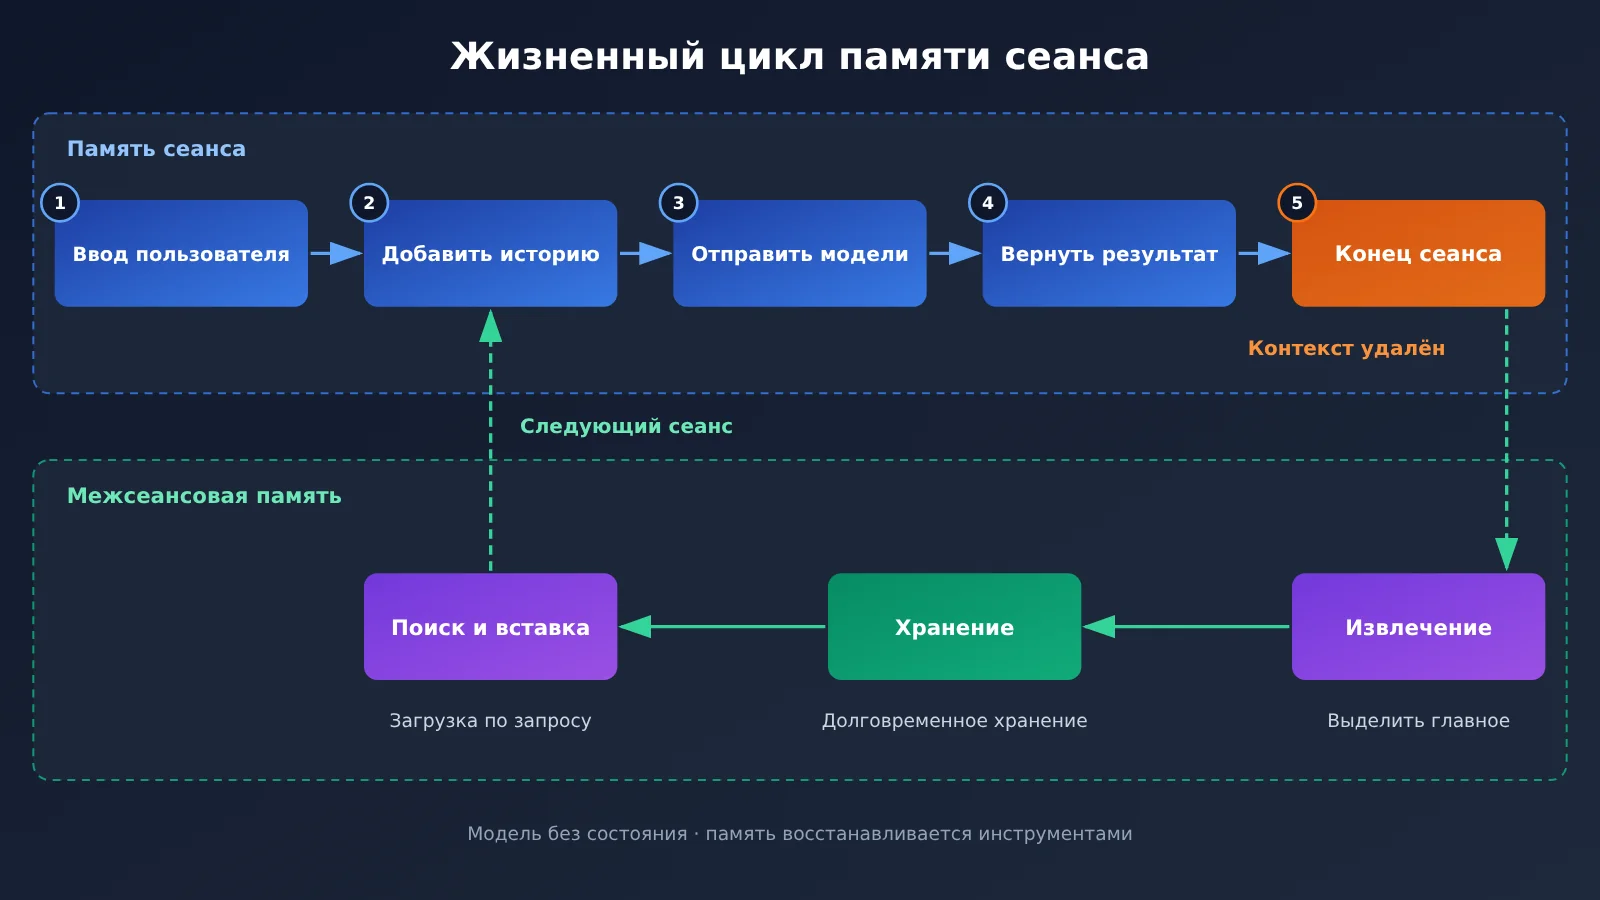
Большая языковая модель сама по себе не хранит состояние. При каждом запросе инструмент должен отправить ей историю диалога, системные инструкции и содержимое нужных файлов — только тогда модель «узнаёт», что произошло раньше. По сути, память внутри сессии работает благодаря тому, что инструмент постоянно добавляет историю обратно в контекстное окно.
Это значит, что после завершения сессии новая начинается с чистого листа — если только инструмент специально не сохранил часть информации отдельно и не загрузил её при следующем запуске. Чем дольше длится сессия и чем больше в ней истории, тем вероятнее, что инструмент сожмёт или обрежет её. Поэтому ранние детали могут «забыться» даже в рамках одной сессии.
Ограничения памяти на уровне сессии
У такой памяти три основные проблемы. Во-первых, приходится повторяться: в каждой новой сессии заново рассказывать о технологическом стеке, соглашениях по именованию и запрещённых зависимостях. Во-вторых, опыт не накапливается: если вы нашли решение после долгих поисков, при следующей похожей проблеме AI о нём не узнает. В-третьих, дорого обходится переключение между задачами: если открыть несколько сессий для работы над разными модулями одного проекта, общего контекста между ними не будет.
Но есть и преимущества: контекст остаётся чистым, старые ошибочные предположения не влияют на новую задачу, а границы конфиденциальности понятнее. Всё это стоит учитывать при выборе решения.
Зачем нужна память между сессиями: сначала разберитесь, нужна ли она вам
Плагин памяти между сессиями нужен не всем. Многие узнают, что «память ограничена одной сессией», и сразу устанавливают плагин. В итоге появляется ещё одна система, которую нужно поддерживать, а заметной пользы от неё нет. Для начала посмотрите на признаки в таблице.
| Признак | Нужна ли память между сессиями | Что лучше сделать |
|---|---|---|
| В каждой новой сессии приходится заново объяснять правила проекта | Не обязательно | Сначала создайте файл с инструкциями на уровне проекта |
| Вы долго работаете над одним крупным проектом и накопили много опыта решения проблем | Да | Рассмотрите решение с поиском по памяти |
| Большинство задач — разовые скрипты или отдельные небольшие вопросы | Нет | Достаточно памяти в рамках сессии |
| Несколько человек в команде используют одни и те же договорённости для работы с ИИ | Отчасти | Поместите договорённости в репозиторий и храните их под контролем версий |
| В работе используются код клиентов, ключи и другие конфиденциальные данные | С осторожностью | Предпочтите локальное хранение или записывайте только обезличенные данные |
| Вы хотите, чтобы ИИ помнил ваши предпочтения в написании кода | Да | Используйте память на уровне пользователя отдельно от памяти проекта |
На практике необходимость постоянно объяснять правила проекта — самая распространённая проблема. Но по большей части её решает один хорошо поддерживаемый файл с инструкциями. Автоматизированная память между сессиями обычно нужна для разрозненных знаний, которые накапливаются в долгосрочном проекте и которые трудно заранее записать: например, для сведений о странном поведении конкретного интерфейса или настоящей причине сбоя сборки.
Есть и ещё один момент, о котором легко забыть: чем больше записей в памяти, тем больше информации каждый раз добавляется в контекст и тем больше расходуется токенов. Для извлечения и краткого изложения записей из памяти часто требуются дополнительные вызовы модели. Если вы хотите заранее оценить качество и стоимость суммаризации разными моделями, через единый интерфейс APIYI apiyi.com можно сравнить несколько популярных моделей, используя один и тот же способ вызова.
4 подхода к памяти между сессиями
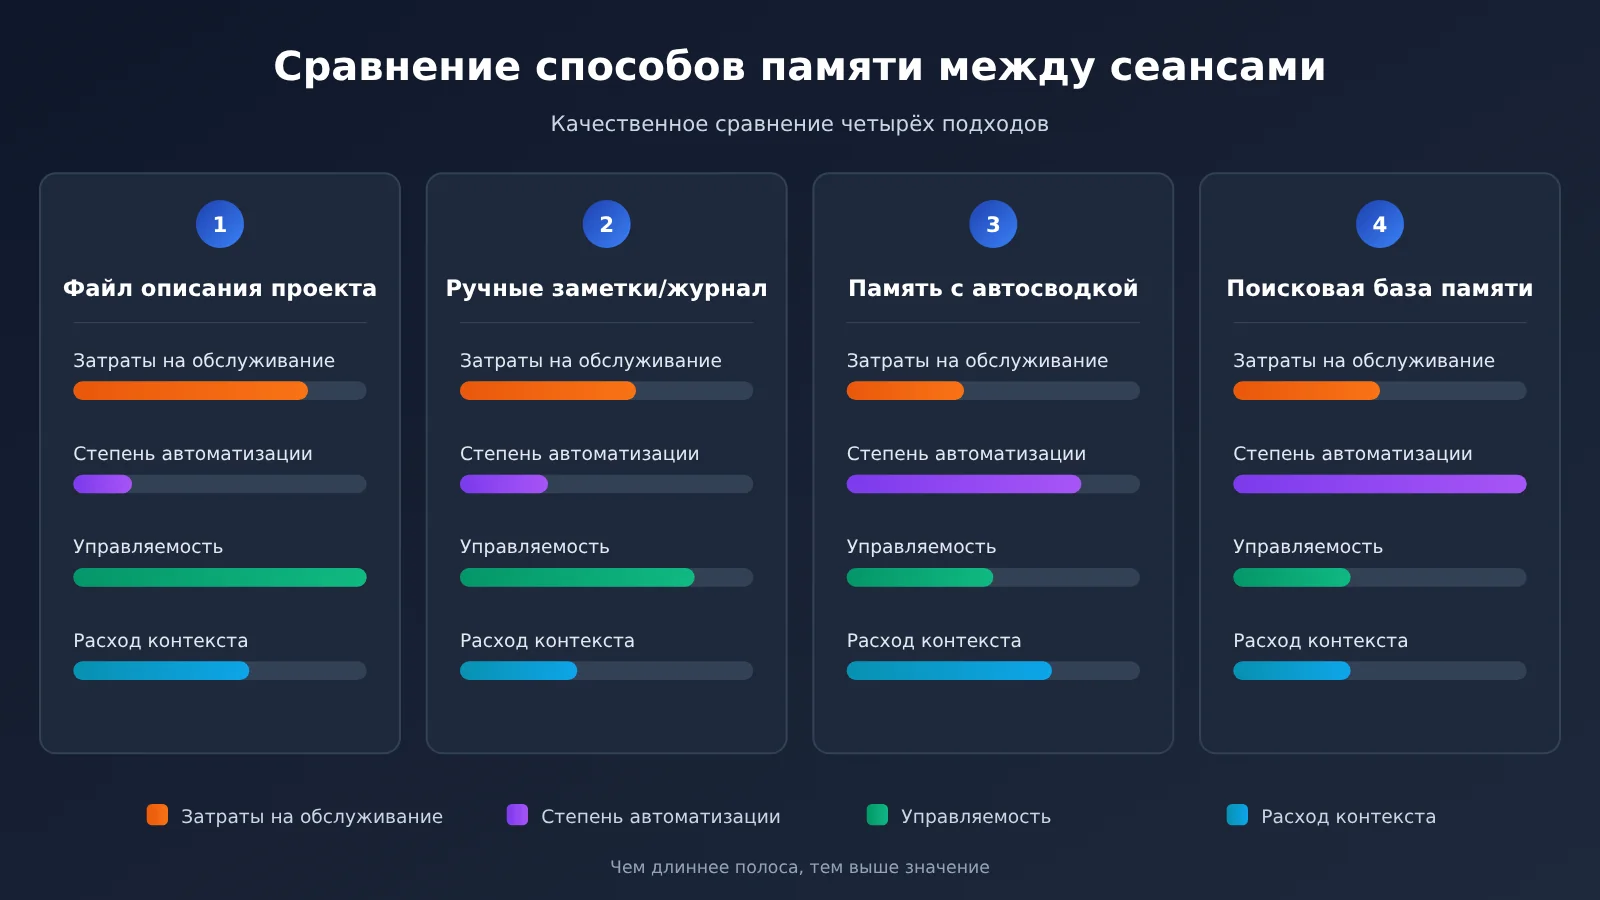
Поскольку ответы сообщества под исходным постом и сведения о конкретных плагинах выходят за рамки материалов этой статьи, разделим распространённые решения на 4 категории по принципу работы. При оценке любого плагина памяти сначала определите, к какой категории он относится, а затем изучите его компромиссы.
| Тип решения | Главная особенность | Когда подходит | Что необходимо |
|---|---|---|---|
| Файл с инструкциями проекта | Правила пишутся вручную и целиком загружаются при запуске | Стабильные правила, совместная работа команды | Поддержка чтения файлов с правилами |
| Ручные заметки / рабочий журнал | В конце сессии ИИ пишет сводку, которую вручную подключают в следующий раз | Личные проекты, простые задачи | Способность модели составлять сводки |
| Автоматические сводки | Инструмент или плагин автоматически выделяет ключевые моменты и сохраняет их | Частая работа, нежелание вести записи вручную | Модель для составления сводок, которую можно подключить через платформы вроде APIYI |
| База памяти с поиском | Записи хранятся в векторном виде и извлекаются по релевантности | Крупные долгосрочные проекты, большой объём накопленного опыта | Модель эмбеддингов и хранилище; часто подключается как расширение через MCP или аналогичные средства |
Пояснение к диаграмме: выше приведено качественное сравнение подходов, а не результаты тестирования конкретных плагинов. Если нужно на практике проверить модели для автоматического составления сводок или поиска записей, можно использовать APIYI apiyi.com для переключения между моделями и их сравнения.
Сравнение решений для памяти между сессиями
Файл с инструкциями проекта: этот вариант лидирует по управляемости и прозрачности. Инструкции хранятся в репозитории, их можно проверять, откатывать и использовать всей командой. Но файл нужно поддерживать вручную, а разрозненный опыт, который в него не записали, останется за бортом. Автоматические решения лучше подходят для накопления информации, которую заранее не пришло бы в голову записать.
Ручные заметки: попросить ИИ составить рабочий журнал в конце сессии и подключить его в следующей — самый дешёвый способ, не требующий дополнительных инструментов. Но он зависит от дисциплины пользователя, а по мере накопления журналов их придётся приводить в порядок. Для тех, кто только столкнулся с ограничениями памяти отдельных сессий и пока не знает, насколько серьёзно нуждается в решении, это самый надёжный старт.
Автоматические сводки и база памяти с поиском: эти подходы лучше автоматизированы и подходят тем, кто работает с ИИ интенсивно. Но качество извлечения записей бывает разным: в новую сессию могут попасть устаревшие или ошибочные сведения, а разобраться в проблеме будет сложнее, чем при работе с файлом инструкций. При выборе такого решения особенно важно, чтобы записи можно было просматривать и удалять. Подробнее об этом — далее.
Как выбрать решение для памяти между сессиями: 6 критериев
Какой бы плагин ни рекомендовало сообщество, его можно оценить по шести критериям ниже. Экосистема плагинов быстро меняется, поэтому актуальные возможности лучше проверять в документации каждого проекта.
| Критерий | Что спросить | Идеальный вариант |
|---|---|---|
| 1. Место хранения | Память хранится локально, в каталоге проекта или на удалённом сервисе? | Для чувствительных проектов можно выбрать локальное хранение; понятно, куда попадают данные |
| 2. Способ записи | Данные извлекаются автоматически, ИИ сам вызывает инструмент для записи или требуется подтверждение человека? | Важные записи можно подтвердить вручную |
| 3. Механизм извлечения | В контекст добавляется вся память или записи ищутся по релевантности? Можно ли управлять их количеством? | Извлечение по необходимости, без переполнения контекста |
| 4. Наблюдаемость | Можно ли просматривать, редактировать и удалять существующие записи? | Память хранится в читаемом виде и её можно исправить в любой момент |
| 5. Область действия | Разделяется ли память на пользовательскую, проектную и сессионную? | Память разных проектов не смешивается |
| 6. Стоимость и совместимость | Требуются ли дополнительные вызовы моделей? Не перестанет ли решение работать после обновления инструмента? | Расходы можно оценить, а проект активно поддерживается |
Хранение и запись памяти между сессиями
Место хранения определяет границы приватности. Если вы работаете с кодом компании или клиента, память, скорее всего, будет содержать бизнес-логику, внутренние пути и даже детали конфигурации. Хранить всё это на удалённом сервисе, когда непонятно, куда попадают данные, рискованно. Способ записи, в свою очередь, влияет на качество памяти: полностью автоматическая запись удобна, но при ней легче всего накапливается шум.
Извлечение памяти между сессиями и управление ею
Механизм извлечения во многом определяет удобство работы. Пока записей мало, добавление всей памяти в контекст работает хорошо. Но по мере роста объёма память начинает занимать место в контекстном окне и мешать решению текущей задачи. Наблюдаемость необходима для управления памятью: если ошибочную запись нельзя обнаружить и удалить, она будет снова и снова вводить ИИ в заблуждение в каждой новой сессии.
Затраты часто недооценивают. Автоматическое суммирование и векторный поиск могут требовать дополнительных вызовов моделей. При оценке решения можно сначала провести небольшой тест и подсчитать дополнительный расход токенов за неделю. При использовании агрегаторов API, таких как APIYI apiyi.com, можно сравнить в одном аккаунте стоимость разных моделей для суммирования и понять, какое сочетание выгоднее.
Память между сессиями: как начать, не меняя инструменты
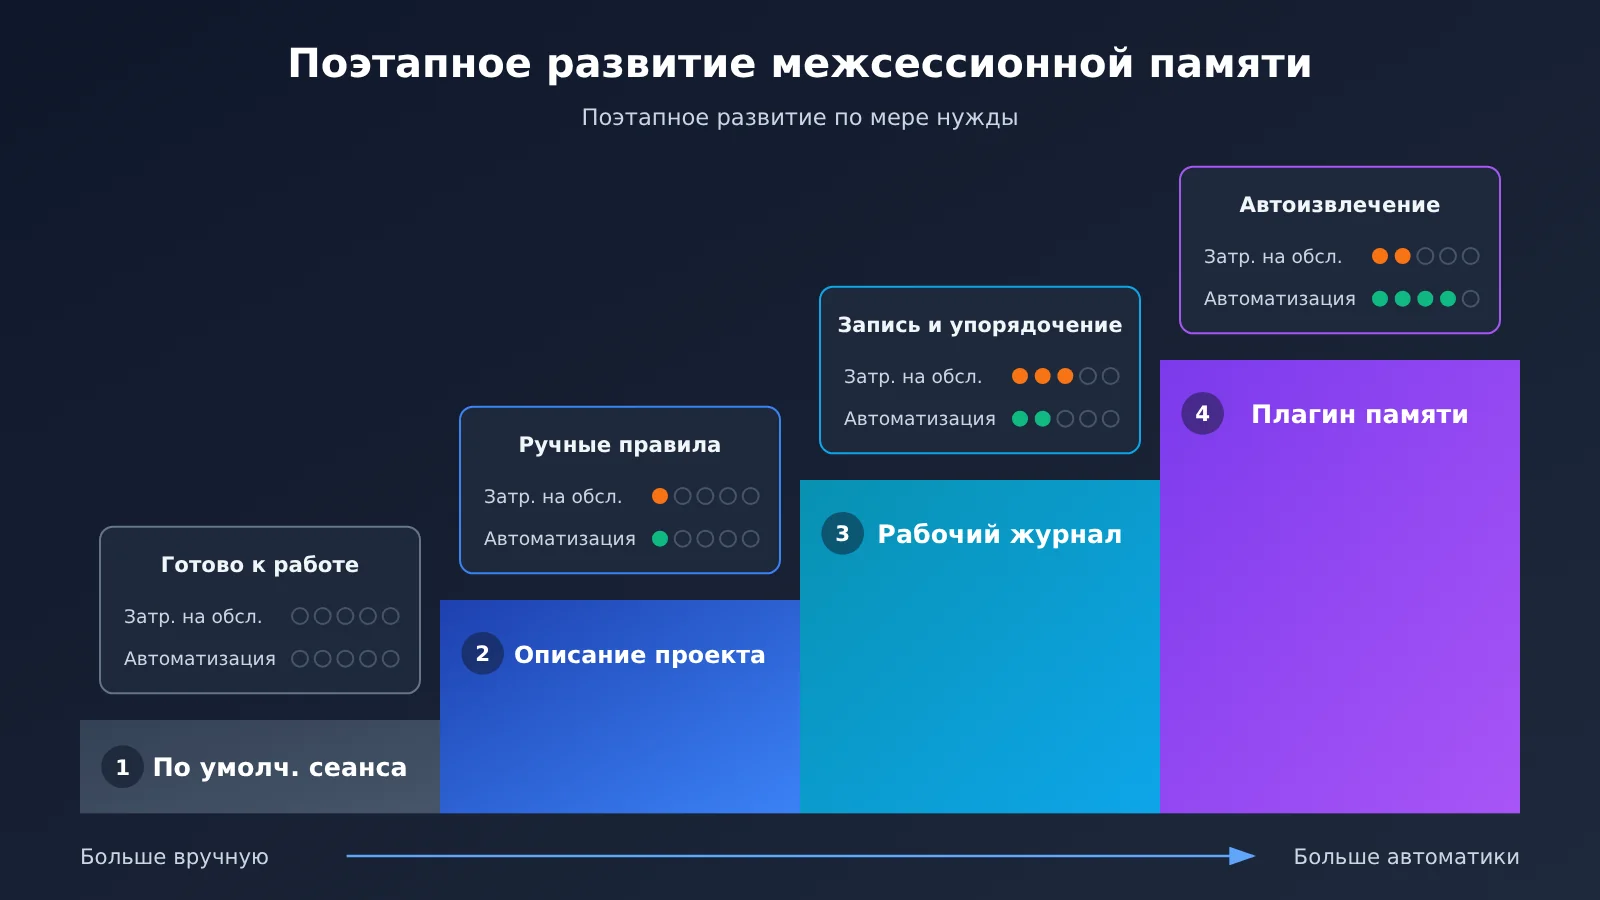
Прежде чем выбирать плагин памяти, попробуйте внедрить её постепенно. Для этого не нужно писать код или устанавливать конкретный плагин — подход совместим с большинством AI-инструментов для программирования.
- Проверьте возможности инструмента: изучите официальную документацию и выясните, поддерживает ли он файлы правил проекта, восстановление сессий, расширения MCP и другие функции. Это поможет не изобретать велосипед.
- Создайте файл с описанием проекта: кратко опишите в нём технологический стек, структуру каталогов, правила именования и ограничения. Разместите файл в проекте и добавьте в систему контроля версий.
- Заводите привычку подводить итоги сессии: после каждой значимой задачи просите AI в заданном формате обобщить принятые решения, возникшие проблемы и незавершённые задачи. Добавляйте итог в рабочий журнал.
- Регулярно наводите порядок: время от времени переносите из журнала в файл описания повторяющиеся сведения, которые будут актуальны долгое время, а устаревшие записи удаляйте.
- Затем оцените необходимость плагина: если через одну-две недели станет понятно, что поддерживать записи вручную слишком сложно, выберите плагин для автоматизации памяти по шести критериям, рассмотренным выше.
Записи в рабочем журнале удобно оформлять по структуре из таблицы: так их будет проще читать и людям, и AI в новой сессии.
| Тип записи | Пример | Стоит ли добавлять в файл описания |
|---|---|---|
| Решение | Выбор подхода к управлению состоянием и его причины | Да, если решение действует долго |
| Проблема | Ошибка сборки с определённой версией зависимости и способ её решения | Зависит от ситуации; можно перенести, когда решение проверено |
| Соглашение | Единый формат ошибок API | Да |
| Задача | Для одного из модулей ещё не дописаны юнит-тесты | Нет, оставить в журнале |
| Конфиденциальные данные | Ключи, внутренние адреса | Записывать запрещено; используйте вместо них описательные заполнители |
🚀 Совет для быстрого старта: подведение итогов сессии на шаге 3 и整理 журнала на шаге 4 можно поручить недорогой модели. Попробуйте через APIYI apiyi.com несколько моделей с единым интерфейсом, сравните качество их итогов и выберите подходящую для инструмента программирования или плагина памяти.
Частые вопросы FAQ
Q1: Что такое память в рамках сессии в инструментах программирования с ИИ?
Это означает, что ИИ помнит предыдущие сообщения и прочитанные материалы только в текущей сессии. При открытии новой сессии эта информация не переносится автоматически. Причина в том, что сама модель не сохраняет состояние: чтобы она «помнила» прошлое, инструмент заново помещает историю в контекстное окно.
Q2: Чем память в рамках сессии отличается от памяти между сессиями?
Память в рамках сессии помогает сохранять контекст чистым, а границы приватности — понятными, но не позволяет накапливать опыт. Память между сессиями переносит прошлый опыт в новые сессии, однако её нужно выбирать и поддерживать, а ещё есть риск, что ошибочные воспоминания будут извлекаться снова и снова.
Q3: Правда ли, что память opencode действует только в рамках одной сессии?
В ноябре 2026 года пользователь V2EX написал, что узнал об этом из другого обсуждения. Однако исходное обсуждение не входит в круг источников этой статьи, а инструмент постоянно обновляется. Лучше ориентироваться на официальную документацию opencode и поведение установленной у вас версии.
Q4: Для каких задач лучше всего подходит память между сессиями?
В основном для следующих:
— **Крупные проекты с долгосрочной поддержкой**: накопленный опыт решения проблем обширен и разрознен, поэтому его трудно заранее описать в правилах
— **Закрепление личных предпочтений**: ИИ должен надолго запомнить ваш стиль кода и привычки
— **Параллельная разработка в нескольких сессиях**: над разными модулями одного проекта работают одновременно и им нужен общий контекст
Для разовых скриптов и небольших отдельных задач такая память обычно не нужна.
Q5: Как удобно тестировать и переключать модели для создания сводок или эмбеддингов, используемые плагином памяти?
Многим решениям для памяти нужны дополнительные модели для создания сводок или векторизации. На платформе, объединяющей несколько моделей, например APIYI apiyi.com, можно сравнить результаты и затраты при едином способе вызова, а затем настроить подходящую модель в плагине. Параметры подключения уточняйте в документации платформы docs.apiyi.com и инструкции к плагину.
Q6: Может ли память между сессиями заметно увеличить расходы на токены?
Да, может. Извлечённые записи каждый раз занимают место в контексте, а автоматическое создание сводок требует дополнительных вызовов. Для начала стоит ограничить количество извлекаемых записей и подсчитать дополнительные расходы за пробный период. Единый обзор расходов в APIYI apiyi.com поможет нагляднее сравнить стоимость разных сочетаний моделей.
Q7: Каковы известные риски и недостатки памяти между сессиями?
Основных риска три: ошибочные или устаревшие записи могут постоянно вводить новые сессии в заблуждение; в память могут попасть конфиденциальные данные, например ключи и внутренние пути; плагин может перестать работать после обновления инструмента. Чтобы снизить риски, выбирайте решение, в котором можно просматривать и удалять записи, регулярно очищайте память и не сохраняйте конфиденциальные данные.
Главное о памяти внутри сессии и между сессиями
- Суть памяти внутри сессии: модель не сохраняет состояние, а инструмент помогает ей «помнить» разговор, повторно передавая его историю.
- Сначала разберитесь, потом устанавливайте: если приходится снова и снова объяснять правила, проблему часто решает файл с инструкциями.
- Четыре подхода: файл с инструкциями, журнал вручную, автоматические сводки и база памяти с поиском — у каждого свои плюсы и минусы.
- Шесть критериев выбора: место хранения, способ записи, механизм извлечения, прозрачность работы, область действия, стоимость и совместимость.
- Возможность удаления важнее полной автоматизации: если ошибочную запись нельзя исправить, ошибка будет повторяться в каждой новой сессии.
- Постепенное внедрение: начните с файла инструкций, затем добавьте рабочий журнал и при необходимости перейдите к плагину памяти.
- Модели можно сначала протестировать: сравнить модели для сводок и эмбеддингов поможет единый интерфейс APIYI apiyi.com.
Итоги
Главное о памяти AI-инструментов для программирования:
- Понимайте ограничения: память внутри сессии — не недостаток, а принцип работы по умолчанию. Он позволяет начинать с чистым контекстом, но накопленный опыт не сохраняется автоматически.
- Начните с недорогого решения: файл с инструкциями по проекту и рабочий журнал избавят от необходимости каждый раз объяснять одно и то же в большинстве случаев.
- Выбирайте плагин по критериям: если действительно нужна автоматическая память между сессиями, оцените хранение, запись, извлечение, прозрачность работы, область действия и стоимость.
Если вы пользуетесь инструментом вроде opencode и выбираете плагин памяти, важнее списка плагинов понять, что именно нужно запоминать, где это хранить и как удалять. Экосистема плагинов быстро меняется, поэтому перед выбором изучите официальную документацию и отзывы пользователей.
Если для решения нужны модели для сводок или эмбеддингов, рекомендуем сначала провести небольшое сравнительное тестирование через APIYI apiyi.com и только потом определиться с конфигурацией.
📚 Источники
- V2EX, вопросы и ответы: какой плагин памяти вы используете с opencode? — вопрос, с которого начинается эта статья
- Ссылка:
v2ex.com/t/1254245 -
Примечание: пользователь задаётся вопросом, почему память opencode ограничена одной сессией. В исходном посте содержится только вопрос; ответы сообщества можно прочитать на странице обсуждения.
-
Официальная документация opencode — описание памяти, файлов правил и возможностей расширения
- Ссылка: актуальную документацию ищите на официальном сайте opencode или в репозитории проекта
- Примечание: в статье не рассмотрено полное описание механизма памяти из официальной документации. Рекомендуем ознакомиться с ним, прежде чем делать выбор.
Автор: техническая команда APIYI
Техническое общение: свяжитесь с нами через главную страницу сайта APIYI apiyi.com, чтобы обсудить инструменты для программирования с помощью ИИ и поделиться опытом выбора моделей. Дополнительные материалы доступны в центре документации docs.apiyi.com.