Catatan penulis: Berangkat dari kebingungan pengguna opencode yang mendapati bahwa “memori hanya berlaku dalam sesi”, artikel ini menjelaskan arti dan keterbatasan memori tingkat sesi, serta 6 dimensi untuk memilih solusi memori lintas sesi.
Kalau kamu sering memakai alat pemrograman AI seperti opencode, mungkin pernah mengalami situasi ini: kemarin kamu berdiskusi panjang dengan AI tentang konvensi proyek, tetapi ketika membuka sesi baru hari ini, ia menanyakannya lagi seolah-olah baru pertama kali bertemu. Pada November 2026, seorang pengguna V2EX bertanya setelah membaca diskusi lain dan menyadari bahwa memori opencode berlaku pada tingkat sesi. Ia pun ingin tahu plugin memori apa yang dipakai pengguna lain.
Ini bukan sekadar perasaan satu pengguna, dan bukan pula masalah satu alat saja. Memori tingkat sesi adalah cara kerja bawaan banyak alat pemrograman AI. Perlu dicatat, postingan aslinya hanya terdiri dari satu kalimat, sementara diskusi yang dirujuk tidak termasuk dalam bahan yang kami tinjau. Untuk penjelasan lengkap tentang mekanisme memori opencode, pembaca juga perlu merujuk ke dokumentasi resminya. Karena itu, artikel ini tidak merekomendasikan plugin tertentu, melainkan menjelaskan pertanyaan yang perlu diajukan saat memilih solusi memori lintas sesi.
Manfaat utama: Setelah membaca artikel ini, kamu bisa menilai apakah benar-benar membutuhkan memori lintas sesi dan menggunakan 6 dimensi untuk mengevaluasi plugin memori atau pendekatan alternatif apa pun, agar pemasangan plugin tidak malah membuat konteks berantakan.
Apa itu memori tingkat sesi pada alat pemrograman AI
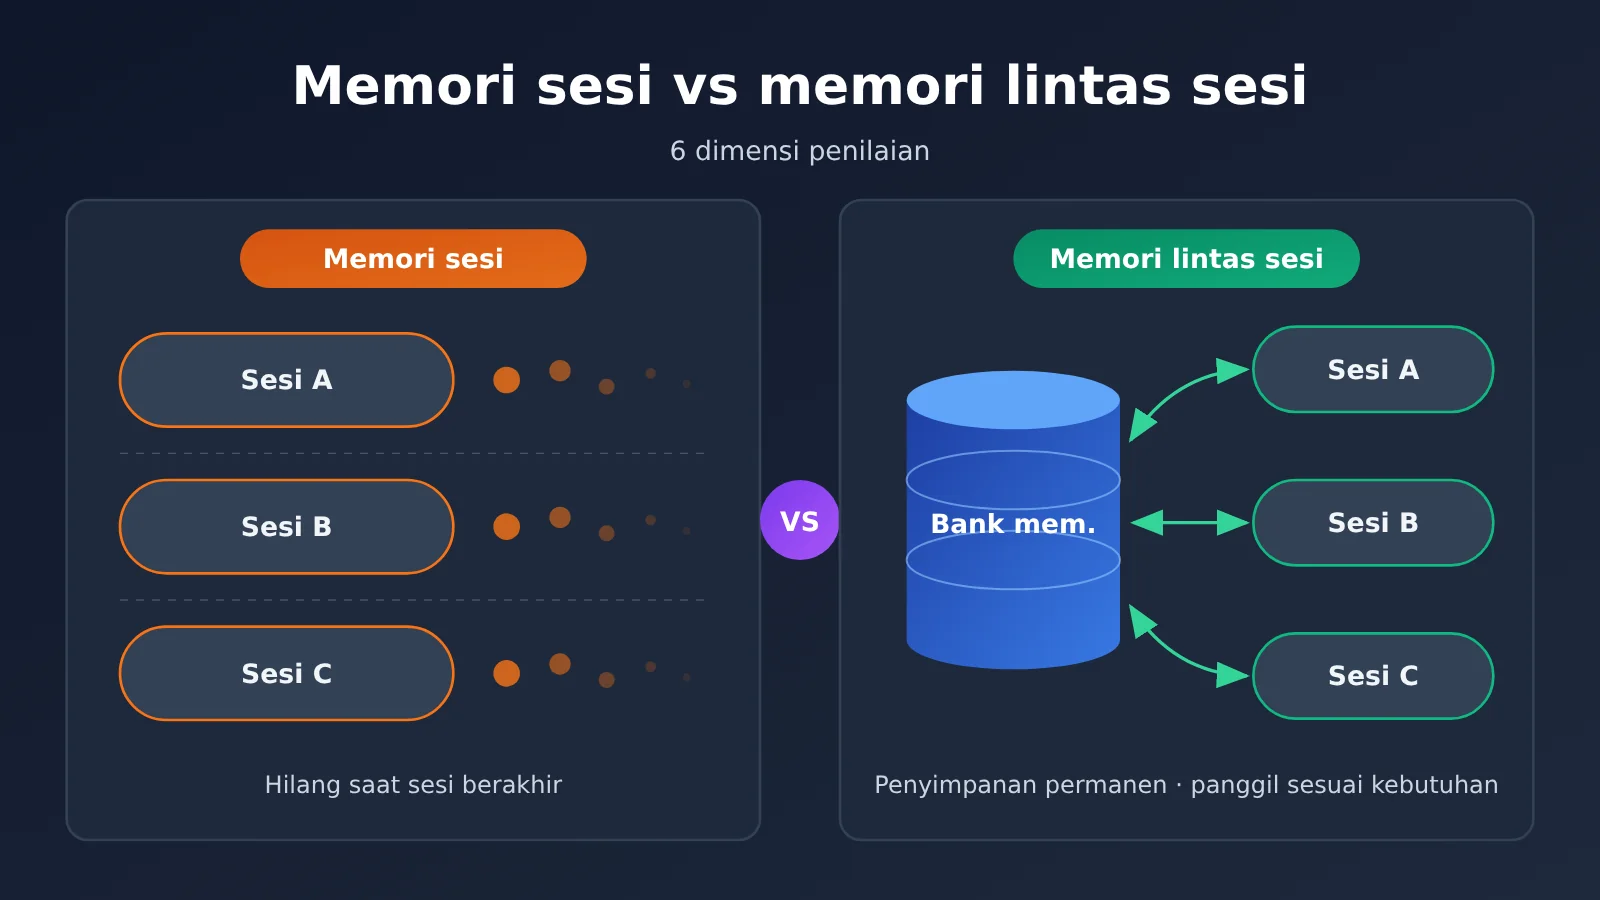
“Memori tingkat sesi” bukan istilah teknis yang baku. Komunitas biasanya menggunakannya untuk menggambarkan situasi ketika AI mengingat apa yang Anda katakan dalam satu percakapan, tetapi informasi itu tidak otomatis terbawa ke sesi baru. Untuk memahaminya, kita perlu membedakan beberapa jenis “memori” yang sering dianggap sama.
| Tingkat memori | Penjelasan | Artinya bagi pengguna |
|---|---|---|
| Jendela konteks | Semua konten yang dapat dilihat model dalam satu permintaan, termasuk riwayat pesan dan file yang dibaca | Sumber utama kemampuan “mengingat” dalam sesi, tetapi kapasitasnya terbatas |
| Riwayat sesi | Alat menyimpan pesan dalam sesi yang sama agar bisa dilihat kembali atau dilanjutkan | Sesi tertentu dapat dipulihkan, tetapi tidak otomatis memengaruhi sesi baru |
| Instruksi tingkat proyek | File aturan yang ditulis di dalam proyek dan dibaca saat alat dijalankan | “Kesepakatan jangka panjang” yang paling stabil, tetapi perlu dikelola secara manual |
| Memori lintas sesi | Informasi yang diekstrak, disimpan, dan dipanggil kembali secara otomatis atau semiotomatis | Membawa pengalaman lama ke sesi baru, tetapi membutuhkan pemilihan solusi dan pengelolaan |
Cara kerja memori tingkat sesi
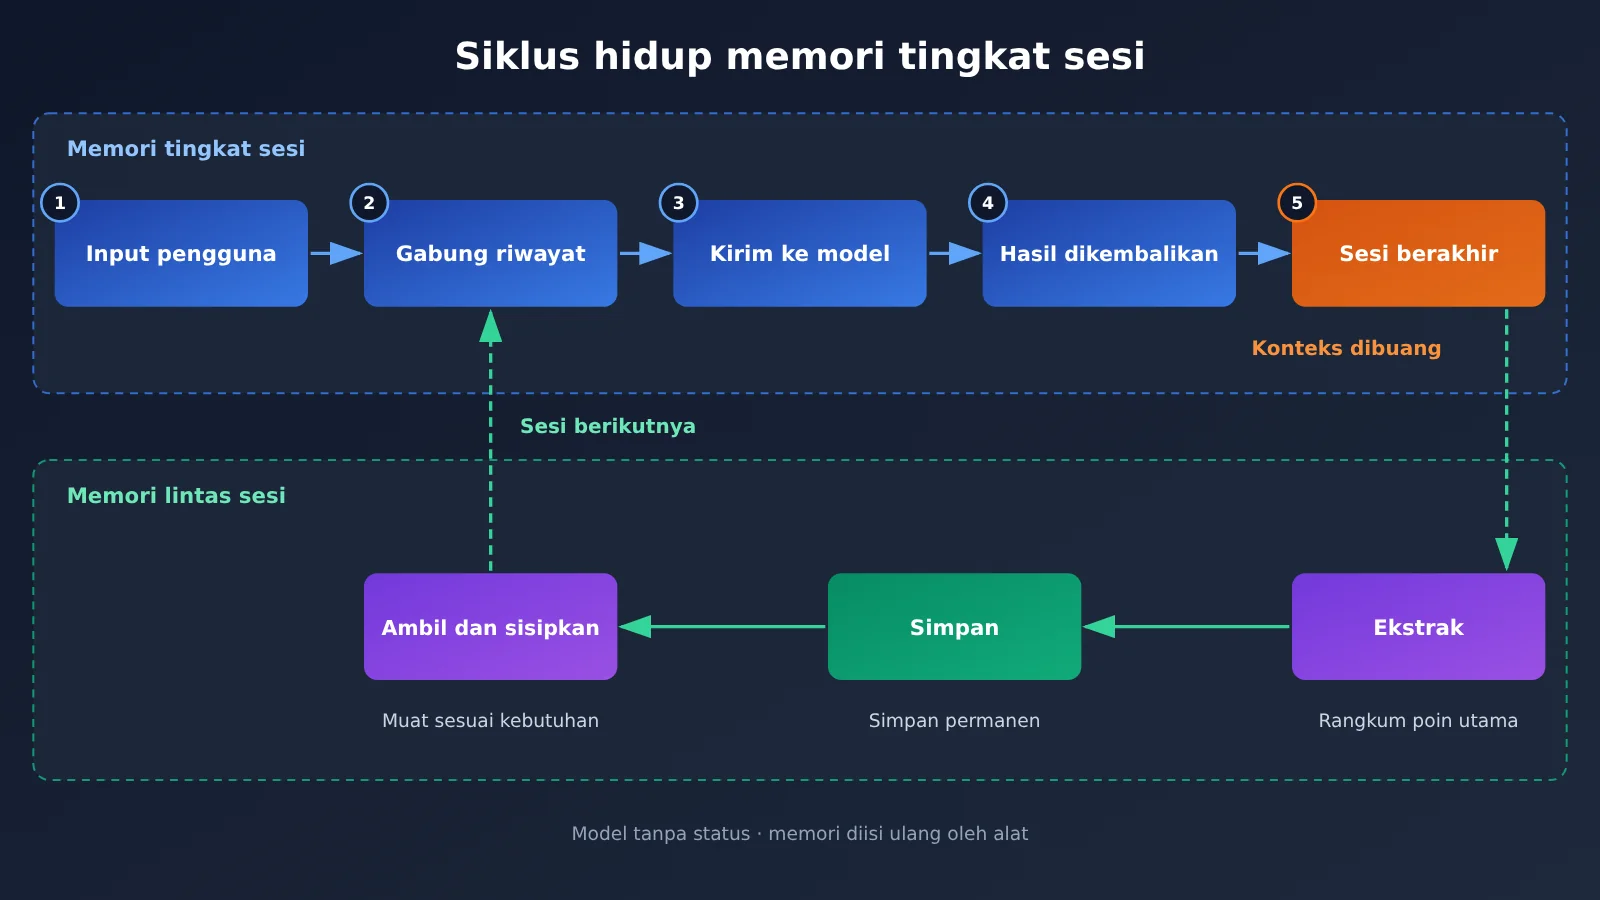
Model bahasa besar pada dasarnya tidak menyimpan status. Pada setiap permintaan, alat harus mengemas riwayat percakapan, petunjuk sistem, dan konten file yang relevan lalu mengirimkannya ke model agar model “tahu” apa yang terjadi sebelumnya. Jadi, kemampuan mengingat dalam sesi pada dasarnya berasal dari alat yang terus memasukkan kembali riwayat ke jendela konteks.
Artinya, setelah sesi berakhir, sesi baru dimulai dari nol, kecuali alat secara aktif menyimpan informasi tertentu di tempat lain dan mengambilnya kembali saat sesi berikutnya dimulai. Semakin panjang sesi, semakin banyak pula riwayatnya. Alat pun sering kali melakukan peringkasan atau pemotongan, sehingga detail awal bisa “terlupakan” bahkan dalam sesi yang sama.
Keterbatasan memori tingkat sesi
Ada tiga masalah utama pada memori tingkat sesi. Pertama, komunikasi berulang: Anda harus menjelaskan kembali tumpukan teknologi, aturan penamaan, dan dependensi yang dilarang di setiap sesi baru. Kedua, pengalaman tidak tersimpan: solusi yang ditemukan setelah menghadapi suatu masalah tidak diketahui AI saat masalah serupa muncul lagi. Ketiga, biaya perpindahan antartugas tinggi: ketika Anda membuka beberapa sesi untuk menangani modul berbeda dalam proyek yang sama, sesi-sesi tersebut tidak berbagi konteks.
Namun, memori tingkat sesi juga punya kelebihan: konteks tetap bersih, asumsi lama yang keliru tidak mengganggu tugas baru, dan batas privasi lebih jelas. Hal-hal inilah yang perlu dipertimbangkan saat memilih solusi.
Mengapa Perlu Memori Lintas Sesi: Tentukan Dulu Apakah Benar-Benar Perlu
Tidak semua orang membutuhkan plugin memori lintas sesi. Banyak yang langsung memasang plugin begitu tahu bahwa “memori hanya berlaku dalam satu sesi”. Akibatnya, mereka harus mengelola sistem tambahan tanpa manfaat yang jelas. Sebelum memutuskan, cocokkan dulu dengan tanda-tanda berikut.
| Tanda penggunaan | Perlukah memori lintas sesi? | Pendekatan yang lebih sesuai |
|---|---|---|
| Harus menjelaskan ulang standar proyek setiap memulai sesi baru | Belum tentu | Buat dulu file penjelasan di tingkat proyek |
| Memelihara proyek besar yang sama dalam jangka panjang dan menemui banyak masalah | Perlu | Pertimbangkan solusi memori yang dapat ditelusuri |
| Sebagian besar tugas berupa skrip sekali pakai atau masalah kecil yang terpisah | Tidak perlu | Cukup gunakan memori tingkat sesi |
| Beberapa anggota tim menggunakan kesepakatan AI yang sama | Sebagian perlu | Simpan kesepakatan di repositori dan kelola dengan kontrol versi |
| Melibatkan informasi sensitif seperti kode klien dan kunci | Perlu kehati-hatian | Utamakan penyimpanan lokal, atau catat hanya informasi yang sudah disamarkan |
| Ingin AI mengingat preferensi penulisan kode pribadi | Perlu | Gunakan memori tingkat pengguna yang terpisah dari memori proyek |
Dalam praktiknya, “berulang kali menjelaskan standar proyek” adalah masalah yang paling umum. Namun, sebagian besar masalah ini sebenarnya bisa diatasi dengan file penjelasan yang terawat. Yang benar-benar membutuhkan memori lintas sesi otomatis biasanya adalah pengalaman dalam proyek jangka panjang yang tersebar dan sulit didokumentasikan sejak awal, seperti perilaku aneh pada suatu antarmuka atau penyebab sebenarnya dari kegagalan build.
Ada satu hal lain yang mudah terlewat: semakin banyak memori, semakin banyak pula konten yang disisipkan ke konteks setiap kali, sehingga konsumsi token meningkat. Pengambilan dan peringkasan memori lintas sesi juga sering memerlukan pemanggilan model tambahan. Jika ingin mengevaluasi hasil dan biaya peringkasan dari berbagai model terlebih dahulu, Anda bisa membandingkan beberapa model populer dengan cara pemanggilan yang sama melalui antarmuka terpadu APIYI apiyi.com.
4 Pendekatan Memori Lintas Sesi
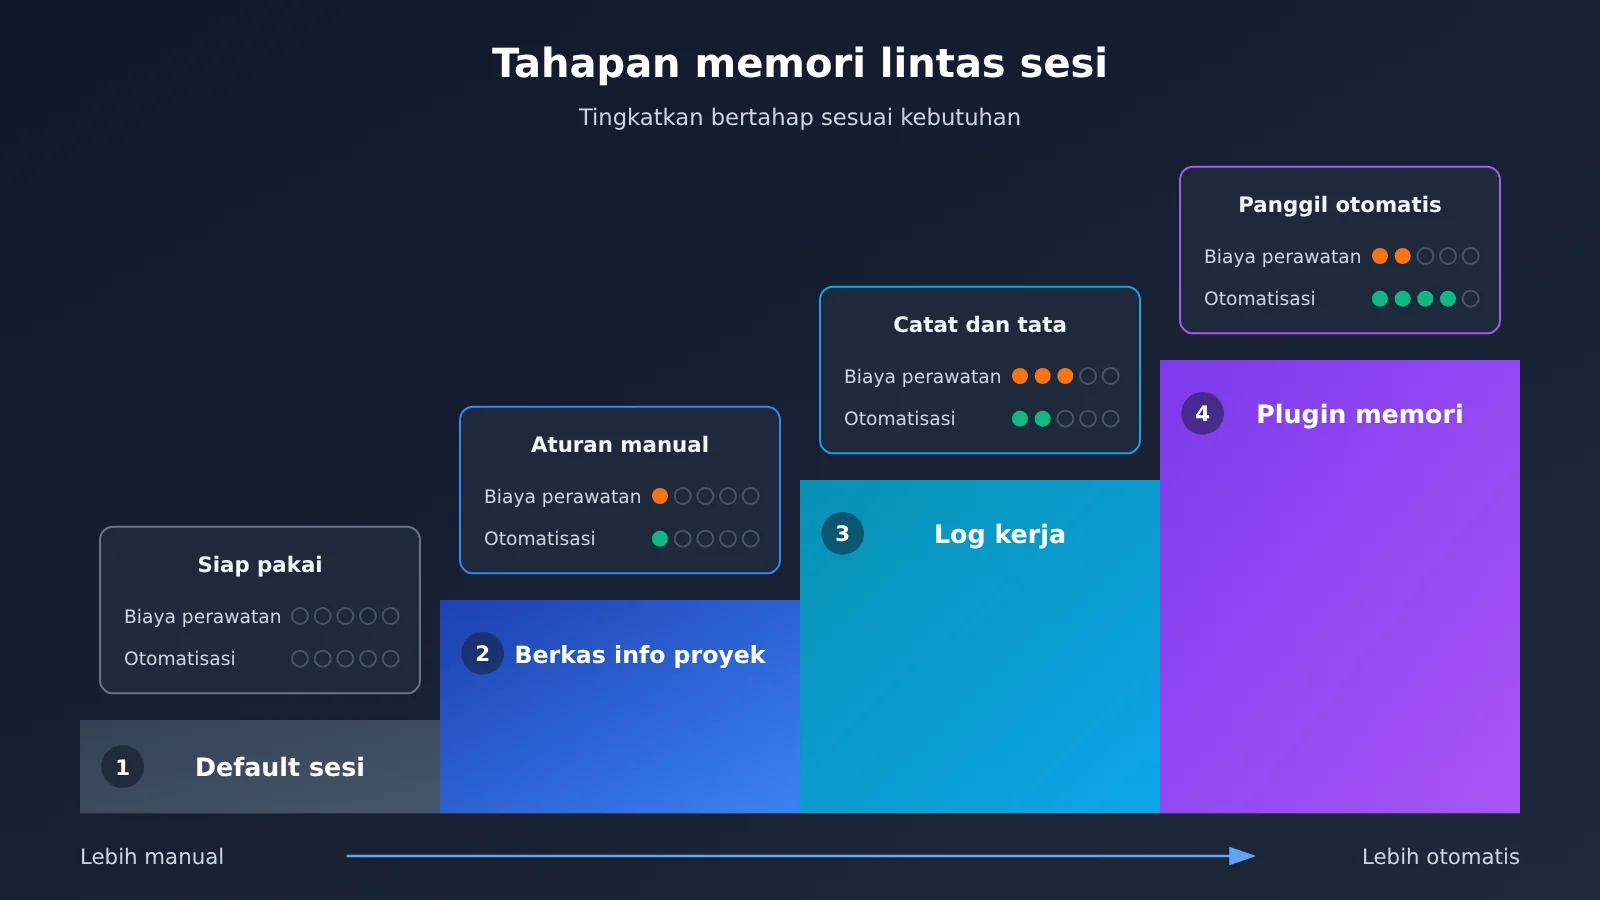
Karena balasan komunitas di unggahan asli dan informasi tentang plugin tertentu tidak termasuk dalam cakupan artikel ini, solusi yang umum digunakan dibagi menjadi 4 kategori berdasarkan cara penerapannya. Saat mengevaluasi plugin memori, tentukan dulu kategorinya, lalu lihat kompromi yang ditawarkan dalam kategori tersebut.
| Jenis solusi | Karakteristik utama | Skenario penggunaan | Kemampuan yang dibutuhkan |
|---|---|---|---|
| File penjelasan proyek | Aturan ditulis secara manual dan dibaca seluruhnya saat sesi dimulai | Aturan yang stabil, penggunaan bersama dalam tim | Alat yang mendukung pembacaan file aturan |
| Catatan manual / log kerja | AI membuat ringkasan di akhir sesi, lalu dirujuk secara manual pada sesi berikutnya | Proyek pribadi, kebutuhan ringan | Kemampuan model untuk merangkum |
| Memori ringkasan otomatis | Alat atau plugin otomatis merangkum dan menyimpan poin penting | Penggunaan intensif, tidak ingin repot memelihara catatan | Model peringkasan, yang dapat diakses melalui platform seperti APIYI |
| Basis memori berbasis pencarian | Memori disimpan sebagai vektor dan diambil berdasarkan relevansi | Proyek besar jangka panjang, banyak pengalaman yang tersimpan | Model embedding dan penyimpanan, biasanya diakses melalui ekstensi seperti MCP |
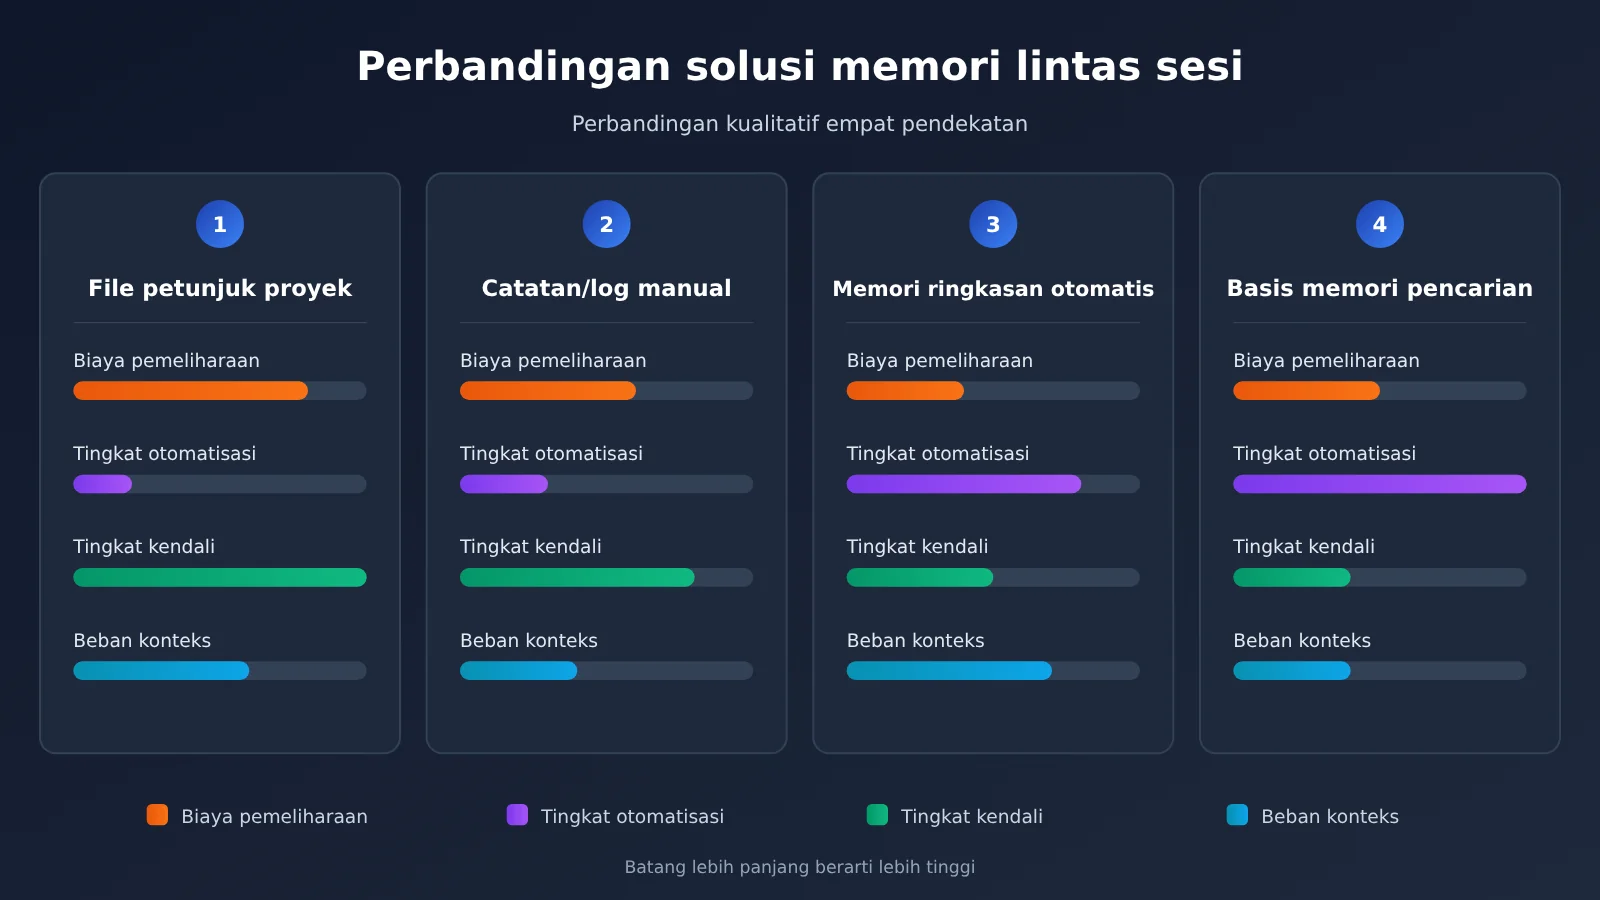
Keterangan diagram: Gambar di atas merupakan perbandingan kualitatif pada tingkat pendekatan, bukan hasil pengujian plugin tertentu. Untuk menguji efektivitas model dalam tahap “ringkasan otomatis” atau “pengambilan memori”, kamu bisa menggunakan APIYI apiyi.com untuk berganti model dan membandingkan hasilnya.
Memahami Perbandingan Solusi Memori Lintas Sesi
Perbandingan file penjelasan proyek: File penjelasan unggul dalam hal kendali dan transparansi. Isinya tersimpan di repositori, sehingga bisa ditinjau, dikembalikan ke versi sebelumnya, dan dibagikan ke tim. Namun, file ini harus dipelihara secara aktif dan tidak bisa mengingat pengalaman yang tidak sempat ditulis. Sebaliknya, solusi memori otomatis lebih cocok untuk mengumpulkan informasi yang “tidak terpikir untuk ditulis sejak awal”.
Perbandingan catatan manual: Meminta AI menulis log kerja di akhir sesi dan merujuknya saat membuka sesi baru adalah cara paling murah dan tidak memerlukan dependensi tambahan. Namun, cara ini bergantung pada kedisiplinan pengguna, dan log yang menumpuk juga perlu dirapikan. Bagi pengguna yang baru menyadari keterbatasan memori per sesi dan belum yakin seberapa besar kebutuhannya, ini adalah titik awal yang paling aman.
Perbandingan memori ringkasan otomatis dan berbasis pencarian: Kedua jenis ini menawarkan otomatisasi yang lebih tinggi dan cocok untuk pengguna intensif. Namun, kualitas pengambilan memorinya bervariasi. Memori yang usang atau keliru bisa masuk ke sesi baru, dan masalahnya lebih sulit ditelusuri dibandingkan pada file penjelasan. Saat memilih solusi ini, kemampuan untuk “melihat dan menghapus” memori yang dibahas nanti menjadi sangat penting.
Cara memilih solusi memori lintas sesi: 6 aspek penilaian
Apa pun plugin yang direkomendasikan komunitas, kamu bisa menilainya berdasarkan 6 aspek berikut. Ekosistem plugin berubah dengan cepat, jadi periksa dokumentasi terbaru setiap proyek untuk mengetahui fitur yang tersedia.
| Aspek penilaian | Pertanyaan yang perlu diajukan | Kondisi ideal |
|---|---|---|
| 1. Lokasi penyimpanan | Apakah memori disimpan secara lokal, di direktori proyek, atau di layanan jarak jauh? | Proyek sensitif bisa menggunakan penyimpanan lokal, dengan lokasi data yang jelas |
| 2. Cara penulisan | Apakah memori diekstraksi otomatis, ditulis oleh AI melalui pemanggilan alat, atau dikonfirmasi secara manual? | Memori penting bisa dikonfirmasi secara manual |
| 3. Mekanisme pemanggilan kembali | Apakah seluruh memori disuntikkan atau dicari berdasarkan relevansi? Apakah jumlah memori yang dipanggil bisa diatur? | Memori dipanggil sesuai kebutuhan agar tidak memenuhi konteks |
| 4. Keterlihatan | Apakah memori yang ada bisa dilihat, diedit, dan dihapus? | Memori berupa teks yang bisa dibaca dan diperbaiki kapan saja |
| 5. Cakupan | Apakah memori dibedakan berdasarkan pengguna, proyek, dan sesi? | Memori antarproyek tidak saling tercampur |
| 6. Biaya dan kompatibilitas | Apakah ada pemanggilan model tambahan? Apakah plugin bisa berhenti berfungsi saat versi alat diperbarui? | Biaya bisa diperkirakan dan pemeliharaan aktif |
Penyimpanan dan penulisan memori lintas sesi
Lokasi penyimpanan menentukan batas privasi. Jika kamu menangani kode perusahaan atau klien, memori bisa saja berisi logika bisnis, path internal, bahkan detail konfigurasi. Menyimpannya di layanan jarak jauh tanpa mengetahui dengan jelas ke mana data dikirim bisa berisiko. Sementara itu, cara penulisan menentukan kualitas memori. Penulisan otomatis memang praktis, tetapi juga paling mudah menumpuk informasi yang tidak relevan.
Pemanggilan kembali dan pengelolaan memori lintas sesi
Mekanisme pemanggilan kembali sangat menentukan kualitas pengalaman. Menyuntikkan seluruh memori bekerja dengan baik saat jumlahnya masih sedikit. Namun, ketika memori makin banyak, cara ini akan menghabiskan jendela konteks dan mengganggu tugas yang sedang dikerjakan. Keterlihatan juga penting untuk pengelolaan: jika memori yang salah tidak bisa ditemukan dan dihapus, memori tersebut akan terus menyesatkan AI di setiap sesi baru.
Aspek biaya sering diremehkan. Peringkasan otomatis dan pencarian vektor bisa menghasilkan pemanggilan model tambahan. Saat melakukan evaluasi, kamu bisa mencobanya dalam skala kecil terlebih dahulu dan menghitung konsumsi token tambahan selama seminggu. Dengan antarmuka agregasi seperti APIYI apiyi.com, kamu bisa membandingkan biaya berbagai model peringkasan dalam satu akun untuk menentukan kombinasi yang lebih hemat.
Panduan cepat memori lintas sesi: langkah praktis tanpa mengganti alat
Sebelum memilih plugin memori, coba dulu pendekatan bertahap berikut. Kamu tidak perlu menulis kode atau bergantung pada plugin tertentu, dan cara ini bisa digunakan di sebagian besar alat pemrograman AI.
- Periksa kemampuan alat yang sudah ada: Baca dokumentasi resmi alat yang kamu gunakan untuk memastikan apakah alat tersebut mendukung file aturan tingkat proyek, pemulihan sesi, ekstensi seperti MCP, dan sebagainya. Dengan begitu, kamu tidak perlu membuat ulang fitur yang sudah tersedia.
- Buat file dokumentasi proyek: Tulis penjelasan singkat tentang tech stack, struktur direktori, aturan penamaan, dan hal-hal yang harus dihindari. Simpan file tersebut di dalam proyek dan masukkan ke sistem kontrol versi.
- Biasakan menutup sesi dengan rangkuman: Setiap kali menyelesaikan tugas penting, minta AI merangkum keputusan, kendala yang ditemui, dan pekerjaan yang belum selesai dalam format tetap, lalu tambahkan rangkuman itu ke log kerja.
- Rapikan secara berkala: Dari waktu ke waktu, pindahkan informasi yang sering muncul dan berlaku untuk jangka panjang dari log ke file dokumentasi, lalu hapus informasi yang sudah tidak relevan.
- Evaluasi kebutuhan plugin: Setelah mencoba selama satu atau dua minggu, jika pemeliharaan manual terasa merepotkan, pilih plugin memori otomatis menggunakan enam dimensi yang dibahas sebelumnya.
Sebaiknya catat isi log kerja mengikuti struktur tabel di bawah ini agar mudah dibaca manusia dan cepat dipahami AI dalam sesi baru.
| Jenis catatan | Contoh isi | Cocok untuk file dokumentasi? |
|---|---|---|
| Keputusan | Pilihan solusi manajemen state beserta alasannya | Cocok, berlaku jangka panjang |
| Kendala | Kegagalan build pada versi tertentu dari sebuah dependensi beserta solusinya | Tergantung situasi, pindahkan setelah solusinya stabil |
| Kesepakatan | Format seragam untuk respons error API | Cocok |
| Tugas | Unit test untuk suatu modul yang belum lengkap | Tidak cocok, simpan di log |
| Informasi sensitif | Kunci, alamat internal | Jangan dicatat; gunakan deskripsi placeholder sebagai gantinya |
🚀 Saran untuk mulai: Rangkuman sesi pada langkah 3 dan perapian log pada langkah 4 cocok dikerjakan oleh model yang biayanya lebih rendah. Coba kualitas rangkuman beberapa model melalui antarmuka terpadu APIYI apiyi.com, lalu tentukan model yang ingin dikonfigurasi untuk alat pemrograman atau plugin memori.
Pertanyaan Umum (FAQ)
Q1: Apa itu memori tingkat sesi pada alat pemrograman AI?
Artinya, AI hanya mengingat percakapan sebelumnya dan konten yang telah dibaca selama sesi aktif. Informasi tersebut tidak otomatis terbawa ke sesi baru. Ini karena model pada dasarnya tidak menyimpan status; alat membuatnya seolah-olah “ingat” dengan memasukkan kembali riwayat ke jendela konteks.
Q2: Apa perbedaan memori tingkat sesi dan memori lintas sesi?
Memori tingkat sesi menjaga konteks tetap bersih dan batas privasi tetap jelas, tetapi tidak dapat menyimpan pengalaman untuk digunakan kembali. Memori lintas sesi memungkinkan sesi baru memanfaatkan pengalaman sebelumnya, tetapi perlu dipilih dan dikelola, serta berisiko memunculkan kembali memori yang keliru berulang kali.
Q3: Benarkah memori opencode hanya berlaku dalam satu sesi?
Seorang pengguna V2EX menulis pada November 2026 bahwa, setelah membaca diskusi lain, ia mengetahui memori opencode bersifat tingkat sesi. Namun, diskusi asli yang mendasari pernyataan itu tidak termasuk dalam sumber artikel ini, dan alat tersebut terus diperbarui. Sebaiknya rujuk dokumentasi resmi opencode dan periksa perilaku versi yang Anda gunakan.
Q4: Untuk skenario apa memori lintas sesi paling cocok?
Memori lintas sesi terutama cocok untuk:
– **Proyek besar yang dipelihara dalam jangka panjang**: Pengalaman mengatasi masalah sering tersebar dan sulit ditulis terlebih dahulu sebagai aturan
– **Preferensi pribadi yang konsisten**: Anda ingin AI mengingat gaya dan kebiasaan penulisan kode Anda dalam jangka panjang
– **Pengembangan paralel dalam beberapa sesi**: Beberapa modul dalam proyek yang sama dikerjakan bersamaan dan membutuhkan latar belakang bersama
Skrip sekali pakai dan masalah kecil yang berdiri sendiri biasanya tidak membutuhkannya.
Q5: Bagaimana cara mudah menguji dan mengganti model peringkasan atau embedding yang digunakan plugin memori?
Banyak solusi memori membutuhkan model tambahan untuk peringkasan atau vektorisasi. Melalui platform agregasi multimodel seperti APIYI apiyi.com, Anda dapat membandingkan hasil dan biaya berbagai model dengan cara pemanggilan yang seragam, lalu mengonfigurasi model yang sesuai pada plugin. Untuk parameter integrasi, lihat dokumentasi platform di docs.apiyi.com dan petunjuk plugin.
Q6: Apakah memori lintas sesi akan meningkatkan biaya token secara signifikan?
Bisa saja. Memori yang dipanggil kembali selalu menggunakan ruang konteks, dan peringkasan otomatis juga menghasilkan pemanggilan tambahan. Sebaiknya batasi jumlah memori yang dipanggil dan catat penggunaan tambahan selama masa uji coba. Tampilan tagihan terpadu APIYI apiyi.com dapat membantu Anda membandingkan biaya berbagai kombinasi model dengan lebih mudah.
Q7: Apa saja risiko atau kekurangan memori lintas sesi yang sudah diketahui?
Ada tiga risiko utama: pertama, memori yang keliru atau usang dapat terus menyesatkan sesi baru; kedua, informasi sensitif seperti kunci dan path internal dapat tersimpan dalam memori; ketiga, plugin dapat berhenti berfungsi setelah pembaruan versi alat. Untuk mengatasinya, pilih solusi yang memungkinkan Anda melihat dan menghapus memori, bersihkan secara berkala, dan hindari menyimpan konten sensitif.
Poin Utama Memori Tingkat Sesi dan Lintas Sesi
- Hakikat memori tingkat sesi: Model tidak menyimpan status; alat mengirim ulang riwayat agar model bisa “mengingat” dalam satu sesi.
- Evaluasi sebelum memasang: Jika masalahnya harus berulang kali menjelaskan aturan, file instruksi sering kali sudah cukup.
- Empat pendekatan: File instruksi, log manual, ringkasan otomatis, dan basis memori berbasis pencarian masing-masing punya kelebihan dan kekurangan.
- Enam dimensi penilaian: Lokasi penyimpanan, cara penulisan, mekanisme pemanggilan kembali, observabilitas, cakupan, serta biaya dan kompatibilitas.
- Kemampuan menghapus lebih penting daripada otomatisasi penuh: Memori yang keliru dan tak bisa diperbaiki akan terus menyebabkan kesalahan di setiap sesi baru.
- Penerapan bertahap: Mulai dari file instruksi, lanjutkan dengan log kerja, lalu gunakan plugin memori jika diperlukan.
- Coba model sebelum menentukan pilihan: Bandingkan model peringkasan dan embedding melalui antarmuka terpadu APIYI di apiyi.com.
Kesimpulan
Berikut poin utama tentang memori tingkat sesi pada alat pemrograman AI:
- Pahami batasannya: Memori tingkat sesi bukanlah kekurangan, melainkan desain bawaan. Keuntungannya adalah konteks yang bersih, tetapi pengalaman tidak tersimpan secara otomatis.
- Mulai dengan solusi berbiaya rendah: File instruksi proyek dan log kerja dapat mengatasi sebagian besar masalah “harus menjelaskan ulang setiap kali”.
- Pilih plugin berdasarkan beberapa dimensi: Jika benar-benar membutuhkan memori lintas sesi yang otomatis, evaluasi penyimpanan, penulisan, pemanggilan kembali, observabilitas, cakupan, serta biaya dan kompatibilitas.
Jika Anda menggunakan alat seperti opencode dan bingung memilih plugin memori, hal yang lebih penting daripada daftar plugin adalah menentukan apa yang perlu diingat, di mana menyimpannya, dan bagaimana menghapusnya. Ekosistem plugin berubah cepat, jadi pelajari dokumentasi resmi dan pengalaman nyata komunitas sebelum menentukan pilihan.
Jika solusi memori membutuhkan model peringkasan atau embedding, coba bandingkan dalam skala kecil melalui APIYI di apiyi.com sebelum menentukan konfigurasi akhir.
📚 Referensi
- Tanya Jawab V2EX: Bagi pengguna opencode, plugin memori apa yang kalian pasang?: Sumber pertanyaan yang menjadi titik awal artikel ini
- Tautan:
v2ex.com/t/1254245 -
Keterangan: Pengguna mempertanyakan memori opencode yang berlaku pada tingkat sesi. Postingan asli hanya berisi pertanyaan; lihat halaman postingan untuk tanggapan komunitas.
-
Dokumentasi resmi opencode: Penjelasan tentang memori, file aturan, dan kemampuan ekstensi
- Tautan: Lihat dokumentasi terbaru di situs resmi atau repositori sumber terbuka opencode
- Keterangan: Artikel ini belum mencakup seluruh penjelasan resmi tentang mekanisme memori. Sebaiknya baca dokumentasinya sebelum menentukan pilihan.
Penulis: Tim Teknis APIYI
Diskusi teknis: Hubungi kami melalui halaman utama APIYI apiyi.com untuk berbagi pengalaman seputar alat pemrograman AI dan pemilihan model. Kunjungi pusat dokumentasi di docs.apiyi.com untuk informasi lebih lanjut.