Nota del autor: A partir de la inquietud de un usuario de opencode que descubrió que «la memoria solo funciona dentro de la sesión», explicamos qué significa la memoria a nivel de sesión, cuáles son sus límites y qué 6 criterios tener en cuenta al elegir una solución de memoria entre sesiones.
Si usas con frecuencia herramientas de programación con IA como opencode, quizá te haya pasado: ayer dedicaste horas a hablar con la IA sobre las convenciones del proyecto y hoy, al abrir una sesión nueva, vuelve a preguntarte todo como si fuera la primera vez. En noviembre de 2026, un usuario publicó una pregunta en V2EX: después de leer otra conversación, descubrió que la memoria de opencode funciona a nivel de sesión y quiso saber qué plugin de memoria usaban los demás.
No es una impresión aislada ni un problema exclusivo de una herramienta. La memoria a nivel de sesión es el funcionamiento predeterminado de muchas herramientas de programación con IA. Eso sí, la publicación original consta de una sola frase, la conversación a la que hace referencia queda fuera del alcance de nuestras fuentes y, para conocer la explicación completa del mecanismo de memoria de opencode, conviene consultar la documentación oficial. Por eso, aquí no recomendamos plugins concretos: nos centramos en las preguntas que debes hacerte al elegir una solución de memoria entre sesiones.
Qué te llevarás: al terminar, podrás decidir si realmente necesitas memoria entre sesiones y evaluar cualquier plugin de memoria o alternativa con 6 criterios, para evitar que instalar uno termine desordenando el contexto.
Qué es la memoria a nivel de sesión en las herramientas de programación con IA
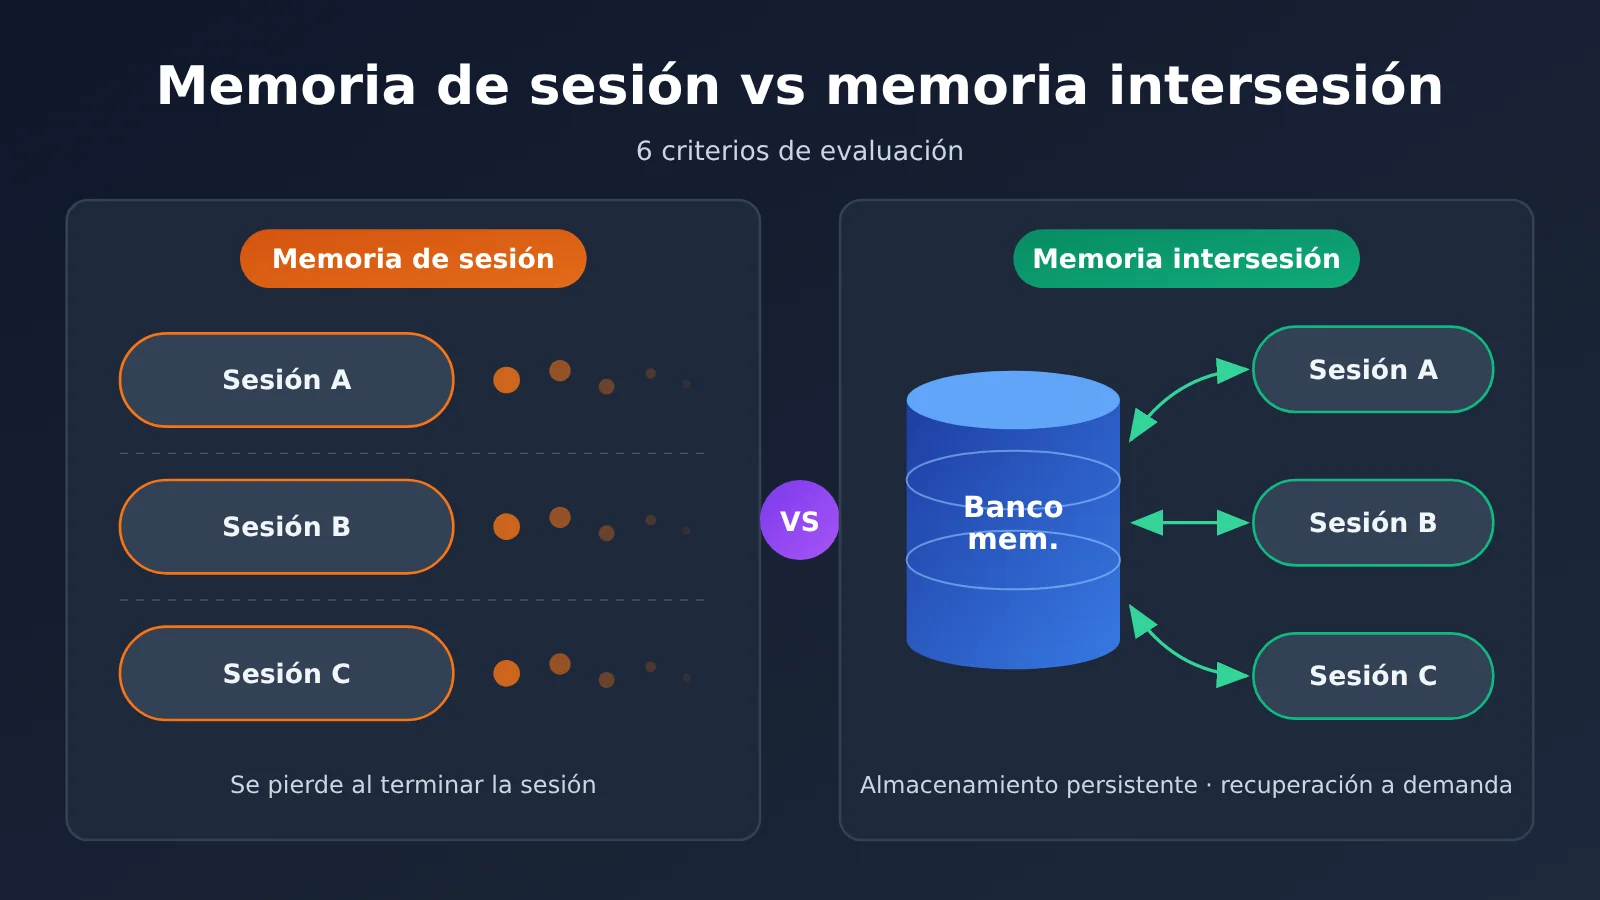
La «memoria a nivel de sesión» no es un término técnico estricto. La comunidad suele usarlo para describir un fenómeno: la IA recuerda lo que dijiste durante una conversación, pero ese contenido deja de incorporarse automáticamente al abrir una sesión nueva. Para entenderlo, conviene distinguir varios tipos de «memoria» que suelen confundirse.
| Nivel de memoria | Descripción | Qué significa para el usuario |
|---|---|---|
| Ventana de contexto | Todo el contenido que el modelo puede ver en una sola solicitud, incluidos los mensajes anteriores y los archivos leídos | Es la fuente de lo que «recuerda» durante la sesión y tiene un límite de longitud |
| Historial de sesión | La herramienta guarda los mensajes de una misma sesión para poder revisarla o retomarla | Permite recuperar una sesión, pero no influye automáticamente en las nuevas |
| Instrucciones a nivel de proyecto | Archivos de reglas dentro del proyecto que la herramienta lee al iniciarse | Son las «convenciones a largo plazo» más estables, pero requieren mantenimiento manual |
| Memoria entre sesiones | Información que se extrae, almacena y recupera de forma automática o semiautomática | Permite que las nuevas sesiones aprovechen experiencias anteriores, pero exige elegir y gestionar una solución |
Cómo funciona la memoria a nivel de sesión
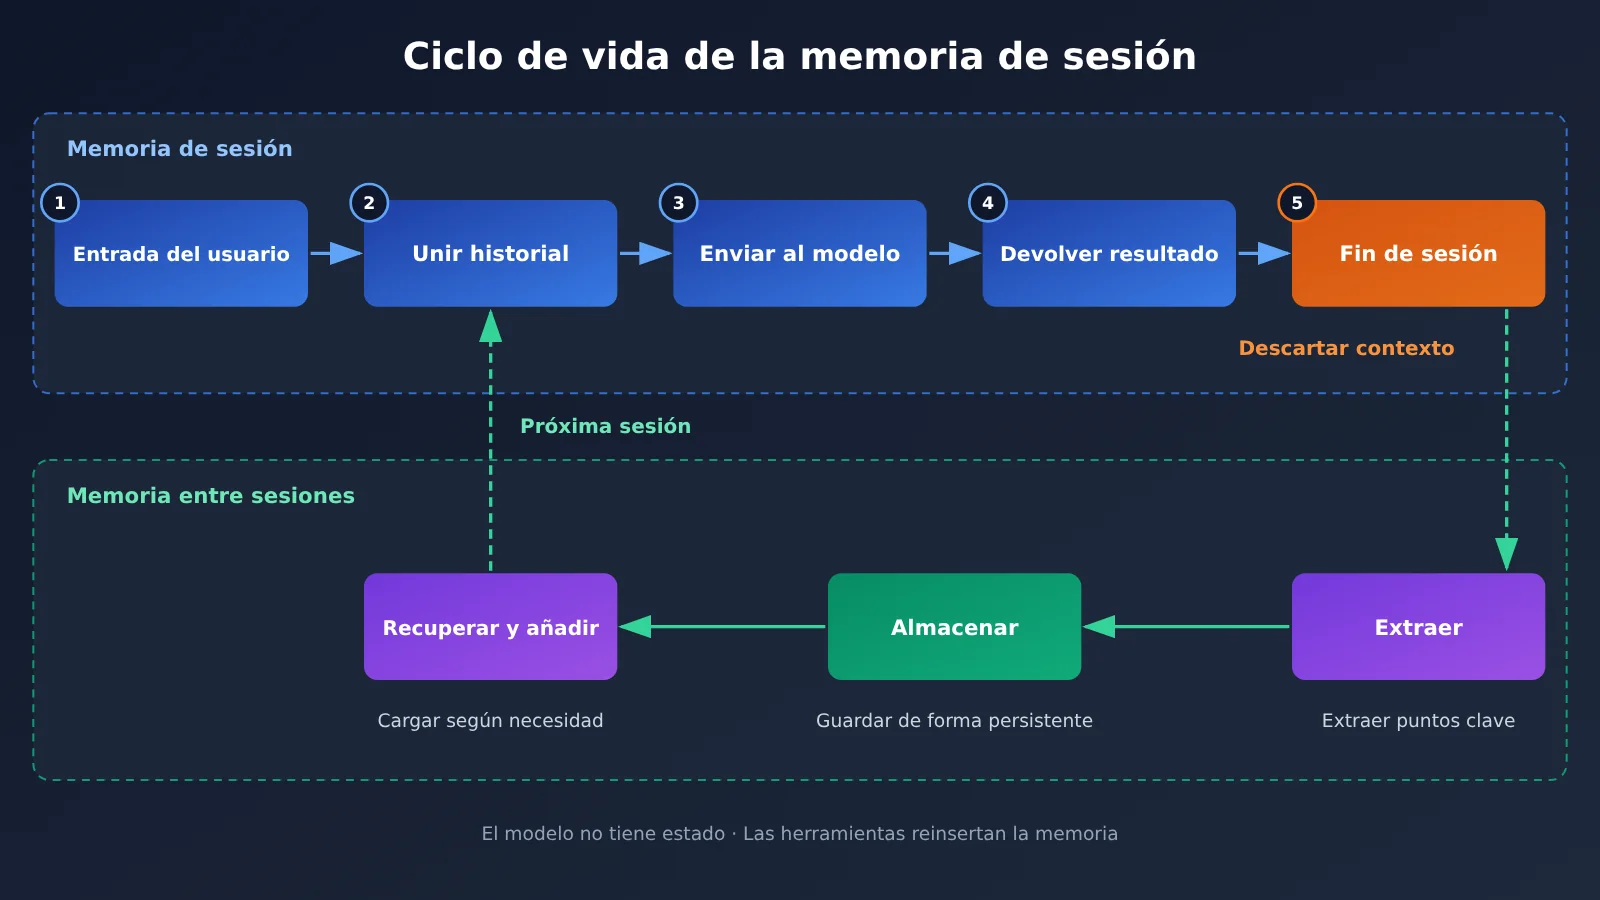
Los Modelos de Lenguaje Grande no mantienen estado por sí mismos. En cada solicitud, la herramienta debe enviar al modelo el historial de conversación, las instrucciones del sistema y el contenido de los archivos relevantes para que «sepa» qué ocurrió antes. En esencia, lo que parece recordar durante la sesión se debe a que la herramienta vuelve a incluir el historial en la ventana de contexto.
Esto significa que, cuando termina la sesión, la siguiente comienza desde cero, a menos que la herramienta guarde cierta información en otro lugar y la recupere al iniciarse de nuevo. Además, cuanto más larga sea la sesión, más historial acumula. Por eso, las herramientas suelen comprimirlo o truncarlo, y pueden «olvidar» detalles del principio incluso dentro de la misma sesión.
Limitaciones de la memoria a nivel de sesión
Los problemas se concentran en tres puntos. Primero, hay que repetir información: en cada nueva sesión debes volver a explicar el stack tecnológico, las convenciones de nombres y las dependencias que no se deben usar. Segundo, la experiencia no se conserva: si encuentras una solución después de tropezar con un problema, la IA no la conocerá la próxima vez que surja uno similar. Tercero, cambiar entre tareas resulta más costoso: si abres varias sesiones para trabajar en distintos módulos de un mismo proyecto, no comparten el contexto entre sí.
Pero la memoria a nivel de sesión también tiene ventajas: el contexto está limpio, las suposiciones erróneas anteriores no contaminan las nuevas tareas y los límites de privacidad son más claros. Estos son precisamente los aspectos que conviene sopesar al elegir una solución.
Por qué usar memoria entre sesiones: primero decide si realmente la necesitas
No todo el mundo necesita un complemento de memoria entre sesiones. Muchas personas descubren que «la memoria solo dura una sesión» y se apresuran a instalar uno, pero terminan con otro sistema que mantener sin obtener un beneficio claro. Antes, revisa estas señales.
| Señal de uso | ¿Necesitas memoria entre sesiones? | Alternativa más adecuada |
|---|---|---|
| Tienes que explicar las normas del proyecto en cada sesión nueva | No necesariamente | Empieza por crear un archivo de instrucciones para el proyecto |
| Mantienes un mismo proyecto grande a largo plazo y has aprendido de muchos problemas | Sí | Considera una solución de memoria con búsqueda |
| La mayoría de tus tareas son scripts de un solo uso o pequeños problemas independientes | No | La memoria de sesión es suficiente |
| Varias personas del equipo comparten las mismas convenciones para usar la IA | En parte | Guarda las convenciones en el repositorio y ponlas bajo control de versiones |
| Trabajas con información sensible, como código de clientes o claves | Con precaución | Prioriza el almacenamiento local o registra solo información anonimizada |
| Quieres que la IA recuerde tus preferencias personales de programación | Sí | Usa memoria a nivel de usuario, separada de la del proyecto |
En la práctica, tener que repetir las normas del proyecto es el problema más común, pero un archivo de instrucciones bien mantenido puede resolverlo en gran medida. La memoria automatizada entre sesiones resulta realmente útil para las experiencias dispersas de proyectos a largo plazo que son difíciles de documentar de antemano: por ejemplo, el comportamiento extraño de una interfaz o la causa real de un fallo de compilación.
También hay algo que se suele pasar por alto: cuanto más se almacena en la memoria, más contenido se incorpora al contexto en cada sesión y más tokens se consumen. Recuperar y resumir recuerdos entre sesiones suele requerir invocaciones adicionales del modelo. Si antes quieres evaluar la calidad y el costo de los resúmenes con distintos modelos, puedes usar la interfaz unificada de APIYI apiyi.com para comparar varios modelos populares con el mismo método de invocación.
4 enfoques para la memoria entre sesiones
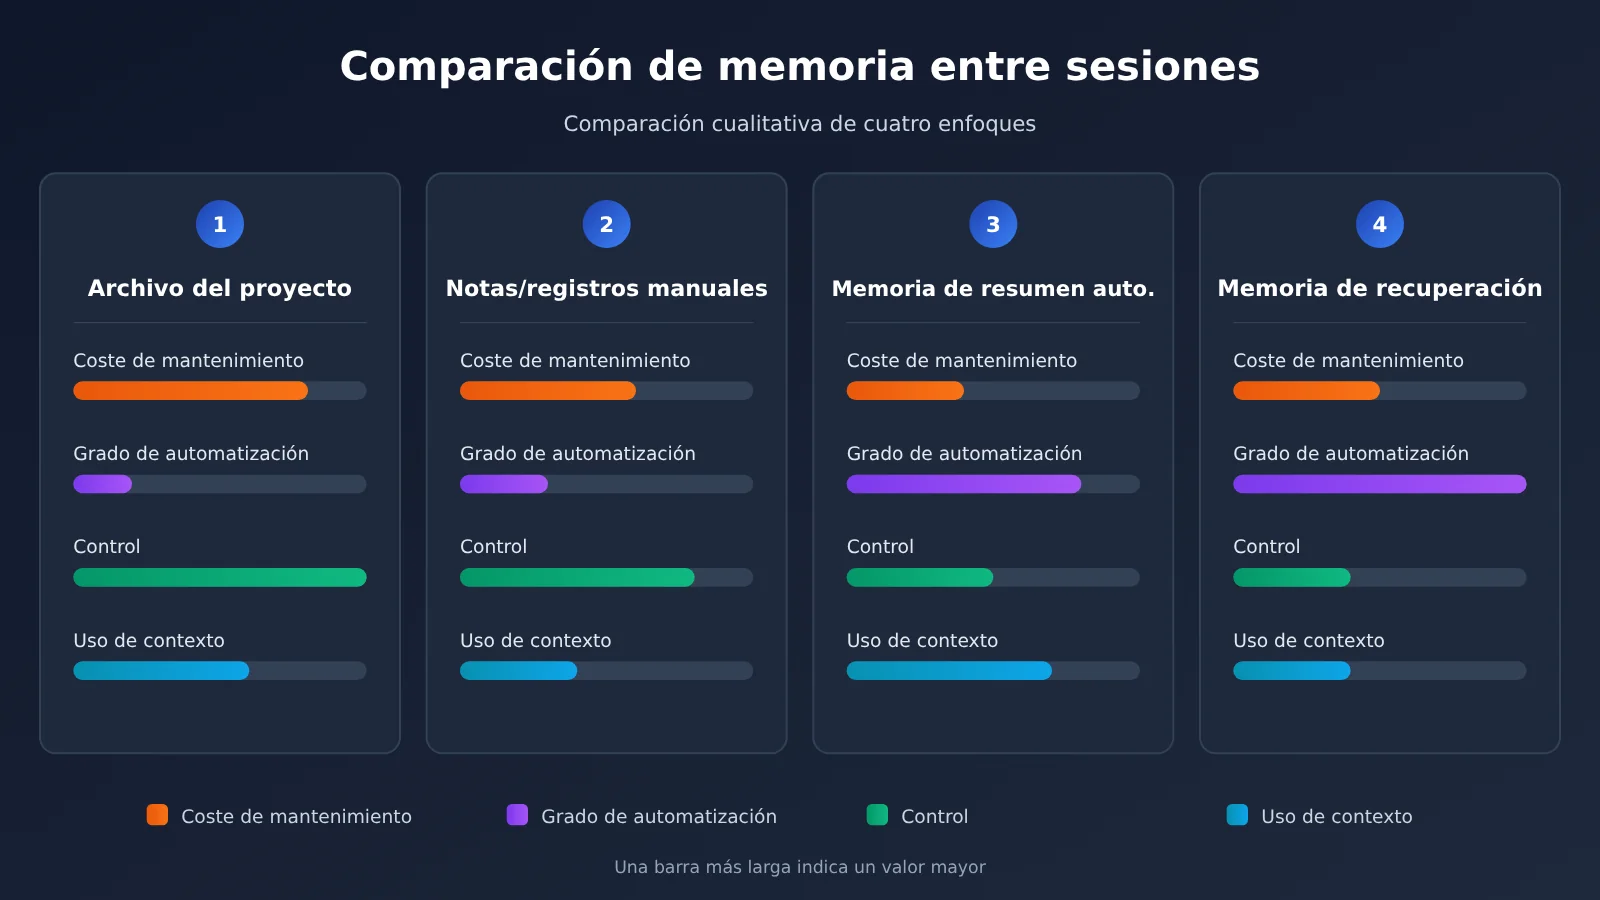
Como las respuestas de la comunidad a la publicación original y los detalles de plugins concretos quedan fuera del alcance de este artículo, agrupamos las soluciones habituales en 4 categorías según cómo funcionan. Al evaluar cualquier plugin de memoria, puedes identificar primero a qué categoría pertenece y después analizar sus ventajas y limitaciones dentro de ella.
| Tipo de solución | Característica principal | Casos de uso | Capacidades necesarias |
|---|---|---|---|
| Archivo de instrucciones del proyecto | Reglas escritas manualmente que se cargan completas al iniciar | Normas estables y trabajo compartido en equipo | La herramienta debe poder leer archivos de reglas |
| Notas manuales / registro de trabajo | La IA escribe un resumen al terminar la sesión y se consulta manualmente en la siguiente | Proyectos personales y necesidades sencillas | Capacidad de resumen del modelo |
| Memoria con resúmenes automáticos | Una herramienta o plugin extrae y guarda los puntos clave automáticamente | Uso frecuente y poco interés en el mantenimiento manual | Modelo de resumen, accesible mediante plataformas como APIYI |
| Base de memoria con recuperación | Los recuerdos se almacenan como vectores y se recuperan según su relevancia | Proyectos grandes y de larga duración, con mucha experiencia acumulada | Modelo de embeddings y almacenamiento, normalmente integrados mediante extensiones como MCP |
Nota sobre el gráfico: la comparación anterior es cualitativa y se centra en los enfoques; no representa datos de pruebas de ningún plugin concreto. Si quieres probar el rendimiento real de los modelos en las etapas de «resumen automático» o «recuperación», puedes usar APIYI apiyi.com para cambiar entre distintos modelos desde un mismo lugar y compararlos.
Cómo interpretar la comparación
Archivo de instrucciones del proyecto: destaca por su control y transparencia. El contenido está en el repositorio, se puede revisar, revertir y compartir con el equipo. Sin embargo, requiere mantenimiento manual y no registra las experiencias que nadie pensó en documentar. Las soluciones de memoria automática, en cambio, son más adecuadas para acumular información «que no sabías de antemano que necesitabas guardar».
Notas manuales: pedirle a la IA que escriba un registro de trabajo al terminar la sesión y consultarlo al abrir la siguiente es la opción más económica y no requiere dependencias adicionales. Eso sí, depende de la constancia del usuario y, cuando se acumulan muchos registros, hay que organizarlos. Es el punto de partida más seguro para quienes acaban de descubrir las limitaciones de la memoria de sesión y aún no saben cuánto necesitan esta función.
Resúmenes automáticos y memoria con recuperación: estas dos categorías ofrecen más automatización y son adecuadas para usuarios intensivos. Sin embargo, la calidad de la recuperación varía y podrían introducir recuerdos obsoletos o incorrectos en una sesión nueva, algo más difícil de detectar que en un archivo de instrucciones. Al elegir una solución de este tipo, es especialmente importante que permita consultar y eliminar recuerdos, como veremos más adelante.
Cómo elegir una solución de memoria entre sesiones: 6 criterios
Sea cual sea el complemento que recomiende la comunidad, puedes evaluarlo con estos 6 criterios. El ecosistema de complementos cambia rápido, así que consulta la documentación más reciente de cada proyecto para conocer sus funciones.
| Criterio | Qué preguntar | Situación ideal |
|---|---|---|
| 1. Ubicación del almacenamiento | ¿La memoria se guarda localmente, en el directorio del proyecto o en un servicio remoto? | Se puede elegir el almacenamiento local para proyectos sensibles y está claro dónde van los datos |
| 2. Método de escritura | ¿Se extrae automáticamente, la IA usa una herramienta para escribirla o requiere confirmación manual? | Las memorias importantes se pueden confirmar manualmente |
| 3. Mecanismo de recuperación | ¿Se inyecta toda la memoria o se busca según su relevancia? ¿Se puede controlar cuántos recuerdos se recuperan? | Se recupera lo necesario, sin llenar la ventana de contexto |
| 4. Observabilidad | ¿Se pueden consultar, editar y eliminar las memorias existentes? | Las memorias son texto legible y se pueden corregir en cualquier momento |
| 5. Alcance | ¿Se distingue entre memorias de usuario, proyecto y sesión? | Las memorias de distintos proyectos no se mezclan |
| 6. Coste y compatibilidad | ¿Se invoca el modelo adicionalmente? ¿Puede dejar de funcionar con las actualizaciones de la herramienta? | El coste se puede estimar y el proyecto se mantiene activo |
Almacenamiento y escritura de la memoria entre sesiones
La ubicación del almacenamiento marca los límites de privacidad. Si trabajas con código de una empresa o de un cliente, la memoria puede contener lógica de negocio, rutas internas e incluso detalles de configuración. Guardarla en un servicio remoto sin saber dónde acabarán los datos supone un riesgo. Por su parte, el método de escritura determina la calidad de la memoria: la escritura totalmente automática ahorra trabajo, pero también facilita que se acumule ruido.
Recuperación y gestión de la memoria entre sesiones
El mecanismo de recuperación es clave para que la experiencia sea buena. Inyectar toda la memoria funciona bien cuando hay poca, pero, a medida que crece, ocupa espacio en la ventana de contexto y puede interferir con la tarea actual. La observabilidad, por su parte, es esencial para gestionarla: si no se puede detectar y eliminar una memoria incorrecta, seguirá confundiendo a la IA en cada sesión nueva.
El coste suele subestimarse. Tanto los resúmenes automáticos como la búsqueda vectorial pueden generar invocaciones adicionales al modelo. Para evaluarlo, puedes empezar con una prueba limitada y medir el consumo extra de tokens durante una semana. Si usas una interfaz que agrupa proveedores, como APIYI apiyi.com, puedes comparar el coste de distintos modelos de resumen desde una misma cuenta y determinar qué combinación resulta más conveniente.
Primeros pasos con la memoria entre sesiones: sin cambiar de herramienta
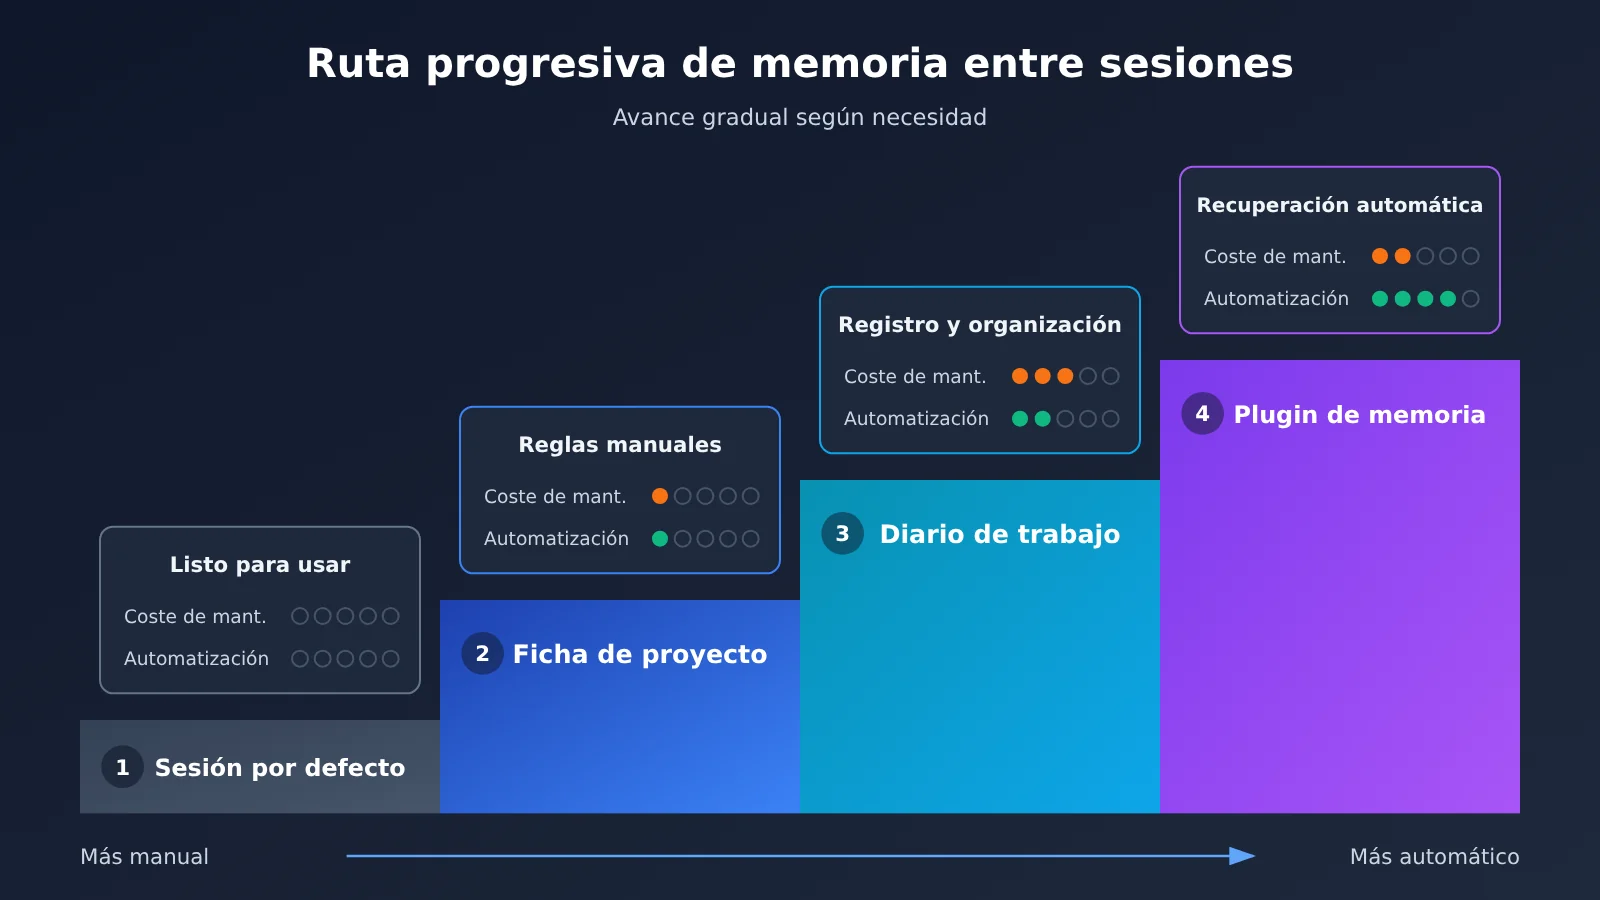
Antes de decidir qué complemento de memoria instalar, prueba este enfoque gradual. No necesitas escribir código ni usar un complemento específico, y funciona con la mayoría de las herramientas de programación con IA.
- Comprueba las capacidades de tu herramienta: consulta la documentación oficial para ver si admite archivos de reglas a nivel de proyecto, recuperación de sesiones, MCP y otras extensiones. Así evitarás reinventar la rueda.
- Crea un archivo de documentación del proyecto: reúne en un documento breve el stack tecnológico, la estructura de directorios, las convenciones de nombres y las prácticas prohibidas. Guárdalo en el proyecto e inclúyelo en el control de versiones.
- Acostúmbrate a cerrar cada sesión: cada vez que completes una tarea importante, pide a la IA que resuma en un formato fijo las decisiones tomadas, los problemas encontrados y los asuntos pendientes. Añade el resumen al registro de trabajo.
- Organiza el contenido periódicamente: cada cierto tiempo, traslada al archivo de documentación la información que se repita en el registro y siga siendo válida a largo plazo. Elimina lo que haya quedado obsoleto.
- Vuelve a evaluar los complementos: después de una o dos semanas de prueba, si el mantenimiento manual resulta demasiado pesado, usa los seis criterios anteriores para elegir un complemento de memoria automatizado.
Puedes organizar el registro de trabajo siguiendo esta tabla. Así será fácil de leer para las personas y la IA podrá asimilarlo rápidamente al comenzar una nueva sesión.
| Elemento | Ejemplo | ¿Conviene incluirlo en el archivo de documentación? |
|---|---|---|
| Decisiones | Solución de gestión de estado elegida y motivos | Sí, si tiene validez a largo plazo |
| Problemas encontrados | Fallo de compilación de una dependencia en una versión concreta y su solución | Depende; trasladarlo cuando la solución sea estable |
| Convenciones | Formato unificado de respuesta para errores de la interfaz | Sí |
| Pendientes | Faltan pruebas unitarias para un módulo | No, dejarlo en el registro |
| Información sensible | Claves, direcciones internas | No registrarla; usar una descripción con marcadores de posición |
🚀 Consejo para empezar: tanto el resumen de sesión del paso 3 como la organización del registro del paso 4 son tareas adecuadas para modelos de menor costo. Puedes probar la calidad de los resúmenes de varios modelos a través de la interfaz unificada de APIYI apiyi.com y después decidir cuál configurar en tu herramienta de programación o complemento de memoria.
Preguntas frecuentes (FAQ)
Q1: ¿Qué es la memoria a nivel de sesión en las herramientas de programación con IA?
Significa que la IA solo recuerda las conversaciones anteriores y el contenido que ha leído durante la sesión actual. Al abrir una nueva sesión, esa información no se transfiere automáticamente. Esto se debe a que el modelo no conserva un estado por sí mismo: la herramienta logra que «recuerde» al volver a introducir el historial en la ventana de contexto.
Q2: ¿En qué se diferencia la memoria a nivel de sesión de la memoria entre sesiones?
La memoria a nivel de sesión mantiene el contexto limpio y establece límites claros de privacidad, pero no permite acumular experiencia. La memoria entre sesiones permite aprovechar lo aprendido en sesiones anteriores, aunque requiere elegir y mantener una solución, además de asumir el riesgo de que se recuperen repetidamente recuerdos incorrectos.
Q3: ¿La memoria de opencode realmente solo funciona dentro de una sesión?
En noviembre de 2026, un usuario de V2EX publicó que, después de leer otra discusión, descubrió que la memoria de opencode funciona a nivel de sesión. Sin embargo, la discusión original no forma parte de las fuentes de este artículo y la herramienta sigue actualizándose. Lo mejor es consultar la documentación oficial de opencode y comprobar el comportamiento de tu versión actual.
Q4: ¿Para qué casos resulta más útil la memoria entre sesiones?
Es especialmente útil en estos casos:
– **Proyectos grandes con mantenimiento a largo plazo**: hay muchas lecciones aprendidas, dispersas y difíciles de incorporar de antemano en las reglas
– **Preferencias personales**: quieres que la IA recuerde a largo plazo tu estilo y tus hábitos de programación
– **Desarrollo paralelo en varias sesiones**: varios módulos del mismo proyecto avanzan a la vez y necesitan compartir contexto
Normalmente no hace falta para scripts de un solo uso ni para pequeños problemas independientes.
Q5: ¿Cómo se pueden probar y cambiar fácilmente los modelos de resumen o de embeddings que usan los complementos de memoria?
Muchas soluciones de memoria necesitan modelos adicionales para generar resúmenes o vectores. Puedes usar una plataforma que reúne varios modelos, como APIYI apiyi.com, para comparar sus resultados y costos con un método de invocación unificado. Una vez que encuentres uno adecuado, puedes configurarlo en el complemento. Para los parámetros de integración, consulta la documentación de la plataforma en docs.apiyi.com y las instrucciones del complemento.
Q6: ¿La memoria entre sesiones aumenta considerablemente el costo en tokens?
Puede hacerlo. Los recuerdos recuperados ocupan espacio en el contexto cada vez que se utilizan, y los resúmenes automáticos también generan invocaciones adicionales. Conviene limitar primero la cantidad de recuerdos recuperados y medir el consumo adicional durante el período de prueba. La vista de facturación unificada de APIYI apiyi.com facilita la comparación de costos entre distintas combinaciones de modelos.
Q7: ¿Qué riesgos o limitaciones conocidos tiene la memoria entre sesiones?
Hay tres principales: los recuerdos incorrectos o desactualizados pueden seguir confundiendo a las nuevas sesiones; la memoria puede contener información sensible, como claves o rutas internas; y los complementos pueden dejar de funcionar cuando se actualiza la herramienta. Para reducir estos riesgos, elige una solución que permita consultar y eliminar recuerdos, límpiala periódicamente y evita guardar contenido sensible.
Puntos clave sobre la memoria de sesión y entre sesiones
- La memoria de sesión, en esencia: el modelo no mantiene estado; la herramienta reproduce el historial para que «recuerde» dentro de una sesión.
- Evalúa antes de instalar: si tienes que explicar las mismas normas una y otra vez, un archivo de instrucciones suele ser suficiente.
- Cuatro enfoques: archivos de instrucciones, registros manuales, resúmenes automáticos y bases de memoria con recuperación; cada uno tiene sus ventajas y desventajas.
- Seis criterios de evaluación: ubicación del almacenamiento, método de escritura, mecanismo de recuperación, observabilidad, alcance y compatibilidad de costos.
- Poder borrar importa más que automatizarlo todo: un recuerdo erróneo que no se puede corregir repetirá el mismo error en cada sesión nueva.
- Implementación gradual: empieza con un archivo de instrucciones, añade un registro de trabajo y pasa a un complemento de memoria si lo necesitas.
- Prueba los modelos antes de elegir: puedes comparar modelos de resumen y de embeddings mediante la interfaz unificada de APIYI apiyi.com.
Resumen
Estos son los puntos clave sobre la memoria de sesión en las herramientas de programación con IA:
- Entiende sus límites: la memoria de sesión no es un defecto, sino el diseño predeterminado. Permite empezar con un contexto limpio, pero las experiencias no se conservan automáticamente.
- Empieza con una solución económica: un archivo de instrucciones del proyecto y un registro de trabajo resuelven la mayoría de los casos en los que «hay que volver a explicarlo todo».
- Elige el complemento según criterios concretos: si realmente necesitas automatizar la memoria entre sesiones, evalúa almacenamiento, escritura, recuperación, observabilidad, alcance y costos.
Si usas herramientas como opencode y te preguntas «qué complemento de memoria instalar», antes de consultar una lista de complementos conviene tener claro qué quieres recordar, dónde guardarlo y cómo borrarlo. El ecosistema de complementos cambia rápido, así que revisa la documentación oficial y las experiencias reales de la comunidad antes de elegir.
Si tu solución de memoria necesita un modelo de resumen o de embeddings, puedes hacer primero una pequeña prueba comparativa a través de APIYI apiyi.com y después decidir la configuración final.
📚 Referencias
- Preguntas y respuestas de V2EX: ¿Qué plugin de memoria usan con opencode?: la pregunta que dio origen a este artículo
- Enlace:
v2ex.com/t/1254245 -
Nota: un usuario plantea su duda sobre la memoria de opencode a nivel de sesión. La publicación original solo contiene la pregunta; consulta las respuestas de la comunidad en la página del hilo.
-
Documentación oficial de opencode: información sobre memoria, archivos de reglas y capacidades de extensión
- Enlace: consulta la documentación más reciente en el sitio oficial o el repositorio de código abierto de opencode
- Nota: este artículo no cubre toda la información oficial sobre el mecanismo de memoria. Conviene revisarla antes de elegir una solución.
Autor: Equipo técnico de APIYI
Intercambio técnico: contáctanos desde la página principal de APIYI apiyi.com para conversar sobre herramientas de programación con IA y selección de modelos. Encontrarás más recursos en el centro de documentación docs.apiyi.com.