Nota do autor: depois que a DeepSeek disponibilizou o código aberto do protótipo de pesquisa Super-agent, quais são suas reais diferenças em relação ao Claude Code e ao Codex? Este artigo analisa seis dimensões das três camadas de capacidade — modelos, ferramentas de programação e sistemas de orquestração — e traz recomendações para diferentes modos de trabalho.
Em 31 de outubro de 2026, a equipe DeepSeek Harness publicou o artigo técnico “Explorando o design do Super-agent: rumo a sistemas de agentes mais autônomos” e disponibilizou no GitHub oficial o código aberto do protótipo dsh-superagent-prototype, sob licença MIT. A arquitetura de orquestração em duas camadas, com Router residente e Workers independentes rapidamente gerou debates. Veículos como Bloomberg e South China Morning Post também noticiaram o lançamento no contexto da concorrência com Claude Code e Codex.
Este não é mais um artigo para tomar partido sobre “quem vai substituir quem”. O próprio repositório deixa claro que se trata de um protótipo de pesquisa, e Claude Code e Codex há muito deixaram de ser ferramentas limitadas a uma única sessão. Ao comparar DeepSeek Super-agent com Claude Code e Codex, a pergunta que realmente importa é: as diferenças vêm do modelo subjacente ou do sistema de orquestração dos agentes?
O que você vai aprender: ao final do artigo, você saberá em qual camada cada solução se encaixa, entenderá o impacto prático das escolhas de design da DeepSeek e poderá escolher a combinação de ferramentas mais adequada ao seu modo de trabalho.
DeepSeek Super-agent: principais informações
Antes de tudo, vale esclarecer o que foi divulgado. O DeepSeek Super-agent não é um novo modelo de base, mas uma arquitetura de sistema de agentes construída em torno de um modelo de linguagem grande. O que está disponível publicamente é um protótipo de pesquisa, não um produto comercial oficial.
| Item | Detalhes |
|---|---|
| Data de lançamento | 31 de outubro de 2026 (artigo técnico e repositório publicados no mesmo dia) |
| Responsável pelo lançamento | Equipe DeepSeek Harness |
| Nome do projeto | deepseek-ai/dsh-superagent-prototype, desenvolvido principalmente em TypeScript |
| Licença de código aberto | MIT: pode ser baixado e modificado gratuitamente e usado em projetos comerciais, desde que as obrigações da licença sejam cumpridas |
| Status do projeto | Protótipo de pesquisa; a equipe ainda não divulgou uma data de lançamento comercial nem um preço de assinatura específico |
| Requisitos de execução | Ambiente DeepSeek Harness e provedor de modelo configurado |
| Escopo atual | Monitora um único repositório GitHub, com integração opcional ao Feishu, e conduz o trabalho de uma Issue até um PR |
Em 2 de novembro, a página do projeto mostrava cerca de 8.900 stars e 898 forks, números que continuam mudando. Vale lembrar que a quantidade de stars indica apenas o interesse pelo projeto: não revela o número real de instalações nem a taxa de sucesso nas tarefas de programação.
Que problema o DeepSeek Super-agent quer resolver
O ponto de partida da equipe DeepSeek é interessante: conforme os modelos ficam melhores em tarefas individuais, o gargalo de eficiência começa a deixar de ser a capacidade do modelo e passa a ser a atenção humana. Com base na própria experiência, a equipe acredita que uma pessoa geralmente consegue acompanhar de forma eficaz apenas cerca de 3 a 5 sessões ativas de agentes. Entre os motivos estão a dispersão de contexto, a troca frequente de janelas, a necessidade de dar manualmente a próxima instrução ao fim de cada tarefa, chamadas de ferramentas que bloqueiam a sessão e interrupções causadas pela suspensão do dispositivo local.
Esse limite de 3 a 5 sessões é uma estimativa baseada na experiência da equipe DeepSeek, não uma estatística do setor. Ainda assim, ele deixa clara a direção da pesquisa do Super-agent: em vez de tornar o modelo mais inteligente, transferir das pessoas para o sistema o agendamento de sessões, o tratamento de eventos e o gerenciamento de contexto. Para isso, a equipe definiu quatro características desejadas: Continuous (continuidade), Productive (alta produtividade), Proactive (proatividade) e Persistent (persistência). São objetivos de projeto, não uma garantia de que o protótipo já os tenha alcançado.
DeepSeek Super-agent, Claude Code e Codex: entenda os três níveis
Antes de discutir “qual é mais poderoso”, é preciso reconhecer que os três não atuam exatamente no mesmo nível de produto. Claude Code e Codex são produtos e ecossistemas de ferramentas com agentes voltados para programação. Já o Super-agent se concentra em criar, ao redor do agente, um mecanismo de execução contínua, orientado a eventos e capaz de coordenar várias tarefas. O raciocínio e a execução de ferramentas continuam dependendo do modelo subjacente e do DeepSeek Harness.
Por isso, a comparação deve ser dividida em três níveis: a capacidade do modelo determina a qualidade do raciocínio em cada etapa e do código gerado; a capacidade das ferramentas de programação determina se é possível ler e gravar arquivos, executar testes e abrir PRs; e a capacidade do sistema de coordenação determina como várias tarefas são recebidas, distribuídas, acompanhadas e entregues. Misturar os três níveis pode levar a conclusões enganosas.
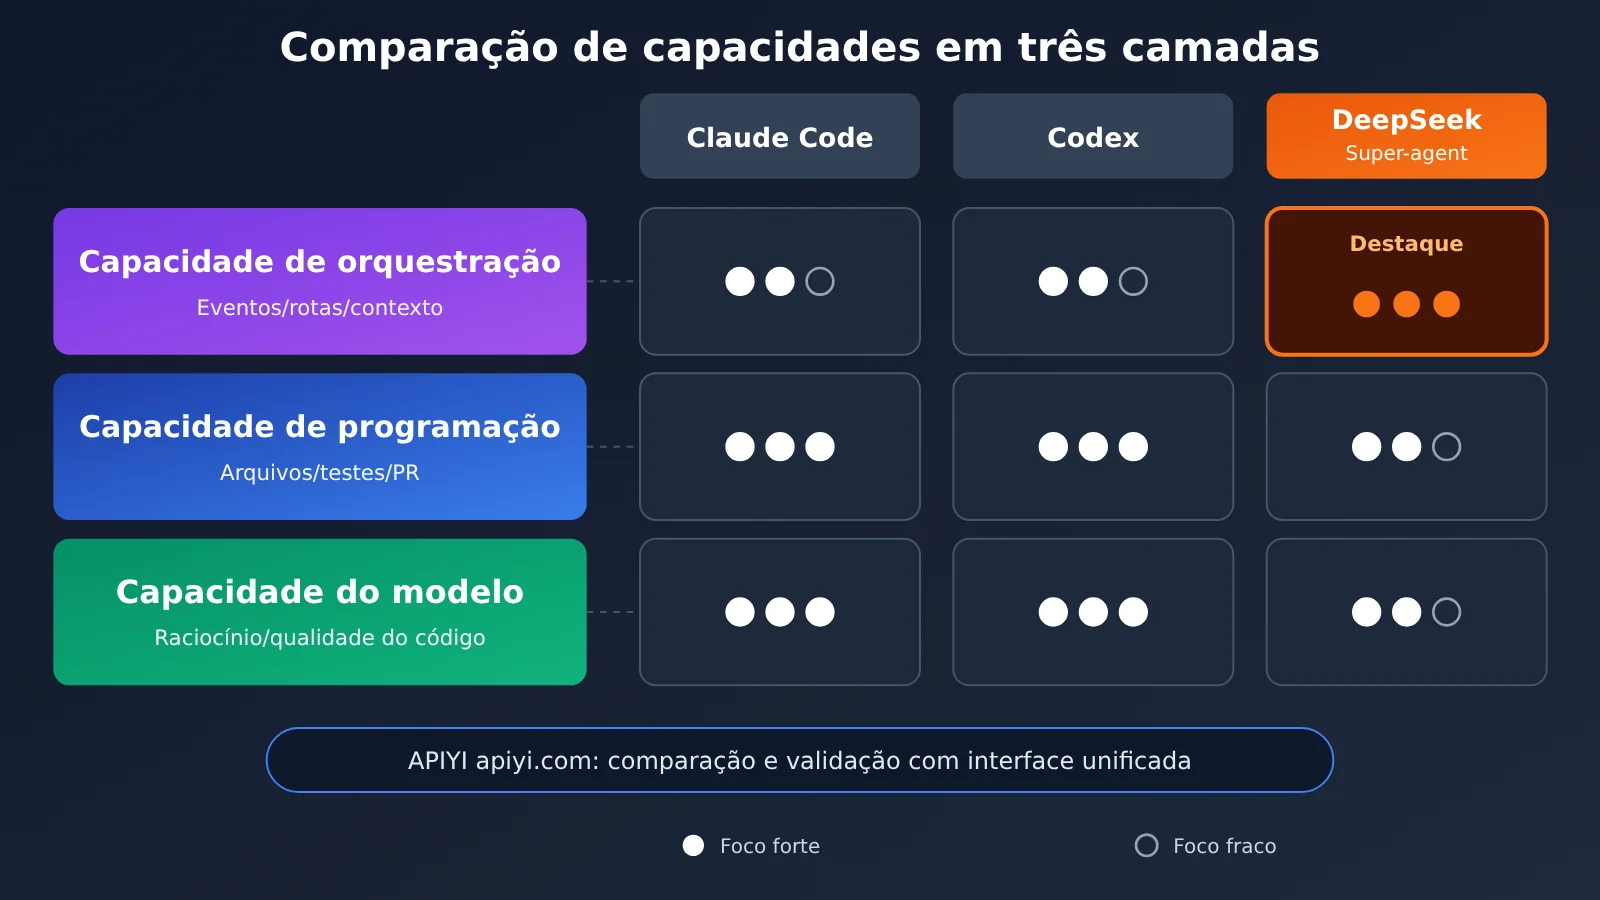
A seguir, comparamos os mecanismos divulgados publicamente em 6 dimensões. Observe que a tabela compara “mecanismos”, não é um ranking de desempenho em condições equivalentes.
| Dimensão | Protótipo DeepSeek Super-agent | Ecossistema Claude Code | Ecossistema Codex / OpenAI |
|---|---|---|---|
| Programação em uma única tarefa | Depende do Harness e do modelo escolhido; um Worker executa a tarefa | Agente de programação maduro, com CLI, aplicativo para desktop e versão em nuvem | Agente de programação maduro, com execução local e em nuvem |
| Colaboração entre vários agentes | Dois níveis: Router + Worker | Subagents e Agent Teams experimental | Sessões paralelas e Worktrees; Multi-agent é um recurso da API |
| Acionamento por eventos | GitHub e, opcionalmente, Feishu | GitHub Actions e Channels (prévia de pesquisa) | Automação por eventos de aplicativos compatíveis e fluxos de trabalho do GitHub Actions |
| Execução contínua em segundo plano | Sessões de Worker; a execução contínua entre dispositivos ainda está em fase de exploração | Agentes em segundo plano e tarefas agendadas na nuvem | Tarefas na nuvem e tarefas agendadas em segundo plano |
| Gerenciamento de contexto | Router permanente mantém o contexto global; Workers são isolados | Subagentes com contextos independentes e lista de tarefas compartilhada pela equipe | Tarefas na nuvem isolam o espaço de trabalho; agente principal consolida os resultados |
| Custo de implantação | Hospedagem própria; exige Node.js, tmux, conta dedicada no GitHub, entre outros | Produto disponível comercialmente, fácil de começar a usar | Produto disponível comercialmente, fácil de começar a usar |
Cada linha tem um impacto diferente na prática. “Programação em uma única tarefa” determina sua experiência diária ao escrever código; “acionamento por eventos” e “execução em segundo plano” determinam se o agente consegue trabalhar sem supervisão constante; “gerenciamento de contexto” determina se as tarefas interferem umas nas outras quando há muitas em andamento; e “custo de implantação” influencia diretamente a disposição da equipe para investir tempo logo de início.
Os recursos multiagente do Claude Code são robustos
Segundo a documentação oficial da Anthropic, os Subagents do Claude Code têm janelas de contexto independentes. É possível definir instruções de sistema específicas, limitar as ferramentas disponíveis, escolher modelos diferentes e executar pesquisas e parte das tarefas de implementação em paralelo, em segundo plano. O recurso experimental Agent Teams vai além: um Lead coordena vários Teammates, cada um em uma sessão independente do Claude Code. Eles compartilham uma lista de tarefas e podem trocar mensagens diretamente. O recurso vem desativado por padrão, e a Anthropic alerta que ele aumenta o esforço de coordenação e o consumo de tokens.
Quanto a eventos e execução contínua, o claude-code-action pode responder a menções de @claude em comentários de issues e PRs e, com a configuração adequada, transformar issues em PRs. O Channels, disponível como prévia de pesquisa, usa o MCP para enviar mensagens de chat, webhooks e resultados de CI a uma sessão em execução, mas exige que ela permaneça ativa. Também há o /loop dentro da sessão, tarefas agendadas no aplicativo para desktop e tarefas agendadas na nuvem. Algumas delas podem continuar na nuvem mesmo depois que o computador é desligado. Portanto, a ideia de que “o Claude Code só espera passivamente por entradas” já ficou para trás.
Recursos multitarefa do Codex: produto e API são coisas diferentes
O Codex pode usar o Git Worktree para criar vários diretórios de trabalho independentes para um mesmo projeto, permitindo que sessões diferentes modifiquem branches distintas em paralelo. O Codex Cloud analisa código, implementa alterações e executa testes em um ambiente de trabalho isolado. As tarefas na nuvem continuam mesmo depois que o computador local é desligado. O ecossistema ChatGPT/Codex também oferece suporte a tarefas agendadas em segundo plano e, para usuários elegíveis, a gatilhos de eventos de aplicativos como o GitHub e à filtragem de atividades de PRs.
Há um ponto que pode gerar confusão: os recursos multiagente oferecidos pela OpenAI Agents API e pela Responses API — como um agente principal que delega tarefas a subagentes com contextos independentes — são recursos de API. Eles não devem ser tratados como funcionalidades padrão de todas as interfaces do Codex. Da mesma forma, o fluxo apresentado no OpenAI Cookbook, que usa o GitHub Actions para chamar o Codex CLI e gerar um PR de correção após uma falha de CI, é uma maneira de montar um fluxo de trabalho, não uma função nativa disponível no Codex CLI sem configuração.
Orquestração com Router + Worker no DeepSeek Super-agent
O fluxo central do protótipo DeepSeek pode ser resumido como Source → Trigger → Eval → Ticket → Assignment → Executor → Result. Os eventos chegam pelo GitHub ou pelo Feishu e passam primeiro por regras determinísticas de verificação de permissões. Em seguida, o modelo avalia se é necessário criar uma tarefa. Cada tarefa aceita gera um Ticket independente, que é atribuído a um Worker com seu próprio diretório de trabalho. O resultado volta pelo canal original, por exemplo, como um PR no GitHub.
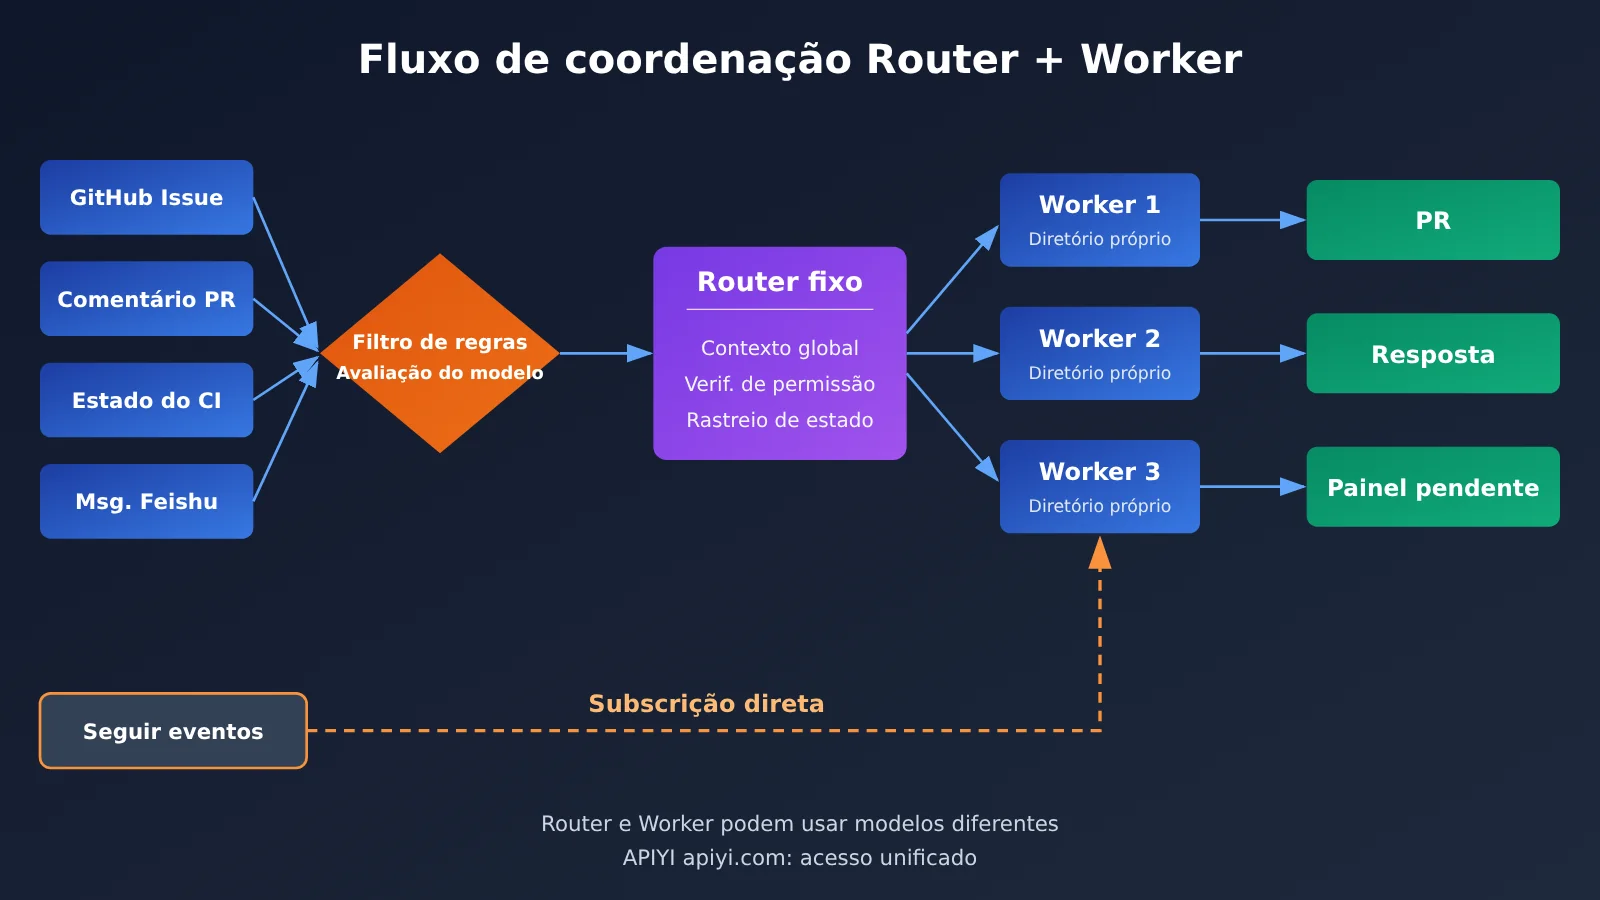
O Router é a sessão principal, que permanece em execução. Ele recebe mensagens, mantém o contexto global, decide se deve criar tarefas, verifica autorizações e distribui e acompanha as tarefas. Em princípio, não assume tarefas complexas de programação. Segundo a equipe do DeepSeek, justamente por isso, em alguns casos o Router pode usar um modelo mais leve para reduzir os custos de orquestração. Já o Worker recebe um Ticket específico e, em um diretório isolado, escreve código, executa testes, lida com feedback posterior e entrega o resultado.
A verdadeira diferença: o foco do sistema de orquestração do DeepSeek Super-agent
Se Claude Code e Codex já contam com múltiplos agentes, execução em segundo plano e recursos de eventos, onde está o diferencial da DeepSeek? A resposta não está em “ter ou não ter” esses recursos, mas em “quem gerencia as tarefas” e qual é o alcance desse gerenciamento.
Em geral, um agente principal que distribui subtarefas, ou o Team Lead de uma equipe de agentes, participa ativamente do planejamento, da coordenação e da consolidação dos resultados de uma única tarefa complexa. O Router da DeepSeek, por sua vez, dá mais atenção à coordenação de alto nível entre tarefas: um Router permanente gerencia várias atividades relativamente independentes ao mesmo tempo. Para o usuário, há um único Super-agent lógico, com o qual ele interage diretamente em canais de trabalho como GitHub e Feishu, sem precisar gerenciar cada sessão de Worker.
A própria DeepSeek reconhece que, se o agente principal de uma equipe de agentes for configurado para cuidar apenas da interação global e da distribuição de tarefas, sem executá-las diretamente, também é possível criar uma arquitetura semelhante de duas camadas. Portanto, Router + Worker não é um recurso exclusivo que ninguém mais consegue implementar. A verdadeira diferença está no grau de sistematização do monitoramento permanente, do roteamento entre tarefas e do contexto de trabalho unificado. Isso aparece em três pontos:
- Router permanente: funciona como uma sessão principal que permanece ativa, em vez de ser um coordenador criado temporariamente para cada tarefa. Assim, o contexto global pode continuar entre tarefas.
- Encaminhamento direto por assinatura de eventos: um Worker inscrito em uma thread pode receber diretamente os eventos subsequentes, como novos comentários no mesmo PR, reduzindo a necessidade de o Router distribuí-los novamente.
- Proatividade conservadora: as tarefas são divididas entre Explicit (solicitações explícitas) e Inferred (candidatas inferidas). Por padrão, o trabalho inferido fica no modo
observe: é apenas registrado, sem execução. A mesclagem automática de PRs também vem desativada por padrão.
Como interpretar os dados dos experimentos oficiais do DeepSeek Super-agent
A DeepSeek realizou uma série de experimentos sintéticos de orquestração: cada execução tinha cerca de 300 mensagens, das quais aproximadamente 20 eram solicitações de trabalho. As demais incluíam conversas informais, feedback posterior, cancelamentos e mensagens de CI. O trabalho de programação foi substituído por ferramentas simuladas que consumiam tempo, e cada configuração foi executada 5 vezes.
| Configuração | Tempo de conclusão P50 | Tempo de conclusão P95 | Tokens lidos do cache por execução |
|---|---|---|---|
| Super-agent | 12,4 minutos | 15,7 minutos | Cerca de 23,2 milhões |
| Super-agent, sem encaminhamento direto por assinatura | 12,6 minutos | 15,5 minutos | Cerca de 31,8 milhões |
| Sessão única + Subagent, comando neutro | 20,4 minutos | 29,5 minutos | Cerca de 6,1 milhões |
| Sessão única + Subagent, priorizando delegação | 13,8 minutos | 29,0 minutos | Cerca de 10,8 milhões |
Há duas conclusões especialmente úteis nesses dados. Primeiro, em comparação com a configuração de sessão única que prioriza a delegação, a vantagem do Super-agent no P50 é pequena, mas a cauda longa no P95 é bem menor. Isso indica que o principal benefício da arquitetura de duas camadas é evitar que algumas tarefas demorem muito mais quando há várias em andamento. Segundo, ao remover o encaminhamento direto por assinatura, o tempo de conclusão praticamente não mudou, mas a leitura de cache subiu de cerca de 23,2 milhões para 31,8 milhões de tokens. Isso sugere que a função principal desse encaminhamento é reduzir o processamento repetido pelo Router, não aumentar a velocidade.
Mas é importante deixar os limites claros: este é um experimento de orquestração, não um teste de qualidade de geração de código. O grupo de comparação usou uma sessão única + Subagent sob comandos específicos; não foi um teste dos produtos completos Claude Code ou Codex nas mesmas condições. Portanto, os dados não provam um aumento de 39% ou 47% na eficiência de programação no mundo real e muito menos servem para criar um ranking de velocidade entre os três. Outro teste oficial de processamento em lote do Router mostrou que, com cerca de 40 eventos por minuto, o tamanho médio dos lotes chegou a 2,8 e o tempo de inferência por decisão caiu para 1,6 segundo. Esse resultado também indica apenas a viabilidade sob a carga usada no teste.
Custos e limites de segurança do DeepSeek Super-agent
Mais velocidade significa mais tokens. Em testes sintéticos, o volume de leituras do cache do Super-agent foi cerca de 3,8 vezes maior que o de uma solução neutra com sessão única. Isso não significa, porém, que o custo total seja 3,8 vezes maior: o valor final também depende dos preços dos modelos, da taxa de acerto do cache, do volume de tokens de entrada e saída e dos modelos usados pelo Router e pelos Workers. A DeepSeek ainda não divulgou o custo médio por tarefa real.
Como referência, estes eram os preços oficiais da API da DeepSeek em 02/11/2026 (em dólares por milhão de tokens). São tarifas dos modelos, não um plano de cobrança do Super-agent:
| Modelo e horário | Entrada sem acerto no cache | Entrada com acerto no cache | Saída |
|---|---|---|---|
| DeepSeek V4.1 Flash fora do pico | $0.15 | $0.003 | $0.60 |
| DeepSeek V4.1 Flash no pico | $0.30 | $0.006 | $1.20 |
| DeepSeek V4 Pro fora do pico | $0.66 | $0.022 | $1.98 |
| DeepSeek V4 Pro no pico | $1.32 | $0.044 | $3.96 |
Além disso, Search e Fetch custam $0.75 cada por mil solicitações bem-sucedidas. A cobrança começou em 1º de novembro de 2026, à 00h00 no horário de Pequim, e só ocorre quando as ferramentas são usadas. Quem faz a implantação também precisa considerar recursos de servidor, custos de operação contínua e manutenção manual. Já Claude Code e Codex têm planos diferentes que envolvem assinatura, API e execução na nuvem. Por isso, ainda não há uma medida uniforme de “custo por PR qualificado” que permita comparar os três.
💰 Dica para gerenciar custos: em uma arquitetura com vários agentes, o principal fator de custo é “qual modelo cada função usa”. Se quiser testar uma combinação com um modelo leve no Router e um modelo mais potente nos Workers, você pode usar a APIYI apiyi.com para acessar modelos de vários provedores com uma única chave API. A cobrança é por uso, o que facilita acompanhar o gasto de tokens das diferentes combinações na mesma fatura.
A segurança também merece atenção. A documentação oficial de implantação reconhece que as configurações específicas do Router e dos Workers rodam no modo danger-full-access e, por padrão, são executadas com a conta de sistema do operador. Isso permite que acessem arquivos do diretório pessoal, executem programas locais e tenham contato com credenciais locais. A recomendação oficial é usar uma conta de sistema separada e uma conta de bot independente no GitHub. Monitorar comentários e mensagens externas também traz riscos de injeção de comandos. A comunidade publicou um relatório de auditoria independente sobre o commit 6337fc8, apontando possíveis problemas, como na validação da interface de administração. No entanto, o processo completo de ataque não foi reproduzido de forma independente, então deve ser tratado como um “risco potencial”, e não como um incidente comprovado.
Análise do impacto do DeepSeek Super-agent
Impacto para desenvolvedores
- Os critérios de avaliação precisam evoluir: ao escolher uma ferramenta, não basta olhar a pontuação do modelo subjacente. Também é preciso avaliar se a integração de eventos, o isolamento de tarefas, a execução em segundo plano e os mecanismos de revisão humana se encaixam no fluxo da equipe.
- O protótipo funciona, mas exige atenção: o usuário da comunidade xxxxkkkqq conseguiu levar uma Issue até um PR em um repositório privado, mas também enfrentou problemas com notificações que não chegavam, verificações de implantação aprovadas sem entrega das mensagens e falhas nas asserções de teste causadas pelo idioma chinês do sistema. Outro usuário encontrou, em uma hora de uso no WSL2, dois defeitos: um na identificação de processos Node.js 24 e outro no recebimento de comentários do GitHub.
- O valor para desenvolvimento próprio é evidente: para equipes que conseguem manter integrações com TypeScript, GitHub e APIs de modelos, o projeto oferece uma implementação de referência completa de Router, eventos, tickets, Worker e regras de permissão.
Impacto para o setor
- O foco da competição está mudando: na programação com IA, a disputa já não se resume a comparar modelos. Agent Harness, design de fluxos de trabalho e experiência do desenvolvedor estão se tornando fatores igualmente importantes.
- O “Agent proativo” caminha para a padronização: a DeepSeek vincula o “trabalho proativo” a políticas de autorização, modo observe e aprovação humana, respondendo à preocupação real de que Agents possam desperdiçar a atenção da equipe.
Com base nesses recursos, é possível escolher conforme o modo de trabalho:
| Modo de trabalho | Combinação recomendada | Motivo |
|---|---|---|
| Programação diária em tarefas individuais | Claude Code ou Codex | Produtos oficiais, fáceis de começar a usar e sem necessidade de implantar um sistema de agendamento |
| Várias tarefas independentes em paralelo | Claude Code Agent Teams / Agent em segundo plano, Codex Worktrees / tarefas na nuvem | Já contam com mecanismos maduros de paralelismo e isolamento |
| Pesquisa sobre monitoramento contínuo de eventos e roteamento unificado | Protótipo DeepSeek Super-agent | Demonstra de forma direta o design de um Router permanente e de assinaturas de eventos |
| Sistema próprio de orquestração de Agents | Protótipo de código aberto + APIs de vários modelos | Permite personalizar a lógica de agendamento e a divisão de funções entre modelos |
| Repositórios de produção sensíveis | Ainda não é recomendável usar diretamente o protótipo de pesquisa | A execução com permissões elevadas e as questões de segurança ainda precisam ser aprimoradas |
🎯 Dica de escolha: as combinações de ferramentas não são excludentes. Muitas equipes podem usar Claude Code ou Codex para a programação diária e uma camada própria de agendamento para lidar com eventos e roteamento. Ao criar essa camada, é possível começar obtendo créditos gratuitos de teste pela APIYI apiyi.com e comparar o desempenho de diferentes modelos nas funções de Router e Worker.
Reproduzindo a lógica do Router do DeepSeek Super-agent com uma API
A melhor forma de entender um sistema de escalonamento é criar uma versão mínima. O exemplo abaixo usa uma interface compatível com a OpenAI para que um modelo leve tome decisões de roteamento. Ele serve apenas para ilustrar a ideia e não representa o código real do protótipo do DeepSeek:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

event = "PR #42 评论:CI 在 test_auth.py 失败,请帮忙看看"
resp = client.chat.completions.create(
    model="ROUTER_MODEL",  # 替换为控制台中可用的轻量模型名
    messages=[{"role": "user", "content": f"判断该事件是否需要建任务,只回答 YES/NO:{event}"}]
)
print(resp.choices[0].message.content)
Veja o exemplo completo de código com Router + Worker
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 一个 Key 接入多家模型
)

ROUTER_MODEL = "ROUTER_MODEL"   # 轻量模型:负责路由判断
WORKER_MODEL = "WORKER_MODEL"   # 强模型:负责具体任务
AUTHORIZED_USERS = {"alice", "bob"}  # 确定性规则:授权名单

@dataclass
class Ticket:
    thread_id: str
    task: str
    history: list = field(default_factory=list)

tickets: dict[str, Ticket] = {}

def router_eval(event: dict) -> bool:
    """先规则过滤,再由模型判断是否建任务"""
    if event["user"] not in AUTHORIZED_USERS:
        return False  # 未授权:仅观察,不执行
    resp = client.chat.completions.create(
        model=ROUTER_MODEL,
        messages=[
            {"role": "system", "content": "你是任务路由器,只回答 YES 或 NO。"},
            {"role": "user", "content": f"该消息是否是需要执行的工作请求?\n{event['text']}"}
        ],
        max_tokens=5
    )
    return "YES" in resp.choices[0].message.content.upper()

def worker_run(ticket: Ticket, text: str) -> str:
    """Worker 使用独立上下文处理任务"""
    ticket.history.append({"role": "user", "content": text})
    resp = client.chat.completions.create(
        model=WORKER_MODEL,
        messages=[{"role": "system", "content": "你是代码修复助手,给出修复思路。"}] + ticket.history
    )
    answer = resp.choices[0].message.content
    ticket.history.append({"role": "assistant", "content": answer})
    return answer

def handle(event: dict) -> str:
    tid = event["thread_id"]
    # 订阅直通:已有 Ticket 的后续事件直接交给对应 Worker
    if tid in tickets:
        return worker_run(tickets[tid], event["text"])
    if router_eval(event):
        tickets[tid] = Ticket(thread_id=tid, task=event["text"])
        return worker_run(tickets[tid], event["text"])
    return "已记录,未建任务"

print(handle({"thread_id": "pr-42", "user": "alice", "text": "CI 在 test_auth.py 失败"}))
print(handle({"thread_id": "pr-42", "user": "alice", "text": "补充:只在 Python 3.12 下失败"}))
Esse exemplo mostra três pontos: as regras determinísticas são aplicadas antes da avaliação do modelo, o Router e o Worker usam modelos diferentes e os eventos seguintes da mesma thread entram diretamente no contexto do Worker existente. Um sistema real também precisa de isolamento dos diretórios de trabalho, sandbox de permissões, persistência de estado e revisão humana. Esses são justamente alguns dos pontos que ainda estão sendo aprimorados no protótipo.
🚀 Comece agora: para executar o código acima, basta substituir a chave API e os nomes dos modelos. Confira a lista de modelos disponíveis no console da APIYI, em apiyi.com. Novos usuários recebem créditos gratuitos para testes, uma boa forma de validar a lógica de escalonamento com baixo custo antes de investir em desenvolvimento adicional.
Perguntas frequentes (FAQ)
Q1: O DeepSeek Super-agent é um modelo novo?
Não. O Super-agent é uma arquitetura de sistema de agentes que funciona fora do modelo. O projeto de código aberto é um protótipo de pesquisa baseado no DeepSeek Harness. Ele não exige um modelo específico da DeepSeek: é possível definir o provedor e o modelo do Router e do Worker nas configurações.
Q2: O DeepSeek Super-agent vai substituir o Claude Code e o Codex?
Por enquanto, não há motivos para afirmar isso. Os três atuam em níveis diferentes: Claude Code e Codex são produtos maduros de agentes de programação, enquanto o Super-agent se concentra na orquestração contínua externa. Até 2 de novembro, também não havia comparações públicas de programação em larga escala e nas mesmas condições. Os experimentos sintéticos oficiais não podem ser tratados como resultados comparativos de desempenho entre os três.
Q3: Claude Code e Codex conseguem executar tarefas em segundo plano e acionadas por eventos?
Sim. O Claude Code oferece GitHub Actions, Channels em prévia de pesquisa, agentes em segundo plano e tarefas agendadas na nuvem. O ecossistema do Codex oferece tarefas na nuvem, Worktrees, tarefas agendadas em segundo plano e automações por eventos em aplicativos compatíveis. A diferença está nos pontos de acesso, nos requisitos de elegibilidade e nos mecanismos de implementação, não na existência desses recursos.
Q4: O protótipo do DeepSeek Super-agent é gratuito?
O código é aberto e gratuito sob a licença MIT, mas a invocação do modelo continua sendo cobrada por token. Também há custos de servidor, manutenção e revisão humana. Código aberto não significa necessariamente um custo total menor por tarefa. Para gerenciar os gastos de API de vários modelos em um só lugar, você pode usar a APIYI apiyi.com, com cobrança por uso e consulta centralizada do consumo.
Q5: Como testar a divisão de tarefas entre vários modelos com Router + Worker gastando pouco?
Você pode usar o código de exemplo deste artigo como referência, definir `base_url` como `https://api.apiyi.com/v1` e deixar um modelo leve fazer o roteamento enquanto um modelo mais potente executa as tarefas. Depois de se cadastrar na APIYI apiyi.com, você recebe créditos gratuitos para testes e pode usar uma única chave API para alternar e comparar modelos populares, como OpenAI, Claude e Gemini.
Q6: Quais são as limitações conhecidas do protótipo do DeepSeek Super-agent?
No momento, ele só permite monitorar um único repositório do github.com e não oferece suporte ao GitHub Enterprise Server. A implantação exige Node.js 22.19+ ou 24+, tmux, GitHub CLI 2.48+ e uma conta de bot dedicada. Por padrão, o Worker é executado com privilégios elevados, o que traz riscos de injeção de comandos e exposição de credenciais. A comunidade também relatou problemas como perda de notificações e compatibilidade com o Node.js 24. Por isso, não é recomendável usá-lo diretamente em repositórios de produção sensíveis.
DeepSeek Super-agent vs. Claude Code e Codex: principais conclusões
- Níveis diferentes: Super-agent é um protótipo de sistema de orquestração; Claude Code e Codex são produtos de agentes de programação.
- Multiagente não é exclusividade: Claude Code e Codex já contam com subagentes, sessões paralelas, execução em segundo plano e recursos baseados em eventos.
- A diferença está na sistematização: Router sempre ativo, roteamento entre tarefas, acesso direto por assinatura e contexto unificado são os pontos centrais do projeto.
- Os dados experimentais têm limites: experimentos sintéticos de orquestração refletem apenas o desempenho nessa função, não a qualidade do código nem um ranking entre os três.
- Velocidade em troca de tokens: as leituras de cache são cerca de 3,8 vezes maiores que na solução de sessão única. O custo precisa ser calculado conforme a combinação de modelos.
- Segurança desde o início: a execução com privilégios elevados e o risco de injeção por entradas externas exigem uma conta separada e validação humana.
- Testar na prática é mais confiável: com uma única chave da APIYI apiyi.com, é possível experimentar a divisão de funções entre Router e Worker usando vários modelos.
Resumo
As principais conclusões da comparação entre DeepSeek Super-agent, Claude Code e Codex são:
- A primeira diferença é o nível de atuação: capacidade do modelo, recursos da ferramenta de programação e capacidade do sistema de orquestração são coisas distintas. Compará-las como se fossem a mesma coisa não faz sentido.
- O valor do DeepSeek está no projeto de orquestração: ele sistematiza o monitoramento contínuo, o roteamento entre tarefas e o contexto unificado, usando autorização e o modo observe para limitar as ações proativas.
- A diferença de maturidade é real: o protótipo já tem um caso real que vai de Issue a PR, mas instalação, confiabilidade e segurança ainda precisam melhorar. Claude Code e Codex continuam sendo escolhas seguras para a programação do dia a dia.
A competição na programação com IA está deixando de ser apenas uma disputa sobre “qual modelo é melhor” para abranger Agent Harness, fluxos de trabalho e experiência do desenvolvedor. Para a maioria das equipes, o caminho mais prático é usar produtos maduros no dia a dia e, ao mesmo tempo, experimentar uma camada própria de orquestração em pequena escala.
Uma opção é usar a APIYI apiyi.com para acessar de forma unificada modelos de diferentes provedores e verificar rapidamente o desempenho e os custos de cada um nas funções de Router e Worker.
📚 Referências
- Repositório oficial do protótipo DeepSeek Super-agent: status do projeto, código-fonte e escopo de aplicação
- Link:
github.com/deepseek-ai/dsh-superagent-prototype -
Descrição: inclui o README e documentos sobre implantação, mecanismo de autorização e filosofia de design
-
Preços oficiais da API DeepSeek: preços dos modelos e custos de Search/Fetch
- Link:
api-docs.deepseek.com/quick_start/pricing -
Descrição: base para calcular os custos dos modelos Router e Worker
-
Documentação do Claude Code Subagents e Agent Teams: recursos para múltiplos agentes
- Links:
code.claude.com/docs/en/sub-agents、code.claude.com/docs/en/agent-teams -
Descrição: explica o contexto independente dos subagentes e os mecanismos de colaboração em equipe
-
Documentação do Claude Code Channels e de tarefas agendadas: envio de eventos e execução contínua
- Links:
code.claude.com/docs/en/channels、code.claude.com/docs/en/scheduled-tasks -
Descrição: apresenta as condições de uso e limitações dos recursos em prévia de pesquisa
-
Documentação do Codex Cloud e Worktrees: tarefas na nuvem e espaços de trabalho paralelos
- Links:
help.openai.com/en/articles/20001545-using-codex-cloud、learn.chatgpt.com/docs/environments/git-worktrees -
Descrição: fontes oficiais para diferenciar os recursos do Codex
-
Guia Multi-agent da OpenAI Agents API: orquestração de múltiplos agentes na camada de API
- Link:
developers.openai.com/api/docs/guides/agents-api/multi-agent -
Descrição: consulte separadamente dos recursos do produto Codex
-
Discussão da comunidade sobre testes do DeepSeek Harness: relato de ponta a ponta, da issue ao PR
- Link:
github.com/deepseek-ai/deepseek-harness/discussions/11706 - Descrição: mostra como o protótipo funciona na prática e quais são os problemas comuns
Autor: Equipe técnica da APIYI
Contato técnico: Entre em contato pela página inicial do site oficial da APIYI. Para mais conteúdo sobre integração de múltiplos modelos e orquestração de agentes, acesse a central de documentação em docs.apiyi.com