Note de l’auteur : après la publication en open source du prototype de recherche Super-agent par DeepSeek, quelles sont ses véritables différences avec Claude Code et Codex ? Cet article les examine sous 6 angles, en distinguant trois niveaux de capacité : le modèle, l’outil de programmation et le système d’orchestration. Il propose aussi des recommandations selon votre façon de travailler.
Le 31 octobre 2026, l’équipe DeepSeek Harness a publié l’article technique « Exploration de la conception de Super-agent : vers des systèmes d’agents plus autonomes » et mis en open source, sous licence MIT, le prototype associé dsh-superagent-prototype sur son GitHub officiel. Son architecture d’orchestration à deux niveaux, avec un Router permanent et des Workers indépendants, a rapidement suscité des discussions. Bloomberg, le South China Morning Post et d’autres médias l’ont présenté dans le contexte de la concurrence avec Claude Code et Codex.
Cet article ne cherche pas à prendre parti pour déterminer « qui va remplacer qui ». Le dépôt indique clairement qu’il s’agit d’un prototype de recherche, et Claude Code comme Codex ne se limitent plus depuis longtemps à une seule session. La vraie question, lorsqu’on compare DeepSeek Super-agent à Claude Code et Codex, est plutôt celle-ci : les différences viennent-elles du modèle sous-jacent ou du système d’orchestration des agents ?
Ce que vous allez en tirer : à la fin de cet article, vous saurez à quel niveau se situe chacun des trois, ce que les choix de conception de DeepSeek apportent concrètement et quelle combinaison d’outils convient à votre façon de travailler.
DeepSeek Super-agent : l’essentiel en bref
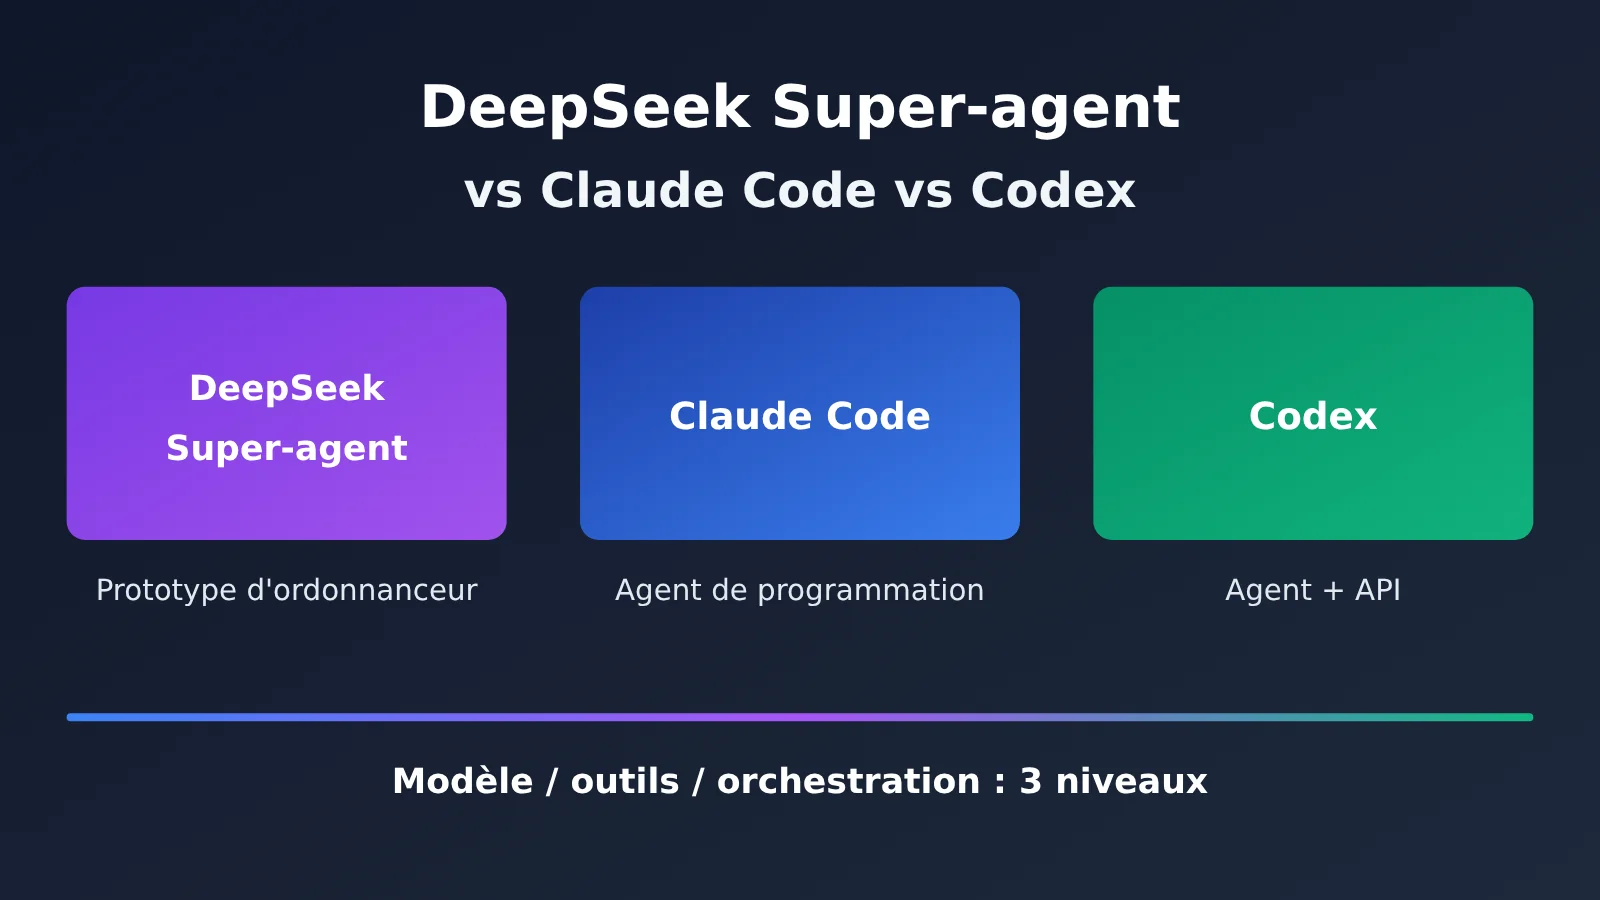
Commençons par clarifier les faits. DeepSeek Super-agent n’est pas un nouveau modèle de base, mais une architecture de système d’agents construite autour d’un grand modèle de langage. Ce qui a été rendu public est un prototype de recherche, pas un produit commercial.
| Information | Détails |
|---|---|
| Date de publication | 31 octobre 2026 (article technique et dépôt publiés le même jour) |
| Équipe à l’origine du projet | Équipe DeepSeek Harness |
| Nom du projet | deepseek-ai/dsh-superagent-prototype, principalement développé en TypeScript |
| Licence open source | MIT : téléchargement et modification gratuits, utilisation commerciale possible sous réserve de respecter les obligations de la licence |
| Statut du projet | Prototype de recherche ; aucune date de sortie officielle ni aucun tarif d’abonnement spécifique n’ont été annoncés |
| Dépendances | Nécessite un environnement DeepSeek Harness et un fournisseur de modèles configuré |
| Périmètre actuel | Surveille un seul dépôt GitHub, avec intégration facultative à Feishu, et fait avancer les tâches de l’Issue à la PR |
Au 2 novembre, la page du projet affichait environ 8 900 stars et 898 forks ; ces chiffres continuent d’évoluer. Les stars reflètent l’intérêt suscité par le projet : elles ne donnent aucune indication sur le nombre réel d’installations ni sur le taux de réussite des tâches de programmation.
Quel problème DeepSeek Super-agent cherche-t-il à résoudre ?
Le point de départ de l’équipe DeepSeek est intéressant : à mesure que les modèles deviennent plus performants sur des tâches individuelles, le principal frein à l’efficacité ne serait plus la capacité du modèle, mais l’attention humaine. D’après son expérience, une personne ne peut généralement suivre efficacement que 3 à 5 sessions d’agents actives. En cause : le contexte dispersé, les changements fréquents de fenêtre, la nécessité de donner manuellement l’instruction suivante à la fin d’une tâche, les appels d’outils qui bloquent les sessions ou encore les interruptions dues à la mise en veille de l’appareil local.
Ces 3 à 5 sessions sont une estimation issue de l’expérience de l’équipe DeepSeek, et non une statistique sectorielle. Elle illustre toutefois clairement la direction de recherche de Super-agent : il ne s’agit pas de rendre le modèle plus intelligent, mais de transférer de l’humain au système la coordination des sessions, le traitement des événements et la gestion du contexte. L’équipe a défini quatre caractéristiques cibles : Continuous (continuité), Productive (productivité élevée), Proactive (proactivité) et Persistent (persistance). Ce sont des objectifs de conception, pas la preuve que le prototype les remplit déjà tous.
DeepSeek Super-agent face à Claude Code et Codex : trois niveaux à distinguer
Avant de se demander « lequel est le plus puissant ? », il faut reconnaître que ces trois solutions ne se situent pas exactement au même niveau. Claude Code et Codex sont des produits Agent et des écosystèmes d’outils dédiés à la programmation. Super-agent cherche plutôt à construire, autour de l’Agent, un mécanisme d’exécution permanent, piloté par les événements et capable de coordonner plusieurs tâches. Le raisonnement et l’exécution des outils dépendent toujours du modèle sous-jacent et de DeepSeek Harness.
La comparaison doit donc distinguer trois niveaux : les capacités du modèle déterminent la qualité du raisonnement à chaque étape et du code généré ; les capacités des outils de programmation déterminent s’ils peuvent lire et modifier des fichiers, exécuter des tests ou créer des PR ; les capacités du système d’orchestration déterminent comment plusieurs tâches sont reçues, réparties, suivies et livrées. Mélanger ces trois niveaux peut facilement conduire à des conclusions trompeuses.
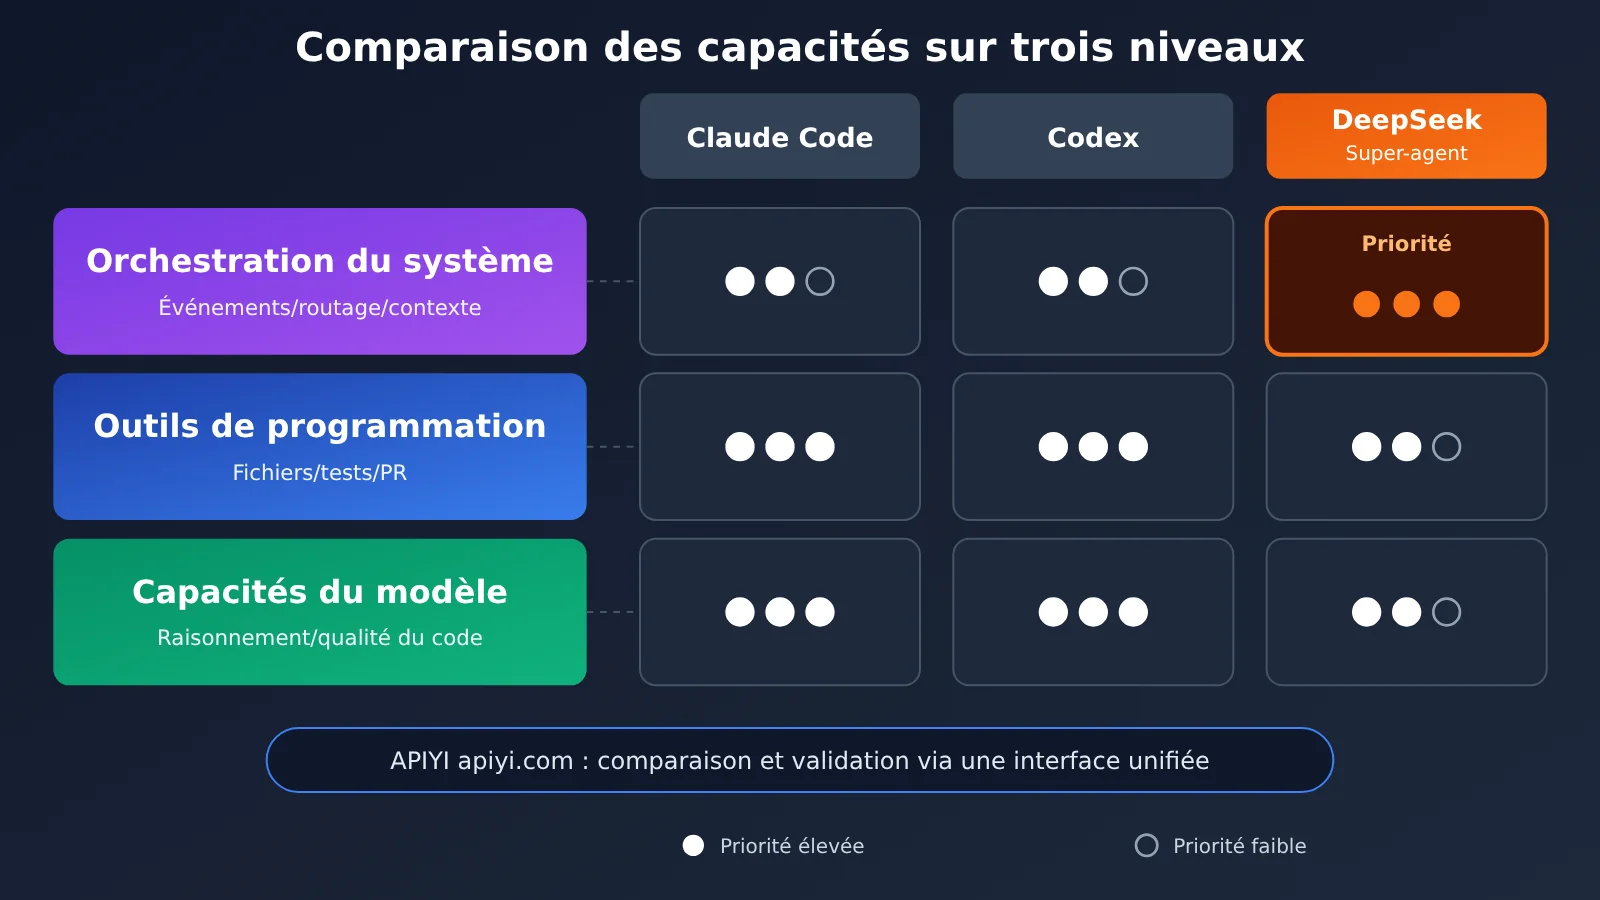
Voici une comparaison des mécanismes actuellement présentés publiquement, selon six critères. Attention : ce tableau compare des « mécanismes », pas des performances mesurées dans les mêmes conditions.
| Critère | Prototype DeepSeek Super-agent | Écosystème Claude Code | Écosystème Codex / OpenAI |
|---|---|---|---|
| Programmation sur une seule tâche | Dépend de Harness et du modèle choisi ; exécution par un Worker | Agent de programmation mature, en CLI, sur ordinateur et dans le cloud | Agent de programmation mature, en local et dans le cloud |
| Collaboration multi-Agent | Deux niveaux : Router + Worker | Subagents, Agent Teams expérimentaux | Sessions parallèles, Worktrees ; le multi-agent est une capacité de l’API |
| Déclenchement par événement | GitHub, Feishu en option | GitHub Actions, Channels en aperçu de recherche | Automatisation par événements d’applications prises en charge, workflows GitHub Actions |
| Exécution continue en arrière-plan | Sessions Worker ; l’exécution continue entre appareils reste une piste de conception | Agents en arrière-plan, tâches planifiées dans le cloud | Tâches dans le cloud, tâches planifiées en arrière-plan |
| Gestion du contexte | Router permanent qui maintient le contexte global, Workers isolés | Contexte indépendant pour chaque sous-Agent, liste de tâches partagée par l’équipe | Espace de travail isolé pour chaque tâche cloud, synthèse par l’Agent principal |
| Coût de déploiement | Auto-hébergé ; nécessite notamment Node.js, tmux et un compte GitHub dédié | Produit officiel, facile à prendre en main | Produit officiel, facile à prendre en main |
Chaque ligne répond à un besoin différent. La « programmation sur une seule tâche » détermine votre expérience quotidienne d’écriture de code ; le « déclenchement par événement » et l’« exécution en arrière-plan » déterminent si l’Agent peut travailler sans surveillance ; la « gestion du contexte » détermine si les tâches risquent d’interférer entre elles lorsqu’elles se multiplient ; le « coût de déploiement », enfin, influe directement sur la volonté de l’équipe d’y consacrer du temps au départ.
Claude Code dispose de solides capacités multi-agents
Selon la documentation officielle d’Anthropic, les Subagents de Claude Code disposent chacun d’une fenêtre de contexte indépendante. On peut leur définir des instructions système spécifiques, limiter les outils auxquels ils ont accès et leur attribuer différents modèles. Ils peuvent aussi mener des recherches et réaliser certaines tâches d’implémentation en parallèle, en arrière-plan. La fonctionnalité expérimentale Agent Teams va plus loin : un Lead et plusieurs Teammates disposent chacun d’une session Claude Code indépendante et partagent une liste de tâches. Les coéquipiers peuvent aussi échanger directement des messages. Cette fonctionnalité est désactivée par défaut, et Anthropic prévient qu’elle augmente les coûts de coordination et la consommation de tokens.
Pour la gestion des événements et les tâches en continu, claude-code-action peut répondre aux mentions @claude dans les commentaires d’issues et de PR et, avec la configuration adaptée, transformer une issue en PR. Channels, proposé en préversion de recherche, utilise MCP pour transmettre des messages de discussion, des webhooks et des résultats de CI à une session active. La session doit toutefois rester ouverte. Il existe aussi /loop dans les sessions, ainsi que des tâches planifiées sur l’application de bureau et dans le cloud. Certaines peuvent continuer dans le cloud après l’arrêt de l’ordinateur. L’idée selon laquelle « Claude Code ne peut qu’attendre passivement des instructions » est donc dépassée.
Les capacités multitâches de Codex : distinguer le produit de l’API
Codex peut utiliser Git Worktree pour créer plusieurs répertoires de travail indépendants pour un même projet. Différentes sessions peuvent ainsi modifier des branches distinctes en parallèle. Codex Cloud analyse le code, apporte des modifications et lance des tests dans des espaces de travail isolés ; les tâches cloud peuvent continuer même après l’arrêt de l’ordinateur. L’écosystème ChatGPT/Codex prend également en charge les tâches planifiées en arrière-plan, ainsi que, pour les utilisateurs éligibles, le déclenchement par des événements provenant d’applications comme GitHub et le filtrage des activités liées aux PR.
Un point prête facilement à confusion : les capacités multi-agents proposées par l’API OpenAI Agents et l’API Responses — un agent principal qui délègue à des sous-agents disposant chacun d’un contexte indépendant — sont des capacités API. Elles ne correspondent pas nécessairement aux fonctionnalités par défaut de toutes les interfaces produit de Codex. De même, le scénario décrit dans l’OpenAI Cookbook, qui consiste à « utiliser GitHub Actions pour appeler Codex CLI et générer une PR de correction après un échec de CI », est une façon de construire un workflow, et non une fonctionnalité intégrée disponible d’emblée dans Codex CLI.
L’orchestration Router + Worker du Super-agent DeepSeek
Le fonctionnement du prototype DeepSeek se résume ainsi : Source → Trigger → Eval → Ticket → Assignment → Executor → Result. Les événements arrivent depuis GitHub ou Feishu et passent d’abord par des règles déterministes qui filtrent les autorisations. Le modèle décide ensuite s’il faut créer une tâche. Chaque tâche acceptée donne lieu à un Ticket distinct, attribué à un Worker disposant de son propre répertoire de travail. Le résultat est renvoyé par le canal d’origine, par exemple sous la forme d’une PR GitHub.
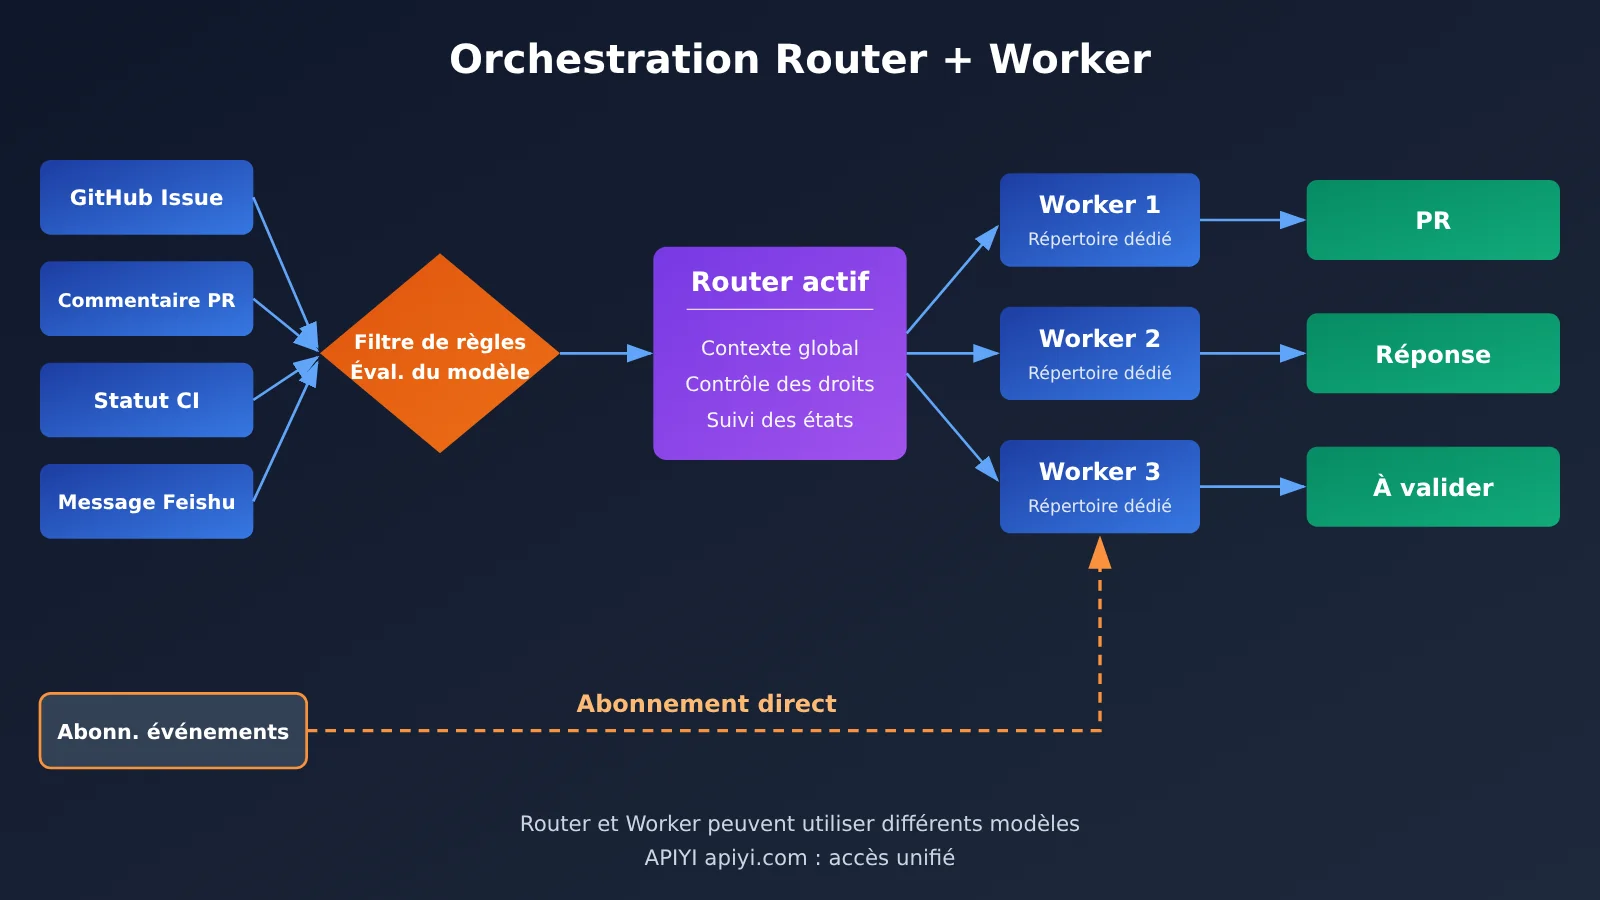
Le Router est la session principale, qui reste active en permanence. Il reçoit les messages, maintient le contexte global, décide s’il faut créer une tâche, vérifie les autorisations, puis attribue et suit les tâches. En principe, il ne se charge pas du développement complexe. C’est pourquoi, selon DeepSeek, il peut dans certains cas utiliser un modèle plus léger pour réduire les coûts d’orchestration. Les Worker, quant à eux, reçoivent des tickets précis : ils écrivent du code dans un répertoire isolé, exécutent les tests, traitent les retours et soumettent les résultats.
La vraie différence : les priorités du système d’orchestration DeepSeek Super-agent
Puisque Claude Code et Codex disposent déjà de fonctions multi-agents, de tâches en arrière-plan et de gestion des événements, qu’est-ce qui distingue DeepSeek ? La différence ne tient pas à la présence de ces fonctions, mais à qui gère les tâches et à l’étendue de cette gestion.
Un Agent principal qui délègue des sous-tâches, ou un Team Lead dans une Agent Team, participe généralement de près à la planification, à la coordination et à la fusion des résultats d’une tâche complexe donnée. Le Router de DeepSeek privilégie, lui, la coordination globale entre plusieurs tâches : un Router permanent gère simultanément plusieurs travaux relativement indépendants. L’utilisateur n’interagit qu’avec un seul Super-agent, depuis ses canaux de travail comme GitHub ou Feishu, sans avoir à gérer chaque session Worker.
DeepSeek reconnaît d’ailleurs qu’en configurant l’Agent principal d’une Agent Team pour qu’il se limite aux interactions globales et à la répartition des tâches, sans les exécuter lui-même, on peut obtenir une architecture à deux niveaux similaire. Le modèle Router + Worker n’est donc pas une exclusivité impossible à reproduire. La vraie différence réside dans le degré de systématisation de l’écoute permanente, du routage entre les tâches et de l’unification du contexte de travail. Cela se traduit par trois aspects :
- Router permanent : il reste actif comme session principale de longue durée, au lieu d’être lancé temporairement pour chaque tâche. Le contexte global peut ainsi se maintenir d’une tâche à l’autre.
- Réception directe des événements souscrits : un Worker abonné à un Thread peut recevoir directement les événements suivants, comme un nouveau commentaire sur la même PR, ce qui évite au Router de les lui redistribuer.
- Proactivité prudente : les tâches sont classées en Explicit (demandes explicites) et Inferred (tâches candidates déduites). Par défaut, les tâches déduites sont placées en mode
observe: elles sont enregistrées, mais pas exécutées. La fusion automatique des PR est également désactivée par défaut.
Comment interpréter les données expérimentales officielles de DeepSeek Super-agent
DeepSeek a mené une série d’expériences synthétiques d’ordonnancement : environ 300 messages par exécution, dont une vingtaine de demandes de travail, le reste étant composé de conversations informelles, de retours, d’annulations et de messages CI. Les tâches de programmation étaient remplacées par des outils simulés prenant du temps, et chaque configuration a été exécutée 5 fois.
| Configuration | Temps d’exécution P50 | Temps d’exécution P95 | Tokens lus dans le cache par exécution |
|---|---|---|---|
| Super-agent | 12,4 minutes | 15,7 minutes | Environ 23,2 millions |
| Super-agent, sans transmission directe des abonnements | 12,6 minutes | 15,5 minutes | Environ 31,8 millions |
| Session unique + sous-agent, invite neutre | 20,4 minutes | 29,5 minutes | Environ 6,1 millions |
| Session unique + sous-agent, délégation prioritaire | 13,8 minutes | 29,0 minutes | Environ 10,8 millions |
Deux enseignements ressortent de ces données. D’abord, par rapport à la session unique privilégiant la délégation, Super-agent n’a qu’une faible avance sur le P50, mais son P95 est nettement plus court. L’intérêt de l’architecture à deux niveaux semble donc surtout être d’éviter les délais excessifs quand les tâches s’accumulent. Ensuite, sans transmission directe des abonnements, le temps d’exécution change à peine, alors que les lectures du cache passent d’environ 23,2 à 31,8 millions de tokens. Cette fonction sert donc surtout à réduire les traitements répétés du Router, plutôt qu’à accélérer l’exécution.
Il faut toutefois bien cerner les limites de ces résultats : il s’agit d’une expérience d’ordonnancement, pas d’un test de qualité de génération de code. La configuration de référence est une session unique avec sous-agent et une invite donnée ; ce n’est pas un test de Claude Code ou de Codex en tant que produits complets, dans les mêmes conditions. Ces chiffres ne prouvent donc pas un gain réel de productivité en programmation de 39 % ou 47 %, et ne permettent pas non plus d’établir un classement de vitesse entre les trois solutions. Une autre série de tests officiels sur le traitement par lots du Router montre qu’à environ 40 événements par minute, la taille moyenne des lots atteint 2,8 et que le temps d’inférence par décision descend à 1,6 seconde. Là encore, cela indique seulement que la solution fonctionne avec la charge utilisée dans ces tests.
Coûts et limites de sécurité de DeepSeek Super-agent
La rapidité a un prix : davantage de tokens. Dans les tests synthétiques, Super-agent a effectué environ 3,8 fois plus de lectures du cache que la solution neutre à session unique. Cela ne signifie pas pour autant que la facture totale est multipliée par 3,8 : elle dépend aussi du prix des modèles, du taux de réussite du cache, du volume de tokens en entrée et en sortie, ainsi que des modèles utilisés par le Router et les Workers. DeepSeek n’a pas encore communiqué de coût moyen par demande réelle.
À titre de référence, voici les tarifs de l’API officielle de DeepSeek au 2 novembre 2026 (en dollars pour un million de tokens). Il s’agit des tarifs des modèles, pas d’une offre tarifaire Super-agent :
| Modèle et période | Entrée sans accès au cache | Entrée avec accès au cache | Sortie |
|---|---|---|---|
| DeepSeek V4.1 Flash, heures creuses | $0.15 | $0.003 | $0.60 |
| DeepSeek V4.1 Flash, heures de pointe | $0.30 | $0.006 | $1.20 |
| DeepSeek V4 Pro, heures creuses | $0.66 | $0.022 | $1.98 |
| DeepSeek V4 Pro, heures de pointe | $1.32 | $0.044 | $3.96 |
Les fonctions Search et Fetch coûtent chacune $0.75 pour 1 000 requêtes réussies. Elles sont facturées depuis le 1er novembre 2026 à 00 h, heure de Pékin, uniquement lorsqu’elles sont utilisées. Il faut aussi compter les ressources serveur, les frais de fonctionnement continu et la maintenance manuelle. De leur côté, Claude Code et Codex proposent différentes formules fondées sur des abonnements, l’API ou l’exécution dans le cloud. Il n’existe donc pas, pour l’instant, de mesure commune du « coût par PR admissible » permettant de comparer les trois solutions.
💰 Conseil pour maîtriser les coûts : dans une architecture multi-agents, la question centrale est de savoir « quel modèle attribuer à chaque rôle ». Si vous voulez tester un modèle léger pour le Router et un modèle plus puissant pour les Workers, APIYI apiyi.com permet d’accéder à plusieurs grands modèles avec une seule clé API. La facturation à l’usage facilite le suivi des dépenses en tokens des différentes combinaisons sur une même facture.
La sécurité mérite tout autant d’attention. La documentation officielle de déploiement reconnaît que les configurations prédéfinies du Router et des Workers fonctionnent en mode danger-full-access. Par défaut, elles s’exécutent sous le compte système de l’opérateur et peuvent lire les fichiers du répertoire personnel, lancer des programmes locaux et accéder aux identifiants stockés sur la machine. DeepSeek recommande d’utiliser un compte système distinct et un compte bot GitHub distinct. L’écoute des commentaires et messages externes présente aussi un risque d’injection d’invite. Un rapport d’audit tiers portant sur le commit 6337fc8 a également été publié dans la communauté : il signale des problèmes potentiels, notamment dans la validation de l’interface d’administration. Toutefois, le scénario d’attaque complet n’a pas été reproduit de manière indépendante. Il faut donc y voir des « risques potentiels », et non des incidents avérés.
Analyse de l’impact de DeepSeek Super-agent
Impact pour les développeurs
- Des critères d’évaluation à élargir : pour choisir un outil, le score du modèle sous-jacent ne suffit pas. Il faut aussi vérifier si l’intégration des événements, l’isolation des tâches, l’exécution en arrière-plan et les mécanismes de validation humaine correspondent aux processus de l’équipe.
- Un prototype utilisable, mais pas sans difficultés : l’utilisateur xxxxkkkqq est parvenu à faire progresser une issue jusqu’à une PR dans un dépôt privé. Il a toutefois rencontré plusieurs problèmes : notifications non reçues, messages absents malgré des vérifications de déploiement concluantes, et échec d’assertions de test dû au chinois défini comme langue système. Un autre utilisateur a repéré en une heure deux défauts sous WSL2 : un problème de reconnaissance des processus Node.js 24 et des commentaires GitHub non reçus.
- Une base intéressante pour les développements personnalisés : pour les équipes capables de maintenir TypeScript, l’intégration GitHub et les API de modèles, le projet constitue une implémentation de référence complète pour le Router, les événements, les tickets, les Workers et les règles d’autorisation.
Impact sur le secteur
- La concurrence se déplace : dans la programmation assistée par IA, la compétition ne se limite plus aux modèles. Les frameworks d’agents (Agent Harness), la conception des workflows et l’expérience développeur deviennent tout aussi importants.
- L’« agent proactif » se structure : DeepSeek associe le travail proactif aux politiques d’autorisation, au mode observe et à la validation humaine. Cela répond à une préoccupation concrète : les agents risquent-ils de mobiliser inutilement l’attention des équipes ?
Compte tenu de ces capacités, voici les choix possibles selon le mode de travail :
| Mode de travail | Combinaison recommandée | Pourquoi |
|---|---|---|
| Tâche de programmation quotidienne | Claude Code ou Codex | Produits officiels, faciles à prendre en main, sans système d’ordonnancement à déployer |
| Plusieurs tâches indépendantes en parallèle | Claude Code Agent Teams / agents en arrière-plan, Codex Worktrees / tâches dans le cloud | Mécanismes de parallélisation et d’isolation déjà éprouvés |
| Recherche sur l’écoute continue des événements et le routage centralisé | Prototype DeepSeek Super-agent | Illustration directe de la conception d’un Router permanent et de l’abonnement aux événements |
| Création d’un système d’orchestration d’agents | Prototype open source + API de plusieurs modèles | Logique d’ordonnancement et répartition des rôles entre modèles personnalisables |
| Dépôts de production sensibles | Prototype de recherche déconseillé en utilisation directe pour le moment | L’exécution avec des privilèges élevés et les questions de sécurité restent à améliorer |
🎯 Conseil pour choisir : ces outils ne s’excluent pas mutuellement. Beaucoup d’équipes peuvent confier la programmation quotidienne à Claude Code ou Codex, puis utiliser une couche d’ordonnancement maison pour gérer les événements et le routage. Pour construire cette couche, vous pouvez commencer par obtenir des crédits de test gratuits auprès d’APIYI, sur apiyi.com, et comparer les performances de différents modèles dans les rôles de Router et de Worker.
Reproduire la logique du Router de DeepSeek Super-agent avec une API
La meilleure façon de comprendre un système d’orchestration, c’est d’en créer une version minimale. L’exemple ci-dessous utilise une interface compatible avec OpenAI pour confier les décisions de routage à un modèle léger. Il illustre uniquement le principe et ne représente pas le code réel du prototype DeepSeek :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

event = "PR #42 评论:CI 在 test_auth.py 失败,请帮忙看看"
resp = client.chat.completions.create(
    model="ROUTER_MODEL",  # 替换为控制台中可用的轻量模型名
    messages=[{"role": "user", "content": f"判断该事件是否需要建任务,只回答 YES/NO:{event}"}]
)
print(resp.choices[0].message.content)
Voir l’exemple complet de code Router + Worker
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 一个 Key 接入多家模型
)

ROUTER_MODEL = "ROUTER_MODEL"   # 轻量模型:负责路由判断
WORKER_MODEL = "WORKER_MODEL"   # 强模型:负责具体任务
AUTHORIZED_USERS = {"alice", "bob"}  # 确定性规则:授权名单

@dataclass
class Ticket:
    thread_id: str
    task: str
    history: list = field(default_factory=list)

tickets: dict[str, Ticket] = {}

def router_eval(event: dict) -> bool:
    """先规则过滤,再由模型判断是否建任务"""
    if event["user"] not in AUTHORIZED_USERS:
        return False  # 未授权:仅观察,不执行
    resp = client.chat.completions.create(
        model=ROUTER_MODEL,
        messages=[
            {"role": "system", "content": "你是任务路由器,只回答 YES 或 NO。"},
            {"role": "user", "content": f"该消息是否是需要执行的工作请求?\n{event['text']}"}
        ],
        max_tokens=5
    )
    return "YES" in resp.choices[0].message.content.upper()

def worker_run(ticket: Ticket, text: str) -> str:
    """Worker 使用独立上下文处理任务"""
    ticket.history.append({"role": "user", "content": text})
    resp = client.chat.completions.create(
        model=WORKER_MODEL,
        messages=[{"role": "system", "content": "你是代码修复助手,给出修复思路。"}] + ticket.history
    )
    answer = resp.choices[0].message.content
    ticket.history.append({"role": "assistant", "content": answer})
    return answer

def handle(event: dict) -> str:
    tid = event["thread_id"]
    # 订阅直通:已有 Ticket 的后续事件直接交给对应 Worker
    if tid in tickets:
        return worker_run(tickets[tid], event["text"])
    if router_eval(event):
        tickets[tid] = Ticket(thread_id=tid, task=event["text"])
        return worker_run(tickets[tid], event["text"])
    return "已记录,未建任务"

print(handle({"thread_id": "pr-42", "user": "alice", "text": "CI 在 test_auth.py 失败"}))
print(handle({"thread_id": "pr-42", "user": "alice", "text": "补充:只在 Python 3.12 下失败"}))
Cet exemple illustre trois principes : les règles déterministes s’appliquent avant la décision du modèle, le Router et le Worker utilisent des modèles différents, et les événements ultérieurs d’un même fil sont directement transmis au contexte du Worker existant. Un système réel nécessite aussi l’isolation des répertoires de travail, un bac à sable pour les permissions, la persistance des états et une validation humaine. Ce sont justement des aspects que le prototype doit encore améliorer.
🚀 Pour démarrer rapidement : il suffit de remplacer la clé API et les noms des modèles pour exécuter le code ci-dessus. Consultez la liste des modèles disponibles dans la console APIYI sur apiyi.com. Les nouveaux utilisateurs bénéficient d’un crédit de test gratuit, pratique pour valider la logique d’orchestration à moindre coût avant de décider si vous souhaitez poursuivre le développement.
Questions fréquentes (FAQ)
Q1 : DeepSeek Super-agent est-il un nouveau modèle ?
Non. Super-agent est une architecture de système d’agents qui fonctionne autour du modèle. Le projet open source est un prototype de recherche basé sur DeepSeek Harness. Il n’impose pas l’utilisation d’un modèle DeepSeek particulier : on peut choisir le fournisseur et le modèle du Router comme du Worker dans les paramètres.
Q2 : DeepSeek Super-agent va-t-il remplacer Claude Code et Codex ?
Rien ne permet de l’affirmer pour le moment. Les trois ne se situent pas au même niveau : Claude Code et Codex sont des produits d’agents de programmation matures, tandis que Super-agent se concentre sur l’orchestration continue à un niveau supérieur. Au 2 novembre, aucune comparaison publique de programmation à grande échelle et dans les mêmes conditions n’était disponible. Les expériences synthétiques officielles ne permettent donc pas d’établir un classement des performances entre les trois.
Q3 : Claude Code et Codex peuvent-ils gérer des déclenchements sur événement et des tâches en arrière-plan ?
Oui. Claude Code propose notamment GitHub Actions, Channels en préversion de recherche, des agents en arrière-plan et des tâches planifiées dans le cloud. L’écosystème Codex propose des tâches dans le cloud, des Worktrees, des tâches planifiées en arrière-plan et l’automatisation sur événement pour les applications prises en charge. Les différences concernent les points d’accès, les conditions d’accès et les mécanismes de mise en œuvre, pas l’existence de ces fonctions.
Q4 : Le prototype DeepSeek Super-agent est-il gratuit ?
Le code est gratuit et open source sous licence MIT, mais l’invocation du modèle reste facturée au token. Il faut aussi compter les coûts de serveur, de maintenance et de vérification humaine. Open source ne signifie pas que le coût total de chaque tâche sera plus bas. Pour gérer au même endroit les frais d’API de plusieurs modèles, vous pouvez utiliser APIYI sur apiyi.com : la facturation se fait à l’usage et la consommation est consultable de façon centralisée.
Q5 : Comment tester à moindre coût une répartition des tâches entre plusieurs modèles avec Router + Worker ?
Vous pouvez vous inspirer du code présenté dans cet article : définissez `base_url` sur `https://api.apiyi.com/v1`, puis confiez le routage à un modèle léger et l’exécution à un modèle plus puissant. Après inscription sur APIYI apiyi.com, vous obtenez un crédit de test gratuit et pouvez utiliser une seule clé API pour comparer des modèles courants comme OpenAI, Claude et Gemini.
Q6 : Quelles sont les limites connues du prototype DeepSeek Super-agent ?
Il ne peut actuellement surveiller qu’un seul dépôt github.com et ne prend pas en charge GitHub Enterprise Server. Son déploiement nécessite Node.js 22.19+ ou 24+, tmux, GitHub CLI 2.48+ et un compte de robot dédié. Le Worker s’exécute par défaut avec des privilèges élevés, ce qui présente des risques d’injection d’invite et de compromission des identifiants. La communauté a également signalé des pertes de notifications et des problèmes de compatibilité avec Node.js 24. Il n’est donc pas recommandé de l’utiliser directement sur des dépôts de production sensibles.
DeepSeek Super-agent face à Claude Code et Codex : l’essentiel
- Des niveaux différents : Super-agent est un prototype de système d’orchestration ; Claude Code et Codex sont des agents de programmation prêts à l’emploi.
- Le multi-agent n’est pas une exclusivité : Claude Code et Codex proposent déjà des sous-agents, des sessions parallèles et des fonctions d’arrière-plan et de gestion des événements.
- La vraie différence tient à l’approche systémique : routeur actif en permanence, routage entre tâches, utilisation directe d’abonnements et contexte unifié sont au cœur de la conception.
- Les résultats expérimentaux ont leurs limites : les tests d’orchestration synthétiques mesurent uniquement les performances d’orchestration, pas la qualité du code ni un classement des trois solutions.
- Plus de vitesse, mais plus de tokens : les lectures en cache sont environ 3,8 fois plus nombreuses qu’avec une seule session. Les coûts doivent être calculés selon les modèles utilisés.
- La sécurité doit être anticipée : les droits élevés et les risques d’injection via des contenus externes exigent des comptes distincts et une validation humaine.
- Rien ne vaut un test pratique : APIYI apiyi.com permet d’expérimenter une répartition Router/Worker entre plusieurs modèles avec une seule clé API.
Conclusion
Les points essentiels de la comparaison entre DeepSeek Super-agent, Claude Code et Codex :
- La première différence concerne le niveau de comparaison : les capacités du modèle, celles de l’outil de programmation et celles du système d’orchestration sont trois choses distinctes. Les mélanger n’a pas de sens.
- L’intérêt de DeepSeek réside dans sa conception de l’orchestration : il organise autour d’un même système l’écoute permanente, le routage entre tâches et le contexte unifié, tout en encadrant les initiatives de l’agent par des autorisations et un mode observe.
- L’écart de maturité est réel : le prototype compte déjà un cas concret allant d’une Issue à une PR, mais son installation, sa fiabilité et sa sécurité restent à améliorer. Claude Code et Codex demeurent des choix sûrs pour programmer au quotidien.
La compétition dans la programmation assistée par l’IA ne se limite plus à la puissance des modèles : elle englobe désormais l’Agent Harness, les workflows et l’expérience développeur. Pour la plupart des équipes, l’approche la plus pragmatique consiste à utiliser des produits matures au quotidien tout en expérimentant à petite échelle une couche d’orchestration personnalisée.
APIYI apiyi.com permet d’accéder à plusieurs modèles majeurs depuis un même service, afin de comparer rapidement leurs performances et leurs coûts dans les rôles de Router et de Worker.
📚 Ressources
- Dépôt officiel du prototype DeepSeek Super-agent : état du projet, code source et périmètre d’utilisation
- Lien :
github.com/deepseek-ai/dsh-superagent-prototype -
Contenu : README, documentation de déploiement, mécanisme d’autorisation et philosophie de conception
-
Tarifs officiels de l’API DeepSeek : prix des modèles et frais Search/Fetch
- Lien :
api-docs.deepseek.com/quick_start/pricing -
Contenu : base de calcul des coûts des modèles Router/Worker
-
Documentation Claude Code Subagents et Agent Teams : fonctionnalités multi-agents
- Liens :
code.claude.com/docs/en/sub-agents、code.claude.com/docs/en/agent-teams -
Contenu : contexte indépendant des sous-agents et mécanismes de collaboration en équipe
-
Documentation Claude Code Channels et tâches planifiées : transmission d’événements et fonctionnement continu
- Liens :
code.claude.com/docs/en/channels、code.claude.com/docs/en/scheduled-tasks -
Contenu : conditions d’utilisation et limites des fonctionnalités en préversion de recherche
-
Documentation Codex Cloud et Worktrees : tâches dans le cloud et espaces de travail parallèles
- Liens :
help.openai.com/en/articles/20001545-using-codex-cloud、learn.chatgpt.com/docs/environments/git-worktrees -
Contenu : références officielles pour distinguer les fonctionnalités des produits Codex
-
Guide multi-agent de l’API OpenAI Agents : orchestration multi-agents au niveau de l’API
- Lien :
developers.openai.com/api/docs/guides/agents-api/multi-agent -
Contenu : à distinguer des fonctionnalités du produit Codex
-
Discussion de la communauté sur les tests de DeepSeek Harness : retour d’expérience de bout en bout, de l’issue à la PR
- Lien :
github.com/deepseek-ai/deepseek-harness/discussions/11706 - Contenu : fonctionnement réel du prototype et problèmes courants
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site officiel APIYI. Retrouvez plus de ressources sur l’intégration de plusieurs modèles et l’orchestration d’agents dans le centre de documentation docs.apiyi.com.