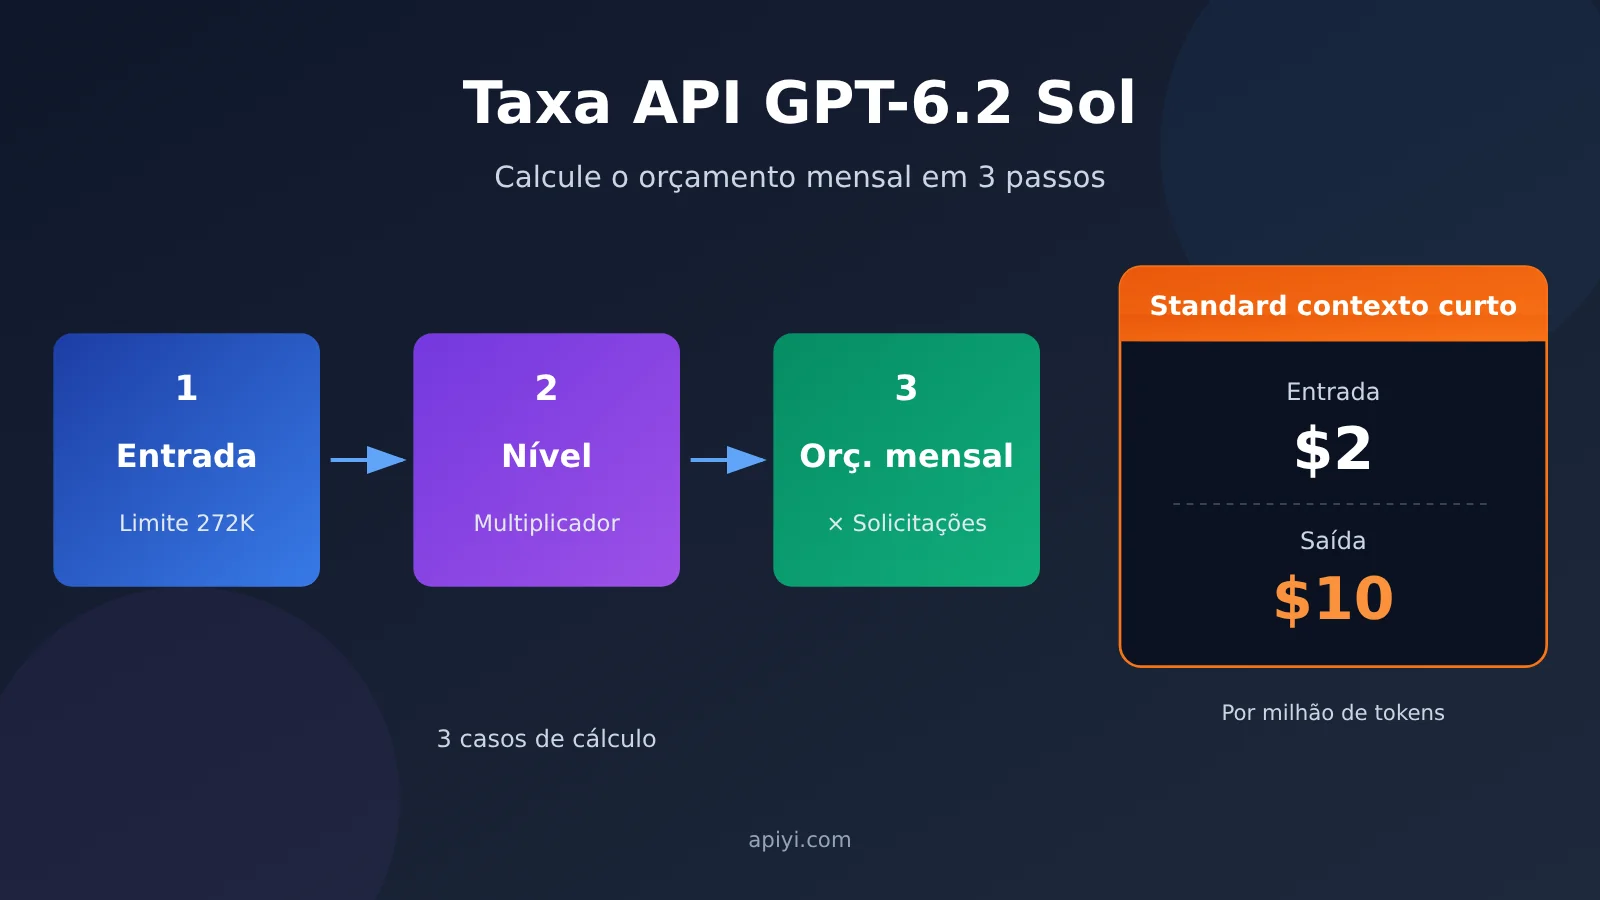
A cobrança pelo uso da API do GPT-6.2 Sol é definida em três etapas. A primeira considera o volume total de entrada de uma única requisição: 272K tokens é o limite que separa contexto curto de contexto longo; acima desse limite, as tarifas de entrada e de cache de toda a requisição são multiplicadas por 2, e a tarifa de saída, por 1,5. A segunda etapa escolhe o nível de serviço conforme o prazo de entrega: Standard é o preço de referência, Batch custa metade, as janelas de processamento em segundo plano de 8h e 2h são cobradas a 60% e 70%, respectivamente, Fast custa 2 vezes e Ultrafast custa 3 vezes antes de 2027-02-28 (horário do Pacífico) e 6 vezes depois. A terceira etapa multiplica o custo por requisição pelo volume mensal de requisições e acrescenta chamadas de ferramentas, eventuais taxas regionais e novas tentativas.
O preço de tabela do Standard com contexto curto é: entrada normal a US$ 2,00 por milhão de tokens, leitura de cache a US$ 0,10 e saída (incluindo tokens de raciocínio) a US$ 10,00. Com esses valores, uma requisição interativa com 20.000 tokens de entrada e 3.000 de saída sai por cerca de US$ 0,07; 2.000 requisições por mês ficam em torno de US$ 140. Todos os preços neste artigo são em dólares por milhão de tokens, com data de verificação em 2026-11-20 (horário de Pequim).
Mapa de conhecimento e índice de leitura da cobrança da API GPT-6.2 Sol
O texto segue a ordem “avaliação do volume de entrada → escolha da faixa conforme o prazo de entrega → chamadas acumuladas”. A tabela abaixo reúne, para cada etapa, a pergunta a ser respondida, o resultado produzido e a seção correspondente no corpo do texto; o resultado de uma seção alimenta a próxima.
| Etapa | Pergunta a responder | Resultado desta etapa | Seção no texto |
|---|---|---|---|
| Avaliação do volume de entrada | Esta requisição se enquadra em contexto curto ou contexto longo? | Tabela de tarifas base aplicável | 1, 3.2 |
| Escolha da faixa conforme o prazo de entrega | O usuário está esperando online ou pode receber a entrega algumas horas depois ou no dia seguinte? | Multiplicador da faixa de serviço | 2, 3.1 |
| Chamadas acumuladas | Quantas requisições por mês e quais despesas adicionais existem? | Orçamento mensal | 2, 4 |
| Recálculo por canal | Se trocarmos o canal de cobrança, quanto custará a mesma requisição? | Comparativo de canais e tabela de orçamento | 4 |
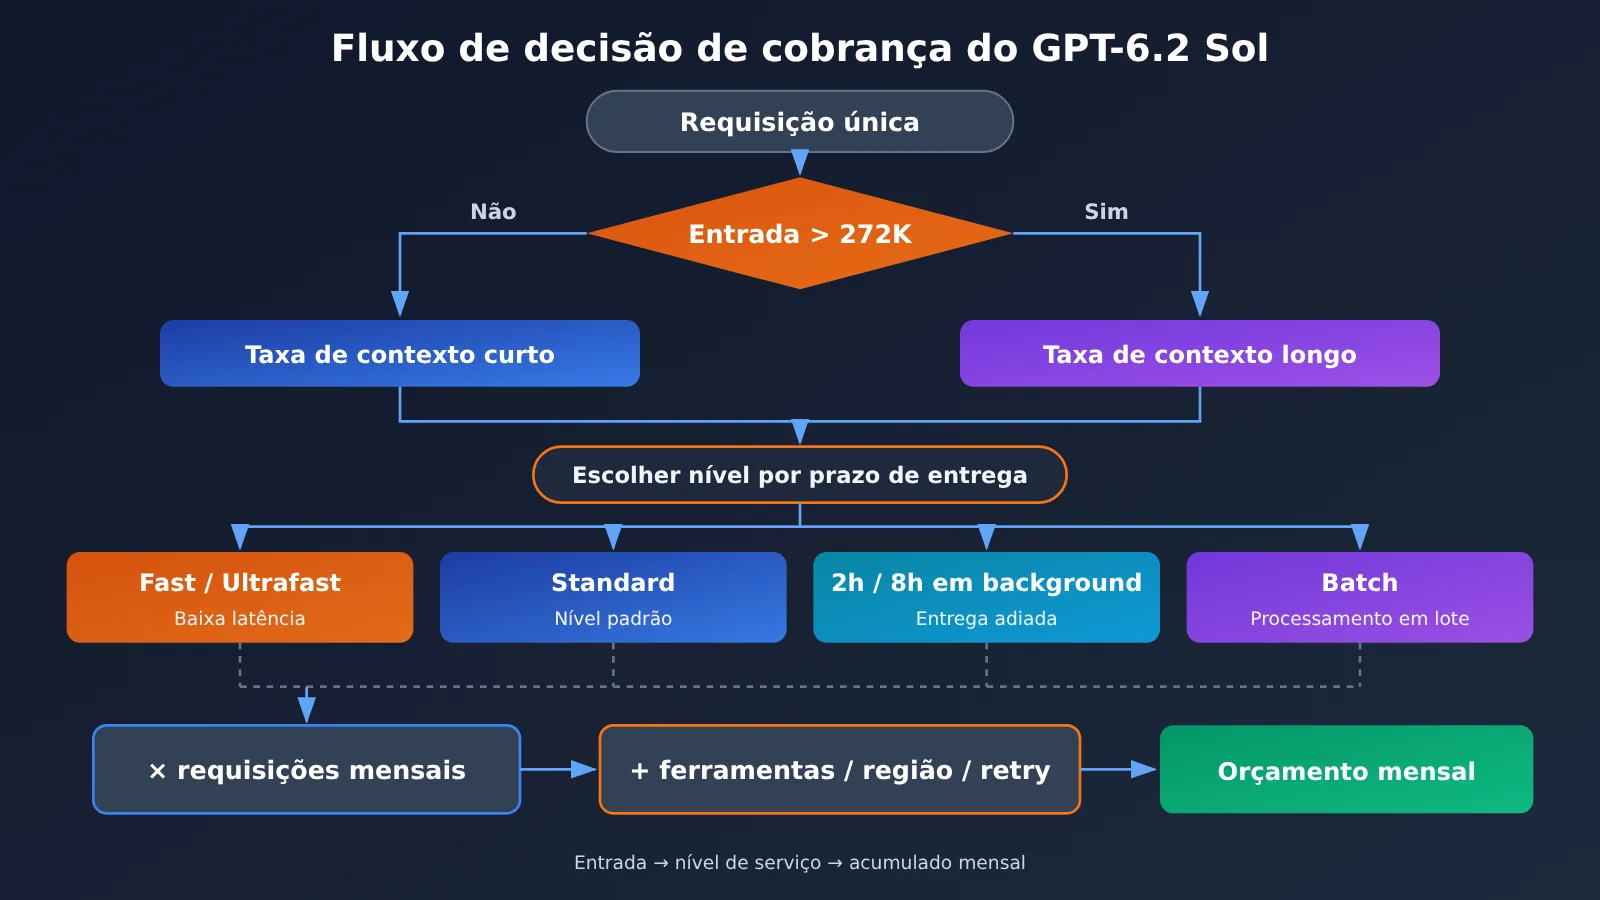
Na ordem de leitura, a seção 1 apresenta as tarifas base, que servem de referência para todos os exemplos de cálculo seguintes. As seções 2 e 3 correspondem, respectivamente, aos dois tipos de negócio: “usuário esperando o resultado online” e “entrega que pode ser adiada”; você pode ler apenas a seção relacionada ao seu caso. A seção 4 aplica os cálculos anteriores à tabela pública de preços da APIYI apiyi.com e às tarifas oficiais da OpenAI, refazendo as contas lado a lado, e por fim apresenta uma tabela de orçamento mensal que você pode preencher diretamente.
Termos de cobrança do GPT-6.2 Sol que você precisa conhecer
| Termo | Explicação |
|---|---|
| Token | Unidade básica usada pelo modelo para medir texto e outras entradas e saídas; a quantidade segue as estatísticas retornadas pelo servidor |
| Standard | Faixa de processamento regular da API oficial e base de preço para os multiplicadores das demais faixas |
| Leitura de cache | Quando a requisição reutiliza um prefixo histórico já armazenado em cache, essa parte da entrada é cobrada pela tarifa de leitura de cache |
| Gravação de cache | Categoria de cobrança independente para armazenar prefixos qualificados para reutilização futura, dividida em duas faixas: 30 minutos e 12 horas |
| Saída cobrada | Volume de saída contabilizado pela API, incluindo tokens de raciocínio e a saída final |
| Batch API | Interface para enviar requisições independentes já preparadas, em formato de arquivo, para processamento em lote no backend |
| Janela de conclusão | Prazo-alvo definido para a resposta inicial depois que a requisição em segundo plano é aceita |
| Fast e Ultrafast | Duas faixas de tarifa mais alta voltadas para cenários de baixa latência |
1. Quais são as tarifas de uma única solicitação da API GPT-6.2 Sol
1.1 As cinco categorias de cobrança do nível Standard
O ID do modelo de API do GPT-6.2 Sol é gpt-6.2-sol, e ele pode ser invocado por dois endpoints: Responses e Chat Completions. Uma única solicitação pode envolver até cinco categorias de cobrança. A tabela abaixo traz os preços oficiais do nível Standard. O preço base de contexto curto é igual ao do GPT-6.1 Sol; a coluna de contexto longo segue os multiplicadores do model card.
| Categoria de cobrança Standard | Contexto curto (entrada ≤272K) | Contexto longo (entrada >272K) |
|---|---|---|
| Entrada normal | $2.00 | $4.00 |
| Leitura de cache | $0.10 | $0.20 |
| Gravação de cache de 30 minutos | $2.50 | $5.00 |
| Gravação de cache de 12 horas | $5.00 | $10.00 |
| Saída (já inclui tokens de raciocínio) | $10.00 | $15.00 |
Há três pontos na tabela que costumam gerar erro de cálculo.
- A gravação de cache não se soma à entrada normal. Os tokens gravados em cache são cobrados uma única vez pela tarifa cheia da faixa de 30 minutos ou de 12 horas, e não entram de novo como entrada normal.
- Os tokens de raciocínio entram na saída. O
usage.output_tokensretornado pelo Responses é o total de saída; o consumo de raciocínio normalmente aparece como subitem emoutput_tokens_details.reasoning_tokens, então basta calcular o orçamento pelo total. - A troca de faixa vale para a solicitação inteira. Assim que o total de entrada passa de 272K, entrada, cache e saída de toda a solicitação migram para a tarifa de contexto longo — não há acréscimo apenas sobre a parte que excedeu.
O model card também lista janela de contexto de 1.050.000 tokens, entrada máxima de 922.000 tokens e saída máxima de 128.000 tokens. 922K é a entrada máxima permitida, 272K é o ponto de virada da cobrança, e um número não tem relação com o outro.
1.2 Despesas além da taxa do modelo
A tabela acima cobre apenas a taxa de tokens do modelo. No Responses, o Sol pode chamar ferramentas como busca de arquivos, busca na web, interpretador de código e geração de imagens, e essas ferramentas têm regras de cobrança próprias quando são realmente usadas. Ao gerar imagens, o Sol fica responsável por disparar a chamada da ferramenta, enquanto a imagem é produzida por uma ferramenta de imagem separada — e o custo da imagem entra na conta à parte. Quando o deployment fica em uma região específica, ainda podem incidir taxas regionais aplicáveis. Na planilha de orçamento, vale reservar colunas separadas para esses itens, em vez de misturá-los no preço unitário do token.
1.3 Ler o consumo real de cobrança com código
Depois de estimar, é preciso calibrar com o campo usage de requisições reais. O exemplo abaixo chama o Sol pela interface compatível com OpenAI e converte a taxa do modelo desta chamada usando a tarifa Standard de contexto curto:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatível com OpenAI do APIYI
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    input="用三句话说明 Batch API 适合什么任务。"
)

u = resp.usage
cached = getattr(getattr(u, "input_tokens_details", None), "cached_tokens", 0) or 0
plain_in = u.input_tokens - cached
cost = (plain_in * 2.00 + cached * 0.10 + u.output_tokens * 10.00) / 1e6
print(resp.output_text)
print(f"输入 {u.input_tokens},其中缓存 {cached},输出 {u.output_tokens},模型费约 ${cost:.6f}")
Essa conversão vale apenas para requisições Standard com entrada de até 272K e sem gravação de cache. Em produção, recomendo registrar o usage de cada requisição em log, agregar por tipo de tarefa e só então preencher a planilha de orçamento da seção 4.
🎯 Prática recomendada oficialmente: antes de fechar o orçamento, rode uma rodada com 20 a 50 requisições reais do seu negócio e levante a distribuição de entrada e saída. Novos usuários do APIYI apiyi.com têm cota de teste gratuita, o que cai bem para esse tipo de calibração com amostra pequena.
2. Como calcular os níveis de interação e o orçamento mensal do GPT-6.2 Sol
2.1 O custo da mesma requisição nos três níveis de interação
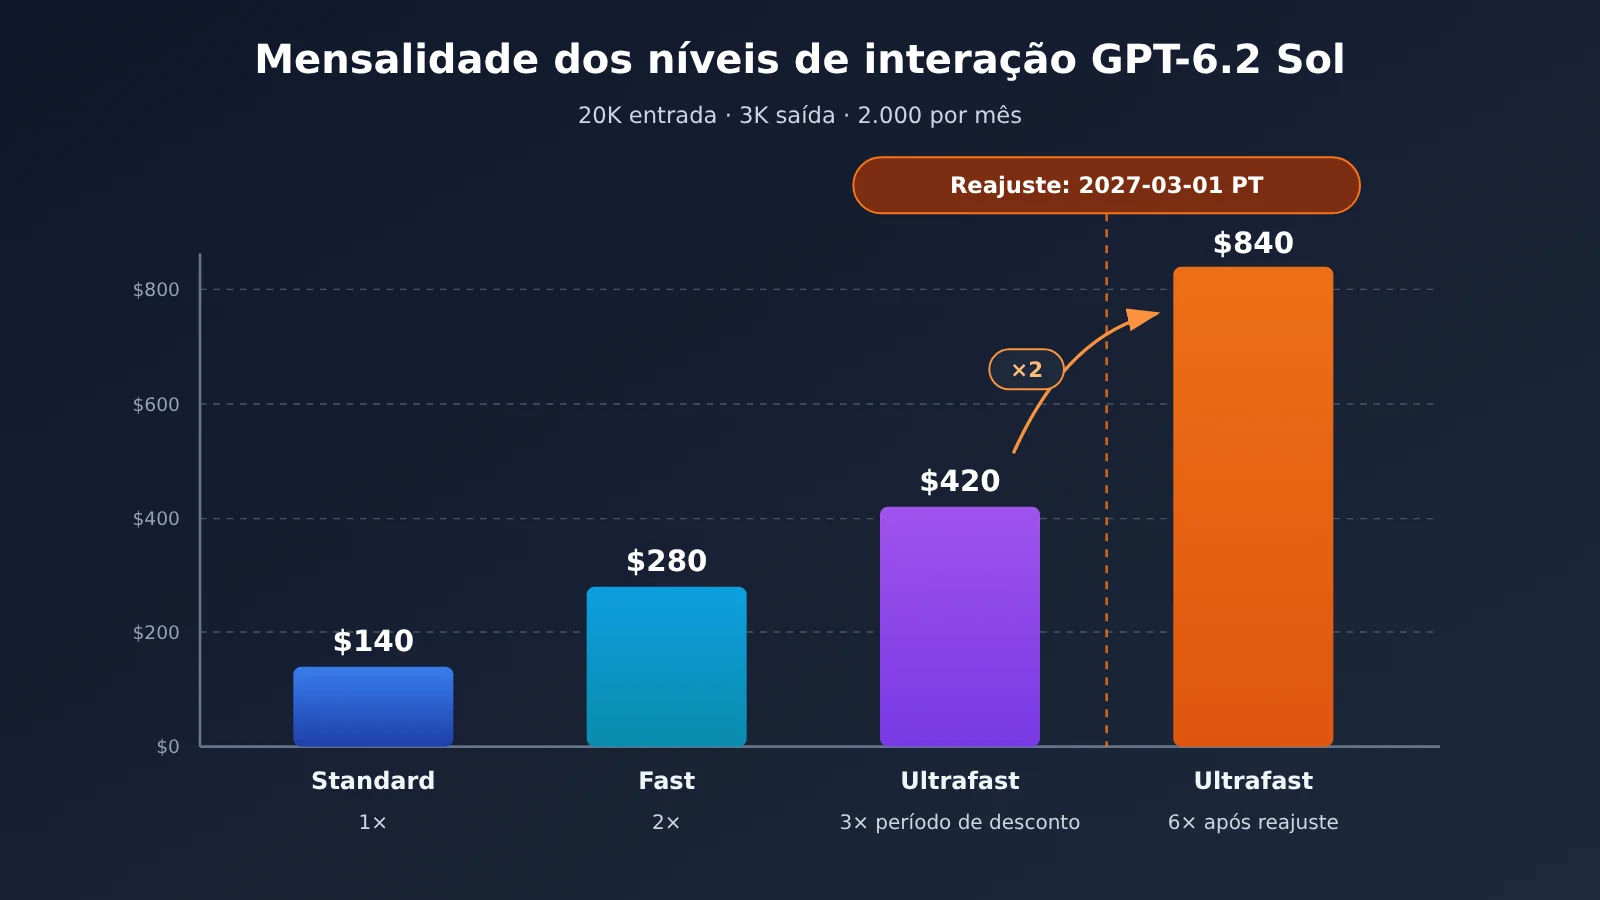
Em cenários interativos, o usuário fica esperando o resultado na interface, e as opções disponíveis são Standard, Fast e Ultrafast. O Fast é cobrado a 2× o Standard; o Ultrafast é 3× até 2027-02-28 (horário do Pacífico) e passa a 6× a partir de 2027-03-01. O GPT-6.2 Sol não oferece o nível Flex.
O exemplo considera uma requisição com 20.000 tokens de entrada comuns e 3.000 tokens de saída faturáveis, sem cache, ferramentas, taxas regionais ou novas tentativas, a 2.000 requisições por mês. O custo por chamada no Standard é 20000×2/1e6 + 3000×10/1e6 = $0.07.
| Nível de serviço | Multiplicador | Custo por chamada | Por mês (2.000 requisições) |
|---|---|---|---|
| Standard | 1× | $0.07 | $140 |
| Fast | 2× | $0.14 | $280 |
| Ultrafast (até 2027-02-28 PT) | 3× | $0.21 | $420 |
| Ultrafast (a partir de 2027-03-01 PT) | 6× | $0.42 | $840 |
2.2 Condições a observar ao ler esta tabela
A tabela fixa o consumo por requisição para facilitar o planejamento do orçamento. Na prática, o consumo de tokens e a latência de uma mesma tarefa variam conforme a requisição e o nível escolhido, então antes de ir para produção vale rodar um lote de requisições reais em cada nível candidato para conferir os números.
Se você for orçar com Ultrafast antes de março de 2027, prepare também uma versão calculada com 6×. Neste exemplo, o custo mensal vai de $420 para $840 depois do reajuste, que entra em vigor em 1º de março no horário do Pacífico — no horário de Pequim, isso corresponde à tarde de 1º de março.
💡 Dica para escolher o nível: para a maioria das requisições interativas, comece com Standard e mude para Fast ou Ultrafast apenas nos pontos de entrada sensíveis à latência. Testando em paralelo pela APIYI apiyi.com com a mesma chave API, você obtém rapidamente os dados reais de latência e consumo de cada nível.
3. Como estimar os custos de processamento noturno e de documentos longos no GPT-6.2 Sol
3.1 Tarefas em lote noturnas: 2h, 8h e Batch
Tarefas que não precisam de retorno imediato têm três formas de desconto. Os modos em segundo plano do Responses com janelas de conclusão de 2h e 8h cobram, respectivamente, 70% e 60% da tarifa de tokens do modelo Standard — mas a requisição precisa ser Standard e não streaming. A janela se refere ao tempo alvo da resposta inicial; soonest não tem desconto por janela. A Batch API cobra 50% do Standard, com envio em lote por arquivo e janela de entrega de 24 horas.
O exemplo assume 10,000 requisições, cada uma com 50,000 tokens de entrada comum e 4,000 tokens de saída cobrados, sem cache e sem ferramentas. O custo por requisição no Standard é 50000×2/1e6 + 4000×10/1e6 = $0.14.
| Modo | Tarifa | Custo por requisição | Total para 10,000 | Quando usar |
|---|---|---|---|---|
| Standard | 100% | $0.14 | $1,400 | Precisa do resultado o quanto antes |
Background 2h |
70% | $0.098 | $980 | O aplicativo precisa obter a resposta inicial em até duas horas e a tarefa precisa receber resultados de ferramentas no meio do caminho |
Background 8h |
60% | $0.084 | $840 | Enviado à noite, entregue antes do expediente do dia seguinte, e precisa de interação passo a passo |
| Batch API | 50% | $0.07 | $700 | As requisições já estão prontas com antecedência, são independentes entre si e podem ser entregues no dia seguinte |
Dá para organizar conforme o formato da tarefa. Para tarefas independentes entre si, como classificação e extração, que podem ser preparadas por completo antes do envio, vale usar o Batch como referência de preço. Quando a tarefa precisa que o aplicativo forneça resultados de ferramentas no meio do caminho para continuar, estime cada etapa separadamente e escolha a janela 2h ou 8h de acordo com o prazo total de entrega do lado do aplicativo.
Há ainda uma restrição de capacidade: as requisições em segundo plano com desconto e o Batch compartilham uma cota de fila independente. Antes de planejar um envio em lote grande, é preciso conferir a cota de tokens de entrada acumulados, para evitar que as requisições fiquem presas na fila.
3.2 Documentos longos: o salto de custo ao cruzar 272K
O salto de custo de documentos longos vem da regra de mudança de faixa. O exemplo assume sem cache e sem ferramentas, saída fixa de 6,000 tokens, faixa Standard, com entradas de 270,000 e 280,000:
| Volume de entrada | Tarifa aplicável | Cálculo | Custo do modelo por requisição |
|---|---|---|---|
| 270,000 | Contexto curto | 270000×2/1e6 + 6000×10/1e6 |
$0.60 |
| 280,000 | Contexto longo | 280000×4/1e6 + 6000×15/1e6 |
$1.21 |
A entrada aumenta apenas 10,000 tokens, mas o custo por requisição sobe de $0.60 para $1.21 — praticamente o dobro. A razão é que toda a requisição passa a ser cobrada pela tarifa de contexto longo, e o preço unitário da saída também muda de $10 para $15.
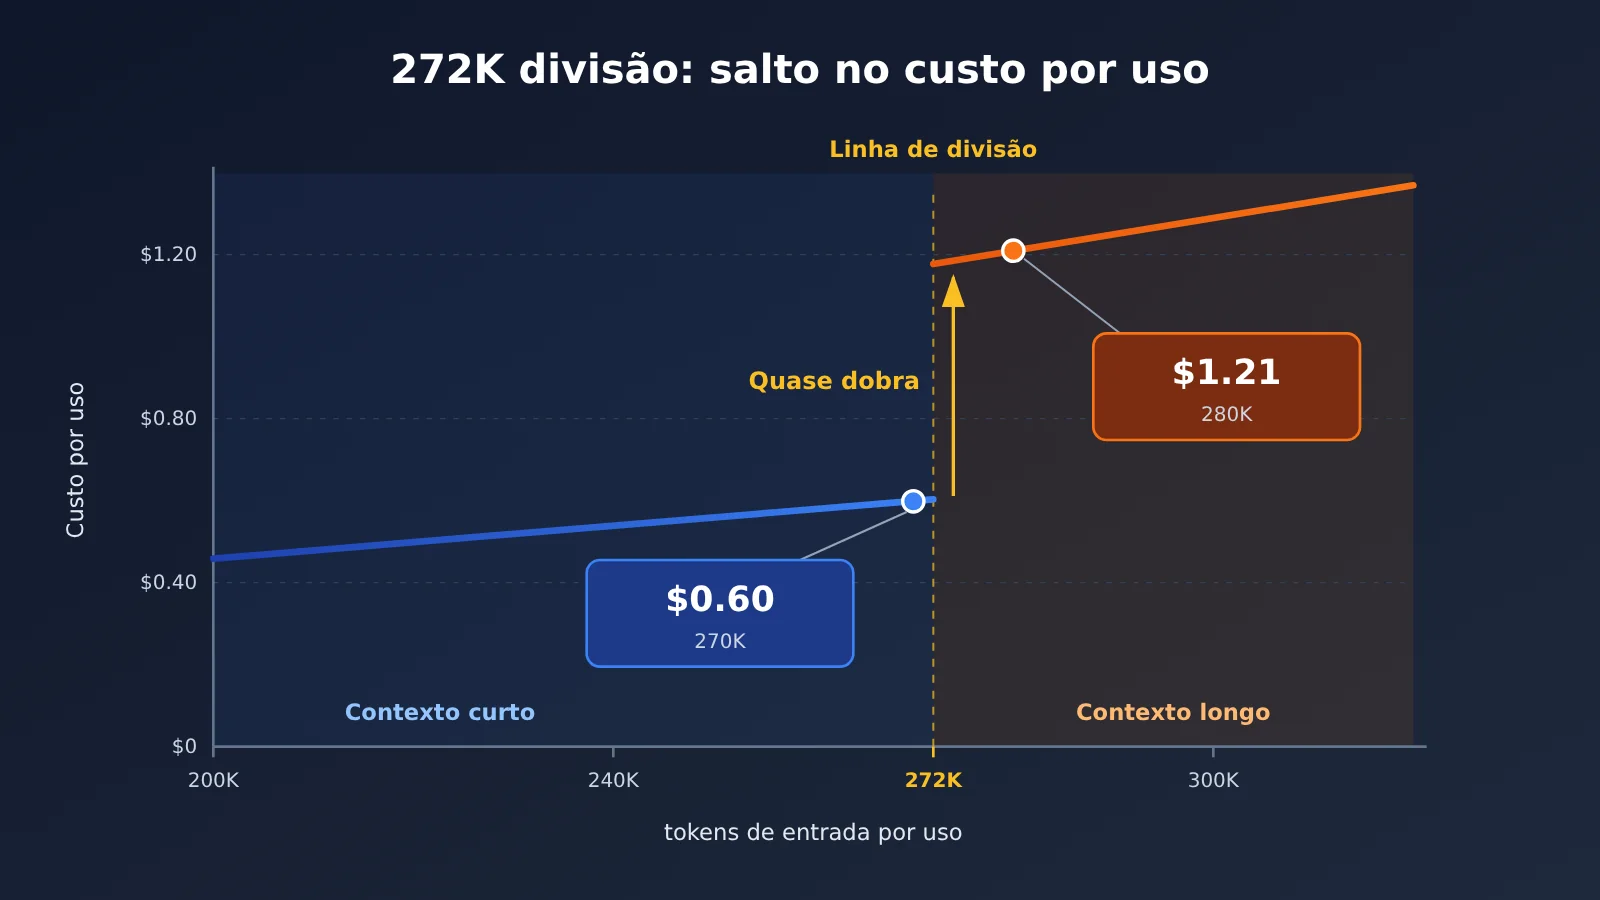
Ao montar o orçamento, registre a distribuição de entrada de cada requisição conforme a fila de negócios, estime separadamente as requisições normais e os picos de documentos longos e depois some tudo. Se a ideia é aparar os documentos para reduzir a entrada abaixo de 272K, é preciso, ao mesmo tempo, validar se o conteúdo aparado ainda preserva as evidências necessárias para a entrega; caso contrário, o custo economizado pode voltar em forma de retrabalho.
4. Preencher o orçamento mensal do GPT-6.2 Sol por canal
4.1 Recálculo lado a lado da tabela de preços pública da APIYI e das tarifas oficiais da OpenAI
Em 2026-11-20, reli a tabela geral pública de modelos da APIYI e a interface pública de preços. Ambas mostram gpt-6.2-sol, e a tabela geral indica duas entradas: responses e chat. O preço público também usa 272,000 tokens de entrada como ponto de corte, mas a expressão de cálculo da faixa longa é diferente dos multiplicadores oficiais.
| Categoria de cobrança (USD / milhão de tokens) | Faixa curta OpenAI | Faixa longa OpenAI | Faixa curta APIYI apiyi.com | Faixa longa APIYI apiyi.com |
|---|---|---|---|---|
| Entrada normal | $2.00 | $4.00 | $2.00 | $3.00 |
| Leitura de cache | $0.10 | $0.20 | $0.10 | $0.15 |
| Gravação de cache | $2.50 (30 minutos) | $5.00 (30 minutos) | $2.50 | $3.75 |
| Saída | $10.00 | $15.00 | $10.00 | $11.25 |
Continuando o recálculo de consumo da seção 3.2. Com 270,000 tokens de entrada e 6,000 de saída, os dois canais ficam em $0.60. Com 280,000 tokens de entrada e 6,000 de saída, a OpenAI oficial fica em $1.21; pela fórmula pública da APIYI, o valor é (280000×3 + 6000×11.25)÷1e6 = $0.9075, uma diferença de cerca de $0.30 por chamada. Quanto maior a proporção de documentos longos, maior o impacto dessa diferença no orçamento mensal.
Essa diferença é derivada apenas dos parâmetros já publicados por ambas as partes. Os descontos de Batch e de janela em segundo plano mencionados anteriormente usam o exemplo de cálculo oficial da OpenAI; ao fazer chamadas via APIYI, o agrupamento de conta, a cobrança real, as faixas disponíveis e as capacidades da API estão sujeitos à configuração atual e à fatura da APIYI.
4.2 Planilha de orçamento mensal: uma linha por tipo de tarefa
A ideia é pegar o cálculo anterior e colocar tudo numa tabela: cada tipo de tarefa ocupa uma linha, você preenche com o consumo médio por requisição e multiplica pelo número de requisições no mês. Se o fluxo de trabalho tiver várias chamadas ao modelo (por exemplo, a inferência em várias etapas de um Agent), registre cada etapa em uma linha separada e some tudo no final.
| Tipo de tarefa | Requisições/mês | Entrada normal média | Leitura de cache média | Escrita em cache (nível) | Saída faturável média | Faixa de contexto | Nível de serviço | Custos adicionais (ferramentas / região) | Taxa de retry estimada | Custo mensal |
|---|---|---|---|---|---|---|---|---|---|---|
| Atendimento ao cliente | 2,000 | 20,000 | 0 | 0 | 3,000 | Curta | Standard | Nenhum | 0% | $140 |
| Classificação noturna | 10,000 | 50,000 | 0 | 0 | 4,000 | Curta | Batch | Nenhum | 0% | $700 |
| Revisão de contratos | Preencher com valores reais | Preencher com valores reais | 6,000 | Longa | Standard | Preencher com valores reais | Preencher com valores reais |
Os números das duas primeiras linhas vêm dos exemplos de cálculo deste artigo e servem como referência para o preenchimento. A fórmula do custo mensal é “custo do modelo por chamada × requisições/mês × (1 + taxa de retry) + custos adicionais”. O custo do modelo por chamada deve ser obtido na tabela de tarifas da seção 1, de acordo com a faixa de contexto e o nível de serviço daquela linha.
🚀 Sugestão prática: depois de preencher a planilha, escolha as duas tarefas de maior valor e faça uma rodada com requisições reais no APIYI apiyi.com. Troque os valores estimados pelos valores medidos em
usagee você terá um orçamento pronto para entregar ao financeiro.
4.3 Verificar se o orçamento é confiável
Depois de receber a fatura do primeiro mês, confira linha por linha três coisas.
- Se a proporção de requisições que ultrapassam 272K na distribuição real de entrada está próxima da estimativa.
- Se a proporção de tokens de raciocínio em
output_tokensé visivelmente maior do que na fase de testes. - Se o número real de retentativas e chamadas de ferramentas foi contabilizado.
Se o desvio dos três itens estiver dentro de 10%, você pode reutilizar essa tabela diretamente no próximo mês; o item com desvio maior é justamente onde você precisa priorizar o ajuste de uso ou de nível.
Materiais de referência
- Preços oficiais da API da OpenAI: multiplicadores de cada nível de serviço e descontos de Batch e da janela em segundo plano
- Link:
developers.openai.com/api/docs/pricing
- Link:
- Ficha do modelo GPT-6.2 Sol: janela de contexto, regras de mudança de nível em 272K e limites
- Link:
developers.openai.com/api/docs/models/gpt-6.2-sol
- Link:
- Guia do modo em segundo plano e da Batch API: janelas de conclusão, requisitos de não streaming e cota de fila
- Link:
developers.openai.com/api/docs/guides/background、developers.openai.com/api/docs/guides/batch
- Link:
- Tabela geral de modelos do APIYI e interface pública de preços: entrada de listagem do
gpt-6.2-sole expressão de precificação por nível- Link:
docs.apiyi.com/models.md、api.apiyi.com/api/pricing
- Link:
Autor: Equipe técnica da APIYI
Contato técnico: Para dúvidas sobre critérios de cobrança e configuração da conta, fale conosco pela página inicial do site da APIYI. Para mais materiais de integração, consulte o centro de documentação em docs.apiyi.com