Resumo: O conjunto completo de APIs do DeepSeek cobra separadamente pelos Tokens do modelo e pelas chamadas de ferramentas. O custo total precisa ser calculado item por item, com base no número de buscas, no número de páginas de arquivos, no volume de processamento de voz e na taxa de acerto do cache.
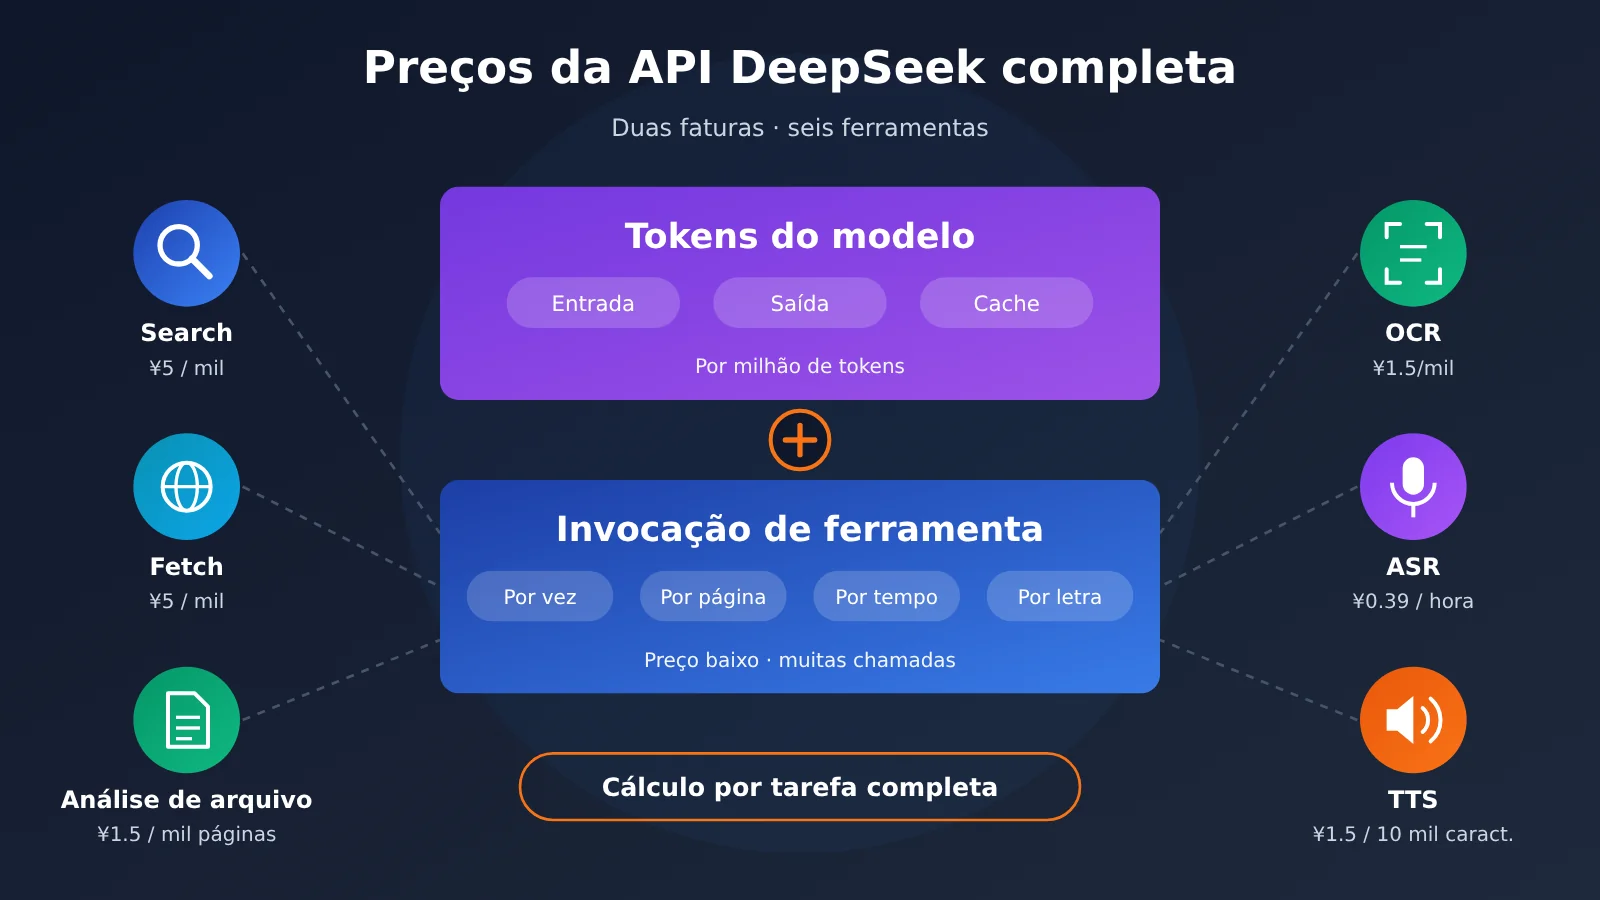
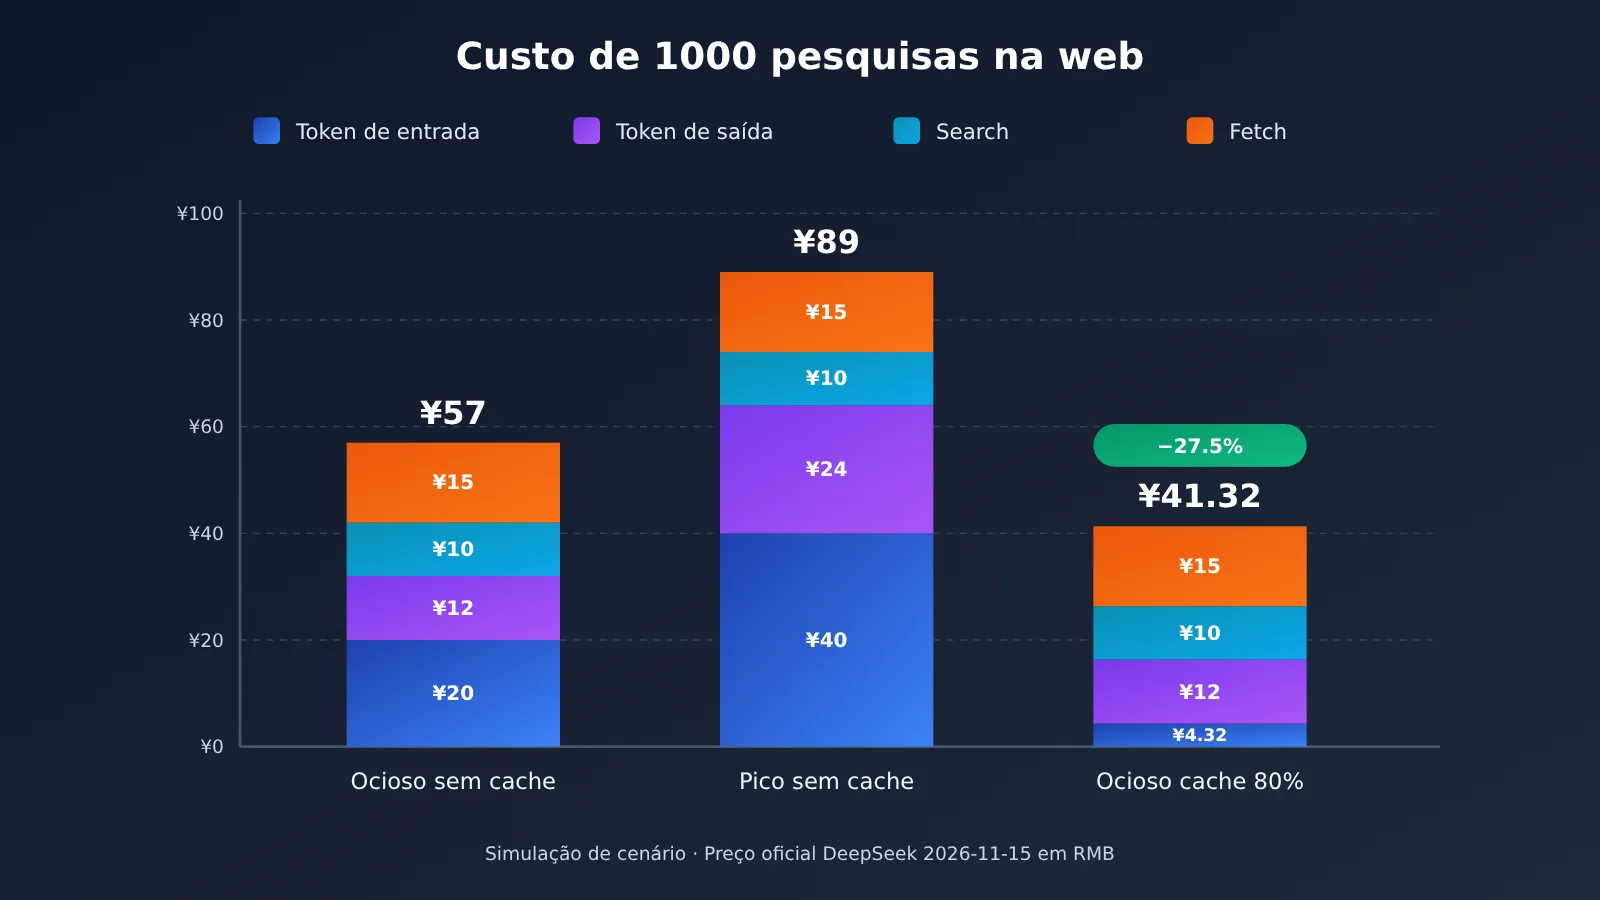
Resposta direta: Segundo o documento oficial de preços em chinês do DeepSeek, de 15 de novembro de 2026, Search e Fetch custam ¥5 por 1000 requisições bem-sucedidas, análise de arquivos e OCR custam ¥1.5 por 1000 páginas, o preço promocional do ASR é ¥0.39 por hora e o do TTS é ¥1.5 por 10000 caracteres cobrados. O preço unitário das ferramentas é bem baixo, mas a conta de uma tarefa de Agent com acesso à internet normalmente é dominada pelos Tokens do modelo. Tomando como base uma tarefa de pesquisa com “2 buscas, 3 capturas, 20 mil Tokens de entrada e 3000 Tokens de saída”, 1000 tarefas custam cerca de ¥57 no horário ocioso e cerca de ¥89 no horário de pico; com 80% de acerto no cache de entrada, o valor no horário ocioso pode cair para cerca de ¥41.32. Por isso, na hora de fazer o orçamento, calcule por “tarefa completa” — o preço de uma única requisição de API é apenas um dos itens.
A seguir, vamos primeiro separar a estrutura de cobrança dos custos de modelo e dos custos de ferramentas, e depois listar item por item o preço unitário e a unidade de cobrança de Search, Fetch, análise de arquivos, OCR, ASR e TTS. Em seguida, vamos demonstrar o cálculo completo com 4 cenários de premissas fixas, mostrando como a busca profunda, a janela de contexto longa e os limites de taxa afetam a conta. Por fim, apresentamos um conjunto de código de log de custos pronto para reutilizar e comparamos como escolher entre a busca embutida no modelo e as interfaces independentes de Search / Fetch.
Para saber: terminologia de cobrança do pacote completo de APIs da DeepSeek
| Termo | Explicação |
|---|---|
| Token | Unidade de medida que o modelo usa ao processar texto; o custo do modelo é cobrado por milhão de tokens |
| Token de entrada | Todo o conteúdo que entra na janela de contexto e participa da inferência, incluindo comando, conteúdo de arquivos e resultados de busca |
| Token de saída | Conteúdo gerado pelo modelo; no modo de raciocínio, o processo de pensamento também entra na conta da saída |
| Context Cache | Reaproveita contextos já processados antes, reduzindo o custo de entradas repetidas |
| Acerto de cache | O conteúdo de entrada consegue reutilizar o cache e passa a ser cobrado pelo preço unitário menor de “acerto de cache” |
| Horário de pico / ocioso | A DeepSeek aplica duas faixas de preço conforme o horário de Pequim; o preço ocioso é metade do preço de pico |
| Search API | Consulta páginas web por palavra-chave e retorna resultados de busca estruturados |
| Fetch API | Captura uma página web indicada e retorna o conteúdo do corpo |
| Busca integrada ao modelo | Declara a ferramenta de busca na requisição de conversa; o próprio modelo decide quando buscar, e o servidor executa a busca em seu nome |
| QPS | Quantidade de requisições permitidas por segundo |
| OCR | Reconhecimento de texto a partir de imagens ou documentos |
| ASR | Transformação de fala em texto |
| TTS | Síntese de texto em fala |
| Caractere de cobrança | Unidade de medida do TTS; cada caractere chinês conta como 2 caracteres de cobrança |
| Tool Usage | Uso cobrado gerado quando o modelo ou o programa efetivamente chama ferramentas externas |
1 Como o pacote completo de APIs do DeepSeek cobra, afinal
1.1 As duas categorias de cobrança do pacote completo de APIs do DeepSeek: custos de modelo e custos de ferramentas
Em 13 de novembro de 2026, o DeepSeek abriu como API os recursos que ficam por trás do App: busca na web, busca com raciocínio profundo, leitura de links, entrada de arquivos, OCR, ASR, TTS, verificação de segurança, entre outros. No faturamento, esses recursos e a inferência do modelo são cobrados separadamente. Dá para resumir tudo em uma fórmula:
Custo total = custo de entrada do modelo (cache hit + cache miss)
            + custo de saída do modelo (inclui tokens de raciocínio)
            + custo de chamadas de ferramentas (Search / Fetch / busca de imagens)
            + custos de processamento de arquivos e voz (páginas analisadas / páginas de OCR / duração do áudio / caracteres de TTS)
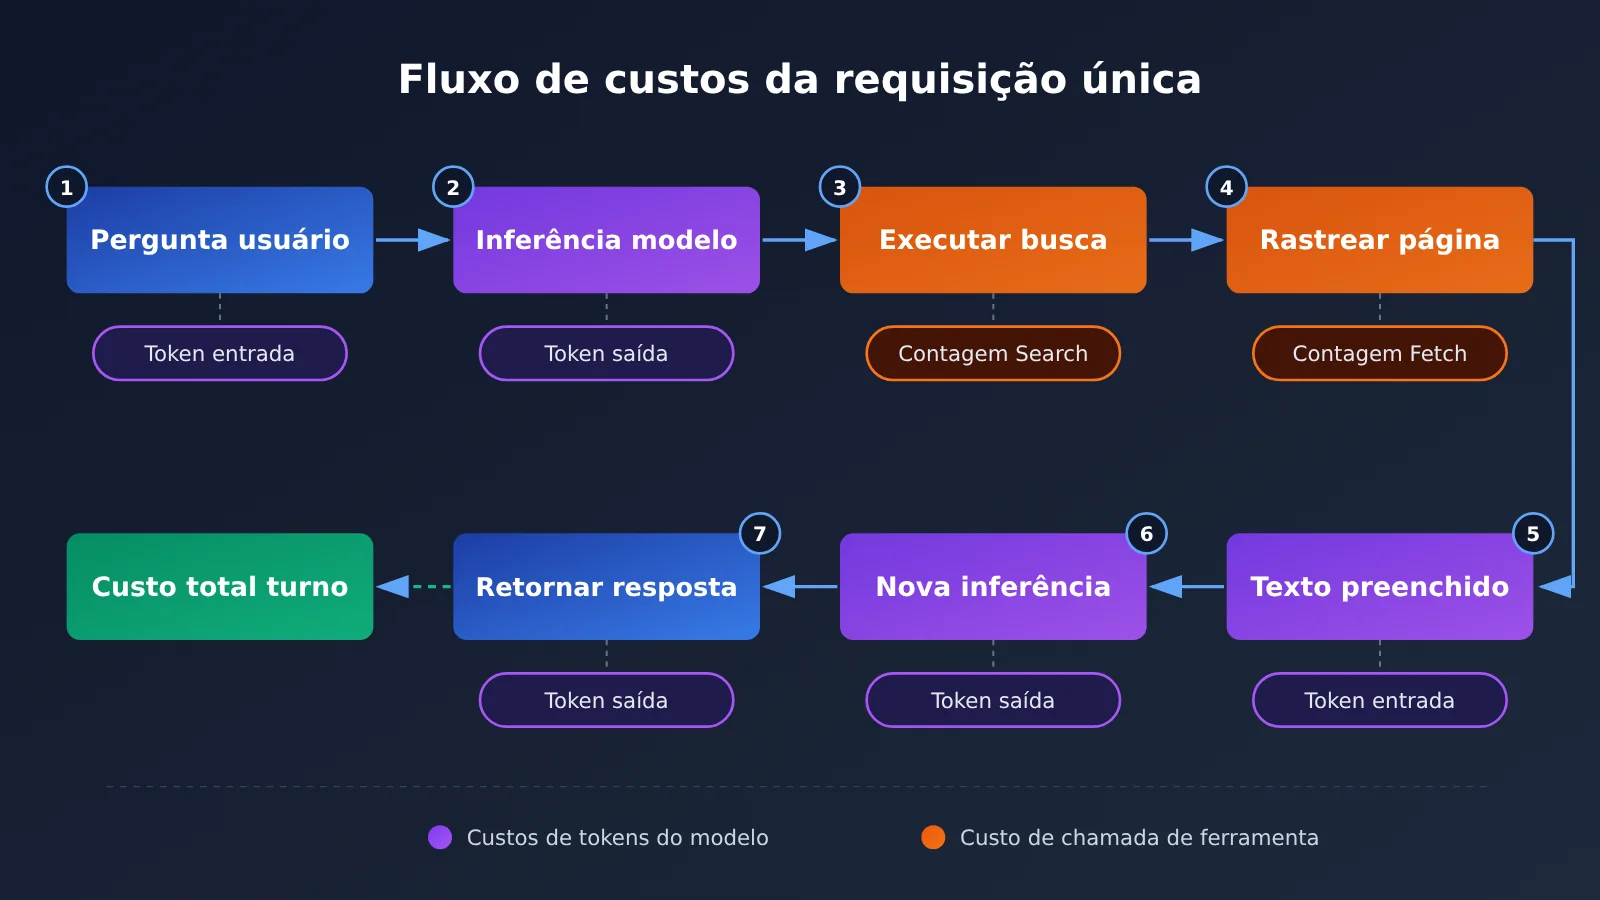
Uma única rodada de perguntas e respostas pode gerar todos esses itens ao mesmo tempo. Por exemplo, quando você ativa a busca com raciocínio profundo em uma conversa, o modelo gera vários termos de busca, abre diversas páginas web e depois insere o conteúdo dessas páginas no contexto para continuar raciocinando. Essa requisição gera custos de busca e de captura de páginas, e também um volume enorme de tokens de entrada, porque o texto das páginas entra no contexto; além disso, o processo de raciocínio ainda é contabilizado como tokens de saída.
1.2 Preços dos modelos DeepSeek Flash e Pro
Os valores abaixo são os publicados no documento oficial de preços do DeepSeek em 15 de novembro de 2026, em yuan (RMB), por milhão de tokens.
| Modelo | Cache hit (fora de pico / pico) | Cache miss (fora de pico / pico) | Saída (fora de pico / pico) | Limite de concorrência |
|---|---|---|---|---|
| DeepSeek-V4.1-Flash | ¥0,02 / ¥0,04 | ¥1 / ¥2 | ¥4 / ¥8 | 2500 |
| DeepSeek-V4-Pro | ¥0,15 / ¥0,30 | ¥4,5 / ¥9 | ¥13,5 / ¥27 | 500 |
O horário de pico vai das 09:00 às 12:00 e das 14:00 às 18:00, de segunda a sexta-feira no horário de Pequim, excluindo feriados nacionais chineses; todo o resto do tempo (incluindo fins de semana e feriados nacionais o dia inteiro) é considerado fora de pico. Os dois modelos têm janela de contexto de 1M e saída máxima de 384K; o Flash suporta compreensão de imagens, o Pro não.
A escolha do modelo também afeta a disponibilidade das ferramentas. Neste anúncio, a integração completa de ferramentas no nível da conversa (busca na web, busca com raciocínio profundo, leitura de links, análise de arquivos, compreensão de imagens, verificação de segurança) fica a cargo do deepseek-flash (DeepSeek-V4.1-Flash). Ao planejar um aplicativo que precise de ferramentas integradas, use o Flash como base para montar o modelo de custos.
2 Quanto custam Search, Fetch, OCR, ASR e TTS na suíte completa de APIs da DeepSeek
A tabela abaixo traz os preços oficiais das ferramentas da DeepSeek (15 de novembro de 2026, em RMB). O “preço de tabela” e a “promoção por tempo limitado” são listados separadamente; após o fim da promoção, é preciso refazer o orçamento com base no preço de tabela.
| Capacidade | Unidade de cobrança | Preço de tabela | Promoção por tempo limitado | Equivalente por chamada / unidade |
|---|---|---|---|---|
| Search (busca) | 1000 solicitações bem-sucedidas | ¥5 | ¥5 | ¥0.005 / chamada |
| Fetch (captura de páginas web) | 1000 solicitações bem-sucedidas | ¥5 | ¥5 | ¥0.005 / chamada |
| Parsing de arquivos | 1000 páginas | ¥1.5 | ¥1.5 | ¥0.0015 / página |
| OCR | 1000 páginas | ¥1.5 | ¥1.5 | ¥0.0015 / página |
| ASR | 1 hora de áudio | ¥0.78 | ¥0.39 | menos de 1 segundo conta como 1 segundo |
| TTS | 10000 caracteres cobráveis | ¥3 | ¥1.5 | caracteres chineses contam como 2 caracteres |
2.1 Como é a cobrança do Search e do Fetch da DeepSeek
O Search independente é cobrado por solicitação bem-sucedida: só conta como sucesso se o HTTP 200 vier com o array results não vazio. Uma única solicitação pode retornar de 1 a 50 resultados (count padrão 10), e o preço é o mesmo para 1 ou 50 resultados; por isso, pegar mais resultados de uma vez sai mais barato do que fazer várias solicitações pequenas. O Fetch independente exige HTTP 200 e o retorno bem-sucedido do corpo da página; falhas, timeouts e ausência de resultados não são cobrados.
O critério de contagem da busca embutida no modelo é diferente. A busca textual embutida é cobrada pelo número de termos de consulta efetivamente executados: se uma chamada de ferramenta leva 3 termos de consulta, conta como 3 cobranças; a busca de imagens embutida é cobrada pelo número de imagens retornadas e pelo número de regiões selecionadas; a captura de páginas web embutida é cobrada pelo número de páginas capturadas com sucesso. Portanto, ao ativar a busca em uma conversa, é normal que uma única rodada de perguntas e respostas gere várias cobranças de busca.
2.2 Cobrança por página do processamento de arquivos e OCR no DeepSeek
O processamento de arquivos é feito via Files API: você envia o arquivo, o servidor o processa e retorna o file_id; depois basta referenciar o file_id na conversa. A cobrança é pelas páginas processadas com sucesso: ¥1,5 a cada 1000 páginas. Se você referenciar novamente o mesmo arquivo já processado em uma conversa, não há nova cobrança de processamento, mas o conteúdo do arquivo entra no contexto a cada vez e é cobrado como tokens de entrada.
O modo de processamento também influencia o uso de tokens. O text_recognition fornece apenas texto puro ao modelo; o rich_layout_recognition recorta gráficos e tabelas como imagens e os envia ao modelo junto com o texto, o que é adequado para relatórios financeiros e apresentações PPT, mas aumenta os tokens de imagem. Arquivos como XLSX, CSV, TXT, MD, JSON e EPUB podem ser enviados como user_data e convertidos para Markdown; esse tipo de upload não tem cobrança de processamento.
O OCR é uma interface separada (/v1/tools/ocr), também a ¥1,5 por 1000 páginas, cobrando pelas páginas reconhecidas com sucesso — falhas e timeouts não são cobrados. As duas funções têm propósitos diferentes: o OCR só extrai texto e informações de posição, enquanto o processamento de arquivos envia o resultado diretamente para o contexto do modelo, para que ele o compreenda.
2.3 Cobrança de voz do ASR e TTS no DeepSeek
O ASR (/v1/tools/asr) tem preço de tabela de ¥0,78 por hora de áudio, com 50% de desconto por tempo limitado, saindo por ¥0,39; menos de 1 segundo é cobrado como 1 segundo. Ele usa upload do arquivo completo e reconhecimento não streaming, com duração máxima de 120 segundos e tamanho máximo de 8 MiB por áudio, suportando WAV PCM de 16 bits e Ogg Opus, com 50 chamadas simultâneas por conta. Gravações longas precisam ser divididas em segmentos; o trecho final com menos de 1 segundo de cada segmento é arredondado para cima separadamente. Quanto mais fragmentado o corte, mais esses arredondamentos se acumulam.
O TTS (/v1/tools/tts, que também oferece síntese streaming via WebSocket) tem preço de tabela de ¥3 a cada 10 mil caracteres faturáveis, com preço promocional de ¥1,5. Cada caractere chinês conta como 2 caracteres faturáveis; letras, números e espaços em inglês contam como 1. O máximo por chamada é de 10 mil caracteres faturáveis. Em termos práticos, 100 mil caracteres faturáveis equivalem a cerca de 50 mil caracteres chineses, então o orçamento para conteúdo em chinês precisa ser multiplicado por 2 antes.
3 Estimativa de custos da suíte completa da API DeepSeek em quatro cenários
Os quatro casos abaixo são calculados com base nos preços unitários públicos e em premissas fixas. O número de chamadas e o uso de tokens são valores hipotéticos: trata-se de uma estimativa por cenário, cujo objetivo é demonstrar o método de cálculo. A fatura real deve ser considerada com base nos campos de cobrança retornados pelo servidor.
3.1 Cenário 1: 1000 tarefas de pesquisa com acesso à internet (¥57 fora de pico / ¥89 no pico)
Premissas: usar DeepSeek-V4.1-Flash; cada tarefa tem 2 termos de consulta de busca bem-sucedidos, 3 páginas da web capturadas com sucesso, 20000 tokens de entrada com cache miss e 3000 tokens de saída.
| Item | Fórmula de cálculo | Fora de pico (¥/execução) | Horário de pico (¥/execução) |
|---|---|---|---|
| Tokens de entrada | 20000 ÷ 1000000 × preço unitário | 0,020 | 0,040 |
| Tokens de saída | 3000 ÷ 1000000 × preço unitário | 0,012 | 0,024 |
| Search | 2 × ¥0,005 | 0,010 | 0,010 |
| Fetch | 3 × ¥0,005 | 0,015 | 0,015 |
| Total por execução | — | 0,057 | 0,089 |
| Total para 1000 execuções | Valor por execução × 1000 | ¥57 | ¥89 |
No horário de pico, o custo de tokens do modelo dobra, enquanto os preços de Search e Fetch não mudam. Por isso, a fatura total sobe de ¥57 para ¥89, um aumento de cerca de 56%. Nesta tarefa, o custo do modelo representa aproximadamente 56% da conta fora de pico (¥32 / ¥57), o que mostra que o maior peso de um agente com acesso à internet ainda está nos tokens. Para reduzir custos da forma mais direta, basta mover para fora do pico as tarefas em lote que podem ser executadas mais tarde.
3.2 Cenário 2: quanto dá para economizar com 80% de acerto no cache de entrada?
Premissa: as condições são as mesmas do Cenário 1 (fora de pico), mas, dos 20000 tokens de entrada, 16000 acertam o cache e 4000 não.
- Entrada com acerto de cache: 16000 ÷ 1000000 × ¥0.02 = ¥0.00032
- Entrada sem acerto de cache: 4000 ÷ 1000000 × ¥1 = ¥0.004
- Saída: 3000 ÷ 1000000 × ¥4 = ¥0.012
- Busca + captura: ¥0.010 + ¥0.015 = ¥0.025
- Total por execução: ¥0.04132; total de 1000 execuções: ¥41.32
Em comparação com os ¥57 do Cenário 1, há uma economia de ¥15.68, cerca de 27.5%. O cache incide apenas sobre o custo de entrada: a entrada cai de ¥0.020 para cerca de ¥0.0043, enquanto os custos de saída e de ferramentas permanecem totalmente inalterados. Quanto maior a taxa de acerto do cache, mais a fatura se aproxima do limite inferior de “saída + ferramentas”; nesse ponto, para continuar reduzindo custos, é preciso diminuir o número de buscas e controlar o comprimento da saída.
3.3 Cenário 3: processamento em lote de 5000 páginas de documentos empresariais
Premissa: período ocioso do Flash; as 5000 páginas de documentos são analisadas uma única vez; as análises seguintes somam 10 milhões de tokens de entrada com cache miss e 1 milhão de tokens de saída.
- Análise de arquivos: 5000 ÷ 1000 × ¥1.5 = ¥7.50
- Entrada do modelo: 10000000 ÷ 1000000 × ¥1 = ¥10.00
- Saída do modelo: 1000000 ÷ 1000000 × ¥4 = ¥4.00
- Total ¥21.50
A taxa de análise representa apenas cerca de 35%. Se o mesmo lote de arquivos for despejado inteiro na janela de contexto repetidas vezes ao longo de várias rodadas de conversa, os tokens de entrada se multiplicam, enquanto o custo de análise não cresce mais. O ponto-chave no cenário de documentos grandes é controlar “quantas vezes o conteúdo do arquivo entra na janela de contexto”.
3.4 Cenário 4: 10 horas de reconhecimento de fala + 100 mil caracteres faturáveis de TTS
Premissa: usando o preço atual com 50% de desconto por tempo limitado; ASR sobre 10 horas de áudio e TTS com 100000 caracteres faturáveis.
- ASR: 10 × ¥0.39 = ¥3.90
- TTS: 100000 ÷ 10000 × ¥1.5 = ¥15.00
- Total ¥18.90
Esse valor cobre apenas os serviços de fala; quando o texto transcrito é enviado ao modelo de conversa para resumo e perguntas e respostas, os tokens do modelo são cobrados separadamente. Pelo preço de tabela, o mesmo volume ficaria em 10 × ¥0.78 + 10 × ¥3 = ¥37.80, ou seja, o orçamento de fala dobra depois que a promoção termina. Além disso, 10 horas de áudio, com limite de 120 segundos por segmento, precisam ser cortadas em pelo menos 300 partes, o que exige orquestração com 50 de concorrência.
4 Quais fatores fazem a fatura da API da suíte completa DeepSeek aumentar
4.1 A busca com raciocínio profundo executa vários termos de consulta em uma única vez
A busca com raciocínio profundo pode chamar cerca de 20 ferramentas antes de responder, e a cobrança é acumulada conforme as ações reais. Algumas regras importantes das condições oficiais de cobrança:
- Um Search que inclui 3 termos de consulta, todos com resultados, conta como 3 buscas
- Uma busca de imagens que retorna 3 imagens conta como 3; se o modelo selecionar mais 2 regiões na imagem, são mais 2 cobranças
- Abrir com sucesso 1 página web que precisa de acesso à internet conta como 1 Fetch; abrir a mesma página novamente não gera nova cobrança
- Executar
find_in_pageem uma página já aberta não gera cobrança separada; Search sem resultado não é cobrado - Quando a segurança de conteúdo do modelo está ativada, algumas páginas, mesmo aparecendo como
url_not_allowedouunavailable, ainda podem ser cobradas se a captura subjacente tiver sido concluída com sucesso
Ao contabilizar, use os campos de cobrança server_tool_use.tool_search, tool_fetch e tool_image_search. web_search_requests e web_fetch_requests apenas mostram o número de blocos retornados e podem incluir requisições com falha; calcular com base neles superestima o custo.
4.2 Contexto longo e entrada repetida de arquivos
Resultados de busca, corpo de páginas web e arquivos já analisados entram no contexto. A ferramenta de leitura de links considera no máximo 10 URLs diferentes na última mensagem do usuário; ao ler várias páginas ao mesmo tempo, o contexto disponível por página diminui, mas o volume total de entrada ainda é considerável. Em sessões longas, cada rodada carrega o histórico, e os Tokens de entrada crescem acumulativamente com as rodadas.
Há três formas de reduzir custos: salvar resumos e fatos-chave na camada da aplicação e referenciar o resumo nas rodadas seguintes; manter o comando de sistema, materiais públicos e regras de fluxo de trabalho no início do contexto e estáveis, para aumentar a probabilidade de acerto do cache; usar rich_layout_recognition apenas quando for preciso ver gráficos e tabelas.
4.3 Limite de taxa de requisições em tarefas em lote
O limite no nível da conta para o Search independente é de 100 QPS, e o do Fetch é de 25 QPS. Essa é a cota da conta inteira, compartilhada por várias chaves API. O Fetch também está sujeito a limites de QPS no nível do domínio de destino; capturar o mesmo site de forma concentrada tende a acionar o 429. Sugestões para tratamento de erros:
- 408, 429, 5xx: tentar novamente após backoff exponencial e distribuir as requisições do mesmo domínio
- 402: saldo insuficiente; primeiro resolva o saldo da conta
- Outros 4xx (como erro de parâmetro): corrija a requisição antes de enviar; tentar novamente não adianta
Requisições com falha não são cobradas, então a nova tentativa em si não aumenta o custo das ferramentas, mas prolonga a duração da tarefa. Para tarefas em lote grandes, o tempo de conclusão deve ser calculado inversamente com base no limite de 25 QPS do Fetch.
5 Como definir um orçamento de custos razoável para o Agente DeepSeek
5.1 Log de custos da API do pacote completo DeepSeek: início rápido
Em ambiente de produção, é preciso registrar separadamente, no mínimo: entrada com acerto de cache, entrada sem acerto de cache, Tokens de saída, número de Search, número de Fetch, número de buscas de imagens, número de páginas de documentos processadas, duração de áudio e caracteres cobrados de TTS. A função abaixo lê diretamente o campo usage para calcular o custo de uma única chamada e pode ser acoplada após cada requisição para gravar o log.
# Estimativa de custo do pacote completo DeepSeek (RMB, preços oficiais de 2026-11-15)
FLASH = {"cache_hit": 0.02, "cache_miss": 1.0, "output": 4.0}  # Horário ocioso ¥/milhão de Tokens
TOOL = {"search": 0.005, "fetch": 0.005, "image_search": 0.005}  # ¥/chamada

def estimate_cost(usage: dict, peak: bool = False) -> dict:
    k = 2 if peak else 1  # O preço de pico é o dobro do preço de horário ocioso; o preço das ferramentas não muda
    stu = usage.get("server_tool_use", {})
    model = (usage.get("cache_read_input_tokens", 0) * FLASH["cache_hit"]
             + usage.get("input_tokens", 0) * FLASH["cache_miss"]
             + usage.get("output_tokens", 0) * FLASH["output"]) / 1e6 * k
    tools = (stu.get("tool_search", 0) * TOOL["search"]
             + stu.get("tool_fetch", 0) * TOOL["fetch"]
             + stu.get("tool_image_search", 0) * TOOL["image_search"])
    return {"model": round(model, 5), "tools": round(tools, 5),
            "total": round(model + tools, 5)}

# Reproduzindo o cenário 2: 16000 acertos de cache + 4000 falhas de cache + 3000 tokens de saída + 2 buscas + 3 fetches
print(estimate_cost({"cache_read_input_tokens": 16000, "input_tokens": 4000,
                     "output_tokens": 3000,
                     "server_tool_use": {"tool_search": 2, "tool_fetch": 3}}))
# {'model': 0.01632, 'tools': 0.025, 'total': 0.04132}
O preço unitário da busca de imagens é tratado aqui como o preço unitário de Search; antes de entrar em produção, confirme com a documentação oficial. Na dimensão do orçamento, produtos de perguntas e respostas são mais adequados para contabilizar “por requisição do usuário”; agentes de múltiplas etapas, Deep Research e automação em lote são mais adequados para contabilizar “por ciclo de vida da tarefa”, agregando todas as invocações de modelo e de ferramentas dentro de uma tarefa sob o mesmo task_id.
5.2 Quando escolher a busca integrada do DeepSeek e quando escolher as interfaces independentes Search / Fetch
| Dimensão | Busca integrada ao modelo (deepseek_web_search / read_url) | API independente Search / Fetch |
|---|---|---|
| Complexidade de desenvolvimento | Baixa; o servidor realiza a busca, a captura e a montagem do contexto | Mais alta; é preciso orquestrar você mesmo o loop de ferramentas |
| Controle do fluxo | O modelo decide quantas buscas fazer e quais páginas ler | O desenvolvedor controla com precisão cada chamada |
| Critério de cobrança | Por número de termos de consulta, número de imagens e páginas capturadas com sucesso | Por número de requisições HTTP bem-sucedidas |
| Previsibilidade de custo | Varia bastante; a busca profunda chega a cerca de 20 chamadas de ferramentas no máximo | Alta; o número de chamadas é definido pelo código |
| Cenários ideais | Assistentes de conversa, replicar rapidamente a experiência do App | RAG, coleta em lote, Agent com fluxo fixo |
Quando você precisa colocar um produto de conversa no ar rapidamente, a busca integrada economiza muito trabalho de engenharia; quando precisa manter o custo por tarefa dentro de uma faixa fixa, ou quando é preciso primeiro filtrar para depois capturar, a interface independente é mais adequada. As duas também podem ser combinadas: usar as ferramentas integradas no fluxo principal de conversa e a interface independente para complementar dados em lote em segundo plano.
5.3 Integração e preços do DeepSeek Search / Fetch na APIYI
A APIYI disponibilizou em 21 de outubro de 2026 as interfaces de ferramentas independentes do DeepSeek, deepseek-search e deepseek-fetch, com os endpoints POST /v1/tools/search e POST /v1/tools/fetch. Elas não consomem tokens do modelo e são cobradas por número de chamadas bem-sucedidas; estão disponíveis nos grupos default e svip, e os tokens do grupo ClaudeCode não conseguem chamá-las diretamente. Para a busca integrada ao modelo usada por clientes como DeepSeek Harness e Claude Code, o trabalho de compatibilidade da APIYI ainda está no planejamento futuro; atualmente, o que está disponível são as interfaces independentes Search / Fetch.
A seguir estão os preços divulgados na documentação da APIYI, em dólares:
| Item | Preço oficial indicado na documentação | Preço no site da APIYI | Equivalente após 20% de bônus | Equivalente após 10% de bônus |
|---|---|---|---|---|
| Search / 1000 vezes | $0.75 | $0.90 | $0.75 | cerca de $0.82 |
| Fetch / 1000 vezes | $0.75 | $0.90 | $0.75 | cerca de $0.82 |
Calculando com base no volume de ferramentas do Cenário 1 (1000 buscas Search + 3000 Fetches): a cobrança no site é (1000 + 3000) ÷ 1000 × $0.90 = $3.60; com o bônus de 20% aplicado a todo o consumo, o equivalente é $3.60 ÷ 1.20 = $3.00; com bônus de 10%, cerca de $3.27. O DeepSeek oficial cobra em RMB, então, para comparar o custo real, é preciso unificar a moeda, a taxa de câmbio e as condições de bônus de recarga; no fim, vale o preço exibido no console da conta.
Exemplo mínimo de chamada (os campos da requisição seguem a documentação da APIYI):
import requests

BASE_URL = "https://api.apiyi.com/v1"  # Interface unificada da APIYI
headers = {"Authorization": "Bearer YOUR_API_KEY"}

resp = requests.post(f"{BASE_URL}/tools/search", headers=headers,
                     json={"model": "deepseek-search",
                           "query": "DeepSeek API 价格", "count": 10})
print(resp.json())
Ver a implementação completa: primeiro buscar, depois capturar, com retentativa com backoff para 429 e contagem
import time
import requests

BASE_URL = "https://api.apiyi.com/v1"  # entrada compatível com OpenAI da APIYI
HEADERS = {"Authorization": "Bearer YOUR_API_KEY"}
RETRY_CODES = {408, 429, 500, 502, 503, 504}

def call_tool(path: str, payload: dict, max_retry: int = 4) -> dict | None:
    """Chama a interface da ferramenta; erros que permitem nova tentativa usam backoff exponencial, e requisições que falham não são cobradas"""
    for i in range(max_retry):
        r = requests.post(f"{BASE_URL}{path}", headers=HEADERS,
                          json=payload, timeout=60)
        if r.status_code == 200:
            return r.json()
        if r.status_code == 402:
            raise RuntimeError("余额不足,请先充值")
        if r.status_code in RETRY_CODES:
            time.sleep(2 ** i)  # 1s, 2s, 4s, 8s
            continue
        raise ValueError(f"请求参数错误: {r.status_code} {r.text}")
    return None

def research(query: str, fetch_top: int = 3) -> dict:
    stats = {"search": 0, "fetch": 0}
    result = call_tool("/tools/search",
                       {"model": "deepseek-search", "query": query, "count": 10})
    items = (result or {}).get("results", [])
    if items:
        stats["search"] += 1  # só cobra quando há resultados não vazios
    pages = []
    for item in items[:fetch_top]:  # busca apenas as páginas cujo conteúdo original realmente precisa ser lido
        page = call_tool("/tools/fetch",
                         {"model": "deepseek-fetch", "url": item.get("url")})
        if page:
            stats["fetch"] += 1
            pages.append(page)
        time.sleep(0.05)  # controla o ritmo para evitar o limite de 25 QPS do Fetch e o limite por domínio
    return {"pages": pages, "billing": stats}

if __name__ == "__main__":
    out = research("DeepSeek 全家桶 API 计费规则")
    print(out["billing"])  # por exemplo, {'search': 1, 'fetch': 3}
🚀 Início rápido: basta se registrar via APIYI apiyi.com para obter crédito de teste; primeiro faça requisições em pequeno volume para validar Search / Fetch e depois estime o orçamento oficial com base no número real de invocações registrado nos logs.
Perguntas frequentes (FAQ)
Q1: Quais itens cobrados fazem parte do API do pacote completo DeepSeek?
Inclui os Tokens do modelo (entrada com acerto de cache, entrada sem acerto de cache, saída) e as taxas de ferramentas (Search, Fetch, busca de imagens, análise de arquivos, OCR, ASR, TTS). A verificação de segurança e a busca dentro da página `find_in_page` não têm preço listado separadamente na tabela pública de preços.
Q2: Qual é a diferença de cobrança entre o API Search independente e a busca embutida no modelo?
O Search independente conta 1 vez por requisição HTTP bem-sucedida — mesmo que retorne 50 itens, conta como 1; a busca embutida no modelo cobra pela quantidade real de termos de consulta, e uma chamada com 3 termos conta como 3. O modo embutido é mais simples de desenvolver, enquanto o modo independente dá mais controle sobre o custo.
Q3: De quando são esses preços e a oferta por tempo limitado pode mudar?
Os preços deste artigo vêm da documentação oficial chinesa de preços da DeepSeek, com data de referência em 15 de novembro de 2026. ASR e TTS estão atualmente com 50% de desconto por tempo limitado; quando a promoção terminar, voltam a ¥0,78 por hora e ¥3 por 10000 caracteres cobrados. Para orçamento de longo prazo, recomenda-se deixar uma margem com base no preço de tabela.
Q4: A fatura dobra direto nos horários de pico?
Só a parte dos Tokens do modelo dobra; os preços das ferramentas não variam por horário. No cenário um, a fatura total sobe de ¥57 para ¥89, um aumento de cerca de 56%. Quanto maior a proporção de gastos com ferramentas em uma tarefa, menor o aumento no horário de pico.
Q5: Como chamar rapidamente DeepSeek Search e Fetch via API?
1. Cadastre-se em APIYI apiyi.com e crie um token do grupo default ou svip
2. Defina o base_url como `https://api.apiyi.com/v1`
3. Use o código deste artigo para chamar `/tools/search` e `/tools/fetch`, com os nomes de modelo `deepseek-search` e `deepseek-fetch`
A mesma API Key também pode chamar outros modelos mainstream da plataforma, o que facilita entregar os resultados de busca a diferentes modelos para comparar o desempenho.
Q6: Perguntas repetidas depois de analisar um arquivo geram cobrança duplicada?
A taxa de análise é cobrada uma única vez; ao referenciar novamente o mesmo `file_id`, não há nova cobrança de análise. Porém, o conteúdo do arquivo entra no contexto a cada vez e é cobrado como Tokens de entrada — em arquivos grandes com várias rodadas de perguntas, o custo principal vem dos Tokens de entrada.
Q7: Quais são as limitações conhecidas do API do pacote completo DeepSeek?
– A integração completa de ferramentas em nível de conversa atualmente é voltada ao `deepseek-flash`
– O Search independente tem 100 QPS em nível de conta, o Fetch tem 25 QPS, e ambos estão sujeitos ao limite de taxa do domínio de destino
– ASR tem no máximo 120 segundos por segmento e é não streaming; TTS aceita no máximo 10000 caracteres cobrados por vez e ainda não permite ajustar a velocidade da fala
– A análise de arquivos aceita no máximo 100 MiB e 1000 páginas por arquivo, e até 20 arquivos referenciados por requisição
Q8: A APIYI consegue chamar todas as novas ferramentas embutidas recém-lançadas pela DeepSeek?
Atualmente a APIYI já disponibilizou o `deepseek-search` e o `deepseek-fetch` independentes, que podem ser orquestrados em Agent e RAG. O trabalho de compatibilidade da busca embutida no modelo com clientes como Harness e Claude Code ainda está em planejamento; o progresso deve ser acompanhado pela documentação oficial da APIYI em apiyi.com.
Principais conclusões sobre os preços da API da suíte completa DeepSeek
- Estrutura de cobrança: os tokens do modelo e a invocação de ferramentas são cobrados separadamente; uma única tarefa gera vários custos ao mesmo tempo
- Preço unitário das ferramentas: Search e Fetch custam ¥5 / 1000 chamadas cada; análise de arquivos e OCR custam ¥1,5 / 1000 páginas cada
- Preços de voz: ASR por tempo limitado a ¥0,39 / hora; TTS por tempo limitado a ¥1,5 / 10 mil caracteres cobráveis, com caracteres chineses contando como 2 caracteres
- O que pesa na fatura: em tarefas de pesquisa com acesso à internet, os tokens do modelo costumam representar mais da metade; horários ociosos e cache são o que mais ajuda
- Efeito do cache: quando a entrada tem 80% de acerto, a fatura do cenário 1 cai de ¥57 para ¥41,32, uma economia de cerca de 27,5%
- Critério de contabilização: contabilize pelo campo de cobrança
server_tool_use; os campos de exibição podem incluir requisições com falha - Como começar: as interfaces independentes Search / Fetch podem ser testadas na APIYI apiyi.com com uma chave unificada
Resumo
Os pontos centrais sobre os preços da API da suíte completa DeepSeek:
- Calcule por tarefa: o custo de uma tarefa de agente = entrada + saída + ferramentas + arquivos e voz; o preço de uma única requisição reflete apenas um desses itens
- Os tokens dominam a fatura: o preço unitário das ferramentas é baixo; contexto longo, arquivos repetidos e saída de raciocínio é que são as principais causas do aumento de custo
- O critério de contabilização determina a controlabilidade: a busca integrada cobra por termo de consulta, o que facilita o desenvolvimento; a interface independente cobra por requisição, com orçamento estável
Na prática, primeiro use a função de custo deste artigo em uma amostra pequena para obter os campos reais de cobrança, depois multiplique pelo volume de negócios para chegar ao orçamento, e reserve uma margem para o término das promoções por tempo limitado. Equipes que precisam orquestrar por conta própria os fluxos de busca e captura podem chamar as interfaces independentes DeepSeek Search / Fetch via APIYI apiyi.com e, com base nos preços reais do console, fazer a comparação na mesma moeda.
📚 Referências
- Modelos e preços do DeepSeek: documentação oficial de preços em tempo real
- Link:
api-docs.deepseek.com/zh-cn/quick_start/pricing -
Descrição: preço unitário por Token dos modelos, horários de pico e de baixa demanda, preços das ferramentas
-
Ferramentas de acesso à rede do DeepSeek: documentação técnica de busca integrada e leitura de links
- Link:
api-docs.deepseek.com/zh-cn/guides/web_tools -
Descrição: regras detalhadas de cobrança da busca profunda, campo de cobrança
server_tool_use -
Busca e captura de páginas web do DeepSeek: documentação independente de Search / Fetch
- Link:
api-docs.deepseek.com/zh-cn/guides/search -
Descrição: definição de requisição bem-sucedida, limites de QPS, tratamento de códigos de erro
-
Análise de arquivos / OCR / ASR / TTS do DeepSeek: documentação técnica de cada ferramenta
- Link:
api-docs.deepseek.com/zh-cn/guides/document_parsing -
Descrição: no mesmo diretório é possível consultar as limitações e as unidades de cobrança de ocr, asr e tts
-
Anúncio da API do pacote completo de aplicações DeepSeek: publicado em 13 de novembro de 2026
- Link:
api-docs.deepseek.com/zh-cn/news/news261113 - Descrição: lista das capacidades disponibilizadas nesta ocasião e escopo de suporte dos modelos
Autor: equipe técnica da APIYI
Contato técnico: fale conosco pela página inicial do site APIYI; os parâmetros de interface e os preços mais recentes do DeepSeek Search / Fetch podem ser consultados no centro de documentação da APIYI