Nota do autor: partindo de um usage do Responses, recalculamos item a item a entrada normal, a leitura de cache e as gravações em cache do GPT-6.2 Sol, e depois explicamos como a vida útil do cache e o status da requisição alteram a fatura do mesmo fluxo de trabalho.
A cobrança do GPT-6.2 Sol pode ser recalculada com um método fixo. O usage no registro da requisição divide a entrada em quatro categorias mutuamente exclusivas: entrada normal, leitura de cache, gravação em cache de 30 minutos e gravação em cache de 12 horas. A saída forma outra categoria, e os tokens de raciocínio já estão incluídos nela. Multiplique o número de tokens de cada categoria pela tarifa correspondente e some; o resultado é o custo do modelo nesta requisição. Os custos de ferramentas são calculados separadamente.
Três condições alteram o resultado. A primeira é se o volume total de entrada de uma única requisição ultrapassa 272K; se ultrapassar, a requisição inteira passa a usar a tarifa de contexto longo. A segunda é a vida útil do cache e a quantidade real de acertos: o mesmo trecho de prefixo gravado como cache de 30 minutos ou de 12 horas tem pontos de equilíbrio diferentes. A terceira é o status da requisição; incomplete, novas tentativas e tarefas em segundo plano afetam a fatura total de um fluxo de trabalho.
A OpenAI lançou o GPT-6.2 Sol em 17 de novembro de 2026. O ID do modelo na API é gpt-6.2-sol, e ele pode ser chamado via Responses e Chat Completions; chamadas de função e ferramentas embutidas passam pelo caminho Responses. Este artigo usa como base os preços oficiais em dólar da OpenAI via conexão direta e também explica como esse modelo aparece na interface pública de preços do APIYI apiyi.com. Todos os exemplos de cálculo deste artigo se baseiam em uso sintético, não em uma fatura medida.
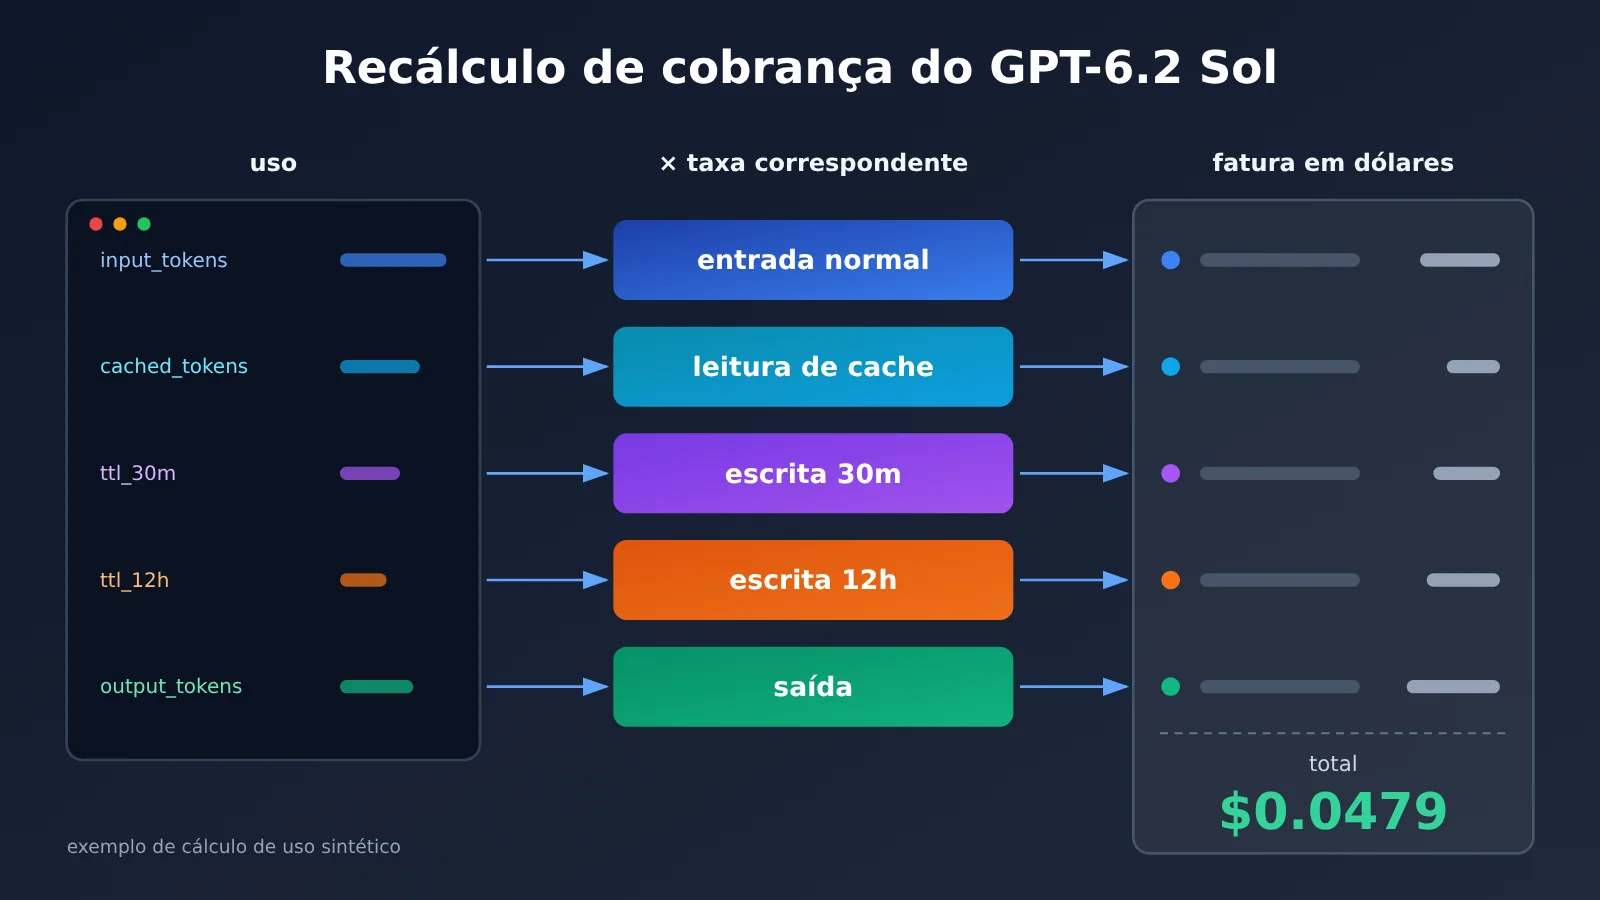
Mapa de conhecimento e ordem de leitura da cobrança do GPT-6.2 Sol
O texto todo segue a sequência «campos → valores → decisão de cache → conciliação do workflow». A saída de cada etapa é a entrada da próxima: primeiro identificamos quais itens existem no usage, depois os convertemos em dólares, em seguida usamos esse cálculo para comparar estratégias de cache e, por fim, somamos requisições individuais no custo total do workflow.
usage do Responses
 ├─ total de entrada input_tokens
 │   ├─ leitura de cache cached_tokens ──────────┐
 │   ├─ gravação 30m ttl_30m_tokens ─────────────┤
 │   ├─ gravação 12h ttl_12h_tokens ─────────────┼─→ × taxa correspondente → custo do modelo por requisição (seção 2)
 │   └─ entrada normal = total − leituras − todas as gravações ┤
 └─ saída output_tokens (inclui reasoning_tokens) ┘
                                          ↓
         escolha da vida útil do cache (seção 3) ← comparação do preço total de várias requisições com o mesmo prefixo
                                          ↓
         conciliação do workflow (seção 4) ← custo de ferramentas + retries + incomplete + exportação de custos
| Nº | Pergunta respondida | Depende do conteúdo da seção anterior | O que dá para fazer depois de ler |
|---|---|---|---|
| 1 | Quais números do usage entram na cobrança | — | Separar de uma resposta os cinco itens de uso cobrados |
| 2 | Quanto valem esses volumes de uso | Os cinco itens de uso da seção 1 | Converter os números do log em dólares e identificar se está na faixa curta ou longa |
| 3 | Gravar o cache por 30 minutos ou por 12 horas | O cálculo de preço unitário da seção 2 | Escolher a vida útil do cache conforme o intervalo entre chamadas e o número de acertos |
| 4 | Quanto custou, no fim das contas, uma tarefa | A apuração por requisição das seções 2 e 3 | Montar uma tabela de log mínima e rastrear a diferença na fatura |
Se você só quer entender uma diferença de cobrança, basta ler as seções 1 e 2. Já quem responde pela estratégia de cache ou pelo controle de custos deve ler as quatro seções em ordem.
Termos de cobrança do GPT-6.2 Sol que você precisa conhecer
| Termo | Explicação |
|---|---|
| usage | Campo na resposta da API que resume o uso de tokens da requisição atual |
| Entrada normal | A quantidade restante após deduzir do total de entrada as leituras de cache cobradas e todas as gravações de cache |
| Leitura de cache | A parte da entrada desta requisição cobrada pelo preço de reutilização |
| Ponto de quebra de cache | Limite que permite ao cache salvar ou reutilizar o prefixo de entrada |
| TTL | Configuração do tempo mínimo de cobertura de cobrança do cache; o Sol oferece dois tipos de escrita: 30 minutos e 12 horas |
| tokens de raciocínio | Tokens gerados pelo modelo na fase de pensamento e incluídos no total de saída cobrado |
| ID de resposta | Identificador que associa os logs de conciliação, a consulta em segundo plano e a resposta correspondente do modelo |
| Taxa de ferramenta | Custo separado gerado pelo uso de ferramentas hospedadas específicas |
1 Como encontrar os cinco itens de cobrança do GPT-6.2 Sol no usage do Responses
1.1 Quatro tipos de entrada e um tipo de saída
O objeto usage do Responses registra separadamente a entrada e a saída de uma requisição. Do lado da entrada, ele informa o total e alguns detalhamentos; do lado da saída, informa o total e o subitem de raciocínio. Na hora de recalcular a fatura, é nesses campos que você precisa olhar:
| Categoria de cobrança | Campo lido | Descrição |
|---|---|---|
| Entrada total | usage.input_tokens |
Soma das quatro categorias de entrada; esse valor não é multiplicado diretamente pela tarifa |
| Leitura de cache | input_tokens_details.cached_tokens |
Volume de leitura do ponto de vista da cobrança |
| Total de escrita em cache | cache_write_tokens |
Soma das escritas dos dois TTLs |
| Escrita de 30 minutos | cache_write_tokens_details.ttl_30m_tokens |
Usado quando o detalhamento por TTL é retornado |
| Escrita de 12 horas | cache_write_tokens_details.ttl_12h_tokens |
Usado quando o detalhamento por TTL é retornado |
| Saída | usage.output_tokens |
Já inclui os tokens de raciocínio |
| Subitem de raciocínio | output_tokens_details.reasoning_tokens |
Serve para entender a composição da saída, não é cobrado à parte |
1.2 Fórmula de cálculo da entrada comum
A entrada comum não tem um campo próprio dentro do usage; é preciso chegar nela por subtração:
Entrada comum = input_tokens − cached_tokens − cache_write_tokens
O que se subtrai aqui é todas as escritas, ou seja, a soma das escritas de 30 minutos e de 12 horas. As duas formas de escrita, a leitura e a entrada comum são mutuamente exclusivas: um mesmo token cai em apenas uma dessas categorias. Os tokens gravados no cache são cobrados pela tarifa de escrita e não voltam a ser cobrados pela tarifa de entrada comum. É justamente aqui que se erra com mais frequência: se você deixar o volume de escrita dentro da entrada comum e ainda cobrar a taxa de escrita em separado, o total fica inflado.
O token de raciocínio do lado da saída também é fácil de contar duas vezes. reasoning_tokens é um subconjunto de output_tokens; para recalcular, basta multiplicar output_tokens pela tarifa de saída. O subitem de raciocínio serve para analisar “por que esta saída ficou tão grande”, não como item de cobrança adicional.
1.3 Para recalcular, use os campos de cobrança; campos de diagnóstico servem só para investigar
Nas informações de diagnóstico do Prompt Caching também aparecem números como “volume reutilizável” e “estimativa de não acerto”. Eles explicam por que o cache não acertou — por exemplo, porque o prefixo mudou ou porque o comprimento é insuficiente — mas não representam aquilo que de fato foi cobrado. Ao recalcular a fatura, use somente os campos de cobrança efetiva presentes no usage.
Se algum canal não retornar o detalhamento por TTL, ou não trouxer cache_write_tokens, não tente deduzir a fatura a partir dos campos ausentes. Nesse caso, vale o registro de cobrança do próprio canal. O exemplo de cálculo da próxima seção usa um usage sintético, com todos os campos preenchidos, para facilitar a demonstração do algoritmo completo.
2 Converta os números do log do GPT-6.2 Sol em dólares
2.1 Tabela oficial de tarifas Standard
A tabela abaixo segue o padrão de conexão direta oficial da OpenAI, em USD / milhão de tokens. O escalão curto ou longo é determinado pela quantidade total de entrada de cada requisição: ao ultrapassar 272K, a requisição inteira passa para a tarifa de contexto longo — entrada e todos os tipos de cache ×2, saída ×1,5.
| Categoria de cobrança Standard | Contexto curto (≤272K) | Contexto longo (>272K) |
|---|---|---|
| Entrada normal | $2,00 | $4,00 |
| Leitura de cache | $0,10 | $0,20 |
| Escrita de cache de 30 minutos | $2,50 | $5,00 |
| Escrita de cache de 12 horas | $5,00 | $10,00 |
| Saída (já inclui tokens de raciocínio) | $10,00 | $15,00 |
O preço base do contexto curto é o mesmo do GPT-6.1 Sol. Além disso, o model card informa uma janela de contexto de 1.050.000 tokens, entrada máxima de 922.000 tokens e saída máxima de 128.000 tokens. “Quanto dá para inserir no máximo” e “a partir de onde começa a cobrança pelo escalão longo” são dois números independentes: uma requisição com 300K de entrada é perfeitamente válida, mas será cobrada inteira pelo escalão longo.
2.2 Recálculo completo do usage sintético
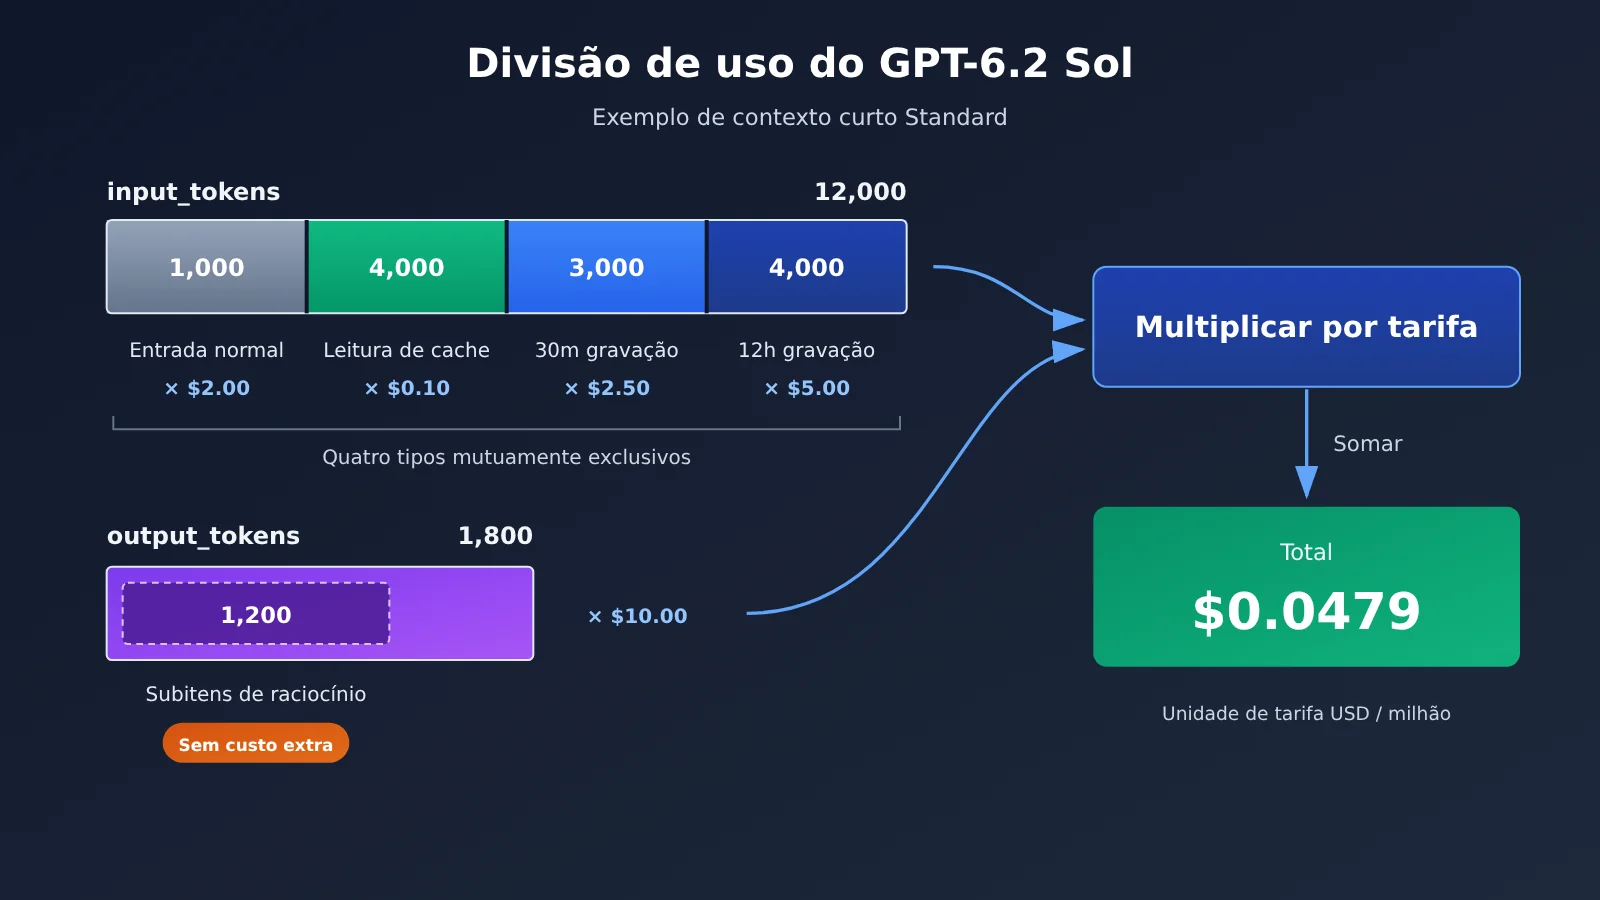
Suponha que uma requisição Standard de contexto curto retorne os seguintes usos, sem uso de ferramentas e sem sobretaxas: total de entrada 12.000, leitura de cache 4.000, gravação de 30 minutos 3.000, gravação de 12 horas 4.000, saída 1.800 (dos quais 1.200 de raciocínio).
Primeiro, obtemos a entrada comum: 12.000 − 4.000 − 3.000 − 4.000 = 1.000. Depois, multiplicamos cada item pela tarifa:
| Item de cobrança | Quantidade de tokens | Tarifa (USD/milhão) | Valor (USD) |
|---|---|---|---|
| Entrada comum | 1.000 | 2,00 | 0,0020 |
| Leitura de cache | 4.000 | 0,10 | 0,0004 |
| Gravação de 30 minutos | 3.000 | 2,50 | 0,0075 |
| Gravação de 12 horas | 4.000 | 5,00 | 0,0200 |
| Saída (inclui 1.200 de raciocínio) | 1.800 | 10,00 | 0,0180 |
| Total | — | — | 0,0479 |
Nessa conta, a gravação de 12 horas representa apenas 4.000 tokens, mas responde por mais de 40% do valor. O motivo é que seu preço unitário é 2,5 vezes o da entrada comum: no momento da gravação há somente custo, e o retorno só se concretiza quando o cache for acertado depois. A seção 3 vai tratar disso em detalhe.
Recomendo que o registro de custos guarde, para cada item de cobrança, a quantidade de tokens e a tarifa separadamente, em vez de armazenar apenas um valor total. Assim, ao surgir uma divergência de custo, basta substituir os valores reais do log na tabela acima e localizar linha por linha a origem da diferença.
2.3 Contexto longo: primeiro troque as tarifas, depois aplique a mesma fórmula
Quando o total de entrada passa de 272K, o algoritmo não muda: basta trocar a coluna inteira de tarifas da tabela acima pelos valores de contexto longo. Atenção: a troca vale para a requisição inteira, e a leitura e a escrita de cache também dobram na mesma proporção, enquanto a saída é cobrada em 1,5×. Por isso, a decisão entre faixa curta e faixa longa precisa ser tomada antes de multiplicar item a item.
Ao chamar por canais de terceiros, as tarifas precisam ser trocadas pela referência desse canal. Tomando a APIYI apiyi.com como exemplo, relendo sua interface pública de preços em 2026-11-20, o billing_expr do gpt-6.2-sol também muda de faixa em 272.000 tokens de entrada: na faixa curta, entrada normal $2, leitura de cache $0.10, escrita de cache $2.50, saída $10; na faixa longa, respectivamente $3, $0.15, $3.75, $11.25 (USD / milhão de tokens). Dá para ver que o multiplicador da faixa longa é diferente do oficial direto, e a expressão da interface também lista só um preço de escrita de cache. O agrupamento, as funcionalidades e a cobrança do projeto real ficam por conta da configuração e da fatura vigentes na plataforma.
O código abaixo faz uma requisição Responses pela interface compatível com OpenAI da APIYI e imprime o usage exatamente como veio, para usar na recálculo depois:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatível com OpenAI da APIYI
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    input=[
        {"role": "developer", "content": "固定规则与公共资料(放在前部便于缓存复用)"},
        {"role": "user", "content": "本次请求的具体问题"},
    ],
    max_output_tokens=4000,
)

print(resp.id, resp.status)
print(resp.usage.model_dump())
Depois de obter o usage, use uma função para converter as cinco métricas de uso em valor em dinheiro. A tabela de tarifas fica como parâmetro; para alternar entre a referência oficial ou a do canal, basta mudar a configuração:
Ver a função completa de recálculo
LONG_THRESHOLD = 272_000

# Padrão oficial Standard da OpenAI, USD / milhão de tokens
OFFICIAL_RATES = {
    "short": {"input": 2.00, "cached": 0.10, "w30m": 2.50, "w12h": 5.00, "output": 10.00},
    "long":  {"input": 4.00, "cached": 0.20, "w30m": 5.00, "w12h": 10.00, "output": 15.00},
}

def _get(d, *keys, default=None):
    for k in keys:
        if not isinstance(d, dict) or k not in d:
            return default
        d = d[k]
    return d

def recalc_cost(usage: dict, rates: dict = OFFICIAL_RATES) -> dict:
    total_in = usage["input_tokens"]
    details = usage.get("input_tokens_details") or {}
    cached = details.get("cached_tokens", 0) or 0

    # A localização dos campos de escrita depende da estrutura real de retorno; aqui consultamos os dois lugares
    write_total = details.get("cache_write_tokens", usage.get("cache_write_tokens"))
    ttl = details.get("cache_write_tokens_details") or usage.get("cache_write_tokens_details")
    if write_total is None:
        raise ValueError("缺少 cache_write_tokens,改用渠道出账记录,不要推定")
    w30 = _get(ttl, "ttl_30m_tokens")
    w12 = _get(ttl, "ttl_12h_tokens")
    if write_total and (w30 is None or w12 is None):
        raise ValueError("缺少写入寿命明细,无法区分 30m/12h 费率")
    w30, w12 = w30 or 0, w12 or 0

    plain = total_in - cached - write_total
    output = usage["output_tokens"]
    tier = "long" if total_in > LONG_THRESHOLD else "short"
    r = rates[tier]

    items = {
        "plain_input": plain * r["input"] / 1e6,
        "cache_read": cached * r["cached"] / 1e6,
        "write_30m": w30 * r["w30m"] / 1e6,
        "write_12h": w12 * r["w12h"] / 1e6,
        "output": output * r["output"] / 1e6,
    }
    items["tier"] = tier
    items["model_total"] = round(sum(v for k, v in items.items() if k != "tier"), 6)
    return items

# Validar com o usage sintético da seção 2.2
demo = {
    "input_tokens": 12000,
    "input_tokens_details": {
        "cached_tokens": 4000,
        "cache_write_tokens": 7000,
        "cache_write_tokens_details": {"ttl_30m_tokens": 3000, "ttl_12h_tokens": 4000},
    },
    "output_tokens": 1800,
    "output_tokens_details": {"reasoning_tokens": 1200},
}
print(recalc_cost(demo))  # model_total: 0.0479
A função lança erro imediatamente quando falta um campo, em vez de tratar como 0. Isso evita calcular erroneamente uma requisição sem detalhes de escrita como “tudo como entrada comum”.
🎯 Dica técnica: Ao montar o registro de custos, recomenda-se primeiro validar a função de recálculo com um usage sintético e só depois conectar aos logs reais. Com a APIYI apiyi.com, você pode usar a mesma chave API para enviar requisições de teste com pouco tráfego, comparar item por item o usage retornado com a fatura da plataforma e só colocar as estatísticas em produção após confirmar o critério dos campos.
3 Como escolher a vida útil do cache do GPT-6.2 Sol conforme o ritmo de chamadas
3.1 A conta para duas e três visitas ao mesmo prefixo
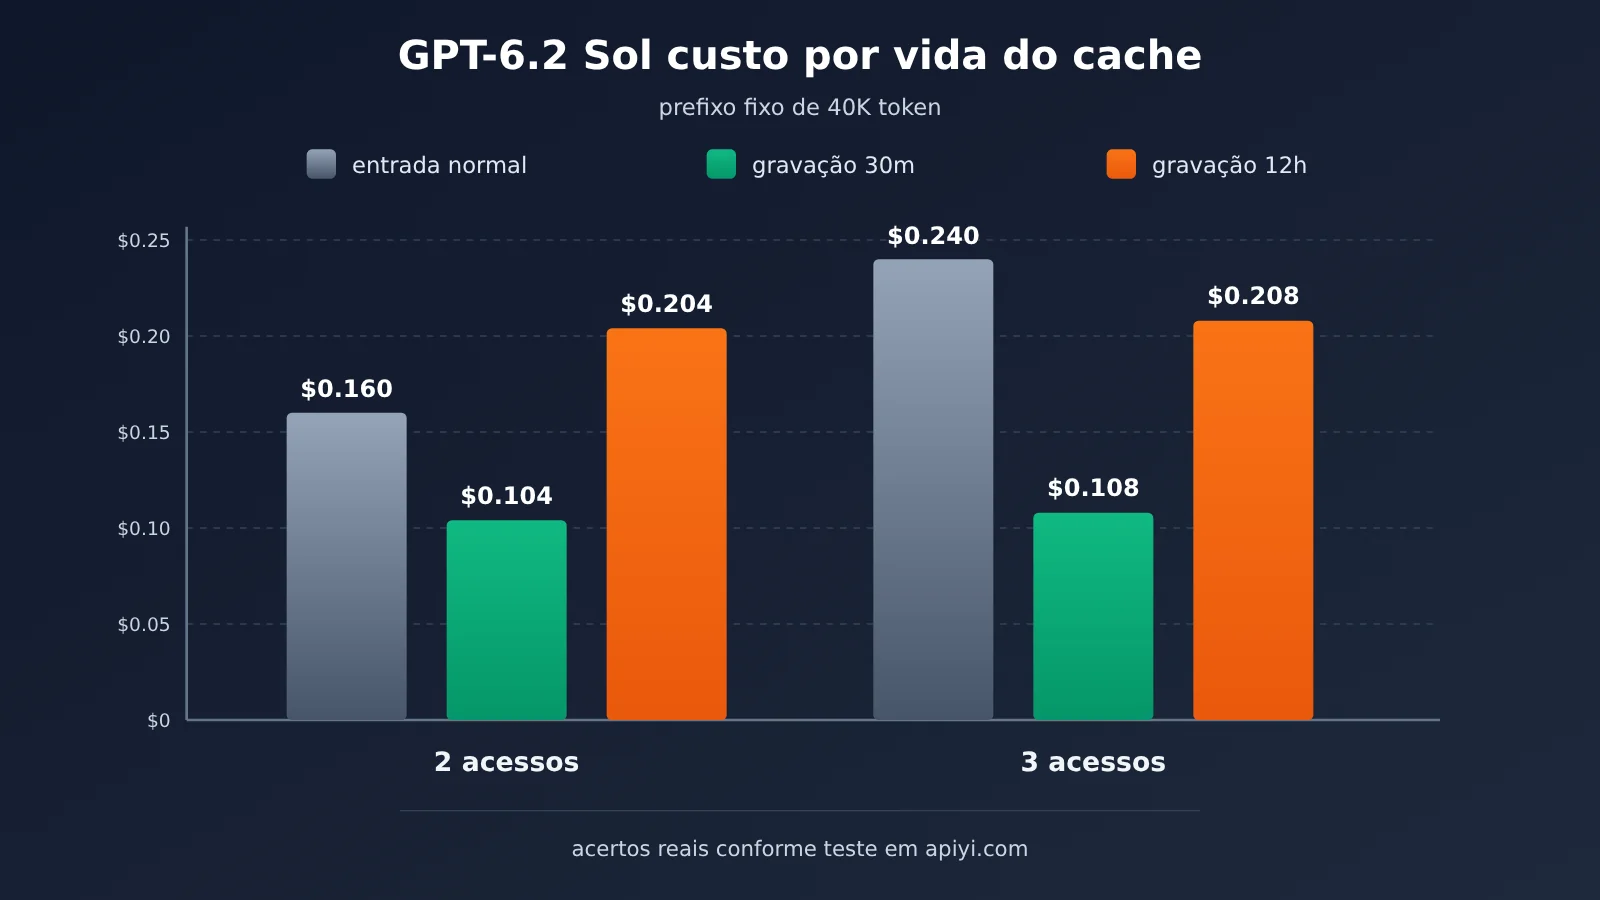
Suponha um prefixo fixo de 40.000 tokens (regras do sistema mais materiais públicos), com cobrança Standard de contexto curto. Os custos de cada tipo por chamada são: cada chamada como entrada comum custa $0.08; a primeira gravação de 30 minutos custa $0.10; a primeira gravação de 12 horas custa $0.20; uma leitura com acerto completo do cache custa $0.004. A tabela abaixo compara apenas a parte do prefixo fixo, sem incluir o conteúdo variável e a saída de cada requisição.
| Padrão de acesso | Entrada comum | Plano de gravação de 30m | Plano de gravação de 12h |
|---|---|---|---|
| Total de 2 chamadas (1 gravação + 1 leitura) | $0.160 | $0.104 | $0.204 |
| Total de 3 chamadas (1 gravação + 2 leituras, todas dentro da janela) | $0.240 | $0.108 | $0.208 |
Em duas chamadas, a gravação de 12 horas custa $0.044 a mais do que não usar cache. Em três chamadas, os dois tipos de cache ficam mais baratos que a entrada comum, mas o plano de 30 minutos ainda custa cerca da metade do plano de 12 horas. Isso vale desde que todas essas chamadas ocorram dentro da janela de 30 minutos.
3.2 Ponto de equilíbrio: quantos acertos para recuperar o custo
Olhar para os números acima por outro ângulo deixa tudo mais intuitivo (as estimativas abaixo usam as tarifas do M3). Cada acerto completo economiza US$ 0,076 em relação a uma entrada normal. A escrita de 30 minutos custa US$ 0,02 a mais que uma entrada normal — basta um acerto para se pagar. A escrita de 12 horas custa US$ 0,12 a mais e precisa de pelo menos dois acertos dentro da janela para se pagar.
Então o valor da escrita de 12 horas não está em “acertar mais vezes na mesma janela”, e sim em ainda conseguir acertar quando o intervalo entre chamadas passa de 30 minutos. Se duas requisições consecutivas com o mesmo prefixo normalmente chegam em questão de minutos, a escrita de 30 minutos já basta — escolher 12 horas só vai fazer você pagar mais pela escrita. Já se as requisições chegam a cada uma ou duas horas, o cache de 30 minutos já expirou faz tempo e você precisa reescrever toda vez; nesse caso, a escrita de 12 horas combinada com vários acertos é que pode sair mais barata.
Há ainda dois pontos que mudam a avaliação. O TTL é o tempo mínimo coberto pela cobrança, não significa que o cache vá necessariamente sobreviver tanto tempo — no fim das contas, o que importa é o volume real de leitura reportado no usage. A escrita de 30 minutos tem regras de renovação na leitura, então em cenários de alta frequência a cobertura real pode ser maior que os 30 minutos nominais. Por isso, depois de escolher a configuração, volte e confira com os registros reais de acerto, em vez de olhar só para a configuração.
3.3 Posicionamento dos breakpoints: conteúdo estável vem primeiro
O cache só funciona no prefixo, e o menor prefixo cacheable é de 1.024 tokens de entrada visíveis. Na prática, dá para distribuir os breakpoints em camadas conforme o ciclo de reutilização:
- Material público de ciclo longo, como manuais de produto e resumos de repositórios de código: deixe no início e considere gravação de 12 horas.
- Registros de sessão de ciclo curto, como o histórico da conversa atual: deixe logo depois e considere gravação de 30 minutos.
- Instruções pontuais que mudam a cada vez: deixe no final, sem entrar no cache.
O GPT-6.2 tem um detalhe de posicionamento que é fácil de errar: o campo instructions de nível superior fica depois do ponto de cache. Se você colocar regras fixas em instructions, essa parte não poderá ser reaproveitada. Regras fixas se encaixam melhor em uma mensagem developer no início do input, deixando instructions para o conteúdo que pode ser ajustado a cada requisição.
💡 Sugestão de escolha: o tempo de vida do cache deve ser definido com base no tráfego real. Recomendo primeiro enviar algumas rodadas de requisições no APIYI apiyi.com com o mesmo prefixo, no ritmo real de uso, e observar o acerto de
cached_tokens; depois disso, decidir qual camada usa 30 minutos e qual usa 12 horas. Diferentes canais podem ter preços distintos para gravação em cache, então vale considerar a cobrança da plataforma como referência.
4 Resumindo os custos do GPT-6.2 Sol por fluxo de trabalho e rastreando as diferenças
4.1 Três estados de requisição que fazem a fatura não bater com o esperado
Se uma única requisição foi calculada corretamente, o total do fluxo de trabalho ainda pode não fechar. As causas mais comuns vêm do estado da requisição:
- incomplete: quando a saída atinge
max_output_tokens, a resposta pode terminar comoincomplete. Nesse caso, pode ainda não haver nenhum texto visível, mas tokens de entrada e de raciocínio já foram gerados e cobrados. Se você só contabiliza as requisições de “conteúdo devolvido com sucesso”, esse custo fica de fora. - Tarefas em segundo plano: para tarefas em segundo plano que já têm um ID de resposta, acompanhe pelo mesmo ID durante o polling; não trate cada consulta como uma nova requisição e registre tudo em duplicidade.
- Retentativas: chamadas independentes disparadas novamente por timeout ou por
incompletegeram novas respostas e precisam de um lançamento separado. Quanto mais retentativas, mais vezes o custo de entrada de uma mesma tarefa é pago em dobro.
4.2 Taxas de ferramentas e os tokens subsequentes gerados pelas ferramentas
O Responses suporta ferramentas como busca em arquivos, busca na web, interpretador de código e geração de imagens. Ao usar geração de imagens, o Sol dispara uma chamada de ferramenta dentro do fluxo, a imagem é produzida por uma ferramenta de imagem separada, e o custo também é calculado pelas regras da ferramenta. Confira as taxas de ferramenta pelo tipo real — por exemplo, a busca na web é cobrada a US$ 10 por mil chamadas, e os tokens do conteúdo retornado pela busca são cobrados à parte, pela tarifa do modelo.
Na reccontabilização, confirme quais tokens o usage cobre. Quando o resultado da ferramenta volta para a próxima rodada de requisições ao modelo, ele aparece como aumento do volume de entrada das requisições seguintes; esse custo cai sobre as requisições seguintes, não sobre a chamada de ferramenta em si. Um fluxo de trabalho com busca costuma ter a fatura composta por duas partes: “taxa por número de chamadas de ferramenta + tarifa das múltiplas rodadas de requisições ao modelo”.
4.3 Itens mínimos de log
Para que o fluxo de trabalho seja conciliável, cada resposta do modelo deve registrar, no mínimo, os seguintes campos:
| Item de log | Função |
|---|---|
| ID do fluxo de trabalho | Agrupar várias requisições na mesma tarefa |
| ID de resposta | Relacionar o polling em segundo plano, distinguir retentativas da mesma requisição |
| Modelo | Determinar a tabela de tarifas, como gpt-6.2-sol |
| Faixa de serviço | Confirmar se o critério é o Standard |
| Estado final | Identificar completed, incomplete, etc. |
| Detalhamento de uso | Entrada comum, leitura, gravação de 30m, gravação de 12h, saída, raciocínio |
| Ferramenta | Tipo de ferramenta e número de chamadas |
| Custo | Valor recalculado por item e marcação de faixa longa/curta |
Com essa tabela, basta agrupar por ID do fluxo de trabalho e somar para obter o custo de uma única tarefa. A investigação de diferenças também ganha uma ordem: primeiro verifique se há incomplete e retentativas, depois se a leitura de cache está abaixo do esperado, e por fim confira o número de chamadas de ferramentas.
4.4 Estimar requisição por requisição e cruzar com a exportação oficial
A estimativa requisição por requisição serve bem para controle de orçamento em tempo real, mas tende a desviar em casos de chamadas de ferramentas em várias etapas, retentativas ou campos de uso faltando. Recomenda-se comparar periodicamente o resumo das estimativas com a exportação oficial de uso ou de custos, e, quando a diferença ultrapassar o limite definido, voltar aos logs e conferir linha por linha. Ao usar um canal de terceiros como intermediário, o objeto de comparação deve passar a ser os campos de faturamento e as tarifas desse canal.
💰 Sugestão de custo: se a equipe usa vários modelos ao mesmo tempo, dá para chamar tudo com uma única chave API pelo APIYI (apiyi.com) e gravar no banco conforme os itens mínimos de log deste artigo. Uma entrada unificada mantém o ID do fluxo de trabalho e o critério de custo consistentes, e na hora da conciliação de fim de mês você economiza uma camada de conversão de canal.
Método de verificação da fatura do GPT-6.2 Sol
Com qualquer registro de requisição do Sol em mãos, você pode verificar a fatura nesta ordem: primeiro confirme se o total de entrada passa de 272K e escolha a coluna de tarifa correspondente; depois subtraia de input_tokens as leituras e todas as escritas para obter a entrada comum; em seguida multiplique os cinco itens pelas respectivas tarifas e some tudo, comparando com a fatura. Se a conta fecha para uma requisição isolada mas não para o total do fluxo de trabalho, vá até os logs e procure por incomplete, retentativas e chamadas de ferramentas.
Se o cache compensa ou não depende, no fim das contas, do volume real de leitura no usage e do intervalo entre chamadas. A escrita de 30 minutos se paga com um único acerto; a de 12 horas exige pelo menos dois acertos dentro da janela, e só mostra vantagem quando o intervalo entre chamadas passa de 30 minutos.
Se você quiser validar essas conclusões com tráfego real, pode solicitar uma cota de teste gratuita na APIYI apiyi.com e usar a função de recálculo deste artigo para conferir item por item a fatura da plataforma.
📚 Referências
-
Anúncio de lançamento do OpenAI GPT-6.2 Astra e Sol: data de lançamento e posicionamento do produto
- Link:
openai.com/index/introducing-gpt-6-2-astra-sol - Descrição: entenda o posicionamento do Sol voltado ao trabalho diário e a Agentes de múltiplas etapas
- Link:
-
Ficha do modelo GPT-6.2 Sol: especificação da janela de contexto, tarifas e multiplicador de contexto longo
- Link:
developers.openai.com/api/docs/models/gpt-6.2-sol - Descrição: fonte da tabela de tarifas e da regra de faixa de 272K usada neste artigo
- Link:
-
Guia de Prompt Caching e diagnóstico de cache: campos de cache, TTL e regras de ponto de quebra
- Link:
developers.openai.com/api/docs/guides/prompt-caching - Descrição: explica cached_tokens, tempo de vida da escrita e prefixo mínimo cacheável
- Link:
-
Guia de Reasoning: tokens de raciocínio e o estado incomplete
- Link:
developers.openai.com/api/docs/guides/reasoning - Descrição: entenda como o uso de raciocínio é contabilizado na saída
- Link:
-
Guia de controle de custo por execução de fluxo de trabalho: agregar o custo de Responses por fluxo de trabalho
- Link:
developers.openai.com/cookbook/articles/per_run_spending_controller_responses_api - Descrição: implementação de referência para controle de orçamento em nível de fluxo de trabalho
- Link:
-
Tabela geral de modelos do APIYI: canais disponibilizados e informações de entrada
- Link:
docs.apiyi.com/models.md - Descrição: veja as entradas disponíveis e os grupos do gpt-6.2-sol
- Link:
Autor: Equipe técnica da APIYI
Contato técnico: fique à vontade para falar com a gente pela página inicial da APIYI apiyi.com; mais materiais de integração estão disponíveis no centro de documentação docs.apiyi.com