한 문장 요약: 매일 뉴스를 검색하고, 주제를 고르고, 백오피스에 입력하는 똑같은 작업에서도 어떤 AI Agent는 곧바로 업무를 넘겨받는 쪽에 더 잘 맞고, 어떤 AI Agent는 먼저 자동화 시스템을 구축하는 쪽에 더 잘 맞아요. 진짜 분수령은 도구, 권한, 그리고 실행 환경이에요.
이 글은 검증 날짜가 2026년 11월 12일인 참고 자료를 바탕으로 역량을 비교한 내용이며, 여기서 통일한 과제는 하나의 가상 시나리오일 뿐, 아홉 개 제품을 같은 과제로 실제 테스트한 결과가 아니에요. 글에서는 성공률이나 소요 시간, 종합 순위를 제시하지 않고, 요금제·지역·기능 진입점은 여전히 실제 계정에서 확인해야 해요.
먼저 이해해야 할 AI Agent 비교 속 실제 용어들
AI Agent는 답변만 생성하는 모델이 아니라, 목표를 중심으로 도구를 호출하고 결과를 읽고 다시 실행을 이어가는 작업 시스템이에요. 콘텐츠 운영에 적용해 보면, 단지 “기획을 쓸 줄 아는” 정도를 넘어 검색 진입점, 백오피스 권한, 그리고 내일 다시 시작할 수 있는 환경까지 필요해요.
| 용어 | 이 업무에서의 의미 | 무엇을 뜻하지 않는가 |
|---|---|---|
| 로컬 작업 | 내 컴퓨터나 연결된 로컬 환경에서 자료를 정리하고 소프트웨어를 조작해요 | 전원을 끄고도 계속 실행되는 건 아니에요 |
| 클라우드 작업 | 원격 환경에서 검색하고 자료를 처리하며 작업을 실행해요 | 전원이 꺼진 컴퓨터의 파일을 자동으로 읽어 주는 건 아니에요 |
| 정기 작업 | 매일 지정된 시간에 뉴스 워크플로우를 트리거해요 | 상시 온라인 상태의 실행 환경이 반드시 보장된다는 뜻은 아니에요 |
| 브라우저 조작/Computer Use | 전자는 웹페이지를 클릭하고 폼을 입력하며, 후자는 그래픽 인터페이스를 통해 앱을 사용해요 | 웹 검색이 곧 데스크톱 제어라는 뜻은 아니에요 |
| API/MCP | API는 프로그램이 모델이나 업무 시스템을 호출하게 해주고, MCP는 외부 도구와 데이터를 연결해요 | 인터페이스를 얻었다고 업무 권한까지 자동으로 얻는 건 아니에요 |
| 하위 Agent | 특정 뉴스 한 건을 찾거나 자료 한 건을 검증하는 독립 또는 제한된 단위를 배정해요 | 병렬로 많이 돌린다고 결과가 반드시 더 신뢰할 수 있는 건 아니에요 |
이런 차이가 뒤에 나오는 선택을 결정해요. 특히 기억해야 할 점은 모델 API, Agent 제품 구독, 실행 환경은 서로 다른 세 가지라는 거예요. 그중 하나를 구매했다고 해서 나머지 두 가지까지 이미 갖춰졌다고 가정할 수 없어요.
9가지 AI Agent에게 같은 작업을 맡겨 보기
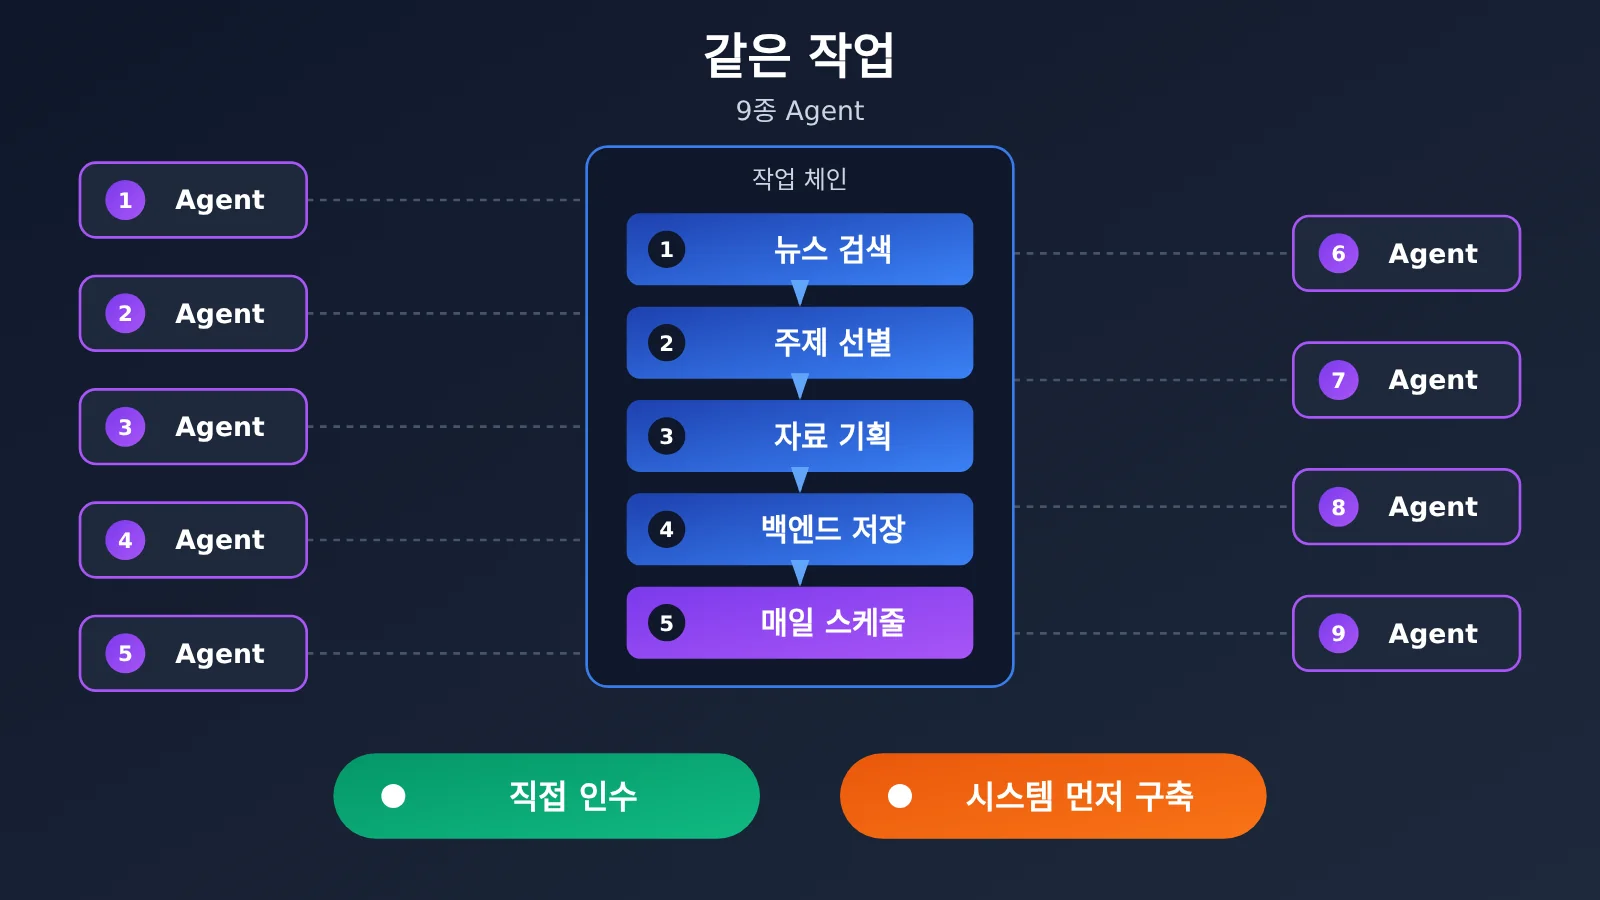
여러분이 각 제품에 똑같은 요구 사항을 던진다고 가정해 봐요. “매일 오전 9시에 최신 AI 뉴스를 검색하고, 쓸 만한 주제 5개를 골라 각 주제의 공식 자료와 기사 기획을 정리한 다음, 회사 콘텐츠 백엔드를 열어 필드를 채우고 초안으로 저장해 주세요.”
추가 조건은 매일 작업을 다시 지시할 필요가 없어야 하고, 로그인이나 승인, 저장이 실패했을 때 합리적으로 처리해야 한다는 거예요. 여기서는 ‘초안 저장’을 종착점으로 삼고 자동 발행은 하지 않아요. 첫 번째 검증 단계에 콘텐츠 심사 권한을 섞이지 않게 하려는 거죠.
| 작업 단계 | 전달할 것 | 주요 검수 포인트 |
|---|---|---|
| 뉴스 검색 | 뉴스 목록과 출처 | 게시 날짜, 수정 날짜, 재게시를 구분하는지 |
| 주제 선별 | 주제 5개와 추천 이유 | 중복을 제거했는지, 대상 독자에게 적합한지 |
| 자료 준비 | 사실, 공식 출처, 확인 대기 항목 | 추론을 사실로 적어 두지 않았는지 |
| 기획 생성 | 제목, 요약, 구조, 작성 경계 | 기업 템플릿에 부합하는지 |
| 백엔드 저장 및 익일 실행 | 초안 기록, 결과 알림, 예약 설정 | 실제로 저장되는지, 내일 실행할 환경이 있는지 |
이 작업은 최소한 연구, 콘텐츠 생성, 업무 처리, 스케줄링이라는 네 단계를 넘나들어요. 어떤 제품이 앞의 세 단계를 끝낸다고 해서 회사 웹사이트에 로그인할 수 있다는 뜻은 아니고, 오늘 저장한다고 해서 내일 자동으로 다시 실행된다는 보장도 없어요.
어떤 AI Agent가 콘텐츠 업무를 바로 맡기에 더 적합할까요?
오늘 바로 콘텐츠 주제와 기획안을 받고 싶다면 ChatGPT Work, Claude Cowork, Kimi Work부터 살펴보세요. DeepSeek Harness와 Kimi Claw도 함께 활용할 수 있지만, 전자는 실행 시스템을 갖춰야 하고 후자의 강점은 주로 클라우드 호스팅과 채널 전달에 있어요.
| AI Agent | 통합 업무에 대한 공개 역량 적합도 | 시작 전 확인할 점 |
|---|---|---|
| ChatGPT Work | 자료 조사, 업무 결과물 생성; 인수인계 자료에 클라우드 브라우저와 폼 조작 기능이 언급됨 | 계정 접근 경로, 로그인 지원, 주요 확인 절차, 웹사이트 접근 조건 |
| Claude Cowork | 여러 파일에 걸친 조사, 보고서 생성, 커넥터, 브라우저 및 예약 작업 | 자격 요건을 충족하는 요금제, 도구 권한, 로컬 자료의 데스크톱 앱 의존 여부 |
| Kimi Work | 로컬 파일 정리, 문서 생성, 브라우저 및 데스크톱 작업 | 데스크톱 환경, 플러그인, 권한; 로컬 작업 실행 시 컴퓨터가 켜져 있어야 함 |
| DeepSeek Harness | 연구, 파일 처리, 맞춤형 워크플로 | 모델, 검색 도구, 브라우저 제공자, 승인 및 배포 환경 |
| Kimi Claw | OpenClaw 클라우드 호스팅, 검색·정리 후 연결된 채널로 전달 | 채널 권한, 기업 백오피스에 필요한 도구 또는 API |
ChatGPT Work는 ‘연구와 사무 작업을 맡긴다’는 사용 방식에 더 가깝습니다. 다만 관련 링크가 이번 자료 검토 과정에서 403을 반환했기 때문에, 이 글은 인수인계 자료의 역량 설명을 따르고 있어요. 이를 이번에 독립적으로 검증하는 데 성공했다고 보지 않으며, 따라서 이를 근거로 회사 백오피스에서 접근하거나 저장할 수 있다고 약속할 수도 없습니다.
Claude Cowork도 지식 업무 결과물을 직접 넘겨받는 쪽에 가깝습니다. 자료에 따르면 2026년 10월 6일부터 나열된 자격 요건을 충족하는 Pro, Max, Ultra 요금제의 새 작업은 클라우드에서 실행돼요. 그러나 승인된 로컬 파일 접근은 여전히 데스크톱 앱과 기기 상태에 달려 있으므로, 클라우드 실행을 로컬 의존성이 사라졌다는 의미로 받아들이면 안 됩니다.
Kimi Work는 자료가 주로 컴퓨터에 저장되어 있고 로컬 오피스 소프트웨어를 조작해야 하는 상황에 더 알맞습니다. 베타 단계의 로컬 Agent이며, 데스크톱 제어에는 해당 Computer Use 설정이 필요해요. 제조사가 언급한 서브 Agent 수와 장시간 작업 소요 시간은 이 글에서 진행한 동시성이나 완료율 테스트 결과가 아닙니다.
DeepSeek Harness는 연구와 파일 작업을 처리할 수 있지만, 모든 도구가 기본으로 갖춰진 사무용 완제품은 아닙니다. 브라우저 조작에는 해당 구성 요소를 설치하고 실험적 제공자를 명시적으로 활성화해야 해요. 세션 복구도 브라우저 로그인 상태를 자동으로 되살리지 않으므로, 기업 백오피스 입력에 곧바로 영향을 줍니다.
Kimi Claw는 Kimi가 제공하는 OpenClaw 클라우드 호스팅 서비스이지, 처음부터 독립적으로 개발한 실행 프레임워크가 아닙니다. 뉴스를 계속 수집하고 콘텐츠 주제를 전달하는 데 알맞지만, 채팅 플랫폼에 연결했다고 해서 어떤 기업 웹사이트든 조작할 수 있는 건 아니에요. 백오피스에 저장하려면 여전히 해당 도구나 브라우저 기능, 또는 비즈니스 API가 필요합니다.
시작 가이드: 먼저 주제 하나로 자료 품질을 검증하고, 그다음 백오피스 저장을 검증하세요. 서로 다른 모델의 기획안 생성 결과를 비교해야 한다면 APIYI apiyi.com에서 모델 단계를 테스트할 수 있어요. 다만 이 테스트가 위 제품의 구독이나 백오피스 권한을 대신 확보해 주지는 않습니다.
어떤 AI Agent가 자동화 시스템을 먼저 구축하는 데 더 적합할까요?
작업이 매일 반복되어야 할 때, 초점은 “오늘 나 대신 페이지 클릭을 마쳐주는 것”에서 “프로세스를 고정하고 유지보수할 수 있게 만드는 것”으로 이동합니다. 이때 Codex, Claude Code, Antigravity, Kimi Code, DeepSeek Harness를 더 살펴볼 만합니다.
| AI Agent | 구축에 도움을 줄 수 있는 것 | 확장과 사용 경계 |
|---|---|---|
| Codex | 뉴스 수집, 중복 제거, 자료 생성, 백엔드 제출 및 테스트 프로그램 | CLI/Harness의 공개 코드와 모델 접근, 관리형 클라우드 서비스는 별개 |
| Claude Code | 코드, MCP, Hooks, Subagents를 통해 비즈니스 프로세스에 연결 | 상용 제품의 확장 인터페이스가 곧底层 엔진开源은 아님 |
| Antigravity | 병렬 개발, 브라우저 검증, 원격 작업과 자동화 | 선택 가능한 모델, Remote Agents와 스케줄링은 계정 및 환경 조건의 제약을 받음 |
| Kimi Code | CLI, 개발 인터페이스, 검색, MCP 등을 활용한 개발 및 유지보수 프로세스 | 임의의 기업 백엔드를 직접 인수하는 것을 주요 포지셔닝으로 하지 않음 |
| DeepSeek Harness | 모델 어댑터, 도구, 세션, 실행 루프 및 백엔드 메커니즘 커스터마이징 | MIT 開源, 여전히 Developer Preview이며 자체 구성과 유지보수가 필요 |
Codex, Claude Code, Antigravity의 가치는 단순히 수집 코드 한 단락을 생성하는 데 있지 않고, 프로젝트를 중심으로 파일을 수정하고, 명령을 실행하고, 테스트하며 문제를 수정할 수 있다는 점에 있습니다. Kimi Code 역시 이런 프로그램을 구축하고 유지보수하는 데 적합하지만, 백엔드 입력에는 추가로 인터페이스나 브라우저 도구를 연결해야 합니다.
DeepSeek Harness는 커스터마이징 수준이 더 깊습니다. 모델 어댑터, 도구 등록, 세션 기록, Agent Loop 모두 조정할 수 있습니다. 하지만 공식적으로 아직 보안 감사를 완료하지 않았음을 명확히 밝히고 있어, 생산 안전성을 갖춘 것으로 보아서는 안 되며, 격리 환경에서 최소 권한으로 먼저 검증하는 것을 권장합니다.
회사에서 안정적인 콘텐츠 API를 제공한다면, 매일 마우스 클릭에 의존하기보다 인터페이스 제출을 우선 검증할 수 있습니다. 이 제안은 API가 절대 변하지 않는다는 뜻이 아니라, 인터페이스가 통상 필드를 명확히 하고 반환 결과를 확인하며 실패 원인을 기록하기에 더 편리하다는 뜻입니다.
모델 계층에서는 APIYI apiyi.com을 고려할 수 있습니다. 플랫폼이 공개한 자체 설명에 따르면, 하나의 API 키로 OpenAI, Claude, Gemini 등 주요 모델에 접속할 수 있는 OpenAI 호환 인터페이스, 사용량 기반 과금과 신규 사용자 테스트 크레딧을 제공합니다. 구체적인 모델 가격과 혜택은 플랫폼 페이지를 기준으로 하며, 아홉 가지 Agent 모두가 해당 인터페이스로 직접 전환할 수 있다는 뜻은 아닙니다.
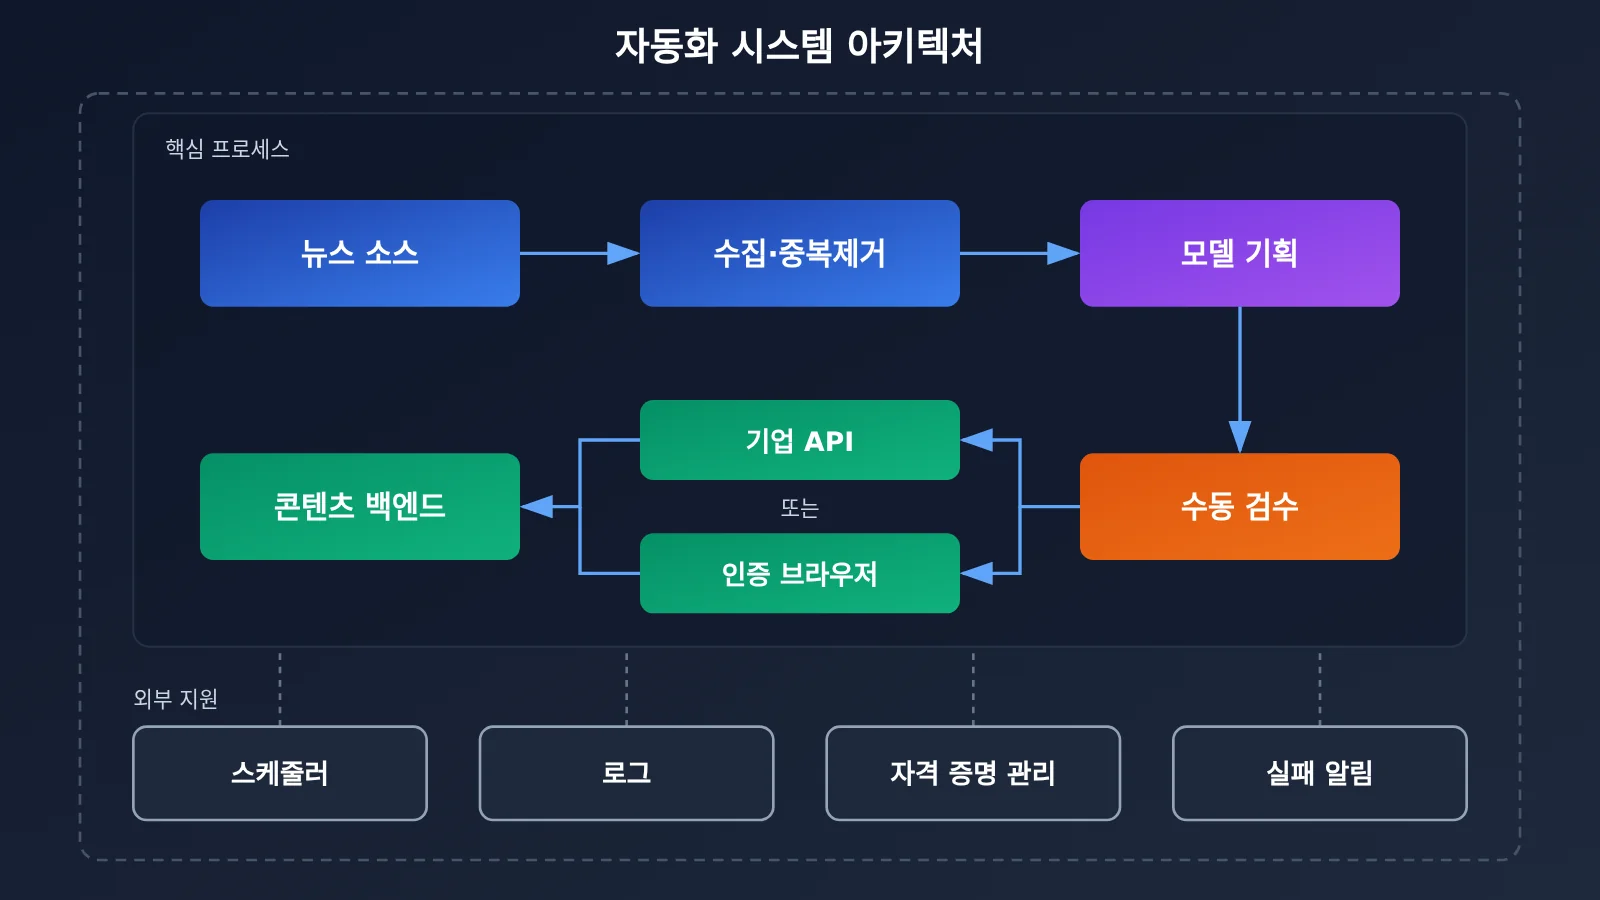
그림에서 모델 인터페이스는 하나의 구성 요소일 뿐입니다. APIYI apiyi.com을 통해 이 계층의 입력과 출력을 검증할 수 있지만, 검색, 로그인, 브라우저, 스케줄링과 실패 복구는 여전히 업무 시스템이 담당합니다.
AI 에이전트 비교의 핵심 분기점: 컴퓨터를 끄면 어떻게 될까요?
판단할 때는 두 가지 질문을 던져야 해요. “작업은 어디에서 실행되나요?” 그리고 “작업이 또 어떤 로컬 리소스에 의존하나요?” 원격 작업은 계속 실행될 수 있지만, 그렇다고 해서 이미 종료된 컴퓨터에 직접 접근할 수 있는 건 아니에요.
| AI 에이전트 | 컴퓨터를 끈 뒤 제출된 작업이 계속되는 조건 | 매일 반복 실행할 때의 핵심 제약 |
|---|---|---|
| ChatGPT Work | 인수인계 자료에 클라우드 작업이 계속될 수 있다고 설명됨 | 예약 진입점, 계정, 사용 도구 확인 필요 |
| Codex | Codex Cloud는 계속 실행 가능하지만, 로컬 CLI는 클라우드와 동일하지 않음 | 지속 스케줄링은 한 번의 클라우드 작업만으로 해결되지 않음 |
| Antigravity | 조건을 충족하는 Remote Agents는 계속 실행 가능 | 세션 내 스케줄링과 영구 자동화는 구분해야 함 |
| Claude Cowork | 명시된 자격 요건을 충족하는 요금제의 새 클라우드 작업은 계속 실행 가능 | 여전히 오프라인 컴퓨터의 로컬 파일을 읽을 수는 없음 |
| Claude Code | 별도의 원격 또는 호스팅 실행 환경이 있는지에 따라 달라짐 | 로컬 세션이 기본적으로 상시 실행 서비스가 될 수는 없음 |
| DeepSeek Harness | 별도로 지속 실행되는 배포 환경 필요 | 로컬 백그라운드 작업은 실행 중인 프로세스에 의존 |
| Kimi Work | 로컬 작업은 컴퓨터를 끈 뒤에도 계속되도록 의존할 수 없음 | 로컬 예약 실행에는 기기와 소프트웨어가 온라인 상태여야 함 |
| Kimi Code | 별도로 지속 실행되는 환경 필요 | 스케줄링 메커니즘을 구축하거나 연동해야 함 |
| Kimi Claw | 클라우드 호스팅 환경은 지속 실행 가능 | 도구 연결, 권한 부여, 할당량, 실패 처리는 여전히 구성해야 함 |
Antigravity의 /schedule은 일회성 및 Cron 예약 작업을 지원하지만, 세션 내에서 만든 작업은 해당 세션에 속해요. 장기간 독립적으로 실행되는 작업에는 영구 Sidecar나 다른 자동화 메커니즘이 필요하며, “예약 작업을 만들었다”는 사실만으로 “운영 라인이 이미 상시 가동 중”이라고 단정할 수는 없어요.
기업 백오피스가 회사 인트라넷을 통해서만 접근 가능하다면, 클라우드 실행은 규정을 준수하는 네트워크 접속 문제도 해결해야 해요. 웹사이트가 공용 인터넷에서 접근 가능하더라도 CAPTCHA, 로그인 만료, 작업 승인 같은 문제를 만날 수 있어요. 이는 기본적으로 우회되는 장애물이 아니라 검증이 필요한 조건이에요.
AI Agent 자동화에서 모델 검증 단계는 어떻게 설계할까요?
아래 두 코드는 “수집한 자료를 모델에 넘겨 기획을 생성하는” 부분만 보여줘요. 뉴스 검색, 기업 백오피스 저장, 정기 실행은 포함하지 않아요. 예제는 OpenAI Python SDK를 사용하고, 모델 이름과 키는 환경 변수에서 읽어 오며, 계정에서 실제로 사용할 수 있는 값을 넣어야 해요.
AI Agent 최소 모델 호출 예제
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["API_KEY"],
    base_url="https://api.apiyi.com/v1",
)
result = client.chat.completions.create(
    model=os.environ["MODEL_NAME"],
    messages=[{
        "role": "user",
        "content": "根据已提供的新闻资料生成选题策划;缺失事实标为待核实。",
    }],
)
print(result.choices[0].message.content)
AI Agent 자료 기획 래핑 예제
완전한 워크플로에서는 모델에게 “최신 뉴스를 써 달라”고만 요구하는 게 아니라 실제 출처 자료를 넘겨야 해요. 아래 래퍼는 증거의 경계를 프롬프트에 명시하고, 예외는 상위 프로세스가 처리하도록 남겨 두어 오류 텍스트가 정식 기획으로 잘못 저장되는 일을 막아요.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["API_KEY"],
    base_url="https://api.apiyi.com/v1",
    timeout=60.0,
)

def make_plan(source_text: str) -> str:
    if not source_text.strip():
        raise ValueError("Source material is required")

    response = client.chat.completions.create(
        model=os.environ["MODEL_NAME"],
        messages=[
            {
                "role": "system",
                "content": (
                    "你是内容策划助手。仅依据提供的资料,输出标题、摘要、"
                    "文章结构、来源清单和待核实项。不得补造数据。"
                ),
            },
            {"role": "user", "content": source_text},
        ],
    )
    text = response.choices[0].message.content
    if not text:
        raise RuntimeError("Empty model response")
    return text
이 두 코드는 텍스트 호출을 검증할 뿐, 도구 호출 프로토콜이나 MCP, 혹은 특정 Agent의 모델 어댑터가 이미 호환된다는 것까지 증명하지는 않아요. 실제 시스템에 연결할 때는 도구 호출, 오류 반환, 구조화된 결과, 권한 경계를 각각 따로 확인해야 해요.
AI Agent 시나리오 추천과 의사결정 단계
먼저 “기능이 가장 많은” 제품을 고르지 말고, 이 작업에서 가장 넘기 어려운 경계가 무엇인지부터 찾아야 해요. 이번 사례에서는 연구 품질, 백오피스 접근, 다음 날 자동 시작을 각각 따로 검증해야 해요.
- 오늘 바로 자료와 기획을 전달해야 한다면: ChatGPT Work, Claude Cowork, Kimi Work를 우선 검토하고, 먼저 단일 작업으로 진행하세요.
- 장기적인 콘텐츠 생산 프로세스를 구축해야 한다면: Codex, Claude Code, Antigravity, Kimi Code를 우선 검토하고, 인터페이스와 수용 기준을 명확히 하세요.
- 컴퓨터를 켜지 않아도 매일 주제를 받아야 한다면: Kimi Claw, ChatGPT Work, Claude Cowork의 클라우드 방식을 우선 검토하고, 계정과 도구 조건을 확인하세요.
- 운영 메커니즘을 깊이 교체해야 한다면: DeepSeek Harness를 검토하되, 먼저 격리 환경에서 검증하고 고권한 프로덕션 계정에는 바로 연결하지 마세요.
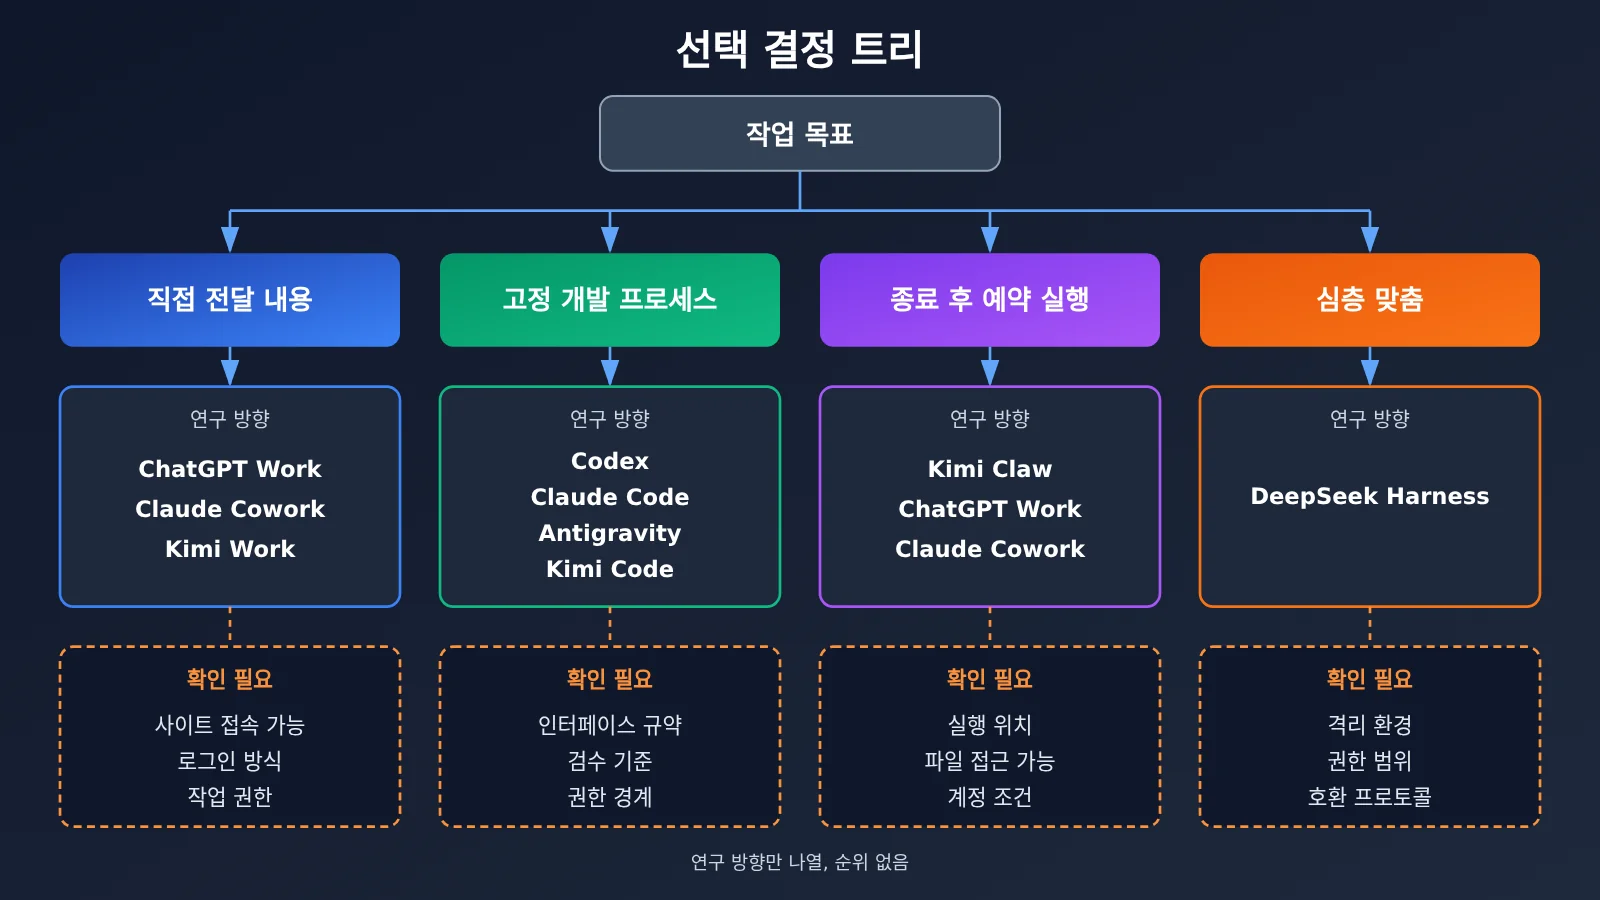
기업 백오피스에서 “주제 저장”을 “초안 제출”로 바꾸면, 브라우저 에이전트는 새 페이지에 맞춰 작업을 계속 시도할 수 있고, 개발형 에이전트는 자동화 프로그램을 점검하고 수정할 수도 있어요. 하지만 둘 다 오판할 수 있으므로 저장 결과 확인, 작업 로그, 필요한 경우 사람의 확인을 남겨 두어야 해요.
AI Agent 비교 자주 묻는 질문
AI Agent가 기획서를 작성할 수 있는데, 왜 전체 업무를 완수하지는 못하나요?
기획서 생성은 하나의 단계만 다룹니다. 검색, 로그인, 필드 매핑, 저장 확인, 예약 실행에는 각각 별도의 도구와 권한, 환경이 필요합니다.
API Agent 인터페이스가 9개 AI Agent 구독을 대체할 수 있나요?
아닙니다. APIYI(apiyi.com)가 제공하는 것은 모델 인터페이스 서비스이며, Work, Cowork, Remote Agents 또는 다른 제품의 구독 권한이 자동으로 포함되지 않습니다.
AI Agent를 통합 인터페이스에 연결한 후 모델을 마음대로 교체할 수 있나요?
직접 단정할 수 없습니다. APIYI(apiyi.com)로 테스트할 때도 해당 어댑터의 프로토콜, 도구 호출, 출력 형식을 검증해야 하며, Base URL만 바꿨다고 해서 전체 Agent가 사용 가능하다고 판단할 수 없습니다.
클라우드 AI Agent가 회사 백오피스에 접근할 수 있나요?
웹사이트 접근 가능 여부, 로그인 방식, 네트워크 조건, 운영 권한을 실제로 검증해야 합니다. 클라우드 브라우저를 갖고 있다고 해서 회사 백오피스 접근 권한까지 확보한 것은 아닙니다.
AI Agent에 예약 작업이 있다면 컴퓨터를 켜둘 필요가 없나요?
실행 위치에 따라 다릅니다. 로컬 예약 작업은 여전히 로컬 환경에서 실행되어야 하며, 클라우드 작업도 실제로 부여받은 파일과 도구만 사용할 수 있습니다.
AI Agent 비교에서 왜 종합 순위를 제공하지 않나요?
이번에는 통일된 실측을 진행하지 않았습니다. 실제로 테스트를 진행할 때는 작업 완료 여부, 수동 개입 횟수, 소요 시간, 실제 소비량, 실패 원인을 기록해야 하며, 기능 개수로 결과를 대체할 수 없습니다.
AI Agent 핵심 요점
- 직접 결과물을 전달하는 것과 시스템을 구축하는 것은 서로 다른 선택 목표예요.
- 웹 검색, 웹 조작, 데스크톱 제어는 반드시 구분해서 판단해야 해요.
- 클라우드에서 계속 실행된다고 해서 전원이 꺼진 컴퓨터의 파일을 읽을 수 있는 건 아니에요.
- 예약 실행 외에도 지속적으로 사용 가능한 실행 환경이 필요해요.
- 소스 코드와 확장 인터페이스가 공개됐다고 해서 호스팅 서비스 전체가 개방된 건 아니에요.
- 먼저 단일 초안 저장을 검증한 뒤 매일 자동 반복을 고려하세요.
AI Agent 비교 요약: 가장 어려운 단계부터 검증하기
이 뉴스 콘텐츠 작업에서는 Work·Cowork 계열 제품이 직접 결과물을 전달하는 방식부터 검증하기에 더 적합하고, 개발형 Agent는 반복 실행 가능한 프로그램을 구축하는 데 더 적합해요. Kimi Claw는 클라우드 호스팅 자동화에 치중하고, DeepSeek Harness는 더 깊은 수준의 실행 시스템 커스터마이징 공간을 제공해요.
다음 단계는 같은 프롬프트를 아홉 개 제품에 보내 승부를 선언하는 것이 아니라, 먼저 실제 뉴스 하나, 기획 템플릿 하나, 권한이 낮은 테스트 백오피스 하나를 준비하는 거예요. 모델 계층의 효과를 비교해야 할 때는 APIYI apiyi.com을 통해 검증한 뒤 검색, 저장, 스케줄링을 하나씩 연결하세요.
AI 에이전트 비교 참고 자료
아래는 이번 핸드오버 자료에서 사용한 공식 자료예요. 관련 기능은 명시된 검증 날짜와 실제 버전, 계정 조건 범위 안에서만 유효해요. 이 중 ChatGPT Work 관련 페이지는 이번 조회에서 403을 반환했어요.
- OpenAI 제품 구분 및 클라우드 브라우저:
help.openai.com/en/articles/20001275-chatgpt-work-and-codex;help.openai.com/en/articles/20001280-using-cloud-browser-in-chatgpt. - Codex 오픈 플랫폼 및 클라우드 실행:
developers.openai.com/blog/codex-as-a-platform;help.openai.com/en/articles/20001545-using-codex-cloud. - Claude Cowork 및 Claude Code:
support.claude.com/en/articles/15520349-use-claude-cowork-on-web-desktop-and-mobile;code.claude.com/docs/en/overview. - Antigravity 원격 실행 및 스케줄링:
antigravity.google/docs/remote-agents;antigravity.google/docs/commands/schedule. - DeepSeek Harness 공식 프로젝트:
github.com/deepseek-ai/deepseek-harness. 참고 자료는 아키텍처, 브라우저 구성, 보안 안내를 다뤄요. - Kimi 제품 문서:
www.kimi.com/en/help/kimi-work/overview;www.kimi.com/code/docs/en/;www.kimi.com/en/help/kimi-claw/overview.
작성자: APIYI 기술팀. 모델 인터페이스 검증과 워크플로 분할 방안을 논의하고 싶다면 APIYI apiyi.com으로 방문해 문의해 주세요. 구체적인 Agent 제품 권한은 여전히 해당 벤더에 확인해야 해요.