작성자 주: 모델 비용을 비교할 때 토큰 100만 개당 단가만 보면 잘못 선택하기 쉬워요. 이 글에서는 「단가 × 실제 토큰 사용량」 측정 프레임워크와 실제 업무를 소규모 샘플로 재검증하는 전체 과정을 소개해요.
많은 팀이 모델을 고를 때 가격표부터 확인해요. A 모델은 토큰 100만 개당 몇 푼인데 B 모델은 몇 달러나 한다면, A가 더 저렴하다고 생각하기 쉽죠. 하지만 월말 청구서는 예상과 다른 경우가 많아요. 때로는 “저렴한” 모델에 오히려 더 많은 비용이 들기도 해요. 이 글에서는 모델을 선택할 때부터 비용을 정확히 따져볼 수 있도록 「단가 × 실제 토큰 사용량 + 캐시 비용 반영」을 통한 실제 비용 측정법을 소개해요.
흔한 가격표 모음이 아니에요. 가격표는 바뀌지만 측정 방법은 계속 쓸 수 있어요. 공개된 측정 사례에서 나타난 현상을 일반적인 프레임워크로 정리한 뒤, 여러분의 실제 업무에 적용해 다시 검증해 볼 거예요.
핵심 가치: 이 글을 읽으면 “표시 가격이 저렴하다고 청구액도 저렴한 것은 아닌” 이유를 설명하고, 실제 요청 20~50건으로 후보 모델별 작업당 비용을 측정할 수 있어요.
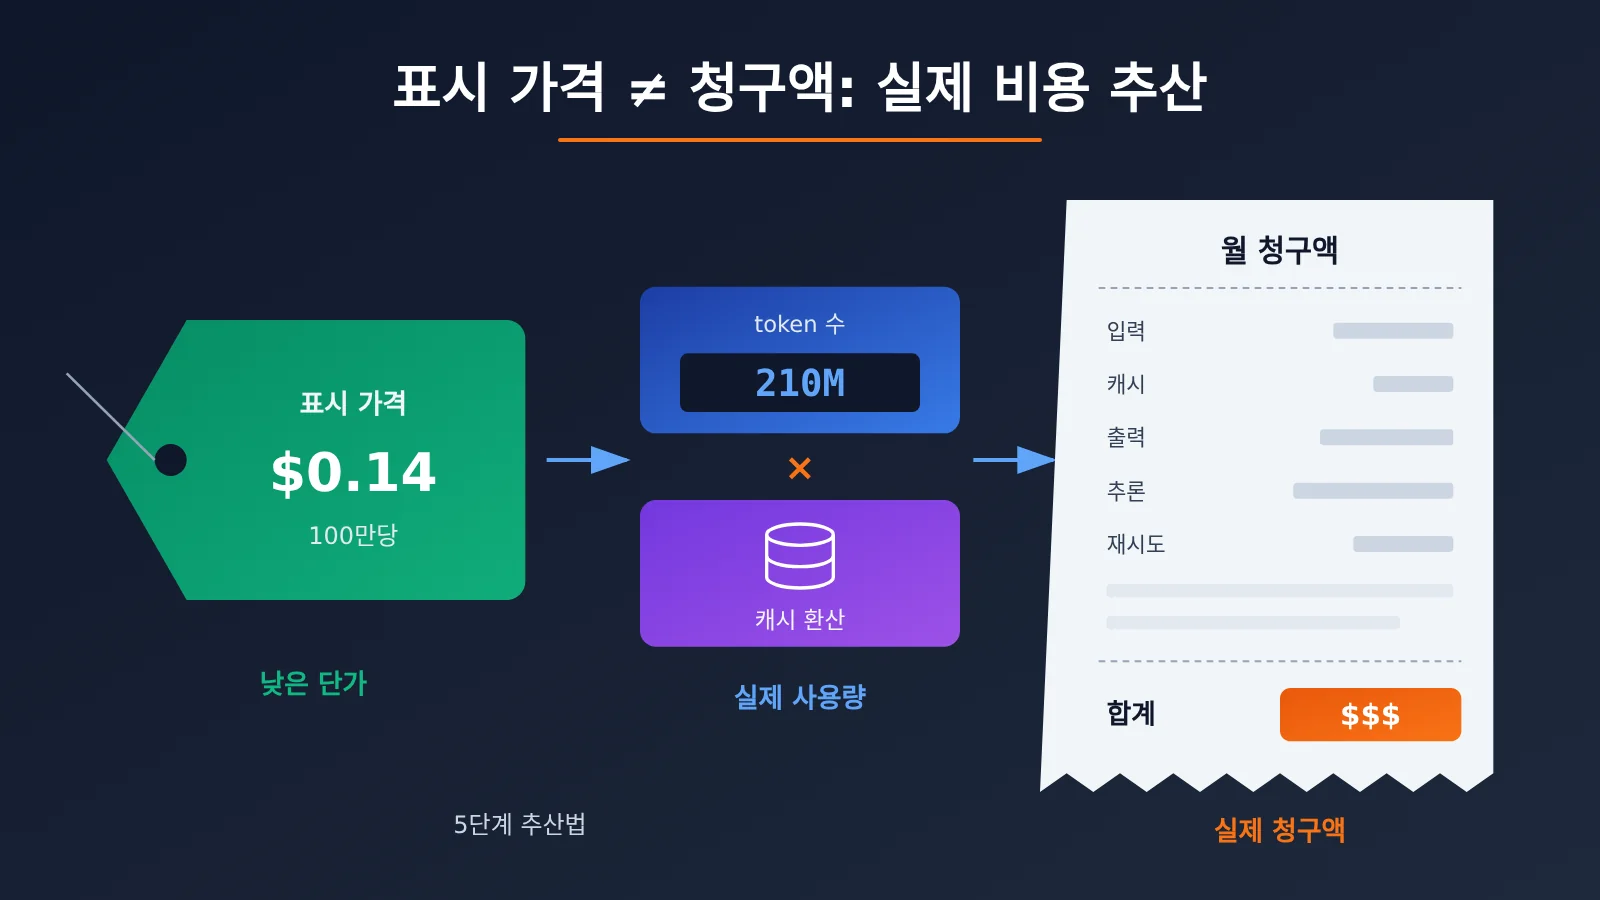
모델의 실제 비용: 핵심 요점
| 요점 | 설명 | 모델 선택에 미치는 영향 |
|---|---|---|
| 단가는 비용을 결정하는 요소 중 하나일 뿐 | 청구액 = 토큰 유형별 수량 × 각 단가의 합계 | 단가만 비교하면 공식의 절반만 비교하는 셈이에요 |
| 토큰화 차이 | 같은 텍스트도 모델마다 서로 다른 수의 토큰으로 나뉘어요 | 입력 비용은 각 모델의 실제 토큰 수를 기준으로 계산해야 해요 |
| 추론 토큰 | 추론 모델의 사고 과정은 보통 출력 토큰으로 과금되며 사용자에게 보이지 않아요 | 보이는 답변이 짧아도 청구액은 높을 수 있어요 |
| 캐시 적중 | 반복되는 접두부가 캐시에 적중하면 더 낮은 캐시 단가가 적용돼요 | 긴 시스템 프롬프트나 여러 차례 대화하는 환경에서 차이가 커요 |
| 성공률과 재시도 | 답이 틀리거나 형식이 맞지 않으면 다시 실행해야 해요 | 유효 비용 = 1회 비용 ÷ 성공률 |
백만 토큰당 단가만 보면 실제 비용을 잘못 계산하는 이유
백만 토큰당 단가는 ‘토큰 하나에 얼마인지’를 보여주지만, 청구액은 ‘작업 하나를 완료하는 데 얼마가 드는지’를 보여줘요. 둘 사이에는 작업 완료에 필요한 토큰 수라는 핵심 변수가 있어요. 모델마다 이 변수의 차이는 단가 차이보다 더 클 때가 많아요.
한 사례로, 서드파티 블로그의 2026년 8월 1일 측정에 따르면 DeepSeek V4 Flash와 Gemini 3.6 Flash는 Artificial Analysis에서 모두 50점으로 같은 점수를 받았어요. 전자의 표시 가격은 $0.14/M, 후자는 $1.50/M으로 단가가 약 10배 차이 났어요. 하지만 같은 평가에서 전자는 약 2억 1,000만 토큰, 후자는 약 5,900만 토큰을 사용해 소비량이 3배 이상 차이 났어요. 토큰 소비량 때문에 단가 이점이 상당 부분 줄어들어 실제 비용 차이는 10배에 훨씬 못 미쳤어요.
토큰화 차이도 있어요. 같은 출처의 2026년 8월 12일 글에서는 완전히 같은 문서를 9개 모델로 각각 토큰 수를 측정했는데, 결과가 614~957토큰으로 최소와 최대 사이에 약 56% 차이가 났어요. 즉, 두 모델의 입력 단가가 완전히 같더라도 같은 프롬프트의 입력 비용이 50% 이상 차이 날 수 있어요.
💡 데이터 참고: 위 수치는 서드파티 블로그에서 한 차례 측정한 결과예요. 평가 작업, 모델 버전, 가격은 시간에 따라 달라지므로 이런 현상이 존재한다는 근거로만 봐야 하며, 예산에 바로 적용할 수는 없어요. 실제 작업에 맞춰 직접 다시 측정해야 해요.
모델 요금 구성: 실제 비용을 결정하는 token 항목
비용을 정확히 계산하려면 먼저 청구 항목을 알아야 해요. 대부분의 제공업체는 아래 항목을 기준으로 요금을 부과하지만, 정확한 명칭과 별도 과금 여부는 각 업체의 공식 문서를 확인하세요.
| 청구 항목 | 의미 | 일반적인 요금 방식 | 놓치기 쉬운 점 |
|---|---|---|---|
| 캐시 미적중 입력 | 이번에 새로 전송했으며 캐시에 적중하지 않은 프롬프트 | 입력 단가 | 토크나이저에 따라 같은 텍스트라도 비용이 달라짐 |
| 캐시 적중 입력 | 이전 요청과 동일한 접두사 부분 | 캐시 읽기 단가, 보통 입력 단가보다 훨씬 저렴함 | 접두사가 완전히 일치해야 캐시에 적중함 |
| 캐시 쓰기 | 일부 업체는 캐시에 처음 저장할 때 별도 요금을 부과함 | 일반 입력 단가보다 높을 수 있음 | 적중률이 낮으면 오히려 더 비쌈 |
| 표시되는 출력 | 사용자가 최종적으로 보는 답변 | 출력 단가 | 출력 단가는 보통 입력 단가의 몇 배임 |
| 추론 token | 모델 내부의 사고 과정 | 일반적으로 출력 단가 적용 | 답변에는 표시되지 않지만 요금에 포함됨 |
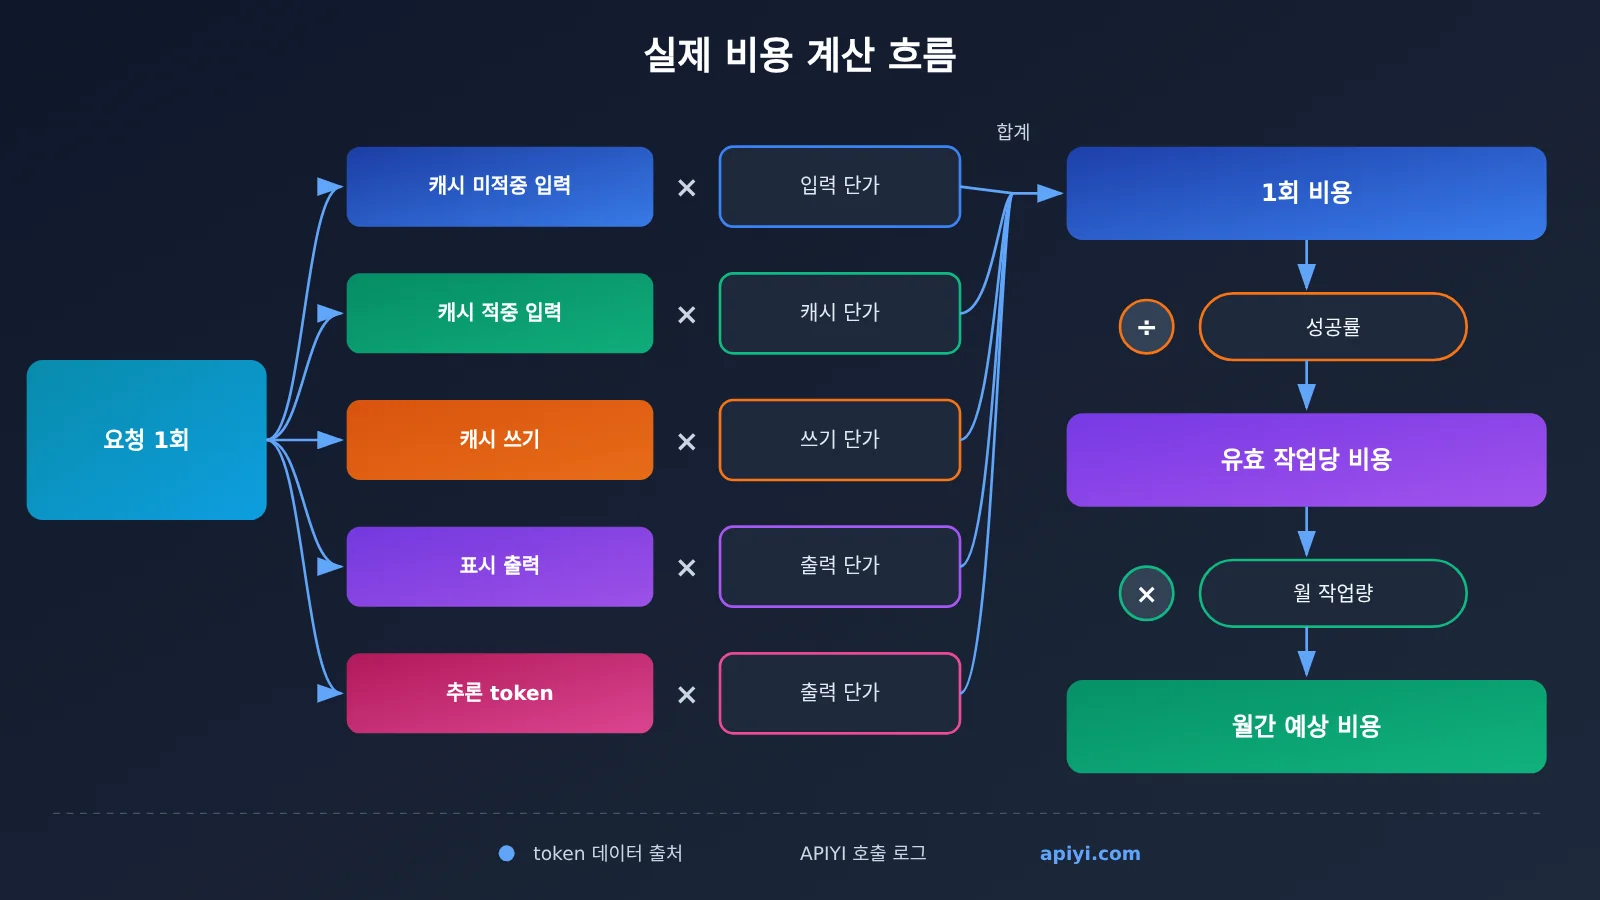
이 항목을 공식으로 정리하면 이 글의 핵심 비용 계산 체계가 돼요.
- 단일 요청 비용 = 캐시 미적중 입력 token × 입력 단가 + 캐시 적중 token × 캐시 단가 + 캐시 쓰기 token × 쓰기 단가 + (표시되는 출력 + 추론 token) × 출력 단가
- 유효 작업당 비용 = 단일 요청 비용 × 평균 호출 횟수 ÷ 작업 성공률
- 월간 예상 비용 = 유효 작업당 비용 × 월간 작업량
캐시가 비용에 미치는 영향은 생각보다 커요. 같은 출처의 2026년 8월 6일자 글에 따르면, DeepSeek V4 Flash의 캐시 적중 가격은 미적중 가격보다 약 50배 저렴하며, 호스팅 업체 간 캐시 가격 차이는 최대 28배에 달해요. 즉, 같은 모델이라도 이용 채널에 따라 청구 금액이 완전히 달라질 수 있으므로 실제 사용하는 채널의 캐시 가격을 확인해야 해요.
추론 토큰이 실제 비용을 키우는 효과
추론 모델은 ‘표시 가격은 저렴한데 청구액은 비싼’ 상황이 발생하는 가장 흔한 원인이에요. 사용자가 질문 하나를 던지고 모델이 200자만 답하더라도, 내부적으로는 먼저 수천 개의 토큰을 사용해 생각할 수 있어요. 이 토큰은 보통 출력 단가로 과금되는데, 출력 단가는 입력 단가보다 몇 배나 높아요.
제3자의 공개 분석에서도 이런 차이를 확인할 수 있어요. 2026년 8월 4일에 발표된 한 글에 따르면, Qwen 3.8 Max는 Artificial Analysis에서 DeepSeek V4 Flash보다 3점 높았지만, 실제로 측정한 3개 작업에서는 비용이 약 345배 높고 속도는 약 6배 느렸어요. 같은 시리즈의 다른 글에서 동일한 평가 방법을 적용한 결과, Kimi K3는 57점에 $2,437, DeepSeek V4 Flash는 50점에 $72, Qwen 3.7 Max는 46점에 $1,604가 들었어요. 점수는 더 낮은데 비용은 더 높은 경우가 실제로 존재하며, 그 원인은 대개 토큰 소비량에 있어요.
같은 제조사의 모델 버전 간에도 차이가 생길 수 있어요. 한 글에 따르면 Claude Opus 4.5부터 4.8까지와 Opus 5의 표시 가격은 모두 $5/$25로 같지만, 실제 측정한 토큰 소비량은 약 1.30배 차이가 났어요. 가격이 그대로여도 청구액은 30% 달라질 수 있다는 뜻이에요. 모델 버전을 업그레이드할 때 놓치기 쉬운 부분이에요.
토큰 사용량으로 실제 비용 추정하기: 5단계 빠른 시작
복잡한 스크립트를 작성하지 않고도 소규모 샘플로 비용을 추정할 수 있어요. 핵심 원칙은 하나예요. 같은 작업과 같은 입력을 기준으로 입력, 출력, 캐시, 추론 토큰을 각각 집계하세요.
1단계: 대표적인 작업 샘플 준비하기
운영 환경이나 실제 요구사항에서 요청 20~50개를 골라 짧은 질의응답, 긴 문서, 여러 차례 이어지는 대화 등 주요 유형을 포함하세요. 캐시 적중은 주로 반복되는 접두부에서 발생하므로 시스템 프롬프트와 컨텍스트를 빠짐없이 보존해야 해요. “안녕하세요” 한마디만으로 테스트하면 토큰화 차이와 캐시 효과를 확인하기 어려워요.
2단계: 변수를 고정하고 후보 모델을 각각 호출하기
각 후보 모델에 동일한 시스템 프롬프트, 사용자 입력, max_tokens, 온도 설정을 적용하세요. 추론 모델이 추론 강도 파라미터를 지원한다면 사용한 단계도 기록해야 해요. 단계에 따라 추론 token 수가 크게 달라질 수 있기 때문이에요.
이 단계에서 통합된 접근 경로를 사용하면 번거로움을 줄일 수 있어요. APIYI apiyi.com 같은 통합 플랫폼에서는 하나의 API 키와 동일한 OpenAI 호환 호출 방식으로 여러 공급사의 모델을 전환할 수 있어요. 모델 이름만 바꾸면 전체 비교를 실행할 수 있으므로 공급사마다 계정을 만들고, 충전하고, SDK를 따로 연동할 필요가 없어요.
3단계: token 유형별로 기록하기
호출할 때마다 응답의 usage 필드에서 token 수를 확인하세요. OpenAI 호환 형식에서 자주 사용하는 필드는 다음과 같아요.
usage.prompt_tokens: 전체 입력 token 수usage.prompt_tokens_details.cached_tokens: 이 중 캐시가 적중한 token 수usage.completion_tokens: 전체 출력 token 수usage.completion_tokens_details.reasoning_tokens: 이 중 추론 token 수
필드 이름은 공급사마다 달라요. 예를 들어 Anthropic 형식에서는 cache_read_input_tokens와 cache_creation_input_tokens로 캐시 읽기와 쓰기를 구분해요. 자세한 내용은 각 공급사의 문서를 확인하세요.
응답을 직접 분석하고 싶지 않다면 플랫폼 기록을 확인해도 돼요. APIYI는 호출별 로그와 사용량 통계를 제공하므로, 동일한 샘플을 여러 모델에서 실행했을 때의 사용량을 비교하기 좋아요. 다만 캐시 token과 추론 token이 로그에 별도로 표시되는지, 캐시 적중에 별도 요금이 적용되는지는 콘솔 화면과 플랫폼 과금 안내를 참고해 계산 전에 확인하세요.
🚀 빠른 시작: 먼저 APIYI apiyi.com에서 샘플 20개로 소규모 비교를 진행해 각 모델의 token 사용량을 확인한 뒤, 샘플을 늘릴지 결정해 보세요. 통합 잔액으로 결제하면 여러 모델의 테스트 비용을 한 계정에서 관리할 수 있어, 테스트 후 비용을 확인하기도 편해요.
4단계: 비용 계산 템플릿에 정리하기
기록한 결과를 아래 템플릿에 모델별로 한 행씩 입력하세요. 단가에는 반드시 조회 날짜와 출처를 적어야 해요.
| 항목 | 입력 방법 | 데이터 출처 |
|---|---|---|
| 모델 및 버전 | 구체적인 버전 번호 또는 날짜 접미사 기재 | 호출 파라미터 |
| 단가 및 조회 날짜 | 입력, 출력, 캐시 읽기, 캐시 쓰기를 각각 별도 열에 기재 | 공식 가격 페이지 또는 사용 중인 플랫폼의 가격 페이지 |
| 평균 캐시 미적중 입력 토큰 | 샘플 평균 | 응답의 usage 또는 플랫폼 로그 |
| 평균 캐시 적중 토큰 | 샘플 평균과 적중률 계산 | 응답의 usage 또는 플랫폼 로그(예: APIYI 사용량 통계) |
| 평균 가시 출력 토큰 | 전체 출력에서 추론 부분을 제외 | 응답의 usage |
| 평균 추론 토큰 | 추론형 모델은 별도 기록 | 응답의 usage |
| 작업 성공률 | 사람 또는 규칙으로 판정한 합격 비율 | 평가 기록 |
| 유효 단일 작업 비용 | 앞서 제시한 공식으로 계산 | 집계 계산 |
5단계: 유효 단일 작업 비용으로 결정하기
마지막으로 비교할 것은 단가가 아니라 ‘유효 단일 작업 비용’이에요. 아래에서는 예시 가격으로 계산 과정을 살펴볼게요. 이 숫자는 방법을 설명하기 위해 만든 가상의 값이며, 실제 모델 가격이 아니에요.
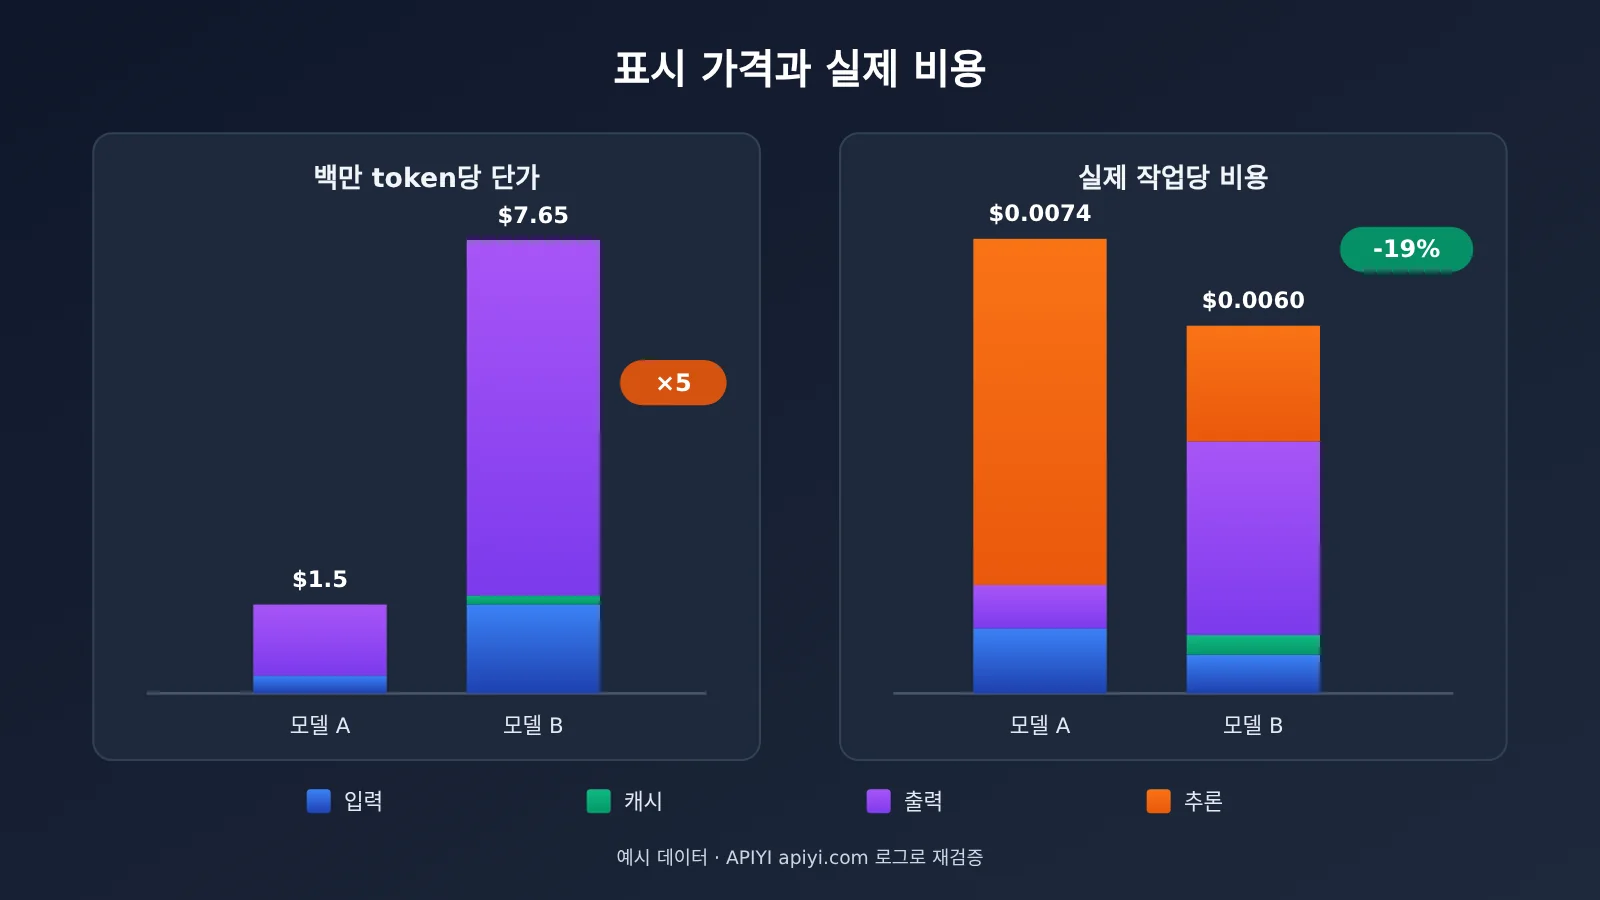
모델 A의 표시 가격은 입력 $0.3/M, 출력 $1.2/M이고, 모델 B는 입력 $1.5/M, 출력 $6/M, 캐시 읽기 $0.15/M이라고 가정해 볼게요. B의 단가는 A의 5배예요.
| 계산 항목 | 모델 A(낮은 표시 가격) | 모델 B(높은 표시 가격) |
|---|---|---|
| 캐시 미적중 입력 토큰 | 3,000 | 400 |
| 캐시 적중 토큰 | 0 | 2,000 |
| 가시 출력 + 추론 토큰 | 500 + 4,000 | 500 + 300 |
| 입력 비용 | $0.0009 | $0.0006 + $0.0003 |
| 출력 비용 | $0.0054 | $0.0048 |
| 요청당 비용 | $0.0063 | $0.0057 |
| 작업 성공률 | 85% | 95% |
| 유효 단일 작업 비용 | 약 $0.0074 | 약 $0.0060 |
이 예시에서 모델 B는 토큰화 효율이 높아 총 입력량이 600토큰 적어요. 긴 시스템 프롬프트의 대부분이 캐시에 적중했고, 추론 과정도 훨씬 짧았어요. 그 결과 표시 가격이 5배 비싼 B의 유효 비용이 오히려 A보다 약 19% 낮아요. 실제로는 반대 결과가 나올 수도 있어요. 따라서 직접 수행하는 작업으로 다시 측정해야 해요.
실제 비용을 산정할 때 주의할 점
산정 방식 자체는 복잡하지 않지만, 몇 가지 함정 때문에 결과가 왜곡될 수 있어요. 실행 전에 하나씩 확인해 보세요.
- 가격에는 반드시 날짜를 표시하세요: 모델 가격은 자주 바뀝니다. 참고 자료에 따르면 DeepSeek V4 Pro 0813은 2026년 8월 16일부터 피크·비피크 시간대별 가격을 적용해요. 같은 모델도 시간대와 채널에 따라 가격이 다를 수 있습니다.
- 모델 별칭이 가리키는 버전을 확인하세요: 한 문서에서는 가장 흔히 쓰이는 것처럼 보이는 모델명이 실제로는 이전 버전을 호출한다고 지적했어요. 산정할 때 응답에 반환된 모델 식별자를 기록해 A 버전을 테스트하고 B 버전을 배포하는 일이 없도록 하세요.
- 캐시 적중에는 접두부 일치가 필요해요: 동적 콘텐츠(타임스탬프, 사용자 ID)를 프롬프트 앞부분에 넣으면 매번 접두부가 달라져 캐시가 거의 적중하지 않아요. 실제 운영 환경과 같은 프롬프트 구조로 비용을 산정하세요.
- 제3자 벤치마크 점수는 참고 자료로만 활용하세요: Artificial Analysis 등의 종합 점수와 작업별 비용은 평가 기관의 작업 분포를 반영하므로, 실제 비즈니스 환경과는 다를 수 있어요.
- 재시도 비용도 포함하세요: 429 속도 제한, 형식 오류, 기준에 미달하는 답변으로 재실행할 때도 비용이 발생해요. 성공률은 실제 판정 결과를 기준으로 계산하세요.
💰 비용 최적화 팁: 산정이 끝나면 ‘유효 작업당 비용’을 모델 선택의 핵심 지표로 삼고, 벤치마크 점수와 지연 시간은 제약 조건으로 활용해 보세요. APIYI apiyi.com에서는 모델명만 바꾸면 모델을 전환할 수 있어 산정 결과에 따라 운영 설정을 빠르게 조정하고, 호출 로그로 실제 사용량을 계속 모니터링할 수 있어요.
자주 묻는 질문 FAQ
Q1: 모델의 ‘실제 비용’이란 무엇인가요?
실제 비용은 백만 token당 표기 가격이 아니라 특정 작업을 완료하는 데 실제로 지불한 비용이에요. 각 유형의 token(캐시 미적중 입력, 캐시 적중, 캐시 쓰기, 표시된 출력, 추론) 수에 해당 단가를 곱한 뒤, 성공률과 재시도까지 고려한 작업당 유효 비용을 뜻해요.
Q2: 같은 문서인데 모델마다 token 수가 다른 이유는 무엇인가요?
모델마다 토크나이저가 달라 중국어, 코드, 문장부호를 나누는 단위가 다르기 때문이에요. 공개된 측정 결과에서는 같은 문서가 9개 모델에서 614~957개 token으로 집계됐어요. 따라서 입력 비용은 각 모델이 보고한 token 수로 계산해야 하며, 한 모델의 집계치를 다른 모델에 적용하면 안 돼요.
Q3: 추론 token도 반드시 비용에 포함해야 하나요?
네. 대부분의 업체는 추론 token을 출력에 포함해 출력 단가로 과금해요. 답변 본문에는 나타나지 않지만 전체 출력의 대부분을 차지할 수도 있어요. 추론 모델을 측정할 때는 `reasoning_tokens`를 별도로 기록하고, 같은 추론 강도 설정에서 비교하는 것이 좋아요.
Q4: 캐시 적중으로 비용을 얼마나 절약할 수 있나요?
업체의 캐시 가격과 적중률에 따라 달라요. 참고 자료에 따르면 DeepSeek V4 Flash의 캐시 적중 가격은 미적중 가격의 약 1/50이지만, 호스팅 제공업체에 따라 캐시 가격이 최대 28배 차이 날 수 있어요. 긴 시스템 프롬프트, 고정 지식 베이스 접두사, 여러 차례에 걸친 대화에서 절약 효과가 커요. 정확한 가격은 이용하는 채널의 안내를 확인하세요.
Q5: 여러 모델의 비용을 소규모 샘플로 빠르게 측정하려면 어떻게 하나요?
여러 모델에 통합 접속할 수 있는 플랫폼을 사용하는 것을 추천해요.
1. APIYI apiyi.com에 가입하고 API 키를 발급받아요.
2. 실제 작업 샘플 20~50개를 준비하고 프롬프트와 매개변수를 고정해요.
3. 모델 이름을 하나씩 바꿔 호출하고, 호출 로그와 사용량 통계로 각 유형의 token을 집계해요.
4. 이 글의 템플릿에 따라 작업당 유효 비용을 계산해요.
이렇게 하면 하나의 계정과 호출 방식으로 모든 비교를 마칠 수 있어, 여러 업체에 가입하고 비용을 대조하는 수고를 줄일 수 있어요.
Q6: 서드파티 블로그의 ‘작업당 비용’을 그대로 사용해도 되나요?
예산에 바로 적용하는 것은 추천하지 않아요. 이런 데이터는 token 사용량 차이가 있을 수 있는 모델 조합을 찾아 후보를 좁히는 데 유용해요. 하지만 평가 작업, 모델 버전, 가격, 캐시 조건이 실제 비즈니스와 다르므로 최종 수치는 직접 준비한 샘플로 다시 측정해야 해요.
Q7: 이 측정 방법에는 어떤 한계가 있나요?
소규모 샘플은 해당 샘플에 포함된 작업 유형만 반영하므로, 실제 작업의 분포가 바뀌면 다시 측정해야 해요. 또한 일부 플랫폼의 로그는 캐시 token과 추론 token을 구분하지 않을 수 있어요. 이때는 모델 응답의 `usage` 필드에서 직접 수집해야 해요. 가격과 모델 버전도 바뀌므로 가격 조정이나 업그레이드 후에는 다시 측정하는 것이 좋아요.
모델 실질 비용 산정 핵심 요점 Key Takeaways
- 단가는 공식의 절반일 뿐이에요: 청구액은 단가에 실제 token 사용량을 곱해 결정돼요.
- 토큰화 차이를 무시할 수 없어요: 같은 문서도 모델에 따라 token 수가 50% 이상 차이 날 수 있어요.
- 추론 token은 출력 비용을 늘려요: 눈에 보이지 않는 사고 과정도 출력으로 과금돼요.
- 캐시 가격은 채널마다 달라요: 긴 프롬프트의 비용은 캐시 적중률과 캐시 단가에 따라 결정돼요.
- 유효 작업당 비용으로 결정하세요: 성공률과 재시도 비용까지 함께 고려해야 해요.
- 통합 인터페이스로 재측정하세요: APIYI의 통합 인터페이스와 호출 로그를 활용하면 같은 샘플로 여러 모델을 더 쉽게 테스트할 수 있어요.
정리
token 사용량과 캐시를 바탕으로 모델의 실질 비용을 추정할 때는 세 가지가 중요해요.
- 청구 내역을 나눠 계산하세요: 캐시 미적중 입력, 캐시 적중, 캐시 쓰기, 가시적 출력, 추론 token을 각각 집계하고 해당 단가를 곱해요.
- 직접 수행할 작업으로 재측정하세요: 서드파티 벤치마크와 가격은 참고 자료일 뿐이에요. 같은 작업과 입력으로 측정한 데이터가 더 믿을 만해요.
- 유효 작업당 비용을 비교하세요: 성공률과 재시도를 반영하고, 월간 작업량을 고려해 예산을 세워요.
모델 가격은 바뀌고 새 모델도 계속 등장하지만, 이 산정 방식은 오랫동안 활용할 수 있어요. 다음 모델 선정에 앞서 실제 샘플 20개로 비교 테스트를 진행한 뒤 사용할 모델을 결정해 보세요. 여러 공급업체의 모델을 빠르게 바꿔가며 테스트해야 한다면 APIYI apiyi.com을 통해 통합 접속하고, 호출 로그로 각 모델의 실제 사용량을 바로 확인할 수 있어요.
📚 참고 자료
- Ofox.ai 블로그 23페이지: DeepSeek V4 Flash와 Gemini 3.6 Flash의 토큰 사용량 비교, 캐시 가격 차이, Qwen 시리즈 비용 산정 등을 다룬 글의 요약
- 링크:
ofox.ai/blog/page/23/ -
설명: 2026년 8월에 게시된 글로, 데이터는 제3자가 한 차례 측정한 결과이므로 참고용으로만 활용하세요.
-
Ofox.ai 블로그 22페이지: 동일한 문서에 대한 9개 모델의 토큰 수 비교, Claude 버전 간 토큰 사용량 차이, DeepSeek V4 Pro의 시간대별 요금 등의 정보
- 링크:
ofox.ai/blog/page/22/ -
설명: 토큰화 방식과 버전에 따른 차이를 구체적인 사례로 살펴보기에 좋아요.
-
Ofox.ai 블로그 25페이지: Kimi K3, GLM-5.2, Opus 4.8의 단일 작업 비용 비교
- 링크:
ofox.ai/blog/page/25/ - 설명: 가격과 벤치마크 점수는 시간이 지나면 달라질 수 있으니, 사용 전에 각 업체의 공식 가격 페이지를 확인하세요.
작성자: APIYI 기술팀
기술 관련 문의: APIYI apiyi.com 홈페이지에서 문의해 주세요. 더 많은 연동 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있어요.