작가 주: Agent 컨텍스트 자동 압축이 발동하는 세 가지 시점과 요약 보존 전략을 실행 가능한 코드와 함께 살펴봐요. 긴 대화에서도 핵심 작업 정보를 잃지 않으면서 토큰 사용량을 관리할 수 있어요.
Codex 같은 코딩 Agent로 몇 시간씩 작업하다 보면 많은 개발자가 같은 의문을 갖게 돼요. 입력창 근처에는 권한 모드와 현재 모델만 표시되고 컨텍스트 사용량은 보이지 않는데, 대체 언제 새 창을 열어야 할까요? 대화가 길어질수록 매 요청에 더 많은 대화 기록을 실어 보내야 하므로 사용 한도도 더 빨리 소모돼요. 이 글에서는 Agent 컨텍스트 자동 압축(Context Compaction)이 발동하는 시점과 요약 전략을 살펴봐요. Codex 같은 도구의 내부 동작을 이해하고, 직접 만든 Agent에도 같은 기능을 구현할 수 있도록 도와드릴게요.
단순히 “대화 기록을 정리하세요”라고 말하는 흔한 조언이 아니에요. OpenAI와 Anthropic의 공식 문서에 공개된 압축 메커니즘을 바탕으로, 실무 경험을 더해 실제로 적용할 수 있는 방법을 정리했어요.
핵심 내용: 이 글을 읽으면 Agent 컨텍스트 자동 압축이 언제 발동하는지, 요약에 무엇을 남기고 무엇을 버려야 하는지 알 수 있어요. 바로 수정해 사용할 수 있는 Python 구현 코드도 얻을 수 있어요.
Agent 컨텍스트 자동 압축 핵심 요약
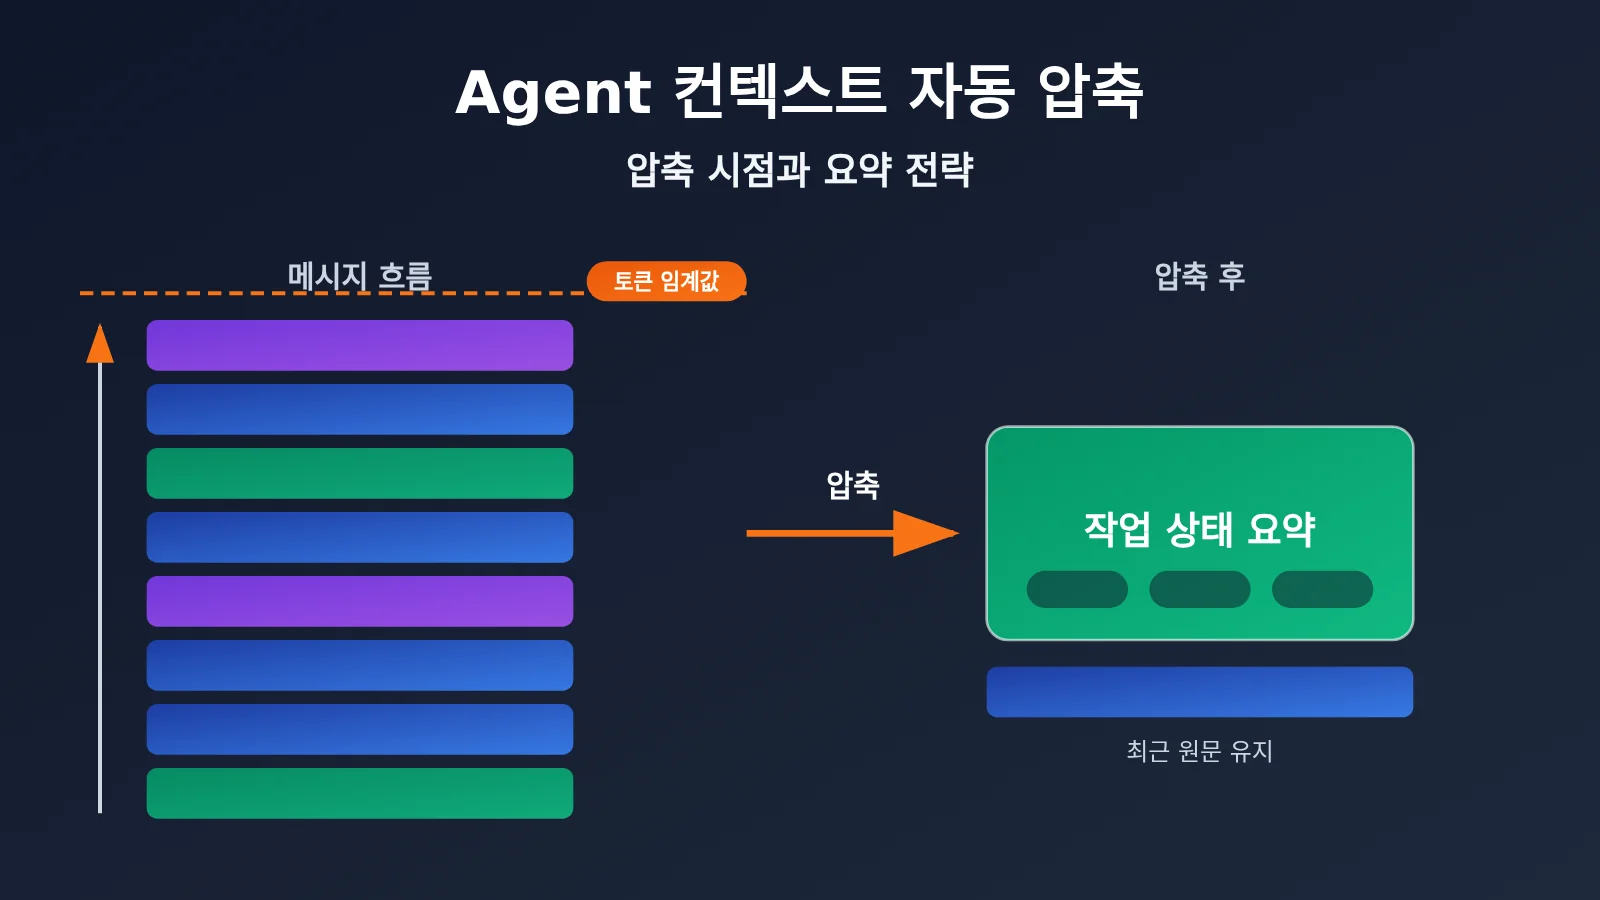
먼저 결론부터 살펴볼게요. Agent 컨텍스트 자동 압축은 보통 컨텍스트가 지정된 Token 임계값에 도달하면 실행돼요. 이전 대화와 도구 호출 기록을 압축해 작업을 계속할 수 있는 상태 설명으로 만드는 거죠. 단순히 대화 기록을 줄이는 게 아니라, 작업 진행 상황과 중요 사실, 완료한 작업, 핵심 결정, 다음 행동을 보존하면서 불필요한 과정 정보를 덜어내는 것이 목표예요.
| 핵심 사항 | 설명 | 장점 |
|---|---|---|
| Token 임계값 기준 실행 | 컨텍스트가 설정된 Token 수에 도달하면 자동으로 압축 | 수동 개입 없이 컨텍스트 윈도우 초과 방지 |
| 능동적 압축 | 애플리케이션이 특정 시점에 직접 압축 호출. 예: 작업 단계 완료 시 | 의미상 자연스러운 경계에서 압축해 정보 손실 최소화 |
| 프레임워크 자동 관리 | SDK 또는 Agent Runtime이 컨텍스트 사용량에 따라 결정 | 별도 설정 없이 사용할 수 있어 빠른 구축에 적합 |
| 잘라내기가 아닌 요약 | 진행 상황, 사실, 결정, 다음 단계를 보존 | 압축 후에도 Agent가 작업을 계속 수행 가능 |
| 단계별 압축 | 매 라운드마다 압축하는 것은 권장하지 않음 | 캐시 적중률과 정보 완전성의 균형 유지 |
Agent에 컨텍스트 자동 압축이 필요한 이유
대규모 언어 모델 API 자체는 상태를 저장하지 않아요. 여러 차례 대화를 이어가려면 매 라운드마다 전체 messages 기록을 모델에 다시 보내야 해요. 따라서 50번째 요청에는 앞선 49번의 대화가 모두 포함되고, 입력 Token은 선형적으로 또는 그보다 빠르게 늘어나요. Agent는 상황이 더 심각해요. 도구 호출 결과인 파일 내용, 터미널 출력, 검색 결과가 대개 매우 길어서 몇 번만 호출해도 컨텍스트 윈도우의 상당 부분을 차지할 수 있거든요.
이로 인해 두 가지 문제가 생겨요. 첫째는 비용이에요. 매 라운드의 입력 Token이 많을수록 사용량 한도가 빠르게 소진돼요. 둘째는 품질이에요. 컨텍스트가 너무 길어지면 모델이 초반의 핵심 정보를 놓치기 쉬워지고, 윈도우를 초과하면 오류가 발생할 수도 있어요. Agent 컨텍스트 자동 압축은 이 두 문제 사이에서 균형을 찾아요. 정보가 아직 온전하고 윈도우에도 여유가 있을 때 기록을 간결한 상태 정보로 정리해 후속 요청의 부담을 줄이는 거예요.
Codex에서 컨텍스트 사용량이 표시되지 않는 이유
클라이언트에서 컨텍스트 윈도우 크기를 더 이상 표시하지 않는 이유에 대해서는 공식적인 설명을 확인하지 못했어요. 여기서는 추측하지 않을게요. 확실한 것은 Codex에 컨텍스트 압축 기능이 내장되어 있어, 긴 대화에서도 원본 기록 전체가 무한정 쌓이지는 않는다는 점이에요. 매 라운드의 사용량을 정확히 확인하고 싶다면 API 호출 로그를 살펴보는 것이 가장 확실해요. 구체적인 방법은 뒤에서 설명할게요.
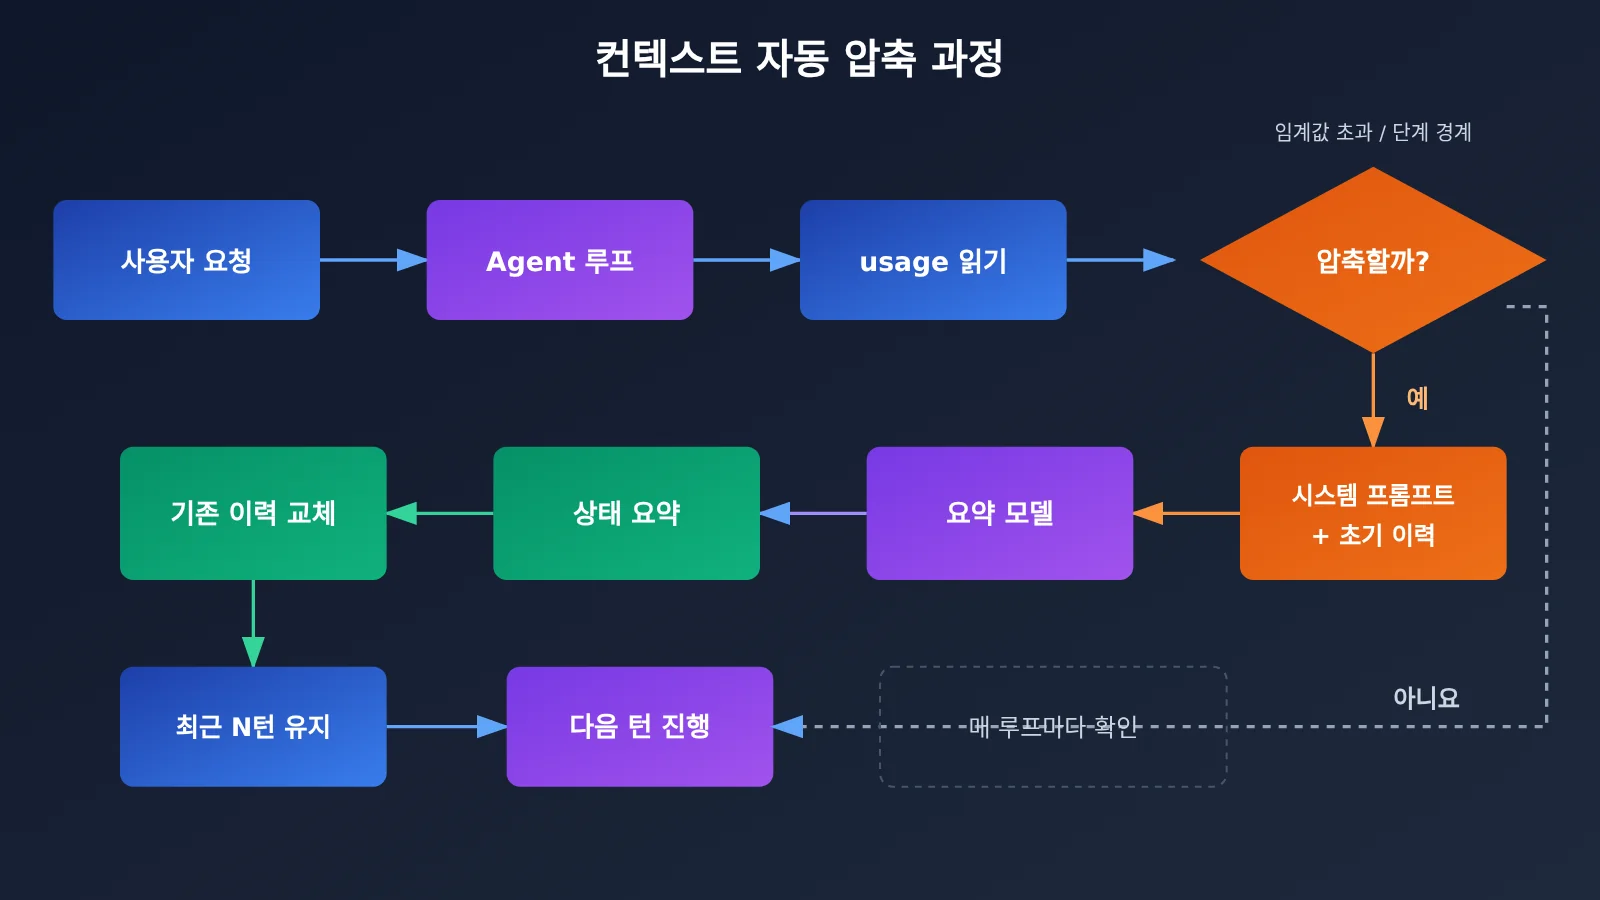
Agent 컨텍스트 자동 압축이 실행되는 3가지 시점
흔히 “컨텍스트를 80% 사용하면 압축한다”고 생각하지만, 이는 공식 규칙이 아니에요. 공식 API 문서는 고정된 컨텍스트 윈도우 비율이 아니라 Token 수 임계값을 기준으로 압축 조건을 정의해요. 압축을 위해 반드시 상한에 가까워질 때까지 기다릴 필요도 없어요. OpenAI와 Anthropic 모두 능동적인 압축을 지원해요.
공식 구현의 압축 조건 비교
| 구현 방식 | 자동 압축 조건 | 공식 설명 |
|---|---|---|
| OpenAI Responses API | 렌더링된 Token 수가 compact_threshold에 도달 |
임계값을 직접 설정할 수 있으며 서버에서 자동 처리 |
| OpenAI Agents SDK | 컨텍스트 압박 또는 명시적 임계값 정책 | 자동, 고정 임계값, 강제 압축 지원 |
| Anthropic Messages API | 입력 Token이 trigger.value에 도달 |
기본값 150,000, 최솟값 50,000 |
| Anthropic Tool Runner | context_token_threshold에 도달 |
기본값 100,000 |
| Anthropic 온디맨드 압축 | 애플리케이션이 직접 요청 | 대화 턴이 완전히 끝난 후 호출 가능 |
표를 보면 공통점이 있어요. 자동 압축은 대부분 ‘입력 Token 수’를 기준으로 판단하며, 임계값을 설정할 수 있어요. 또한 애플리케이션이 압축 시점을 직접 결정하는 방법도 제공해요.
시점 1: Token 임계값 도달 시
가장 기본적인 안전장치예요. 매 호출이 끝난 뒤 API 응답에 포함된 입력 Token 수를 확인하고, 설정한 임계값을 넘으면 압축을 실행해요. 임계값을 컨텍스트 윈도우 상한에 너무 가깝게 설정하면 안 돼요. 압축할 때 기존 대화 기록을 요약 모델에 다시 보내야 하고, 다음 턴의 도구 출력도 담을 여유가 필요하기 때문이에요.
실무에서는 Anthropic의 기본값을 참고할 수 있어요. 긴 컨텍스트 윈도우를 지원하는 모델에서는 임계값을 10만 Token 수준으로 설정하고, 임계값에 도달한 뒤에도 도구 호출 결과를 온전히 담을 공간을 남겨두세요.
시점 2: 작업 단계가 끝났을 때 능동적으로 압축
정보 손실을 최소화할 수 있는 방법이에요. OpenAI는 매 턴마다 압축하기보다 의미 있는 작업 단계를 완료한 뒤 압축할 것을 권장해요. 예를 들어 Agent가 ‘버그 위치 파악 → 코드 수정 → 테스트 통과’ 과정을 마쳤다면, 중간 시행착오는 더 이상 중요하지 않아요. ‘어떤 파일을 왜 수정했고, 테스트를 통과했다’는 사실만 기억하면 돼요.
단계가 끝난 시점에는 미완료 상태로 남아 있는 도구 호출이 없기 때문에, 더 정확한 요약을 작성하기도 쉬워요.
시점 3: 프레임워크가 컨텍스트 압박에 따라 관리
Agents SDK나 Tool Runner 같은 프레임워크를 사용한다면 내장 압축 정책을 켜고 런타임이 컨텍스트 압박에 따라 자동으로 결정하도록 할 수 있어요. 관리가 편하지만 요약 내용을 직접 제어하기는 어려워요. 프로토타입이나 범용 시나리오에 적합해요.
🎯 기술 팁: 세 가지 방식은 함께 사용할 수 있어요. ‘작업 단계가 끝날 때 능동적으로 압축하고, Token 임계값을 안전장치로 활용하는’ 조합을 추천해요. 여러 모델에서 임계값이 적절한지 확인하고 싶다면 APIYI apiyi.com에서 하나의 키로 OpenAI, Claude, Gemini 등의 모델을 전환하며 비교 테스트할 수 있어요.
Agent 컨텍스트 자동 압축을 위한 요약 전략
트리거가 ‘언제 압축할지’를 결정한다면, 요약 전략은 ‘어떤 형태로 압축할지’를 결정해요. 압축에 실패하면 Agent가 사용자의 초기 제약 조건을 잊거나 이미 수행한 작업을 반복하는 경우가 많아요. 근본적인 원인은 요약에 ‘무슨 대화를 나눴는지’만 기록하고 ‘작업 상태가 어떤지’는 기록하지 않았기 때문이에요.
요약에 남길 내용과 버려도 되는 내용
| 범주 | 남길 내용 | 버려도 되는 내용 |
|---|---|---|
| 작업 목표 | 사용자의 원래 요구사항, 필수 제약 조건, 완료 기준 | 인사말, 반복 확인 |
| 작업 진행 상황 | 완료한 단계, 현재 진행 단계 | 각 단계의 상세한 추론 과정 |
| 중요 사실 | 파일 경로, 함수명, 설정값, 오류 메시지의 핵심 부분 | 파일 전체 내용, 긴 로그 |
| 핵심 결정 | 선택한 방안과 그 이유 | 기각된 방안에 대한 상세 논의 |
| 다음 행동 | 할 일 목록, 해결되지 않은 문제 | 완료됐고 이후 영향도 없는 세부 사항 |
요약 전략을 적용하는 5단계
- 시스템 프롬프트는 항상 유지하기: 시스템 프롬프트는 압축하지 않고 항상 messages의 맨 앞에 둬요.
- 최근 N턴의 원문 유지하기: 최근 대화 몇 턴은 현재 작업과 밀접하게 관련된 경우가 많으므로 그대로 두고, 그보다 이전 부분만 압축해요.
- 구조화된 요약 템플릿 사용하기: 요약 모델이 ‘목표 / 진행 상황 / 사실 / 결정 / 다음 단계’ 다섯 항목에 맞춰 출력하도록 해 누락을 방지해요.
- 도구 결과부터 간추리기: 지나치게 긴 도구 반환값은 오류 메시지의 앞뒤 몇 줄이나 검색 결과의 제목과 결론처럼 핵심 부분만 남겨요.
- 사용자 발언을 별도로 보관하기: ‘공개 인터페이스를 수정하지 마세요’처럼 사용자가 명시한 제약 조건은 모델이 다시 쓰도록 하지 말고 원문 그대로 보관하는 것이 좋아요.
이 중 가장 중요한 단계는 구조화된 템플릿이에요. 모델에 자유롭게 요약을 맡기면 대화의 전반적인 분위기를 요약하는 경향이 있어요. 반면 구조화된 항목을 사용하면 각 내용을 빠짐없이 확인해 작업을 이어가는 데 필요한 상태 정보를 보존할 수 있어요.
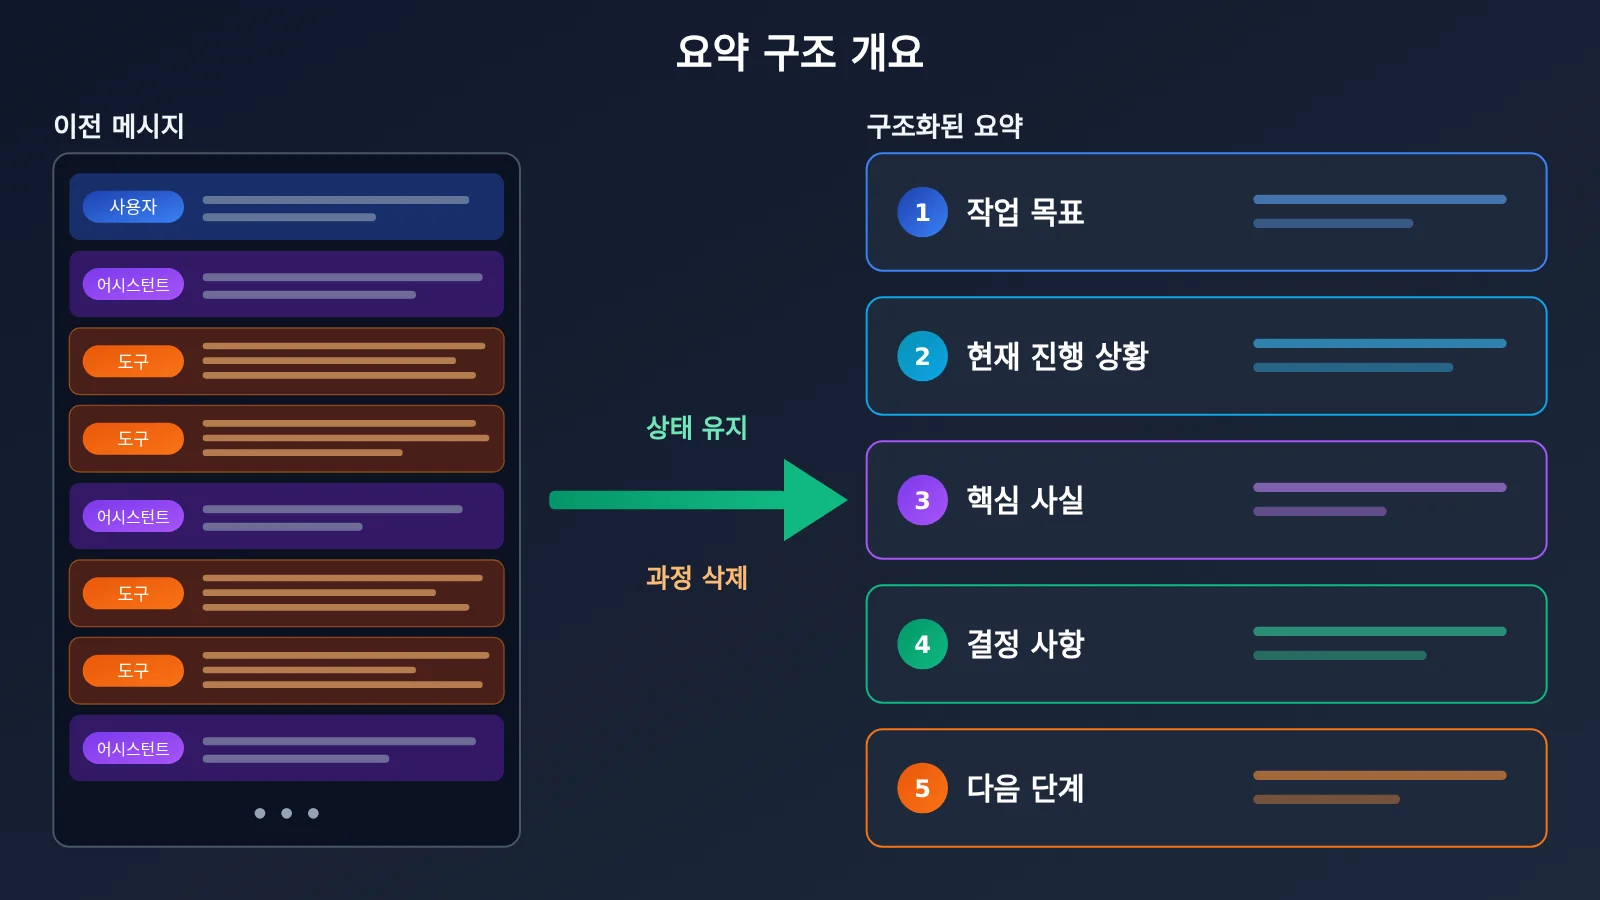
Agent 컨텍스트 자동 압축 빠른 시작
아래에서는 클라이언트에서 messages를 직접 관리하는 범용 방식을 구현해요. OpenAI 호환 인터페이스라면 어디서든 사용할 수 있어요. 매 호출 후 usage.prompt_tokens에서 입력 토큰 수를 확인하고, 임계값을 넘으면 초기 대화 기록을 요약 모델에 넘겨 압축하는 방식이에요.
간단한 예제
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 인터페이스
)

messages = [{"role": "system", "content": "你是一个编码助手。"}]
messages.append({"role": "user", "content": "帮我检查这个函数的边界条件"})

resp = client.chat.completions.create(model="gpt-4o-mini", messages=messages)
messages.append({"role": "assistant", "content": resp.choices[0].message.content})

# 매 턴 입력 토큰을 기록해 압축 여부를 판단
print("本轮输入 Token:", resp.usage.prompt_tokens)
에이전트 컨텍스트 자동 압축 전체 구현 코드 보기
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MAIN_MODEL = "gpt-4o-mini"      # 주요 작업 모델, 필요에 따라 교체 가능
SUMMARY_MODEL = "gpt-4o-mini"   # 요약 모델, 더 저렴한 모델 사용 가능
TOKEN_THRESHOLD = 100_000       # 입력 토큰 임곗값, 초과 시 압축
KEEP_RECENT = 6                 # 최근 N개 메시지의 원문 유지

SUMMARY_PROMPT = """请把以下 Agent 对话历史压缩为任务状态摘要,严格按五个栏目输出:
【任务目标】用户原始需求与硬性约束(约束请逐字保留)
【当前进度】已完成的步骤与当前阶段
【关键事实】文件路径、函数名、配置值、关键报错
【已做决策】采用的方案及原因
【下一步行动】待办事项与未解决问题
不要记录寒暄和推理过程,不要编造历史中没有的信息。"""


def compact(messages: list) -> list:
    """把早期历史压缩为一条摘要消息,保留系统提示与最近对话。"""
    system_msg = messages[0]
    old = messages[1:-KEEP_RECENT]
    recent = messages[-KEEP_RECENT:]
    if not old:
        return messages

    history_text = "\n".join(f"[{m['role']}] {m['content']}" for m in old)
    resp = client.chat.completions.create(
        model=SUMMARY_MODEL,
        messages=[
            {"role": "system", "content": SUMMARY_PROMPT},
            {"role": "user", "content": history_text},
        ],
    )
    summary = resp.choices[0].message.content
    summary_msg = {"role": "user", "content": f"(以下为之前对话的压缩摘要)\n{summary}"}
    return [system_msg, summary_msg] + recent


class CompactingAgent:
    def __init__(self, system_prompt: str):
        self.messages = [{"role": "system", "content": system_prompt}]
        self.last_prompt_tokens = 0

    def chat(self, user_input: str) -> str:
        # 시점 1: 이전 턴의 입력 토큰이 임곗값을 초과하면 먼저 압축
        if self.last_prompt_tokens > TOKEN_THRESHOLD:
            self.messages = compact(self.messages)

        self.messages.append({"role": "user", "content": user_input})
        resp = client.chat.completions.create(model=MAIN_MODEL, messages=self.messages)
        reply = resp.choices[0].message.content
        self.messages.append({"role": "assistant", "content": reply})
        self.last_prompt_tokens = resp.usage.prompt_tokens
        return reply

    def finish_stage(self):
        # 시점 2: 작업 단계를 완료한 후 미리 압축
        self.messages = compact(self.messages)
        self.last_prompt_tokens = 0


agent = CompactingAgent("你是一个严谨的编码助手。")
print(agent.chat("帮我定位登录接口偶发 500 的原因"))
agent.finish_stage()  # 수정이 끝난 후 단계 전환 시 미리 압축
🚀 빠른 시작: APIYI apiyi.com에 가입하면 무료 테스트 크레딧을 받을 수 있어요. 위 코드에서 API 키만 교체하면 바로 실행할 수 있습니다. OpenAI 호환 인터페이스를 제공하며, 주요 작업 모델과 요약 모델을 서로 다른 제공업체의 모델로 선택해 비용을 관리할 수 있어요.
Agent 컨텍스트 자동 압축 구현 방식 비교
| 방식 | 핵심 특징 | 적합한 상황 | 사용 가능 플랫폼 |
|---|---|---|---|
| 클라이언트 수동 압축 | messages를 직접 구성하고 요약 로직을 완전히 제어 |
자체 개발 Agent, 요약 템플릿 커스터마이징 | APIYI apiyi.com, 각 공식 API |
| 서버 측 임계값 압축 | Responses API의 compact_threshold 등이 해당 |
클라이언트의 상태 관리 부담을 줄이고 싶을 때 | 해당 인터페이스를 지원하는 플랫폼 |
| 프레임워크 내장 압축 | Agents SDK, Tool Runner가 자동으로 관리 | 프로토타입 구축, 범용 작업 | 해당 SDK에 의존 |
| 새 세션 시작 | 수동으로 요약한 뒤 새 창 열기 | Codex 등 클라이언트의 일상적인 사용 | 모든 클라이언트 |
클라이언트 수동 압축은 제어력이 뛰어나지만, 토큰 집계와 요약 품질을 직접 관리해야 해요. 서버 측 압축은 대화 기록을 직접 구성할 필요가 없지만, 요약의 세부 과정은 개발자에게 공개되지 않아요. 자체 개발 Agent라면 ‘클라이언트 구조화 요약 + 임계값 기반 보완’을 함께 적용하는 편이 보통 더 안정적이에요.
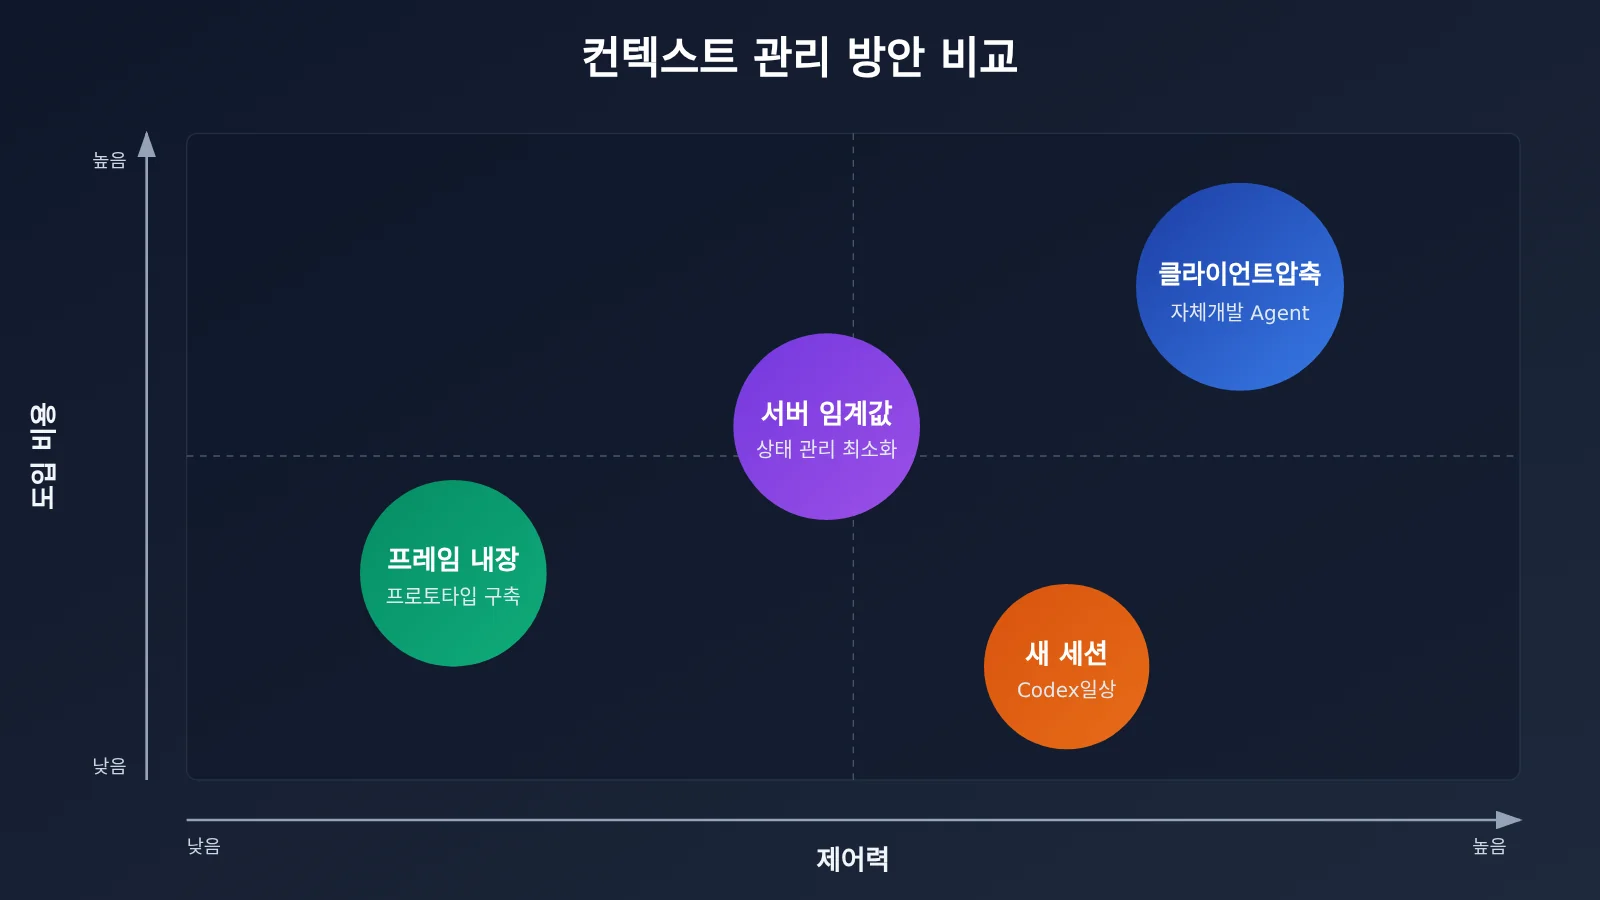
Agent 컨텍스트 자동 압축과 캐시 비용의 관계
압축하면 무조건 비용이 절약될 것 같지만, 프롬프트 캐싱도 고려해야 해요. APIYI의 OpenAI 캐시 요금 안내에 따르면, 캐시에 적중한 입력 부분에는 입력 요금의 10%가 적용돼요. 긴 대화에서 이전 대화의 접두부가 바뀌지 않으면 캐시에 적중하기 쉬워서, 매 턴 새로 추가되는 ‘정가’ 토큰은 사실 많지 않아요.
하지만 압축을 실행하면 메시지 접두부가 새로운 요약으로 대체돼요. 그러면 다음 요청에서는 캐시가 적중하지 않아 한 번은 정가로 다시 처리해야 해요. 이것이 공식 문서에서 ‘매 턴마다 압축’하지 말라고 권장하는 이유예요. 너무 자주 압축하면 캐시가 반복해서 끊겨, 오히려 압축하지 않을 때보다 비용이 더 들 수도 있어요. 한 단계 동안 대화 기록을 안정적으로 늘려 캐시를 충분히 활용한 뒤, 단계가 끝나거나 임계값에 가까워졌을 때 한 번에 압축하는 편이 더 합리적이에요.
자주 묻는 질문 FAQ
Q1: Agent 컨텍스트 자동 압축이란 무엇인가요?
컨텍스트가 일정 Token 양에 도달하거나 작업 단계가 끝났을 때, 이전 대화와 도구 호출 기록을 작업 상태 요약으로 압축해 원본 기록을 대체하는 방식이에요. 매번 입력되는 Token을 줄이면서도 진행 상황, 사실, 결정 사항, 다음 할 일을 보존해 Agent가 작업을 이어갈 수 있게 해요.
Q2: 컨텍스트 압축과 대화 기록을 단순히 잘라내는 것은 어떻게 다른가요?
잘라내기는 가장 오래된 메시지를 삭제하는 방식이에요. 구현은 간단하지만 사용자의 초기 요구사항과 제약 조건을 잃을 수 있어요. 반면 압축은 모델로 기록을 구조화된 요약으로 정리하므로 정보를 훨씬 더 많이 보존해요. 다만 요약을 위한 모델 호출이 한 번 더 필요하고, 압축 후에는 캐시를 다시 구축해야 해요.
Q3: “80%를 사용하면 압축한다”는 공통 규칙이 있나요?
없어요. 공식 문서에서는 주로 Token 수 임계값으로 실행 조건을 정해요. 예를 들어 Anthropic Messages API의 기본값은 150,000, 최솟값은 50,000이며, Tool Runner의 기본값은 100,000이에요. 사용하는 모델의 컨텍스트 윈도우 크기와 한 번에 반환되는 도구 출력의 양을 고려해 임계값을 설정하세요.
Q4: Codex에서는 언제 새 창을 여는 게 좋나요?
하나의 작업 단계가 완전히 끝난 후에 새 창을 여는 것이 좋아요. 예를 들어 기능 개발을 마치고 테스트까지 통과한 시점이에요. 새 창을 열기 전 Agent에게 “목표 / 진행 상황 / 사실 / 결정 사항 / 다음 할 일” 형식으로 요약을 요청해 새 대화의 첫머리에 붙여 넣으세요. 현재 작업과 관계없는 새 주제로 넘어갈 때도 새 창을 열어 불필요한 기록이 사용량을 계속 차지하지 않도록 하세요.
Q5: 클라이언트에 컨텍스트 사용량이 표시되지 않으면 Token 소비량을 어떻게 확인하나요?
API 수준에서 확인할 수 있어요. OpenAI Codex 사용 사례 문서에 따라 Codex의 API를 APIYI에 연결하면, 호출할 때마다 APIYI apiyi.com 관리 화면에 상세 로그와 사용량 통계가 기록돼요. 긴 대화에서 매번 입력 Token이 얼마나 늘어나는지 확인하고, 압축하거나 새 대화를 시작할 시점을 판단할 수 있어요.
Q6: 압축 전략의 효과를 빠르게 검증하려면 어떻게 하나요?
이 글의 전체 코드를 사용해 같은 다단계 작업을 “압축 안 함”, “임계값 압축”, “단계별 압축” 세 가지 모드로 실행하고, 총 Token 소비량과 작업 완료 품질을 비교해 보세요. APIYI apiyi.com에서는 하나의 키로 주 모델과 요약 모델에 서로 다른 공급업체의 모델을 사용할 수 있어 비용과 품질의 균형점을 찾기 편해요.
Q7: 컨텍스트 압축에는 어떤 한계가 있나요?
첫째, 요약에서 세부 사항이 빠질 수 있어요. 특히 코드의 눈에 띄지 않는 설정값이 누락될 수 있어요. 둘째, 압축할 때마다 캐시가 무효화되므로 자주 압축하면 비용이 늘어나요. 셋째, 요약 모델이 가끔 존재하지 않는 정보를 만들어낼 수 있어요. 이를 방지하려면 구조화된 템플릿을 사용하고, 사용자 제약 조건은 원문 그대로 보존하세요. 파일 경로 같은 핵심 정보는 요약에만 의존하지 말고 별도의 작업 노트 파일에도 기록하세요.
Agent 컨텍스트 자동 압축 핵심 요약 Key Takeaways
- 압축의 본질: 긴 대화 기록을 단순히 삭제하는 게 아니라, 작업을 계속할 수 있는 상태로 정리하는 거예요.
- 세 가지 실행 시점: 토큰 임곗값을 안전장치로 활용하거나, 단계가 끝날 때 직접 압축하거나, 프레임워크가 컨텍스트 부담에 따라 관리해요.
- 80% 규칙은 없어요: 공식 기준은 토큰 수 임곗값이며, 컨텍스트 윈도우와 도구 출력 크기에 맞춰 설정해야 해요.
- 구조화된 요약: 목표, 진행 상황, 사실, 결정 사항, 다음 단계의 다섯 항목으로 정리하고, 사용자 제약 조건은 원문 그대로 보존해요.
- 매 차례 압축하지 마세요: 너무 자주 압축하면 캐시가 무효화될 수 있어요. 단계별로 모아서 압축하는 편이 비용을 줄이는 데 도움이 돼요.
- 로그로 사각지대 보완하기: 클라이언트에 사용량이 표시되지 않는다면 APIYI apiyi.com 호출 로그에서 매 차례 토큰이 얼마나 늘어나는지 확인할 수 있어요.
정리
Agent 컨텍스트 자동 압축의 핵심은 다음과 같아요.
- 실행 시점: 단계가 끝날 때 직접 압축하고, 토큰 임곗값은 안전장치로 활용하세요. 빠르게 시작하려면 프레임워크의 내장 정책도 좋아요.
- 요약 전략: 시스템 프롬프트와 최근 몇 차례의 원문은 유지하고, 이전 기록은 다섯 항목으로 구조화해 요약하세요.
- 비용 균형: 압축하면 캐시가 무효화되므로, “단계 내에서는 안정적으로 늘리고, 단계가 끝나면 한꺼번에 압축하는” 방식이 좋아요.
평소 Codex를 사용한다면 “단계를 마칠 때마다 요약하고 새 창을 열기”를 수동 압축 방식으로 활용할 수 있어요. 자체 Agent를 개발 중이라면 이 글의 코드를 직접 수정해 보세요. APIYI apiyi.com에서는 무료 테스트 크레딧과 여러 모델을 위한 통합 인터페이스를 제공해 효과를 빠르게 검증할 수 있어요. 호출 로그를 함께 살펴보면 압축 전후의 토큰 변화도 명확하게 확인할 수 있어요.
📚 참고 자료
- OpenAI Responses API 문서: 컨텍스트 압축과
compact_threshold설정 안내 - 링크:
platform.openai.com/docs/api-reference/responses -
설명: 서버 측 자동 압축과 상태 관리에 관한 공식 안내
-
OpenAI Agents SDK 문서: 에이전트 실행 중 컨텍스트 관리 전략
- 링크:
openai.github.io/openai-agents-python -
설명: 자동 압축, 고정 임계값, 강제 압축 등의 전략 설정 방법
-
Anthropic 컨텍스트 압축 문서: Messages API와 Tool Runner의 압축 트리거 매개변수
- 링크:
docs.anthropic.com - 설명:
trigger.value와context_token_threshold의 기본값 및 필요에 따른 압축 방법
작성자: APIYI 기술팀
기술 문의: APIYI 웹사이트 홈페이지에서 문의해 주세요. Codex 설정, 다중 턴 대화, 캐시 과금 등에 관한 자세한 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있어요.