gemini-3.1-pro-preview から Gemini 4 Argon に切り替えたところ、同じプロンプトでも Argon の回答がかえって「浅く考えている」と感じる開発者が少なくありません。原因は、Gemini 4 Argon の推論強度のデフォルト設定にある可能性が高いでしょう。Google の公式ドキュメントによると、Gemini 4 Argon のデフォルトの thinking_level は high ではなく mediumです。一方、gemini-3.1-pro-preview はデフォルトで最上位の high に設定されています。コードやクライアントで推論強度を明示的に指定していなければ、移行後にモデルの思考の深さがひそかに一段階下がってしまいます。
さらに厄介なのが、Cherry Studio などの一般的なチャットクライアントでは、新しいモデルの推論パラメーターへの対応が遅れがちな点です。設定画面に推論強度の項目自体が表示されないこともあります。この記事では、まず Gemini 4 Argon の推論強度の選択肢、デフォルト値、料金への影響を整理し、そのうえでネイティブ API、OpenAI 互換 API、Cherry Studio のカスタムパラメーターという3つの設定方法を紹介します。
この記事でわかること:どのような方法で呼び出す場合でも Gemini 4 Argon の推論強度を希望のレベルに設定でき、max_tokens による出力の途中切れやパラメーターの400エラーといった移行時の落とし穴を避けられます。
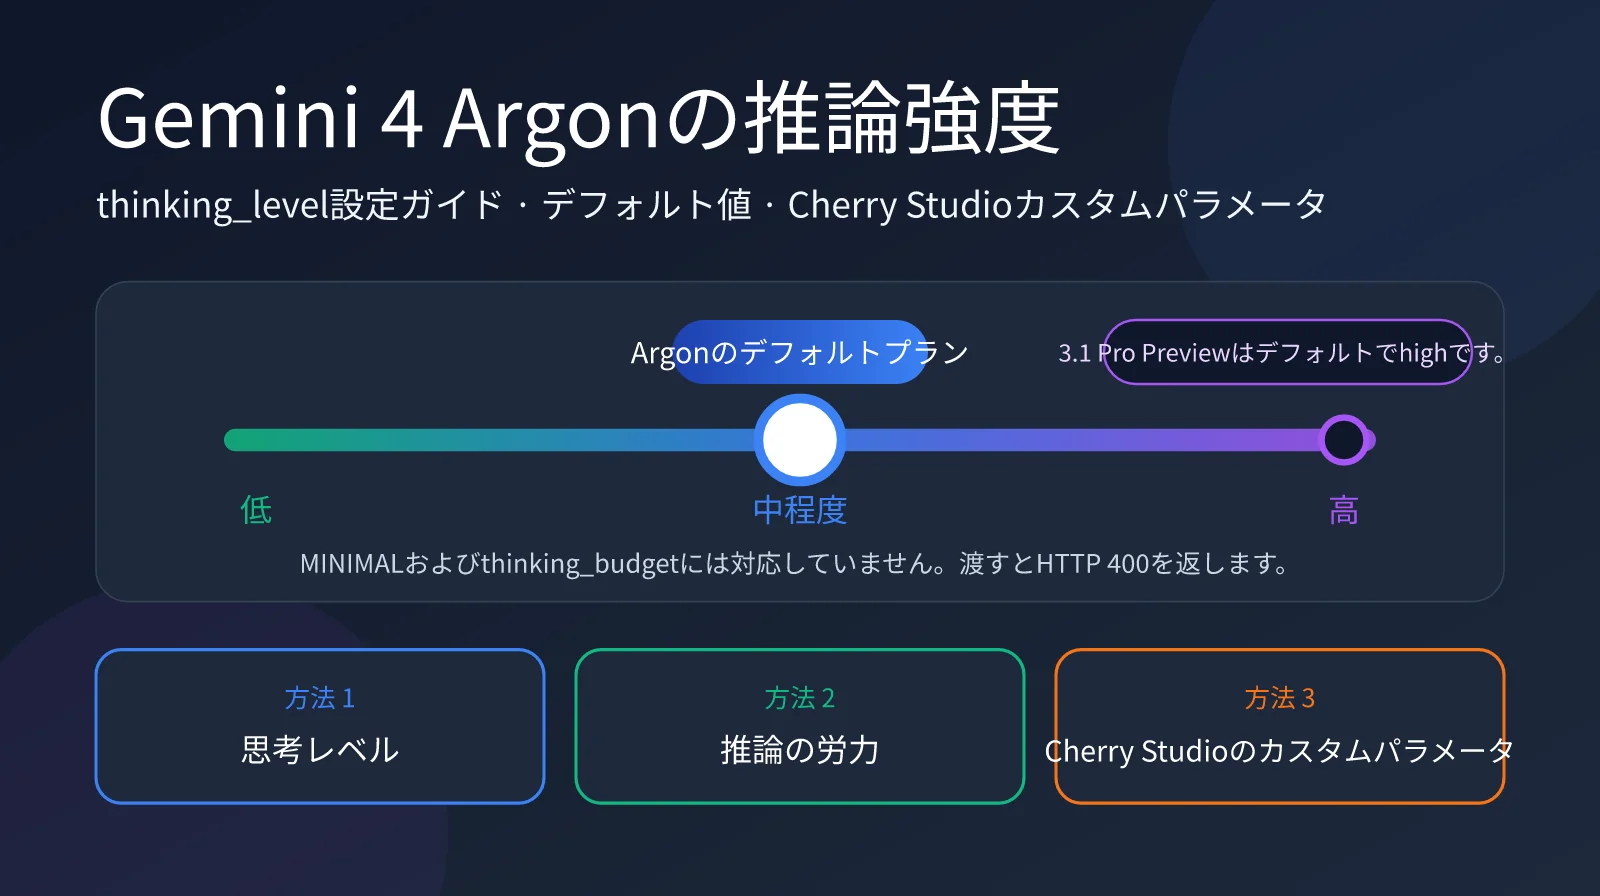
Gemini 4 Argon の推論強度:押さえておきたいポイント
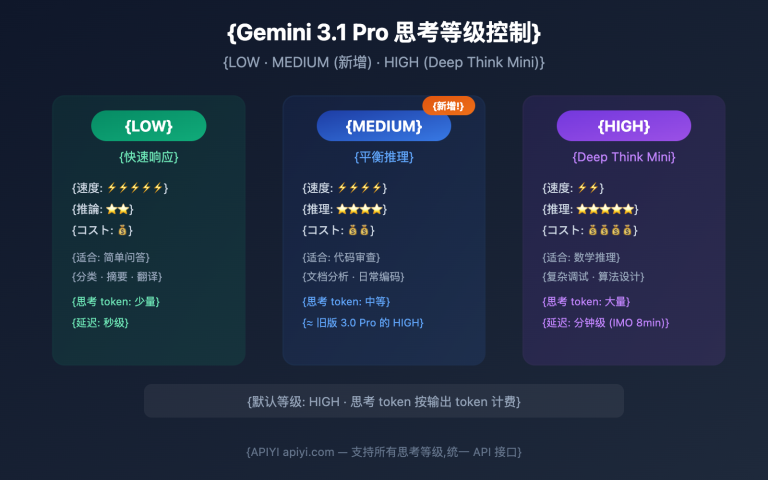
Gemini 4 Argon では、thinking_level パラメーターを使って推論強度を制御します。選べるのは low、medium、high の3段階です。前世代のモデルにあったトークン数指定の thinking_budget は廃止され、minimal もサポートされていません。これらを設定すると、HTTP 400 エラーが返されます。次の表に、Google Cloud の開発者向けガイドに記載された各レベルの説明をまとめました。
| 推論レベル | デフォルトか | 公式の推奨用途 | 特徴 |
|---|---|---|---|
| LOW | いいえ | 分類、要約、メタデータ抽出 | レイテンシが最も低く、思考トークンはほとんど発生しない |
| MEDIUM | ✅ gemini-4-argon のデフォルト | 一般的なプログラミング、ツール呼び出し、ドキュメントに関する質問、動画理解 | 速度・コスト・精度のバランスが取れている |
| HIGH | ✅ cyber-permissive 版のデフォルト | 複数ファイルにまたがるソフトウェア開発、形式証明、アーキテクチャ設計、脆弱性の発見 | 最も深く思考する。最初のトークンが返るまでの時間とコストが大きく増加する |
| MINIMAL | 非対応 | — | 設定すると HTTP 400 エラーが返る |
| thinking_budget | 非対応 | — | 前世代では暗黙的に変換される場合があったが、Argon では400エラーが返る |
注意したいのは、Fairwind 計画でネットワーク防御を担う組織向けの gemini-4-argon-cyber-permissive はデフォルトが HIGH である一方、標準版の gemini-4-argon は MEDIUM だという点です。また、Google の評価表に掲載された Argon のスコアは、すべて最高の推論レベルで実行した結果です。デフォルトの medium で呼び出すと、実際の性能が公式発表の水準に届かない可能性があります。
Gemini 4 Argon の推論強度のデフォルト値と前世代モデルとの比較
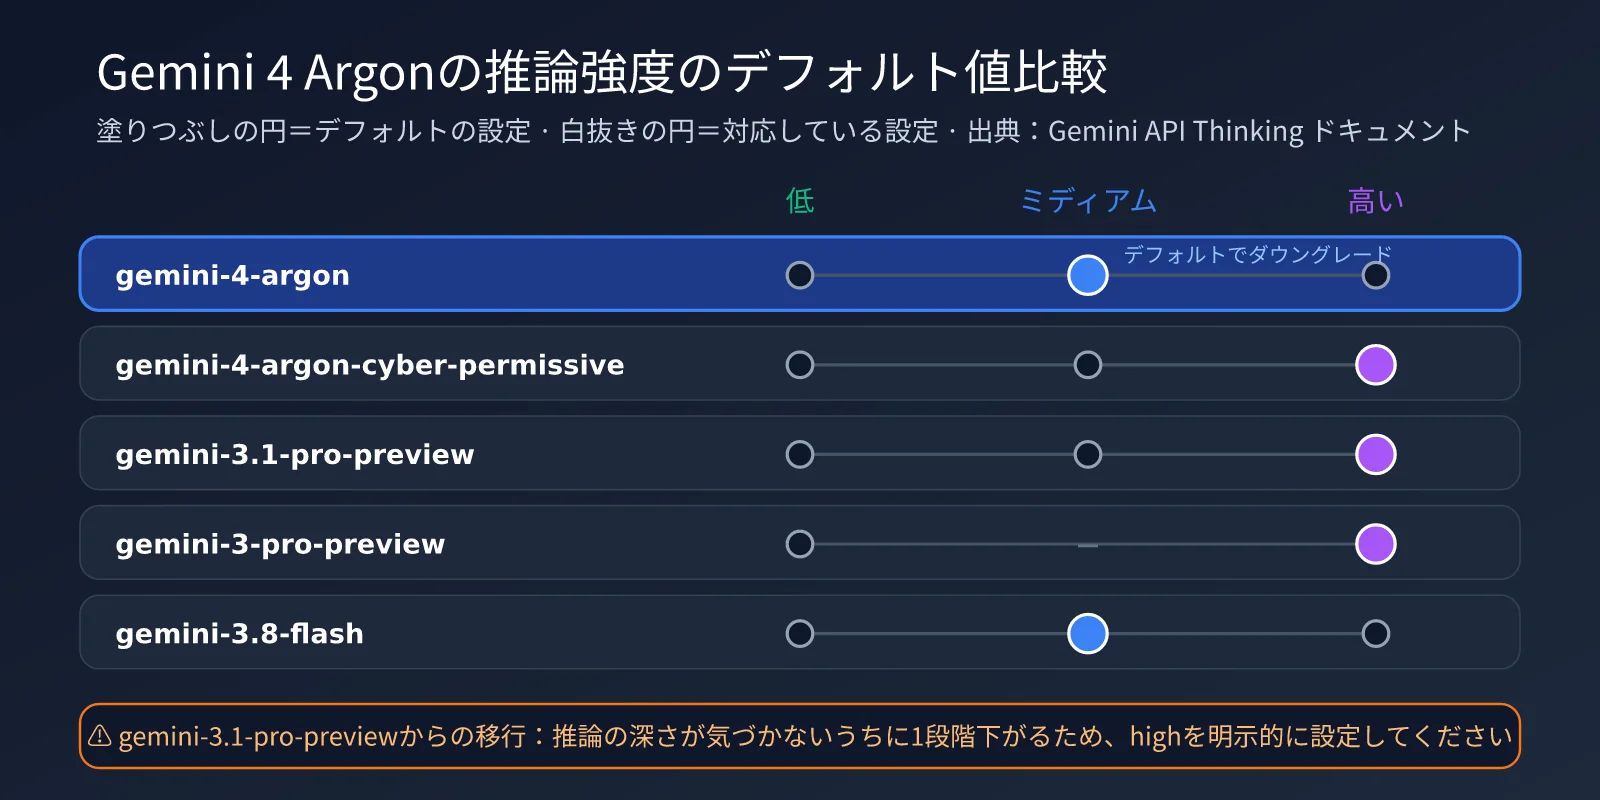
Gemini 4 Argon と最近の Gemini モデルの推論レベルのデフォルト値を並べると、移行時に注意すべき点が見えてきます。以下のデータは、Google Gemini API の公式 thinking ドキュメントに基づいています。
| モデル | デフォルトの推論レベル | 対応レベル |
|---|---|---|
| gemini-4-argon | medium | low、medium、high |
| gemini-4-argon-cyber-permissive | high | low、medium、high |
| gemini-3.1-pro-preview | high | low、medium、high |
| gemini-3-pro-preview | high | low、high |
| gemini-3.8-flash | medium | low、medium、high |
| gemini-3-flash-preview | high | minimal、low、medium、high |
ご覧のとおり、Google は新世代モデルのデフォルトの推論レベルを high から medium に引き下げる傾向にあります。Gemini 3.8 Flash と Gemini 4 Argon も同様です。これによりデフォルトのレイテンシとコストを抑えられますが、3.1 Pro の「デフォルトで最大限に考える」動作に慣れている場合は、Argon への移行時に high を明示的に設定しないと、従来と同じ推論の深さを保てません。
🎯 移行時のアドバイス:gemini-3.1-pro-preview から Gemini 4 Argon に移行する場合は、まずコードで推論レベルを明示し、2つのモデルの出力品質を比較するのがおすすめです。APIYI(apiyi.com)の統合インターフェースを使えば、model パラメーターを変更するだけで新旧の Gemini モデルを呼び出し、A/B テストを実施できます。
Gemini 4 Argon の推論強度と料金の関係
推論強度は回答の品質だけでなく、料金にも直接影響します。Argon の思考トークンは出力料金で課金され、試用期間中は100万トークンあたり10ドル、正式料金は20ドルです。一方、思考の過程はデフォルトではユーザーにすべて表示されるわけではありません。つまり、推論レベルを上げるほど、「見えない思考」に対する費用も増えていきます。
試用価格で概算すると、high レベルのリクエストで思考トークンが1,500個発生した場合、思考分だけで約0.015ドルの追加料金がかかります。1日1万回呼び出すと、1か月で追加費用はおよそ4,500ドルになります。Google が Argon のデフォルトを medium に引き下げたのは、こうした事情もあるでしょう。日常的なリクエストの大半は最も深い推論を必要とせず、デフォルトを high にすると、多くのユーザーが不要な思考に料金を支払うことになるからです。タスクに応じて推論レベルを使い分け、すべてのリクエストで high に固定しないほうが合理的です。
Gemini 4 Argonの推論強度を設定する3つの方法
Gemini 4 Argonの推論強度は、呼び出し方法に応じて3つの方法で設定できます。GoogleネイティブSDKの thinking_level、OpenAI互換インターフェースの reasoning_effort、そして extra_body によるGoogleネイティブパラメーターの透過です。これらを同時に使用することはできず、エラーになります。
| 設定方法 | パラメーターの場所 | 設定値 | 適した用途 |
|---|---|---|---|
| ネイティブの thinking_level | thinking_config.thinking_level |
LOW / MEDIUM / HIGH | Google GenAI SDK、Vertex AI |
| OpenAI互換の reasoning_effort | リクエストボディのトップレベル reasoning_effort |
minimal / low / medium / high | OpenAI SDK、各種互換クライアント |
| extra_bodyによる透過 | extra_body.google.thinking_config |
low / medium / high | 思考の要約など、ネイティブオプションも有効にしたい場合 |
OpenAI互換インターフェースの reasoning_effort は、Argonの thinking_level にマッピングされます。Google公式の対応表では、minimal と low は low、medium は medium、high は high にマッピングされます。ただし、OpenAIやAnthropicで使われる xhigh や max などの上位レベルはArgonでは認識されず、指定すると400エラーが返されます。
方法1:ネイティブSDKでthinking_levelを設定する
Google GenAI SDKでは、ThinkingConfig でレベルを直接指定します。Vertex AIのエンドポイントでは、global、us、eu の3つのリージョンを利用できます。
from google import genai
from google.genai import types

client = genai.Client(enterprise=True, project="YOUR_PROJECT", location="global")

resp = client.models.generate_content(
    model="gemini-4-argon",
    contents="为多生产者单消费者场景设计一个无锁环形缓冲区",
    config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_level="HIGH"),
        max_output_tokens=32768,
    ),
)
print(resp.text)
方法2:OpenAI互換インターフェースでreasoning_effortを設定する
OpenAI SDKを使っているプロジェクトでは、互換インターフェース経由でArgonを呼び出すのが、変更を最小限に抑えられる方法です。reasoning_effort パラメーターを追加するだけで使えます。
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

resp = client.chat.completions.create(
    model="gemini-4-argon",
    reasoning_effort="high",      # 映射为 thinking_level=high
    max_tokens=32000,             # 必须为思考 token 预留空间
    messages=[{"role": "user", "content": "审查这段并发代码的竞态条件"}],
)
print(resp.choices[0].message.content)
print(resp.usage)
コード全体を表示:extra_bodyによる透過と3段階の比較テスト
import time
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")
PROMPT = "一个 Kubernetes Pod 一直处于 CrashLoopBackOff,请给出系统的排查步骤和命令"


def call_with_effort(level: str):
    """方式二:OpenAI 兼容的 reasoning_effort"""
    start = time.time()
    resp = client.chat.completions.create(
        model="gemini-4-argon",
        reasoning_effort=level,
        max_tokens=32000,
        messages=[{"role": "user", "content": PROMPT}],
    )
    return resp, time.time() - start


def call_with_extra_body(level: str):
    """方式三:extra_body 透传 Google 原生 thinking_config
    注意:不能与 reasoning_effort 同时使用"""
    return client.chat.completions.create(
        model="gemini-4-argon",
        max_tokens=32000,
        messages=[{"role": "user", "content": PROMPT}],
        extra_body={
            "google": {
                "thinking_config": {
                    "thinking_level": level,
                    "include_thoughts": True,
                }
            }
        },
    )


if __name__ == "__main__":
    for level in ("low", "medium", "high"):
        resp, cost_time = call_with_effort(level)
        u = resp.usage
        print(f"[{level:6}] 耗时 {cost_time:5.1f}s | 输出 {u.completion_tokens} token")
💡 呼び出しのヒント:OpenAI互換インターフェースを使うと、Gemini 4 Argonを手軽に導入できます。OpenAI SDKを使った既存コードも、ほとんど変更せずに利用できます。テスト用の利用枠はAPIYI(apiyi.com)で用意できます。まずは上記の3段階比較スクリプトを使って、代表的なタスクで推論強度による違いを確認してみましょう。
Cherry StudioでGemini 4 Argonの推論強度を設定する
Cherry Studioの入力欄右下には推論強度のドロップダウンメニューがあります。ただし、この項目が表示されるのは、クライアントが推論モデルとして認識しているモデルのみです。コミュニティのIssueによると、Cherry Studioは推論強度に対応しているかどうかを、ビルド時にmodels.devとOpenRouterから生成した内蔵モデルカタログに基づいて判定します。インターフェースから実行時に返される機能情報は参照しません。そのため、Gemini 4 Argonのような新しいモデルは、クライアントのモデルカタログが更新されるまではドロップダウンメニューに表示されないことがあります。また、項目を選択できても反映されない場合があります。
その場合は、Cherry Studioのカスタムパラメーター機能を使うのが最も確実です。公式ドキュメントによると、カスタムパラメーターはリクエストボディに直接追加され、内蔵パラメーターより優先されます。
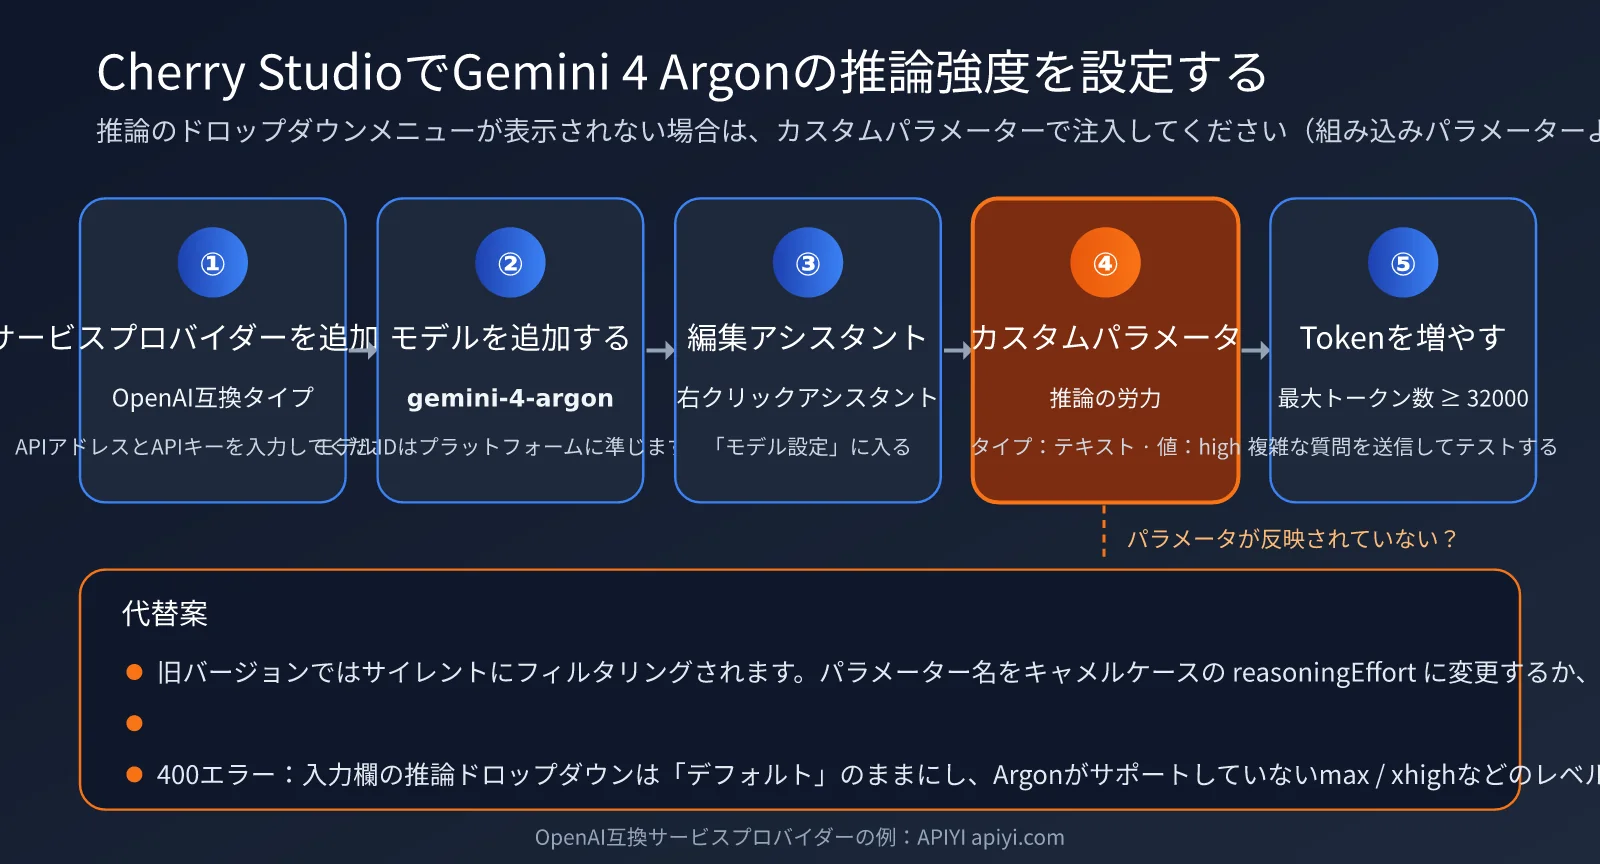
Cherry Studioでカスタムパラメーターを設定する手順
OpenAI互換タイプのプロバイダーを例に、設定手順を説明します。
- プロバイダーを追加する:設定画面でOpenAI互換タイプのプロバイダーを追加し、APIアドレスとAPIキーを入力します。たとえば、APIYIの
https://api.apiyi.comを指定します。 - モデルを追加する:プロバイダーの設定にモデルID
gemini-4-argonを追加します。 - アシスタントの設定を開く:アシスタント一覧で対象のアシスタントを右クリックし、「アシスタントを編集」を選択して、「モデル設定」タブに切り替えます。
- カスタムパラメーターを追加する:パラメーター名に
reasoning_effort、種類に「テキスト」、値にhigh(またはlow、medium)を指定します。 - 出力上限を増やす:「最大Token数」を有効にして上限を増やします。思考用の領域を確保するため、少なくとも32000を推奨します。
- テストする:複数段階の推論が必要な問題を使い、設定前後で応答時間と思考内容を比較します。
上記の手順で設定しても推論強度が反映されない場合は、次のよくある原因を確認してください。
| 状況 | 考えられる原因 | 解決方法 |
|---|---|---|
| reasoning_effortを設定しても変化がない | 古いバージョンでは、OpenAI互換モードでこのパラメーターが警告なしに除外されることがある | 最新版にアップデートするか、パラメーター名を reasoningEffort に変更する |
| 入力欄に推論強度のドロップダウンメニューが表示されない | 内蔵モデルカタログにArgonが登録されていない | カスタムパラメーターを使う。上級者はモデル設定に推論機能の情報を追加できる |
| リクエストで400エラーが返される | クライアントがArgon非対応のmax、xhighなどのレベルを送信している | ドロップダウンメニューを「デフォルト」のままにし、カスタムパラメーターでlow/medium/highを指定する |
| 内蔵設定でパラメーターが上書きされる | 入力欄の推論オプションとカスタムパラメーターが競合している | 入力欄は「デフォルト」のままにし、両方で同時に設定しない |
| ネイティブパラメーターを透過したい | 思考の要約も有効にしたい | JSON型の extra_body パラメーターを追加し、値に {"google": {"thinking_config": {"thinking_level": "high"}}} を指定する |
reasoning_effort が警告なしに除外される問題は、Cherry Studioで2026年3月にPRによる修正が行われています。新しいバージョンでは、内部で使われる reasoningEffort に自動変換されます。古いバージョンを使っている場合は、パラメーター名をキャメルケースの reasoningEffort にすれば、このフィルタリングを回避できます。
Cherry Studio以外の一般的なチャットクライアントでも、基本的な方法は同じです。「カスタムパラメーター」「追加リクエストボディ」「詳細パラメーター」などの項目を探し、リクエストボディのトップレベルフィールドとして reasoning_effort を追加します。JSON形式しかサポートしていない場合は、extra_body を使ってネイティブの thinking_config を透過します。設定後は、同じ複雑な問題を使って応答時間とトークン消費量を比較し、パラメーターが反映されていることを確認しましょう。
🚀 クライアントのおすすめ設定:Cherry StudioでGemini 4 Argonを使う場合は、OpenAI互換タイプのプロバイダーを選ぶと、パラメーターを安定して透過できます。APIYI(apiyi.com)はOpenAI互換の統一インターフェースを提供しているため、Cherry Studioで一度設定すれば、Gemini、Claude、GPTなどの各シリーズのモデルを利用できます。
Gemini 4 Argonの推論強度を実測:設定時の注意点
推論強度は、レイテンシやコスト、出力品質に直接影響します。第三者の技術ブログComputingForGeeksがArgonを使って運用タスクを比較テストしており、参考になる結果が公開されています。
| テスト項目 | デフォルト(medium) | high | 差 |
|---|---|---|---|
| 平均出力トークン数 | 463 | 1,836 | 約4倍 |
| 平均レイテンシ | 5.5秒 | 15.3秒 | 約2.8倍 |
| 最初に表示されるトークン | 約4.3秒 | 12~13秒 | 先に約1,400個の思考トークンを出力 |
| 9回の呼び出しコスト(お試し価格) | $0.045 | $0.169 | 約3.8倍 |
| low / mediumとデフォルトの比較 | ほぼ同じ | — | 短いタスクでは、いずれも思考トークンは発生せず |
この結果から、2つのことがわかります。1つ目は、簡単で短いタスクではlow、medium、デフォルトの設定にほとんど差がなく、思考トークンも発生しないことです。実際に「深く考える」のはhighのみです。2つ目は、highには明確なコストが伴うことです。コストは約4倍になり、最初のトークンが表示されるまでの時間も約8秒長くなります。ただし、このテストの対象は短いプロンプトに限られています。複雑で長いタスクでは、mediumでも思考プロセスが発生する場合があります。
Gemini 4 Argonの推論強度設定でよくある4つの落とし穴
Googleの移行ガイドとコミュニティでの実測結果を踏まえると、Gemini 4 Argonの推論強度を設定する際に特に注意したい点は次のとおりです。
- max_tokensが小さすぎると空の応答になる:
max_output_tokensには、思考トークンと本文のトークンの両方が含まれます。実測では、highとmax_tokensの値1024を組み合わせたところ、Argonが1021個のトークンをすべて思考に使い、最終的に空文字列を返しました。終了理由はMAX_TOKENSでした。highを使う場合は、少なくとも16K~32Kの余裕を確保してください。 - thinking_budgetをそのまま使うとエラーになる:gemini-3.1-pro-previewでは
thinking_budgetが設定レベルに暗黙的にマッピングされますが、Argonでは400エラーが返されます。移行時には必ず削除してください。 - temperatureなどのサンプリングパラメータが無視される:Googleのドキュメントによると、Argonのバックエンドではカスタムのtemperatureが無視されます。また、
frequency_penalty、presence_penalty、candidate_countは400エラーになります。思考の深さは推論レベルで調整し、出力形式はresponse_schemaで指定するのがおすすめです。 - コスト削減のためにmax_tokensを減らすと逆効果:コストやレイテンシを抑えたい場合、Googleはmax_tokensを小さくするのではなく、推論レベルを下げるよう推奨しています。max_tokensを減らすと、出力が途中で切れてしまうおそれがあります。
📊 推論レベルの選び方:日常的な質問や簡単なプログラミングには、デフォルトのmediumで十分です。複雑なアーキテクチャ設計や複数ファイルのリファクタリング、数学的な証明などにはhighを使いましょう。APIYI(apiyi.com)の呼び出しログで各レベルのトークン消費量を比較すると、品質とコストのバランスが取れた設定を見つけやすくなります。
よくある質問
Q1:Gemini 4 Argonの推論強度は、デフォルトでhighですか?
いいえ。標準版の`gemini-4-argon`はデフォルトでmediumです。highがデフォルトなのは、ネットワーク防御側を対象とする`gemini-4-argon-cyber-permissive`のみです。この点は、デフォルトで最高レベルのhighが設定されているgemini-3.1-pro-previewとは異なります。最も強い推論能力を利用するには、`thinking_level=”high”`または`reasoning_effort=”high”`を明示的に設定してください。
Q2:Gemini 4 Argonの思考を無効にしたり、minimalに設定したりできますか?
できません。Argonが対応しているのはlow、medium、highの3段階のみです。minimalや`thinking_budget`を指定すると、HTTP 400エラーが返されます。OpenAI互換インターフェースで`reasoning_effort=”minimal”`を渡した場合は、lowにマッピングされます。レイテンシを極力抑えたい場合は、minimalに対応したGemini 3.x Flashシリーズなどのモデルを検討してください。
Q3:Cherry Studioに推論強度の項目が表示されない場合は、どうすればよいですか?
Cherry Studioの内蔵モデル一覧にArgonがまだ登録されていないためです。「アシスタントを編集 → モデル設定」から、カスタムパラメータとして`reasoning_effort`を追加し、種類をテキスト、値を`high`に設定してください。カスタムパラメータは内蔵パラメータより優先されます。パラメータを安定してそのまま転送するには、APIYI(apiyi.com)のようなOpenAI互換サービスがおすすめです。
Q4:推論強度が正しく反映されているか、どうすれば確認できますか?
最も簡単なのは、レスポンスに含まれるusageの出力トークン数と、レスポンスにかかった時間を確認する方法です。highでは、デフォルトより出力トークン数が多くなり、最初のトークンが表示されるまでの時間も明らかに長くなります。Cherry Studioでは、思考内容が表示されるかどうかも確認できます。同じ複雑な質問をデフォルトとhighでそれぞれ試し、結果を比較してみてください。
まとめ
Gemini 4 Argonの推論強度について、押さえておきたいポイントはデフォルトがmediumであり、highではないことです。デフォルトが最上位のgemini-3.1-pro-previewとは異なるため、移行時に明示的な設定を行わないと、モデルの思考の深さが意図せず1段階下がってしまいます。Argonで利用できるのはlow、medium、highの3段階のみです。thinking_budgetとminimalを指定すると400エラーが発生します。また、highを使う場合は、思考トークンのために十分なmax_tokensを確保してください。
呼び出し方法は、ネイティブSDKではthinking_level、OpenAI互換インターフェースではreasoning_effortを使用します。Cherry Studioなど、Argonの推論オプションにまだ対応していないクライアントでは、カスタムパラメーターを追加して指定できます。日常的なタスクではデフォルトのmediumを使い、複雑なタスクでは必要に応じてhighに切り替え、実測データをもとに適切な段階を判断するのがおすすめです。
APIYI(apiyi.com)のOpenAI互換インターフェースを利用してGemini 4 Argonに一元的に接続すれば、コードやCherry Studioなどのクライアントで、reasoning_effortという1つのパラメーターを使って推論強度を柔軟に切り替えられます。
参考資料:
- Google Gemini API Thinkingドキュメント: ai.google.dev/gemini-api/docs/thinking
- Google Gemini API OpenAI互換ドキュメント: ai.google.dev/gemini-api/docs/openai
- Google Cloud Gemini 4 Argon開発者ガイド: docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-argon
- Cherry Studioアシスタント設定ドキュメント: docs.cherryai.com.cn
- Cherry Studio GitHub Issues #11987、#19761: github.com/CherryHQ/cherry-studio
著者:APIYI Team | 大規模言語モデルの接続やパラメーター調整の実践情報を発信しています。AIモデルの接続方法に関する詳しい解説は、APIYI(apiyi.com)をご覧ください。