从 gemini-3.1-pro-preview 切换到 Gemini 4 Argon 后,不少开发者发现了一个问题:同样的提示词,Argon 的回答有时反而“想得更浅”。原因很可能在于 Gemini 4 Argon 推理强度的默认值。根据 Google 官方文档,Gemini 4 Argon 默认的 thinking_level 是 medium,而不是 high;而 gemini-3.1-pro-preview 默认就是最高档 high。如果你的代码或客户端从未显式设置推理强度,迁移后模型的思考深度就会悄悄降一档。
更麻烦的是,Cherry Studio 等常用对话客户端对新模型的推理参数支持往往滞后,输入框里的推理强度选项可能根本不出现。本文先讲清楚 Gemini 4 Argon 推理强度的取值、默认值和计费影响,再给出原生 API、OpenAI 兼容接口和 Cherry Studio 自定义参数三种设置方法。
核心价值:读完本文,你能在任何调用方式下把 Gemini 4 Argon 推理强度设到想要的档位,并避开 max_tokens 截断、参数 400 报错等迁移陷阱。
Gemini 4 Argon 推理强度核心要点
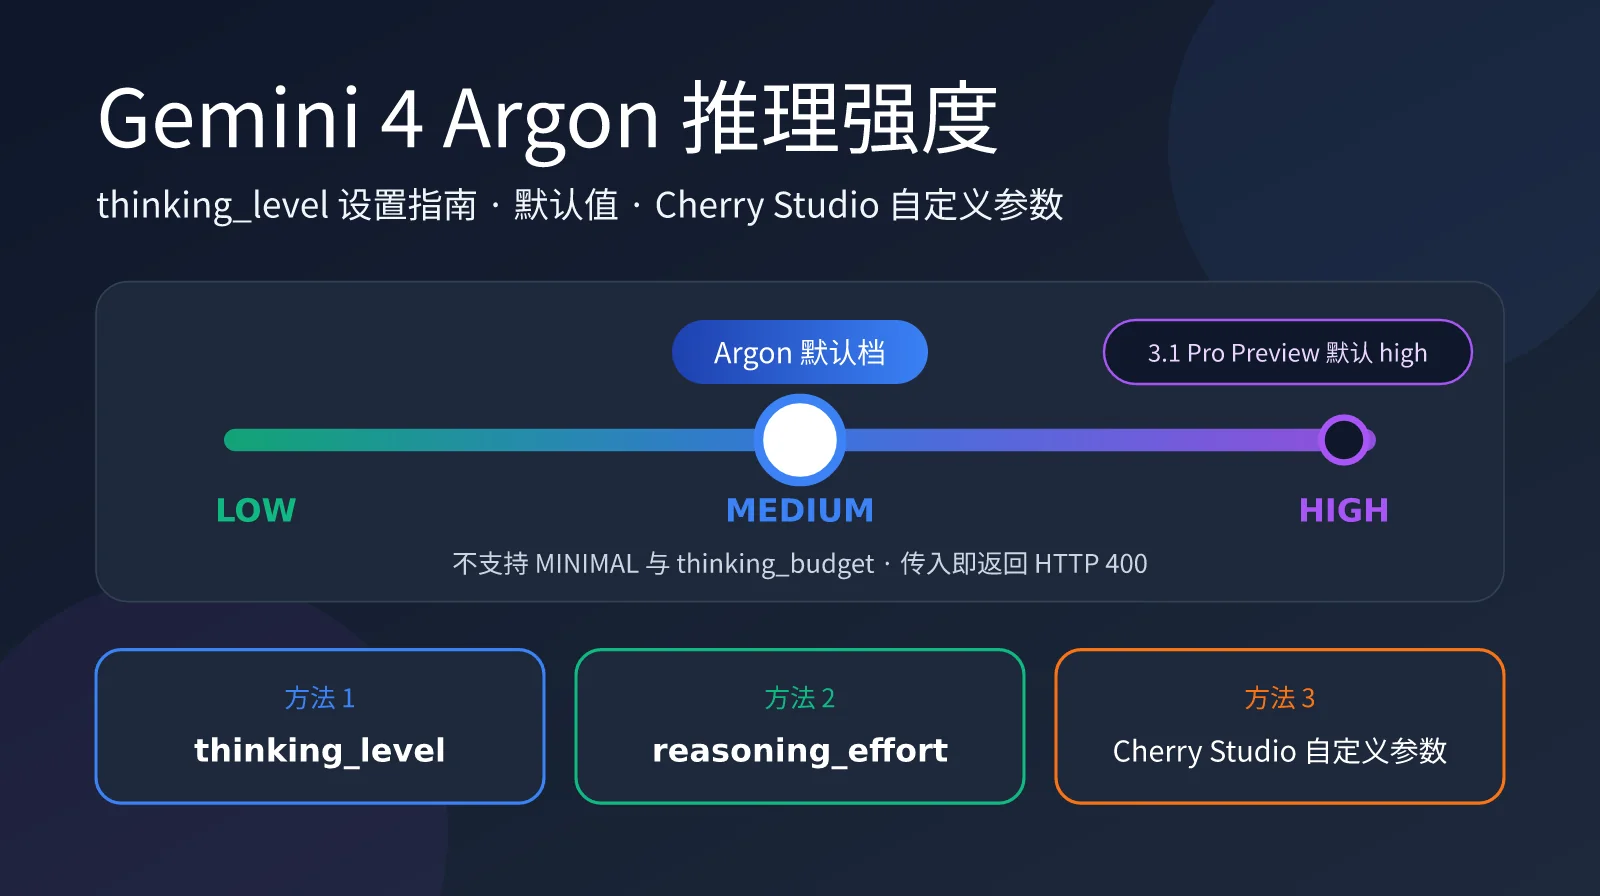
Gemini 4 Argon 通过 thinking_level 参数控制推理强度,只支持 low、medium、high 三档。和前代模型相比,它取消了按 token 数设置的 thinking_budget,也不支持 minimal 档位,设置这两者都会直接返回 HTTP 400 错误。下表整理了 Google Cloud 开发者指南中对三档的官方说明。
| 推理档位 | 是否默认 | 官方推荐场景 | 特点 |
|---|---|---|---|
| LOW | 否 | 分类、摘要、元数据提取 | 延迟最低,几乎不产生思考 token |
| MEDIUM | ✅ gemini-4-argon 默认 | 常规编程、工具调用、文档问答、视频理解 | 速度、成本和准确率的平衡点 |
| HIGH | ✅ cyber-permissive 版默认 | 多文件软件工程、形式化证明、架构设计、漏洞挖掘 | 思考最深,首 token 延迟和成本明显上升 |
| MINIMAL | 不支持 | — | 设置后返回 HTTP 400 |
| thinking_budget | 不支持 | — | 前代会被静默映射,Argon 直接返回 400 |
值得注意的是,面向 Fairwind 计划网络防御方的 gemini-4-argon-cyber-permissive 版本默认就是 HIGH,只有标准版 gemini-4-argon 默认是 MEDIUM。另外,Google 评测表中 Argon 的所有成绩都是在最高推理档位下跑出的。如果你按默认 medium 调用,实际表现可能达不到官方宣传的水平。
Gemini 4 Argon 推理强度默认值与前代对比
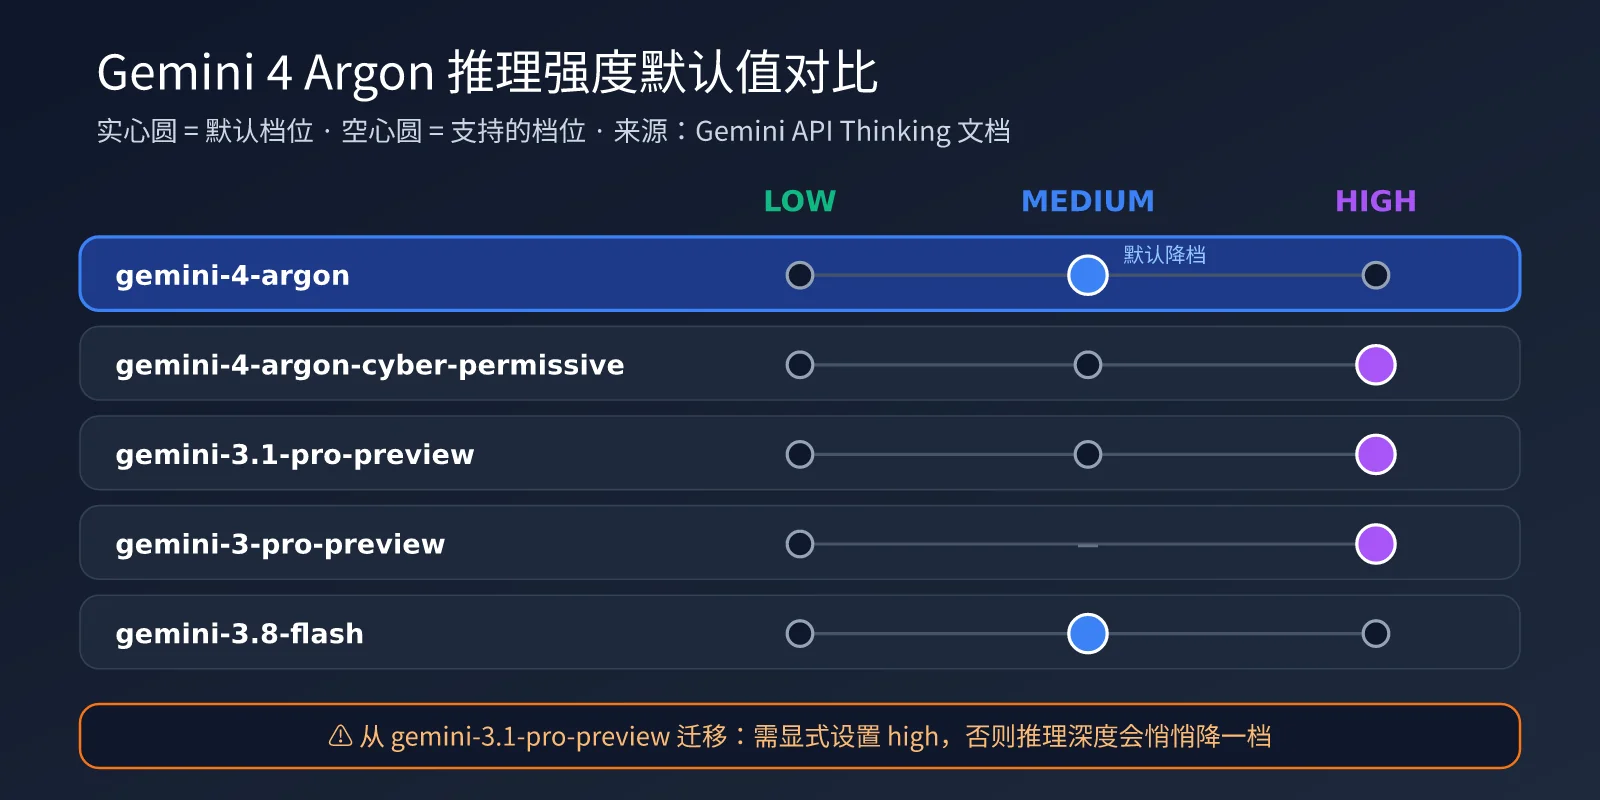
把 Gemini 4 Argon 和近期几款 Gemini 模型的推理默认值放在一起,就能看清迁移时的风险所在。以下数据来自 Google Gemini API 官方 thinking 文档。
| 模型 | 默认推理档位 | 支持的档位 |
|---|---|---|
| gemini-4-argon | medium | low、medium、high |
| gemini-4-argon-cyber-permissive | high | low、medium、high |
| gemini-3.1-pro-preview | high | low、medium、high |
| gemini-3-pro-preview | high | low、high |
| gemini-3.8-flash | medium | low、medium、high |
| gemini-3-flash-preview | high | minimal、low、medium、high |
可以看到,Google 正在把新一代模型的默认推理档位从 high 下调到 medium,Gemini 3.8 Flash 和 Gemini 4 Argon 都是如此。这样做可以降低默认延迟和成本,但对习惯了 3.1 Pro“默认全力思考”的用户来说,迁移到 Argon 时必须显式设置 high,才能保持原来的推理深度。
🎯 迁移建议:从 gemini-3.1-pro-preview 迁移到 Gemini 4 Argon 时,建议先在代码里显式写上推理档位,再对比两个模型的输出质量。通过 API易 apiyi.com 平台的统一接口,可以同时调用新旧两款 Gemini 模型做 A/B 对比,只需修改 model 参数。
Gemini 4 Argon 推理强度与计费的关系
推理强度不仅影响回答质量,也直接决定账单。Argon 的思考 token 按输出价格计费,尝鲜期每百万 token $10,正式价 $20,而思考过程在默认情况下并不会完整显示给用户。也就是说,档位越高,你为“看不见的思考”支付的费用就越多。
按尝鲜价粗略估算,一次 high 档请求如果产生 1500 个思考 token,仅思考部分就要多花约 $0.015;每天调用 1 万次,一个月下来就是 4500 美元左右的额外支出。这也是 Google 把 Argon 默认档下调到 medium 的现实考量:大部分日常请求并不需要最深的推理,默认 high 会让很多用户为用不上的思考付费。因此,更合理的做法是按任务类型分配档位,而不是全局固定为 high。
Gemini 4 Argon 推理强度的 3 种设置方法
根据调用方式不同,Gemini 4 Argon 推理强度有三种设置入口:Google 原生 SDK 的 thinking_level、OpenAI 兼容接口的 reasoning_effort,以及通过 extra_body 透传 Google 原生参数。三者不能同时使用,否则会报错。
| 设置方式 | 参数位置 | 可选值 | 适用场景 |
|---|---|---|---|
| 原生 thinking_level | thinking_config.thinking_level |
LOW / MEDIUM / HIGH | Google GenAI SDK、Vertex AI |
| OpenAI 兼容 reasoning_effort | 请求体顶层 reasoning_effort |
minimal / low / medium / high | OpenAI SDK、各类兼容客户端 |
| extra_body 透传 | extra_body.google.thinking_config |
low / medium / high | 需要同时开启思考摘要等原生选项 |
OpenAI 兼容接口中的 reasoning_effort 会被映射到 Argon 的 thinking_level。根据 Google 官方映射表,minimal 和 low 都映射为 low,medium 映射为 medium,high 映射为 high。但 OpenAI 和 Anthropic 使用的 xhigh、max 等更高档位 Argon 并不认识,传入后会直接返回 400。
方法一:原生 SDK 设置 thinking_level
使用 Google GenAI SDK 时,在 ThinkingConfig 中直接指定档位即可。Vertex AI 端点支持 global、us、eu 三个区域。
from google import genai
from google.genai import types

client = genai.Client(enterprise=True, project="YOUR_PROJECT", location="global")

resp = client.models.generate_content(
    model="gemini-4-argon",
    contents="为多生产者单消费者场景设计一个无锁环形缓冲区",
    config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_level="HIGH"),
        max_output_tokens=32768,
    ),
)
print(resp.text)
方法二:OpenAI 兼容接口设置 reasoning_effort
如果你的项目基于 OpenAI SDK,通过兼容接口调用 Argon 是改动最小的方式,只需加一个 reasoning_effort 参数。
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

resp = client.chat.completions.create(
    model="gemini-4-argon",
    reasoning_effort="high",      # 映射为 thinking_level=high
    max_tokens=32000,             # 必须为思考 token 预留空间
    messages=[{"role": "user", "content": "审查这段并发代码的竞态条件"}],
)
print(resp.choices[0].message.content)
print(resp.usage)
查看完整代码:extra_body 透传与三档对比测试
import time
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")
PROMPT = "一个 Kubernetes Pod 一直处于 CrashLoopBackOff,请给出系统的排查步骤和命令"


def call_with_effort(level: str):
    """方式二:OpenAI 兼容的 reasoning_effort"""
    start = time.time()
    resp = client.chat.completions.create(
        model="gemini-4-argon",
        reasoning_effort=level,
        max_tokens=32000,
        messages=[{"role": "user", "content": PROMPT}],
    )
    return resp, time.time() - start


def call_with_extra_body(level: str):
    """方式三:extra_body 透传 Google 原生 thinking_config
    注意:不能与 reasoning_effort 同时使用"""
    return client.chat.completions.create(
        model="gemini-4-argon",
        max_tokens=32000,
        messages=[{"role": "user", "content": PROMPT}],
        extra_body={
            "google": {
                "thinking_config": {
                    "thinking_level": level,
                    "include_thoughts": True,
                }
            }
        },
    )


if __name__ == "__main__":
    for level in ("low", "medium", "high"):
        resp, cost_time = call_with_effort(level)
        u = resp.usage
        print(f"[{level:6}] 耗时 {cost_time:5.1f}s | 输出 {u.completion_tokens} token")
💡 调用提示:OpenAI 兼容接口是接入 Gemini 4 Argon 最省事的方式,现有基于 OpenAI SDK 的代码基本不用改。推荐通过 API易 apiyi.com 获取测试额度,用上面的三档对比脚本先测一测你的典型任务在不同推理强度下的差异。
Cherry Studio 中设置 Gemini 4 Argon 推理强度
Cherry Studio 输入框右下角有一个推理强度下拉菜单,但这个选项只对客户端“认识”的推理模型显示。社区 issue 显示,Cherry Studio 判断模型是否支持推理强度,依赖的是构建时从 models.dev 和 OpenRouter 生成的内置模型目录,并不会读取接口运行时返回的能力信息。像 Gemini 4 Argon 这样刚发布的新模型,在客户端更新目录之前,下拉菜单很可能不显示,甚至出现选项能选但不生效的情况。
这种情况下,最可靠的办法是使用 Cherry Studio 的自定义参数功能。按官方文档的说明,自定义参数会被直接加入请求体,并且优先级高于内置参数。
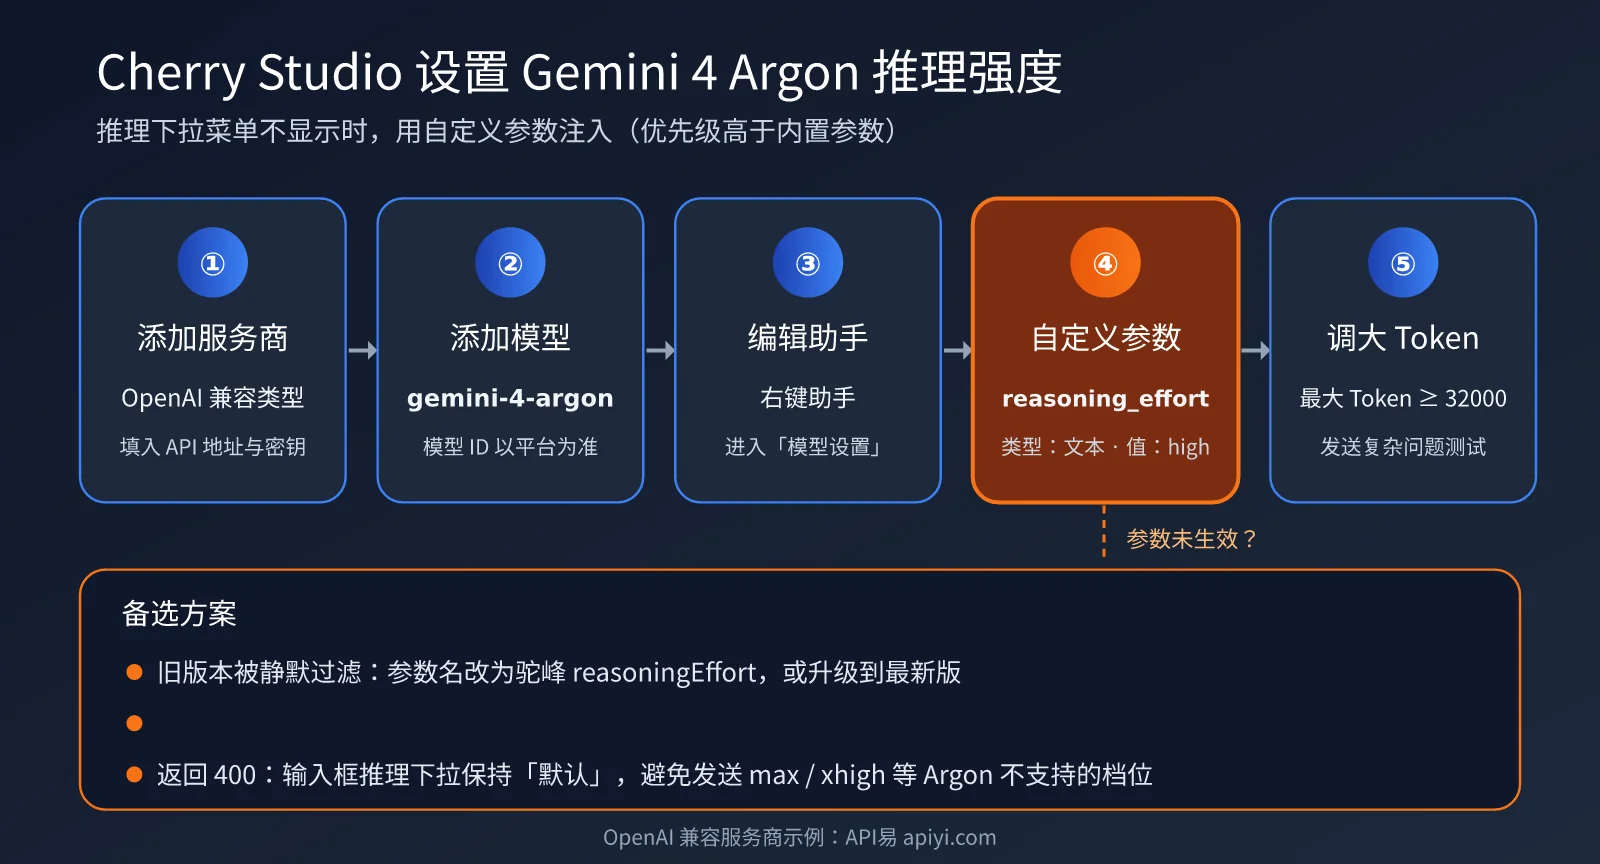
Cherry Studio 自定义参数配置步骤
以 OpenAI 兼容类型的服务商为例,完整配置步骤如下:
- 添加服务商:在设置中添加 OpenAI 兼容类型的服务商,填入 API 地址和密钥,例如 API易 的
https://api.apiyi.com。 - 添加模型:在服务商下添加模型 ID
gemini-4-argon。 - 进入助手设置:在助手列表中右键目标助手,选择“编辑助手”,切换到“模型设置”标签页。
- 添加自定义参数:参数名填
reasoning_effort,类型选“文本”,值填high(或low、medium)。 - 调大输出上限:开启并调大“最大 Token 数”,建议至少 32000,为思考过程预留空间。
- 发送测试:用一道需要多步推理的问题测试,对比设置前后的响应耗时和思考内容。
如果按上面的步骤设置后,推理强度仍然没有生效,可以检查以下几种常见情况:
| 问题现象 | 可能原因 | 解决方法 |
|---|---|---|
| 设置 reasoning_effort 后无变化 | 旧版本会在 OpenAI 兼容模式下静默过滤该参数 | 升级到最新版;或改用参数名 reasoningEffort |
| 输入框推理强度下拉菜单不显示 | 内置模型目录尚未收录 Argon | 使用自定义参数;进阶用户可在模型配置中补充推理能力信息 |
| 请求返回 400 错误 | 客户端发送了 max、xhigh 等 Argon 不支持的档位 | 下拉菜单保持“默认”,只用自定义参数指定 low/medium/high |
| 参数被内置设置覆盖 | 输入框推理选项与自定义参数冲突 | 输入框保持“默认”,避免两处同时设置 |
| 需要透传原生参数 | 想同时开启思考摘要 | 添加 JSON 类型参数 extra_body,值为 {"google": {"thinking_config": {"thinking_level": "high"}}} |
其中 reasoning_effort 被静默过滤的问题,Cherry Studio 已在 2026 年 3 月通过 PR 修复,新版本会自动把它转换为内部使用的 reasoningEffort。如果你使用的是较旧版本,可以直接把参数名写成驼峰形式 reasoningEffort 绕过过滤。
除了 Cherry Studio,其他常见对话客户端的思路也一样:先找到“自定义参数”“额外请求体”或“高级参数”之类的入口,把 reasoning_effort 作为请求体顶层字段加入;如果客户端只支持 JSON 形式,就用 extra_body 透传原生的 thinking_config。设置完成后,用同一道复杂问题对比响应耗时和 token 消耗,确认参数确实生效。
🚀 客户端建议:在 Cherry Studio 中接入 Gemini 4 Argon 时,建议选择 OpenAI 兼容类型的服务商,参数透传最稳定。API易 apiyi.com 提供 OpenAI 兼容的统一接口,在 Cherry Studio 中配置一次,就能同时使用 Gemini、Claude、GPT 等系列模型。
Gemini 4 Argon 推理强度实测与避坑指南
推理强度直接影响延迟、成本和输出质量。第三方技术博客 ComputingForGeeks 用 Argon 做了一组运维类任务的对比测试,结果很有参考价值。
| 测试指标 | 默认(medium) | high | 差异 |
|---|---|---|---|
| 平均输出 token | 463 | 1,836 | 约 4 倍 |
| 平均延迟 | 5.5 秒 | 15.3 秒 | 约 2.8 倍 |
| 首个可见 token | 约 4.3 秒 | 12–13 秒 | 先输出约 1400 个思考 token |
| 9 次调用成本(尝鲜价) | $0.045 | $0.169 | 约 3.8 倍 |
| low / medium 与默认对比 | 几乎一致 | — | 短任务中均未产生思考 token |
这组数据说明两点。第一,在简单短任务上,low、medium 和默认设置几乎没有区别,都不会产生思考 token,只有 high 档才会真正“深度思考”。第二,high 档的代价很明确:成本接近 4 倍,首 token 延迟增加 8 秒左右。需要注意的是,该测试只覆盖了短提示词,在复杂长任务中 medium 档也可能产生思考过程。
Gemini 4 Argon 推理强度设置的 4 个常见坑
结合 Google 迁移指南和社区实测,设置 Gemini 4 Argon 推理强度时最容易踩的坑有以下几个:
- max_tokens 过小导致空回复:
max_output_tokens同时包含思考 token 和正文 token。有实测显示,high 档配合 1024 的 max_tokens 时,Argon 把 1021 个 token 全部用于思考,最终返回空字符串,结束原因为MAX_TOKENS。使用 high 档时请至少预留 16K–32K。 - 沿用 thinking_budget 直接报错:gemini-3.1-pro-preview 会把
thinking_budget静默映射为档位,Argon 则直接返回 400,迁移时务必删除。 - temperature 等采样参数被忽略:Google 文档说明 Argon 后端会忽略自定义 temperature,
frequency_penalty、presence_penalty、candidate_count还会返回 400。建议用推理档位控制思考深度,用 response_schema 控制输出格式。 - 用 max_tokens 压成本适得其反:Google 官方建议,想降低成本和延迟时应该降低推理档位,而不是调小 max_tokens,否则容易截断输出。
📊 档位选择建议:日常问答和简单编程用默认 medium 即可,复杂架构设计、多文件重构、数学证明再切换到 high。可以在 API易 apiyi.com 平台的调用日志中对比不同档位的 token 消耗,找到质量和成本的最佳平衡点。
常见问题
Q1:Gemini 4 Argon 的推理强度默认是 high 吗?
不是。标准版 `gemini-4-argon` 默认是 medium,只有面向网络防御方的 `gemini-4-argon-cyber-permissive` 默认是 high。这一点和 gemini-3.1-pro-preview 不同,后者默认就是最高档 high。如果需要最强的推理能力,必须显式设置 `thinking_level=”high”` 或 `reasoning_effort=”high”`。
Q2:Gemini 4 Argon 能关闭思考或设为 minimal 吗?
不能。Argon 只支持 low、medium、high 三档,设置 minimal 或 `thinking_budget` 会返回 HTTP 400。通过 OpenAI 兼容接口传入 `reasoning_effort=”minimal”` 时会被映射为 low。如果需要极低延迟,可以考虑 Gemini 3.x Flash 系列等支持 minimal 档位的模型。
Q3:Cherry Studio 里看不到推理强度选项怎么办?
这是因为 Cherry Studio 的内置模型目录尚未收录 Argon。可以在“编辑助手 → 模型设置”中添加自定义参数 `reasoning_effort`,类型为文本,值为 `high`。自定义参数优先级高于内置参数。推荐使用 API易 apiyi.com 这类 OpenAI 兼容服务商,参数透传最稳定。
Q4:怎么确认推理强度真的生效了?
最直接的方法是查看响应中 usage 的输出 token 数和响应耗时:high 档的输出 token 和首 token 延迟会明显高于默认档。在 Cherry Studio 中也可以观察是否出现思考内容。建议用同一道复杂问题分别测试默认档和 high 档,对比差异。
总结
Gemini 4 Argon 推理强度的关键结论是:默认 medium,不是 high。这和默认最高档的 gemini-3.1-pro-preview 不同,迁移时如果不显式设置,模型的思考深度会悄悄降一档。Argon 只支持 low、medium、high 三档,thinking_budget 和 minimal 都会触发 400 错误,使用 high 档时还要为思考 token 预留足够的 max_tokens。
在调用方式上,原生 SDK 用 thinking_level,OpenAI 兼容接口用 reasoning_effort,Cherry Studio 等暂未支持 Argon 推理选项的客户端,可以通过自定义参数注入。建议日常任务保持默认 medium,复杂任务按需切到 high,用实测数据决定档位。
我们建议通过 API易 apiyi.com 平台以 OpenAI 兼容方式统一接入 Gemini 4 Argon,在代码和 Cherry Studio 等客户端中都能用 reasoning_effort 一个参数灵活切换推理强度。
参考资料:
- Google Gemini API Thinking 文档: ai.google.dev/gemini-api/docs/thinking
- Google Gemini API OpenAI 兼容文档: ai.google.dev/gemini-api/docs/openai
- Google Cloud Gemini 4 Argon 开发者指南: docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-argon
- Cherry Studio 助手设置文档: docs.cherryai.com.cn
- Cherry Studio GitHub Issues #11987、#19761: github.com/CherryHQ/cherry-studio
作者:APIYI Team | 持续分享大模型接入与参数调优实践,更多 AI 模型接入教程请访问 API易 apiyi.com