gpt-6-astraは2026年9月3日にリリースされ、翌日には一般公開されました。しかし、公開からわずか1週間で、SNS上では「gpt-6-astraが賢くなくなった(降智した)」という不満の声が溢れました。同じプロンプトを入力してもリリース当初ほどの品質が出ない、あるいは「Extra high」の推論設定で処理は速くなったものの、結果が以前より粗くなったという指摘です。同時に、ChatGPTやCodexにおけるAstraの利用枠が前世代のGPT-5.6 Solよりも明らかに厳しくなっており、多くの開発者が作業途中で制限に引っかかる事態が発生しています。本記事では、gpt-6-astraが本当に賢くなくなったのかを判断する5ステップの調査法と、利用枠を使い切った際に公式のAPI中継サービスで補う方法を紹介し、ワークフローを安定させるためのヒントをお届けします。
核心的価値:この記事を読めば、「本当の性能低下」と「認識のズレ」を区別できるようになります。また、サブスクリプションの利用枠の現実的な境界を理解し、推論強度とキャッシュ戦略をコントロールすることで、フルスペックのgpt-6-astraを合理的なコストで呼び出す方法を習得できます。
gpt-6-astraの性能低下に関する議論のポイント
調査を始める前に、現在判明している事実を整理しましょう。Decryptなどの海外メディアのまとめによると、Astra公開から1週間後に苦情が集中し始めました。一部の開発者(opencodeチームを含む)は、コストが倍増し、品質が期待を下回ったためにGPT-5.6 Solに戻しています。しかし、記事執筆時点ではOpenAIからAstraに関する正式な声明は出ておらず、多くの熟練ユーザーは「モデル自体は変わっておらず、単に『ハネムーン期間』が過ぎてミスが目立つようになっただけだ」と指摘しています。
| ポイント | 判明している事実 | あなたへの影響 |
|---|---|---|
| リリース日 | 2026-09-03に承認済みユーザーへ公開、09-04に全面利用可能 | モデルはまだ初期段階であり、サーバー側の設定が頻繁に変更される可能性がある |
| 性能低下の苦情 | 同じプロンプトでの出力品質低下、高推論設定での処理時間短縮の報告 | 感覚だけでなく、再現性のある方法で検証する必要がある |
| 公式の回答 | Astraに関する正式な声明はなし | デフォルトの推論強度が調整されたかどうかは確認できない |
| 過去の事例 | 2026年7月にもSolで同様の疑念が浮上。OpenAIは意図的な弱体化を否定したが、「推論強度」設定の実験は認めた | ChatGPT側の推論予算はユーザーが完全にコントロールできるものではない |
| 利用枠の制限 | PlusのWork/Codexで約5〜45回/5時間(Sol時代の約半分) | ヘビーユーザーはピーク時に制限に達しやすい |
なぜgpt-6-astraは「賢くなくなった」と感じるのか
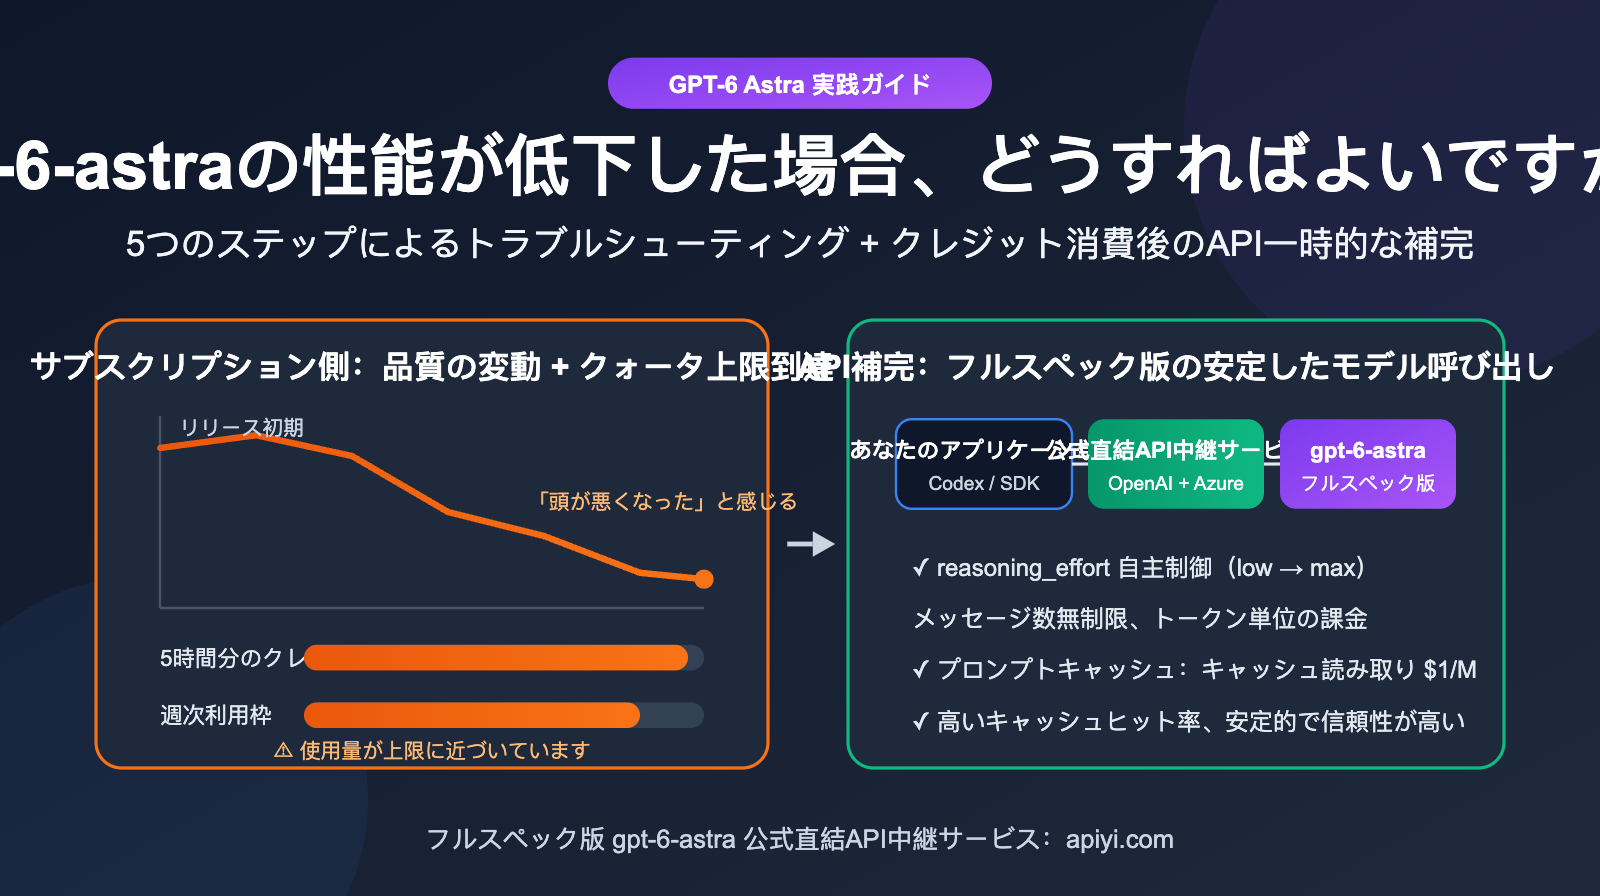
モデルの重みが密かに置き換えられた可能性は極めて低く、より一般的な原因は「推論予算」にあります。gpt-6-astraはAPIにおいて low、medium、high、xhigh、max の5段階の推論強度をサポートしており、強度が高いほどモデルは回答前に多くの思考ステップを踏むため、品質と処理時間が向上します。ChatGPTやCodexのようなサブスクリプション製品では、推論予算はプラットフォーム側で一括管理されており、プラットフォームが計算リソースの負荷を抑えるために予算を下げれば、ユーザーには「速いが粗い」結果として映ります。これは苦情の内容と完全に一致します。
一方で、Theo氏などの開発者は、Astra自体の出力にはもともと大きなばらつきがあり、同じタスクでも素晴らしい結果を出すこともあれば、初歩的なミスを犯すこともあると指摘しています。リリース当初は素晴らしい事例が記憶に残りやすく、使い続けるうちに失敗事例が強調されるため、この心理的な落差が「性能低下」として解釈されることもあります。したがって、調査の鍵は「プラットフォームの調整」「モデルのばらつき」「自身の使い方」という3つの変数を切り分けて考えることです。
gpt-6-astra の「性能低下」を疑う際の5ステップ診断法
gpt-6-astra の性能が落ちたと感じたときに、闇雲にモデルを切り替えるのではなく、以下の手順で原因を一つずつ切り分けていくことをおすすめします。
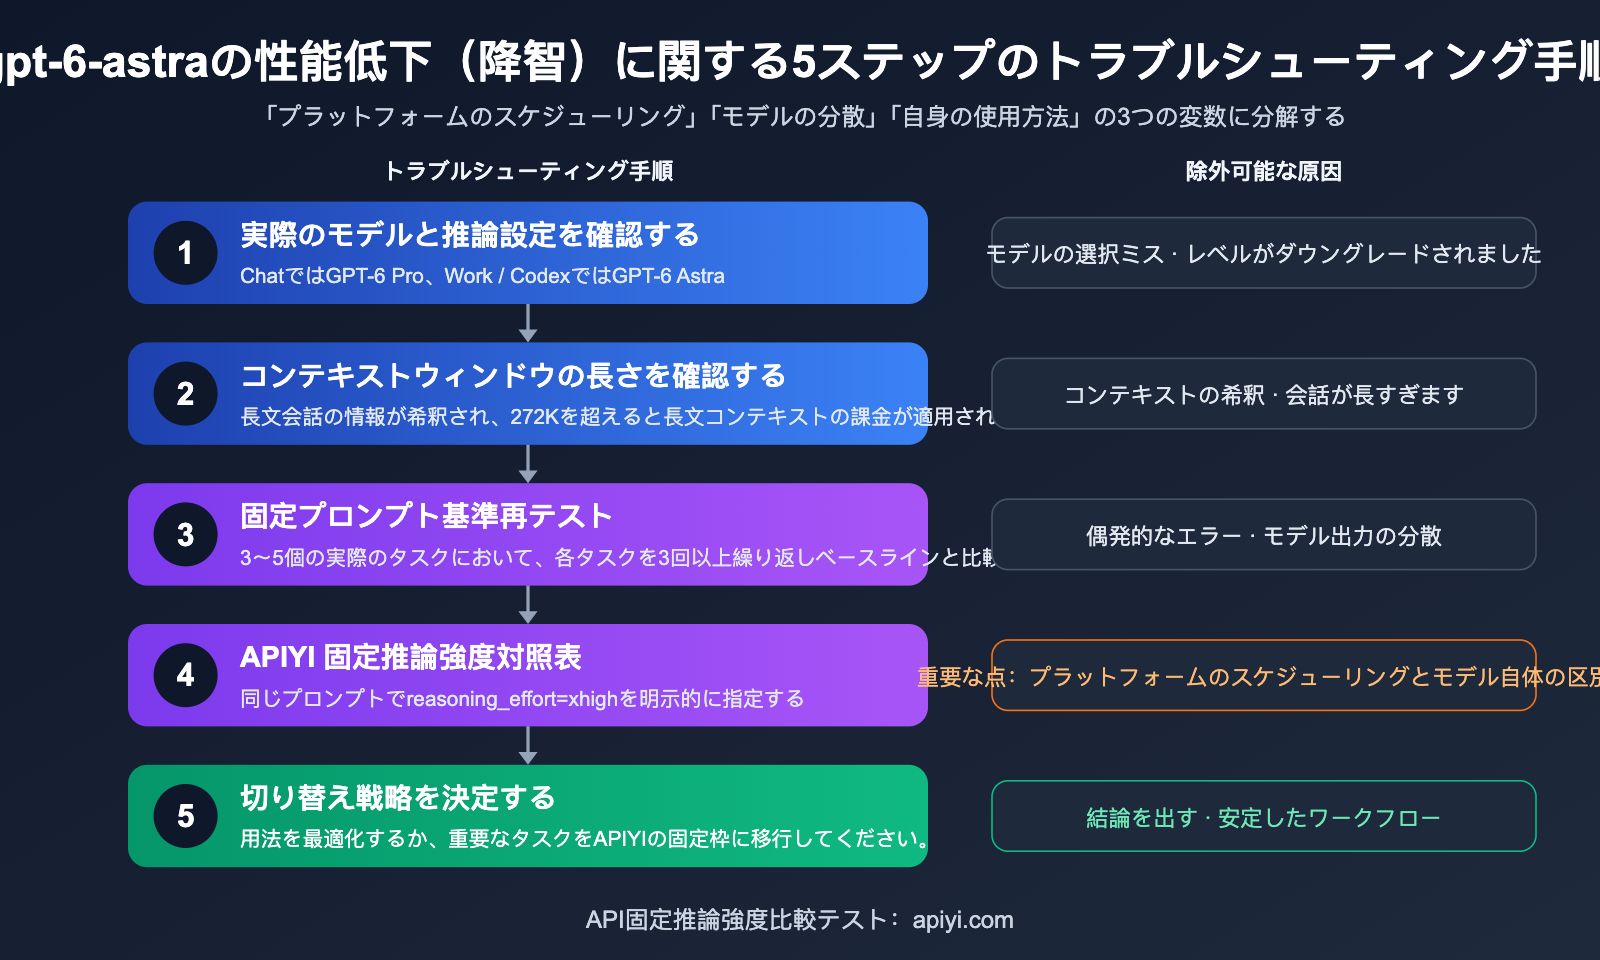
- 使用モデルと設定の確認: ChatGPTにおいて、Astraはチャット上では「GPT-6 Pro」として表示されますが、WorkやCodexでは「GPT-6 Astra」となり、それぞれクォータ(利用枠)体系が異なります。現在どのモデルで、どの程度の思考強度(reasoning effort)で実行されているか、また制限によるダウングレードが発生していないかを確認してください。
- コンテキストウィンドウの確認: Astraのコンテキストウィンドウは1,050,000トークンですが、長時間の会話では初期の文脈が薄れるのは大規模言語モデルの共通の課題です。Codexのセッションが長時間続いている場合は、新しいチャットを開始し、背景情報を整理してから再テストしてください。
- 固定プロンプトによるベンチマーク: 慣れ親しんだタスクを3〜5個選び、初期の頃の出力をベースラインとして保存します。同じプロンプトで3回以上実行し、安定して質が低下しているのか、偶発的なミスなのかを判断します。単発の比較では統計的な意味がありません。
- APIによる推論強度の固定: APIを使用して
reasoning_effortを明示的に指定し、ChatGPT側と同じプロンプトで出力を比較します。もしAPIのxhigh設定の方が明らかに質が高い場合、問題はモデルそのものではなく、プラットフォーム側の推論予算(リソース配分)にある可能性が高いです。 - 結論に基づいた戦略の決定: 自身のプロンプトや会話管理に問題がある場合は改善を行い、プラットフォームのスケジューリングや制限が原因であれば、重要なタスクを制御可能なAPI呼び出しへ移行させます。
| 現象 | 最も可能性の高い原因 | 検証方法 | 推奨アクション |
|---|---|---|---|
| 回答は速いが推論が浅い | 推論予算が制限されている | APIで xhigh を指定して比較 |
重要なタスクはAPI経由で固定設定にする |
| 長い会話でミスが増える | 文脈の希薄化または制限超過 | 新規チャットで再テスト | タスクの分割、コンテキストの整理 |
| 同じタスクで質が不安定 | モデル出力の分散が大きい | 同じプロンプトで3〜5回実行 | 検証ステップの追加や複数回サンプリング |
| 用量不足の警告が出る | 5時間または週の制限に到達 | 利用状況パネルを確認 | リセットを待つか、APIで補完する |
| コード品質が明らかに低下 | 設定の切り替わりやプロンプトの漂移 | 初期ベースラインと比較 | システムプロンプトと設定を固定する |
🎯 診断アドバイス: 第4ステップは「プラットフォームの問題」と「モデルの問題」を切り分ける鍵です。APIYI (apiyi.com) を通じて、同じプロンプトで
highとxhighの両方を実行して比較することをおすすめします。同プラットフォームは公式直結方式で gpt-6-astra を提供しており、OpenAIのネイティブAPIと同一のパラメータを使用できるため、比較結果の信頼性が高まります。
gpt-6-astra の利用制限に達してしまったら
モデルの性能が低下していなくても、利用制限(クォータ)の問題は作業リズムを大きく乱す原因になります。海外メディアやコミュニティの情報によると、Astra は「ChatGPT Work」および「Codex」において「5時間ごとのローリング制限 + 週次制限」という二重の制限を設けており、両方の枠が残っていないと利用できません。さらに、9月5日の全ユーザー向け制限リセット以降、一部のヘビーユーザーに対しては上限がさらに厳格化されたという報告もあります。下表はコミュニティで算出された推定値ですが、実際の利用状況はOpenAIの公式ダッシュボードで確認してください。
| サブスクリプション | Work/Codex での Astra 推定枠 | Chat での GPT-6 Pro | 対象ユーザー |
|---|---|---|---|
| Plus | 約 5-45 回 / 5時間 | 提供なし | ライトな体験、たまに複雑なタスクをこなす方 |
| Pro $100 | 約 25-225 回 / 5時間 | 約 50 回 / 週 | 日常的な開発がメインの方 |
| Pro $200 | 約 100-900 回 / 5時間 | 約 200 回 / 週 | 終日ヘビーに利用する方 |
| API 従量課金 | メッセージ数制限なし、RPM/TPM 制限のみ | 適用外 | バッチ処理、重要タスク、一時的な補完 |
これほど幅があるのは、1回のメッセージで消費される枠がタスクの複雑さ、推論レベル、コンテキストの長さに依存するためです。40分間フル稼働するPC操作タスクと、単純な質問応答では消費量が全く異なります。多くの開発者にとって、たまに発生するピーク時のために $200 のプランへアップグレードするのは割に合いません。既存のサブスクリプションを維持しつつ、制限に達した際に API で従量課金補完を行うのが最も経済的です。
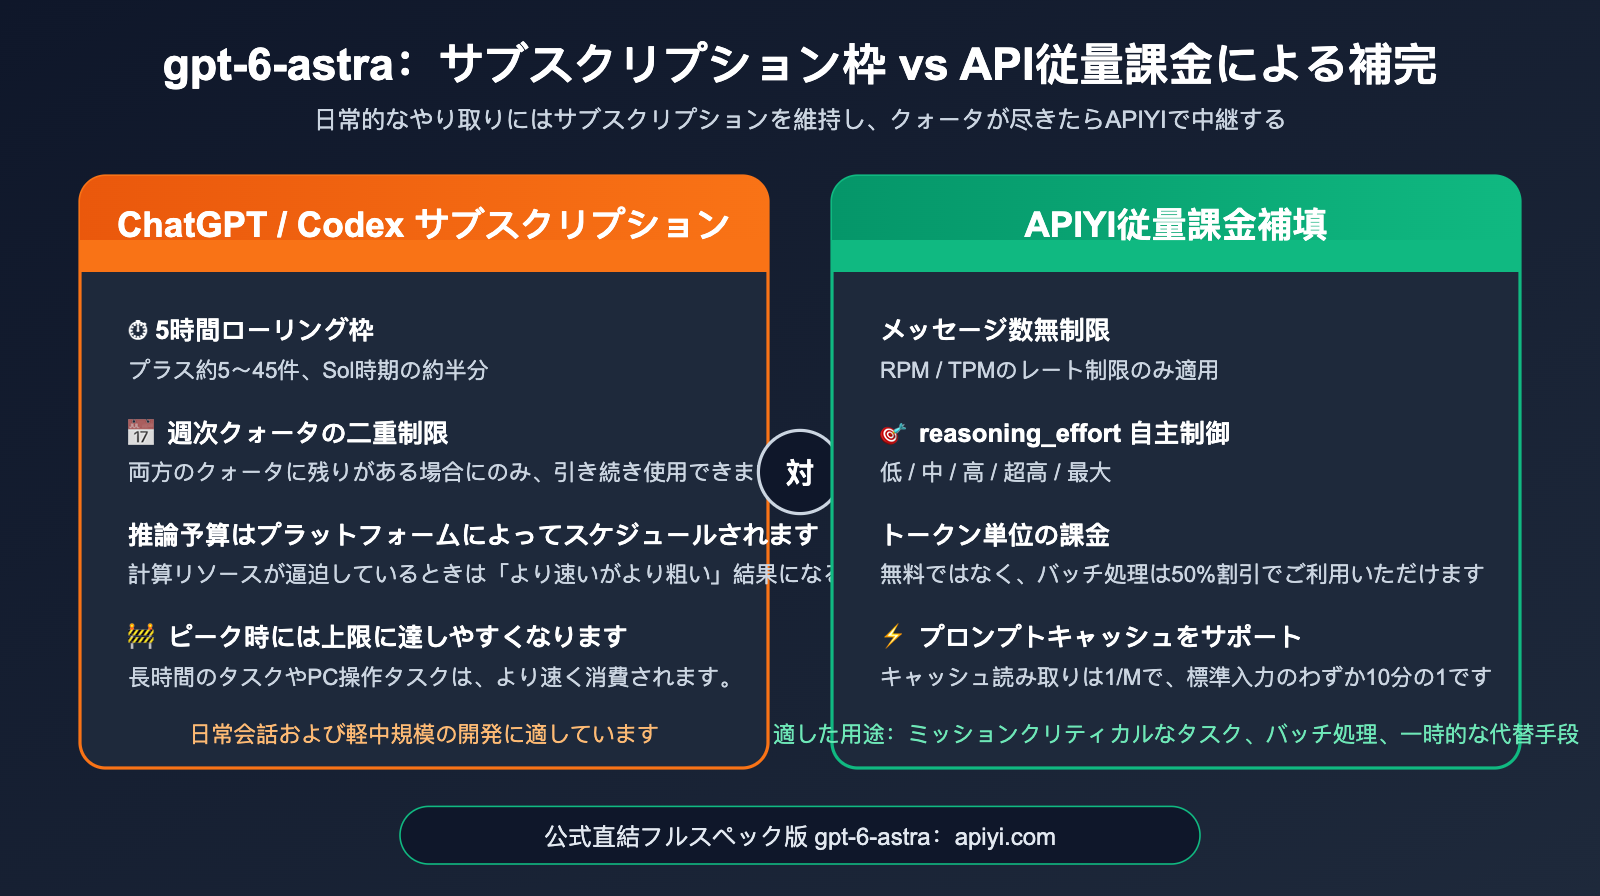
gpt-6-astra API 補完の3つのメリット
API を一時的な補完として利用することは、単に「枠が増える」こと以上の意味があります。それは「制御権を取り戻せる」ということです。第一に、推論の強度を明示的に指定できるため、プラットフォーム側で勝手に調整されることがなく、いわゆる「性能低下(降智)」の不確実性を回避できます。第二に、API はトークン単位の従量課金であるため、使わないときはコストがかからず、利用制限のピーク時といった断続的なニーズに最適です。第三に、API はバッチ処理やプロンプトキャッシュなどのコスト最適化手段をサポートしており、長期的に見てもコストをコントロール可能です。
サービスを選ぶ際は、公式直結のサービスかどうかを確認することが重要です。一部のサードパーティチャネルでは、リバースエンジニアリングされたインターフェースを使用していたり、リクエストを別のモデルにルーティングしたりする場合があり、これが「性能低下」の問題をさらに悪化させます。APIYI (apiyi.com) が提供する gpt-6-astra は完全なフルスペック版であり、OpenAI および Azure の公式直結ルートを採用しています。インターフェースのパラメータも公式と完全に一致しており、サブスクリプション外の安定した補完先として最適です。
gpt-6-astra API クイックスタート
gpt-6-astra は Chat Completions、Responses、Batch の3つのエンドポイントをサポートしており、入力はテキストと画像に対応、出力はテキストとなります。以下のシンプルな例では OpenAI 公式 SDK を使用しており、base_url と APIキーを置き換えるだけで実行可能です。
gpt-6-astra のシンプルな呼び出し例
from openai import OpenAI

# APIYIのAPIキーとベースURLを設定
client = OpenAI(
    api_key="YOUR_APIYI_KEY",
    base_url="https://api.apiyi.com/v1"
)

response = client.chat.completions.create(
    model="gpt-6-astra",
    reasoning_effort="xhigh",  # low / medium / high / xhigh / max から選択
    messages=[
        {"role": "system", "content": "あなたは熟練のバックエンドエンジニアです。回答には実行可能なコードを含めてください。"},
        {"role": "user", "content": "Pythonで有効期限付きのLRUキャッシュを実装してください"}
    ]
)
print(response.choices[0].message.content)
print(response.usage)  # prompt_tokens_details.cached_tokens に注目
完全なコード:キャッシュキー、リトライ、利用統計を含む実装例
import time
from openai import OpenAI, APIError, RateLimitError

client = OpenAI(
    api_key="YOUR_APIYI_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 固定の長いシステムプロンプトを先頭に配置し、プロンプトキャッシュをヒットさせる
SYSTEM_PROMPT = open("system_prompt.md", encoding="utf-8").read()


def ask_astra(user_input: str,
              effort: str = "high",
              cache_key: str = "project-alpha-v1",
              max_retries: int = 3) -> str:
    """gpt-6-astraを呼び出し、推論強度を固定してキャッシュキーを再利用する"""
    for attempt in range(max_retries):
        try:
            resp = client.chat.completions.create(
                model="gpt-6-astra",
                reasoning_effort=effort,
                prompt_cache_key=cache_key,
                messages=[
                    {"role": "system", "content": SYSTEM_PROMPT},
                    {"role": "user", "content": user_input},
                ],
            )
            usage = resp.usage
            cached = 0
            if usage.prompt_tokens_details:
                cached = usage.prompt_tokens_details.cached_tokens or 0
            hit_rate = cached / usage.prompt_tokens if usage.prompt_tokens else 0
            print(f"入力 {usage.prompt_tokens} | キャッシュ {cached} "
                  f"| ヒット率 {hit_rate:.1%} | 出力 {usage.completion_tokens}")
            return resp.choices[0].message.content
        except RateLimitError:
            wait = 2 ** attempt
            print(f"レート制限に達しました。{wait} 秒後にリトライします")
            time.sleep(wait)
        except APIError as e:
            print(f"APIエラー: {e}")
            time.sleep(1)
    raise RuntimeError("複数回のリトライに失敗しました")


if __name__ == "__main__":
    tasks = [
        "このSQLのインデックス使用状況をレビューしてください: SELECT ...",
        "注文サービスのための冪等なリトライスキームを設計してください",
    ]
    for t in tasks:
        print(ask_astra(t, effort="xhigh")[:200])
💡 活用アドバイス:初回呼び出し時は、まず
mediumレベルで動作を確認し、タスクの難易度に応じて段階的に引き上げることをお勧めします。APIYI (apiyi.com) で登録してテスト用クレジットを取得し、出力品質が期待通りであることを確認してから本格的なタスクに移行してください。
Codex で gpt-6-astra API を補完として切り替える
Codex CLI をメインで利用している場合、利用制限に達しても作業を中断する必要はありません。~/.codex/config.toml にカスタムモデルプロバイダーを設定し、APIキーを使って作業を継続できます。
model = "gpt-6-astra"
model_provider = "apiyi"
model_reasoning_effort = "high"

[model_providers.apiyi]
name = "APIYI"
base_url = "https://api.apiyi.com/v1"
env_key = "APIYI_API_KEY"
wire_api = "responses"
設定完了後、export APIYI_API_KEY=あなたのキー を実行してから Codex を起動してください。サブスクリプションの制限がリセットされたら、model_provider をコメントアウトするだけで元のログイン方式に戻せます。状況に応じて両方のモードを切り替えて利用可能です。
gpt-6-astra の推論強度の選び方
推論強度は品質、処理時間、コストに直結します。一律で最大にするのではなく、タスクの種類に応じて使い分けるのが賢明です。
| 推論強度 | 代表的なシナリオ | 品質表現 | 時間とコスト |
|---|---|---|---|
| low | フォーマット変換、単純な質問、情報抽出 | 基本ニーズを満たす | 最低 |
| medium | 日常的なコード補完、ドキュメント作成 | バランス型 | 低め |
| high | 複雑なリファクタリング、設計、データ分析 | 安定・信頼性あり | 中程度 |
| xhigh | 難解なバグ特定、長大なエージェントタスク | リリース当初に近い体験 | 高め |
| max | 数学的証明、セキュリティ監査、高価値な意思決定 | 最高品質 | 最高(呼び出し頻度に注意) |
🎯 選定アドバイス:サブスクリプション側で「性能低下」を感じる場合は、本来 ChatGPT で実行していた重要なタスクを
xhighレベルに固定して呼び出してみてください。APIYI (apiyi.com) を経由して呼び出す場合、推論強度はリクエストパラメータによって完全に制御されるため、品質の変動を説明可能な範囲内に抑えることができます。
gpt-6-astra のコスト管理とキャッシュヒット率の最適化
gpt-6-astra の公式価格は入力 10ドル、出力 50ドル(100万トークンあたり)と、GPT-5.6 Sol のリリース時価格の数倍に達します。そのため、API を補完的に利用する際は、コスト管理を最優先で検討する必要があります。幸いなことに、Astra のキャッシュ入力価格はわずか 1ドルであり、標準入力価格の10分の1に相当します。キャッシュヒット率の高さが、請求額に直接的な差を生むことになります。
| 課金項目 | 公式価格(100万トークンあたり) | 説明 |
|---|---|---|
| 標準入力 | 10ドル | 入力が 272K トークン以下の場合に適用 |
| キャッシュ読み取り | 1ドル | プロンプトキャッシュにヒットした部分、90% 節約 |
| キャッシュ書き込み | 12.5ドル | 新規書き込みのプレフィックス、標準入力よりわずかに高い |
| 標準出力 | 50ドル | 推論トークンを含む |
| 長文コンテキスト | 入力とキャッシュは2倍、出力は1.5倍 | 入力が 272K トークンを超えると適用 |
| Batch / Flex | 標準価格の 50% | リアルタイム性が不要なタスクに最適 |
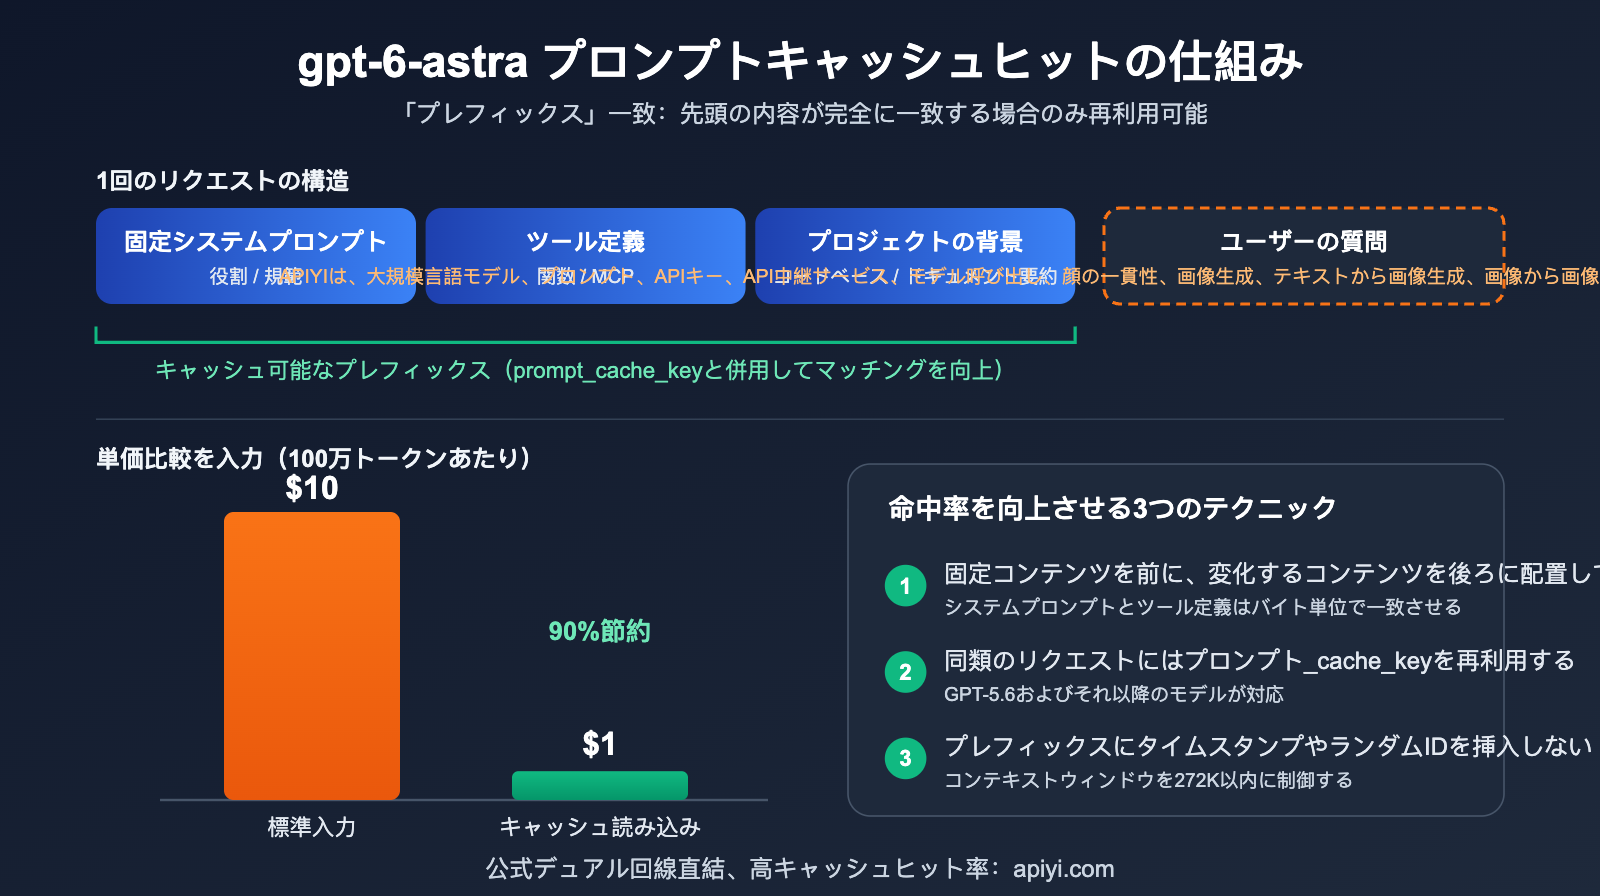
gpt-6-astra のキャッシュヒット率を向上させる4つのテクニック
プロンプトキャッシュは「プレフィックス(接頭辞)」でマッチングされます。リクエストの冒頭部分が完全に一致していれば、以前の計算結果を再利用できます。この仕組みを活かし、以下の点から最適化を行いましょう。
- 固定内容を先頭に配置:システムプロンプト、ツール定義、プロジェクトの仕様など、変更のない内容をメッセージの最前列に配置し、ユーザーの質問やタイムスタンプなどの動的な内容は最後に配置します。
- prompt_cache_key の活用:GPT-5.6 以降のモデルはこのパラメータをサポートしています。共通の長いプレフィックスを持つリクエストに同じキャッシュキーを使用することで、マッチング確率が大幅に向上します。
- プレフィックスへの動的な値の挿入を避ける:システムプロンプトに現在時刻やランダムなIDを書き込むと、リクエストのたびにプレフィックスが異なってしまい、キャッシュが無効化されます。
- コンテキストを 272K 以内に制御:この閾値を超えると長文コンテキスト課金が適用され、キャッシュ読み取り価格も倍増します。長いドキュメントの場合は、先に検索処理を行ってからモデルに渡すことを推奨します。
キャッシュヒット率は、基盤となるネットワーク経路の安定性にも左右されます。リクエストが異なるバックエンド間で頻繁に切り替わると、キャッシュを維持するのが困難になります。APIYI (apiyi.com) は OpenAI と Azure の公式回線を直接利用しており、gpt-6-astra に向けてキャッシュフレンドリーなルーティング最適化を行っています。固定プレフィックスの環境下では高いキャッシュヒット率を実現可能です。レスポンス内の cached_tokens フィールドで効果を直接確認できます。
gpt-6-astra の性能低下と補完に関するよくある質問
Q1:gpt-6-astra は本当に OpenAI によって性能が制限(降智)されていますか?
現時点ではモデルの重みが置き換えられたという公式な証拠はなく、OpenAI からも正式な発表はありません。サブスクリプション側の推論予算のスケジューリング変更や、モデル自体の出力のばらつきが原因である可能性が高いです。本記事の5ステップのトラブルシューティング法を試し、API の固定設定で比較してから結論を出すことをお勧めします。
Q2:API 経由で呼び出す gpt-6-astra と ChatGPT のものは同じモデルですか?
同じモデルです。違いは、API は推論強度を明示的に指定できるのに対し、サブスクリプション製品の推論予算はプラットフォーム側で調整される点です。APIYI (apiyi.com) が提供するのは、公式直結のフルスペック版 gpt-6-astra であり、推論強度は完全に指定したパラメータ通りに実行されます。
Q3:サブスクリプション枠と API は同時に使えますか?
はい、両者は独立しています。日常的な対話はサブスクリプション枠を使用し、枠が尽きた場合やバッチ処理が必要な場合に API に切り替える運用がおすすめです。Codex 等の設定ファイルで簡単に切り替えが可能です。
Q4:API での補完は高額になりませんか?
使い方次第です。推論設定の調整、キャッシュヒット率の向上、リアルタイム性が不要なタスクを Batch に回すことで、コストを半分以下に抑えることができます。まずは APIYI (apiyi.com) で少量の実際のタスクを試して単価を算出し、その後に補完規模を決定することをお勧めします。
Q5:gpt-6-astra と GPT-5.6 Sol はどう使い分けるべきですか?
Sol は価格が大幅に安いため、通常のコーディングやバッチタスクに適しています。一方、Astra は PC 操作、複雑な推論、長距離の Agent タスクで強みを発揮します。Sol をデフォルトモデルとし、難易度の高いタスクのみ Astra にアップグレードすることで、品質を維持しつつコストを最適化できます。
まとめ:gpt-6-astra の不確実性を制御可能な変数に変える
gpt-6-astra は、OpenAI が現在提供する最も強力なフラッグシップモデルですが、リリース初期の「性能低下(いわゆる『脳の劣化』)」に関する議論や利用制限の厳格化は、サブスクリプション製品の本質的な特徴を浮き彫りにしました。つまり、推論予算や使用上限はプラットフォーム側に決定権があり、ユーザーはそれを受け入れるしかないという点です。このような状況下では、モデルが「賢くなったか、バカになったか」を推測し続けるよりも、固定されたプロンプトと推論レベルを用いて、自分自身の品質基準を確立する方が賢明です。
実践的には、以下の3ステップで進めるのが効果的です。まず「5ステップのトラブルシューティング」でプラットフォーム側の調整、モデルの分散、そして自身の使い方を切り分けます。次に、利用制限に達した際は API で補完し、重要なタスクは high または xhigh レベルに固定します。最後に、固定プレフィックス、prompt_cache_key、およびバッチ処理を活用してコストを抑えます。これにより、サブスクリプション側の仕様変更に左右されず、コアとなるワークフローを安定させることができます。
安定した補完チャネルが必要な場合は、APIYI (apiyi.com) を通じてフルスペック版の gpt-6-astra を呼び出すことをお勧めします。このプラットフォームは OpenAI および Azure の公式直結型であり、インターフェースは公式と完全互換でキャッシュヒット率も高く、ChatGPT や Codex のサブスクリプションに代わる信頼性の高い選択肢として最適です。
参考資料:
- OpenAI モデルドキュメント(gpt-6-astra): developers.openai.com/api/docs/models/gpt-6-astra
- OpenAI ヘルプセンター Astra 利用量説明: help.openai.com
- Decrypt による Astra 性能低下に関する報道: decrypt.co
- Microsoft Foundry プロンプトキャッシュドキュメント: learn.microsoft.com
- APIYI モデルドキュメント: docs.apiyi.com
著者紹介: APIYI 技術チーム。AI 大規模言語モデルの API 接続とエンジニアリングの実践に注力しています。gpt-6-astra の呼び出し最適化やコスト管理に関する知見については、ぜひ APIYI (apiyi.com) を通じて交流しましょう。