著者注:定期実行される監視・要約エージェントを4つの構成要素に分解し、モデル呼び出し層をOpenAI互換インターフェースによって特定のSDKから切り離す方法を、実行可能なPythonのサンプルとともに解説します。
OpenRouterは最近、@openrouter/agent 0.11.0を使って、Hacker Newsを自動監視し、要約を生成する定期実行型の常駐AIエージェントをTypeScriptで構築するチュートリアルを公開しました。業界ニュースや競合の動向、技術コミュニティの人気投稿を毎朝自動でまとめたいと考えるチームは多く、このシナリオはよい例といえます。この記事では、このチュートリアルをきっかけに、特定のSDKに依存しない、監視・要約エージェントの汎用アーキテクチャを解説します。
この記事は、そのチュートリアルの焼き直しではありません。元のチュートリアルについて公開されているのは概要情報のみなので、具体的な実装を推測することはしません。ここでは、監視・要約エージェントがどのような要素で構成されるのか、モデルやサービスプロバイダーをいつでも切り替えられるよう、モデル呼び出し層をどう設計するかという、より汎用的な問題に焦点を当てます。
この記事で得られること:「定時起動、データ取得、モデルによる要約、結果の出力」という4段階の構成を理解し、OpenAI互換インターフェースを使った、用途に合わせてすぐに改造できるPython実装を手に入れられます。
監視・要約 Agent の要点
まずは記事全体の結論を表にまとめます。以降のセクションで、それぞれ詳しく見ていきます。
| 要点 | 内容 | メリット |
|---|---|---|
| 4段階の構成 | 定期実行 → データ取得 → モデルによる要約 → 結果出力 | 各段階を個別に交換・テストできる |
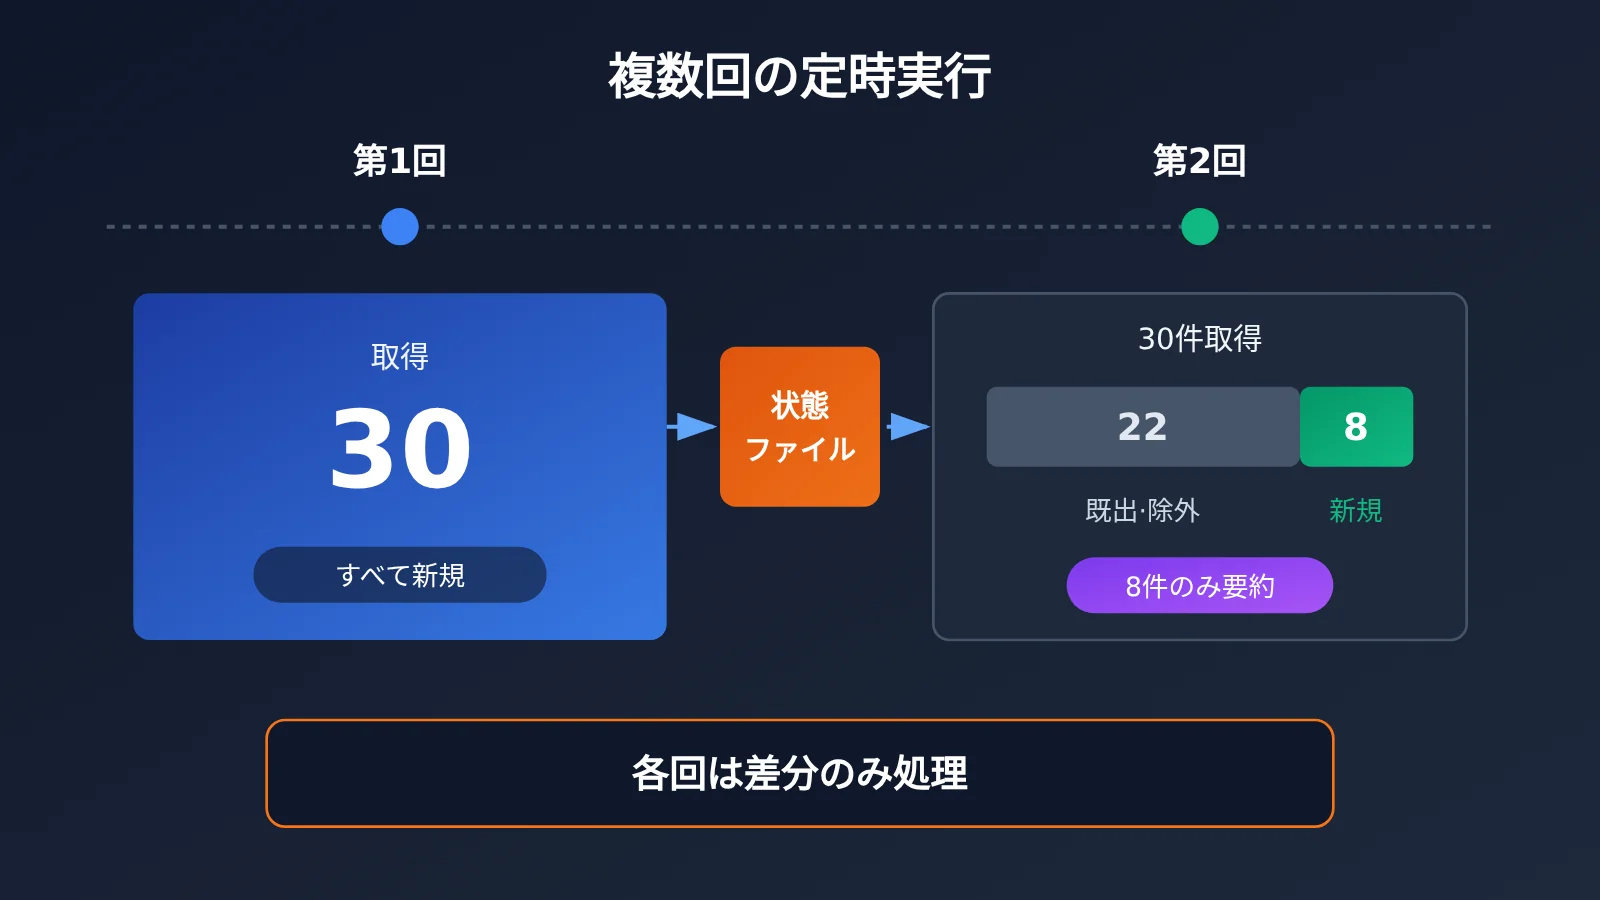
| 状態管理 | 処理済みの項目を記録し、重複した要約を防ぐ | 呼び出し回数を節約し、出力をすっきり保てる |
| モデル呼び出し層の分離 | 業務コードは要約インターフェースのみに依存し、特定の SDK に直接依存しない | モデルやサービスプロバイダーの変更は設定だけで済む |
| OpenAI 互換プロトコル | 共通の Chat Completions 形式を呼び出し層の基盤にする | エコシステムが成熟しており、さまざまなモデルを利用できる |
| タスクに応じたモデル選択 | 要約ではコンテキスト長、指示への追従性、安定性、コストを重視する | 単純なタスクに高いコストをかけずに済む |
監視・要約 Agent を構成する4つの要素
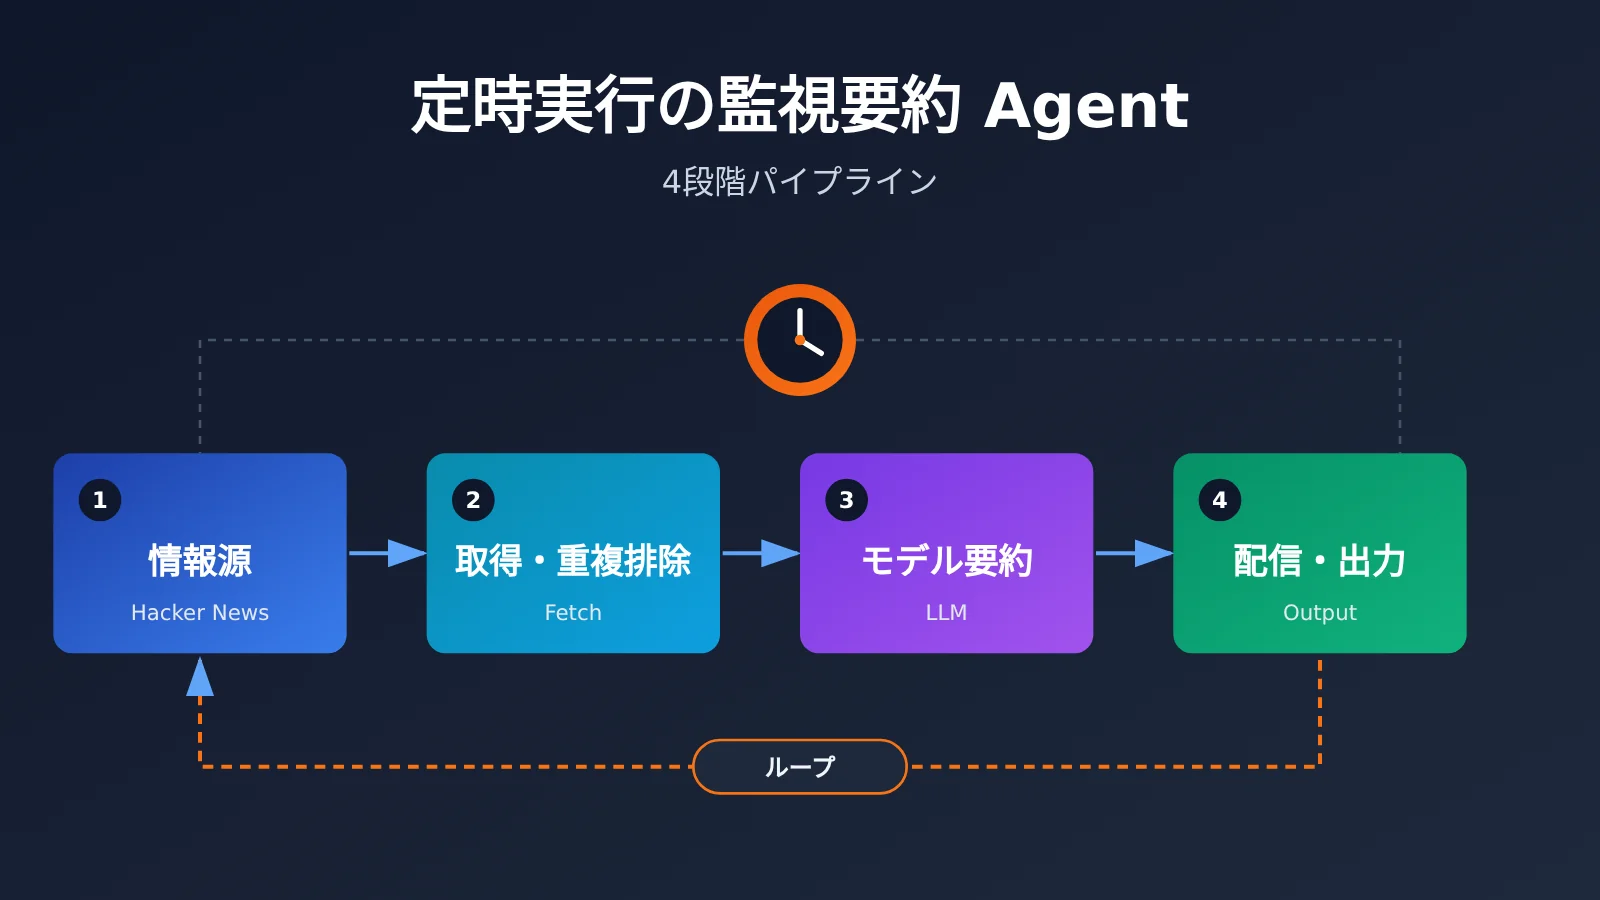
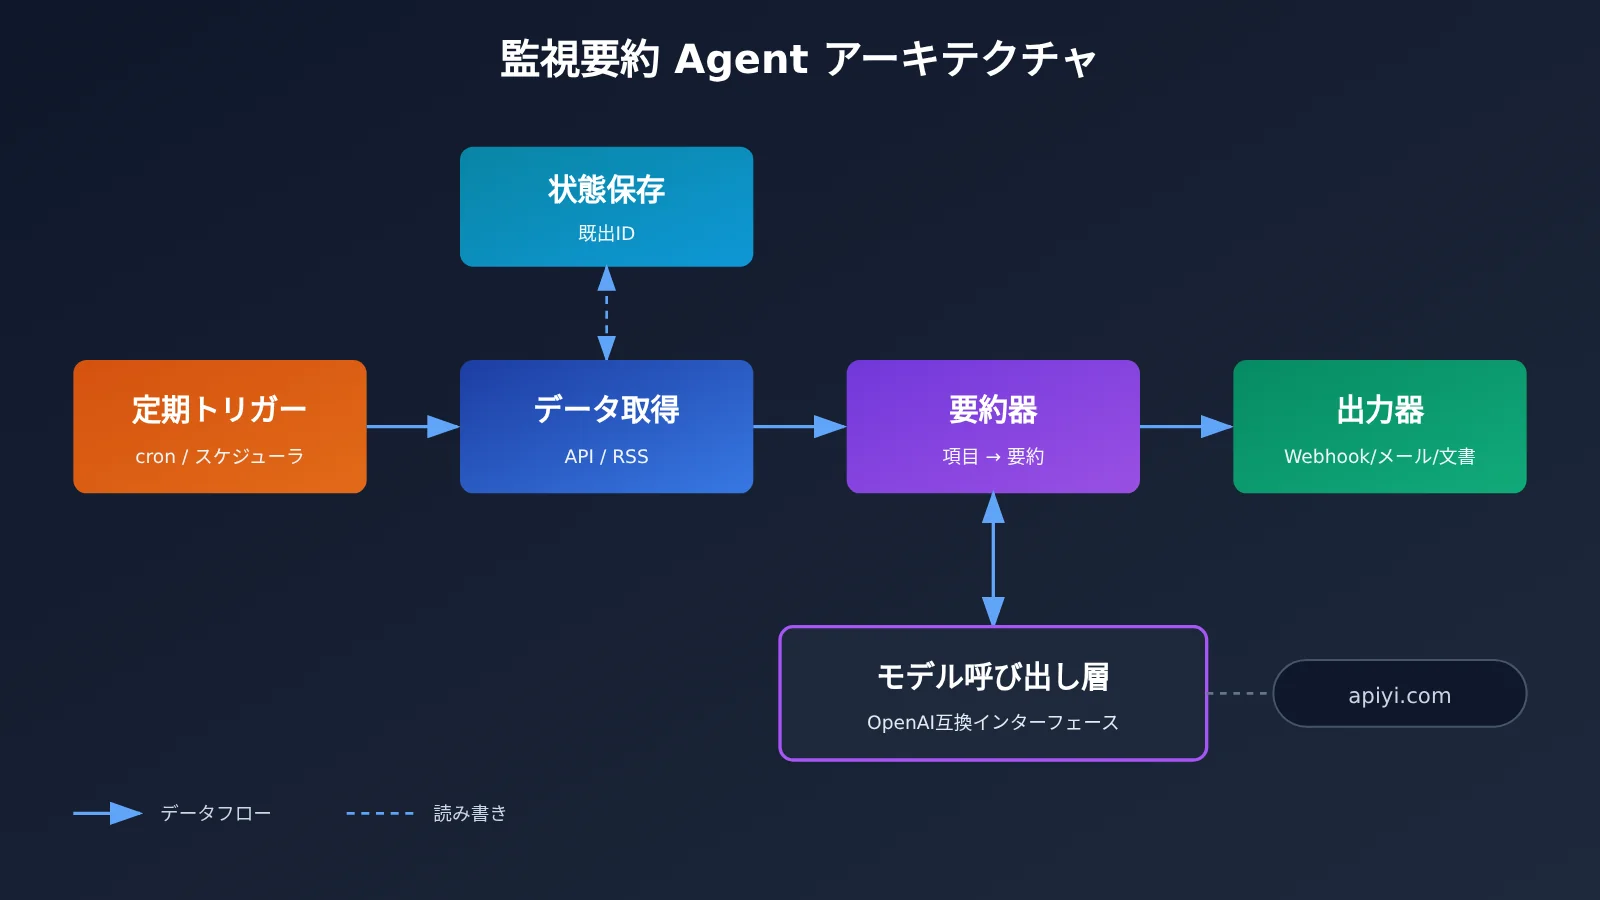
いわゆる「常駐 Agent」の実態は、タイマーによって繰り返し起動されるパイプラインです。複雑な多段階推論は必要ありませんが、誰かが動作を見守っているわけではないため、高い安定性が求められます。長期にわたって安定稼働させるには、責務の明確な4つのコンポーネントに分けることが大切です。
| 構成要素 | 役割 | 一般的な実装 | 設計のポイント |
|---|---|---|---|
| 定期実行トリガー | 一定の間隔でタスクを起動する | cron、systemd timer、クラウド関数のタイマー、CI の定期実行ワークフロー、プロセス内スケジューリングライブラリ | トリガーと業務ロジックを分離し、失敗時に再実行できるようにする |
| データ取得器 | 情報源から新しいコンテンツを取得する | 公開 API、RSS、Web スクレイピング | タイムアウトと取得件数の上限を設定し、確認済み ID を記録する |
| 要約器 | 大規模言語モデルを呼び出して要約を生成する | Chat Completions インターフェース | 入力を適切な長さに切り詰め、プロンプトを固定し、出力形式を制約する |
| 出力器 | 結果を人が確認できる場所に届ける | メール、IM ボットの Webhook、Markdown ファイル、データベース | 配信失敗時にファイルへ保存するなど、代替手段を用意する |
4つの部分は、シンプルなデータ構造だけを介してやり取りします。取得器は「項目のリスト」を出力し、要約器は「要約テキスト」を出力し、出力器はそのテキストを処理します。この設計なら、どこかに問題が起きても個別に原因を特定できます。例えば、要約の品質が悪ければ要約器だけを調整し、配信に失敗したら出力器だけを調べれば済みます。
最初のバージョンでは、すべてのロジックを1つのスクリプトに詰め込むケースも多いでしょう。動作はしても、保守は大変です。Hacker News を GitHub Trending に変更したり、モデルを別のサービスに切り替えたりするたびに、コード全体を修正する必要が出てきます。コンポーネントごとに分けておけば、情報源を増やすには取得器を追加するだけで済み、モデル層は設定を変更するだけで切り替えられます。
監視・要約エージェントの定期実行方法を選ぶ
「常駐」を実現するうえで欠かせないのが、定期的な実行です。OpenRouter のチュートリアルでは常駐プロセスとして実装していますが、実際のデプロイ方法にはいくつかの選択肢があります。手持ちのインフラに合わせて選びましょう。
| 実行方法 | 動作形態 | メリット | 注意点 |
|---|---|---|---|
| システムの cron | 実行のたびに新しいプロセスを起動し、完了後に終了 | シンプルで信頼性が高く、プロセスが常駐しないためメモリリークが起きない | 状態をディスクに保存する必要があり、環境変数も別途設定が必要 |
| プロセス内スケジューリングライブラリ | プロセスが常駐し、内部で定期実行 | 接続やキャッシュを共有しやすい | プロセスのクラッシュに備えた監視が必要(systemd やコンテナの再起動ポリシーなど) |
| クラウド関数のタイマー | サーバーレスで定刻に実行 | 運用管理が不要で、呼び出し回数に応じた課金 | 実行時間に上限があり、状態は外部に保存する必要がある |
| CI の定期ワークフロー | CI プラットフォーム上でスケジュールに従って実行 | サーバー費用がかからず、ログを追跡できる | 実行時刻が遅れる場合があり、高頻度の実行には不向き |
1時間ごとや1日ごとに実行する要約タスクなら、システムの cron と「実行後に終了する」スクリプトを組み合わせる方法が、通常は最もコストパフォーマンスに優れています。常駐プロセスのメモリ使用量が増え続ける問題を避けられ、失敗しても次の実行時刻に再試行されます。分単位の高頻度な監視が必要な場合や、複数回の実行にまたがって負荷の大きいリソースを共有したい場合に、常駐プロセスを検討するとよいでしょう。
監視サマリーAgentのモデル呼び出し層をどう切り離すか
ここがこの記事のポイントです。OpenRouterのチュートリアルでは、同社の @openrouter/agent SDKを使用しています。手早く始めるには便利ですが、このSDKがカスタムのOpenAI互換エンドポイントに対応しているかどうかは、公開されている概要情報には記載がなく、こちらでも確認していません。そのため、この記事ではSDKを他のプラットフォームに接続する方法は扱いません。
そこで、別の方法を考えてみましょう。業務コードを特定のAgent SDKに直接依存させるのではなく、間に薄い「サマリーインターフェース」を設けます。業務コードは summarize(items) を呼び出すだけ。裏側でどのモデルやエンドポイントを使うかは、この層が設定に応じて決定します。
監視サマリーAgentの呼び出し層のインターフェース設計
呼び出し層の設計原則は、次の3つにまとめられます。どれもシンプルですが、将来の手戻りを大幅に減らせます。
- 業務上の意味だけを公開する:外部には
summarize(items) -> strを提供し、messagesやtemperatureなどの低レベルなパラメータを業務コードに公開しません。 - 内部のプロトコルを統一する:内部ではOpenAI互換のChat Completions形式を使用し、
base_url、api_key、modelはすべて環境変数から読み込みます。 - 失敗時には代替結果を返す:呼び出しに失敗した場合は一定回数リトライし、それでも失敗したら元のタイトル一覧を出力します。これにより、その日に読める結果を最低限確保できます。
OpenAI互換プロトコルを基盤に選ぶ理由は、事実上の共通形式となっており、公式SDKや多数のサードパーティ製ツールで base_url の変更がサポートされているためです。サーバー側がこの形式に対応していれば、モデルの切り替えは設定を1行変更するだけで済みます。
| インターフェースの選択肢 | モデル切り替えのコスト | エコシステムとツール | 適した場面 |
|---|---|---|---|
| 特定の専用Agent SDKに依存する | プロバイダーの変更時には通常コードの修正が必要 | SDKの組み込み機能をすぐに使える | そのプラットフォームを長期利用すると決めており、組み込み機能を重視する場合 |
| OpenAI公式SDKと互換エンドポイントを直接使う | base_url と model を変更するだけ |
エコシステムが最も成熟しており、サンプルも豊富 | ほとんどの監視サマリータスク |
| HTTP呼び出しを自前で実装する | 設定の変更だけで済むが、保守コストは自分で負担する | 依存関係が最も少ない | 依存ライブラリのサイズに特に敏感な環境 |
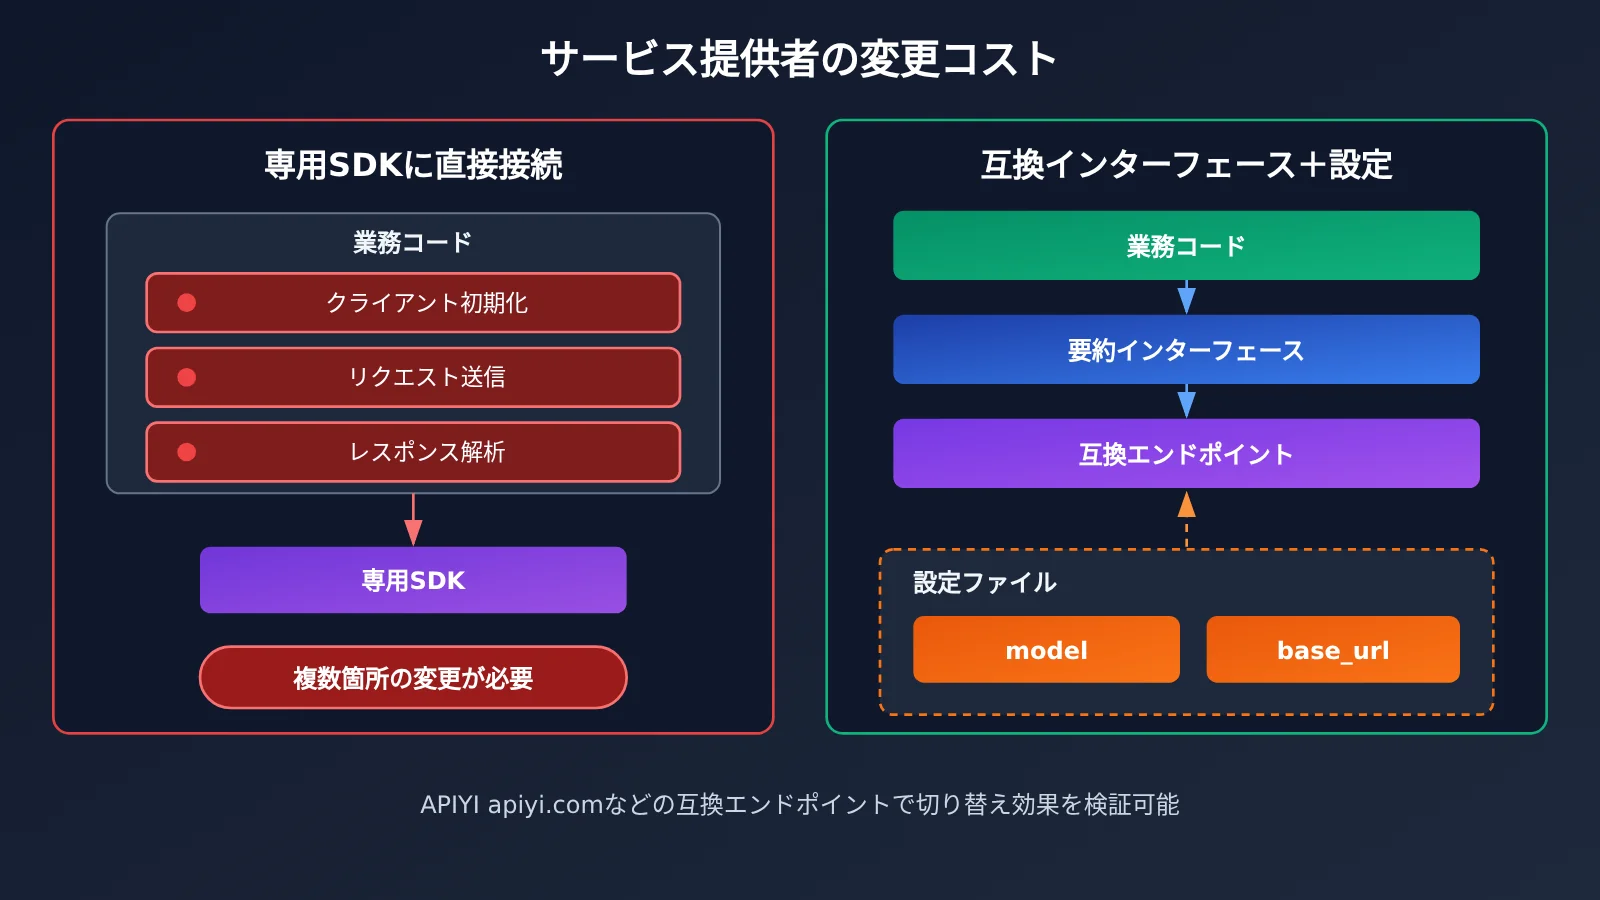
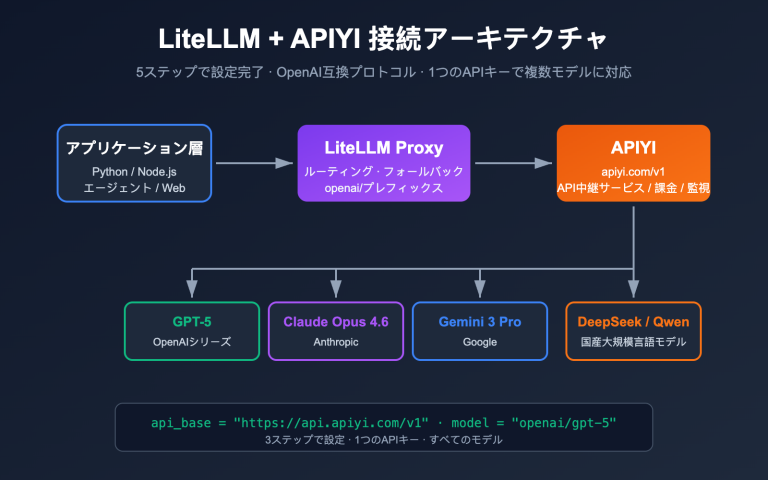
この設計なら、APIYIのような集約プラットフォームもモデル呼び出し層の選択肢の一つになります。APIYIはOpenAI API形式と互換性があり、OpenAI公式SDKから接続できます。モデルの切り替えもモデル名を変更するだけです。監視サマリーAgentでは、モデルごとに接続コードを書くことなく、同じAPIキーで異なるモデルのサマリーを比較できます。
監視情報の要約タスクでモデルを選ぶ際のポイント
要約タスクは一見シンプルですが、情報源によってモデルに求められる能力は大きく異なります。現時点ではこの種のタスクに関する体系的なテストデータがないため、「どのモデルが最適か」という結論は示さず、選定時に比較したいポイントを整理します。
| 考慮すべき要素 | 重要な理由 | 実践のヒント |
|---|---|---|
| コンテキスト長 | 一度に数十件の見出しや本文を入力することがある | まず入力を絞り込み、その後の長さに合わせてモデルを選ぶ |
| 指示への追従性 | 配信や解析をしやすくするため、要約には固定フォーマットが必要 | 同じプロンプトで数回実行し、フォーマットが安定しているか確認する |
| 言語能力 | 英語の情報源から中国語の要約を出力する必要がある | 特に専門用語が正確に翻訳されているかを確認する |
| 呼び出しコスト | 定期タスクを長期間運用すると、費用が積み重なる | 1回の実行につき呼び出しを1回に抑え、入力件数と出力の長さを制御する |
| サービスの安定性 | 無人で運用するため、失敗に翌日まで気づかないことがある | リトライとフォールバックを設定し、予備のモデルも用意する |
💡 選び方のヒント:要約モデルに決まった正解はありません。実際に使う情報源で数日間試し、比較するのが最も確実です。APIYI apiyi.com を通じて、同じコードで複数の候補モデルを切り替えながら、フォーマットの安定性や中国語の表現を比較し、長期的に使うモデルを決めるとよいでしょう。
監視・要約エージェントのクイックスタート
ここでは、Pythonで最小限の機能を備えたエージェントを実装します。情報源にはHacker Newsの公開API(hacker-news.firebaseio.com/v0)を使用します。OpenRouterチュートリアルと同じシナリオなので、比較しながら理解できます。
最小限の例:取得して要約する
以下のコードは、Hacker Newsの人気記事トップ10のタイトルを取得し、モデルに中国語の要約を生成させます。一連の処理が正常に動くかを確認するための例です。
import requests
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI 兼容端点
)

HN = "https://hacker-news.firebaseio.com/v0"
ids = requests.get(f"{HN}/topstories.json", timeout=10).json()[:10]
titles = [requests.get(f"{HN}/item/{i}.json", timeout=10).json().get("title", "") for i in ids]

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # 示例模型名,以平台模型列表为准
    messages=[{"role": "user", "content": "用中文分 3 点总结这些热帖的主题:\n" + "\n".join(titles)}]
)
print(resp.choices[0].message.content)
このコードは動作しますが、まだ「常時運用」には向いていません。重複排除やエラー処理がなく、モデルとエンドポイントも固定されているためです。以下の完全版では、4つのコンポーネントを分離し、状態管理を追加しています。
完全な実装コードを見る(4コンポーネント+重複排除+フォールバック)
import json
import os
import time
from pathlib import Path

import openai
import requests

HN = "https://hacker-news.firebaseio.com/v0"
STATE_FILE = Path(os.getenv("STATE_FILE", "seen_ids.json"))
TOP_N = int(os.getenv("TOP_N", "30"))


# ---------- 数据获取器 ----------
def fetch_new_stories(seen: set) -> list:
    ids = requests.get(f"{HN}/topstories.json", timeout=10).json()[:TOP_N]
    items = []
    for i in ids:
        if i in seen:
            continue
        item = requests.get(f"{HN}/item/{i}.json", timeout=10).json() or {}
        if item.get("title"):
            items.append({"id": i, "title": item["title"],
                          "url": item.get("url", ""), "score": item.get("score", 0)})
    return items


# ---------- 状态管理 ----------
def load_seen() -> set:
    return set(json.loads(STATE_FILE.read_text())) if STATE_FILE.exists() else set()

def save_seen(seen: set) -> None:
    STATE_FILE.write_text(json.dumps(sorted(seen)[-2000:]))  # 只保留最近的 ID


# ---------- 摘要器(模型调用层) ----------
class Summarizer:
    def __init__(self):
        self.client = openai.OpenAI(
            api_key=os.environ["LLM_API_KEY"],
            base_url=os.getenv("LLM_BASE_URL", "https://api.apiyi.com/v1"),
        )
        self.model = os.getenv("SUMMARY_MODEL", "gpt-4o-mini")

    def summarize(self, items: list, retries: int = 2) -> str:
        lines = "\n".join(f"- [{x['score']}] {x['title']}" for x in items)
        prompt = ("你是技术资讯编辑。请用中文把下面的 Hacker News 新热帖归纳为 3-5 个主题,"
                  "每个主题一句话,并列出最值得关注的 3 条标题。\n" + lines)
        for attempt in range(retries + 1):
            try:
                resp = self.client.chat.completions.create(
                    model=self.model,
                    messages=[{"role": "user", "content": prompt}],
                    max_tokens=800,
                )
                return resp.choices[0].message.content
            except Exception as e:
                print(f"摘要失败(第 {attempt + 1} 次):{e}")
                time.sleep(2 ** attempt)
        return "【模型暂不可用,以下为原始标题】\n" + lines  # 降级输出


# ---------- 输出器 ----------
def deliver(text: str) -> None:
    webhook = os.getenv("WEBHOOK_URL")
    if webhook:
        try:
            requests.post(webhook, json={"text": text}, timeout=10).raise_for_status()
            return
        except Exception as e:
            print(f"推送失败,改为落盘:{e}")
    Path(f"digest-{time.strftime('%Y%m%d-%H%M')}.md").write_text(text, encoding="utf-8")


# ---------- 一次运行(由定时器触发) ----------
def run_once() -> None:
    seen = load_seen()
    items = fetch_new_stories(seen)
    if not items:
        print("没有新条目,本轮跳过")
        return
    deliver(Summarizer().summarize(items))
    save_seen(seen | {x["id"] for x in items})


if __name__ == "__main__":
    run_once()
完全版には、押さえておきたい設計上のポイントがいくつかあります。まず、Summarizer が外部に公開するのは summarize だけで、モデル名、エンドポイント、APIキーはすべて環境変数から取得します。これは、前述した呼び出し層の分離にあたります。次に、状態ファイルには直近の一群の ID だけを保持し、長期間の運用でファイルが際限なく大きくなるのを防ぎます。最後に、モデルの処理が失敗した場合は元のタイトルを出力し、通知の送信に失敗した場合は結果をファイルに保存します。これにより、毎回の実行結果を後から確認できます。
監視・要約 Agent の定期実行
スクリプトは「一度実行したら終了する」設計なので、システムの cron にそのまま任せられます。以下の設定では、毎日 8 時と 20 時に 1 回ずつ実行されます。
# crontab -e
0 8,20 * * * cd /opt/hn-digest && LLM_API_KEY=xxx SUMMARY_MODEL=gpt-4o-mini /usr/bin/python3 agent.py >> run.log 2>&1
別のモデルと比較したい場合は、SUMMARY_MODEL を別のモデル名に変更するだけで、コードを一行も書き換える必要はありません。本番環境では、APIキーを crontab に直接書かず、.env ファイルやシークレット管理サービスに保存することをおすすめします。
🚀 まずはここから:最小構成のサンプルで処理が問題なく動くことを確認してから、完全版に切り替えて cron に登録しましょう。APIYI(apiyi.com)では新規ユーザー向けの無料テスト枠を提供しており、1 つの APIキーで OpenAI、Claude、Gemini などのモデルを切り替えられます。プロトタイプ段階で要約の出来を手早く比較するのに便利です。
よくある質問 FAQ
Q1:定期実行型の監視・要約 Agent とは何ですか?
タイマーによって定期的に起動する自動化プログラムです。予定に従って情報源から新着情報を取得し、大規模言語モデルで要約したうえで、メールや IM、ファイルに出力します。対話型 Agent と異なり、無人で長期間稼働するため、複雑な推論よりも安定性や重複排除が重要です。
Q2:専用 Agent SDK と OpenAI 互換インターフェースの違いは何ですか?
専用 SDK にはツール呼び出しやスケジューリングなどの機能が組み込まれていることが多く、すぐに開発を始められます。一方で、業務コードがそのプラットフォームに依存します。OpenAI 互換インターフェースはより低レベルなため、スケジューリングや重複排除を自分で実装する必要がありますが、モデルやサービス提供者を設定変更だけで切り替えられます。シンプルな要約タスクでは、後者の柔軟性のほうが役立つことが多いでしょう。
Q3:OpenRouter の @openrouter/agent チュートリアルを、そのまま別のプラットフォーム向けに変更できますか?
現在公開されている概要情報には、このチュートリアルが TypeScript で `@openrouter/agent` 0.11.0 を使って実装されていることしか記載されていません。SDK がカスタムエンドポイントに対応しているかどうかは、こちらでも確認できていません。切り替えの余地を残したい場合は、チュートリアルの活用例を参考にしつつ、この記事のように OpenAI 互換の呼び出し層を使って自分で実装するほうが確実です。
Q4:監視・要約 Agent はどのような場面に適していますか?
– **技術コミュニティの人気投稿の日報**:Hacker News や技術フォーラムの話題を毎日まとめる
– **競合の更新情報の追跡**:競合のブログや更新履歴を監視し、変更点を要約する
– **オープンソースプロジェクトの動向**:注目しているリポジトリの新バージョンや重要な Issue をまとめる
– **業界ニュースの朝刊**:複数の RSS フィードを集約し、毎朝中国語の速報を配信する
Q5:API を使ってモデルを素早く呼び出し、要約するにはどうすればよいですか?
OpenAI 互換形式に対応した集約プラットフォームの利用をおすすめします。
1. APIYI apiyi.com にアクセスしてアカウントを登録し、APIキーと無料テスト枠を取得する
2. この記事のコードの `base_url` を `https://api.apiyi.com/v1` に設定する
3. `SUMMARY_MODEL` 環境変数でモデルを切り替え、要約の結果を比較する
Q6:長期間の運用における呼び出しコストを抑えるにはどうすればよいですか?
基本は、差分だけを処理し、1回の実行につきモデルの呼び出しを1回に抑えることです。状態ファイルを使って処理済みの項目を除外し、1回あたりの入力件数と `max_tokens` を制限したうえで、実際のニーズに合わせて実行頻度を設定しましょう。モデルによって料金は大きく異なるため、APIYI apiyi.com のモデル料金ページで比較し、要約のような軽量タスクにはより経済的なモデルを選べます。
Q7:監視・要約 Agent にはどのような制限がありますか?
– **タイトルだけでは情報が限られる**:タイトルだけで要約すると内容を誤って判断する可能性があります。必要に応じて本文を取得できますが、入力の長さや適法な取得に注意が必要です
– **モデルが詳細を作り出すことがある**:与えられた内容だけに基づいて要約するようプロンプトで指示し、重要な結論には元のリンクを残しましょう
– **情報源は変化する**:インターフェースの形式やレート制限の方針が変わると取得に失敗するため、実行ログを監視する必要があります
監視サマリー Agent の重要ポイント Key Takeaways
- 4段階の構成:定期実行、データ取得、モデルによる要約、結果出力をそれぞれ独立させ、差し替えやトラブルシューティングをしやすくする
- 処理後に終了するほうが安定:実行頻度の低い要約タスクには、常駐プロセスよりも cron と単発スクリプトの組み合わせが手軽
- 状態管理が品質を左右する:処理済みの ID を記録し、毎回新着分だけを要約することで、重複や無駄を防ぐ
- 呼び出し層を分離する:業務ロジックは
summarizeインターフェースのみに依存させ、モデル、エンドポイント、APIキーはすべて設定から読み込む - 互換プロトコルを基盤にする:OpenAI 互換形式を使えば、環境変数を1行変えるだけでモデルを切り替えられる
- モデルは実測で選ぶ:コンテキスト、指示への追従性、言語、コスト、安定性を比較する。APIYI apiyi.com なら、同じコードでモデルを切り替えて検証できる
- 失敗時の代替手段を用意する:モデルの処理に失敗したら元のタイトルを出力し、通知に失敗したらファイルに保存する
まとめ
定期的に実行する監視サマリー Agent の構築では、複雑なフレームワークを使うことよりも、構造を明確に分けることが重要です。
- コンポーネントの分割:実行、取得、要約、出力の4つのコンポーネントをシンプルなデータ構造でつなぎ、それぞれを個別にテストできるようにする
- インターフェースの分離:薄い要約インターフェースで特定の SDK への依存を分離し、基盤には OpenAI 互換プロトコルを採用する
- 安定性を優先:重複排除、リトライ、代替手段の用意は、無人で実行するタスクに欠かせない設計
OpenRouter の Hacker News チュートリアルは、よい実践例です。本記事の汎用アーキテクチャを使えば、同じ考え方をさまざまな情報源やモデルに応用できます。まずは最小限のサンプルで一連の処理を動かし、次に cron で数日間実行して、要約の品質を確認してから長期的に使うモデルを選ぶのがおすすめです。
効果を手早く検証するには、APIYI apiyi.com がおすすめです。1つの APIキーで複数の主要モデルを切り替えられ、新規ユーザーは無料のテスト枠をプロトタイプ段階の比較テストに利用できます。
📚 参考資料
- OpenRouter チュートリアルの概要:Agent SDK で Hacker News を監視する常駐 AI エージェントを構築
- リンク:
aihot.news/items/upl3hjjdokqe13w3ieo9opr0v -
説明:本記事のきっかけとなった資料です。
@openrouter/agent0.11.0 を使い、TypeScript で定期実行するエージェントを構築する方法を紹介しています -
Hacker News 公式 API:公開されている読み取り専用のデータ API
- リンク:
github.com/HackerNews/API -
説明:topstories や item などのエンドポイントのフィールドを解説しています。本記事のサンプルで使用するデータソースのドキュメントです
-
OpenAI Python SDK:公式クライアントライブラリ
- リンク:
github.com/openai/openai-python - 説明:
base_urlパラメータを使って互換エンドポイントに接続する方法を紹介しています
著者:APIYI 技術チーム
技術に関するお問い合わせ:APIYI のウェブサイトのトップページからお気軽にお問い合わせください。接続方法の詳細は docs.apiyi.com のドキュメントセンターをご覧ください