Catatan penulis: Berangkat dari desain super-agent DeepSeek, artikel ini membahas cara memilih model untuk router dan worker dalam sistem multi-agen, serta menjelaskan bagaimana Token yang dibaca dari cache memengaruhi biaya arsitektur.
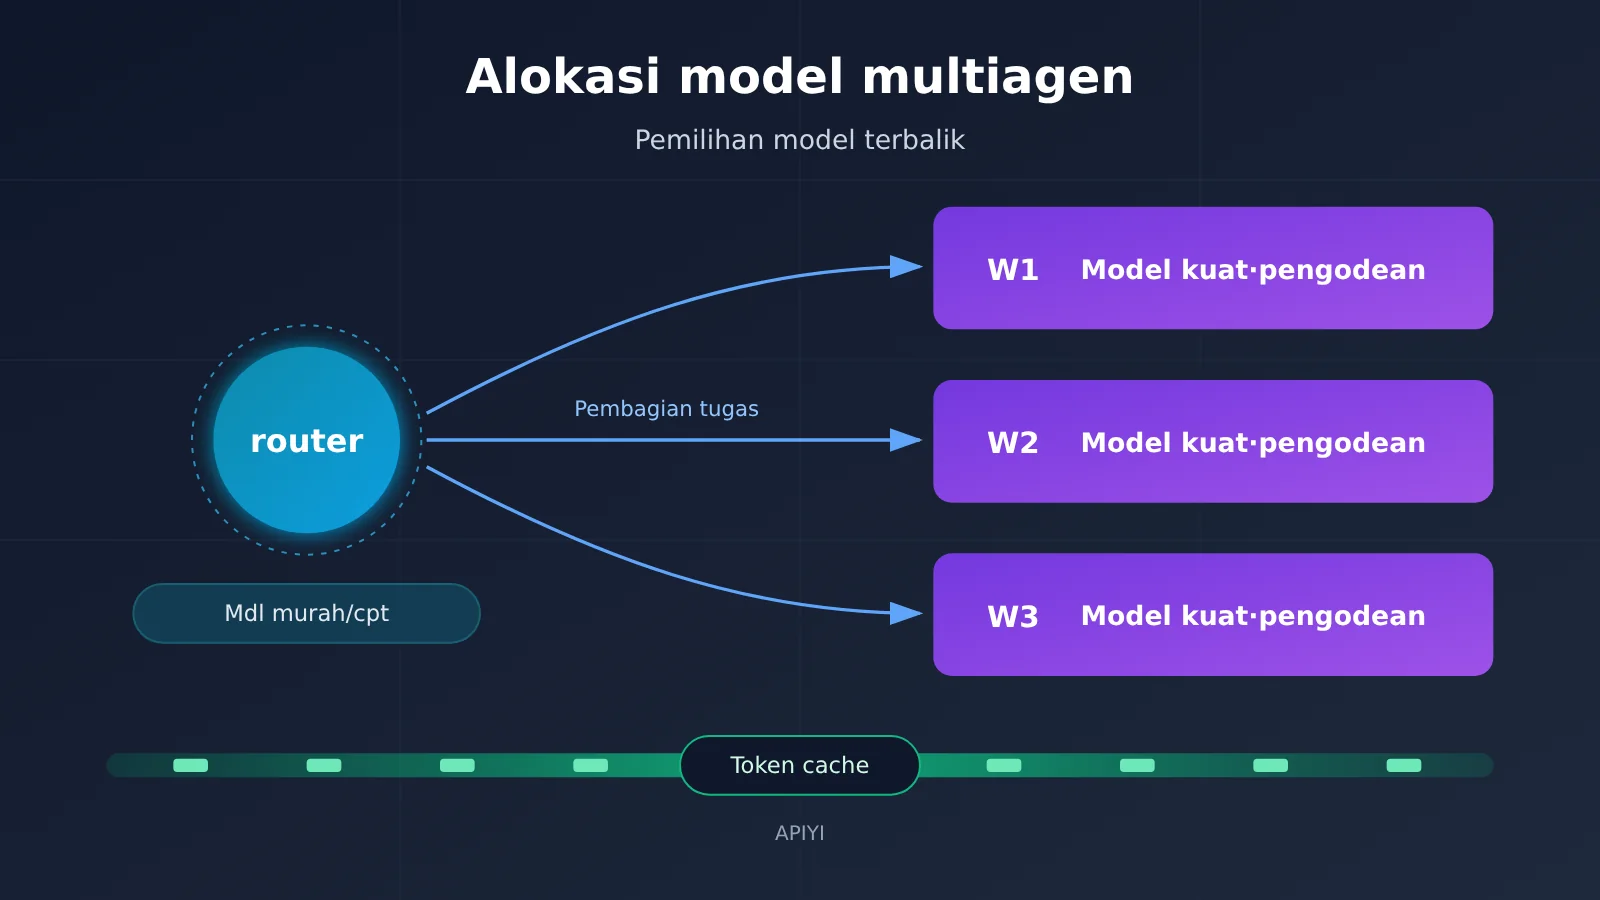
Saat membangun sistem pengodean multi-agen, kebanyakan orang memilih model terkuat untuk “komandan utama”, lalu menggunakan model murah untuk para pelaksananya. Desain super-agent yang dipublikasikan tim DeepSeek Harness pada November 2026 menawarkan pendekatan sebaliknya: router menggunakan model murah, worker menggunakan model kuat. Router yang menangani percakapan dan membagikan tugas memakai model ringan, sementara worker yang benar-benar menulis kode memakai model terkuat.
Ini bukan sekadar artikel yang menceritakan ulang berita. Kita akan menerjemahkan arsitektur ini menjadi panduan praktis untuk memilih model: kemampuan apa yang dibutuhkan router dan worker, bagaimana memperkirakan jumlah Token yang dibaca dari cache, serta kapan sebaiknya memilih model berbiaya rendah. Data pengujian yang dikutip dalam artikel ini pun oleh DeepSeek sendiri hanya disebut sebagai hasil “indikatif”; kita akan menjelaskan batasannya.
Manfaat utama: Setelah membaca artikel ini, kamu bisa menyusun rencana pembagian model berdasarkan peran untuk sistem multi-agenmu sendiri, sekaligus memperkirakan besaran biayanya dari jumlah Token yang dibaca dari cache.
Pokok-Pokok Pembagian Model untuk Multiagen
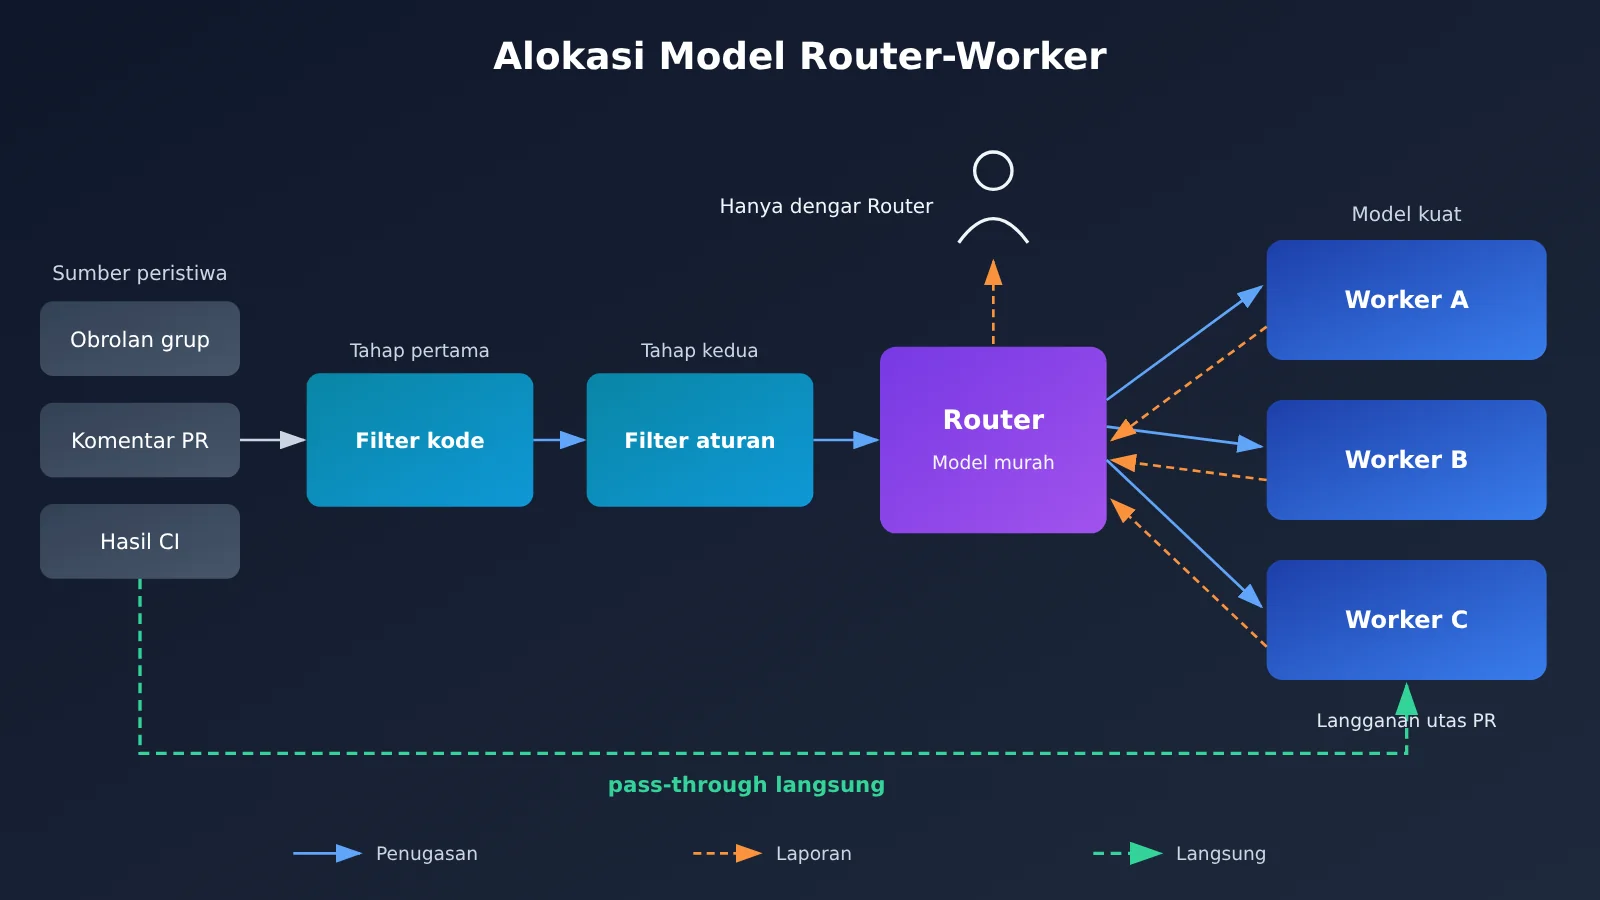
Desain DeepSeek terdiri dari dua lapisan. Router adalah sesi yang berjalan terus-menerus untuk berkomunikasi dengan pengguna, membagikan tugas, dan melacak hubungan antartugas. Worker hanya menangani satu tugas dalam satu waktu, dengan konteks baru yang terpisah. Worker tidak pernah berbicara langsung dengan pengguna dan hanya melaporkan status kepada router. Berdasarkan pembagian ini, tabel berikut bisa menjadi panduan awal untuk memilih model.
| Peran | Tanggung jawab utama | Menulis kode? | Tingkat model yang disarankan | Alasan pemilihan |
|---|---|---|---|---|
| router | Berdialog, membagikan tugas, dan melacak hubungan antartugas | Tidak; izin shell pun tidak wajib diberikan | Ringan, murah, dan cepat | Tugasnya sederhana tetapi sering dipanggil, jadi latensi dan biaya per panggilan lebih penting |
| worker | Menerima satu tugas dan menyelesaikan penulisan kodenya | Ya | Model coding terkuat yang tersedia saat ini | Kualitas kode langsung menentukan hasil akhir |
| Lapisan penyaring pemicu | Menyaring noise dari obrolan grup dan notifikasi CI | Tidak | Gunakan kode biasa pada tahap pertama dan model kecil pada tahap kedua | Sebagian besar peristiwa tidak perlu diteruskan ke model |
Mengapa pembagian model multiagen perlu “dibalik”
Menurut DeepSeek, hambatan utama dalam coding berbantuan AI telah bergeser dari kemampuan model ke perhatian manusia. Biasanya, satu orang hanya mampu mengikuti 3 hingga 5 sesi agen aktif secara bersamaan. Jika lebih banyak, akan sulit mengetahui sesi mana yang menunggu persetujuan, mana yang terhambat, atau dua sesi mana yang diam-diam mengubah PR yang sama. Karena itu, nilai router bukan terletak pada “kecerdasan”, melainkan pada kemampuannya membagikan tugas dan mencatat status secara konsisten. Router tidak memecah tugas; ia hanya membagikan dan melacaknya. Ini berbeda dari pola umum, ketika “agen utama memecah tugas menjadi beberapa langkah”.
Karena router tidak membutuhkan penalaran mendalam dan tidak menulis kode, menempatkan model termahal di sana hanya akan membuang anggaran. Worker-lah yang menghasilkan kode, dan kualitas kode menentukan keberhasilan hasil akhir. Jadi, anggaran untuk model yang kuat sebaiknya dialokasikan ke worker. Inilah yang dimaksud dengan “pembalikan pemilihan model”: semakin dekat perannya dengan pengguna, semakin ringan modelnya; semakin dekat dengan kode, semakin kuat modelnya.
Kemampuan apa saja yang dibutuhkan router dan worker?
Agar bisa memilih model yang tepat, kita perlu memecah tanggung jawab setiap peran menjadi kemampuan yang dibutuhkan. Daftar berikut bisa langsung digunakan untuk mengevaluasi model kandidat.
| Kemampuan | Kebutuhan router | Kebutuhan worker | Panduan pemilihan |
|---|---|---|---|
| Mengikuti instruksi dan klasifikasi | Tinggi, harus konsisten menentukan tugas yang menjadi tanggung jawabnya | Sedang | Prioritaskan pengujian akurasi pembagian tugas untuk router |
| Konteks panjang dan penelusuran kembali | Sedang, menggunakan ringkasan berdasarkan ID yang diuraikan bertahap | Tinggi, perlu membaca banyak kode | Perhatikan jendela konteks dan kemampuan pencarian kode worker |
| Kualitas pembuatan kode | Tidak diperlukan | Prioritas tertinggi | Jangan terlalu menghemat anggaran untuk worker |
| Latensi respons | Prioritas tinggi, sering mengambil keputusan | Sedang, setiap tugas boleh memakan waktu lebih lama | Pilih model cepat sekelas Flash untuk router |
| Sensitivitas terhadap harga satuan | Sangat tinggi, volume pembacaan cache sangat besar | Sedang | Harga satuan router memengaruhi total biaya |
| Pemanggilan alat | Sedikit, akses shell bisa ditiadakan | Banyak, perlu menjalankan kode dan pengujian | Batasi setiap peran dengan batasan izin |
Ada satu kebutuhan router yang mudah terlewat: secara struktural, router tidak boleh “mengerjakan tugas sendiri”. DeepSeek sengaja tidak memberikan akses shell kepada router untuk menghilangkan kemungkinan itu. Jadi, saat memilih model untuk router, tidak perlu mencari model yang “bisa melakukan segalanya”. Sebaliknya, kita perlu menerima bahwa router “hanya bisa membagikan tugas”.
Biaya Token Pembacaan Cache dalam Alokasi Model Multi-Agen
Router yang murah saja belum cukup. Komponen biaya terbesar dalam arsitektur ini adalah Token pembacaan cache. Router bekerja dalam sesi jangka panjang dan berulang kali membaca konteks dari cache. Di sisi lain, beberapa worker berjalan paralel dan masing-masing juga membaca banyak konteks. Data pengujian DeepSeek menunjukkan masalah ini dengan jelas.
| Metrik pengujian | Nilai | Keterangan |
|---|---|---|
| Jumlah pesan per putaran | Sekitar 300 | Sekitar 20 di antaranya adalah permintaan kerja nyata |
| Waktu penyelesaian rata-rata super-agent | 12,4 menit | Waktu pada sisi yang lebih lambat adalah 15,7 menit |
| Waktu baseline sesi tunggal pada sisi yang lebih lambat | 29,5 menit | Digunakan sebagai pembanding |
| Beban keputusan router | Naik dari sekitar 1 menjadi sekitar 40 per menit | Waktu per keputusan turun dari 6,4 detik menjadi 1,6 detik |
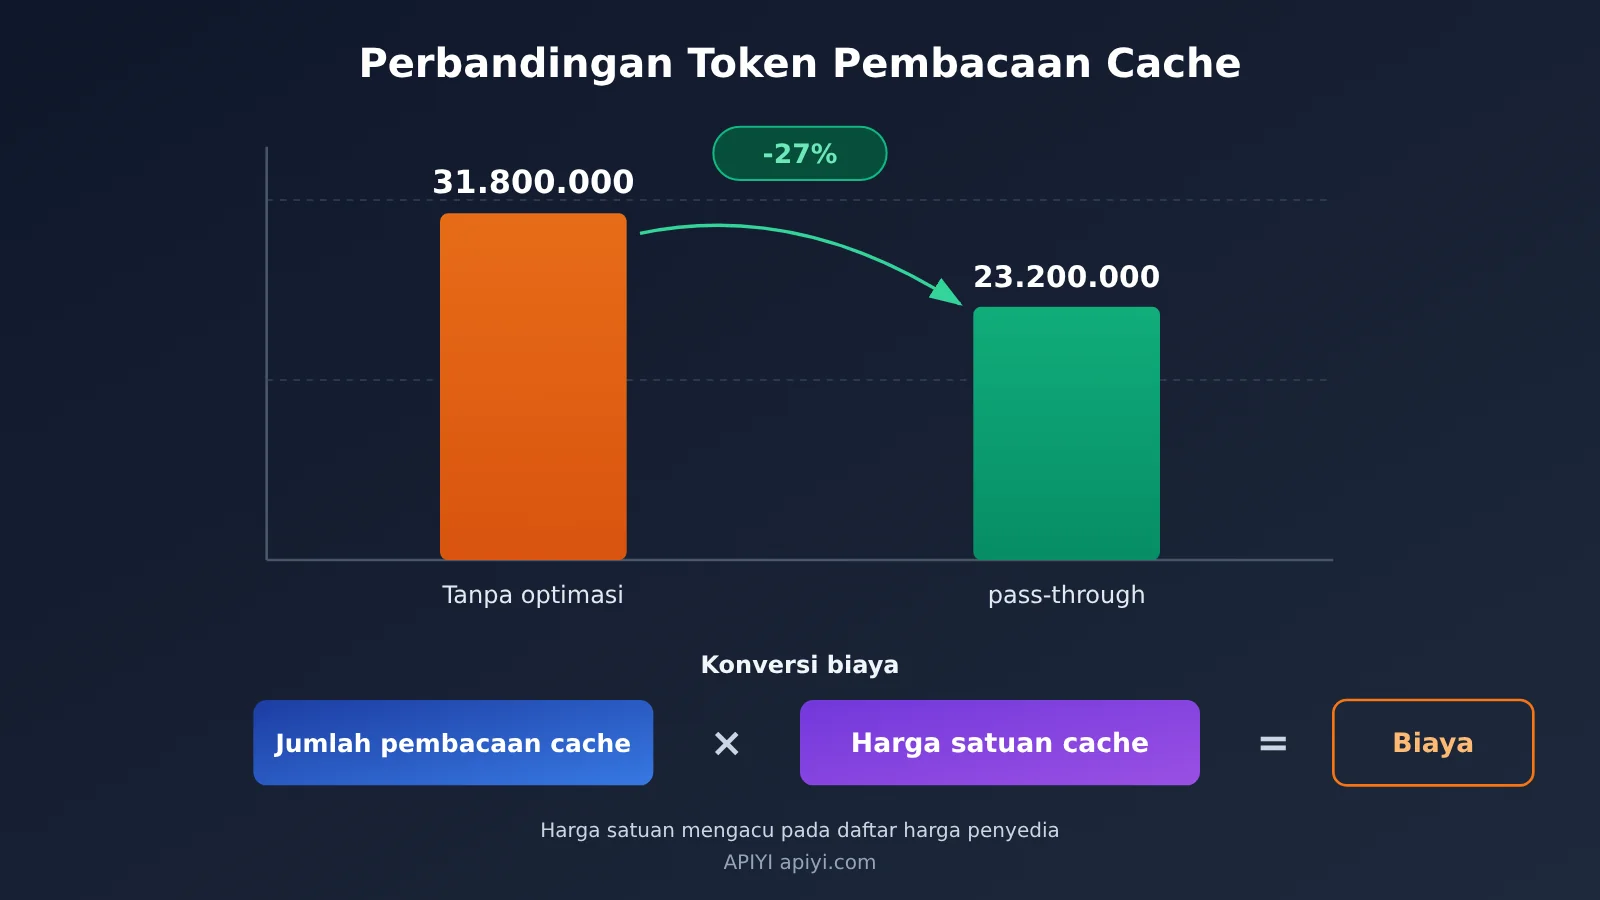
| Token pembacaan cache | 23,2 juta | Dengan optimasi pass-through |
| Pembacaan cache tanpa optimasi | 31,8 juta | Saat worker tidak berlangganan thread secara langsung |
| Biaya cache | Sekitar 7 dolar AS | Berdasarkan harga tingkat Flash DeepSeek pada jam sepi |
Cara memperkirakan biaya alokasi model multi-agen berdasarkan pembacaan cache
Untuk memperkirakan biaya satu putaran, bagi perhitungannya menjadi tiga bagian: Token pembacaan cache dikalikan harga satuan pembacaan cache, ditambah Token input yang tidak ditemukan di cache dikalikan harga satuan input, lalu ditambah Token output dikalikan harga satuan output. Dalam arsitektur router-worker, bagian pertama biasanya mendominasi biaya. Karena itu, harga pembacaan cache adalah komponen yang paling perlu diperhatikan saat memilih model.
Jika dihitung mundur dari angka yang dilaporkan, sekitar 7 dolar AS untuk 23,2 juta Token pembacaan cache setara dengan kurang lebih 0,3 dolar AS per juta Token. Ini hanya perkiraan dari angka dalam laporan, bukan harga resmi. Harga aktual harus mengacu pada daftar harga terkini dari penyedia model. Dengan angka perkiraan ini, Anda bisa memasukkan harga pembacaan cache dari model kandidat untuk melihat seberapa besar kenaikan biaya jika beban kerja yang sama dijalankan dengan model yang lebih mahal.
Optimasi pass-through juga patut diperhatikan. Setelah worker berlangganan thread, peristiwa baru langsung diteruskan ke worker tanpa melalui router. Pembacaan cache pun turun dari 31,8 juta menjadi 23,2 juta, atau berkurang sekitar 27%. Artinya, optimasi arsitektur dan penggunaan model yang lebih murah sama-sama dapat langsung menekan biaya.
Tiga batasan data asli yang perlu diperhatikan
- Tahap penulisan kode disimulasikan: Dalam pengujian, “menulis kode” digantikan oleh alat yang hanya menghabiskan waktu. Yang diukur adalah perilaku penjadwalan, bukan kualitas kode, sehingga hasilnya tidak bisa membuktikan model mana yang paling efektif untuk worker.
- Data hanya bersifat indikatif: DeepSeek menegaskan bahwa angka-angka ini bersifat indicative, bukan hasil benchmark yang ketat.
- Pernyataan perbandingan harga dengan tingkat Sonnet tidak konsisten: Ringkasan laporan menyebut perkiraan sekitar 4,64 dolar AS berdasarkan harga tingkat Sonnet, tetapi isi artikel mengatakan bahwa penggunaan yang sama pada tingkat harga yang lebih tinggi akan “jauh lebih mahal”. Kedua pernyataan ini bertentangan. Sebelum memeriksanya di artikel asli DeepSeek, sebaiknya jangan mengutip perbandingan harga tersebut.
Panduan Cepat Alokasi Model Multi-Agen
Untuk menerapkan logika di atas ke sistem Anda, ikuti langkah-langkah berikut. Tidak ada kode di sini; semua opsi konfigurasi dijelaskan langsung dalam teks agar mudah disesuaikan dengan framework Anda.
- Tentukan peran sebelum memilih model: Buat daftar semua peran yang memanggil model dalam sistem. Setidaknya, bedakan antara router, worker, dan filter pemicu. Catat apakah setiap peran menulis kode dan membutuhkan alat.
- Jadikan nama model sebagai opsi konfigurasi: Atur parameter terpisah untuk setiap peran, seperti
router_model,worker_model, danfilter_model. Jangan menanam nama model langsung di kode aplikasi. - Pastikan delegasi melalui struktur: Hapus alat eksekusi seperti shell dari router. Eksperimen DeepSeek menunjukkan bahwa agen dengan satu sesi tidak pernah mendelegasikan tugas dalam 5 kali percobaan dengan petunjuk netral; percobaan paling lambat memakan waktu hampir setengah jam. Bahkan ketika petunjuk secara jelas meminta delegasi, dalam 1 dari 5 percobaan agen menganggap tugas terlalu kecil dan mengerjakannya sendiri.
- Lakukan penyaringan terlebih dahulu: Gunakan kode biasa untuk menyaring gangguan dari peristiwa pemicu berdasarkan sumber dan daftar izin. Hanya kirim peristiwa yang lolos ke model untuk dinilai berdasarkan aturan tim.
- Catat jumlah token yang dibaca dari cache: Pada setiap putaran, catat tiga kategori token: pembacaan cache, input tanpa cache, dan output. Gunakan rumus sebelumnya untuk menghitung biaya per putaran.
- Bandingkan dengan model lain: Gunakan kumpulan tugas yang sama dan hanya ganti
router_model. Amati perubahan pada akurasi pembagian tugas, latensi, dan biaya, lalu putuskan apakah perlu beralih ke model yang lebih rendah.
Pada langkah ke-2 dan ke-6, metode integrasi langsung memengaruhi efisiensi eksperimen. Jika router dan worker berasal dari penyedia berbeda, mengelola kunci dan konfigurasi SDK masing-masing berarti Anda harus mengubah banyak hal setiap kali beralih model. Melalui platform antarmuka terpadu seperti APIYI apiyi.com, Anda bisa menggunakan kunci API yang sama dan format permintaan yang kompatibel dengan OpenAI. Cukup ubah parameter model untuk menetapkan model dari penyedia berbeda ke router dan worker, sehingga biaya eksperimen perbandingan jauh lebih rendah.
🚀 Saran untuk mulai cepat: Saat memvalidasi prototipe, gunakan satu kunci di APIYI apiyi.com untuk mengonfigurasi parameter model router dan worker secara terpisah. Jalankan kumpulan tugas yang sama dan catat penggunaan token. Untuk mengetahui model yang tersedia, misalnya model kelas Flash dari DeepSeek, lihat daftar model terkini di platform.
Kapan Memilih Model Berbiaya Rendah untuk Sistem Multi-Agen
Model berbiaya rendah tidak cocok untuk semua tugas. Tabel berikut membantu menentukan apakah setiap peran bisa menggunakan model yang lebih murah.
| Karakteristik skenario | Saran | Alasan | Cara akses |
|---|---|---|---|
| Peran hanya melakukan pembagian tugas, pelacakan, dan pemeriksaan konteks cache | Pilih model murah dan cepat | Tugasnya sederhana, sehingga harga per unit dan latensi lebih menentukan pengalaman penggunaan | APIYI apiyi.com atau API resmi penyedia |
| Peran bertugas membuat dan mengubah kode | Pilih model yang kuat | Kualitas kode menentukan hasil akhir | APIYI apiyi.com atau API resmi penyedia |
| Pembacaan cache mencapai puluhan juta dan dijalankan berulang setiap hari | Prioritaskan penurunan harga per unit pembacaan cache | Biaya cache meningkat secara linear seiring jumlah eksekusi | Hitung berdasarkan daftar harga penyedia |
| Tugas satu kali yang ringan dan jarang dilakukan | Gunakan pembayaran sesuai pemakaian | Penggunaannya kecil, sehingga kompleksitas arsitektur tambahan tidak sepadan | Saluran pembayaran sesuai pemakaian apa pun |
| Tugas otomatisasi berfrekuensi tinggi dan intensif token | Evaluasi paket bulanan atau paket dengan batas penggunaan tinggi | Biaya marjinal per eksekusi tidak lagi tercermin pada tagihan | Bergantung pada ketentuan paket |
Sebagai referensi untuk baris terakhir, laporan pada periode yang sama menyebutkan bahwa Claude Code Pass dibanderol 9,99 dolar AS per bulan. Paket ini menawarkan batas laju sekitar 2 hingga 5 kali lebih tinggi untuk model terbuka seperti Kimi K3.1 Pro, GLM 5.3, dan DeepSeek V4.1 Flash, dengan tiga tingkat batas penggunaan: per 5 jam, mingguan, dan bulanan. Laporan tersebut juga menyebutkan bahwa untuk tugas yang hanya membuat keputusan routing atau memeriksa konteks cache, model yang cepat dan murah lebih cocok secara teknis, bukan sekadar lebih hemat. Namun, paket seperti ini membatasi pilihan pada model yang tersedia di dalamnya. Jika worker membutuhkan model di luar paket, kamu tetap memerlukan saluran akses lain.
Risiko dan batasan alokasi model multiagen
Alokasi model menyelesaikan persoalan biaya dan pembagian tugas, tetapi tidak menyelesaikan masalah yang masih melekat pada arsitektur ini. DeepSeek mengakui dua persoalan yang belum terpecahkan. Pertama, memori jangka panjang: setelah sistem berjalan selama beberapa bulan, mempertahankan riwayat yang relevan tanpa memenuhi jendela konteks masih sulit dilakukan. Kedua, injeksi petunjuk: setiap agen yang membaca peristiwa eksternal, seperti obrolan grup atau komentar PR, berpotensi dimanipulasi. Router dan worker terhubung melalui siklus cloud bersama, sehingga secara teori, sumber peristiwa yang disusupi dapat menyebarkan instruksi ke setiap mesin yang diakses sistem.
Ini berdampak langsung pada alokasi model. Penggunaan model murah untuk router bukan berarti perlindungannya boleh dilonggarkan, karena justru router yang pertama kali berhadapan dengan peristiwa eksternal. Saat diterapkan secara internal di DeepSeek, perilaku proaktif awalnya dijalankan dalam mode log “seharusnya akan melakukan ini”, bukan langsung dieksekusi. Contohnya adalah strategi “reproduksi dan perbaiki secara diam-diam”: ketika seseorang melaporkan bug, agen mencoba mereproduksinya di latar belakang. Setelah bug dikonfirmasi dan diperbaiki, agen baru mengajukan PR selagi percakapan masih berlangsung. Jika gagal mereproduksinya, agen tidak mengirim apa pun. Saat meluncurkan sistem baru, lebih aman untuk mengamati log terlebih dahulu, lalu memberikan kewenangan secara bertahap.
Selain itu, kode prototipe DSH Super Agent di GitHub secara jelas ditandai sebagai kode riset, bukan produk resmi. Tidak masalah menjadikan desainnya sebagai referensi, tetapi tidak disarankan untuk langsung menerapkannya di lingkungan produksi.
Pertanyaan yang Sering Diajukan (FAQ)
Q1: Apa yang dimaksud dengan “inversi pemilihan model” dalam sistem multiagen?
Artinya, router menggunakan model yang ringan dan murah, sedangkan worker menggunakan model terkuat. Router hanya menangani percakapan, pembagian tugas, dan pelacakan, tanpa menulis kode. Worker bertanggung jawab atas pengodean, jadi anggaran untuk model yang kuat sebaiknya dialokasikan ke worker, bukan ke posisi “komandan utama”.
Q2: Apa perbedaan arsitektur router-worker dengan pola “agen utama menguraikan tugas”?
Dalam pola agen utama, agen utama harus menguraikan tugas menjadi beberapa langkah, sehingga membutuhkan kemampuan penalaran yang lebih tinggi. Router DeepSeek tidak melakukan penguraian; tugasnya hanya membagikan dan melacak tugas, sehingga bisa menggunakan model yang lebih ringan. Konsekuensinya, worker harus mampu menyelesaikan seluruh tugas secara mandiri.
Q3: Kapan desain ini dipublikasikan? Apakah DSH Super Agent bisa langsung digunakan?
Laporan terkait diterbitkan pada 3 November 2026. DSH Super Agent adalah prototipe riset yang dirilis di GitHub bersamaan dengan artikel desainnya. Pihak resmi menegaskan bahwa ini bukan produk yang didukung dan hanya cocok digunakan untuk memahami arsitekturnya.
Q4: Apakah cukup menggunakan petunjuk agar satu agen belajar mendelegasikan tugas?
Pengujian DeepSeek menunjukkan bahwa cara ini tidak andal: dengan petunjuk netral, tidak ada delegasi dalam 5 kali percobaan. Bahkan dengan petunjuk yang menekankan delegasi, ada 1 percobaan tanpa delegasi. Delegasi yang andal memerlukan isolasi struktural, misalnya memisahkan sesi dan menghapus alat eksekusi, bukan menulis petunjuk yang lebih panjang.
Q5: Bagaimana cara praktis mengonfigurasi model dari vendor berbeda untuk router dan worker dalam satu sistem?
Kuncinya adalah menjadikan nama model sebagai parameter konfigurasi berdasarkan peran dan menggunakan satu cara integrasi:
1. Daftar di APIYI apiyi.com dan dapatkan kunci API
2. Atur parameter `model` secara terpisah untuk router dan worker dalam konfigurasi sistem
3. Pertahankan format permintaan dan cukup ganti nama model untuk melakukan eksperimen perbandingan
Dengan begitu, Anda tidak perlu mengelola konfigurasi SDK terpisah untuk setiap vendor. Model yang tersedia mengikuti daftar terkini di platform.
Q6: Apakah data biaya dalam artikel asli bisa langsung digunakan untuk membuat anggaran?
Sebaiknya jangan langsung digunakan. Tahap pengodean disimulasikan, sehingga datanya hanya bersifat indikatif. Pernyataan perbandingan harga dengan model kelas Sonnet juga tidak konsisten. Cara yang lebih baik adalah menguji volume pembacaan cache dengan kumpulan tugas Anda sendiri, lalu mengalikannya dengan harga satuan terkini. Di APIYI apiyi.com, jalankan tugas yang sama untuk setiap model yang ingin dibandingkan agar mendapatkan data yang sesuai dengan kebutuhan Anda.
Q7: Apa saja keterbatasan arsitektur ini yang sudah diketahui?
Ada tiga keterbatasan utama: penurunan kualitas memori setelah berjalan lama; risiko injeksi petunjuk saat membaca peristiwa eksternal; serta volume Token pembacaan cache yang sangat besar, sehingga biaya meningkat signifikan jika menggunakan model mahal. Selain itu, belum tersedia data hasil untuk model tertentu yang digunakan sebagai router, jadi Anda perlu mengujinya sendiri.
Poin Penting Pembagian Model Multi-Agen
- Pemilihan model dibalik: router memakai model ringan dan murah, sementara worker memakai model kuat untuk menulis kode.
- Hambatannya adalah perhatian: manusia biasanya hanya bisa memantau 3 hingga 5 sesi; router membantu memusatkan komunikasi.
- Delegasi bergantung pada struktur: menghapus alat eksekusi dari router jauh lebih andal daripada mengubah petunjuk.
- Cache menjadi komponen biaya terbesar: dalam satu putaran pengujian, pembacaan cache mencapai 23,2 juta token. Tarif per token menjadi faktor terpenting.
- Optimasi arsitektur juga menghemat biaya: mekanisme pass-through mengurangi pembacaan cache sekitar 27%.
- Gunakan data dengan hati-hati: pengodean dilakukan melalui simulasi, sehingga hasilnya hanya sebagai indikasi dan perbandingan harga masih perlu diverifikasi.
- Gunakan antarmuka terpadu untuk eksperimen: di APIYI apiyi.com, cukup ubah parameter
modeluntuk membandingkan berbagai skema pembagian model.
Kesimpulan
Inti pembagian model multi-agen ini adalah memakai model murah untuk router dan model kuat untuk worker:
- Pilih berdasarkan peran: gunakan model cepat dan murah untuk peran yang hanya membagi serta memantau tugas, dan model kuat untuk peran pengodean.
- Hitung biaya cache: token pembacaan cache merupakan pengeluaran utama dalam arsitektur ini, jadi prioritaskan perbandingan tarif pembacaan cache saat memilih model.
- Tentukan berdasarkan pengujian: data dalam artikel asli hanya menjadi acuan awal. Pada akhirnya, uji biaya dan hasilnya menggunakan kumpulan tugas Anda sendiri.
Mulailah dengan membuat prototipe router-worker menggunakan kumpulan tugas kecil. Jadikan nama model sebagai parameter yang dapat dikonfigurasi berdasarkan peran, lalu ganti model router secara bertahap untuk mengamati perubahan akurasi pembagian tugas dan biaya. Untuk perbandingan ini, Anda bisa menggunakan APIYI apiyi.com agar dapat mengakses model dari berbagai penyedia dengan satu kunci API, sehingga keputusan pemilihan model didasarkan pada data Anda sendiri.
📚 Referensi
- DeepSeek’s Super Agent Harness: Fixing the Attention Bottleneck in AI Coding: Penjelasan desain super agent DeepSeek
- Tautan:
mindstudio.ai/blog/deepseek-super-agent-harness-design -
Keterangan: Membahas arsitektur router-worker, eksperimen delegasi, data token cache, dan masalah yang belum terpecahkan
-
Claude Code Pass Pricing: What’s in the $9.99/Month Plan: Penjelasan paket bulanan dengan batas penggunaan tinggi
- Tautan:
mindstudio.ai/blog/claude-code-pass-pricing - Keterangan: Membahas pertimbangan antara tarif berdasarkan penggunaan dan paket bulanan untuk alur kerja multiagen yang intensif token
Penulis: Tim Teknis APIYI
Diskusi teknis: Hubungi kami melalui halaman utama APIYI di apiyi.com untuk berdiskusi tentang pembagian model dalam sistem multiagen. Kunjungi pusat dokumentasi di docs.apiyi.com untuk panduan integrasi lainnya.