Google は 2026-11-10 に Gemini 4 Carbon を有料開発者と企業向けに公開しました。モデル ID は gemini-4-carbon です。Gemini 4 Argon をベースにしたテキストモデルで、入力にはテキスト、画像、音声、動画を使えます。Google は同日、公式ブログと公式アカウントで、これを 現時点で最も強力な Gemini モデルであり、長期タスクとマルチステップ推論のために作られたと紹介しました。Gemini API の changelog でも、同日付で一般提供(GA)として記録されています。
この記事は「圧勝」を謳うリリース情報の焼き直しではありません。情報を3つの層に分けて整理します。公式が自ら発表している内容、2026年10月時点のモデルカードにある結果表、そして現時点でまだわかっていない部分です。モデルカード上で負けている項目も、勝っている項目も、すべて書きます。
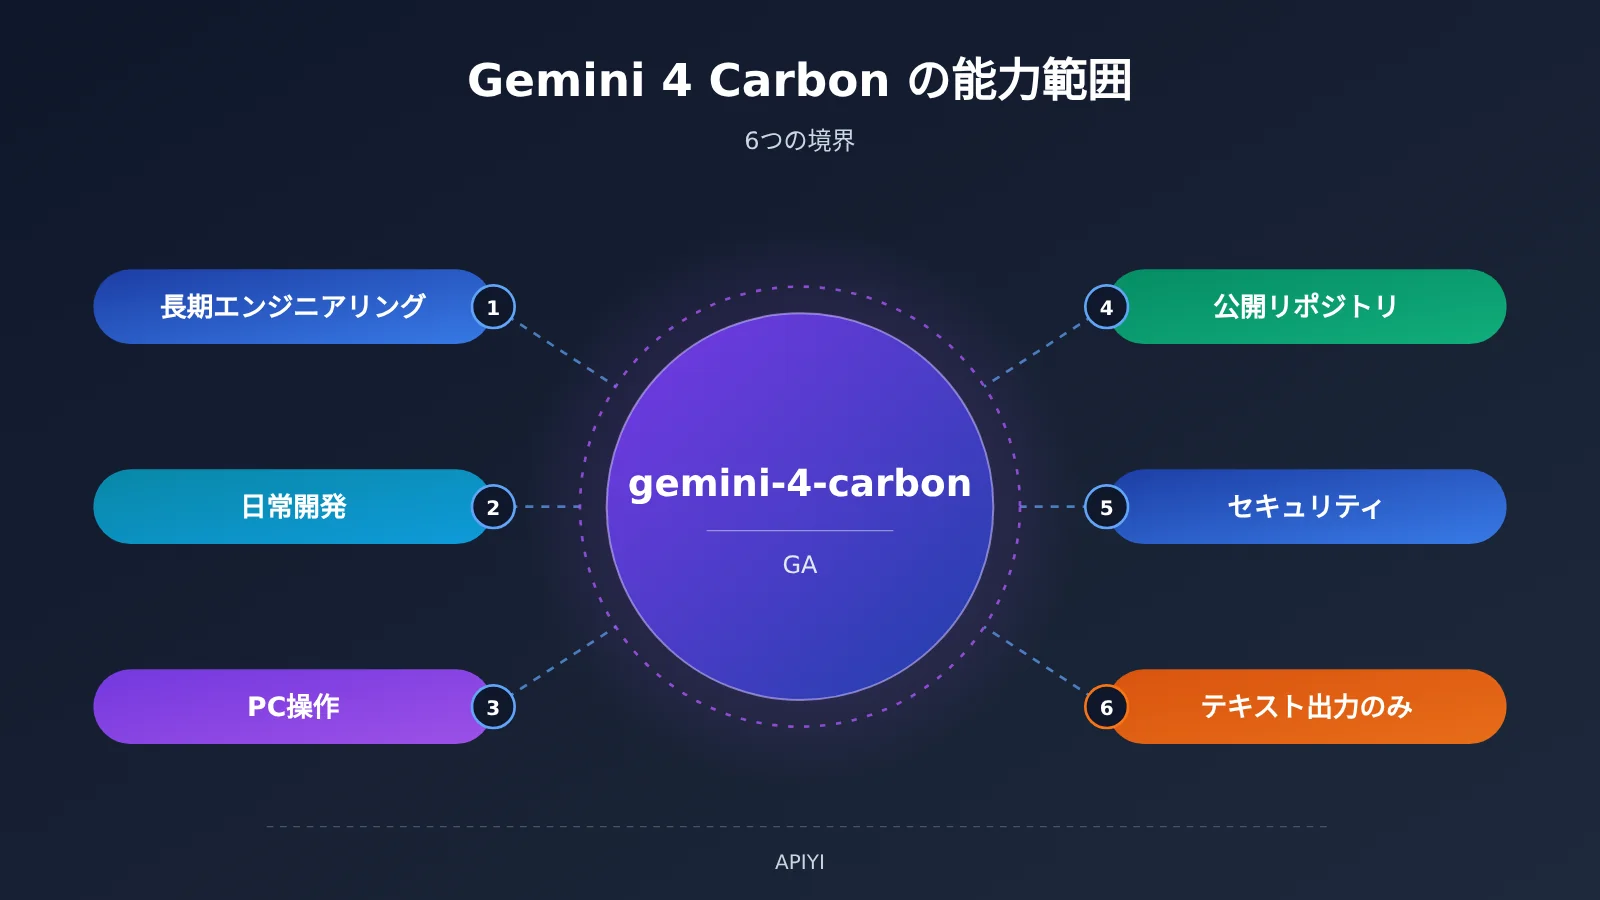
この記事で得られること:Gemini 4 Carbon の能力の境界線を6つ把握できます。どんな仕事を任せる価値があり、どんな仕事は Argon や他のモデルに任せたほうがよいのかが見えてきます。
Gemini 4 Carbon 核心情報まとめ
Gemini 4 Carbon が初めて姿を見せたのは、今回ではありません。2026-10-28 に Google が「Introducing Gemini 4 Carbon」を発表した時点では、一部のサイバーセキュリティ防御担当者だけが利用でき、Fairwind Program を通じて段階的に開放されていました。その後、11月10日にようやくすべての有料開発者向けに公開されました。
| 項目 | 詳細 | 情報源の階層 |
|---|---|---|
| 初回発表 | 2026-10-28。一部のサイバーセキュリティ防御担当者向けに先行提供し、Fairwind Program で段階的に開放 | 公式発表 |
| 一般公開 | 2026-11-10。有料開発者、企業、科学者、Google AI Ultra 加入者が対象 | 公式ブログ |
| API の状況 | gemini-4-carbon は 2026-11-10 に GA。同じページに gemini-4-argon が 2026-11-05 に GA と記載 |
Gemini API changelog |
| 開発者向けの入口 | Google AI Studio と Android Studio 内の Gemini API、Gemini for business | Google 公式投稿 |
| 加入者向けの入口 | Gemini アプリ、Search の AI Mode、Antigravity、Google AI Studio(Ultra 加入者) | Google 公式投稿 |
| 無料プランと下位プラン | 公式からは今回、開放日が示されていません。The Verge は、いつ開放されるのか、そもそも開放されるのかは不明と報じています | 不明 |
Google 公式投稿の公開時刻は 2026-11-10 16:05 UTC で、北京時間では 11月11日 00:05 にあたります。そのため、多くの開発者が情報を目にしたのは11日の朝でした。また、もともと Argon 向けだった科学者向けプログラム(1万名の枠と、Antigravity の6か月間利用)が Carbon にも拡大されました。申請は引き続き受け付けており、審査は週単位で順次行われます。ただし、資格、受け入れ容量、選考に関する制限があります。
Gemini 4 Carbon のデータを読む際の3つの区分
Gemini 4 Carbon に関する数字は多いものの、情報源も算出の基準もそれぞれ異なります。以下で示すデータには、すべてどの区分に属するかを明記します。基準の違うスコアを同じ表で比べてしまうことを避けるためです。
| 区分 | 含まれる内容 | 使い方 |
|---|---|---|
| 公式の自己申告 | 10月28日の発表と11月10日の公開発表に載っているランキング、社内ベンチマーク、安全性に関する数字 | 参考にはなりますが、基準は Google が決めており、外部で再現できるとは限りません |
| モデルカードの結果表 | 2026年10月時点での Carbon と Argon、GPT-6 Astra、Claude Opus 5.5、Claude Fable 5.1 との比較 | 同じ表の中では基準が揃っているため、本記事の横並びの比較はこの表のみを使います |
| 不明 | 無料プランの開放時期、独立した第三者による長期的な評価、第三者ページに掲載された最新の指数 | 結論は出さず、現状を説明するにとどめます |
たとえば Artificial Analysis のページを 2026-11-11 に取得したところ、サマリー部分には Intelligence Index が 60 と表示されていました。ところが同じページのグラフ部分には「No publicly available API」という表記が多数あり、11月10日に API が公開されたという事実と食い違っています。そのため本記事では 60 という数字は採用せず、モデルカードが引用している AA Index v5.0 のスコア 59(基準は2026年10月)に統一しています。
Gemini 4 Carbon はどんなモデルか
Google の説明によると、ソフトウェアエンジニアリングやナレッジワークの大半は、引き続き Argon で十分対応できます。Carbon が担当するのは、本当に知能の限界にぶつかるタスクです。たとえば、複数ステップにわたる複雑なコーディングやデバッグ、オープンエンドな科学研究などが挙げられます。Argon よりも多くの thinking tokens を使い、仮説をより丁寧に探索し、検証ループもより長く回します。
| 仕様項目 | Gemini 4 Carbon | 説明 |
|---|---|---|
| ベースモデル | Gemini 4 Argon ベース | Argon からの移行はモデル名の置き換えだけで済みます |
| 入力モダリティ | テキスト、画像、音声、動画 | マルチモーダル理解に対応 |
| 出力モダリティ | テキストのみ | 画像や動画は生成できません |
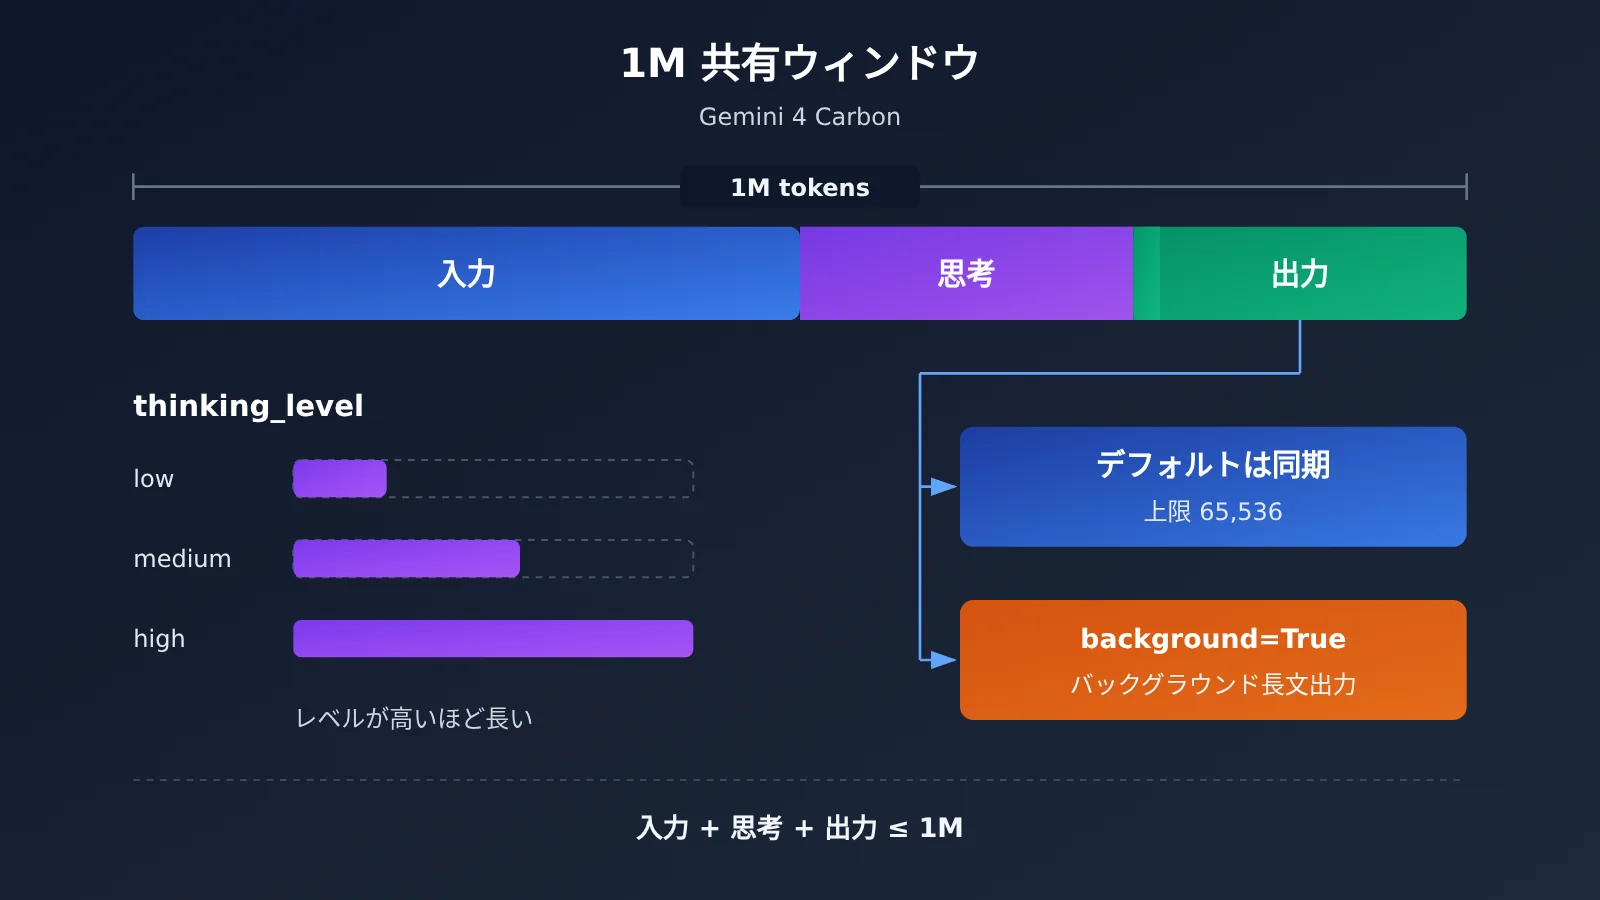
| コンテキストウィンドウ | 1M トークン(入力・思考・出力で共有) | 従来のモデルでは「思考+回答」の上限が 64K でした |
| 同期出力のデフォルト上限 | 65,536 tokens | これより長い出力が必要な場合は、Interactions API で background=True を設定します |
| 知識のカットオフ | 2026 年 3 月(モデルカードより) | 分野によっては、これより前になる場合があります |
Gemini 4 Carbon の thinking_level は 3 段階
thinking_level は 3 段階のみで、デフォルトは medium です。開発者ガイドでは、次のような使い分けが示されています。
low:分類、ルーティング、ピンポイントの情報抽出といった軽いタスク向けです。medium:デフォルトの設定で、速度・コスト・一発での正確さのバランスを取ります。high:複数ファイルにまたがる根本原因の特定、セキュリティパッチ、形式数学、初期段階のアーキテクチャ設計に向いています。
65,536 tokens を超える出力が必要な場合は、Interactions API で background=True を設定し、あわせて max_output_tokens を 65536 より大きい値に引き上げます。さらに、思考過程の分も余裕を持たせておかないと、回答が途中で切れてしまう可能性があります。
Argon から Gemini 4 Carbon への移行時の注意点
gemini-4-argon から gemini-4-carbon へ切り替えるときは、モデル名を変えるだけで済みます。thinking_level も 1M ウィンドウもそのままです。開発者ガイドには、移行時に引っかかりやすいポイントがいくつか挙げられています。
- thinking_budget は非推奨になりました。指定すると警告が出ます。
- temperature、top_p、top_k をカスタム指定しても無視され、警告が出ます。
- 明示的な cached_content を作成したり渡したりするのはやめましょう。暗黙的キャッシュがデフォルトで有効になっていて、キャッシュされた入力には 95% の割引が適用されます。
- 難しいプロンプトでは処理に数分かかることがあります。クライアントのタイムアウトは少なくとも 15〜20 分に設定するか、
background=Trueを使うのがおすすめです。
APIYI で Gemini 4 Carbon を呼び出す
2026-11-11 時点で、APIYI の料金インターフェースに gemini-4-carbon が追加されています。gemini-4-argon と同じく default と svip の 2 つのグループで利用でき、エンドポイントは Gemini ネイティブと OpenAI 互換チャットの両方です。呼び出しのポイントは次のとおりです。
- モデル ID:
gemini-4-carbon - OpenAI 互換の base_url:
https://api.apiyi.com/v1(リクエストパスは/v1/chat/completions) - Gemini ネイティブのエンドポイント:
/v1beta - グループ:
default、svip(倍率はどちらも 1)
APIYI の現在の表示価格は、入力 2 ドル、出力 10 ドル、キャッシュ読み取り 0.10 ドル / 1M tokens(2026-11-11 時点)で、Argon と同じです。ここで注意したいのは、Google 公式サイトの 2 / 10 ドルは 2026-11-30 までのプロモーション価格だという点です。12 月 1 日からは、世界共通の標準価格が入力 4 ドル、出力 20 ドルになります。また、APIYI ドキュメントの一覧表のスナップショットは 2026-11-10 15:40(UTC+8)のもので、一般公開より前の時点です。この行がまだ表示されていない場合は、コンソールと料金インターフェース api.apiyi.com/api/pricing の情報を優先してください。モデルの種類と価格は、プラットフォームのモデル一覧が最新です。
🚀 クイックスタートのヒント:すでに OpenAI SDK を使っているプロジェクトなら、base_url を
https://api.apiyi.com/v1に向けて、モデル名をgemini-4-carbonに変えるだけです。同じキーのまま Argon と並べて比較テストできます。対応モデルの一覧は apiyi.com のモデル一覧でご確認ください。
Gemini 4 Carbon モデルカードの成績(2026年10月時点)
下表はモデルカードの結果表からの抜粋です。結果は2026年10月時点のもので、公式が公開している比較データであり、APIYIによる検証結果ではありません。サイバーセキュリティの3項目は Fairwind Program 経由での成績なので、別途明記しています。Terminal-Bench 4.0 の Argon の欄は、モデルカード上で表示が崩れており、妥当なパーセンテージになっていないため、本記事では引用しません。
| ベンチマーク | Carbon | Argon | GPT-6 Astra | Opus 5.5 | Fable 5.1 |
|---|---|---|---|---|---|
| AA Index v5.0 | 59 | 50 | 57 | 58 | 49 |
| Vals Index v2.2 | 70.4% | 69.2% | 65.0% | 70.2% | — |
| SWE-sweep | 9.6% | 4.3% | 9.5% | 3.6% | 2.9% |
| FrontierSWE 2 | 61.2% | 55.0% | 65.5% | 62.3% | 56.3% |
| Terminal-Bench 4.0 (AA) | 65.2% | 引用しない | 59.1% | 59.6% | 52.0% |
| Agents’ Last Exam v1.1 | 77.4% | 69.0% | 73.1% | 71.6% | — |
| OSWorld-2.1 オフラインサブセット | 81.5% | 74.7% | 80.9% | 87.2% | 76.8% |
| AutomationBench(Zapier) | 53.9% | 51.3% | 41.4% | 42.5% | 31.4% |
| GraphWalks 256k–1M BFS (F1) | 96.2% | 84.2% | 71.8% | 66.8% | 65.0% |
| RiemannBench | 80.0% | 76.0% | 72.0% | 69.6% | 65.6% |
| Terminal-Bench-Science 0.1 | 64.8% | 52.9% | 63.3% | 59.0% | 43.3% |
| CWE-bench(Fairwind) | 71.0% | 68.0% | 68.0% | 67.0% | 58.0% |
| ExploitGym(Fairwind) | 54.8% | 42.0% | 42.4% | 34.5% | — |
| SEC-bench Pro(Fairwind) | 88.2% | 83.4% | 85.4% | — | — |
表からは、はっきりしたパターンが見えてきます。Carbon が最も大きく差をつけているのは、長いコンテキストの検索(GraphWalks)、科学的推論(RiemannBench、Terminal-Bench-Science)、長期的なエージェントタスク(Agents’ Last Exam、Terminal-Bench 4.0)といった分野です。一方、コンピュータ操作と、公開リポジトリを対象にしたソフトウェアエンジニアリングの2項目では、トップではありません。
また、差がごくわずかな項目もいくつかあります。Vals Index では Carbon 70.4% に対して Opus 5.5 が 70.2%、SWE-sweep では Carbon 9.6% に対して Astra が 9.5% です。これらはほぼ同点と見るべきで、明確なリードと読み取るのは避けたほうがよいでしょう。
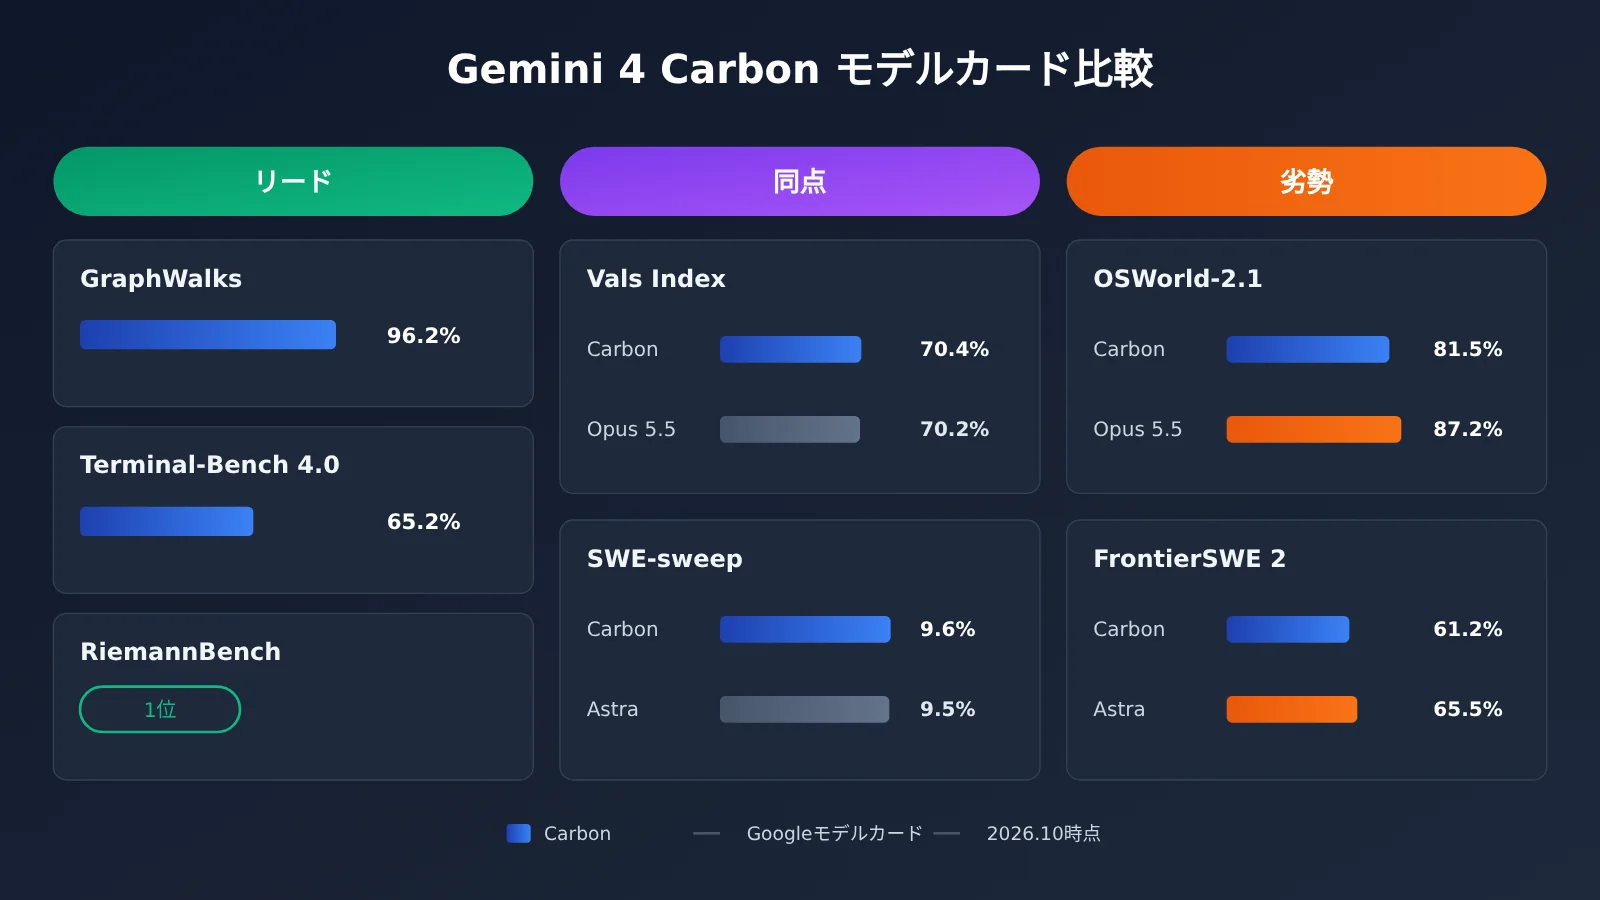
📊 図表の説明:上記のデータは Google のモデルカードによるもので、2026年10月時点のものです。ご自身の業務タスクで差を確かめたい場合は、APIYI(apiyi.com)で同じキーを使い、
gemini-4-carbonとgemini-4-argonをそれぞれ呼び出して比較してみてください。
Gemini 4 Carbon の6つの能力境界
まず表で6つの境界をまとめ、そのあとで1つずつ詳しく見ていきます。
| No. | 能力境界 | 一言でいうと | 根拠レベル |
|---|---|---|---|
| 1 | 長期・多段階のエンジニアリング | より強力だが、思考トークンの消費が多い | モデルカード+公式の自己申告 |
| 2 | 日常的な機能開発 | 公式は引き続き Argon を推奨 | 公式見解 |
| 3 | コンピューター操作 | Opus 5.5 の 87.2% が Carbon の 81.5% を上回る | モデルカード |
| 4 | 公開リポジトリのエンジニアリング | FrontierSWE 2 では Astra の 65.5% が Carbon の 61.2% を上回る | モデルカード |
| 5 | セキュリティ | 高スコアは Fairwind 経由の結果で、モデル名を変えるだけでは再現できない | モデルカード+発表記事 |
| 6 | 出力形式と利用範囲 | 出力はテキストのみ。無料枠の開放日は未定 | 公式ドキュメント+不明 |
境界1:Gemini 4 Carbon は長期・多段階のエンジニアリングに強いが、思考トークンを多く消費する
モデルカードを見ると、Carbon は Terminal-Bench 4.0(65.2%)、Agents’ Last Exam(77.4%)、GraphWalks のロングコンテキスト検索(96.2%)のいずれも表内でトップです。Vending-Bench 2 のシミュレーション経営でも残高が最も高く、16484ドルでした。これらのタスクに共通するのは、ステップが長く、何度も検証が必要になる点です。Google が言う「検証ループを長く回し続ける」という特徴とぴったり重なります。
その代償も、公式の説明にきちんと書かれています。Carbon は Argon よりも多くの thinking tokens を使います。モデルカードも、既知の制限として「思考レベルを上げるとトークン消費が増える」ことを挙げています。基本の単価は両者で同じですが、1タスクあたりの合計料金は高くなる可能性があります。複雑なプロンプトでは、応答まで数分かかることもあります。
境界その2:日常的な機能開発では、公式も Gemini 4 Argon を推奨
Google の説明はとても明快です。ソフトウェアエンジニアリングやナレッジワークの大半は、引き続き Argon を使うのがおすすめとのこと。トークン消費が少なく、やり取りも速いためです。Carbon を使うのは、最も難しいマルチステップのエンジニアリング、アーキテクチャ設計と監査、形式数学や科学的発見、高精度が求められる金融・法務の統合分析、脆弱性リサーチに限られます。
モデルカードの数値も、この使い分けを裏付けています。Vals Index では Carbon が 70.4%、Argon が 69.2% で、差はわずかです。Antigravity プレビューの /swarm も同じ考え方に沿っています。公式は、アーキテクチャ設計、全体の調整、監査といった最も深い推論が必要な役割に Carbon を割り当て、並列で実装を進める各パートは gemini-4-argon や gemini-3.8-flash に任せることを推奨しています。
境界その3:コンピューター操作タスクでは、モデルカード上 Opus 5.5 が上
OSWorld-2.1 オフラインサブセットは、モデルカードの中でデスクトップやコンピューター操作の能力を測るベンチマークです。この項目では Claude Opus 5.5 が 87.2% で、Carbon の 81.5%、Astra の 80.9% を上回っています。デスクトップアプリの操作、画面上のクリック、複数ソフトをまたぐ作業の実行が主な用途なら、この項目で Carbon は1位ではありません。
また、Carbon は Gemini ネイティブ、または OpenAI 互換のチャットインターフェースで利用する形で、Anthropic の messages プロトコルには対応していません。Claude Code や messages プロトコルに深く依存したワークフローを使っている場合は、移行コストもあわせて検討してください。
境界4:公開リポジトリのFrontierSWE 2ではGPT-6 Astraが上
FrontierSWE 2では、GPT-6 Astraが65.5%で表中の最高スコアです。2位はOpus 5.5の62.3%、3位がCarbonの61.2%でした。そのため、「Carbonはソフトウェアエンジニアリングで全面的にAstraをリードしている」という主張は成り立ちません。
ここで区別しておきたいのは、11月10日の公開ドラフトに「CarbonがCursorBench 4.0で1位」という記述がある点です。これは公式の自己申告で、評価主体も評価の基準もモデルカードとは異なります。そのため、上の表と並べて比較するべきではありません。SWE-sweepではCarbonが9.6%、Astraが9.5%とほぼ互角で、差は誤差の範囲内です。
境界5:サイバーセキュリティの高スコアはFairwind経路によるもの
CWE-bench、ExploitGym、SEC-bench Proの3項目では、Carbonはモデルカード上ですべて1位です。ただしモデルカードには、これがFairwind Programの経路での成績であると明記されています。10月28日のリリース文にも、これらのサイバーセキュリティベンチマークはガードレールなしで評価された(evaluated without guardrails)と書かれています。
つまり、有料APIのモデル名を gemini-4-carbon に切り替えただけでは、同等のサイバーセキュリティ専用の能力が手に入るわけではありません。防御向けの専用機能を使うにはFairwindへの申請が必要で、審査を通過した防御側の組織だけが利用できます。公式サイトの価格表に別枠で載っているGemini 4 Carbon Cyber Permissiveも、2ドルのキャンペーン価格の対象外です。
安全性の面では、公式の自己申告による数値も参考になります。375項目のagentic honesty(エージェントの誠実性)テストの合格率は92%でした(Argonは70%)。また、実験データがない場面では98%の確率で捏造を拒否します。Gray SwanのIPI(間接プロンプトインジェクション)攻撃の成功率は0%と報告されています。ただしGoogle自身も、より難度の高い自動レッドチームテストでは、一部の分布でモデルが制限を越えてしまう場合があると認めています。プロンプトインジェクションへの堅牢性は、今後も強化が必要です。
境界その6:出力はテキストのみ、無料枠の開放日は未定
Carbon はテキスト、画像、音声、動画を理解できますが、出力はテキストだけです。画像生成モデルでも動画生成モデルでもないため、画像や動画の生成が必要なワークフローでは、別のモデルを選ぶ必要があります。
利用範囲については、一般ユーザー向けの入口と Antigravity は現時点では Google AI Ultra が対象で、API は有料枠での提供です。無料ユーザーや下位プランのユーザーがいつ使えるようになるのかについて、公式は今回、日付を示していません。モデルカードには、そのほかの制限として、基盤モデルによく見られるハルシネーション、ジェイルブレイク耐性は引き続き強化中であること、ときどき遅くなったりタイムアウトしたりすることも挙げられています。
Gemini 4 Carbon の影響分析
Gemini 4 Carbon が開発者に与える影響
- モデルの役割分担がより明確に:日常的な主力は Argon、Carbon は最も難しい場面だけに投入します。ルーティングや /swarm 方式のオーケストレーションを使えば、トークン消費を抑えられます。
- 移行コストが低い:モデル名を差し替えるだけで済みますが、thinking_budget や temperature などのパラメータは整理し、明示的な cached_content も外す必要があります。
- タイムアウト設定の見直しが必要:クライアント側で 15〜20 分のタイムアウトを設定するか、background=True を使うことになるため、既存のゲートウェイやリトライのロジックにも影響します。
- 価格には期間限定の枠がある:公式サイトの 2 / 10 というキャンペーン価格は 11 月 30 日までです。長期的なコストを見積もるときは、12 月以降の通常価格で計算してください。
💡 選び方のヒント:同じ「難しいタスク」でも、長いコンテキストの検索や科学的な推論は Carbon、コンピュータ操作は Opus 5.5、公開リポジトリのエンジニアリングは Astra が向いています。まず APIYI(apiyi.com)で同じ業務サンプルを使って各モデルを比較し、そのうえでルーティングルールを決めることをおすすめします。
Gemini 4 Carbon が業界に与える影響
- 「最強モデル」の定義がより細かくなる:モデルカードを見ても、すべての項目で1位のモデルはありません。タスクの種類ごとにモデルを使い分けることが当たり前になっていきそうです。
- セキュリティ機能が段階的に開放される:サイバーセキュリティ分野の機能は Fairwind を通じて限定的に開放され、ガードレールなしの評価スコアも別枠で示されています。こうしたやり方は、今後ほかのベンダーにも広がるかもしれません。
- 思考トークンが主なコスト変動要因に:単価が同じでも、思考の深さによって請求額は変わります。そのため、チームは thinking_level の細かな調整をより重視するようになるでしょう。
よくある質問 FAQ
Q1:Gemini 4 Carbon とは何ですか?
Gemini 4 Carbon は、Google が Gemini 4 Argon をベースに開発したテキスト出力モデルです。モデル ID は `gemini-4-carbon` で、2026-11-10 から有料の開発者と企業向けに公開されました。テキスト、画像、音声、動画の入力に対応しており、1M トークンのウィンドウは、入力・思考・出力で共有されます。
Q2:Gemini 4 Carbon と Gemini 4 Argon はどう使い分ければいいですか?
thinking_level、1M のウィンドウ、エントリー価格は、どちらも同じです。公式では、トークンの消費が少なくやり取りも速い Argon を日常の開発に使うよう勧めています。Carbon は、複数ステップにわたるエンジニアリング、アーキテクチャ監査、科学的推論といった最も難しいタスク向けです。ただし、その分だけ思考トークンの消費は多くなります。
Q3:Gemini 4 Carbon のモデルカードのスコアは、そのまま API での性能と考えてよいですか?
多くの項目は参考になりますが、注意点が2つあります。1つ目は、結果が 2026 年 10 月時点のものであることです。2つ目は、サイバーセキュリティの3項目が Fairwind 経由・ガードレールなしでの評価結果であることです。有料 API で日常的にコーディングする場合のデフォルトのスコアとして扱うことはできません。また、公開記事にある CursorBench などのランキングは公式の自己申告で、モデルカードとは基準が異なります。
Q4:API 経由で Gemini 4 Carbon をすぐに呼び出すにはどうすればいいですか?
次の3ステップで進められます。
1. APIYI(apiyi.com)でアカウントを登録し、APIキーを取得します。新規ユーザーには無料のテスト枠があります。
2. OpenAI SDK の base_url を `https://api.apiyi.com/v1` に設定し、モデル名に `gemini-4-carbon` を指定します。
3. タスクの難易度に合わせて thinking_level を設定します。難しいタスクでは、クライアント側のタイムアウトを長めにするのを忘れないでください。
同じキーで `gemini-4-argon` も呼び出せるので、そのまま比較もできます。
Q5:Gemini 4 Carbon には、どのような既知の制限がありますか?
モデルカードには、次の制限が挙げられています。ハルシネーションが依然として発生すること、脱獄への耐性を引き続き強化している段階であること、ときどき遅くなったりタイムアウトしたりすること、思考レベルを高くするとトークン消費が増えること。そのほか、出力はテキストのみで、無料枠がいつ公開されるかは不明です。また、コンピューター操作と FrontierSWE 2 の2項目は、モデルカード上でも1位ではありません。
Gemini 4 Carbon の要点 Key Takeaways
- 位置づけ:Argon をベースにした、Gemini 史上最強のテキストモデルです。2026年11月10日に GA となりました。
- 強み:長時間にわたるエージェント作業、長いコンテキストの検索、科学的推論で、モデルカード上の成績がトップクラスです。
- コスト面:入門時の単価は Argon と同じですが、思考トークンが増えるため、1タスクあたりの費用は高くなります。
- 弱み:OSWorld では Opus 5.5 に、FrontierSWE 2 では Astra に及びません。
- セキュリティスコア:サイバーセキュリティで高得点が出ているのは Fairwind 経由の場合で、デフォルトの API の能力ではありません。
- 対応範囲:出力はテキストのみです。無料枠の提供開始日は未定です。
- 始め方:APIYI に
gemini-4-carbonが追加されました。同じキーを使って Argon と比較できます。
まとめ
Gemini 4 Carbon の得意・不得意は、次の3点に整理できます。
- 任せるべき領域:長時間のマルチステップなエンジニアリング、長いコンテキストの検索、科学的推論、アーキテクチャ設計や監査です。これらの分野では、モデルカード上のスコアが明確にリードしています。
- 無理に任せなくてよい領域:日常的な機能開発は、引き続き Argon で十分です。コンピュータ操作と公開リポジトリでのエンジニアリングの2項目は、モデルカード上でそれぞれ Opus 5.5 と Astra のほうが上です。
- 前提を確認すべき点:サイバーセキュリティのスコアは Fairwind 経由のものです。公開稿のランキングは公式の自己申告にあたります。無料枠については、まだ不明です。
おすすめは、まずタスクの種類ごとに分けて、自分たちのサンプルで Carbon の改善が増えた思考トークン分に見合うかを確かめる方法です。APIYI(apiyi.com)なら、Carbon と Argon を同じインターフェースで並べてテストできます。そのうえでルーティングのルールを決めると安心です。
📚 参考資料
- Gemini 4 Carbon 公開のお知らせ:2026-11-10 Google公式ブログ
- リンク:
blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available -
説明:公開範囲と、公開記事に掲載された公式の自己申告ベンチマーク
-
Introducing Gemini 4 Carbon:2026-10-28 初回発表記事
- リンク:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon -
説明:Fairwindでの先行公開の背景と、サイバーセキュリティ評価の基準
-
Gemini 4 Carbon モデルカード:結果は2026年10月時点
- リンク:
deepmind.google/models/model-cards/gemini-4-carbon -
説明:本記事の比較表のデータソースと既知の制限事項
-
Gemini 4 Carbon デベロッパーガイド:Google AI Studio
- リンク:
aistudio.google.com/learn/gemini-4-carbon-developer-guide -
説明:thinking_level、1Mコンテキストウィンドウ、移行時の注意点
-
Gemini 4 Carbon セーフティレポート:Google DeepMind
- リンク:
storage.googleapis.com/deepmind-media/gemini/gemini_4_carbon_safety_report.pdf -
説明:honesty、レッドチーム、プロンプトインジェクションに関するデータ
-
Google Cloud モデル料金:公式料金表
- リンク:
cloud.google.com/model-garden/pricing -
説明:プロモーション価格と12月以降の標準価格、Cyber Permissiveの料金
-
APIYI Gemini 4 Argon ドキュメント:同シリーズのモデル呼び出しガイド
- リンク:
docs.apiyi.com/models/gemini-4-argon - 説明:ArgonとCarbonはインターフェースが共通のため、移行時の参考になります
著者:APIYI技術チーム
技術交流:APIYI公式サイトのトップページからお気軽にお問い合わせください。モデル呼び出しに関するさらに詳しい資料は、docs.apiyi.com のドキュメントセンターをご覧いただけます