Nota del autor: este artículo explica cómo Flint-interactive usa «eventos semánticos + operaciones de actualización» para reducir el costo y los errores cuando un agente genera gráficos interactivos. También repasa tres formas de integrarlo.
Si desarrollas agentes de IA para análisis de datos o informes, es posible que ya te hayas encontrado con esto: el agente crea rápidamente un gráfico estático, pero en cuanto le pides «filtrar con un clic» o «vincular gráficos mediante una selección por área», necesita varias rondas de ajustes. Un momento falla la distribución, al siguiente deja de funcionar el resaltado; arreglas una cosa y se rompe otra. Al final, los tokens y el tiempo se van en depuración.
Microsoft Research presentó Flint-interactive el 22 de octubre de 2026. Es un lenguaje de visualización interactiva de datos construido sobre Flint. Este artículo no recomienda una nueva biblioteca de gráficos: toma Flint-interactive como caso de estudio para explorar cómo diseñar especificaciones de salida de alto nivel para agentes, de modo que tengan que escribir menos código de renderizado de bajo nivel.
Qué te aporta: al terminar, entenderás los límites de costo y fiabilidad que aparecen cuando un agente genera gráficos interactivos. También conocerás la idea de «dejar la lógica visual al compilador y describir la lógica de interacción con eventos semánticos» y sabrás en qué escenarios conviene integrar la solución en una conversación, en una aplicación o mediante interacciones personalizadas.
Por qué es costoso pedirle a un agente que escriba código de interacción sin Flint-interactive
Pedirle a un agente que escriba directamente el código de un gráfico interactivo parece la opción más flexible. Pero el blog de investigación señala que, incluso con modelos de última generación muy capaces, hay dos obstáculos evidentes al llevarlo a la práctica.
El primero es el alto costo de generación. Es poco frecuente que un agente entregue un gráfico interactivo satisfactorio en una sola ronda. Normalmente necesita varias rondas de razonamiento, programación y depuración, y cada una consume tokens y tiempo. El segundo es la falta de fiabilidad. Las visualizaciones interactivas son complejas por naturaleza: cuanto más expresivos son los gráficos, más fácil es que aparezcan problemas de diseño o que las interacciones fallen. Además, al corregirlos pueden surgir nuevos problemas.
Entonces, ¿es viable usar directamente las interacciones integradas en una biblioteca de gráficos? Según el blog, algunas bibliotecas de visualización no ofrecen suficiente expresividad en sus interacciones integradas, lo que dificulta crear gráficos interactivos personalizados. En el fondo, lo que falta es un lenguaje para describir interacciones que sea «expresivo y, a la vez, de suficiente alto nivel».
| Enfoque | Lo que debe generar el agente | Problema principal | Adecuación |
|---|---|---|---|
| Escribir directamente código de renderizado de bajo nivel | Escucha de eventos, detección de interacciones y lógica de redibujado | Varias rondas de depuración, alto consumo de tokens y riesgo de introducir nuevos errores | Máxima expresividad, poca estabilidad |
| Usar solo las interacciones integradas de la biblioteca | Activar o desactivar algunas opciones de configuración | Tipos de interacción limitados y difíciles de personalizar | Estable, pero con poca expresividad |
| Especificación de Flint-interactive | Mapeo de eventos semánticos a operaciones de actualización | Hay que aprender un nuevo sistema de especificación | Combina expresividad y fiabilidad |
Si necesitas cambiar de modelo con frecuencia para ejecutar este tipo de tareas de generación en varias rondas con tu agente, puedes acceder a varios modelos populares mediante la interfaz unificada de APIYI apiyi.com. Con el mismo código de invocación podrás comparar las rondas y el consumo de distintos modelos, y averiguar cuánto cuesta realmente escribir código de bajo nivel en tu caso.
Puntos clave de Flint-interactive
| Punto clave | Descripción | Ventaja para desarrolladores |
|---|---|---|
| Eventos semánticos | El compilador interpreta acciones como clics, arrastres y pulsaciones de teclas para determinar qué elementos del gráfico y qué datos se seleccionaron | El agente no necesita procesar coordenadas de píxeles ni detectar qué elementos se pulsaron |
| Operaciones de actualización | Operaciones de alto nivel como set-style, set-annotation y set-viewport describen los cambios en la visualización | No hace falta manipular las marcas gráficas específicas del motor de renderizado |
| Máquina de estados de Flint Canvas | Hace seguimiento de las interacciones del usuario en el lienzo y gestiona el estado de renderizado | El framework gestiona el entorno de ejecución y reduce los errores de estado |
| Componibilidad | Tanto la generación de eventos como las actualizaciones visuales se pueden combinar y conectar con tablas, texto y componentes | Permite crear historias con datos y paneles interactivos conectados |
Eventos semánticos: Flint-interactive solo se ocupa de «qué datos seleccionó el usuario»
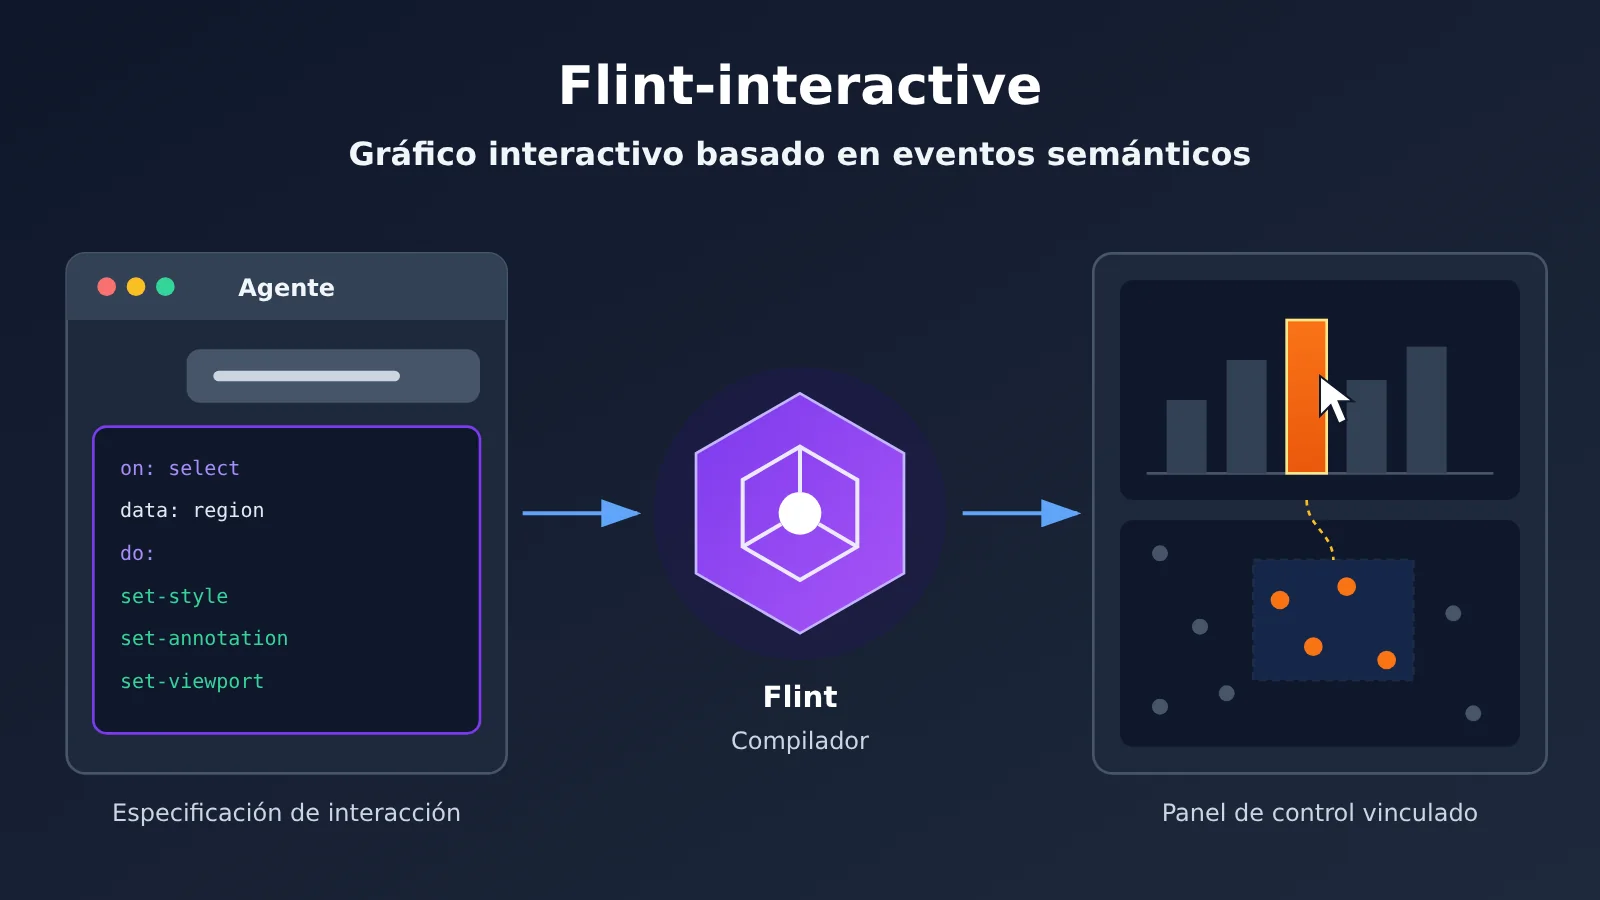
Los eventos semánticos son el concepto central de Flint-interactive. En un enfoque tradicional, el agente debe procesar «el mouse se pulsó en la coordenada (x, y) y se arrastró hasta otro punto» y después calcular qué puntos de datos abarca esa zona. En Flint, el compilador se encarga de ese paso y produce directamente un evento con significado, como «el usuario seleccionó estos grupos de países con un recuadro».
Es parecido a la diferencia entre los «eventos nativos del DOM» y los «eventos de negocio» en el desarrollo frontend. Al implementar la lógica de negocio, no te interesan las coordenadas de mousedown, sino que «el usuario seleccionó el pedido A». Los eventos semánticos aplican esa misma abstracción al ámbito de la visualización, con la garantía de que el compilador la procesa correctamente.
Operaciones de actualización: Flint-interactive sustituye el redibujado imperativo por resultados declarativos
Una vez recibido el evento semántico, la lógica de interacción solo tiene que responder a una pregunta: ¿cómo debería quedar la visualización? Las operaciones de actualización que enumera el blog incluyen usar set style para resaltar datos, set annotation para añadir una etiqueta a un punto y set viewport para desplazar o ampliar la vista.
Es una relación parecida a la que existe entre SQL y escribir bucles a mano. Con SQL describes «qué resultado quieres» y la base de datos decide cómo obtenerlo; con las interacciones de Flint describes «qué datos deben resaltarse» y el compilador se encarga de convertirlo en cambios concretos en el lienzo, incluida la detección de elementos y las actualizaciones visuales de bajo nivel.
Máquina de estados: Flint Canvas gestiona el entorno de ejecución de las interacciones
Flint Canvas es, en esencia, una máquina de estados que sigue continuamente las interacciones del usuario en el lienzo y gestiona el estado de renderizado. Para el agente, esto significa que no tiene que mantener estados intermedios propensos a errores, como «qué está seleccionado ahora» o «si ya se eliminó el resaltado anterior».
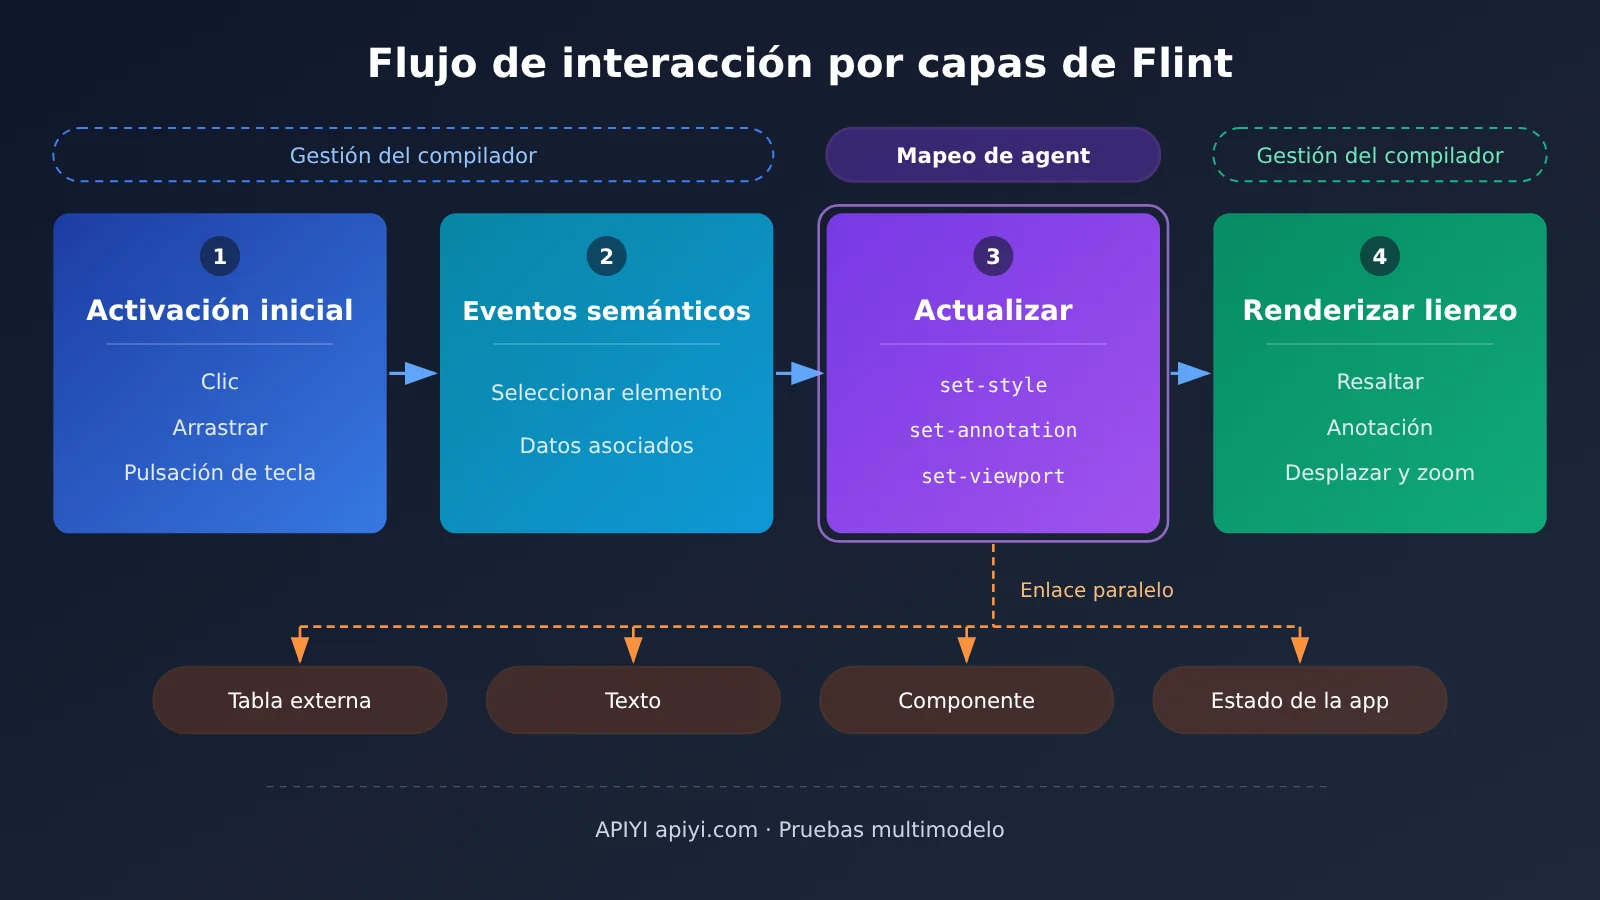
La imagen muestra la división central que plantea el blog: el compilador gestiona la lógica visual y el usuario describe la lógica de interacción en el plano semántico. El agente solo se ocupa de la capa intermedia que asigna «qué actualización corresponde a cada evento»; los dos extremos, más propensos a errores, quedan en manos del framework.
Principios transferibles detrás de Flint-interactive: diseñar especificaciones de salida de alto nivel para agentes
Más allá de Flint-interactive, lo más valioso de este caso es su criterio de ingeniería: no le pidas al agente que genere la capa en la que es más fácil equivocarse. El código de renderizado de bajo nivel tiene dependencias complejas y ciclos de retroalimentación largos, por lo que los intentos repetidos del agente en esa capa resultan costosos.
Visto de otro modo, Flint convierte un problema abierto de programación en uno de «hacer correspondencias con un vocabulario limitado». El espacio de salida del agente se reduce, su estructura se vuelve más uniforme y resulta más fácil validarla. Esta idea también se aplica a la orquestación de flujos de trabajo, la generación de formularios y la composición de informes.
| Criterio | Conviene que lo genere el agente | Conviene dejarlo al compilador o al entorno de ejecución |
|---|---|---|
| ¿Expresa una intención de negocio? | Sí, por ejemplo: «al seleccionar un país, resaltar los del mismo grupo» | No, por ejemplo, convertir coordenadas de píxeles |
| ¿Depende de muchos estados implícitos? | Pocas dependencias; basta una correspondencia | Muchas dependencias; requiere seguimiento continuo |
| ¿Es fácil localizar los errores? | La especificación tiene una estructura clara y es fácil de validar | Los detalles de renderizado están dispersos y son difíciles de revisar |
| ¿Se puede reutilizar? | Se puede guardar como preajuste, por ejemplo, linked-brush | Es infraestructura genérica que se implementa una sola vez |
Al diseñar el formato de salida de tu propio agente, puedes usar esta tabla para revisar cada criterio. Si una capa expresa intenciones, tiene pocas dependencias de estado y es fácil de validar, conviene asignársela al agente. En caso contrario, es mejor delegarla a código determinista o a un compilador.
Cabe aclarar que el blog de investigación no aporta datos cuantitativos sobre una reducción del consumo de tokens o un aumento de la tasa de éxito. En lugar de dar por válidos estos beneficios, conviene comprobarlos con pruebas en tus propias tareas.
Primeros pasos con Flint-interactive: 3 formas de integración
El blog presenta tres opciones, dirigidas a usuarios de gráficos, desarrolladores de aplicaciones y diseñadores de interacción. Las veremos de menor a mayor complejidad.
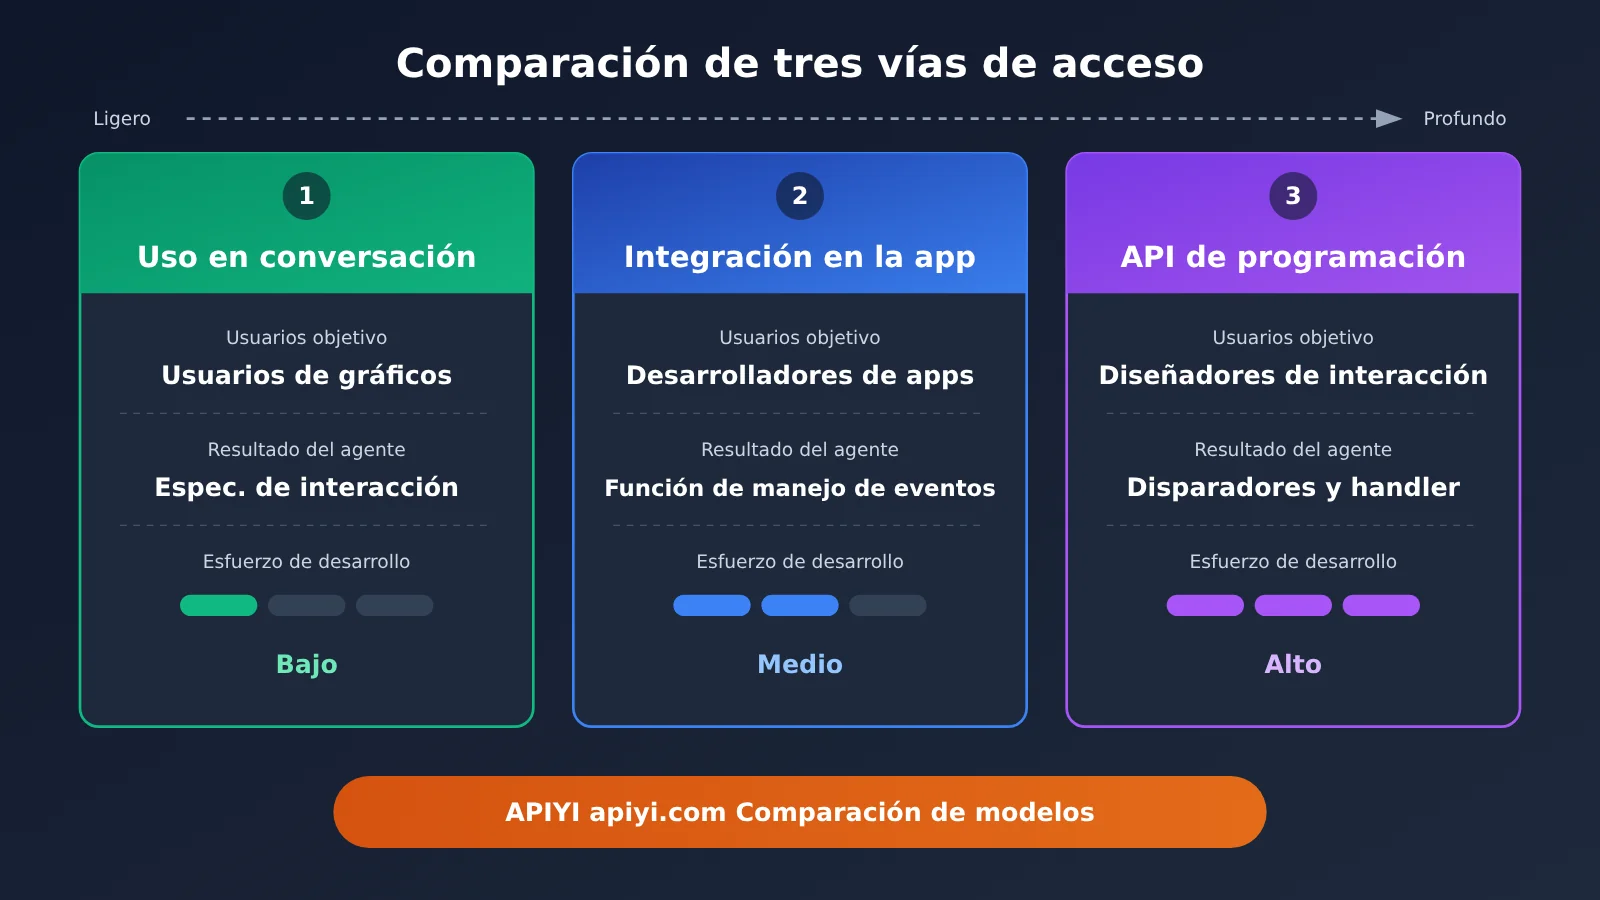
| Opción de integración | Usuario objetivo | Qué genera el agente o la aplicación | Casos de uso habituales |
|---|---|---|---|
| Uso en conversación (Flint-MCP + MCP Apps) | Usuarios de gráficos | Especificación de gráficos Flint + interaction_spec |
Explorar datos en un chat y usar la selección en preguntas posteriores |
| Integración en aplicaciones (Flint Interactive Canvas) | Desarrolladores de aplicaciones | Funciones de gestión de eventos semánticos + operaciones de actualización enviadas a Canvas | Paneles, narrativas de datos y vinculación entre gráficos y tablas |
| Interacciones personalizadas (API de programación) | Diseñadores de interacción | Disparador trigger + función handle personalizada | Interacciones a medida que van más allá de las opciones predefinidas, como DimpVis |
Opción uno: usar Flint-interactive en una conversación (MCP)
Esta es la opción más sencilla. Con Flint-MCP y MCP Apps, puedes usar Flint Interactive directamente en un chat o un entorno de lienzo. Para configurarlo, sigue la guía oficial de configuración de MCP. Una vez integrado, el flujo es aproximadamente así:
- Siguiendo la guía oficial de configuración de MCP, integra Flint-MCP en un chat o entorno de lienzo compatible con MCP Apps;
- Dile al agente qué gráfico quieres crear y qué interacciones necesitas, por ejemplo: «permitir la selección por área y resaltar los países del mismo grupo»;
- Además de la especificación del gráfico Flint, el agente generará un
interaction_specy mostrará un gráfico interactivo en la conversación; - Selecciona elementos en el gráfico: esa selección se puede pasar como contexto a los siguientes turnos de la conversación.
El paso 4 es especialmente útil. Si seleccionas una zona con datos anómalos y preguntas «¿por qué estos puntos tienen valores más altos?», el agente recibe el resultado estructurado de la selección, en lugar de una descripción vaga en texto.
Ruta dos: integrar Flint-interactive Canvas en una aplicación
Si quieres usarlo en tu propio panel o en una historia de datos, puedes optar por Flint Interactive Canvas. El flujo de datos es bidireccional:
- Gráfico → aplicación: Flint Canvas emite eventos semánticos que tu aplicación recibe mediante funciones de gestión de eventos. Puedes usarlos para filtrar una tabla, actualizar otro gráfico o modificar el estado de la aplicación;
- Aplicación → gráfico: cuando un componente de la aplicación necesita controlar un cambio en el gráfico, basta con enviar una operación de actualización a Flint Canvas.
El ejemplo del blog muestra una interacción bidireccional entre un gráfico y una tabla: al hacer clic en una fila de la tabla, se resalta el punto correspondiente en el gráfico, y viceversa. Para los productos de informes, esta es la base de una experiencia en la que gráficos y datos están vinculados. El blog también menciona que puedes compartir la habilidad interaction-author con tu agente de programación para que te ayude a añadir interacciones predefinidas a la aplicación.
Ruta tres: crear interacciones personalizadas en Flint-interactive con la API de programación
Cuando las interacciones predefinidas, como la selección vinculada con linked-brush, no son suficientes, puedes usar la API de programación para definir un disparador, o trigger, y una función handle personalizada que transforme los eventos semánticos en una serie de actualizaciones del gráfico.
El ejemplo del blog consiste en hacer clic en un país para resaltarlo y añadirle una etiqueta con su nombre. Este handler combina las operaciones set-style y set-annotation, sin necesidad de manipular elementos gráficos específicos del motor de renderizado. En un ejemplo más complejo con DimpVis, el usuario puede arrastrar un punto a lo largo de una trayectoria temporal para observar cómo cambian la temperatura y las precipitaciones en todas las ciudades.
🚀 Consejo para empezar: usa primero la ruta uno para comprobar en una conversación si tus datos se prestan a la interacción. Después, decide si vale la pena invertir en la ruta dos o la ruta tres. Puedes acceder de forma unificada a los modelos que impulsan al agente a través de APIYI apiyi.com, alternar entre varios modelos populares con el mismo código y observar cuál genera un
interaction_specválido de forma más consistente.
Evaluar la fiabilidad de las especificaciones de Flint-interactive generadas por agentes
El blog no indica qué modelos o agentes generan mejores especificaciones de Flint, así que conviene establecer un proceso de evaluación sencillo antes de pasar a producción. Estos son algunos indicadores útiles:
| Indicador | Cómo observarlo | Qué indica |
|---|---|---|
| Tasa de éxito en la primera ronda | Medir el porcentaje que se renderiza y permite interactuar correctamente desde el primer intento | Refleja directamente el costo de generación |
| Promedio de rondas de corrección | Registrar las rondas de conversación necesarias desde la generación inicial hasta obtener un resultado utilizable | Refleja el consumo de tokens y tiempo |
| Cumplimiento de la intención de interacción | Comprobar manualmente si el comportamiento interactivo coincide con los requisitos | Una especificación válida no garantiza que responda a la intención |
| Estabilidad ante regresiones | Comprobar si las demás interacciones siguen funcionando después de modificar una | Aborda el problema de fiabilidad mencionado en el blog |
Una buena opción es preparar un conjunto fijo de requisitos de interacción como prueba y usar la misma indicación para comparar dos enfoques: «escribir directamente el código de renderizado» y «generar una especificación de Flint». Con una interfaz que agrupa varios modelos, como APIYI, puedes compararlos en un mismo script sin tener que integrar por separado el SDK de cada proveedor.
Preguntas frecuentes FAQ
Q1: ¿Qué es Flint-interactive?
Flint-interactive es un lenguaje de visualización de datos interactiva creado por Microsoft Research sobre la base de Flint. Un compilador traduce las interacciones del usuario en eventos semánticos y después modifica los gráficos mediante operaciones de actualización de alto nivel. Así, usuarios y agentes pueden describir con especificaciones concisas interacciones como clics, filtros, zoom, resaltado y vinculación entre gráficos.
Q2: ¿En qué se diferencia Flint-interactive de pedirle a un agente que escriba directamente el código de interacción de los gráficos?
Cuando escribe el código directamente, el agente tiene que gestionar los eventos, la detección de elementos seleccionados y el redibujado al mismo tiempo. Esto ofrece mucha expresividad, pero requiere más rondas de depuración y es más propenso a errores. Flint-interactive deja la lógica visual en manos del compilador: el agente solo describe «qué actualización corresponde a cada evento semántico». El resultado es más breve y tiene una estructura más fácil de validar.
Q3: ¿Cuándo se publicó Flint-interactive?
El blog de Microsoft Research publicó esta investigación el 22 de octubre de 2026, por lo que se trata de un resultado reciente. Las fuentes no especifican la licencia de código abierto, el grado de madurez ni si está listo para producción. Antes de usarlo en un proyecto formal, conviene consultar la información más reciente del repositorio oficial.
Q4: ¿Para qué casos de uso es más adecuado Flint-interactive?
– **Análisis de datos conversacional**: seleccionar puntos de datos con un recuadro en el chat y usar el resultado en preguntas posteriores;
– **Informes y paneles**: vincular varios gráficos y hacer clic en ellos para filtrar tablas de detalle;
– **Narrativas basadas en datos**: resaltar de forma bidireccional gráficos y párrafos del texto, como en las narrativas interactivas del periodismo de datos.
Q5: ¿Cómo se prepara la invocación del modelo al crear un agente que use Flint-interactive?
Flint resuelve «qué generar», pero aún hay que integrar el modelo por separado. Una opción práctica es acceder a varios modelos populares a través de APIYI apiyi.com y probar el mismo conjunto de requisitos de interacción mediante una interfaz unificada. Así puedes comparar la tasa de especificaciones utilizables al primer intento y el número de rondas de corrección de cada modelo antes de decidir cuál usar en producción.
Q6: ¿Cómo puede decidir una persona responsable de producto si su equipo debería adoptar Flint-interactive?
Puedes empezar por responder dos preguntas: ¿tus usuarios realmente necesitan explorar los gráficos? ¿El agente genera actualmente tantos gráficos interactivos que hay que rehacer con frecuencia? Si ambas respuestas son afirmativas, vale la pena hacer una prueba a pequeña escala con la primera opción. Durante las pruebas, puedes usar la plataforma APIYI para cambiar rápidamente entre modelos y mantener bajos los costos de validación.
Q7: ¿Qué limitaciones conocidas o aspectos pendientes de confirmar tiene Flint-interactive?
– **Faltan datos cuantitativos**: el blog no publica cifras concretas sobre el ahorro de tokens ni la mejora de la tasa de éxito;
– **Compatibilidad con modelos desconocida**: no se indica qué modelos generan mejor las especificaciones de Flint;
– **Vocabulario de interacciones limitado**: las interacciones que no estén entre las predefinidas deben implementarse con la API de programación. El equipo oficial anima a enviar nuevas opciones predefinidas en GitHub para ampliar el vocabulario.
Puntos clave de Flint-interactive
- Origen del coste: cuando un agente escribe directamente el código de interacción, necesita varias rondas de depuración, consume muchos tokens y puede introducir nuevos bugs durante las correcciones;
- Eventos semánticos: el compilador traduce acciones básicas, como hacer clic o arrastrar, en información sobre qué datos se seleccionaron;
- Operaciones de actualización: se usan set-style, set-annotation y set-viewport para declarar cambios en la visualización, sin tocar el renderizado de bajo nivel;
- Separación de responsabilidades: el compilador se encarga de la lógica visual, la lógica de interacción se describe en la capa semántica y el runtime gestiona la máquina de estados de Canvas;
- Tres vías de uso: MCP en conversaciones, Canvas dentro de aplicaciones y la API de programación para interacciones personalizadas;
- Principio aplicable a otros casos: diseñar especificaciones de salida de alto nivel para agentes y delegar la capa más propensa a errores en un sistema determinista;
- Validación práctica: comparar varios modelos mediante la interfaz unificada de APIYI y probar la estabilidad de la generación de especificaciones.
Resumen
La idea de los eventos semánticos de Flint-interactive se resume en tres puntos:
- Identificación precisa del problema: generar gráficos interactivos es difícil no porque los modelos no sean lo bastante potentes, sino porque falta un lenguaje de interacción expresivo y de nivel suficientemente alto;
- Separación clara de responsabilidades: el compilador analiza los eventos y actualiza la visualización; el agente solo describe la relación «evento → actualización»;
- Integración por niveles: desde probarlo en una conversación hasta integrarlo en una aplicación o crear interacciones personalizadas, puedes avanzar según tus necesidades.
Si tu equipo desarrolla agentes para informes o análisis de datos, puedes aprovechar estos principios de diseño para revisar el formato de salida de tus agentes, aunque por ahora no uses Flint.
Para hacer pruebas, puedes acceder a varios modelos populares desde la interfaz unificada de APIYI en apiyi.com y comparar sus resultados con el mismo conjunto de requisitos de interacción. Así podrás encontrar antes la combinación de modelo y especificación que mejor se adapte a tu negocio.
📚 Referencias
- Microsoft Research Blog – Flint-interactive: blog oficial de investigación sobre Flint-interactive
- Enlace:
microsoft.com/en-us/research/blog/flint-interactive-a-language-for-creating-interactive-data-visualizations - Descripción: presenta los eventos semánticos, las operaciones de actualización, la máquina de estados de Canvas y las tres formas de uso: MCP, Canvas y API de programación. El blog también incluye una guía de configuración de MCP, una biblioteca de ejemplos interactivos y acceso a la API de programación.
Autor: equipo técnico de APIYI
Intercambio técnico: visita APIYI en apiyi.com para compartir experiencias prácticas sobre agentes e integración de múltiples modelos. Encontrarás más recursos en el centro de documentación docs.apiyi.com.