著者注:5ステップの検証フローで、AIで論文を書くときに「参考文献がデータベースで見つからない」という問題を解決します。検索ソース、原文を開く、項目を照合、引用を比較、人による確認までをカバーします。
AIで論文を書くとき、多くの人が最初に同じ問題に直面します。モデルが参考文献のリストを提示し、著者、ジャーナル、年、巻号のいずれも本物のように見えるのに、データベースで検索してみるとその論文が見つからないのです。本記事では、検索と原文照合を中心とした文献検証フローを紹介し、AIで論文を書く際に偽文献を避ける具体的な方法を身につける助けをします。
これはAIを使うなと説得する記事ではありません。AIは思考の整理、表現の推敲、書式の整備を支援できます。しかし「この文献が実在するか、この記述が本当に含まれているか」は、検索と原文の確認でしか判断できません。モデルに記憶だけを頼りに答えさせるわけにはいきません。APIYI apiyi.com のようなマルチモデル集約プラットフォームを使えば、さまざまなモデルを呼び出して執筆を支援できますが、どのモデルを使う場合でも、以下の検証フローは避けて通れません。
核心的な価値:本記事を読み終えれば、そのまま実行できる検証チェックリストが手に入ります。各参考文献が実在するか、正しく引用されているかを判断できるようになり、論文内の文献が指導教員や査読者による一件ずつの確認に耐えられるようになります。
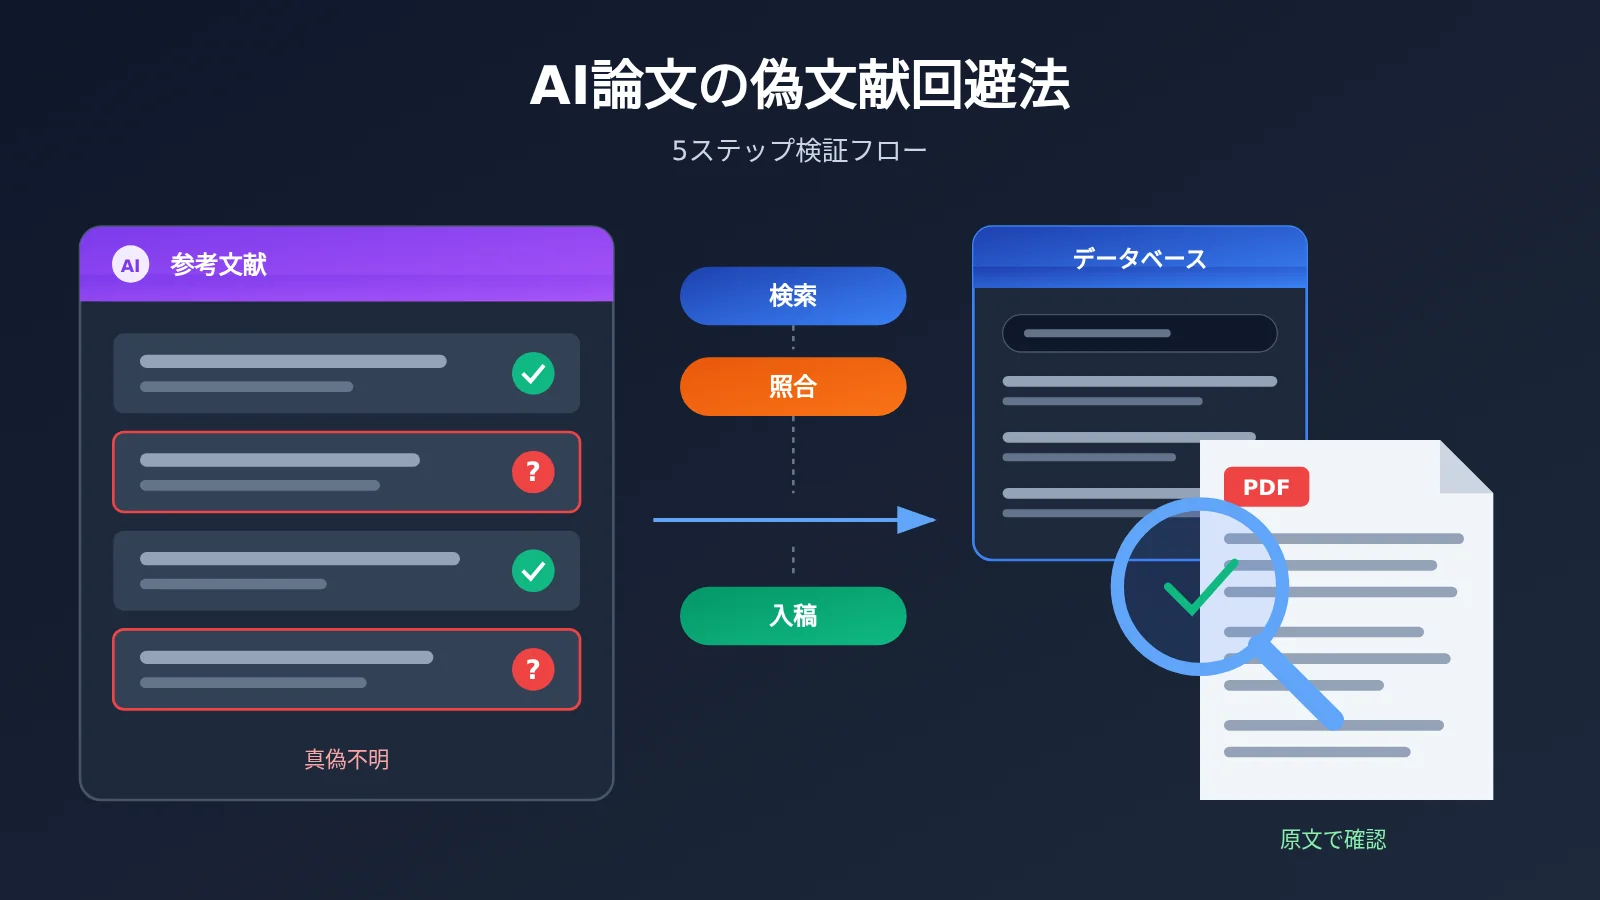
AIで論文を書くときに偽の参考文献を避けるための核心ポイント
まず問題の根本から整理しておきましょう。汎用のチャットモデルは質問に答えるとき、リアルタイムで文献データベースを検索しているわけではなく、大半は学習で身につけた言語パターンに基づいて文章を生成しています。そのため、出力される参考文献の書式は整っていても、中身は組み立てられたものかもしれないのです。実在する著者名に存在しないタイトルを組み合わせたり、実在するジャーナルに誤った年やページ番号を付けたりといった具合です。
| ポイント | 説明 | 価値 |
|---|---|---|
| まず検索、その後で引用 | 文献はデータベースの検索結果から取得し、モデルの記憶には頼らない | 出所不明の項目が生成されるのを根本から防ぐ |
| すべての項目で原文を開ける | 引用前に抄録ページまたは全文を確認できること | 文献の存在と内容の関連性の両方を確認できる |
| 項目をフィールドごとに照合 | 著者・タイトル・ジャーナル・年・巻号・ページ・DOIを一つずつ比較 | 「半分だけ本物」の混在項目を防ぐ |
| 引用内容を原文と照合 | 本文中の「某某氏は……と指摘している」が原文で裏付けられること | 誤引用や過度な拡大解釈を防ぐ |
| 最終確認は人が行う | 各文献は著者本人が確認してから原稿に反映 | 責任の所在が明確で、学術規範にも適合 |
AIで論文を書くときに現れる偽文献の3つの典型パターン
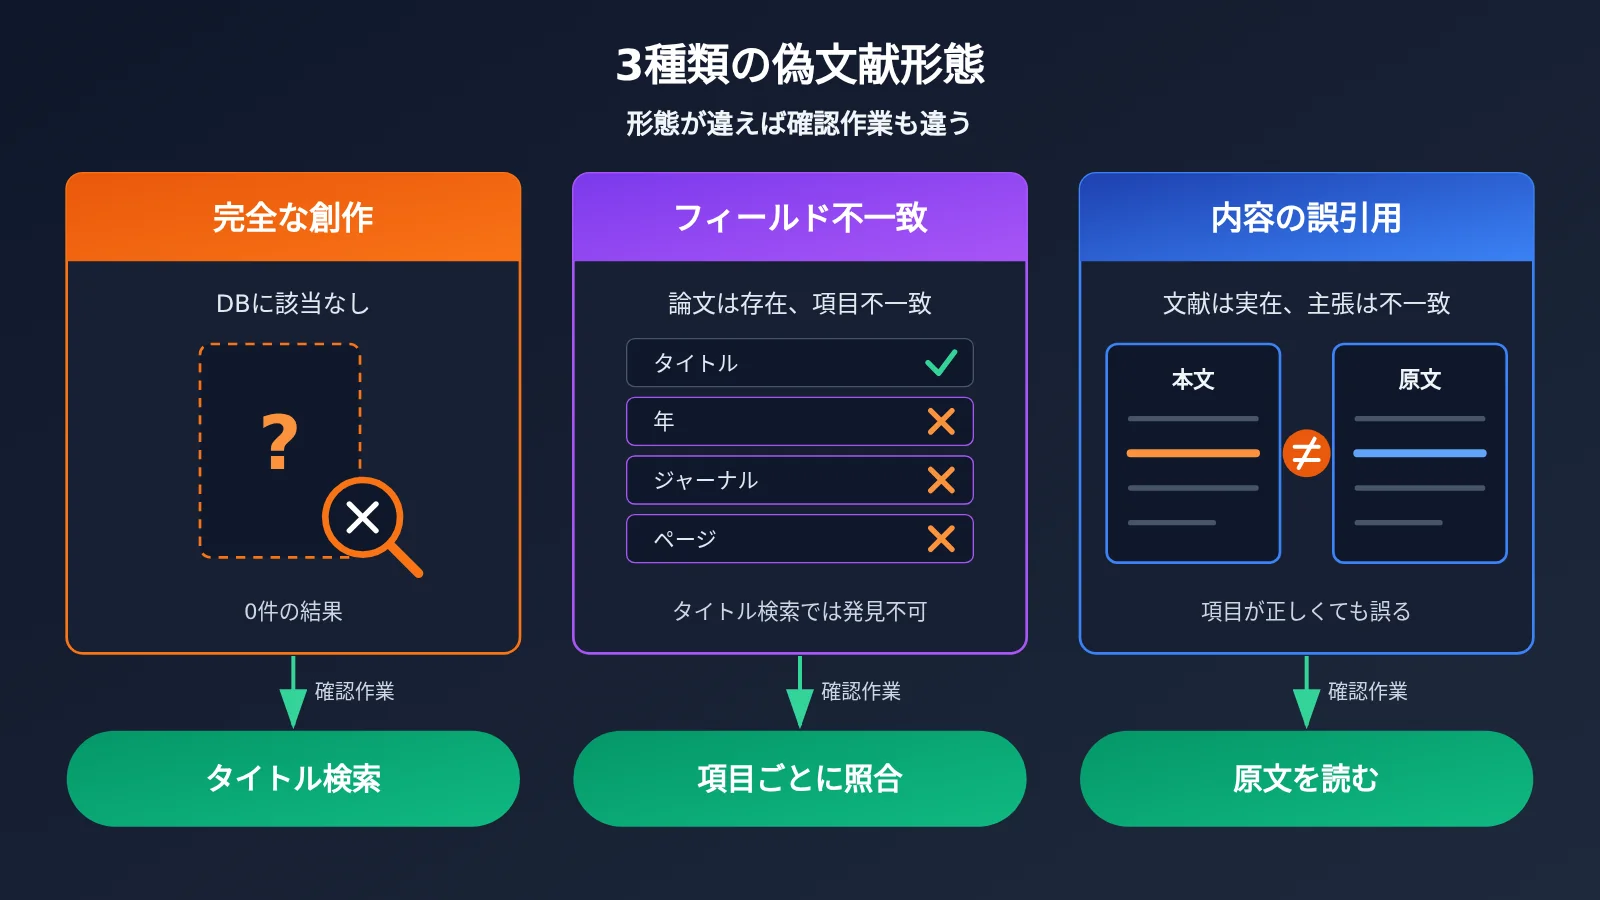
1つ目は完全な虚構です。文献全体がどのデータベースでも見つからず、著者名は実在していても、その論文が発表されたことは一度もないというケースです。これは最も見つけやすく、データベースでタイトルを検索すればすぐに露呈します。
2つ目はフィールドの食い違いで、これが最も見抜きにくいパターンです。論文自体は実在するものの、年・ジャーナル・巻号・著者の順序が改変されていたり、2本の論文の情報が1つの項目に混ぜ合わされていたりします。タイトルだけ検索すると「見つかった」と感じますが、フィールドごとに照合して初めて食い違いに気づきます。3つ目は内容の誤引用です。文献は実在し、項目も正しいのに、本文で「この研究は……を証明した」と書かれている内容が、原文にはその結論がない、あるいは結論の適用条件が省かれているというケースです。
この3つのケースでは検証方法が異なります。最初の2つは検索と項目の照合で対応できますが、3つ目は原文を開いて読むしかありません。これが、本記事のワークフローで「原文を開く」を独立したステップとして位置づけている理由です。
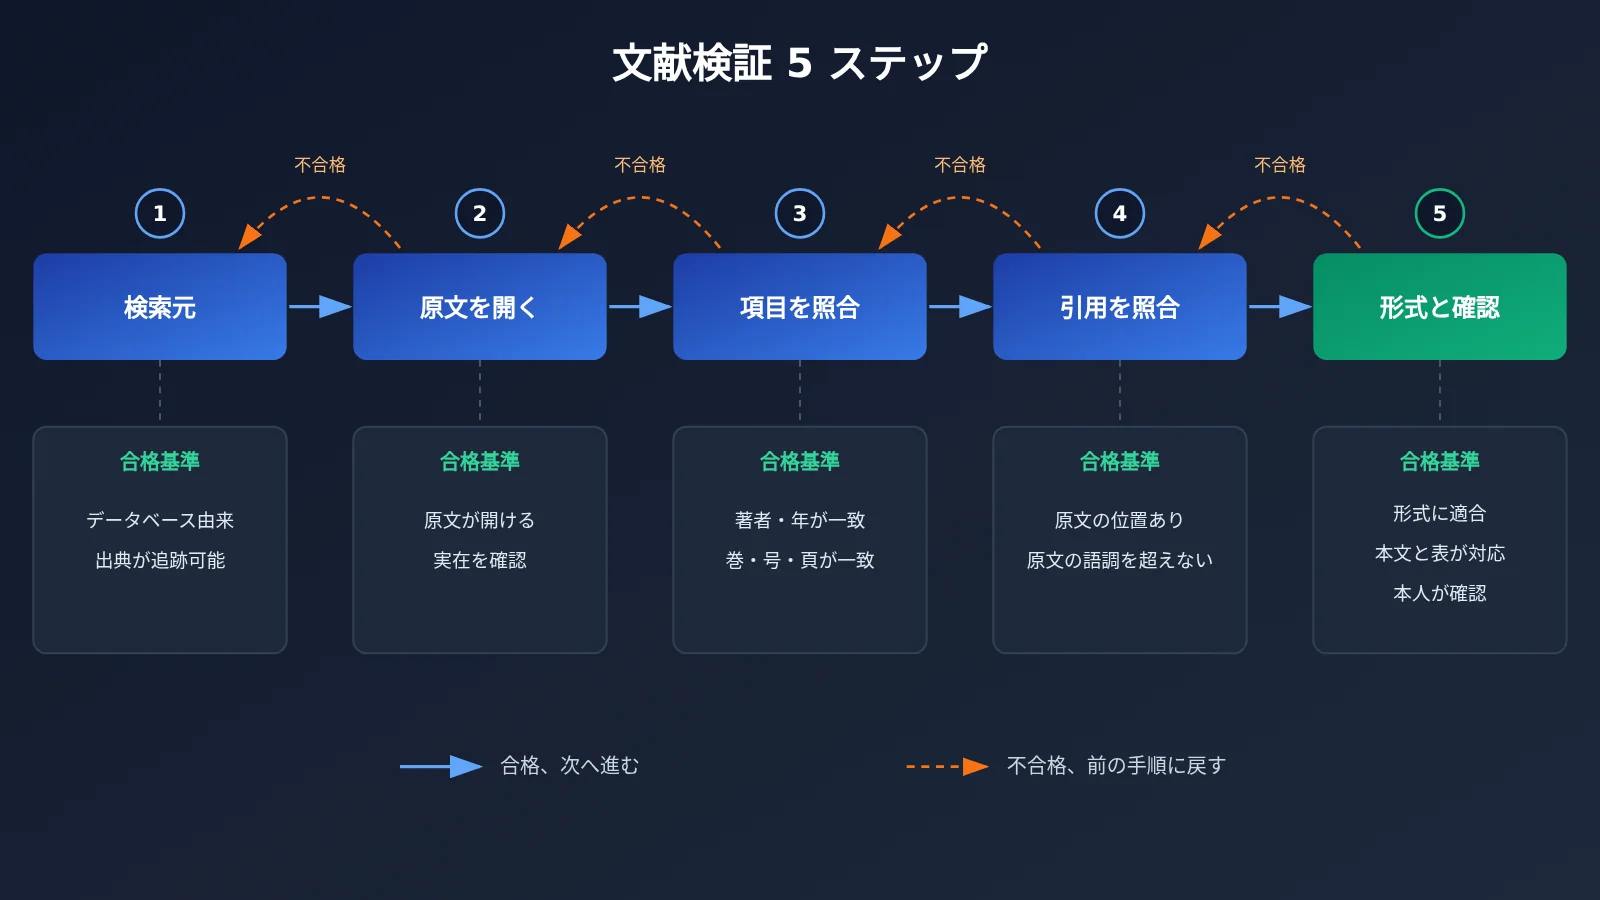
AIで論文を書くときに偽の文献を避けるクイックスタート:5ステップの検証フロー
このフローは特定のツールに依存しません。大学図書館のデータベース、学術検索エンジン、文献管理ソフトウェアのいずれでも実行できます。各ステップには操作方法と「合格基準」を記載しているので、基準を満たしてから次のステップに進んでください。
ステップ1:AIに文献リストを作らせるのではなく、検索の起点から文献を取得する
AIに対して「あるテーマについて参考文献を20件挙げて」と頼むのはやめましょう。これこそ、偽の文献が最もよく生まれる原因です。より確実な方法は、AIに研究課題の分解、検索キーワードの抽出、検索式の組み立てを手伝ってもらい、その後、自分でデータベースに出向いて検索を実行することです。
具体的には、AIに中国語・英語のキーワード、同義語、上位語・下位語を出してもらい、学校が契約している中国語データベース、英語の学術データベース、または学術検索エンジンで検索し、被引用数・年・ジャーナルのレベルで絞り込みます。検索結果のページこそが、文献が実在することの最初の証拠になります。
合格基準:候補となる各文献が実際の検索結果から得られたものであり、どのデータベースで、どんなキーワードを使って見つけたのかを説明できること。
ステップ2:原文を開き、存在と関連性を確認する
候補文献を入手したら、少なくとも要旨ページまたは出版社ページを開いてください。可能であれば全文もダウンロードします。タイトルだけを見て引用することは、誤引用の主な原因です。
読む際は、次の3点に注目します。要旨における研究課題と結論、方法におけるサンプルと条件、結論における限界の説明です。誤引用の多くは、「特定のサンプルや条件でのみ成立する」といった限定を無視した結果にほかなりません。
合格基準:この文献が何を述べているかを1〜2文で説明でき、自分の論文のどの議論と関連するかを示せること。
ステップ3:文献項目をフィールドごとに照合する
項目の照合は、原文の著作権ページ、出版社ページ、データベースの詳細ページに基づいて行い、モデル出力、二次引用、他人の論文の参考文献リストに基づかないでください。
| 照合項目 | 照合元 | よくある問題 | 判断基準 |
|---|---|---|---|
| 著者 | 原文のトップページ、データベースの詳細ページ | 著者の順序が逆、共著者の漏れ、氏名の綴り誤り | 順序と綴りが原文と完全に一致 |
| タイトル | 原文のトップページ | 表現が言い換えられている、副題が欠けている | 副題を含めて一字一句一致 |
| 学術誌/出版社 | 著作権ページ、学術誌の公式サイト | 名称が似ている学術誌との混同、会議と学術誌の混同 | 誌名の正式名称が一致 |
| 年、巻、号 | 著作権ページ、データベースの詳細ページ | オンライン公開年と正式出版年の混用 | 対象の引用形式に従って該当する年を選択 |
| ページ番号 | 原文のヘッダー・フッター | ページ範囲の誤りまたは欠落 | 開始ページと終了ページが原文と一致 |
| DOI などの識別子 | 原文のトップページ、出版社ページ | DOI が解決できない、または解決先が別の論文を指す | 解決結果が同じ論文を指す |
DOI は非常に便利な照合ツールです。文献に DOI が付いている場合は、DOI 解決サービスで開き、解決先が同じ論文かどうかを確認します。解決に失敗する、またはまったく別の論文に解決される場合は、その文献に問題があるとほぼ判断できます。
合格基準:表内のすべての項目が元の情報源と一致し、モデル出力に依存している項目が一つもないこと。
ステップ4:引用内容を原文に戻して照合する
項目が正しいというのは「その論文が存在する」ことしか示しておらず、「その論文があなたの書いたこの一文を述べた」ことまでは示していません。本文中の引用は一つひとつ、原文の中に対応する文・データ・図表を見つけられる必要があります。
実用的な方法は、引用対照表を作ることです。左に本文中の引用文、中央に原文の該当箇所(ページ番号や章・節)、右に原文のキーとなる表現を書きます。こうしておけば、指導教員に「この結論はどこから出たのか」と聞かれても、すぐに該当箇所を示せます。AIに引用文の書き換えを手伝ってもらった場合は、書き換えた後にかならず原文と照合し直してください。推敲のときに一番よく起きるのが、「関連する可能性がある」を「証明した」に変えてしまうミスだからです。
合格基準:各引用に原文の位置があり、引用文の強さ(関連する・示す・証明する)が原文の表現を超えていないこと。
ステップ5:フォーマットを統一し、人手で確認して入稿する
フォーマットは最後です。中国語論文では GB/T 7714 規格が一般的で、英語誌では APA、MLA、あるいはジャーナル独自の形式が求められることがあります。学校や投稿先ジャーナルの最新の要求に従ってください。チェック済みの文献は文献管理ソフトに保存し、ソフトに引用と参考文献リストを生成させるのがおすすめです。手入力によるミスを減らせます。
入稿前にもう一度、全体をチェックします。本文中の番号が参考文献リストと一対一で対応しているか、本文で引用したのにリストに載っていない文献や、リストにはあるけれど本文で引用していない文献がないか。
合格基準:フォーマットが目標の規格に適合し、本文の引用と参考文献リストが完全に対応しており、各文献を本人が確認済みであること。
🚀 クイックスタートのアドバイス:この5ステップのうち、AIが最も力を発揮するのはステップ1のキーワード分解と、ステップ5のフォーマット整理です。文献が実在するかどうかの判断をAIに任せるのには向いていません。研究課題の分解や表現の推敲で異なるモデルの効果を比較したい場合は、APIYI apiyi.com の統一インターフェースを使えば、複数の主要モデルを切り替えて試せます。ただし文献そのものは、やはりデータベースと原文に戻って確認してください。
AIで論文を書くときに偽の文献を避ける:どの工程をAIに任せ、どこは必ず人が行うか
多くの人の悩みは「AIを使うかどうか」ではなく、役割分担がはっきりしていないことにあります。次の表は、AIにできることと、人が必ずやるべきことを工程ごとに整理したものです。
| 執筆工程 | AIが向いていること | 必ず人が行うこと | リスクレベル |
|---|---|---|---|
| テーマ設定と研究課題 | 研究課題を掘り下げる、反例を挙げる、論証の弱点を指摘する | 主張と研究的な貢献を決める | 中 |
| 文献検索 | キーワードを抽出する、検索式を組み合わせる、用語を翻訳する | データベースで実際に検索し、選別する | 高(AIに文献を直接リストアップさせてはいけない) |
| 文献の読解 | 長い段落の理解を助ける、用語を説明する | 原文を読み、関連性を判断する | 高 |
| 本文の執筆と推敲 | 語順を整える、用語を統一する、論理のつながりを確認する | 変更を一箇所ずつ確認し、引用番号が消えていないことを確かめる | 中 |
| 引用フォーマット | 規範に沿って句読点やフィールドの順序をチェックする | フィールドの内容が原文と一致することを確認する | 低〜中 |
この表で注目したいのは、推敲の工程にも文献リスクがあるという点です。AIに段落全体を書き直させると、引用番号をうっかり一つ削ってしまったり、引用文の語調を変えてしまったりすることがあります。そのため推敲のときは、AIには指定した文だけを直すよう指示し、変更を一箇所ずつ確認するのがおすすめです。新しい文章をそのまま丸ごと受け入れるのは避けましょう。
💡 選択のヒント:モデルによって、長文の理解や中国語表現の得意分野はそれぞれ異なります。どれが使いやすいかは、あなたの執筆スタイル次第です。APIYI apiyi.com の統一インターフェースを使えば、同じ草稿を複数のモデルで比較し、推敲や追加の問いかけに最も適したものを選べます。
AIで論文を書くときに偽の文献を避けるための、ツール別アプローチ比較
この問題に対処するツールには、大きくいくつかのアプローチがあります。ここでは、開発者がコミュニティで共有しているデスクトップ執筆ツール「Prose」を例に取り上げます。その設計原則の一つが「照合できるものだけを信頼する」という考え方です。変更点はdiffで確認でき、文献は原文を開けること。開発者の説明によれば、学術検索や中国語データベースに接続して検索を実行し、GB/T 7714形式の引用文献を取得でき、ローカルのZotero文献ライブラリにも接続できるとのことです。ここではあくまで一つの製品アプローチとして紹介します。実際の効果については、ご自身で試して判断してください。
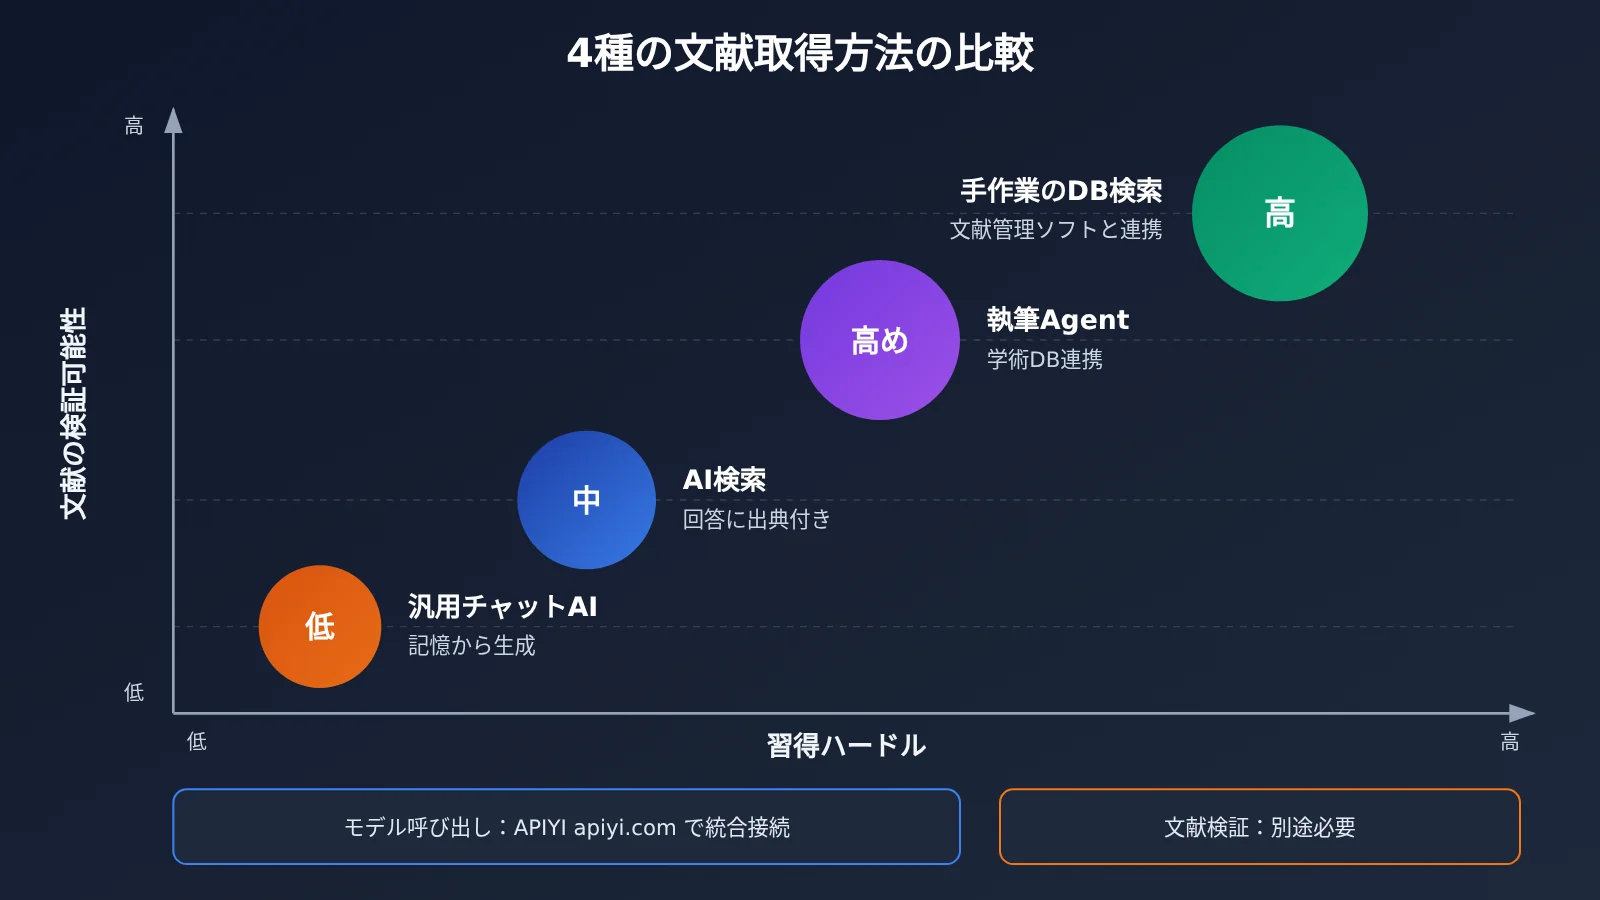
| 文献の取得方法 | 主な特徴 | 照合可能度 | 適した場面 | 利用できるプラットフォーム/方法 |
|---|---|---|---|---|
| 汎用チャットAIが記憶から生成 | 文献リストを直接出力し、書式も整っている | 低。1件ずつ検証が必要 | キーワードの発想にのみ向き、そのまま引用するのは不適 | 各種チャットモデル。APIYI apiyi.com で複数モデルを統合的に呼び出せる |
| 出典付きのAI検索 | 回答に参照元リンクが付く | 中。参照元が学術文献かどうかの確認が必要 | 分野の概要を素早く把握したいとき | 各種AI検索プロダクト |
| 学術データベース検索に接続した執筆ツール | データベースから検索して引用文献を取得 | やや高。ただし原文を開く必要は残る | 手作業の検索や書式整理を減らしたいとき | Proseなどの執筆エージェント |
| 人手による検索+文献管理ソフト | 完全にコントロール可能。ただし手順は最も多い | 高 | 学位論文、正式な投稿 | 大学のデータベース、Zoteroなど |
汎用チャットAIの比較分析:汎用チャットAIは表現の推敲や考えの掘り下げには便利ですが、提示される文献は本質的に生成されたテキストであり、1件ずつ検証する必要があります。それに比べ、検索結果を出発点とする方法はどれも、源流の段階で偽文献のリスクを下げられます。
執筆エージェントの比較分析:検索を執筆フローに組み込んだツールは、コピー&ペーストの手間を大幅に省けます。しかし「ツールが検索してくれた」ことは「あなたが原文を読んだ」ことと同じではありません。第2ステップと第4ステップは、依然として自分で行う必要があります。また、学術データベースへの自動アクセスがデータベースの利用規約に適合するかどうか、そして在籍校のAI支援執筆に関する規定についても、ご自身で確認したうえで利用してください。
AIで論文を書くときに偽文献を避けるレッドフラッグ信号チェックリスト
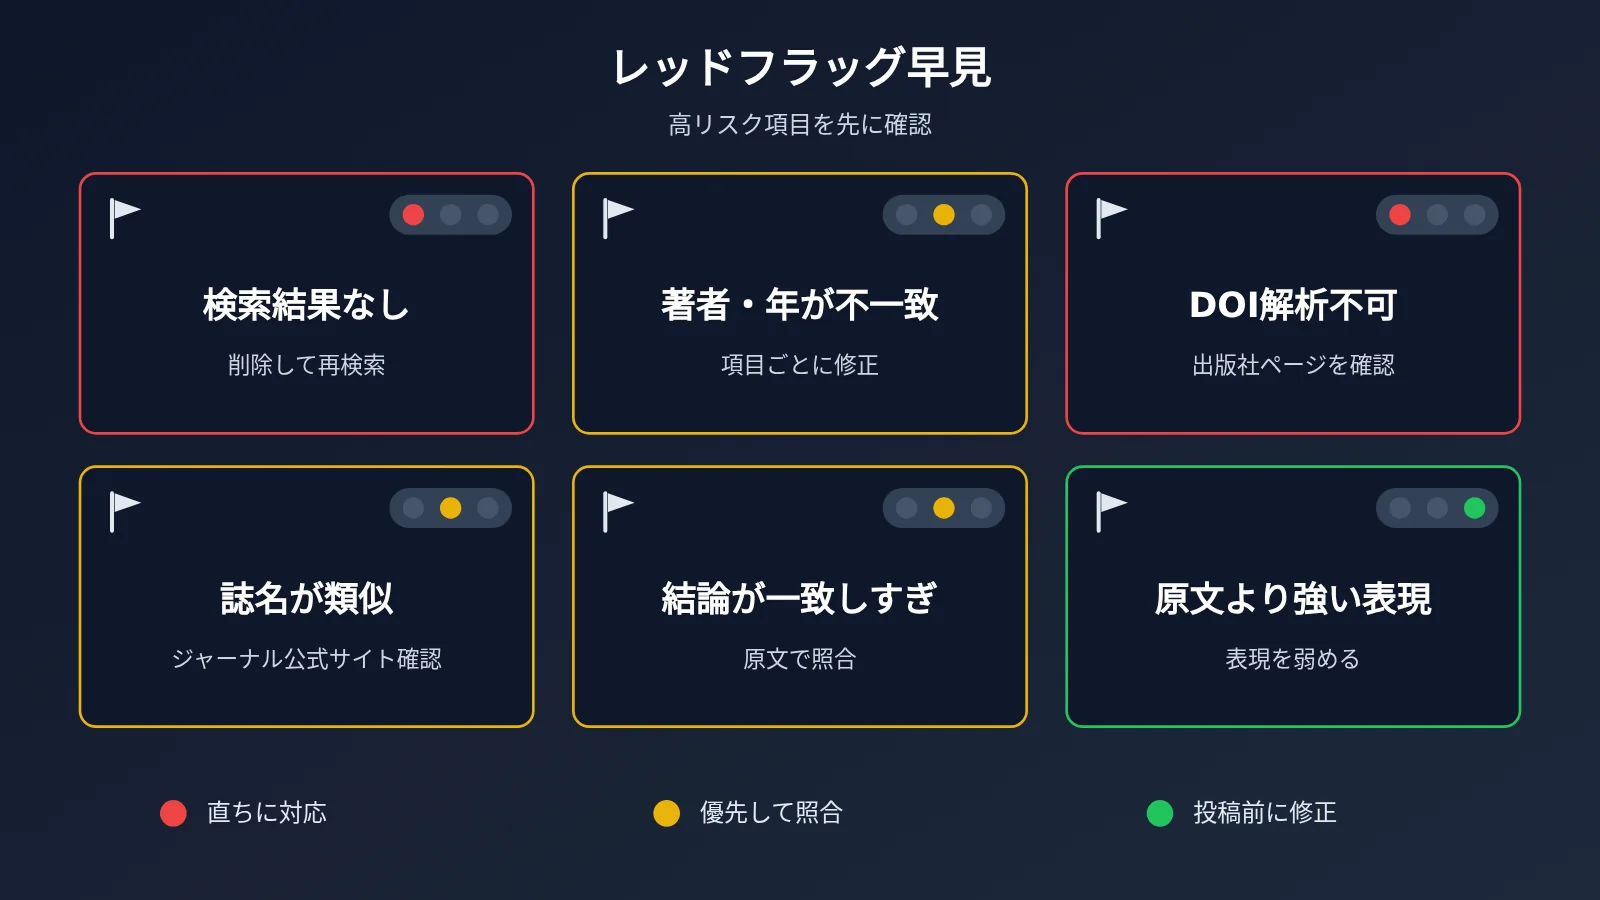
一連のワークフローを実行する前に、以下の信号を活用すると、高リスクの項目をすばやく絞り込み、優先的に確認できます。
| レッドフラッグ信号 | 想定される問題 | 優先対応 |
|---|---|---|
| データベースでタイトルを検索しても結果が出ない | 完全な架空 | 直ちに削除し、代替文献を再検索する |
| 類似タイトルは見つかるが、著者または年が異なる | フィールドの不一致または結合 | 原文を基準に各フィールドを修正するか、使用をやめる |
| DOIが解決できない、または別の論文を指す | 識別子の偽造または不一致 | 出版社ページの情報を基準にする |
| ジャーナル名が一般的な誌名と酷似しているが少し異なる | 誌名の混同 | ジャーナル公式サイトで確認する |
| 文献の結論が自分の論点と「一致しすぎている」 | モデルによる迎合的な書き換えの可能性 | 原文を開き、結論と適用条件を確認する |
| 本文の引用文の語調が原文より強い | 過度な解釈・飛躍 | 原文の表現に合わせて語調を弱める |
このチェックリストは、AIが新しい内容を出力するたびにざっと目を通すのに適しています。特に「一致しすぎている」という項目は重要です。モデルは期待に沿う内容を出しがちなので、自分の論点をちょうど支えてくれる文献ほど、時間をかけて原文に戻って確認する価値があります。
よくある質問 FAQ
Q1:AIによる論文作成における「偽文献」とは何ですか?
AIが生成した、データベースで検索できない、または情報が原文と一致しない参考文献を指します。完全に架空の項目、フィールドが食い違っている項目、項目自体は実在するものの内容が誤って引用されているケースなどが含まれます。形式が整っていて信頼できそうに見えるからこそ、1件ずつ検証する必要があります。
Q2:出典リンク付きのAI検索と汎用チャットAIは何が違いますか?
汎用チャットAIは主に学習で得た内容に基づいて回答を生成するため、挙げられた文献はすべて検証が必要です。出典付きのAI検索はクリック可能な出典が付くため、存在の確認は容易です。ただし出典はWebページやニュース、二次資料である可能性があり、学術原文ではないため、正式に引用する前には原典文献を探す必要があります。
Q3:タイトルだけ検索して見つかれば、引用してよいですか?
不十分です。タイトルで見つかることは「完全な架空」を除外したにすぎません。著者、ジャーナル、年、巻号、ページ、DOIをフィールドごとに照合し、原文を開いて、引用する主張が確かにこの文献に由来することを確認する必要があります。フィールドの食い違いや内容の誤引用は、タイトルで見つかる場合でも起こります。
Q4:AIは文献の場面で何をするのが最も適していますか?
主に以下の作業に適しています。
– **研究課題の分解**:幅広いテーマを検索可能なサブ課題に分ける
– **検索語の生成**:中日英のキーワード、同義語、検索式の組み合わせを提示する
– **読解の補助**:原文中の専門用語や複雑な段落を解説する
– **形式チェック**:指定された規範に沿って句読点やフィールドの順序を確認する
Q5:複数のモデルで執筆を補助したい場合、どう接続すると便利ですか?
マルチモデル集約プラットフォームを検討するとよいでしょう。APIYI(apiyi.com)は統一インターフェースで複数の主要モデルを呼び出せるため、同じ下書きを使ってモデルごとの追問や推敲の表現を比較できます。なお、提供されるのはモデル呼び出し機能であり、文献検索や真実性の検証を行うものではありません。文献は本記事の5ステップの流れに沿って自分で確認する必要があります。
Q6:学校はAIによる論文執筆の補助を認めていますか?
学校やジャーナルごとに規定が異なり、AIの使用状況の申告を求める場合もあれば、使用範囲を制限する場合もあります。書き始める前に、所属する学校・学部・目標ジャーナルの最新規定を確認し、必要に応じて指導教員に確認してください。本記事の流れは文献の真実性の問題を解決するものであり、こうした規定の遵守を代替するものではありません。
Q7:ツールで中国語データベースを自動検索する際、何に注意すればよいですか?
学術データベースへの自動アクセスは、データベースの利用規約やアクセス頻度の制限に関わる可能性があり、データベースやライセンス方式によって規定が異なります。こうした機能を使う前に、データベースのサービス利用規約を確認し、学校が購入したライセンスの範囲を把握しておくことで、アカウントの制限を避けられます。
Q8:この検証フローにはどのような限界がありますか?
最大的課題は時間です。文献が多いと、1件ずつ原文を開いて確認するのに膨大な時間がかかります。また、一部の文献はアクセス権がないために全文を取得できないことがありますが、その場合は図書館の文献提供サービスを通じて入手できます。現時点では、各種ツールの検索精度や誤引用率に関する独立したテストデータも不足しているため、ツールの効果は自分でサンプリングして検証するのが確実です。ワークフローの中でモデルに推敲などの工程を分担させる際は、APIYI apiyi.com を使ってモデルを切り替え、浮いた時間を原文の照合に充てるとよいでしょう。
AI 論文執筆で偽の文献を避けるための核心要点 Key Takeaways
- 偽の文献が生まれる根源:汎用モデルはリアルタイムでデータベースを照会するのではなく、言語のパターンに基づいて文献を生成する
- 三つの形態:完全な捏造、項目の不一致、内容の誤引用。検証方法はそれぞれ異なる
- 出所の原則:文献は実際の検索結果から得たものであり、AI に直接文献リストを作らせない
- 照合の原則:著者、タイトル、ジャーナル、年、巻号、ページ、DOI を項目ごとに原文と照合する
- 引用の原則:すべての引用箇所が原文中で特定でき、表現の強さが原文を超えないこと
- 役割分担の原則:AI は問い返し、推敲、書式を担当し、文献の実在性と関連性は人間が判断する
- ツール選択:モデルは APIYI apiyi.com 経由で一元的に接続・比較でき、文献の検証は別途行う
まとめ
AI で論文を書く際に偽の文献を避けるための核心的なポイント:
- まず検索してから引用する:すべての文献に実在する検索ソースを持たせ、モデルの記憶に頼らない
- 原文を開いて照合する:実在を確認し、項目を一つひとつ突き合わせ、引用文は原文に戻って根拠を探す
- 最終的には人が確認する:書式はソフトに任せ、内容は本人が一つひとつチェックしてから入稿する
AI は執筆を格段に速くしてくれますが、参考文献は論文の中で最も一つひとつ調べられやすい部分です。この5ステップの流れを執筆習慣にして、AI が新しい内容を出すたびにレッドフラグチェックリストを通せば、偽の文献をほぼ原稿の外にブロックできます。
執筆中の追问や推敲の段階で複数のモデルを比較したい場合は、APIYI apiyi.com から統合的に接続してテストできます。検証の労力は検索と原文の確認に集中させましょう。
📚 参考資料
- V2EX 分享創造 – Prose 長文執筆エージェントの紹介:開発者による執筆ツールの設計原則と文献検索の考え方の紹介
- リンク:
v2ex.com/t/1254240 -
説明: 文中の「照合できるものだけが意味を持つ」「変更は diff で見えるべき」といった設計思想は、ツール選びの参考になります。機能評価は開発者本人による説明です
-
Prose 公式サイト:デスクトップ AI 執筆ツール
- リンク:
prose-ai.cn -
説明: 「検索を執筆フローに埋め込む」といった製品形態に興味がある読者は、ご自身で試して評価してみてください
-
GB/T 7714 情報と文献 参考文献著録ルール:中国語論文でよく使われる参考文献の書式規範
- リンク: 最新版は学校の図書館または国家標準の公開チャネルからご確認ください
- 説明: 書式の要件は、学校やジャーナルの具体的な規定に従ってください
作者: APIYI 技術チーム
技術交流: APIYI apiyi.com のウェブサイトトップページからお気軽にお問い合わせください。モデル接続に関するさらなる資料は docs.apiyi.com ドキュメントセンターをご覧ください