
Nota del autor: a partir de la metáfora de Lai Jie, de Stardust Intelligence, «no me cobren tokens por cada tornillo que se aprieta», analizamos qué partes de un flujo de trabajo de IA conviene dejar en manos de programas fijos y cuáles requieren el criterio de un Modelo de Lenguaje Grande.
El 5 de noviembre de 2026, la sección «Diversidad corporativa» de 爱范儿 publicó una entrevista exclusiva con Lai Jie, fundador y CEO de Stardust Intelligence. Una de sus frases se ha repetido entre quienes desarrollan aplicaciones de IA: «Quiero que los tornillos los apriete un programa fijo, funcionando las 24 horas del día. No me cobren tokens por cada tornillo que aprieta».
No es solo una ocurrencia. En la entrevista, Lai Jie hablaba de la división de tareas en robótica: un modelo de IA incorporada se encarga de las acciones físicas y, cuando surge un problema, consulta al Modelo de Lenguaje Grande base en lenguaje natural. Aplicada a los flujos de trabajo de software, esta idea plantea una pregunta muy práctica: ¿en qué partes de una aplicación de IA no conviene invocar un Modelo de Lenguaje Grande?
Valor principal: este artículo traslada la perspectiva sobre robótica de la entrevista al diseño de límites de invocación en flujos de trabajo de software. Presenta 5 tipos de tareas que no deberían invocar un Modelo de Lenguaje Grande, un conjunto de criterios de decisión por niveles y un ejemplo de código de enrutamiento listo para adaptar. Conviene aclarar que los robots y el software son sistemas distintos: la aplicación que hacemos aquí es una analogía, cuyos resultados tendrás que validar con tu propio uso real.
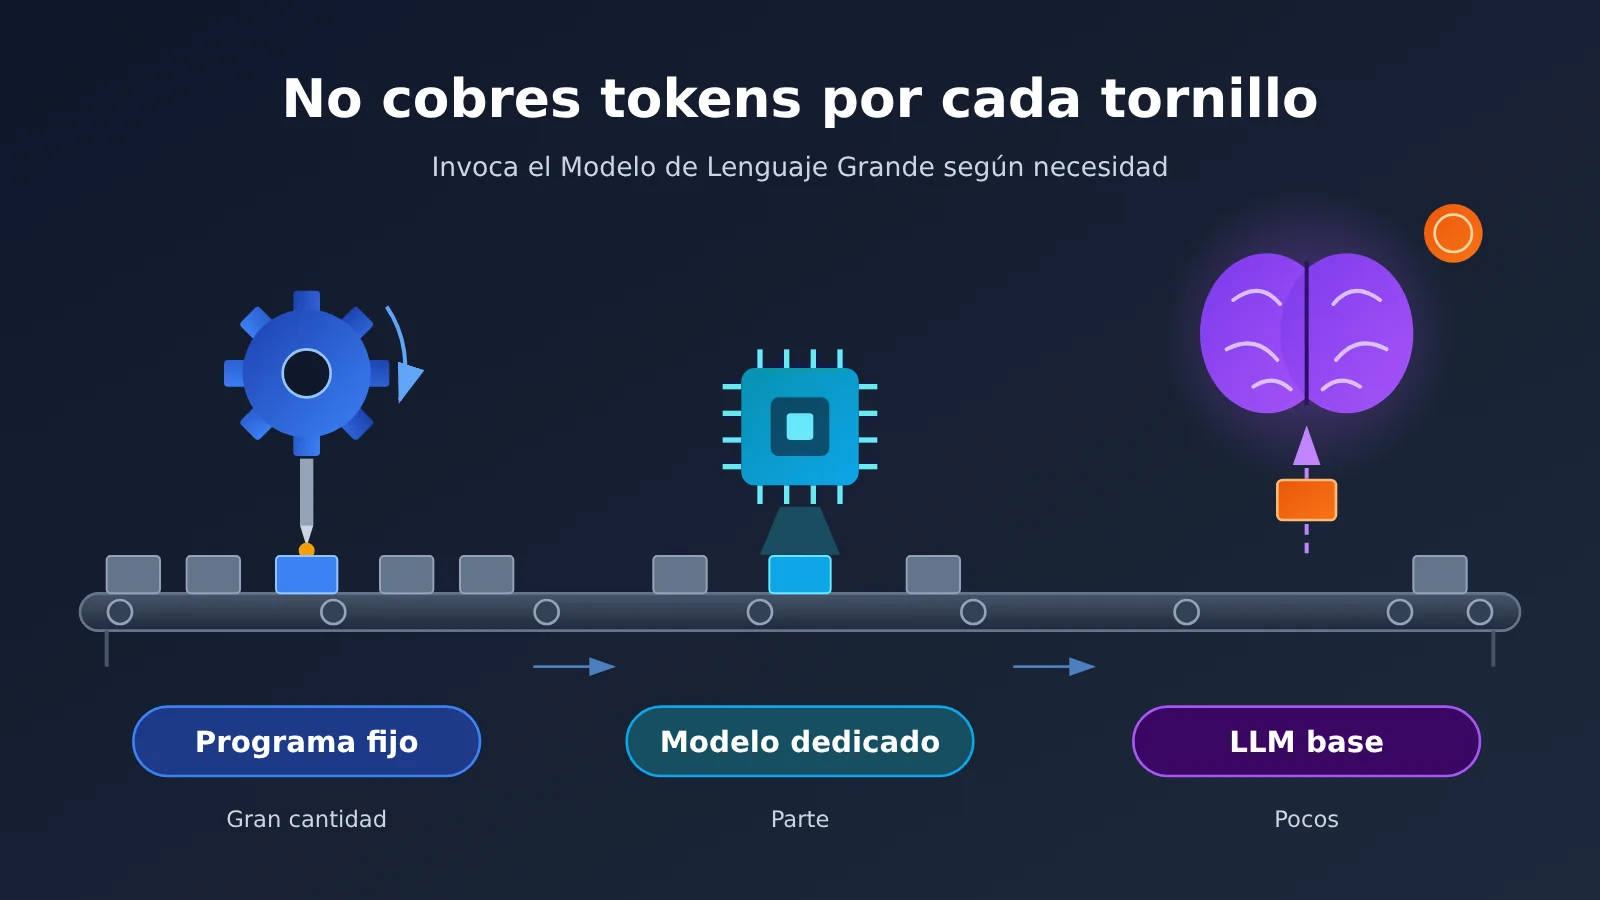
«No me cobren tokens por cada tornillo»: ideas clave
La frase surgió en la última pregunta de la entrevista. Cuando le preguntaron de qué esperaba que los robots liberaran a los humanos, Lai Jie dejó claro que no quería que los robots «fueran a una fábrica a apretar tornillos». Por un lado, considera que el valor de los robots está en la amplitud de sus capacidades; por otro, desde el punto de vista de los costos, no vale la pena pagar tokens por cada acción repetitiva.
| Dato | Detalle |
|---|---|
| Fuente | Entrevista número 15 de la sección «Diversidad empresarial» de 爱范儿 |
| Fecha de publicación | 5 de noviembre de 2026 |
| Entrevistado | Lai Jie, fundador y CEO de 星尘智能, y antiguo primer empleado del laboratorio de robótica Robotics X de Tencent |
| Idea central | Las acciones repetitivas deben quedar a cargo de programas predefinidos, sin pagar tokens cada vez |
| Reparto de tareas | El modelo de IA encarnada se encarga de la ejecución física y, cuando encuentra un problema, consulta en lenguaje natural a un Modelo de Lenguaje Grande de base |
| Aplicación al software | Los flujos de trabajo con IA necesitan definir cuándo recurrir a programas predefinidos, modelos especializados y Modelos de Lenguaje Grande de base |
Conviene aclarar que la entrevista recoge las opiniones del fundador y no aporta mediciones reales de costos ni datos verificados por terceros. Aquí retomamos su lógica de reparto de tareas, no ninguna conclusión concreta.
La metáfora de Lai Jie: «llamar a mamá por videollamada»; el Modelo de Lenguaje Grande solo aporta contexto
En la entrevista aparece una metáfora que explica el reparto de tareas incluso mejor que la de «atornillar». Lai Jie cuenta que, si no sabe cocinar pero quiere hacerlo, llama a su madre por videollamada. Ella le dice «primero pon un poco de aceite en la sartén caliente», pero no necesita decirle qué botella contiene el aceite. Si tiene dudas, vuelve a preguntarle. La clave es que su madre aporta conocimientos contextuales, pero él tiene que saber echar el aceite: ella no puede hacerlo por él desde el otro lado de la llamada.
En robótica, el modelo de inteligencia corpórea debe percibir por sí mismo parámetros físicos como el peso, la fuerza de agarre y si el objeto está bien sujeto. Solo consulta al Modelo de Lenguaje Grande base ante preguntas como «no consigo sujetarlo bien y está un poco inestable, ¿qué hago?». Lai Jie considera que entrenar al Modelo de Lenguaje Grande base también con información táctil «no es imposible, pero el coste no compensa y el ancho de banda de comunicación también sería un problema». Añade que no se trata simplemente de una estructura por capas, sino de un sistema de agentes parecido a una colonia de hormigas: cada agente no tiene por qué ser muy potente, pero juntos lo son.
| Rol en el sistema robótico | Responsabilidad en la entrevista | Rol equivalente en un flujo de trabajo de software |
|---|---|---|
| Programa fijo | Atornillar de forma repetitiva durante 24 horas | Motor de reglas, expresiones regulares, scripts, consultas de bases de datos |
| Modelo de inteligencia corpórea | Ejecución física, percepción de parámetros y traducción del estado a lenguaje natural | Modelos pequeños especializados en clasificación, extracción, búsqueda vectorial, etc. |
| Modelo de Lenguaje Grande base | Aportar conocimiento contextual y proponer soluciones a problemas difíciles | Razonamiento complejo, generación abierta y decisiones ante excepciones |
| Sistema operativo AOS | Encapsular capacidades en módulos de habilidades y adaptarlos al Modelo de Lenguaje Grande y a los agentes | Capa de orquestación de flujos de trabajo, capa de invocación de herramientas, enrutador |
Esta tabla es una interpretación del artículo, no una cita textual de la entrevista. La robótica implica control en tiempo real del mundo físico y limitaciones de ancho de banda en las comunicaciones; los flujos de trabajo de software, en cambio, están más condicionados por el coste de los tokens, la latencia y la estabilidad. Los cuellos de botella no son exactamente los mismos.
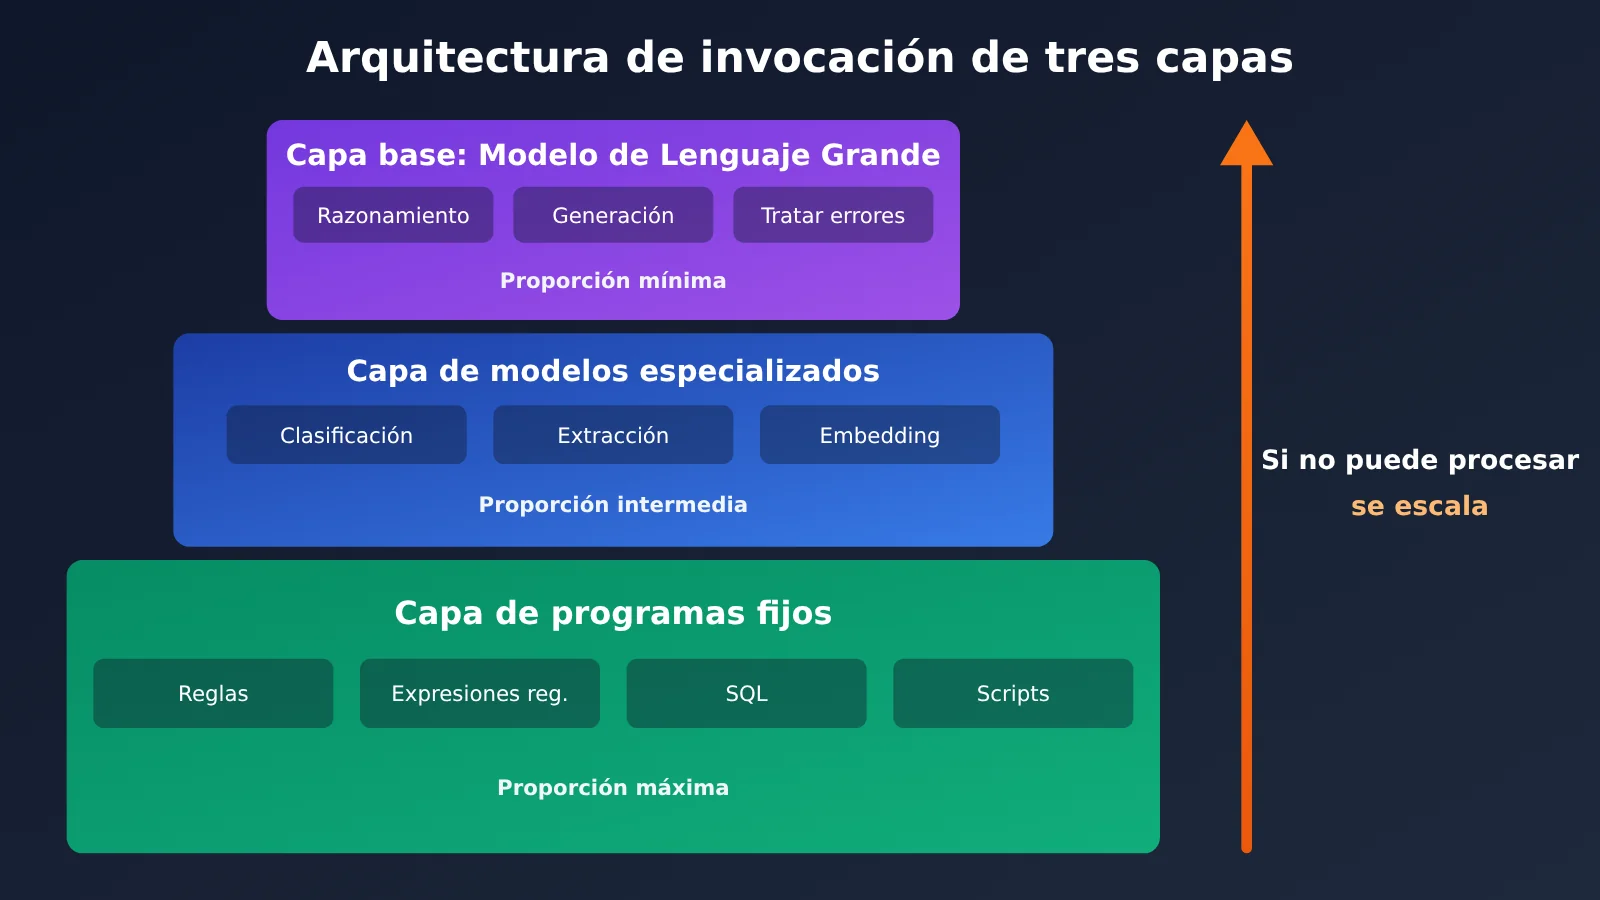
Qué etapas de una aplicación de IA no deberían llamar a un Modelo de Lenguaje Grande: 5 criterios
Al crear la primera versión de un agente, muchos equipos tienen la costumbre de encargarle todos los pasos a un Modelo de Lenguaje Grande: validar formatos, convertir fechas e incluso comprobar si un campo está vacío mediante una indicación. En la fase de prototipo esto permite avanzar rápido, pero, una vez en producción, cada solicitud paga por tareas deterministas y además introduce una variabilidad innecesaria.
Si pensamos en estas tareas como «apretar tornillos», podemos usar los siguientes 5 criterios para decidir si una etapa merece una invocación del modelo.
| Criterio | Programa convencional | Modelo especializado | Modelo de Lenguaje Grande de base |
|---|---|---|---|
| Estructura de la entrada | Campos fijos y formato definido | Texto semiestructurado | Lenguaje natural abierto |
| ¿La salida es única? | Hay una única respuesta correcta | Hay un número limitado de categorías | Hay varias respuestas razonables |
| ¿Se pueden enumerar todas las reglas? | Se pueden escribir con if/else | Hay muchas reglas, pero los patrones son estables | No se pueden enumerar todas las reglas |
| Costo de un error | Se exige cero errores | Se admiten algunos errores con revisión | Se deben sopesar varios factores |
| Frecuencia de invocación | Muy alta; se ejecuta siempre | Alta | Baja; se activa según sea necesario |
Las tareas de «apretar tornillos» que conviene dejar a un programa convencional
Las siguientes tareas suelen ser deterministas y repetitivas. Usar un Modelo de Lenguaje Grande para ellas puede reducir la estabilidad:
- Validación y limpieza de formatos: para comprobar correos electrónicos, números de teléfono, estructuras JSON y campos obligatorios bastan las expresiones regulares y la validación con Schema.
- Consultas y cálculos de datos: para obtener el estado de un pedido, la cantidad en inventario o el total de importes, consulta directamente la base de datos o llama a la interfaz del sistema de negocio. No dejes que el modelo los «deduzca».
- Salida con plantillas fijas: para mensajes SMS de notificación, acuses de recibo estándar y encabezados de informes, basta con rellenar variables mediante un motor de plantillas.
- Control de flujo y reintentos: las bifurcaciones, los reintentos por tiempo de espera y las colas para limitar solicitudes pertenecen a la lógica de orquestación y no necesitan la intervención del modelo.
- Consultas frecuentes con resultados en caché: cuando una misma pregunta se repite, consulta primero la caché o la base de preguntas frecuentes. Si hay una coincidencia, devuelve la respuesta directamente.
Las tareas que sí necesitan el criterio de un Modelo de Lenguaje Grande
En cambio, las tareas que realmente justifican llamar a un Modelo de Lenguaje Grande de base son como «las preguntas que solo mamá puede responder al otro lado del teléfono»: aclarar una intención ambigua del usuario, combinar información de varias fuentes para redactar una conclusión, resolver situaciones excepcionales que las reglas no contemplan o generar contenido creativo. Todas tienen algo en común: no hay una única respuesta, no se pueden enumerar todas las reglas y ocurren con relativa poca frecuencia.
Los modelos especializados quedan a medio camino. Para tareas como la clasificación de intenciones, la extracción de entidades, el análisis de sentimientos o la vectorización de texto, a menudo basta con un modelo más pequeño. Podemos verlo como la versión de software de un «modelo de IA incorporada»: resuelve por sí mismo lo que puede y presenta los casos que no puede manejar como preguntas claras para la capa superior.
Ejemplo de diseño por capas de un flujo de trabajo de IA: filtrar antes las tareas que no requieren un modelo grande
Tomemos como ejemplo un flujo habitual de «procesamiento automático de tickets de atención al cliente» para ver cómo definir los límites de invocación en cada paso. Es un ejemplo de diseño, no son datos medidos en un proyecto real.
| Paso del flujo de trabajo | Capa responsable | Método de procesamiento | ¿Consume tokens? |
|---|---|---|---|
| Validación de campos del ticket | Programa convencional | Validación del esquema; se rechaza directamente si faltan campos | No |
| Consulta del estado del pedido y del envío | Programa convencional | Invocación de interfaces de la base de datos del negocio | No |
| Búsqueda de coincidencias con preguntas frecuentes | Programa convencional / modelo especializado | Prioridad a las reglas de palabras clave; búsqueda vectorial como respaldo | Pocos |
| Clasificación de intenciones | Modelo especializado | Un modelo pequeño devuelve una categoría de un conjunto limitado | Pocos |
| Gestión de reclamaciones complejas y casos excepcionales | Modelo de Lenguaje Grande base | Genera recomendaciones de actuación a partir del contexto del pedido | Sí |
| Relleno de plantillas de respuesta | Programa convencional | Un motor de plantillas genera el texto final | No |
Como ves, de los 6 pasos, solo uno requiere invocar un Modelo de Lenguaje Grande base. El ahorro concreto de tokens, los posibles cambios en la tasa de éxito y la variación de la latencia dependen de la composición del tráfico y de la cobertura de las reglas. Para evaluarlos, hay que usar registros reales.
Ejemplo mínimo: primero las reglas, el modelo como respaldo
Este código muestra una estrategia mínima de enrutamiento por capas: primero, las reglas interceptan las solicitudes rutinarias; después, un modelo pequeño clasifica las restantes y solo se invoca un Modelo de Lenguaje Grande en casos complejos. Los nombres de los modelos son ejemplos; consulta la lista de modelos disponibles en la plataforma.
import re
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz de APIYI compatible con OpenAI
)

def handle(query: str) -> str:
    # Primera capa: lógica fija; no se invoca el modelo si las reglas resuelven la solicitud
    if re.search(r"(订单号|单号)\s*[::]?\s*\d{8,}", query):
        return "已为您查询订单状态(走业务接口,不消耗 token)"
    # Segunda capa: un modelo pequeño clasifica la intención
    intent = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": f"只输出类别(咨询/投诉/其他):{query}"}],
        max_tokens=5,
    ).choices[0].message.content.strip()
    if intent != "投诉":
        return f"已归类为:{intent},转入标准流程"
    # Tercera capa: solo las reclamaciones complejas invocan el Modelo de Lenguaje Grande base
    return client.chat.completions.create(
        model="claude-sonnet-4",
        messages=[{"role": "user", "content": f"请给出投诉处理建议:{query}"}],
    ).choices[0].message.content
Ver el código completo con registro de uso
import re
import time
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SMALL_MODEL = "gpt-4o-mini"       # Ejemplo: modelo pequeño para clasificación y extracción
LARGE_MODEL = "claude-sonnet-4"   # Ejemplo: modelo grande para razonamiento complejo

@dataclass
class UsageLog:
    records: list = field(default_factory=list)

    def add(self, layer: str, tokens: int, latency: float):
        self.records.append({"layer": layer, "tokens": tokens, "latency": latency})

    def summary(self):
        result = {}
        for r in self.records:
            s = result.setdefault(r["layer"], {"count": 0, "tokens": 0, "latency": 0.0})
            s["count"] += 1
            s["tokens"] += r["tokens"]
            s["latency"] += r["latency"]
        return result

log = UsageLog()

RULES = [
    (re.compile(r"(订单号|单号)\s*[::]?\s*\d{8,}"), "order_lookup"),
    (re.compile(r"(营业时间|几点开门)"), "faq_hours"),
]

def rule_layer(query: str):
    for pattern, action in RULES:
        if pattern.search(query):
            return action
    return None

def call_model(model: str, prompt: str, layer: str, max_tokens: int = 512) -> str:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=max_tokens,
    )
    tokens = resp.usage.total_tokens if resp.usage else 0
    log.add(layer, tokens, time.time() - start)
    return resp.choices[0].message.content.strip()

def handle(query: str) -> str:
    start = time.time()
    action = rule_layer(query)
    if action:
        log.add("rule", 0, time.time() - start)
        return f"[规则层] 执行动作:{action}"

    intent = call_model(
        SMALL_MODEL,
        f"只输出一个类别(咨询/投诉/其他),不要解释:{query}",
        layer="small",
        max_tokens=5,
    )
    if "投诉" not in intent:
        return f"[专用模型层] 归类为:{intent}"

    return call_model(
        LARGE_MODEL,
        f"你是资深客服主管,请针对以下投诉给出处理建议:{query}",
        layer="large",
    )

if __name__ == "__main__":
    for q in ["订单号:2026110612345 到哪了", "你们营业时间是?", "收到的商品破损,客服一直不回复"]:
        print(handle(q))
    print(log.summary())
🚀 Consejo para empezar: Para obtener resultados fiables con el enrutamiento por capas, usa la misma interfaz para cambiar de modelo entre capas y registra el consumo. Con APIYI en apiyi.com puedes invocar modelos pequeños y grandes con una sola clave API y comparar el consumo de tokens de cada capa mediante las estadísticas de uso de la plataforma. Si eres nuevo, puedes usar el crédito de prueba gratuito para validar tu prototipo.
Análisis del impacto de «no me cobres tokens por apretar cada tornillo»
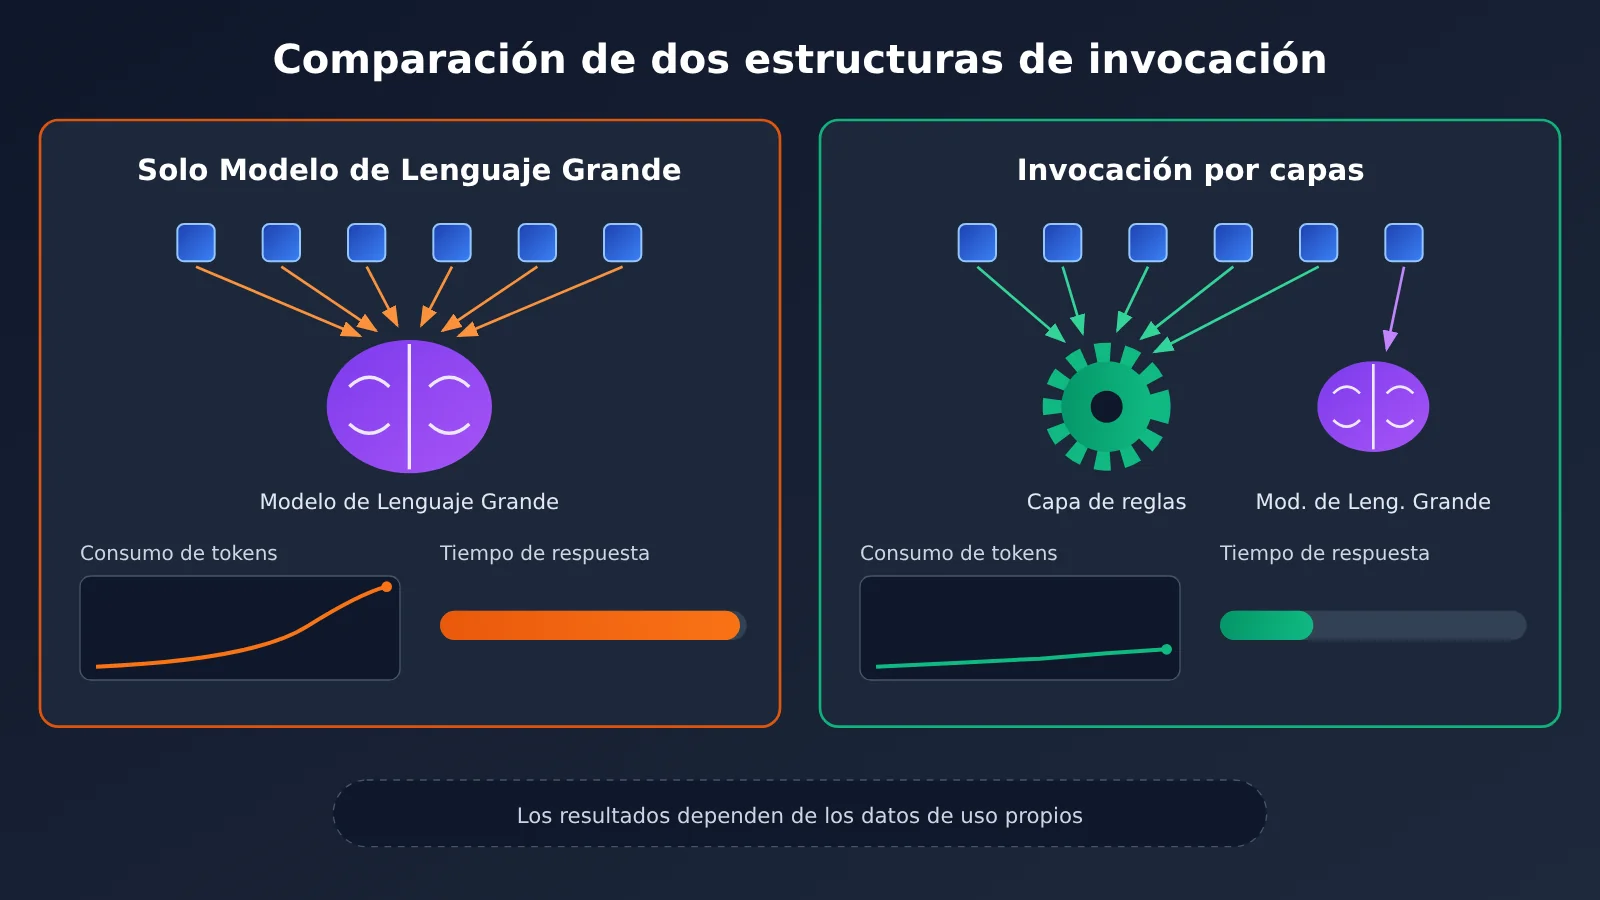
La imagen muestra las diferencias estructurales entre ambos diseños, no datos de una prueba real. Para obtener una comparación concreta, conviene ejecutar ambas opciones con el mismo conjunto de solicitudes en APIYI apiyi.com y sacar conclusiones a partir de los registros de uso.
| Criterio | Invocación del Modelo de Lenguaje Grande en todos los pasos | Invocación por capas | Plataformas disponibles |
|---|---|---|---|
| Velocidad de desarrollo | El prototipo es más rápido: basta con escribir una indicación | Requiere definir reglas y rutas adicionales | APIYI apiyi.com y las API oficiales de distintos proveedores |
| Consumo de tokens | Se cobra por cada paso | El costo se concentra principalmente en los pasos complejos | Las mismas |
| Resultados predecibles | Incluso las tareas deterministas pueden presentar variaciones aleatorias | Los resultados de la capa de reglas son predecibles | Las mismas |
| Latencia de respuesta | Cada paso requiere esperar a que el modelo genere una respuesta | La capa de reglas responde casi al instante | Las mismas |
| Costo de mantenimiento | Las indicaciones se vuelven cada vez más largas | Las reglas deben actualizarse a medida que cambia el negocio | Las mismas |
Impacto para quienes crean flujos de trabajo y desarrollan aplicaciones
- El orden de diseño se invierte: en lugar de «conectar primero un Modelo de Lenguaje Grande y buscar después cómo ahorrar», se enumeran todos los pasos, se identifica cuáles son «tornillos» y se decide dónde incorporar el modelo.
- El lugar de los modelos especializados cobra más importancia: así como un modelo de inteligencia encarnada traduce estados físicos a lenguaje natural, el valor de una capa intermedia está en convertir entradas ambiguas en problemas estructurados, para que cada invocación del Modelo de Lenguaje Grande sea más precisa.
- La observabilidad se vuelve indispensable: una vez introducidas las capas, hay que registrar las invocaciones, los tokens y la latencia de cada una. De lo contrario, no se puede saber si una tarea debería pasar a una capa superior o inferior.
Impacto para responsables de producto
- El modelo de costos es más predecible: los pasos deterministas no consumen tokens y el gasto se concentra en las solicitudes complejas, cuyo volumen puede estimarse.
- Hay que aceptar que «más inteligente no siempre es mejor»: consultar un pedido mediante un Modelo de Lenguaje Grande puede parecer más inteligente, pero lo que el usuario necesita es precisión y rapidez.
- Las métricas de validación deben definirse con antelación: el consumo de tokens, la tasa de éxito de las tareas y la latencia de extremo a extremo deben servir como base de comparación antes del lanzamiento.
Impacto para la industria
La postura de Laijie representa una forma de pensar: que los Modelos de Lenguaje Grande de base sean cada vez más potentes no significa que haya que concentrar todas las capacidades en un solo modelo. La alternativa es que distintos «agentes» especializados cumplan cada uno su función. En software, esta idea está alineada con la evolución de la invocación de herramientas y la orquestación de agentes. Sin embargo, la entrevista se centró en la robótica y todavía faltan casos públicos con datos que muestren cuánto aporta este enfoque a los flujos de trabajo de software. Hará falta que más equipos lo pongan a prueba.
Preguntas frecuentes
P1: ¿Qué significa «no me cobres tokens por cada tornillo»?
Es una frase de Lai Jie, fundador de 星尘智能, en una entrevista con 爱范儿 en noviembre de 2026. Según él, las tareas repetitivas, como atornillar piezas en una fábrica, deberían dejarse en manos de programas de funcionamiento fijo que operen las 24 horas, en lugar de invocar un modelo y pagar tokens por cada movimiento. Aplicado a las aplicaciones de IA, significa que los pasos deterministas y frecuentes no deberían invocar un Modelo de Lenguaje Grande.
P2: ¿Se puede aplicar directamente a los flujos de trabajo de software el enfoque por capas de la robótica?
No son directamente equivalentes. La robótica implica control en tiempo real, percepción táctil y ancho de banda de comunicaciones; los flujos de software están condicionados sobre todo por el costo de los tokens, la latencia y la estabilidad. Lo que sí se puede aprovechar es la lógica de reparto: «la capa de ejecución resuelve lo que puede y deriva los problemas difíciles a una capa superior». Los beneficios concretos deben validarse con casos reales.
P3: ¿Cómo decidir si un paso necesita un modelo pequeño o un Modelo de Lenguaje Grande?
Fíjate en si las salidas posibles son limitadas y las reglas son estables. Para tareas con categorías de salida limitadas y patrones estables, como la clasificación de intenciones o la extracción de campos, prueba primero un modelo pequeño. Deja para un Modelo de Lenguaje Grande las tareas que requieren razonamiento integral, generación abierta o gestión de excepciones. Una buena opción es probar distintos modelos con el mismo conjunto de muestras en APIYI apiyi.com y decidir después de comparar la precisión y el consumo.
P4: ¿La organización por capas siempre reduce los costos?
No necesariamente. Si la mayoría de las solicitudes ya son problemas complejos y la capa de reglas apenas puede resolver algunas, el beneficio será limitado. Si las reglas son demasiado amplias y retienen solicitudes por error, también pueden reducir la tasa de éxito. Lo recomendable es registrar primero la situación actual y después comparar el consumo de tokens, la tasa de éxito y la latencia antes y después de implementar las capas.
P5: ¿Cómo crear rápidamente un prototipo de invocación por capas?
Puedes seguir estos pasos:
1. Enumera todos los pasos del flujo de trabajo, identifica los «de tipo tornillo» e impleméntalos con reglas.
2. Visita APIYI apiyi.com, regístrate y obtén una clave API. Usa la interfaz compatible con OpenAI para conectar tanto un modelo pequeño como un Modelo de Lenguaje Grande.
3. Usa como referencia el código de este artículo para implementar el enrutamiento y registra los tokens y la latencia por capa.
La ventaja de una interfaz unificada es que solo necesitas cambiar el parámetro `model` para alternar entre modelos, lo que facilita compararlos varias veces.
P6: ¿Cuáles son los errores más comunes al diseñar por capas?
– **Proliferación de reglas**: se añaden tantas reglas que terminan siendo más difíciles de mantener que las indicaciones. Conviene revisarlas y depurarlas periódicamente.
– **Pérdida de información entre capas**: tras la clasificación, el modelo pequeño no transmite el contexto al Modelo de Lenguaje Grande, que tiene que volver a interpretarlo.
– **Falta de una alternativa**: si ni las reglas ni el modelo pequeño pueden resolver la solicitud, debe existir una vía para derivarla a un Modelo de Lenguaje Grande o a una persona.
«No me cobres tokens por cada tornillo»: ideas clave
- Origen de la idea: procede de una entrevista de爱范儿 a Lai Jie, de Stardust Intelligence, en noviembre de 2026. Es una opinión del fundador.
- Reparto del trabajo: la capa de ejecución realiza las acciones por su cuenta y solo consulta al Modelo de Lenguaje Grande base para obtener contexto adicional ante problemas difíciles.
- 5 tareas de rutina: la validación de formatos, las consultas de datos, la generación de resultados con plantillas, el control de flujo y los aciertos de caché no deberían invocar al Modelo de Lenguaje Grande.
- Estructura de tres capas: programas fijos como base, modelos especializados en el nivel intermedio y un Modelo de Lenguaje Grande base solo para problemas abiertos y excepciones.
- La analogía tiene límites: las conclusiones sobre robótica no se pueden trasladar directamente al software; hay que comprobar los beneficios con datos propios.
- Tres métricas para validar: comparar el consumo de tokens, la tasa de éxito de las tareas y la latencia de extremo a extremo antes y después de aplicar las capas.
- Cómo empezar: la interfaz unificada de APIYI apiyi.com permite cambiar entre modelos de cada capa y observar su consumo.
Resumen
La frase «No me cobres tokens por cada tornillo» nos invita a revisar en qué momentos invocamos modelos dentro de un flujo de trabajo de IA:
- Identifica las tareas de rutina: deja en manos de programas fijos los pasos frecuentes, muy predecibles y con una única respuesta.
- Añade modelos especializados: usa modelos pequeños para tareas con categorías limitadas y patrones estables, así como para organizar las consultas.
- Reserva el Modelo de Lenguaje Grande para el final: paga tokens por tareas que realmente lo merezcan, como el razonamiento abierto, las decisiones ante excepciones y la generación creativa.
Este método no depende de un modelo o lanzamiento concreto y puede servir como lista de verificación duradera para diseñar agentes. Al implementarlo, asegúrate de comparar los resultados antes y después de aplicar las capas con los registros de tu negocio, en lugar de dar por hecho que los costos bajarán.
Si estás diseñando un flujo de trabajo por capas, puedes usar una sola clave API en APIYI apiyi.com para acceder a modelos de distintos tamaños, cambiar entre ellos en cada capa y comparar las estadísticas de consumo. Así podrás decidir con datos quién debe apretar cada «tornillo».
📚 Referencias
- 爱范儿 – Conversación con Lai Jie, de 星尘智能: entrevista n.º 15 de la sección «Empresas diversas»
- Enlace:
ifanr.com/1687805 -
Descripción: Fuente original de la analogía entre «apretar tornillos y pagar por tokens» y de la idea de repartir tareas entre modelos de IA corporeizada y Modelos de Lenguaje Grande de base.
-
Documentación de la API Chat Completions de OpenAI: descripción de los parámetros de la API compatible con OpenAI
- Enlace:
platform.openai.com/docs/api-reference/chat - Descripción: Ayuda a entender campos como
model,max_tokensyusagepara implementar el registro de uso por capas.
Autor: Equipo técnico de APIYI
Intercambio técnico: Puedes contactarnos desde la página principal de APIYI. Para más información sobre la integración de modelos y las estadísticas de uso, consulta el centro de documentación de APIYI.






