
Anmerkung des Autors: Ausgehend von Lai Jies Vergleich „Verlangt mir nicht für jede eingedrehte Schraube eine Token-Gebühr“ untersucht dieser Artikel, welche Schritte in einem KI-Workflow feste Programme übernehmen sollten und wo die Urteilskraft eines großen Sprachmodells gefragt ist.
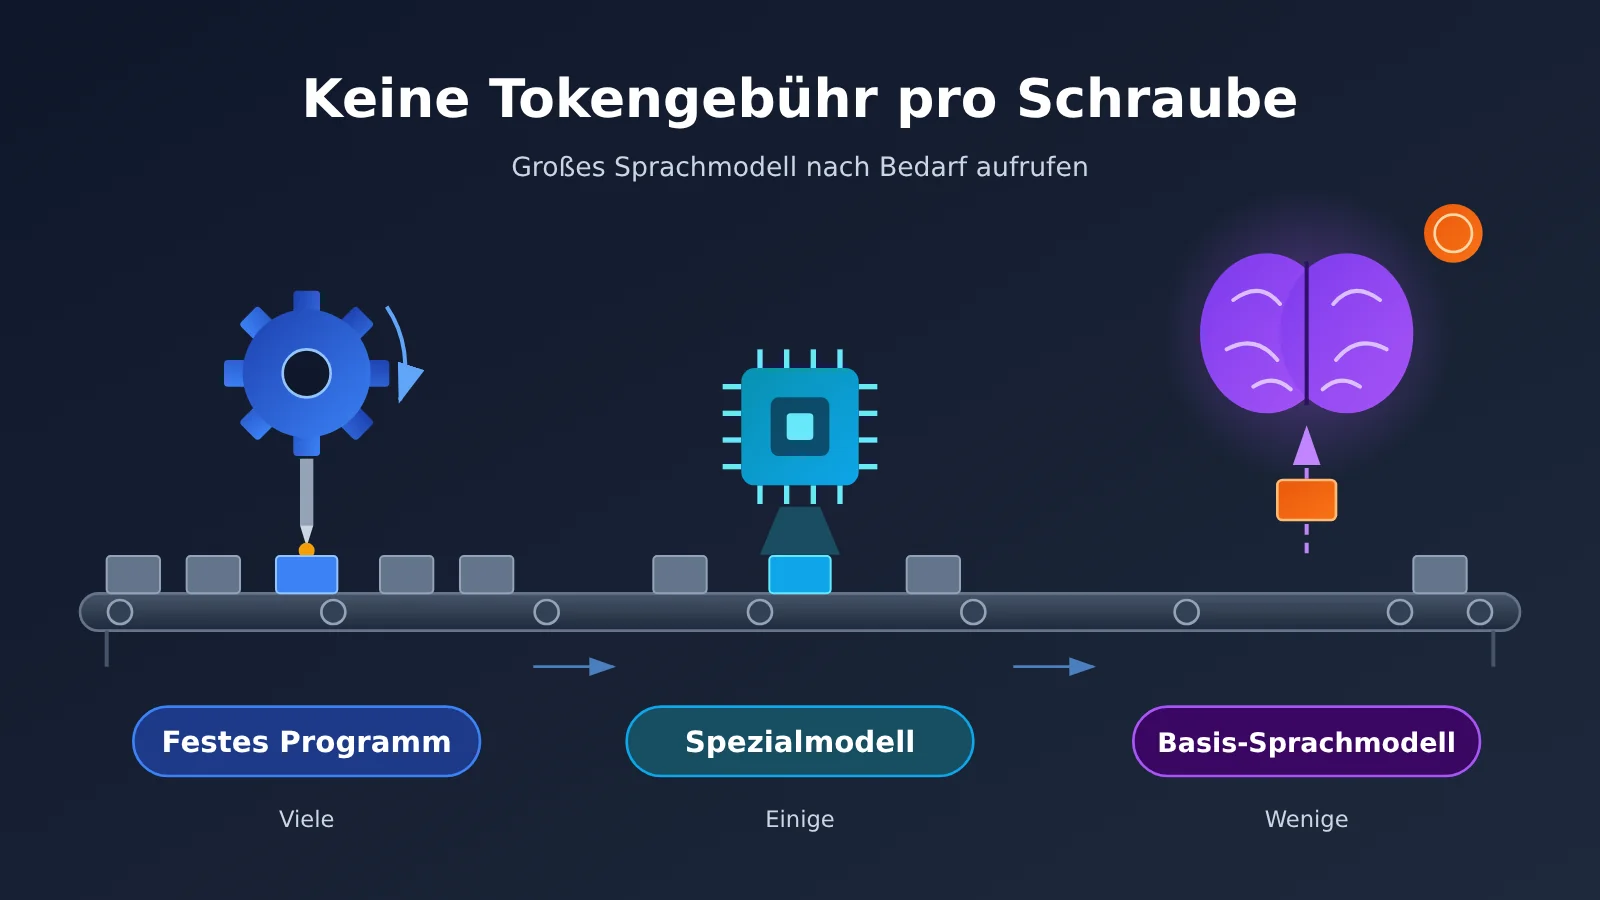
Am 5. November 2026 veröffentlichte die ifanr-Rubrik „Unternehmen der Vielfalt“ ein Interview mit Lai Jie, Gründer und CEO von Stardust Intelligence. Ein Satz daraus wurde von vielen Entwicklern von KI-Anwendungen immer wieder zitiert: „Ich möchte, dass feste Programme die Schrauben eindrehen und 24 Stunden am Tag durchlaufen. Verlangt mir nicht für jede eingedrehte Schraube eine Token-Gebühr.“
Das ist mehr als ein Scherz. Lai Jie sprach im Interview über die Arbeitsteilung bei Robotern: Ein Embodiment-Modell übernimmt die physischen Bewegungen und fragt bei Problemen ein großes Basismodell in natürlicher Sprache um Rat. Auf Software-Workflows übertragen, führt dieser Gedanke zu einer ganz praktischen Frage: Für welche Schritte einer KI-Anwendung sollte man besser kein großes Sprachmodell aufrufen?
Der Kern dieses Artikels: Wir übertragen die Gedanken aus dem Interview auf die Gestaltung der Aufrufgrenzen in Software-Workflows. Dazu betrachten wir 5 Arten von Aufgaben, für die kein großes Sprachmodell nötig ist, stellen Kriterien für eine mehrstufige Entscheidung vor und zeigen ein Codebeispiel für das Routing, das sich direkt anpassen lässt. Dabei gilt: Roboter und Software sind unterschiedliche Systeme. Die folgende Übertragung ist eine Analogie – ob sie funktioniert, muss anhand Ihrer eigenen tatsächlichen Nutzung überprüft werden.
„Stellt mir nicht für jede Schraube eine Token-Gebühr in Rechnung“ – das Wichtigste auf einen Blick
Die Aussage stammt aus der letzten Frage des Interviews. Auf die Frage, von welcher Arbeit Roboter die Menschen befreien sollten, sagte Lai Jie klar, dass er Roboter nicht „in die Fabrik zum Schrauben“ schicken möchte. Zum einen sieht er ihren Wert in ihren vielseitigen Fähigkeiten. Zum anderen lohnt es sich aus Kostensicht nicht, bei repetitiver Arbeit für jede einzelne Bewegung eine Token-Gebühr zu zahlen.
| Informationspunkt | Details |
|---|---|
| Quelle | 15. Interview der Rubrik „Diversity Company“ von 爱范儿 |
| Veröffentlichungsdatum | 5. November 2026 |
| Interviewpartner | Lai Jie, Gründer und CEO von 星尘智能 und ehemaliger Mitarbeiter Nummer 1 des Tencent-Robotiklabors Robotics X |
| Kernaussage | Wiederkehrende Bewegungen sollten fest programmiert werden, statt jedes Mal eine Token-Gebühr zu zahlen |
| Arbeitsteilung | Ein Embodied-AI-Modell übernimmt die physische Ausführung und fragt bei Problemen ein grundlegendes Großes Sprachmodell in natürlicher Sprache um Rat |
| Impuls für Software | In KI-Workflows sollten die Einsatzgrenzen zwischen festen Programmen, Spezialmodellen und grundlegenden Großen Sprachmodellen klar definiert sein |
Wichtig ist: Das Interview gibt die Sicht des Gründers wieder. Der Artikel enthält weder gemessene Kostendaten noch unabhängige Prüfungen durch Dritte. Wir greifen die Logik der Arbeitsteilung auf, nicht bestimmte Schlussfolgerungen.
Lai Jies Vergleich mit dem Videoanruf bei Mama: Das große Sprachmodell liefert Kontext
Im Interview findet sich ein Vergleich, der die Aufgabenverteilung besser erklärt als das „Schraubenfestziehen“. Lai Jie sagt: Wenn er nicht kochen kann, es aber lernen möchte, ruft er seine Mutter per Video an. Sie sagt ihm dann etwa: „Gib zuerst etwas Öl in die heiße Pfanne“, muss ihm aber nicht erklären, welche Flasche das Öl enthält. Bei Fragen kann er nachhaken. Der entscheidende Punkt: Seine Mutter ergänzt das nötige Kontextwissen, aber das Öl in die Pfanne geben muss er selbst können – am anderen Ende der Leitung kann sie ihm das nicht abnehmen.
Auf Roboter übertragen heißt das: Das verkörperte Modell muss physische Parameter wie Gewicht, Griffkraft und einen sicheren Halt selbst wahrnehmen. Nur bei Fragen wie „Ich bekomme es nicht richtig zu fassen, es ist etwas instabil – was soll ich tun?“ wendet es sich an das große Basissprachmodell. Lai Jie zufolge wäre es zwar möglich, auch taktile Informationen in das Training des großen Basissprachmodells einzubeziehen, „aber die Kosten wären unangemessen und auch die Kommunikationsbandbreite wäre ein Problem“. Er ergänzt, dass es sich nicht um eine einfache Schichtung handelt, sondern eher um einen agentenbasierten Ansatz nach dem Vorbild von Ameisen: Die einzelnen Agenten müssen nicht besonders leistungsfähig sein, zusammen können sie aber viel erreichen.
| Rolle im Robotersystem | Aufgabe laut Interview | Entsprechende Rolle im Software-Workflow |
|---|---|---|
| Festes Programm | Rund um die Uhr Schrauben festziehen | Regel-Engine, reguläre Ausdrücke, Skripte, Datenbankabfragen |
| Verkörpertes Modell | Physische Ausführung, Wahrnehmung von Parametern, Übersetzung des Zustands in natürliche Sprache | Spezialisierte kleine Modelle für Klassifizierung, Extraktion und Vektorsuche |
| Großes Basissprachmodell | Kontextwissen ergänzen, Lösungen für schwierige Fälle liefern | Komplexes Schlussfolgern, offene Generierung, Entscheidungen in Ausnahmefällen |
| AOS-Betriebssystem | Fähigkeiten als Fertigkeitsmodule bündeln und mit dem großen Sprachmodell und Agenten verbinden | Workflow-Orchestrierung, Ebene für Tool-Aufrufe, Router |
Diese Zuordnung ist eine Ableitung dieses Artikels und kein wörtliches Zitat aus dem Interview. Bei Robotern spielen die Echtzeitsteuerung in der physischen Welt und die begrenzte Kommunikationsbandbreite eine Rolle. Software-Workflows unterliegen dagegen stärker den Einschränkungen durch Token-Abrechnung, Latenz und Stabilität. Die Engpässe sind also nicht vollständig vergleichbar.
Wo KI-Anwendungen kein großes Sprachmodell aufrufen sollten: 5 Entscheidungskriterien
Viele Teams überlassen in der ersten Version ihres Agenten jeden Schritt einem großen Sprachmodell: Es soll Formate prüfen, Datumsangaben umwandeln und sogar per Eingabeaufforderung feststellen, ob ein Feld leer ist. In der Prototypenphase geht das schnell. Im Produktivbetrieb zahlt man jedoch bei jeder Anfrage für deterministische Aufgaben und bringt zudem unnötige Zufälligkeit ins Spiel.
Nach dem Prinzip „Schrauben eindrehen“ helfen die folgenden fünf Kriterien bei der Entscheidung, ob sich ein Modellaufruf für einen Arbeitsschritt lohnt.
| Entscheidungskriterium | Eher festes Programm | Eher spezialisiertes Modell | Eher großes Basismodell |
|---|---|---|---|
| Sind die Eingaben strukturiert? | Feste Felder, klares Format | Teilstrukturierter Text | Offene natürliche Sprache |
| Ist die Ausgabe eindeutig? | Eine einzige richtige Antwort | Begrenzte Anzahl von Kategorien | Mehrere sinnvolle Antworten |
| Lassen sich die Regeln vollständig erfassen? | Als if/else formulierbar | Viele Regeln, aber stabile Muster | Regeln lassen sich nicht vollständig erfassen |
| Wie schwer wiegen Fehler? | Fehlerfreiheit erforderlich | Wenige Fehler akzeptabel, mit Nachprüfung | Umfassende Abwägung nötig |
| Wie häufig erfolgt der Aufruf? | Sehr häufig, bei jeder Ausführung | Häufig | Selten, nach Bedarf |
„Schrauben-Aufgaben“ für feste Programme
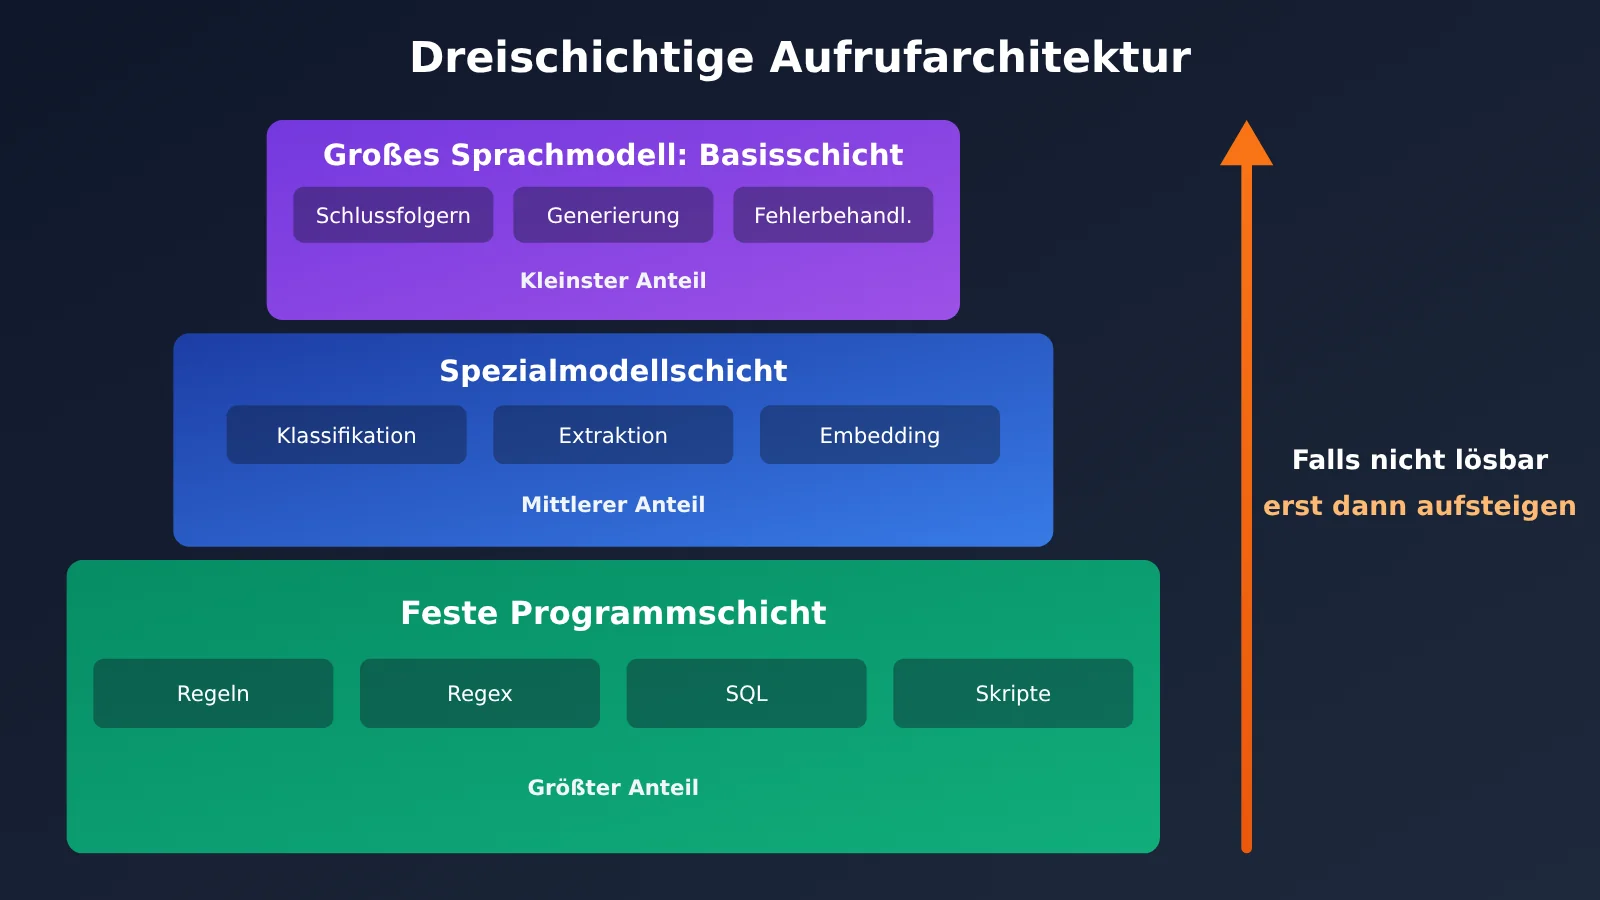
Die folgenden Aufgaben sind typische Beispiele fürs „Schrauben eindrehen“: Sie sind gut vorhersehbar und wiederholen sich häufig. Ein großes Sprachmodell würde hier die Zuverlässigkeit eher verringern:
- Formatprüfung und Bereinigung: E-Mail-Adressen, Telefonnummern, JSON-Strukturen und Pflichtfelder lassen sich mit regulären Ausdrücken und Schema-Validierung prüfen.
- Datenabfragen und Berechnungen: Bestellstatus, Lagerbestände und Gesamtbeträge sollten direkt aus der Datenbank oder über eine Geschäftsschnittstelle abgerufen werden. Ein großes Sprachmodell sollte sie nicht „berechnen“.
- Ausgaben nach festen Vorlagen: Für SMS-Benachrichtigungen, Standardbestätigungen und Tabellenüberschriften genügt eine Template-Engine, die Variablen einsetzt.
- Ablaufsteuerung und Wiederholungsversuche: Verzweigungen, Wiederholungen nach Timeouts sowie Ratenbegrenzung und Warteschlangen gehören zur Orchestrierungslogik. Dafür braucht es kein Modell.
- Häufige Cache-Treffer: Wird dieselbe Frage immer wieder gestellt, sollte zuerst der Cache oder die FAQ-Sammlung geprüft werden. Bei einem Treffer wird die Antwort direkt zurückgegeben.
Aufgaben, die wirklich das Urteilsvermögen eines großen Sprachmodells brauchen
Ein großes Basismodell lohnt sich dagegen für „Fragen, die nur Mama am anderen Ende der Leitung beantworten kann“: wenn eine unklare Nutzerabsicht geklärt werden muss, aus mehreren Quellen eine Schlussfolgerung zu formulieren ist, ein Ausnahmefall von den Regeln nicht abgedeckt wird oder kreative Inhalte gefragt sind. Gemeinsam haben diese Aufgaben: Es gibt keine eindeutige Antwort, die Regeln lassen sich nicht vollständig erfassen und sie treten vergleichsweise selten auf.
Spezialisierte Modelle liegen dazwischen. Aufgaben wie Absichtsklassifizierung, Entitätsextraktion, Stimmungsanalyse und Textvektorisierung können oft kleinere Modelle übernehmen. Man kann sie sich als Softwareversion eines „verkörperten Modells“ vorstellen: Es erledigt selbst, was es kann, und gibt Fälle, die es nicht bewältigt, als klar formulierte Frage an die nächsthöhere Ebene weiter.
Beispiel für ein mehrschichtiges KI-Workflow-Design: Unnötige Aufrufe großer Sprachmodelle vermeiden
Am Beispiel eines typischen Workflows zur automatischen Bearbeitung von Kundenservice-Tickets zeigen wir, wie sich die Grenzen für Modellaufrufe in konkrete Schritte übersetzen lassen. Es handelt sich um ein Designbeispiel, nicht um Messdaten aus einem realen Projekt.
| Workflow-Schritt | Zuständige Ebene | Verarbeitung | Token-Verbrauch |
|---|---|---|---|
| Ticketfelder validieren | Festes Programm | Schema validieren, bei fehlenden Feldern direkt zurückweisen | Nein |
| Bestell- und Lieferstatus abfragen | Festes Programm | Datenbankschnittstelle des Geschäftssystems aufrufen | Nein |
| Häufige Fragen zuordnen | Festes Programm / spezialisiertes Modell | Zuerst Schlüsselwortregeln, bei Bedarf Vektorsuche | Gering |
| Anliegen klassifizieren | Spezialisiertes Modell | Kleines Modell gibt eine von wenigen festgelegten Kategorien aus | Gering |
| Komplexe Beschwerden und Ausnahmefälle bearbeiten | Großes Basissprachmodell | Handlungsvorschläge unter Einbeziehung des Bestellkontexts erzeugen | Ja |
| Antwortvorlage ausfüllen | Festes Programm | Template-Engine gibt den endgültigen Text aus | Nein |
Wie man sieht, ist nur bei einem der sechs Schritte der Aufruf eines großen Basissprachmodells nötig. Wie viele Token sich tatsächlich einsparen lassen, ob die Erfolgsquote sinkt und wie sich die Latenz verändert, hängt von der Zusammensetzung der Anfragen und der Abdeckung durch die Regeln ab. Das muss anhand tatsächlicher Protokolldaten ausgewertet werden.
Minimalbeispiel: Regeln zuerst, Modell als Fallback
Der folgende Code zeigt einen einfachen Ansatz für gestuftes Routing: Zunächst fangen Regeln „Schrauben“-Anfragen ab. Anschließend klassifiziert ein kleines Modell die Anfrage. Nur bei komplexen Fällen kommt ein Großes Sprachmodell zum Einsatz. Die Modellnamen dienen lediglich als Beispiele. Welche Modelle tatsächlich verfügbar sind, entnehmen Sie bitte der Modellliste der Plattform.
import re
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-kompatible Schnittstelle von APIYI
)

def handle(query: str) -> str:
    # Erste Stufe: Feste Programmlogik; kein Modellaufruf, wenn Regeln ausreichen
    if re.search(r"(订单号|单号)\s*[::]?\s*\d{8,}", query):
        return "已为您查询订单状态(走业务接口,不消耗 token)"
    # Zweite Stufe: Ein kleines Modell klassifiziert die Absicht
    intent = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": f"只输出类别(咨询/投诉/其他):{query}"}],
        max_tokens=5,
    ).choices[0].message.content.strip()
    if intent != "投诉":
        return f"已归类为:{intent},转入标准流程"
    # Dritte Stufe: Nur bei komplexen Beschwerden das Große Sprachmodell aufrufen
    return client.chat.completions.create(
        model="claude-sonnet-4",
        messages=[{"role": "user", "content": f"请给出投诉处理建议:{query}"}],
    ).choices[0].message.content
Vollständige Implementierung mit Nutzungsprotokollierung anzeigen
import re
import time
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SMALL_MODEL = "gpt-4o-mini"       # Beispiel: kleines Modell für Klassifizierung und Extraktion
LARGE_MODEL = "claude-sonnet-4"   # Beispiel: großes Sprachmodell für komplexe Schlussfolgerungen

@dataclass
class UsageLog:
    records: list = field(default_factory=list)

    def add(self, layer: str, tokens: int, latency: float):
        self.records.append({"layer": layer, "tokens": tokens, "latency": latency})

    def summary(self):
        result = {}
        for r in self.records:
            s = result.setdefault(r["layer"], {"count": 0, "tokens": 0, "latency": 0.0})
            s["count"] += 1
            s["tokens"] += r["tokens"]
            s["latency"] += r["latency"]
        return result

log = UsageLog()

RULES = [
    (re.compile(r"(订单号|单号)\s*[::]?\s*\d{8,}"), "order_lookup"),
    (re.compile(r"(营业时间|几点开门)"), "faq_hours"),
]

def rule_layer(query: str):
    for pattern, action in RULES:
        if pattern.search(query):
            return action
    return None

def call_model(model: str, prompt: str, layer: str, max_tokens: int = 512) -> str:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=max_tokens,
    )
    tokens = resp.usage.total_tokens if resp.usage else 0
    log.add(layer, tokens, time.time() - start)
    return resp.choices[0].message.content.strip()

def handle(query: str) -> str:
    start = time.time()
    action = rule_layer(query)
    if action:
        log.add("rule", 0, time.time() - start)
        return f"[规则层] 执行动作:{action}"

    intent = call_model(
        SMALL_MODEL,
        f"只输出一个类别(咨询/投诉/其他),不要解释:{query}",
        layer="small",
        max_tokens=5,
    )
    if "投诉" not in intent:
        return f"[专用模型层] 归类为:{intent}"

    return call_model(
        LARGE_MODEL,
        f"你是资深客服主管,请针对以下投诉给出处理建议:{query}",
        layer="large",
    )

if __name__ == "__main__":
    for q in ["订单号:2026110612345 到哪了", "你们营业时间是?", "收到的商品破损,客服一直不回复"]:
        print(handle(q))
    print(log.summary())
🚀 Tipp für den schnellen Einstieg: Für aussagekräftige Ergebnisse beim mehrstufigen Routing ist es wichtig, über dieselbe Schnittstelle zwischen den Modellen der einzelnen Ebenen zu wechseln und den Verbrauch zu erfassen. Mit APIYI auf apiyi.com können Sie kleine und große Modelle über denselben API-Schlüssel aufrufen und den Token-Verbrauch der Ebenen anhand der Nutzungsstatistik vergleichen. Neue Nutzer können einen Prototyp zunächst mit dem kostenlosen Testguthaben prüfen.
Auswirkungen des Prinzips „Nicht für jede festgezogene Schraube Token-Gebühren zahlen“
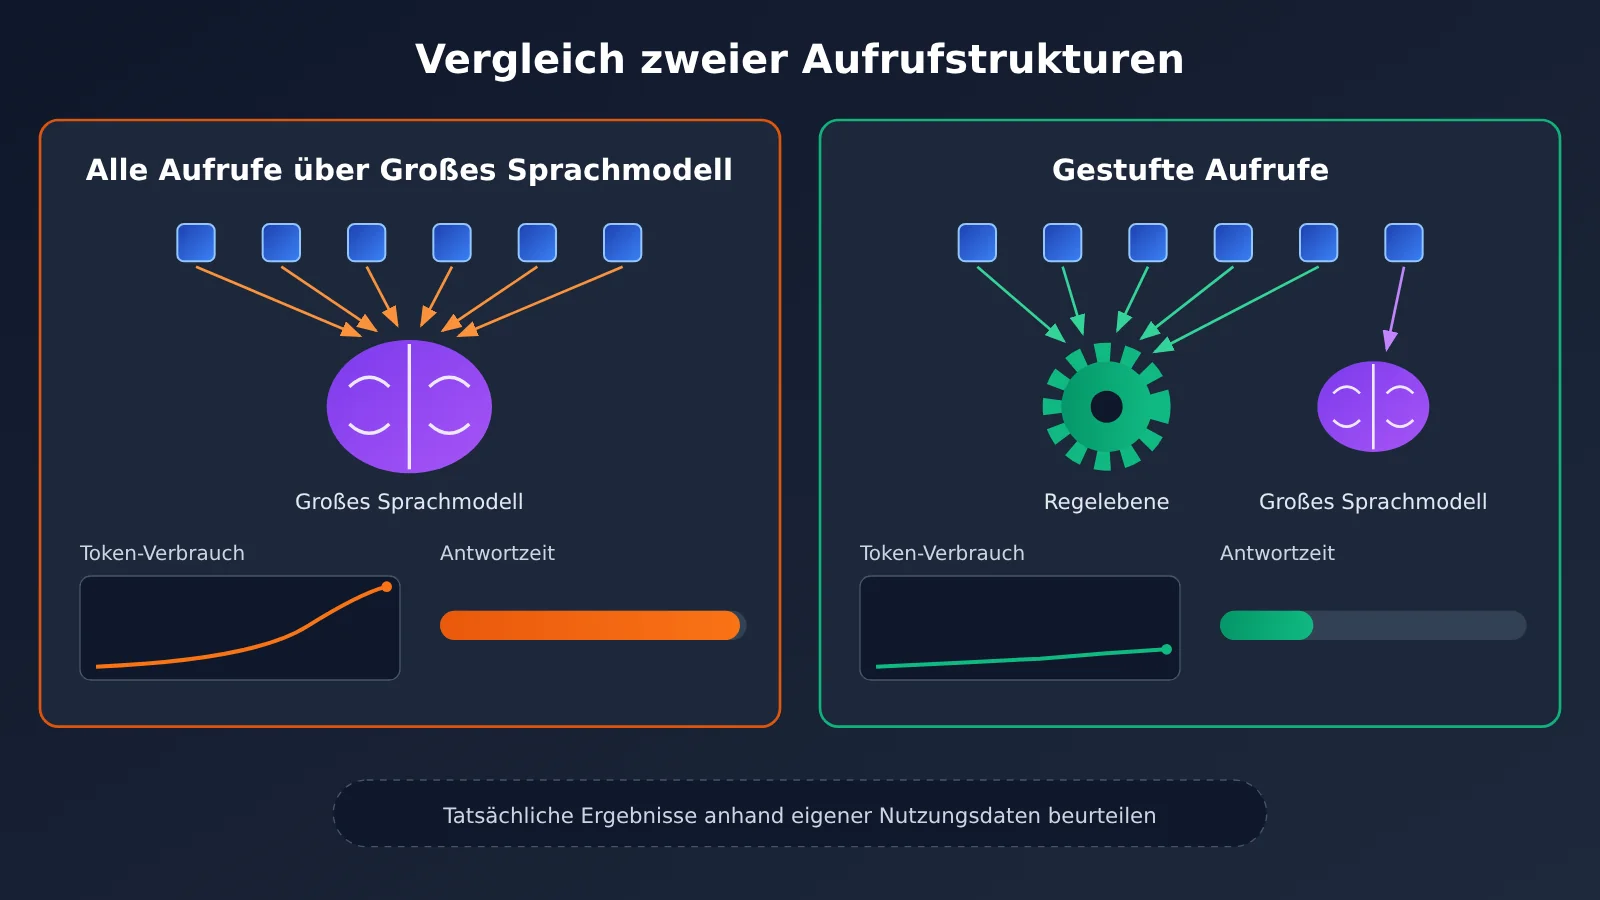
Die Grafik zeigt den strukturellen Unterschied zwischen den beiden Ansätzen, keine gemessenen Werte. Für einen konkreten Vergleich empfiehlt es sich, beide Varianten mit demselben Satz an Anfragen über APIYI apiyi.com auszuführen und die Ergebnisse anhand der Nutzungsdaten auszuwerten.
| Vergleichskriterium | Großes Sprachmodell für jeden Schritt | Gestaffelte Aufrufe | Verfügbare Plattformen |
|---|---|---|---|
| Entwicklungsgeschwindigkeit | Schnellster Weg zum Prototyp: Eine Eingabeaufforderung genügt | Regeln und Routing müssen zusätzlich ausgearbeitet werden | APIYI apiyi.com, offizielle APIs verschiedener Anbieter |
| Token-Verbrauch | Für jeden Schritt fallen Kosten an | Kosten fallen hauptsächlich für schwierige Schritte an | Wie oben |
| Determinismus der Ergebnisse | Auch bei deterministischen Aufgaben sind zufällige Abweichungen möglich | Ergebnisse der Regelebene sind vorhersehbar | Wie oben |
| Antwortlatenz | Bei jedem Schritt muss auf die Modellgenerierung gewartet werden | Die Regelebene liefert Ergebnisse nahezu sofort | Wie oben |
| Wartungsaufwand | Eingabeaufforderungen werden immer länger | Regeln müssen an geschäftliche Änderungen angepasst werden | Wie oben |
Auswirkungen auf Workflow-Entwickler und Entwicklerinnen
- Die Reihenfolge beim Entwurf kehrt sich um: Statt „erst ein großes Sprachmodell anbinden und dann nach Einsparmöglichkeiten suchen“ werden zunächst alle Schritte aufgelistet. Anschließend wird markiert, welche davon „Schrauben“ sind, und entschieden, wo das Modell zum Einsatz kommt.
- Die Rolle spezialisierter Modelle wird wichtiger: So wie ein Embodiment-Modell physische Zustände in natürliche Sprache übersetzt, bereitet eine Zwischenschicht unklare Eingaben als strukturierte Probleme auf. Dadurch wird jeder Aufruf des großen Sprachmodells zielgerichteter.
- Beobachtbarkeit wird unverzichtbar: Nach der Aufteilung in Ebenen müssen Aufrufzahlen, Token-Verbrauch und Latenz pro Ebene erfasst werden. Sonst lässt sich nicht beurteilen, ob Aufgaben auf eine höhere oder tiefere Ebene verlagert werden sollten.
Auswirkungen auf Produktverantwortliche
- Das Kostenmodell wird besser planbar: Deterministische Schritte verbrauchen keine Token; die Kosten konzentrieren sich hauptsächlich auf schwierige Anfragen, deren Umfang sich abschätzen lässt.
- „Intelligenter“ ist nicht immer besser: Eine Bestellabfrage einem großen Sprachmodell zu überlassen, wirkt vielleicht intelligenter. Nutzer brauchen aber vor allem eine korrekte und schnelle Antwort.
- Die Kriterien für die Erfolgsmessung müssen früh feststehen: Token-Verbrauch, Erfolgsquote der Aufgaben und Ende-zu-Ende-Latenz sollten vor der Einführung als Vergleichsbasis für die alte und die neue Lösung dienen.
Auswirkungen auf die Branche
Laijies Sichtweise steht für einen bestimmten Ansatz: Dass große Basismodelle immer leistungsfähiger werden, bedeutet nicht, dass alle Fähigkeiten in ein einziges Modell gepackt werden müssen. Stattdessen übernehmen „Agenten“ mit unterschiedlichen Fähigkeiten jeweils ihre eigenen Aufgaben. Im Softwarebereich passt das zur Entwicklung von Tool-Aufrufen und Agent-Orchestrierung. Das Interview behandelte allerdings Robotik-Szenarien. Wie groß der Nutzen dieses Ansatzes für Software-Workflows ist, lässt sich mangels öffentlich zugänglicher Fallbeispiele noch nicht beziffern. Dafür braucht es Erfahrungen aus der Praxis weiterer Teams.
Häufig gestellte Fragen (FAQ)
Q1: Was bedeutet „Berechnet mir nicht für jede eingedrehte Schraube eine Token-Gebühr“?
Das sagte Lai Jie, Gründer von Stardust Intelligence, in einem Interview mit Ai Faner im November 2026. Seiner Ansicht nach sollten fest programmierte Abläufe repetitive Aufgaben wie das Eindrehen von Schrauben in Fabriken rund um die Uhr übernehmen. Stattdessen für jede einzelne Bewegung ein Modell aufzurufen und Token-Gebühren zu zahlen, hält er für unnötig. Auf KI-Anwendungen übertragen heißt das: Für deterministische, häufig wiederkehrende Schritte sollte kein großes Sprachmodell aufgerufen werden.
Q2: Lässt sich der mehrstufige Ansatz aus der Robotik direkt auf Software-Workflows übertragen?
Nicht eins zu eins. In der Robotik spielen Echtzeitsteuerung, taktile Wahrnehmung und Kommunikationsbandbreite eine Rolle. Bei Software-Workflows sind dagegen vor allem Token-Kosten, Latenz und Stabilität entscheidend. Übernehmen lässt sich die Arbeitsteilung: Die Ausführungsebene erledigt einfache Aufgaben selbst und gibt schwierige Probleme an eine höhere Ebene weiter. Welchen Nutzen das bringt, muss anhand konkreter Fälle überprüft werden.
Q3: Woran erkenne ich, ob ich für einen Schritt ein kleines oder ein großes Sprachmodell einsetzen sollte?
Entscheidend ist, ob die möglichen Ausgaben begrenzt und die Regeln stabil sind. Bei Aufgaben mit einer begrenzten Zahl von Kategorien und stabilen Mustern, etwa Intent-Klassifikation oder Feldextraktion, lohnt sich zunächst der Versuch mit einem kleinen Modell. Aufgaben, die komplexes Schlussfolgern, offene Generierung oder den Umgang mit Ausnahmefällen erfordern, gehen an ein großes Sprachmodell. Testen Sie am besten auf APIYI apiyi.com verschiedene Modelle mit denselben Beispielen und vergleichen Sie Genauigkeit und Verbrauch, bevor Sie sich entscheiden.
Q4: Senkt eine Aufteilung in Ebenen immer die Kosten?
Nicht unbedingt. Wenn die meisten Anfragen bereits komplexe Probleme betreffen und die Regelebene nur wenige davon abfangen kann, fällt der Nutzen gering aus. Sind die Regeln zu weit gefasst und fangen Anfragen fälschlich ab, kann sogar die Erfolgsquote sinken. Erfassen Sie daher zuerst den Ist-Zustand und vergleichen Sie anschließend Token-Verbrauch, Erfolgsquote und Latenz vor und nach der Aufteilung.
Q5: Wie lässt sich schnell ein Prototyp für Modellaufrufe über mehrere Ebenen erstellen?
Gehen Sie dazu wie folgt vor:
1. Listen Sie alle Schritte des Workflows auf, markieren Sie „Schrauben“-Aufgaben und setzen Sie diese mit Regeln um.
2. Registrieren Sie sich bei APIYI apiyi.com, holen Sie sich einen API-Schlüssel und binden Sie über eine OpenAI-kompatible Schnittstelle sowohl ein kleines als auch ein großes Sprachmodell an.
3. Orientieren Sie sich am Code in diesem Artikel, um das Routing umzusetzen, und erfassen Sie Token-Verbrauch und Latenz je Ebene.
Der Vorteil der einheitlichen Schnittstelle: Zum Wechseln des Modells müssen Sie nur den Parameter `model` ändern. Das erleichtert wiederholte Vergleiche.
Q6: Welche häufigen Fallstricke gibt es bei einer mehrstufigen Architektur?
– **Ausufernde Regeln**: Es kommen immer mehr Regeln hinzu, bis sie schwerer zu pflegen sind als die Eingabeaufforderung. Räumen Sie deshalb regelmässig auf.
– **Informationsverlust zwischen Ebenen**: Gibt das kleine Modell nach der Klassifikation den Kontext nicht an das grosse Sprachmodell weiter, muss dieses den Sachverhalt erneut erfassen.
– **Fehlende Rückfallebene**: Können weder die Regeln noch das kleine Modell eine Entscheidung treffen, sollte eine Weiterleitung an ein grosses Sprachmodell oder einen Menschen möglich sein.
„Nicht für jede angezogene Schraube Token-Gebühren verlangen“ – die wichtigsten Punkte
- Quelle der Aussage: Die Einschätzung stammt aus einem Interview von Aifaner mit Lai Jie von Stardust Intelligence im November 2026 und gibt die Sicht des Gründers wieder.
- Arbeitsteilung: Die Ausführungsebene erledigt Aktionen selbst und fragt nur bei schwierigen Problemen ein großes Basissprachmodell nach zusätzlichem Kontext.
- Fünf Arten von „Schrauben“: Für Formatprüfung, Datenabfragen, Vorlagenausgaben, Ablaufsteuerung und Cache-Treffer sollte kein großes Sprachmodell aufgerufen werden.
- Drei Ebenen: Feste Programme bilden die Grundlage, spezialisierte Modelle übernehmen die mittlere Ebene und ein großes Basissprachmodell bearbeitet nur offene Fragen und Ausnahmefälle.
- Grenzen des Vergleichs: Erkenntnisse aus der Robotik lassen sich nicht direkt auf Software übertragen. Der Nutzen muss anhand eigener Daten geprüft werden.
- Drei Kennzahlen zur Prüfung: Vergleichen Sie vor und nach der Aufteilung Token-Verbrauch, Erfolgsquote und Ende-zu-Ende-Latenz.
- So gelingt der Einstieg: Über die einheitliche Schnittstelle von APIYI apiyi.com lassen sich Modelle für die einzelnen Ebenen wechseln und ihr Verbrauch beobachten.
Zusammenfassung
Die Aussage „Nicht für jede angezogene Schraube Token-Gebühren verlangen“ erinnert uns daran, die Aufrufgrenzen in KI-Workflows zu überdenken:
- Zuerst die Schrauben erkennen: Schritte, die häufig vorkommen, weitgehend deterministisch sind und eine eindeutige Antwort haben, gehören in feste Programme.
- Dann spezialisierte Modelle einsetzen: Kleine Modelle übernehmen Aufgaben mit begrenzten Kategorien und stabilen Mustern und bereiten Fragen auf.
- Erst zuletzt das große Sprachmodell nutzen: Offenes Schlussfolgern, Entscheidungen in Ausnahmefällen und kreative Generierung sind Aufgaben, für die sich Token-Gebühren lohnen.
Dieser Ansatz ist weder an ein bestimmtes Modell noch an eine einzelne Veröffentlichung gebunden und eignet sich dauerhaft als Checkliste für das Agent-Design. Prüfen Sie bei der Umsetzung unbedingt anhand Ihrer eigenen Geschäftsprotokolle, was sich durch die Aufteilung verändert – statt einfach anzunehmen, dass die Kosten sinken.
Wenn Sie einen mehrstufigen Workflow entwickeln, können Sie über APIYI apiyi.com mit einem API-Schlüssel auf Modelle verschiedener Leistungsklassen zugreifen, diese auf den einzelnen Ebenen flexibel wechseln und die Nutzungsstatistiken vergleichen. So entscheiden Sie anhand von Daten, wer welche „Schraube“ anzieht.
📚 Referenzen
- 爱范儿 – Gespräch mit Lai Jie von Stardust Intelligence: Das 15. Interview der Reihe „多样性公司“
- Link:
ifanr.com/1687805 -
Hinweis: Ursprüngliche Quelle für den Vergleich zwischen „Schrauben eindrehen und Token-Kosten“ sowie für den Ansatz zur Aufgabenverteilung zwischen Embodied-AI-Modellen und großen Sprachmodellen
-
OpenAI-Dokumentation zur Chat-Completions-Schnittstelle: Beschreibung der Parameter für OpenAI-kompatible Schnittstellen
- Link:
platform.openai.com/docs/api-reference/chat - Hinweis: Hilft beim Verständnis von Feldern wie
model,max_tokensundusage, um die Nutzung nach Ebenen zu erfassen
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI. Weitere Informationen zur Modelleinbindung und Nutzungsstatistik finden Sie im Dokumentationszentrum von APIYI.




