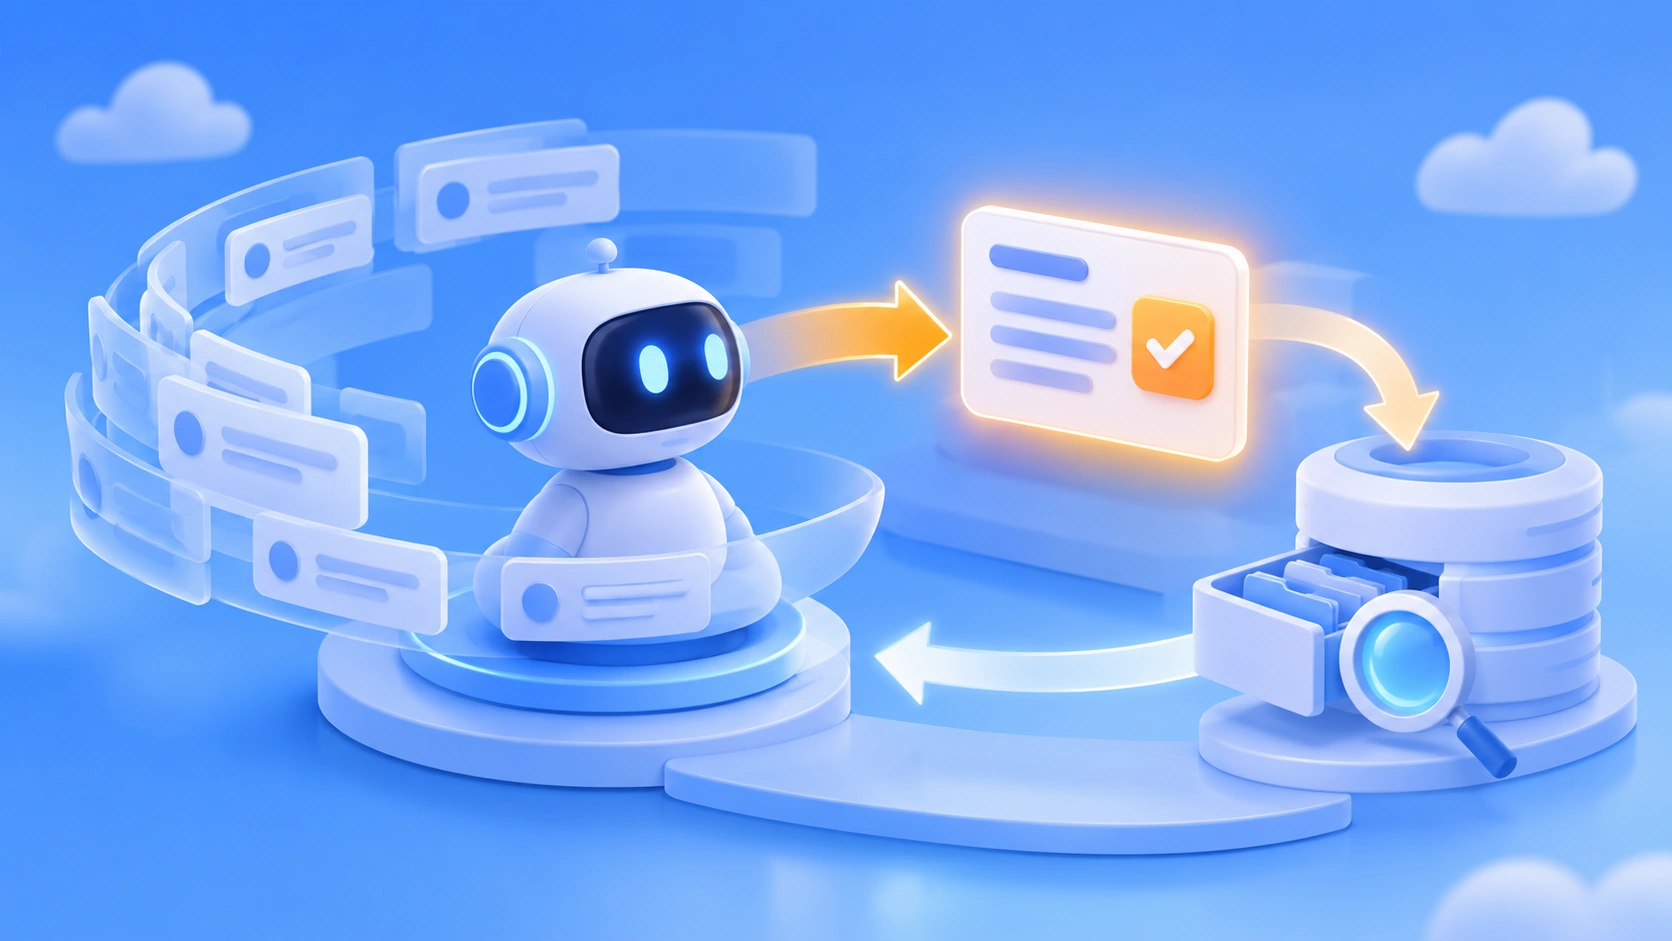
作者注:openJiuwen WorkSwarmのコンテキスト切り替え機構を例に、「引き継ぎサマリー+アーカイブ検索」パターンを解説します。長時間稼働するエージェントがコンテキストウィンドウの上限に近づいたときの設計上の選択肢とトレードオフを整理します。
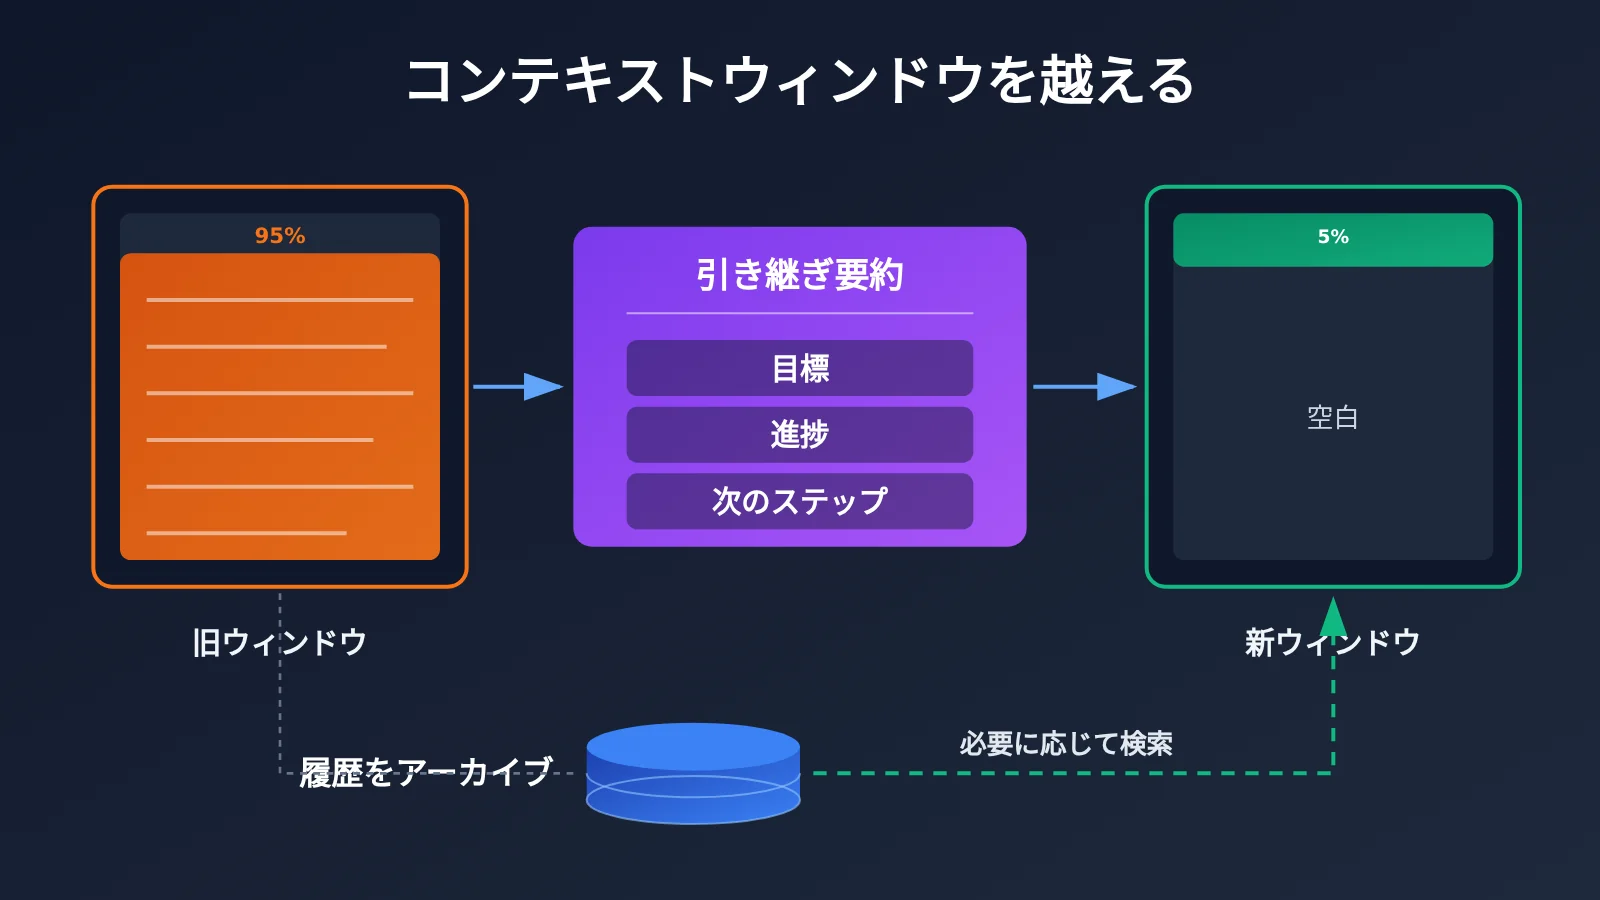
Huaweiが支援するオープンソースのエージェントコミュニティ、openJiuwenが先日、Hyper-Agentクラスタアーキテクチャを公開しました。その中に、開発者が注目したい仕組みがあります。エージェントのコンテキストウィンドウが上限に近づくと、目標・進捗・次のステップをまとめた引き継ぎサマリーを持って新しいウィンドウに切り替え、詳細が必要になったときにアーカイブされた履歴を検索します。一文で説明できる仕組みですが、その背後には、長時間稼働するエージェントすべてが直面するエンジニアリング上の課題があります。
これは単なる噂ではありません。この機能はopenJiuwen WorkSwarmの一部として公開されており、コードはJiuwenSwarmという名前でGitHub上にオープンソースとして公開されています。この記事では、この仕組みを例に、引き継ぎサマリーに何を含めるべきか、いつ切り替えを発動するか、いつアーカイブを参照するかという3つの設計課題を掘り下げます。また、「より長いコンテキストに頼る」方法と「サマリーによる引き継ぎ+検索」のトレードオフも比較します。
この記事で得られること:ご自身のエージェントアプリケーションに照らし合わせながら、コンテキストウィンドウの上限に対処するための選択肢と、それぞれのリスクを整理できます。
引き継ぎ要約とアーカイブ検索:主要ポイント
まず、参考資料から確認できる事実を整理し、開発者にとって何を意味するのかを見ていきます。下表の情報はいずれも公開報道に基づいています。報道で確認できない実装の詳細については、後ほど明記します。
| 項目 | 詳細 |
|---|---|
| 発表元 | openJiuwen、Huawei が支援するオープンソースのエージェントコミュニティ |
| 発表内容 | Hyper-Agent クラスターアーキテクチャ。その機能は openJiuwen WorkSwarm で実装 |
| オープンソースの状況 | JiuwenSwarm の名称で GitHub 上にコードを公開 |
| 主な変化 | 永続的エージェント(Persistent Agent)が自身のアイデンティティと状態を保持し、セッションはシステムがスケジューリングする基盤リソースになる |
| コンテキストの仕組み | ウィンドウが上限に近づくと新しいウィンドウに切り替え、「目標・進捗・次のステップ」の引き継ぎ要約を渡す。詳細が必要なときはアーカイブ履歴を検索する |
| 報道時期 | 2026 年 11 月初旬 |
なぜ永続的エージェントにはコンテキストウィンドウの上限への対処が必要なのか
WorkSwarm は、エージェントを単一のチャットセッションから切り離し、「デジタル従業員」として飛書や釘釘などの業務グループに常駐させる設計です。同じエージェントが複数の外部グループチャットで複数のタスクを追跡し、あるチャネルで依頼を受け、別のチャネルで成果を届けられます。システムはゲートウェイを介してインスタントメッセージングアプリや Web インターフェースに接続し、AgentServer がエージェントと作業セッションをスケジューリングします。
このような形態では、コンテキストウィンドウの上限は偶発的な問題ではなく、必ず直面するものです。単発の質問に答えるチャットボットがウィンドウを使い切ることはまれですが、数日間にわたってプロジェクトを追跡するエージェントでは、会話履歴やツールの呼び出し結果、ファイルの内容が蓄積し続けます。報道によると、WorkSwarm のアクティビティパネルには各エージェントの token 使用量も表示されます。これは、コンテキストの消費量自体が、この種のシステムで継続的に監視すべき運用指標であることを示しています。
リソースとしてのセッション:引き継ぎ要約の前提
引き継ぎ要約の仕組みを理解する鍵は、WorkSwarm が「エージェント」と「セッション」を分離している点にあります。エージェントのアイデンティティと状態は持続する一方、セッションはシステムが割り当て、並行してスケジューリングし、コンテキストを引き継いで再開できるリソースです。セッションを置き換えられるからこそ、「ウィンドウがいっぱいになったら新しいウィンドウに切り替える」という設計が自然な選択肢になります。
引き継ぎ要約の役割は、古いセッションと新しいセッションの間で、作業状態を伝えるために必要十分な情報を渡すことです。一方、アーカイブ履歴によって、古いセッションの詳細が失われずに保持されます。情報は「常にコンテキスト内にある」状態から、「必要に応じて取得する」状態に変わるのです。
引き継ぎサマリーの設計課題その1:何を含めるべきか
報道では、目標、進捗、次のステップの3要素が挙げられています。シンプルな構成ですが、実際に運用するには、それぞれをさらに細かく整理する必要があります。以下の表は、この3要素を基にまとめた設計の参考例です。エンジニアリング上の提案であり、JiuwenSwarm での実装が確認されたものではありません。
| 項目 | 含めることが推奨される内容 | 省略した場合のリスク |
|---|---|---|
| 目標 | 元のタスクの説明、成果物の要件、依頼者、提出先のチャネル | 新しいウィンドウが元の要件から逸脱したり、誤ったグループや形式で成果物を提出したりする |
| 進捗 | 完了したサブタスク、重要な決定事項とその理由 | 作業を重複したり、すでに確認済みの方針を覆したりする |
| 次のステップ | 未完了のタスク、障害となっている点、回答待ちの外部からの連絡 | タスクが停滞し、エージェントがどこから再開すればよいかわからなくなる |
| 制約(追加項目) | ユーザーが明示した禁止事項、権限の範囲、形式に関する好み | ユーザーが伝えた好みに反し、一貫した体験が損なわれる |
| インデックス(追加項目) | 重要な情報が保存されているアーカイブ内の場所やキーワード | 詳細が必要なときに検索できず、アーカイブが形骸化する |
このうち「制約」と「インデックス」は、私たちが追加した2項目です。制約が重要なのは、「レポートは1ページ以内にする」といった、ユーザーが長い会話の中で断片的に伝えた好みが、サマリーを圧縮する際に特に抜け落ちやすいためです。インデックスは、引き継ぎサマリーとアーカイブ検索をつなぐ橋渡しとなります。サマリーが短いほど、新しいウィンドウに「詳細がどこにあるか」を伝える必要があります。
WorkSwarm の場面では、複数のグループやチャネルによって生じる複雑さにも注意が必要です。報道によると、グループ間の共有にはユーザーの承認が必要で、一時的または永続的な権限を付与でき、後から取り消すこともできます。こうした権限の状態が引き継ぎサマリーに記載されていないと、新しいウィンドウのエージェントが権限の有無を誤って判断する可能性があります。この種の情報は、自由記述ではなく、構造化された項目として保存するほうが適しています。
引き継ぎ要約の設計課題2:コンテキストをいつ切り替えるか
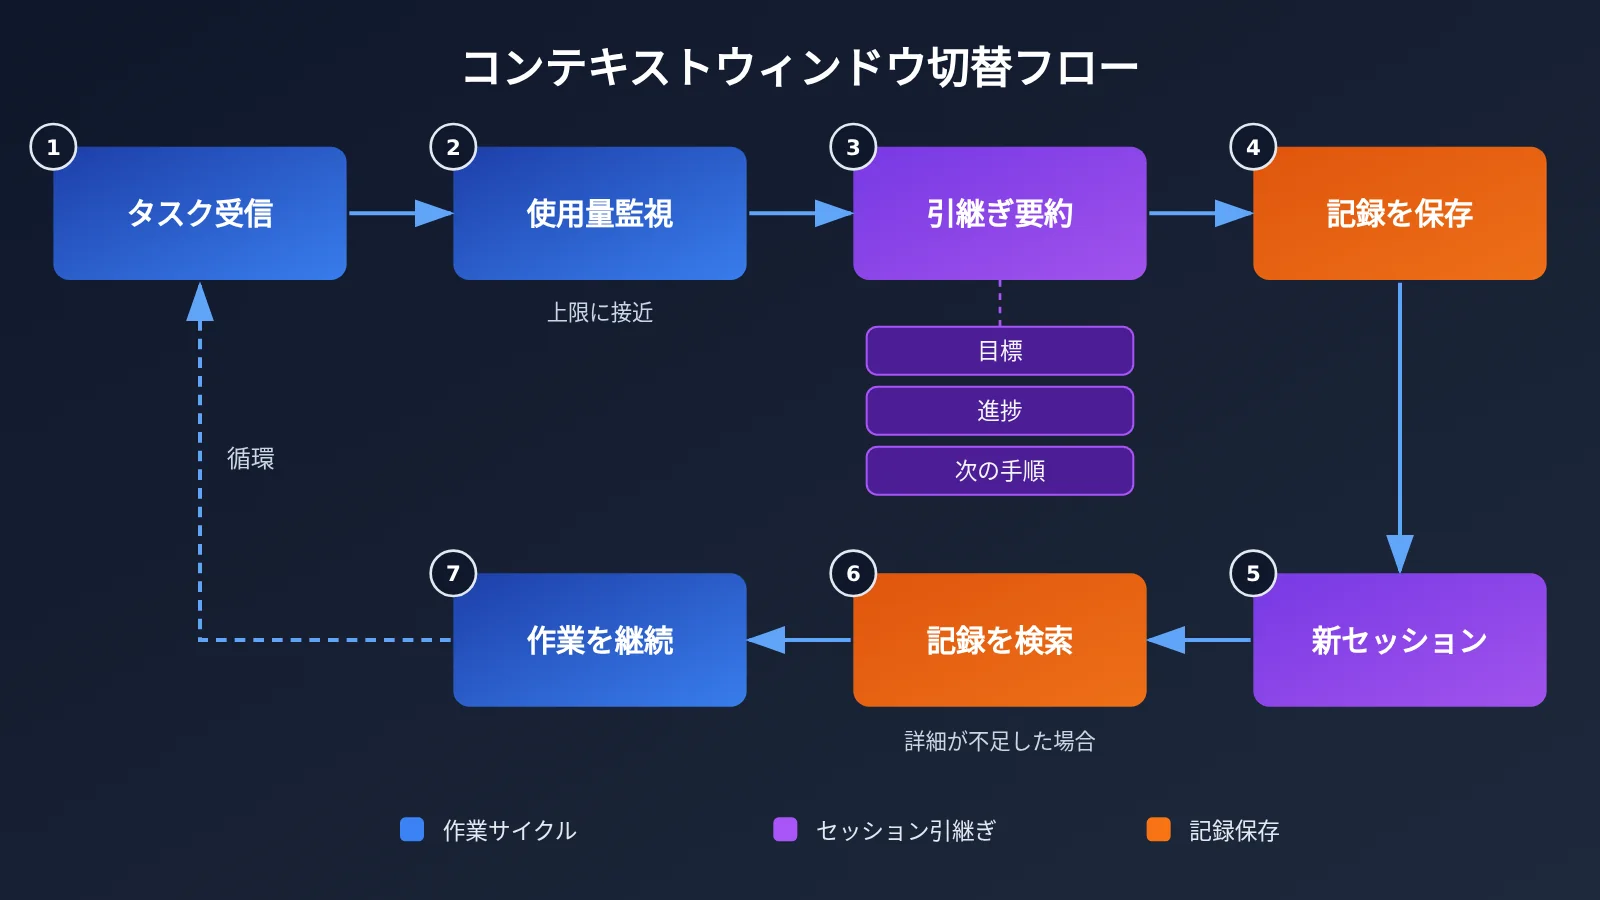
報道では「上限に近づいたとき」に切り替えると説明されているだけで、具体的なしきい値や、要約をモデルとルールのどちらで生成するかは公開資料では明らかになっていません。確認するには、JiuwenSwarmのソースコードやドキュメントを調べる必要があります。エンジニアリングの観点では、切り替えのタイミングとして通常、次のような選択肢があります。
| トリガー戦略 | 実装方法 | メリット | リスク |
|---|---|---|---|
| 固定比率のしきい値 | トークン使用量がウィンドウの一定割合に達したときに切り替える | 実装が簡単で、動作を予測しやすい | タスクの重要なステップの途中で切り替わる可能性がある |
| 予約容量のしきい値 | 次の入力と要約生成に必要な残り容量が不足するときに切り替える | 要約生成自体に必要な容量を確保できる | 次の入力の規模を見積もる必要がある |
| タスクの区切りで切り替え | サブタスクの完了時やユーザーの返信待ちなど、自然な区切りで切り替える | 要約がより完全になり、切り替えコストも低い | ウィンドウを使い切る前に区切りが訪れるとは限らない |
| ハイブリッド戦略 | タスクの区切りでの切り替えを優先し、上限しきい値を超えたら強制的に切り替える | 完全性と安全性を両立できる | ロジックが複雑になり、より多くのテストが必要になる |
特に注意したいのは、引き継ぎ要約の生成自体にもコンテキストを消費することです。ウィンドウを完全に使い切ってから切り替えを始めると、モデルが履歴を読み終え、質の高い要約を書くための容量が残っていない可能性があります。そのため、どの戦略を採用する場合でも、要約生成用に余裕を確保しておく必要があります。
要約の生成方法については、モデルによる要約は柔軟性が高く、タスクの意味を理解できます。一方、ルールによる要約(タスク一覧の状態フィールドをそのまま抽出するなど)は安定していますが、会話中の暗黙の決定を捉えるのは困難です。実践では、両者を組み合わせる方法がよく使われます。構造化された状態はプログラムで管理し、モデルは自然言語による進捗説明の補足のみを担当します。
引き継ぎ要約とアーカイブ検索を実装する:シンプルなプロトタイプ
以下は、このパターンの考え方を示すシンプルなプロトタイプです。JiuwenSwarm の実装ではありません。推定トークン使用量がしきい値に近づくと、モデルに引き継ぎ要約を生成させ、古いメッセージをアーカイブに保存します。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の OpenAI 互換インターフェース
)

HANDOFF_PROMPT = "请将以上工作记录整理为交接摘要,包含:目标、进展、下一步、约束、关键信息索引。"

def make_handoff(messages, model="gpt-4o-mini"):
    resp = client.chat.completions.create(
        model=model,
        messages=messages + [{"role": "user", "content": HANDOFF_PROMPT}]
    )
    return resp.choices[0].message.content
プロトタイプの全コードを見る(切り替え判定とアーカイブ検索を含む)
import openai
from typing import List, Dict

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MODEL = "gpt-4o-mini"
CONTEXT_LIMIT = 100_000      # サンプル値。使用するモデルの実際のウィンドウに合わせて調整
SWITCH_RATIO = 0.7           # 要約生成のための余裕を確保
HANDOFF_PROMPT = (
    "请将以上工作记录整理为交接摘要,分为五部分:"
    "1.目标 2.进展(含关键决策及理由)3.下一步 4.用户约束 5.关键信息索引(关键词列表)"
)

class LongRunningAgent:
    def __init__(self, system_prompt: str):
        self.system_prompt = system_prompt
        self.messages: List[Dict] = [{"role": "system", "content": system_prompt}]
        self.archive: List[Dict] = []   # 履歴のアーカイブ。本番環境ではデータベースやベクトルデータベースに置き換え可能

    def estimate_tokens(self) -> int:
        # 概算。本番環境では使用するモデルに対応したトークナイザーを使う
        return sum(len(m["content"]) for m in self.messages)

    def maybe_switch(self):
        if self.estimate_tokens() < CONTEXT_LIMIT * SWITCH_RATIO:
            return
        resp = client.chat.completions.create(
            model=MODEL,
            messages=self.messages + [{"role": "user", "content": HANDOFF_PROMPT}]
        )
        summary = resp.choices[0].message.content
        self.archive.extend(self.messages[1:])      # 古い会話をアーカイブに保存
        self.messages = [
            {"role": "system", "content": self.system_prompt},
            {"role": "system", "content": f"【交接摘要】\n{summary}"}
        ]

    def search_archive(self, keyword: str, top_k: int = 5) -> str:
        hits = [m["content"] for m in self.archive if keyword in m["content"]]
        return "\n---\n".join(hits[-top_k:]) or "归档中未找到相关记录"

    def chat(self, user_input: str) -> str:
        self.maybe_switch()
        self.messages.append({"role": "user", "content": user_input})
        resp = client.chat.completions.create(model=MODEL, messages=self.messages)
        answer = resp.choices[0].message.content
        self.messages.append({"role": "assistant", "content": answer})
        return answer

agent = LongRunningAgent("你是负责跟进项目周报的数字员工。")
print(agent.chat("请记录:本周报告不要超过一页。"))
このプロトタイプのアーカイブ検索は、単純なキーワードマッチングです。報道では、JiuwenSwarm がベクトル検索を使っているのか、別の方法を使っているのかは明らかにされていません。実際のプロジェクトでは、アーカイブの規模に応じて全文検索、ベクトル検索、または両者の組み合わせを選べます。また、search_archive をツールとして登録し、いつ呼び出すかをモデル自身に判断させることもできます。
🚀 クイックスタート:このようなプロトタイプを構築する際は、要約生成とメインタスクに異なるモデルを使えます。例えば、軽量モデルで要約を生成し、高性能モデルでメインタスクを処理する方法があります。APIYI apiyi.com では、1つの APIキーで OpenAI、Claude、Gemini などのモデルを呼び出せるため、同じコード内で切り替えて比較できます。新規ユーザーには無料のテスト枠もあります。
引き継ぎ要約の設計課題3:いつアーカイブ履歴を調べ直すか
アーカイブ検索は、「要約では必ず情報が失われる」という根本的な問題に対処します。どのような圧縮でも情報は失われますが、重要なのは、失われた情報を後から取り戻せるかどうかです。アーカイブを調べ直すタイミングには、大きく分けて3つの設計方針があります。
- モデルによる自律的な呼び出し:検索をツールとしてモデルに提供し、情報が不足しているとモデルが判断したときに自ら検索します。柔軟ですが、「自分が何を知らないか」をモデルが判断できるかどうかに左右されます。
- ルールによるトリガー:ユーザーが要約にないエンティティ、ファイル名、時点に言及したとき、プログラムが自動的に検索し、結果をコンテキストに追加します。制御しやすい一方、ルールでカバーできる範囲には限りがあります。
- インデックスによる案内:引き継ぎ要約に重要な情報のインデックスを残し、新しいウィンドウで関連する話題が出たときに、インデックスに従って必要な情報を正確に取得します。要約時に作成するインデックスの品質に左右されます。
私たちは、最大のリスクは「自分が何を見落としているか分からないこと」だと考えています。たとえば、要約からユーザーの好みが漏れ、新しいウィンドウにもその存在を示す手がかりがなければ、モデルは検索しようと思いつきません。これが、前述のとおり、要約に「制約」と「インデックス」のフィールドを追加することを推奨する理由です。これらがアーカイブを調べ直すための入り口になります。
長いコンテキストへの依存 vs 引き継ぎ要約:影響分析
コンテキストウィンドウの上限に直面したとき、別の選択肢として、より長いコンテキストに対応したモデルへ切り替える方法があります。2つの方法は併用できますが、それぞれ適した条件が異なります。以下の表は判断材料をまとめたもので、効果を示すデータは含まれていません。
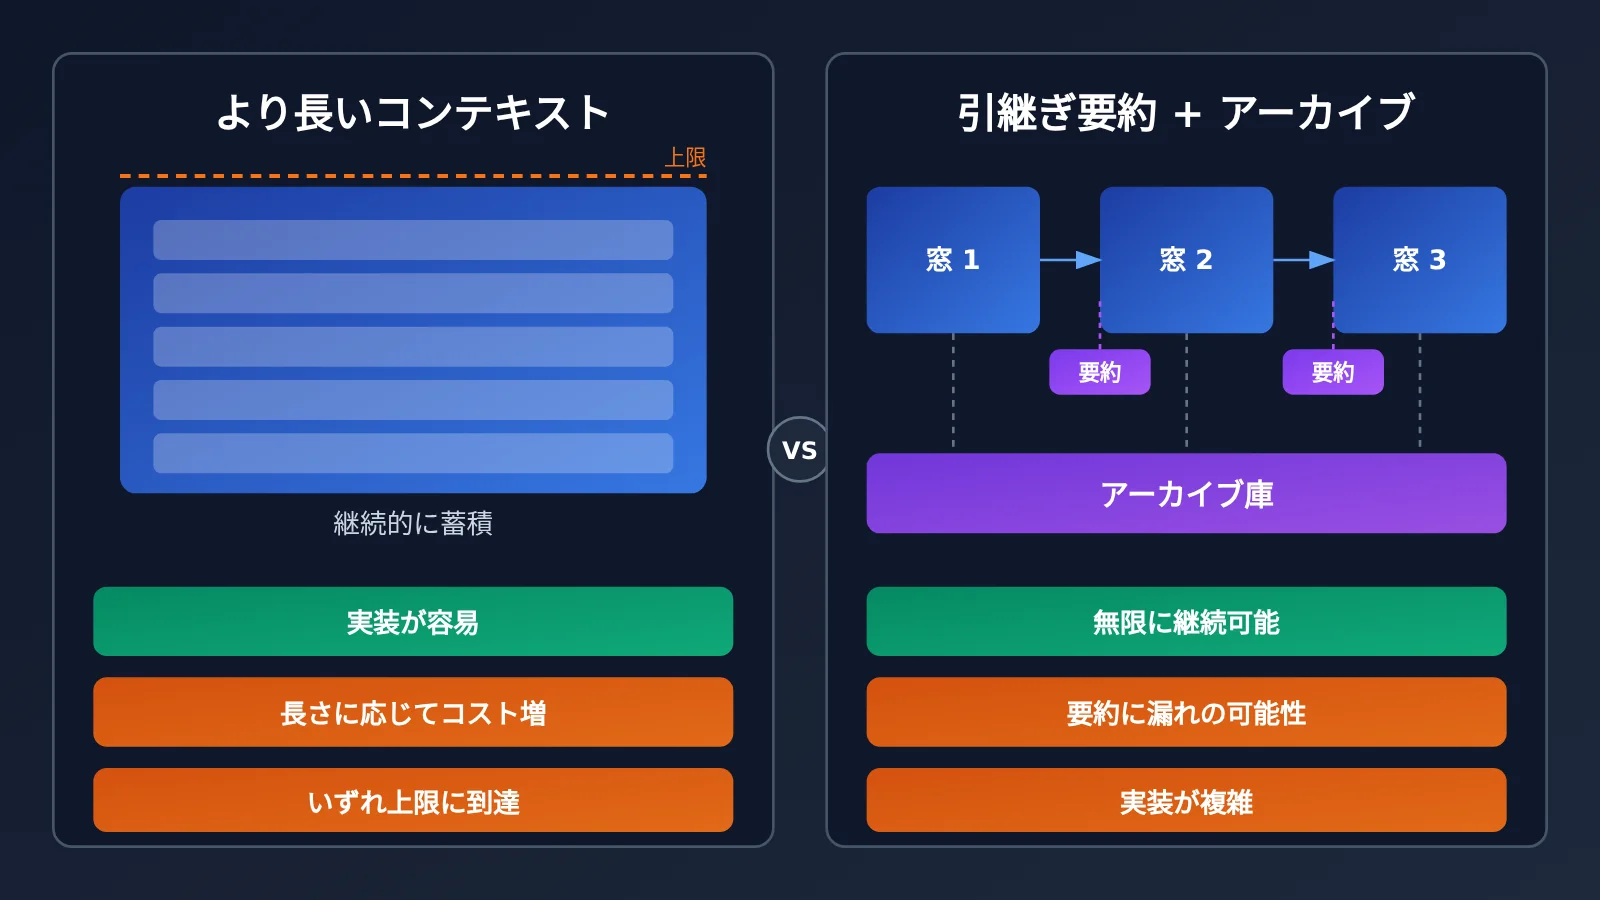
| 比較項目 | 長いコンテキストへの依存 | 引き継ぎ要約 + アーカイブ検索 |
|---|---|---|
| 実装の複雑さ | 低い。基本的に改修不要 | 高い。要約、アーカイブ、検索の3つのロジックが必要 |
| 情報の完全性 | 元の情報がすべて含まれる | 要約では情報が失われるため、検索で補う必要がある |
| タスクの継続時間 | モデルのウィンドウ仕様に制限される | 理論上は継続し続けられる |
| 1回の呼び出しコスト | 履歴が増えるにつれて上昇し続ける | 切り替えのたびに下がる |
| 主なリスク | 非常に長い入力の中で重要な情報が埋もれる | 要約で抜けた詳細を検索でも取り戻せない |
| 適した用途 | 中程度の期間で、全文の照合が必要なタスク | 数日から数週間にわたる継続的な作業 |
| 利用可能なプラットフォーム | APIYI apiyi.com などが、さまざまなコンテキストサイズのモデルを提供 | プラットフォームを問わず、どのモデルでも利用可能 |
💡 選択のヒント:タスクが通常1つの長いウィンドウ内で完了するなら、まず長いコンテキストに対応したモデルへ切り替えるほうが手軽です。一方、WorkSwarmのデジタル従業員のようにエージェントを長期間常駐させる必要があるなら、引き継ぎ要約はほぼ必須です。まずはAPIYI apiyi.com でコンテキストサイズの異なるモデルに同じタスクを実行させ、実際の使用量を確認してから、要約の仕組みを開発するかどうかを決めるとよいでしょう。
開発者への影響
- コンテキスト管理がアーキテクチャ上の課題に:WorkSwarmはセッションをスケジューリング可能なリソースとして扱っています。つまり、コンテキストの切り替えはエラー発生後の対処ではなく、システム設計の一部になります。
- 状態の明示的なモデル化が必要:引き継ぎ要約の品質は、エージェントが目標、決定事項、未完了のタスクを明確に記録しているかに左右されます。そのため、開発者は設計段階から状態の構造を計画する必要があります。
- 可観測性の重要性が高まる:WorkSwarmはアクティビティパネルにトークン使用量と応答時間を表示します。長期間稼働するエージェントでは、切り替え頻度や検索のヒット状況も監視する必要があります。
業界への影響
- セッション型から常駐型へ:エージェントの活用が「一問一答」から「長期間常駐する作業グループ」へと進むにつれ、ウィンドウをまたいでコンテキストを引き継ぐ機能は、この種の製品の基盤になります。
- オープンソースの実装が参考に:JiuwenSwarmのオープンソース化により、開発者は切り替えの閾値、要約の生成、検索の実装を直接調べられるため、ゼロから手探りで進める必要がなくなります。
よくある質問 FAQ
Q1: 「引き継ぎサマリー + アーカイブ検索」パターンとは何ですか?
長時間稼働するエージェントが、コンテキストウィンドウをまたいで作業を続けるための方法です。ウィンドウが上限に近づくと、エージェントは目標・進捗・次のステップをまとめた引き継ぎサマリーだけを持って新しいウィンドウに切り替えます。履歴全体はアーカイブされ、詳細が必要になったときに検索します。openJiuwen WorkSwarm はこの考え方を採用しています。
Q2: コンテキストの長いモデルに変更すれば解決しませんか?
中程度の長さのタスクであれば、長いコンテキストに対応したモデルに変更するのが確かに最も手軽です。ただし、長期間稼働するエージェントでは履歴が増え続けるため、どんなウィンドウもいずれ上限に達します。また、非常に長い入力の中では重要な情報が埋もれてしまう可能性もあります。まずは APIYI apiyi.com を通じて、コンテキスト長の異なるモデルで実際のタスクを試し、サマリーの仕組みが必要かどうかを判断するのがおすすめです。
Q3: WorkSwarm の切り替えしきい値とサマリーの生成方法はどうなっていますか?
現在公開されている報道では、具体的なしきい値、サマリーがモデルとルールのどちらで生成されるか、アーカイブ検索にベクトル検索とそれ以外のどちらが使われているかは明らかにされていません。こうした実装の詳細は、GitHub 上の JiuwenSwarm のオープンソースコードや公式ドキュメントで確認する必要があります。この記事での関連する議論は、一般的なエンジニアリング上の分析です。
Q4: API を使って引き継ぎサマリーの仕組みを手早く検証するにはどうすればよいですか?
以下の手順でプロトタイプを構築できます。
1. APIYI apiyi.com に登録し、APIキーと無料テスト枠を取得する
2. この記事のプロトタイプコードを使用し、base_url を `https://api.apiyi.com/v1` に設定する
3. 実際の長い会話を使ってテストし、切り替え後もエージェントが重要な制約を覚えているか確認する
Q5: このパターンにはどのような既知のリスクがありますか?
最も大きなリスクは、サマリーから詳細が抜け落ち、新しいウィンドウではそれを検索して取り戻す手がかりがなくなることです。次に、タスクの重要なステップの途中で切り替えが起こり、状態に不整合が生じるリスクがあります。また、この仕組みがタスクの品質に実際にどのような影響を与えるかについては、現時点で公開されたテストデータがありません。本番環境に導入する前に、自分の利用シーンで十分に検証しましょう。
引き継ぎサマリーとコンテキストウィンドウの要点 Key Takeaways
- 基本の仕組み:ウィンドウがいっぱいになる前に新しいウィンドウへ切り替え、目標・進捗・次のステップをまとめた引き継ぎサマリーを渡す
- 前提条件:エージェントのアイデンティティをセッションから切り離し、セッションをスケジューリング・復元可能なリソースとして扱う
- サマリーの設計:3つの要素に加え、ユーザーの制約とアーカイブのインデックスを記載して、情報の抜け漏れを防ぐ
- 切り替えのタイミング:サマリー生成用の余裕を確保し、できるだけタスクの区切りで切り替える
- アーカイブの参照:サマリーでは必ず情報が失われるため、検索手段によって情報を取り戻せるかどうかが決まる
- 方式の選択:中規模のタスクでは長いコンテキストに対応したモデルへの切り替えも有効だが、長期間稼働するタスクではサマリーによる引き継ぎがより重要になる
- 手軽な検証:APIYI apiyi.com の複数モデル統一インターフェースを使って、プロトタイプを構築・比較できる
まとめ
openJiuwen WorkSwarm のコンテキスト切り替えの仕組みは、長時間稼働するエージェントを設計するうえで参考になるモデルです。
- 引き継ぎサマリーで作業状態を伝える:目標・進捗・次のステップが最小限必要な情報です。制約とインデックスを加えると、さらに実用的になります。
- 切り替えのタイミングには余裕を持たせる:サマリーの生成自体にもコンテキストを消費するため、ウィンドウが完全に埋まるまで待つことはできません。
- アーカイブ検索で情報の欠落を補う:サマリーは「要点を覚えておく」役割に絞り、詳細は必要に応じて検索します。
エージェントを単発のセッションから長期稼働へ移行するなら、まず状態の構造を整理し、長いコンテキストに対応したモデルへ切り替えるか、引き継ぎサマリーを導入するかを検討しましょう。APIYI apiyi.com で手軽にプロトタイプを構築し、複数のモデルでサマリーの品質とコンテキスト消費量を比較するのもおすすめです。
📚 参考資料
- Pandaily の記事:openJiuwen Hyper-Agent のクラスターアーキテクチャと WorkSwarm デジタル従業員
- リンク:
pandaily.com/openjiuwen-hyper-agent-swarm-architecture-persistent-agents-workswarm-digital-employees -
概要: 永続的なエージェント、コンテキストの切り替え、引き継ぎ要約の仕組みを紹介する英語記事
-
JiuwenSwarm オープンソースコード:openJiuwen WorkSwarm のオープンソース実装
- リンク:
github.com(JiuwenSwarm で検索) - 概要: 切り替えのしきい値、要約の生成、アーカイブ検索の具体的な実装を確認できます
著者: APIYI 技術チーム
技術に関するお問い合わせ: APIYI apiyi.com のトップページからお気軽にお問い合わせください。詳しい資料は docs.apiyi.com のドキュメントセンターをご覧ください。