要約:AI動画制作はすでに、ネイティブ動画生成とAgentコードレンダリングという2つの技術ルートに分かれています。前者はリアルな映像と自然な動きが得意で、後者は精密なアニメーション、データ表現、修正可能なエンジニアリング型の制作が得意です。両者の違いを理解してこそ、効率的な動画制作ワークフローを構築できます。
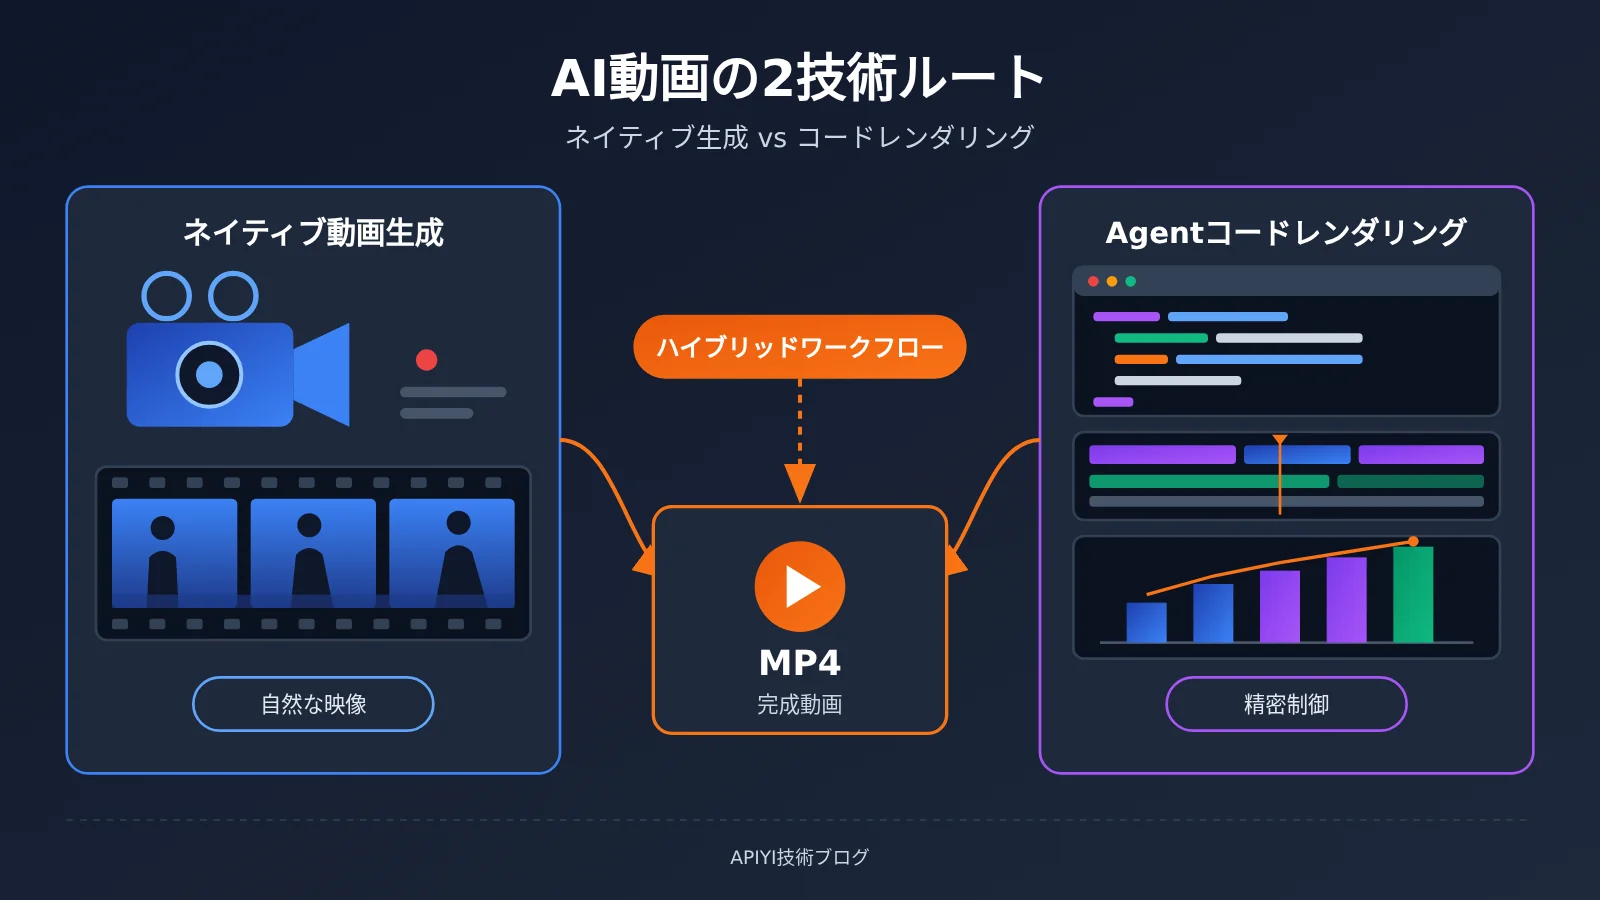
結論から先に:ネイティブ動画生成とAgentコードレンダリングは、それぞれ異なるタスクに適しています。人物、実写感、自然な動き、カメラワークはSeedance、Kling、Veoといったネイティブ動画モデルに任せ、データチャート、数式、ソフトウェアチュートリアル、価格パラメータ、テンプレート化された大量コンテンツはRemotion、Manim、FFmpegで構成されるコードレンダリングパイプラインに任せます。この2つを組み合わせれば、自然な映像と精密なコントロールを同時に手に入れられます。これが現在もっとも実用的な制作手法です。
内容の予告:以下ではまず、両ルートの出力メカニズムにおける根本的な違いを説明します。続いてネイティブ動画モデル(Seedance 2.5、Kling 4.0、Veo 3.1)とコードレンダリングツールチェーン(Remotion、Manim、FFmpeg、Claude Motion、Codex)の能力とコストをそれぞれ分解し、さらにVibeVideoBenchの独立した評価データを交えて、Agentが動画を作る実際のレベルを解説します。最後に、製品プロモーション動画を例としたハイブリッド制作フローを示し、各モデルやツールがそれぞれどの工程を担うのかを説明します。
To Know:AI動画技術ロードマップ用語集
| 用語 | 解説 |
|---|---|
| Text-to-Video | テキストのプロンプトから直接動画を生成する |
| Image-to-Video | 参照画像をもとに動的な動画を生成する |
| Multimodal Reference | 画像・動画・音声など複数の素材を同時に使って生成を指示する |
| Keyframe | キーフレーム。ある時点の画面状態を定義するために使う |
| Timestamp-level Editing | 動画のタイムスタンプ単位で、特定の区間の内容を正確に修正する |
| Agent | タスクを自律的に計画し、ツールを呼び出し、結果を確認して修正できるAIシステム |
| Remotion | Reactコンポーネントとコードで動画アニメーションを制作するツール |
| Manim | Pythonで数学・科学アニメーションを制作するエンジン |
| FFmpeg | 動画のエンコード、音声合成、編集、フォーマット変換を担うコマンドラインツール |
| ffprobe | FFmpegに付属する検査ツール。解像度、フレームレート、再生時間、音声トラックを読み取れる |
| TTS | テキスト読み上げ。ナレーションを自動生成するために使う |
| Deterministic Rendering | 決定論的レンダリング。同じコードとパラメータであれば、毎回同じ画面を出力する |
| Claude Motion | Anthropicがコード駆動アニメーションを製品化した機能。現在はBeta版 |
| Cache Hit | キャッシュヒット率。繰り返し使うコンテキストはキャッシュから直接読み取り、Token費用を大幅に削減できる |
1 AI動画の2つの技術ルート:出力の仕組みはまったく異なる
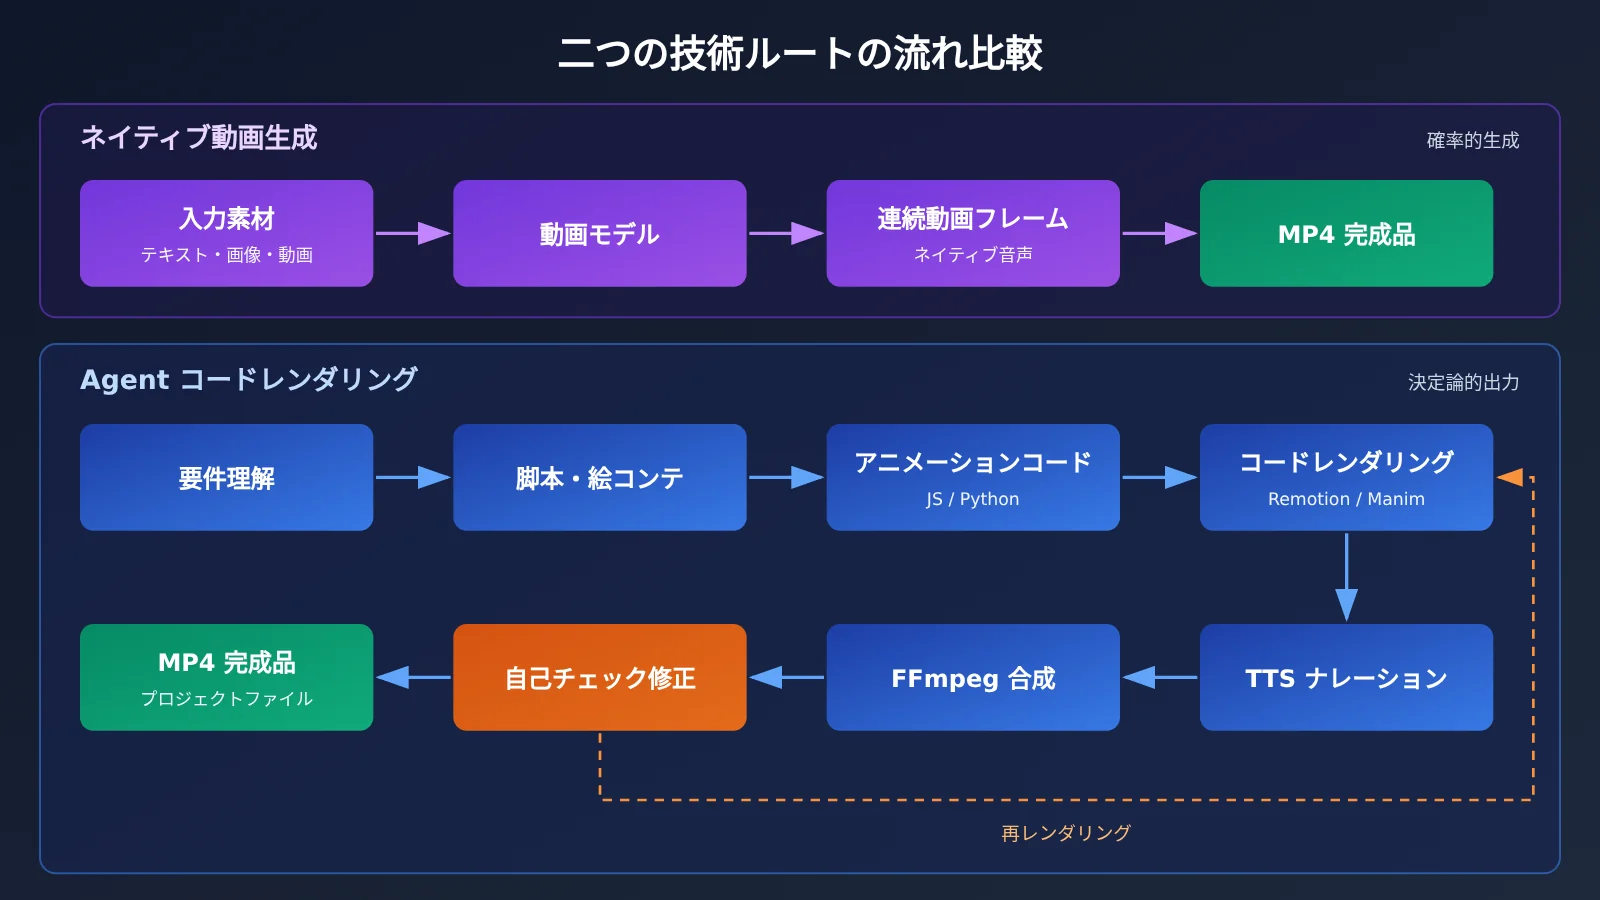
どちらのルートでも1本のMP4を出力できますが、映像を生成する方法は根本的に違います。ネイティブ動画生成はモデルが各フレームを直接「描画」します。一方、Agentコードレンダリングはモデルが動画制作プログラムを書き、レンダリングエンジンがそのプログラムに従って映像を出力します。この違いが、制御の精度、修正のしやすさ、コストのすべてに影響します。
1.1 ネイティブ動画生成:モデルが直接、連続した映像を創り出す
ネイティブ動画生成はText-to-VideoとImage-to-Videoをベースにしています。ユーザーがテキストの説明や参照画像を渡すと、モデルが連続した動画フレームを直接出力します。映像に登場する人物、オブジェクト、環境、連続した動き、物理的な動きは、すべてモデルが一度に生成します。カメラのズームイン/アウト、ショットサイズの変化、シーン切り替えもプロンプトに書き込めます。
最新世代のモデルはネイティブ音声を同時に生成でき、複数の参照画像や参照動画を使って人物の外観、シーン、ビジュアルスタイルを制御することも可能です。強みは映像の自然さとリアルさにあります。その代わり、各フレームは確率的生成に由来するため、同じプロンプトでも2回の生成結果は同一になりません。ピクセル単位の修正も、再生成や専用の編集機能に頼ることになります。
1.2 Agentコードレンダリング:AIが自ら動画制作プログラムを書く
Agentコードレンダリングでは、大規模言語モデルが監督とプログラマーの両方を務めます。一般的なフローは次のとおりです。
- 要件を理解し、テーマ、ターゲット層、ビジュアルスタイルを決定する;
- スクリプト、ナレーション、絵コンテ、タイムラインを作成する;
- JavaScriptやPythonでアニメーションコードを書く(Remotion、Manim、Three.js、Cairo、Blenderなど);
- TTSを呼び出してナレーションを生成し、音楽や効果音を作る;
- FFmpegを呼び出して音声と映像を合成する;
- 映像、音声、タイミングの同期をチェックし、問題を見つけたら修正して再レンダリングする;
- MP4の完成ファイルと再利用可能なプロジェクトファイルを出力する。
このルートの出力は決定論的です。コードとパラメータが変わらなければ、レンダリング結果も変わりません。数値ひとつ、字幕一行、配色ひとつを変えるときも、コードを修正して再レンダリングするだけで、他の映像はそのまま保たれます。データビジュアライゼーション、製品紹介、知識解説、動的情報グラフィックに強く、実在の人物や実写映像を生成する場合は既存の素材や3Dアセットに頼ることになります。
2 ネイティブ動画生成という選択肢:どんなタスクに向くか
2026年のネイティブ動画モデルは、1回の生成時間を最大30秒まで押し上げ、競争の軸はマルチモーダル参照、キーフレーム制御、生成後の継続的な編集へと移っています。以下の表に、代表的な3モデルの公開されている能力をまとめます。
| 能力 | Seedance 2.5 | Kling 4.0 | Veo 3.1 |
|---|---|---|---|
| 発表/公開時期 | 2026-07-31 発表 | 2026-10-28 API 全面公開 | Gemini API ドキュメントに記載 |
| 1回の生成時間 | 最長30秒 | 最長30秒 | 動画延長をサポート |
| 参照素材 | 画像30枚、動画10本、音声10本 | 画像10枚、動画5本、混合で最大15項目 | 画像によるガイド生成 |
| 主な制御方法 | 複数回延長、タイムスタンプ編集、グリーンスクリーンとカメラアングル編集 | 最大10個のキーフレーム、音声参照 | 最終フレーム制御、動画延長 |
| 音声 | 音声参照をサポート | 音声参照をサポート | ネイティブ音声生成 |
| 課金方式 | 解像度と長さに応じて(Token消費を含む) | Unit/秒単位 | 生成仕様に応じて |
2.1 Seedance 2.5:30秒の連続生成とマルチモーダル参照
Seedance 2.5 は、ByteDance の Seed チームによって2026年7月31日に発表されました。1回の生成で最大30秒の動画を作成でき、複数の連続したショットを含めることも可能です。参照機能は現在公開されているパラメータの中で最も幅広く、最大30枚の参照画像、10本の参照動画、10本の参照音声を利用できます。キャラクター設定、背景写真、動作参照、BGMをまとめてモデルに渡し、複雑なシーンを構成できます。
編集面では、既存動画を複数回延長し、人物・シーン・音声の一貫性をできるだけ維持できます。指定した時点で人物の動作やストーリーを変更できるほか、グリーンスクリーン編集、カメラ視点編集、複数キャラクターの一貫性にも対応しています。また、Clay Render(クレイレンダリング)の参照を使って、空間構造、人物の立ち位置、カメラワークを制御できます。公式の作例では、京劇の人物演技、舞台パフォーマンス、複数キャラクターのインタラクション、連続するシーン転換などを扱っており、こうした複数キャラクター、長回し、連続的な物語こそ、コードによるレンダリングで最も難しかった部分です。
2.2 Kling 4.0:キーフレームと動画参照制御
Kling 4.0 は2026年10月28日に API を全面公開し、1回の生成で最長30秒、720p と 1080p、アスペクト比は21:9とアダプティブ比に対応しています。最大の特徴は最大10個のキーフレームです。クリエイターはタイムライン上で複数の画面状態を固定でき、モデルがキーフレーム間の動きを補完するため、カメラワークやキャラクターのポーズをより細かく制御できます。
参照素材に関しては、Kling 4.0 は最大10枚の参照画像、5本の参照動画をサポートし、1回の混合入力で最大15項目まで扱えます。さらに Omni マルチモーダル参照と音声参照も利用できます。テキスト生成、画像生成、参照素材、動画編集を一体化しており、安定したキャラクターの見た目、指定したカメラパス、既存動画の二次編集が必要なプロジェクトに適しています。
2.3 Veo 3.1:ネイティブ音声と動画延長
Google は Gemini API で2種類の動画生成プロダクトを提供しています。Veo 3.1 はネイティブ音声生成、動画延長、最終フレーム制御、画像ガイド生成を重視しており、「音声付き映像」のクリップを一度に生成するのに適しています。Gemini Omni Flash はマルチモーダル入力、キャラクターの一貫性、動画理解、マルチターン対話型編集を重視しています。両者は、ネイティブ動画分野における2つの方向性、つまり高品質なクリップの生成と、生成後の継続的な編集・修正・延長をそれぞれ代表しています。
OpenAI に関しては、Sora 製品は2026年4月26日にサービスを終了し、Sora 2 モデルと Videos API は2026年9月24日に提供終了となりました。公式の廃止告知には、1対1で代替できる API はないと記載されています。OpenAI が2026年11月4日にリリースした Images 2.6 は、2~16フレームの GIF アニメーション出力に対応しており、動的な表情、キャラクターの動作ループ、絵コンテプレビューに適しています。MP4 の完全な動画制作とは異なるワークフローです。
2.4 ネイティブ動画生成のメリットとコスト
ネイティブ動画生成の中核的な強みは、4つの側面に集約されます。自然な人物の動作、説得力のある物理運動、映画のようなカメラワーク、そしてオープンエンドな創造的表現です。これらをコードで実装しようとすると、大量のアニメーションアセットと手作業による調整が必要になりますが、動画モデルなら1回の生成で実現できます。
コスト面では、ネイティブ動画は出力仕様と長さに応じて課金されます。BytePlus ModelArk が2026年11月13日に更新した Seedance 2.5 の公式価格を例に見てみましょう:
| 出力仕様 | 5秒動画の参考価格 | 1秒あたりの目安 |
|---|---|---|
| 480p | $0.514 | $0.103 |
| 720p | $1.156 | $0.231 |
| 1080p | $2.843 | $0.569 |
720p から 1080p になると、1秒あたりのコストは約2.5倍に増えます。上記の表は公式の代表的な仕様に基づく試算であり、入力動画の長さ、解像度、フレームレート、そして実際の Token 消費量によって最終的な請求額は変動します。一方、Kling 4.0 はプラットフォームの Unit 単位で課金されます。720p は 1 Unit/秒、1080p は 1.5 Units/秒、Kling 4.0 Flash の 720p は 0.6 Units/秒となり、既存の動画を入力する場合は入力の長さにも影響を受けます。Unit はプラットフォームの課金単位であるため、プラットフォームのルールに従って実際の金額に換算する必要があります。
注意すべきなのは、これらの価格が「1回生成する」ためのコストだという点です。ネイティブ動画にはランダム性があるため、実際の制作では何度も生成してから選び出すことが多く、最終的に使用できるカットのコストは通常、単発の見積もり価格よりも高くなります。
3 エージェントによるコードレンダリング路線:AIを動画制作エンジニアにする
コードレンダリング路線の中心となるのは、成熟したオープンソースまたは商用ツール群です。大規模言語モデルは要件をこれらのツールが実行できるコードに変換し、スケジューリング、チェック、修正まで担います。
3.1 Remotion:Reactアニメーションと自動動画制作
RemotionはReactコンポーネントで画面を記述し、フレーム番号によって要素の位置、サイズ、透明度、動きを制御します。開発者はReact、HTML、CSS、JavaScriptをそのまま使ってアニメーションを作成でき、文字、グラフ、画像、動画、音声を画面内で組み合わせ、各フレームを正確に制御できます。CLIによる一括レンダリング、サーバーサイドレンダリング、クラウド上のLambdaレンダリングに対応し、異なるパラメータを渡して内容の異なる動画を一括生成することもできます。
公式のレンダリングフローはとてもシンプルです。
# Remotion をインストール
npm install remotion @remotion/cli

# 指定した動画コンポジション(Composition)をレンダリングして MP4 を出力
npx remotion render HelloWorld out.mp4
ライセンス面では、Remotionは個人および3人以下の小規模企業に無料で提供され、条件を満たせば商用利用も可能です。Automatorsプランはレンダリング1回あたり0.01ドルで、最低月額利用料は100ドルです。Creatorsプランは1シートあたり月額25ドル、Enterpriseプランは月額500ドルからです(2026年11月14日更新)。Remotionのレンダリングライセンス料と、AIモデルがコードを書くために消費するトークン費用は別々のコストです。試算する際は分けて計算してください。
3.2 Manim:精密な数学・科学アニメーション
Manim は Python 製のアニメーションエンジンで、数式の提示、図形の変換、物理的な運動過程、アルゴリズムの動作原理、科学実験の解説を専門に扱います。数式、座標軸、幾何構造、オブジェクト間の運動関係はすべてコードで定義されるため、各記号や各曲線の位置を正確かつ制御可能に配置できます。ネイティブの動画モデルが生成する数式では、文字の誤りや構造の誤りがしばしば発生しますが、まさにそこが Manim の得意分野です。
公式のクイックスタート例では、コマンド1つで MP4 を出力できます:
manim -pql main.py CreateCircle
3.3 FFmpeg:各種素材を最終的な動画に仕上げる
FFmpeg は、コードレンダリング経路全体における「最終組み立てライン」です。動画のエンコードとトランスコード、音声の結合、複数クリップの連結、字幕の焼き込み、トリミングと拡大縮小、フレームレート変換、フォーマット変換を担います。付属の ffprobe は、完成した動画の解像度、フレームレート、長さ、音声トラック情報を読み取ることができ、Agent はこれを自動検収に利用します。仕様が基準を満たしていなければ、前のステップに戻って修正します。
# クリップを連結(list.txt に各クリップファイルを1行ずつ列挙)
ffmpeg -f concat -safe 0 -i list.txt -c copy merged.mp4

# ナレーションを結合し字幕を焼き込む
ffmpeg -i merged.mp4 -i voice.mp3 -vf subtitles=subs.srt \
  -map 0:v -map 1:a -c:v libx264 -c:a aac final.mp4

# 出力仕様をチェック
ffprobe -v error -show_entries stream=codec_type,width,height,r_frame_rate \
  -show_entries format=duration final.mp4
3.4 Claude Motion:コードアニメーションが普通の製品機能に
Anthropic は 2026年10月8日に Claude Motion Beta をリリースし、コード駆動のアニメーションを企業ユーザーに直接提供しました。ユーザーが自然言語でアニメーションの要件を記述すると、Claude がテキスト、グラフ、図形、画像をコードアニメーションとして構成し、Artifacts に保存します。ユーザーは会話を通じて修正を続けることもでき、エディタに入って手動で調整することもでき、最後に MP4 としてエクスポートできます。
典型的な用途としては、四半期決算を30秒の解説アニメーションに変換する、料金プランを動的な比較図にする、製品の操作手順をガイドアニメーションにする、会議資料を社内広報動画にする、といったものがあります。利用条件について、Beta は Team および Enterprise ユーザー向けに公開されており、Team ではデフォルトで有効、Enterprise では組織の管理者が有効にする必要があり、使用量はプランの枠にカウントされます。Claude Motion はネイティブの動画生成モデルを呼び出さないため、実在の人物や実写風の連続ショットを生成することはできません。
Claude Motion の製品価値は、そのハードルの低さにあります。企業の運営、財務、マーケティング担当者は Remotion のプロジェクトを構築することなく、コードアニメーションの精度と修正可能性を直接手に入れることができます。
3.5 GPT + Codex:Agent がツールを呼び出して動画制作を完遂
もうひとつの形は、汎用モデルが Agent 開発環境でツールを自律的に呼び出すというものです。2026年10月26日に公開された VibeVideoBench は、この能力を専門的に評価します。239件の実動画制作タスクは、データストーリー、教育コース、論文解説、ブランドマーケティング、製品機能紹介など12カテゴリのコンテンツを対象としています。各タスクでは、AI がサンドボックス内で60分以内に、再生可能な MP4、動画を再生成できるプロジェクトファイル、スケジュールと制作説明を自律的に納品することを求められます。9つのエージェントシステムが合計2,151回の実行を完了し、いずれも各々のネイティブ開発環境で利用可能な最大推論強度で実行され、途中で人手による指示を追加することは許されていませんでした。
上位2システムの比較は以下のとおりです(3つの審査パネルの平均、評価範囲1〜5点):
| 指標 | GPT-6 Astra(Codex CLI) | Claude Opus 5.5(Claude Code) |
|---|---|---|
| 動画の納品成功率 | 238/239(99.6%) | 239/239(100%) |
| 仕様適合率 | 93.7% | 99.6% |
| タスク要件の通過率 | 97.1% | 97.3% |
| 総合品質スコア | 4.109 | 4.074 |
| 厳格タスク成功率 | 74.5% | 76.3% |
| 人間選好 Elo | 1242 | 1203 |
| 平均タスクコスト | $8.19 | $15.38 |
| 中央値 / P90 タスクコスト | $7.88 / $11.88 | $10.19 / $31.22 |
| 平均出力 Token | 61K | 130.7K |
| キャッシュヒット率 | 97% | 65% |
このテストでは、GPT-6 Astra の総合品質と人間による選好がやや高く、平均タスクコストは約46.7%低くなっています。一方、Claude Opus 5.5 は239件すべてのタスクを納品し、仕様適合率と厳格タスク成功率で上回りました。コスト差の主な要因は Token 使用効率です。Astra は出力 Token が約53.3%少なく、キャッシュヒット率は97%に達しましたが、Opus はタスクコストの約76%が Cache Write によるものです。Astra の標準入出力単価は Opus の2.5倍であるにもかかわらず、1タスクあたりの実費はむしろ低くなっています。
このデータを解釈する際には、評価の前提を踏まえる必要があります。評価対象は「モデル + 実行環境」で構成される完全なエージェントシステムであり、GPT と Claude が使用する Codex CLI と Claude Code 自体にも違いがあります。各タスクは1回だけ実行され、制限時間は60分です。3つの審査パネルによるシステムランキングの相関係数は0.933〜0.950、人間の Elo ランキングとの相関係数は0.98ですが、個々の動画における人間の選好と審査結果の一致率は73.3%でした。したがって、これらのスコアはシステム全体のおおよその水準を判断するのに適しており、すべての動画タスクに一般化できるものではなく、ネイティブな Text-to-Video モデルの評価を代替するものでもありません。
VibeVideoBench は、Agent が動画制作を行う際の主なボトルネックも明らかにしています。2,151回の実行のうち224回は再生可能な動画を納品できませんでした。そのうち169回は時間管理の問題で、最終レンダリングの開始が遅すぎる、実行が遅すぎる、あるいはまったく開始されないといったケースが含まれ、失敗事例の約75%を占めています。動画 Agent の難しさは、「アニメーションコードを書けるかどうか」から、レンダリングのスケジューリングと納品管理へと移っています。
Claude Motion と比較すると、Codex や Claude Code のような Agent 環境は開発者向けです。Remotion、Manim、FFmpeg、TTS、画面収録を自由に組み合わせて完全なプロジェクトファイルを生成でき、自動化された制作ラインへの組み込みに適しています。一方、Claude Motion は企業のエンドユーザー向けで、インタラクションがより簡単であり、機能の範囲はテキスト、グラフ、図形アニメーションに集中しています。
4 ネイティブ動画生成と Agent コードレンダリングの選び方
4.1 ネイティブ動画生成が適しているタスク
- 人物実写スタイル:実写の人物が登場し、表情や身振りを伴う映像
- 製品の使用シーン:製品が実際の環境で使用される様子
- 自然な動きとカメラワーク:ズームやパン、追い撮り、ショット切り替え
- 映画のような広告:光や影、雰囲気、質感を優先するブランド映像
- キャラクターの演技と連続するストーリー:複数キャラクターの掛け合い、長回しによるナラティブ
- 複雑な自然環境:天候、水流、都市の街並みなど、モデリングが難しいシーン
4.2 コード駆動型制作に適したタスク
- 正確なデータチャート:数値、座標、比率が正確である必要がある
- ソフトウェア操作チュートリアル:画面録画に注釈、ハイライト、ステップ説明を加える
- 数学・科学の解説:公式の導出、幾何学的変換、アルゴリズムのデモ
- 動的情報図:構造化された情報を段階的に提示
- 製品パラメータの比較と価格説明:すべての数値が検証・変更可能
- テンプレート化されたバルクコンテンツ:同じテンプレートでデータを差し替え、数百本の動画を一括生成
次の表は、2つのルートが一般的なタスクにどの程度適しているかをまとめたものです:
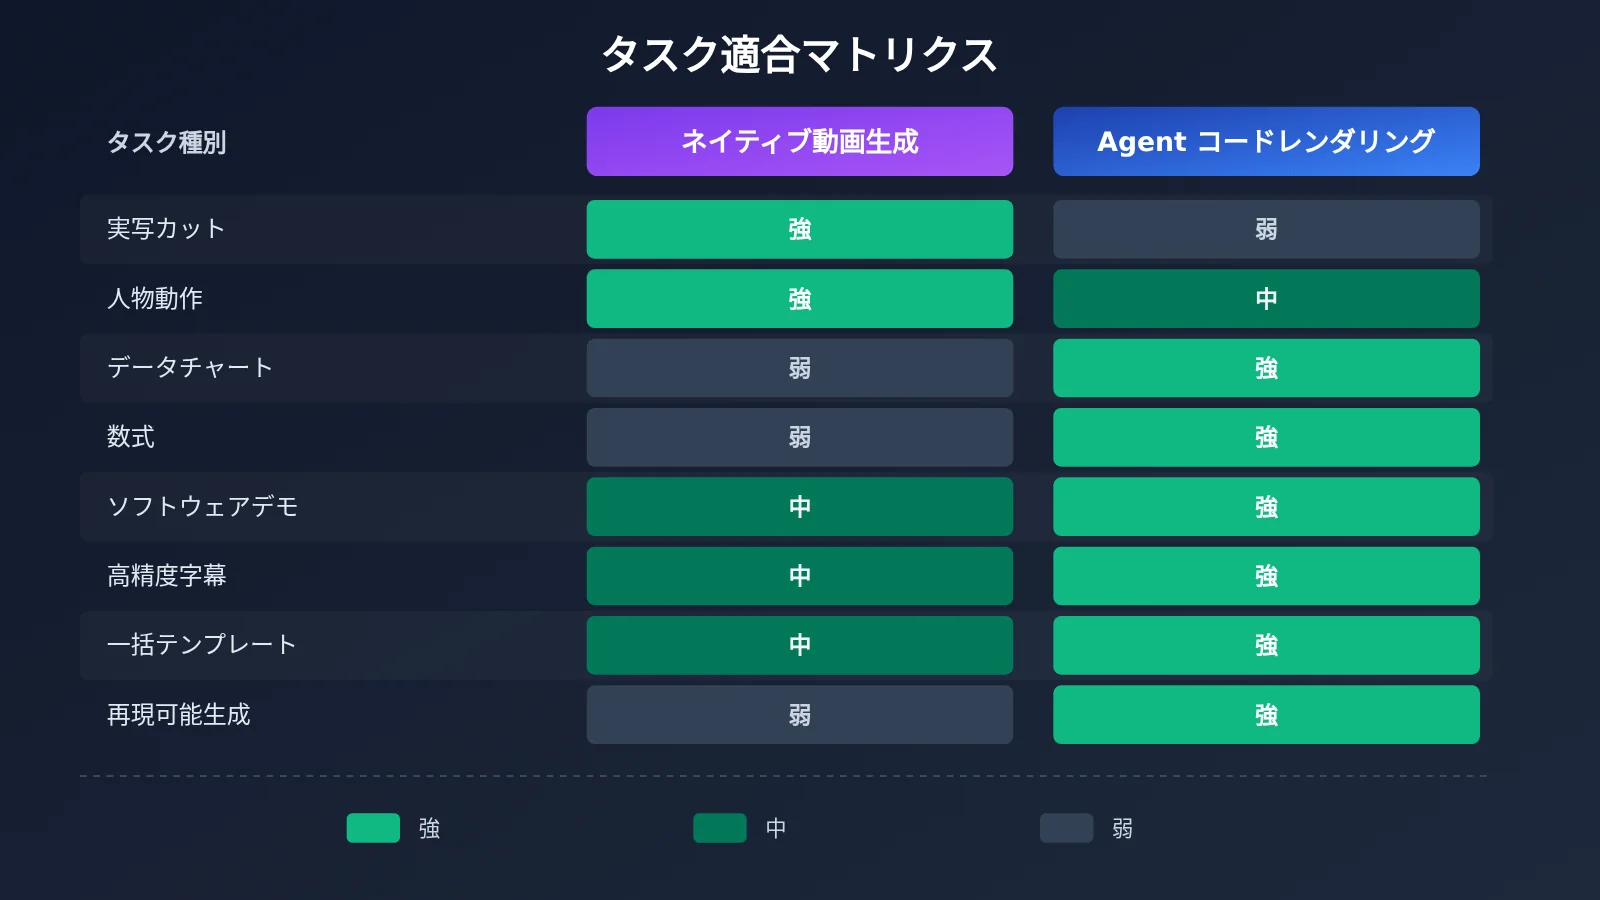
| タスク | ネイティブ動画生成 | Agentコードレンダリング |
|---|---|---|
| 映画風の実写カット | 強い | 既存素材や3Dアセットが必要 |
| 人物の自然な動作 | 強い | アニメーションアセットに依存 |
| 複雑なカメラワーク | 強い | 正確にプログラミング可能 |
| データの正確な表示 | 保証が難しい | 強い |
| 数学公式のアニメーション | エラーが起きやすい | 強い |
| ソフトウェアUIのデモ | 参照と後処理が必要 | 強い |
| 正確な字幕 | 後処理での校正が必要 | 強い |
| 製品の動的展示 | 強い | 強い |
| 統一テンプレートによるバルク生産 | 複数回の生成と選別が必要 | 強い |
| 単一ディテールの正確な修正 | 再生成や編集に依存 | 強い |
| 同じアニメーションの再現可能な生成 | ランダム性の影響を受ける | 強い |
VibeVideoBenchの研究でも、コードレンダリングが正確な公式、データチャート、ルールに一貫したゲーム画面、同期したナレーションなどのタスクに特に適していることが指摘されています。
💡 選択のヒント:判断基準は一文に単純化できます。画面が「本物のように見える」必要があるならネイティブ動画モデルを、情報が「正確で誤りがない」必要があるならコードレンダリングを使います。コードレンダリングのパイプラインにおけるスクリプト、絵コンテ、アニメーションコードはすべて汎用大規模言語モデルに依存しています。まず APIYI apiyi.com で同じAPIキーを使い、GPT、Claude、Geminiをあなたのスクリプトやコードタスクでそれぞれテストし、その後メインモデルを決めることをお勧めします。
4.3 2つのアプローチのコスト構造
2つのアプローチではコストの内訳が大きく異なるため、単価だけを直接比較しても意味は限定的です。
- ネイティブ動画生成:主に出力解像度と再生時間に応じて課金され、参照動画の入力による追加消費が加わります。さらに、ランダム性に起因する複数回の生成と選別が隠れたコストとなります。
- Agent によるコードレンダリング:汎用モデルのToken費用(入力、出力、キャッシュの読み書き)、コード実行とレンダリングの計算資源、ツールライセンス(Remotion の商用ライセンスなど)、TTS や音楽・効果音素材の费用が含まれます。
比較の際は「最終的に納品できる動画の総コスト」を基準にしてください。ネイティブ動画の1カットが5回生成してようやく1回使える結果になるなら、その実コストは提示価格の5倍です。Agent タスクでも、キャッシュヒット率が低く再レンダリングを繰り返せば、Token 費用は同样に急速に膨らみます。VibeVideoBench のデータが示すのは、単価の高いモデルでも出力 Token が少なくキャッシュヒット率が高ければ、タスクあたりのコストをより低く抑えられるということです。モデル選定では、実測のタスクあたりの支出を確認する必要があります。
💰 コスト最適化:コードレンダリングのパイプラインではモデル費用の比率が高く、しかも長いコンテキストでのマルチターン呼び出しが多くなります。APIYI apiyi.com を通じて複数の主要モデルを従量課金で呼び出せば、同じコードセットで同じ動画タスクを異なるモデルに実行させ、実際のコストを比較できます。そのうえでタスクの種類ごとにモデルを割り当ててください。
5 最も効果的な方法:2つのAI動画技術ルートを組み合わせる
5.1 ハイブリッド制作フロー
2つのルートを組み合わせ、ネイティブ動画モデルに自然な映像を担当させ、コードレンダリングに正確な表現を担当させるのが、現在最も実用化しやすい方法です:
- クリエイティブと絵コンテ:GPTまたはClaudeがクリエイティブ、スクリプト、絵コンテを担当し、各ショットに制作方式を注記します。
- 自然なショット:Seedance、Kling、Veoが人物、シーン、製品使用シーンを生成します。
- 正確な画面:Remotionがデータチャート、字幕、ブランド要素、製品パラメータのアニメーションを担当します。
- ナレーション:TTSがスクリプトに基づいてナレーションを生成します。
- 合成:FFmpegがショットを結合し、音声トラックをマージし、字幕を焼き込みます。
- 検収と修正:AI Agentがffprobeで仕様をチェックし、音声と映像の同期や字幕を確認し、問題を発見したら対応する工程に戻って修正します。
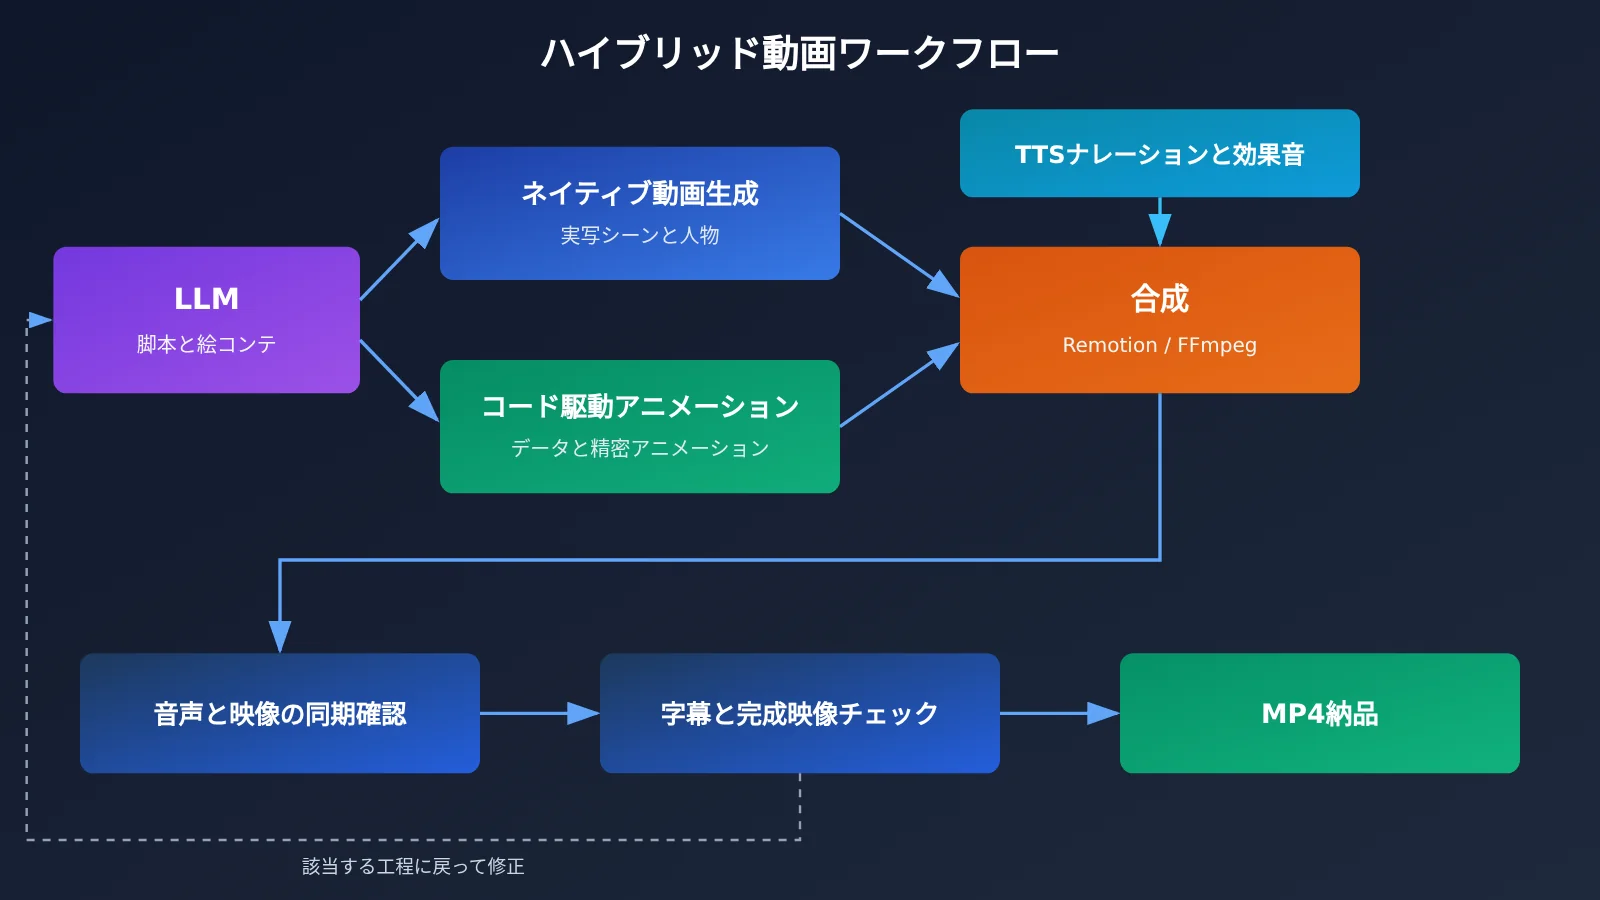
上の図では、スクリプト・絵コンテと完成映像チェックの2つの工程はどちらも汎用大規模言語モデルが担当しており、この部分の呼び出しはAPIYI apiyi.comに統一的に接続し、1つのOpenAI互換インターフェースでGPT、Claude、Geminiを切り替えられる仕組みになっています。
5.2 通しで見る実例:ある製品PR動画の役割分担
モバイルアプリの製品PR動画を例に、各部分の役割分担を考えてみましょう。
- オープニングの雰囲気カット(ユーザーが通勤中やオフィスで製品を使うシーン):Seedance 2.5 または Kling 4.0 に任せます。製品写真とキャラクター設定画を参照画像として使い、人物と製品の外観を一致させます。Kling 4.0 ではキーフレームで冒頭と締めの構図を固定できます。Seedance 2.5 の公式見積もりでは720pで毎秒約 $0.231 なので、予算を立てる際は複数回生成する余裕も見込んでおきましょう。
- 機能デモのパート:実際のアプリ画面を録画し、Remotion でハイライト枠やステップ番号、動的な注釈を重ねます。画面の内容は実際のスクリーンキャプチャに由来するため、モデルが「作り上げた」ボタンが現れることはありません。
- 仕様と価格のパート:Remotion コンポーネントで機能比較表や価格カードをレンダリングします。価格を変更するときはデータファイルだけを修正して再レンダリングすれば、他の画面はそのまま維持されます。
- ナレーションと字幕:大規模言語モデルがナレーション原稿を書き、TTS が音声を生成し、同時に SRT 字幕ファイルを出力します。
- 最終組み立てと検収:FFmpeg ですべてのクリップをつなぎ、音声トラックを合成します。さらに Agent が ffprobe で再生時間・解像度・音声トラックを確認し、各セクションごとに字幕とナレーションが同期しているかをチェックします。
この分担により、リアルさが求められるカットは動画モデルが担保し、検証可能な情報はすべてコードが担保するという体制になります。今後の改訂では、該当するクリップを再レンダリングするだけで済みます。
5.3 APIを使ったルーティング注釈付き絵コンテの生成
ハイブリッドフローの最初のステップは、大規模言語モデルに構造化された絵コンテを出力させ、各ショットがどのルートをたどるかを明示することです。以下の例では、OpenAI互換インターフェースを使ってこのステップを実行します:
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI互換インターフェース
)

MODEL = "your-model-name"  # プラットフォームのモデル一覧にある実際のモデル名に置き換えてください

prompt = """家計簿アプリの30秒宣伝映像の絵コンテを書き、JSON配列で出力してください。
各ショットには id、duration、description、route フィールドを含めます。
route は native(実在の人物と場景、動画モデルに任せる)
または code(データ、パラメータ、字幕、UI注釈、Remotionレンダリングに任せる)のいずれかです。"""

resp = client.chat.completions.create(
    model=MODEL,
    messages=[{"role": "user", "content": prompt}],
)
print(resp.choices[0].message.content)
完全な実装を見る: 絵コンテのルーティング + Remotionレンダリングパラメータの生成
import json
import subprocess
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

PLANNER_MODEL = "your-planner-model"  # クリエイティブと絵コンテを担当するモデル
CODER_MODEL = "your-coder-model"      # レンダリングパラメータ/コードの生成を担当するモデル


def plan_storyboard(brief: str) -> list[dict]:
    """モデルに route 注釈付きの絵コンテJSONを出力させます。"""
    resp = client.chat.completions.create(
        model=PLANNER_MODEL,
        messages=[
            {"role": "system", "content": "あなたは動画監督です。有効なJSON配列のみ出力してください。"},
            {"role": "user", "content": brief},
        ],
    )
    return json.loads(resp.choices[0].message.content)


def build_remotion_props(shot: dict) -> dict:
    """codeルートのショット用にRemotionコンポーネントのパラメータを生成します。"""
    resp = client.chat.completions.create(
        model=CODER_MODEL,
        messages=[
            {"role": "system", "content": "ショットの説明をRemotionコンポーネントのpropsに変換し、JSONオブジェクトのみ出力してください。"},
            {"role": "user", "content": json.dumps(shot, ensure_ascii=False)},
        ],
    )
    return json.loads(resp.choices[0].message.content)


def render_code_shot(shot_id: str, props: dict) -> str:
    """Remotion CLIを呼び出して単一のショットをレンダリングします。"""
    out = f"out/{shot_id}.mp4"
    subprocess.run(
        ["npx", "remotion", "render", "InfoCard", out,
         f"--props={json.dumps(props, ensure_ascii=False)}"],
        check=True,
    )
    return out


if __name__ == "__main__":
    shots = plan_storyboard("家計簿アプリの30秒宣伝映像の絵コンテを書き、"
                            "フィールド: id、duration、description、route(native/code)。")
    for shot in shots:
        if shot["route"] == "code":
            path = render_code_shot(shot["id"], build_remotion_props(shot))
            print("レンダリング済み: ", path)
        else:
            # nativeショットは動画生成モデルに任せ、ここではプロンプトを記録して生成待ちにする
            print("ネイティブ生成待ち: ", shot["id"], shot["description"])
🚀 クイックスタート: 上記の絵コンテとパラメータ生成のステップには汎用の大規模言語モデルだけで十分です。APIYI apiyi.com で登録した後、新規ユーザー向けの無料テスト枠を利用することをおすすめします。まず2〜3個のモデルで同じ宣伝映像の要件をそれぞれ実行し、絵コンテの品質とトークン消費量を比較してから、本番フローに固定するとよいでしょう。
6 まとめ:AI動画の競争の焦点は「制作ワークフロー全体」
2つの技術ルートとタスクの適性の関係は、すでに明確になっています。ネイティブ動画生成はリアルな映像、人物の演技、カメラワークを担当し、Seedance 2.5、Kling 4.0、Veo 3.1 は30秒の連続生成、マルチモーダル参照、キーフレーム、継続的な編集においてそれぞれ重点が異なります。一方、エージェントによるコードレンダリングは正確な情報、再現可能なレンダリング、バッチ生産を担当し、Remotion、Manim、FFmpeg がツールの基盤を構成します。Claude Motion はそれを企業ユーザー向けに製品化し、Codex、Claude Code は開発者が完全な自動化パイプラインを構築できるようにします。
VibeVideoBench の結果が示すのは、最高水準のエージェントシステムはすでに完全な動画を安定して納品でき、失敗の主な原因はレンダリングのスケジューリングと時間管理に集中しているということです。単一タスクのコストはモデルの単価ではなく、Token 効率とキャッシュヒット率によって決まります。これはつまり、動画制作の競争が単一モデルの画質から、「生成・編集・レンダリング・納品」というワークフロー全体を組織する能力へと移りつつあることを意味します。
核心ポイントの振り返り:
- ルートの違い:ネイティブ生成はモデルが直接映像を出力し、コードレンダリングはモデルがプログラムを書いてからレンダリングする
- ネイティブ生成が適する用途:人物、実写のような質感、自然な動き、映画的な広告、連続するストーリー
- コードレンダリングが適する用途:データチャート、数式、ソフトウェアのチュートリアル、スペックや価格、テンプレート化された大量コンテンツ
- コスト比較の基準:最終的に納品できる動画の総コストを基準とし、リトライ、Token、レンダリング、ライセンス費用を含める
- ベストプラクティス:ハイブリッドワークフロー。動画モデルには自然な映像を、コードには正確な表現を担当させる
- 複数モデルの呼び出し:スクリプト、絵コンテ、アニメーションコード、完成品のチェックはそれぞれ別のモデルに適しており、統一インターフェースによって切り替えコストを下げられる
実際の制作では、1本の動画に対してクリエイティブ、コーディング、チェックをそれぞれ別の大規模言語モデルで行うことが少なくありません。APIYI(apiyi.com)を利用すれば、1つのAPIキーでGPT、Claude、Gemini などのモデルを統一的に呼び出せます。タスクごとにモデルを割り当て、利用量に応じて課金することで、リソースをワークフローそのものに集中できます。
参考資料
- VibeVideoBench 公式ベンチマーク:コード駆動型の動画生成エージェント評価
- リンク:
vibevideobench.github.io -
説明: 239タスクのランキング、品質スコア、コストと失敗原因の分析
-
Seedance 2.5 公式アナウンス:30秒生成とマルチモーダル参照
- リンク:
seed.bytedance.com/en/blog/one-take-creation-flexible-referencing-introducing-seedance-2-5 -
説明: 参照素材の上限、延長、タイムスタンプ編集機能
-
BytePlus ModelArk Pricing:Seedance 2.5 API の価格
- リンク:
docs.byteplus.com/en/docs/modelark/model-pricing -
説明: 解像度別の動画生成参考価格
-
Kling API ドキュメント:Kling 4.0 更新のお知らせと課金
- リンク:
kling.ai/document-api/apiReference/updateNotice -
説明: キーフレーム、複数素材の参照、Unit 課金ルール
-
Gemini API 動画生成ドキュメント:Veo 3.1 と Gemini Omni Flash
- リンク:
ai.google.dev/gemini-api/docs/video -
説明: ネイティブ音声、動画延長、マルチターン編集機能
-
Remotion ドキュメントとライセンス価格
- リンク:
remotion.dev/docs/render、remotion.dev/docs/license/pricing -
説明: レンダリングコマンドと商用ライセンスプラン
-
Manim Community ドキュメント
- リンク:
docs.manim.community/en/stable -
説明: 数学・科学アニメーションエンジンの使い方
-
FFmpeg 公式ドキュメント
- リンク:
ffmpeg.org/documentation.html -
説明: エンコード、合成、字幕、ffprobe によるチェック
-
Claude Motion 使用ガイド
- リンク:
support.claude.com/en/articles/17454997-get-started-with-claude-motion -
説明: ベータ機能のワークフローと公開条件
-
OpenAI API Deprecations
- リンク:
developers.openai.com/api/docs/deprecations - 説明: Sora 2 および Videos API の提供終了情報
- リンク:
作者: APIYI 技術チーム
技術交流: APIYI 公式サイトのトップページからお問い合わせください。その他の接続資料は docs.apiyi.com ドキュメントセンターでご覧いただけます