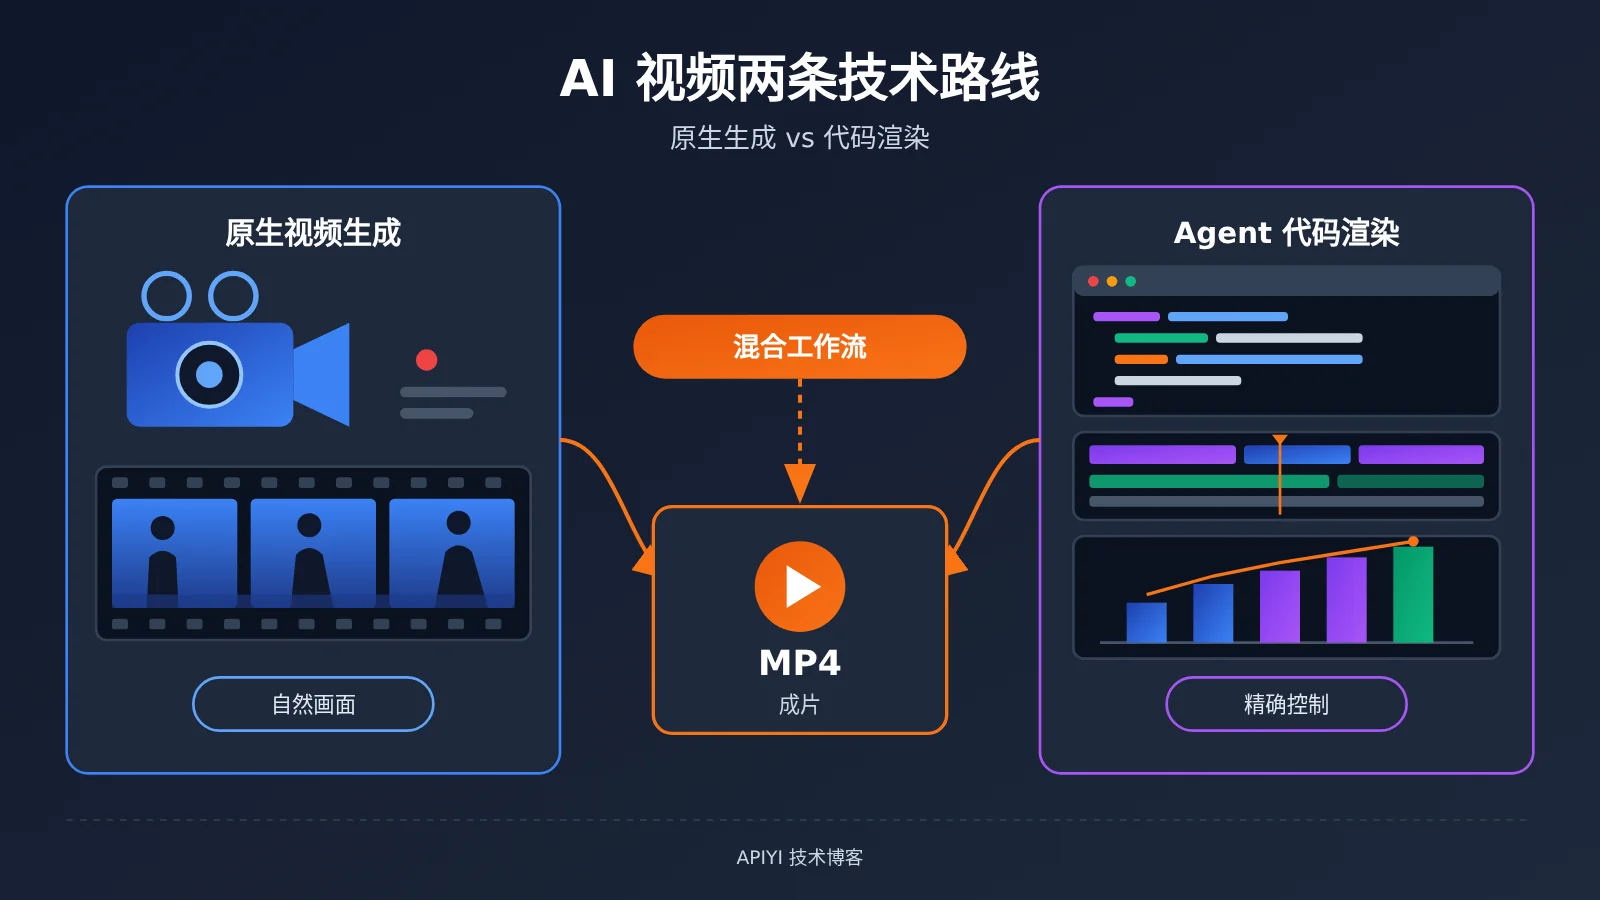
摘要:AI 视频创作已经分成原生视频生成和 Agent 代码渲染两条技术路线。前者擅长真实画面和自然运动,后者擅长精确动画、数据表达和可修改的工程化生产。理解两者差异,才能搭建高效的视频制作工作流。
结论先行:原生视频生成和 Agent 代码渲染适合不同任务。人物、实拍感、自然运动和镜头语言交给 Seedance、Kling、Veo 这类原生视频模型;数据图表、公式、软件教程、价格参数和模板化批量内容交给 Remotion、Manim、FFmpeg 组成的代码渲染链路。两者组合起来,可以同时获得自然画面和精确控制,这是当前最实用的生产方案。
内容预告:下文先说明两条路线在输出机制上的根本区别,再分别拆解原生视频模型(Seedance 2.5、Kling 4.0、Veo 3.1)和代码渲染工具链(Remotion、Manim、FFmpeg、Claude Motion、Codex)的能力与成本,并结合 VibeVideoBench 的独立评测数据说明 Agent 做视频的真实水平。最后给出一套以产品宣传片为例的混合生产流程,说明不同模型和工具各自负责哪一段工作。
To Know:AI 视频技术路线术语表
| 术语 | 解释 |
|---|---|
| Text-to-Video | 根据文字提示直接生成视频 |
| Image-to-Video | 根据参考图片生成动态视频 |
| Multimodal Reference | 同时用图片、视频、音频等多种素材指导生成 |
| Keyframe | 关键帧,用来定义某个时间点的画面状态 |
| Timestamp-level Editing | 按视频时间点精确修改某一段内容 |
| Agent | 能自主规划任务、调用工具、检查结果并修正的 AI 系统 |
| Remotion | 用 React 组件和代码制作视频动画的工具 |
| Manim | 用 Python 制作数学和科学动画的引擎 |
| FFmpeg | 负责视频编码、音频合成、剪辑和格式转换的命令行工具 |
| ffprobe | FFmpeg 附带的检查工具,可读取分辨率、帧率、时长和音轨 |
| TTS | 文本转语音,用于自动生成旁白 |
| Deterministic Rendering | 确定性渲染,同一份代码和参数每次输出相同画面 |
| Claude Motion | Anthropic 将代码驱动动画封装成产品的功能,目前为 Beta |
| Cache Hit | 缓存命中率,重复上下文直接读缓存,能显著降低 Token 费用 |
1 AI 视频的两条技术路线:输出机制完全不同
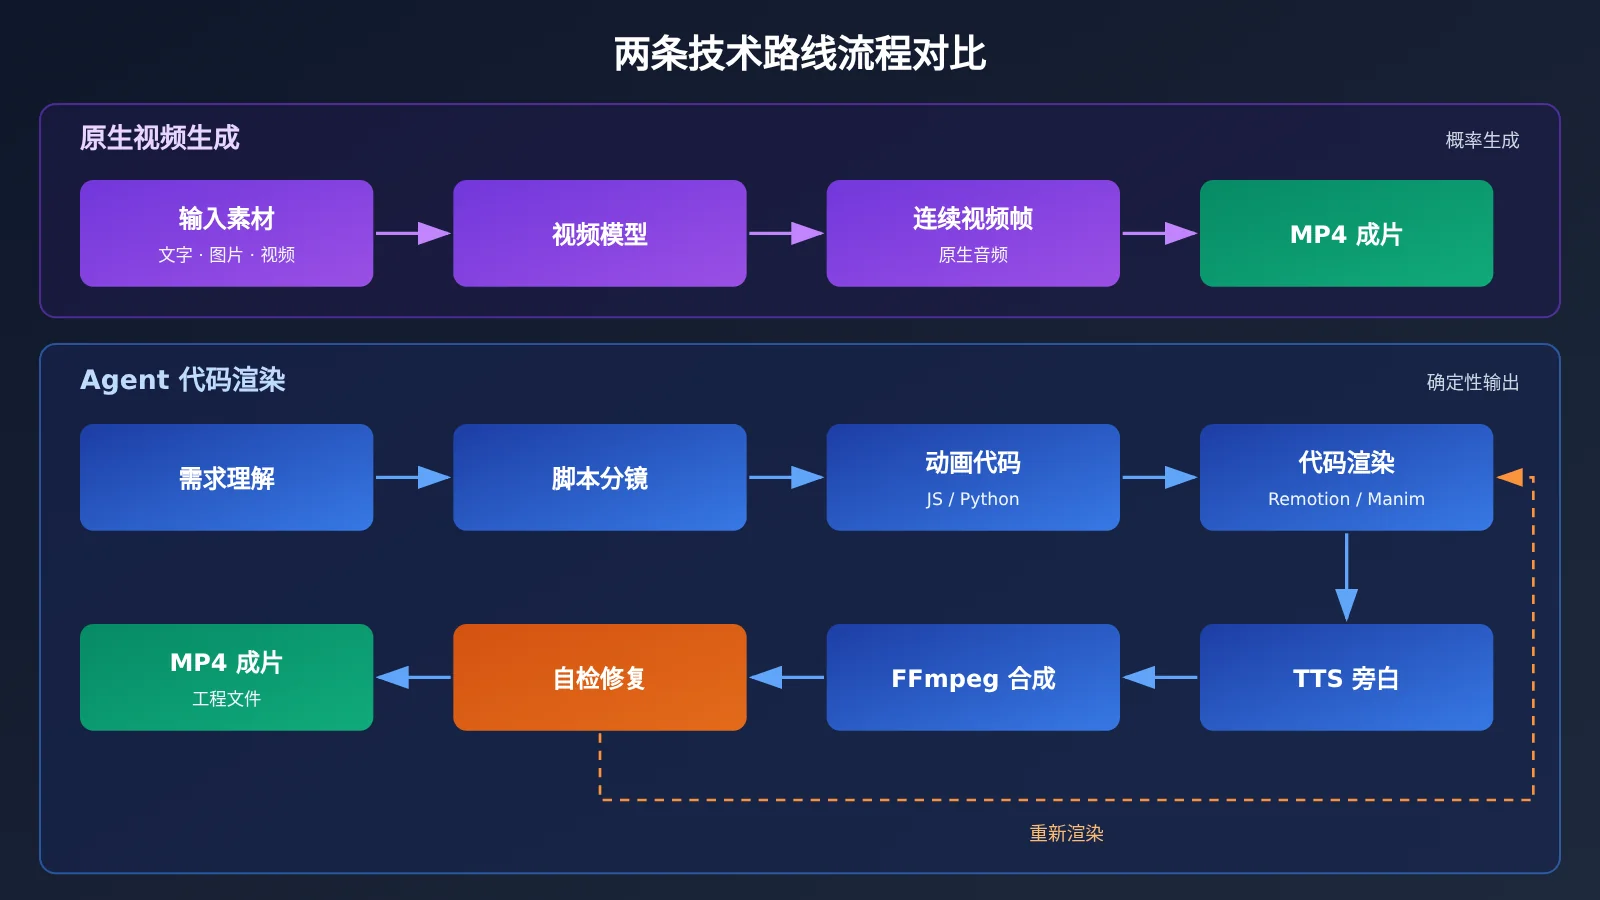
两条路线都能交付一段 MP4,但它们产出画面的方式完全不同。原生视频生成由模型直接“画”出每一帧;Agent 代码渲染则由模型写出一套视频制作程序,再由渲染引擎按程序输出画面。这一区别决定了两者在控制精度、可修改性和成本上的全部差异。
1.1 原生视频生成:模型直接创造连续画面
原生视频生成以 Text-to-Video 和 Image-to-Video 为基础。用户提供文字描述或参考图片,模型直接输出连续视频帧,画面中的人物、物体、环境、连续动作和物理运动都由模型一次性生成。镜头推拉、景别变化和场景切换同样可以写进提示词里。
新一代模型已经能同步生成原生音频,并支持用多张参考图片、参考视频控制人物外观、场景和视觉风格。它的优势是画面自然、真实感强;代价是每一帧都来自概率生成,同一提示词两次生成的结果并不相同,精确到像素的修改也依赖重新生成或专门的编辑功能。
1.2 Agent 代码渲染:AI 自己编写视频制作程序
Agent 代码渲染让大模型同时担任导演和程序员。一个完整的流程通常包括:
- 理解需求,确定主题、受众和视觉风格;
- 编写脚本、旁白、分镜和时间轴;
- 用 JavaScript、Python 编写动画代码(Remotion、Manim、Three.js、Cairo、Blender 等);
- 调用 TTS 生成旁白,制作音乐和音效;
- 调用 FFmpeg 合成音画;
- 检查画面、音频和时间同步,发现问题后修改并重新渲染;
- 输出 MP4 成片和可复用的工程文件。
这条路线的输出是确定性的:代码和参数不变,渲染结果就不变。修改一个数字、一行字幕或一个配色,只需改代码重新渲染,其他画面保持原样。它擅长数据可视化、产品介绍、知识科普和动态信息图,生成真实人物和实拍镜头则需要依赖现成素材或 3D 资产。
2 原生视频生成路线:适合什么任务
2026 年的原生视频模型已经把单次生成时长推到 30 秒,竞争重点转向多模态参考、关键帧控制和生成后的持续编辑。下表汇总三款代表模型的公开能力。
| 能力 | Seedance 2.5 | Kling 4.0 | Veo 3.1 |
|---|---|---|---|
| 发布/开放时间 | 2026-07-31 发布 | 2026-10-28 API 全面开放 | Gemini API 文档在列 |
| 单次生成时长 | 最长 30 秒 | 最长 30 秒 | 支持视频延长 |
| 参考素材 | 图片 30 张、视频 10 段、音频 10 段 | 图片 10 张、视频 5 段,混合最多 15 项 | 图片引导生成 |
| 核心控制方式 | 多轮延长、时间戳编辑、绿幕与机位编辑 | 最多 10 个关键帧、语音参考 | 末帧控制、视频延长 |
| 音频 | 支持音频参考 | 支持语音参考 | 原生音频生成 |
| 计费方式 | 按分辨率和时长(含 Token 消耗) | 按 Unit/秒 | 按生成规格 |
2.1 Seedance 2.5:30 秒连续生成与多模态参考
Seedance 2.5 由字节跳动 Seed 团队于 2026 年 7 月 31 日发布,单次生成最长 30 秒,一次生成可以包含多个连续镜头。它的参考能力是目前公开参数中最宽的:最多 30 张参考图片、10 段参考视频和 10 段参考音频,可以把角色设定、场景照片、动作参考和配乐一起交给模型组织成复杂场景。
编辑层面,Seedance 2.5 支持多轮延长已有视频并尽量维持人物、场景和声音的一致性,支持指定时间点修改人物动作和剧情,还支持绿幕编辑、摄像机视角编辑和多角色一致性。它还可以用 Clay Render(黏土渲染)参考控制空间结构、人物站位和镜头运动。官方示例覆盖京剧人物表演、舞台演出、多角色互动和连续场景转换,这类多角色、长镜头、连续叙事的内容正是代码渲染最难完成的部分。
2.2 Kling 4.0:关键帧与视频参考控制
Kling 4.0 于 2026 年 10 月 28 日全面开放 API,单次生成最长 30 秒,支持 720p 和 1080p,画面比例包括 21:9 和自适应比例。它的特色是最多 10 个关键帧:创作者可以在时间轴上锁定多个画面状态,让模型在关键帧之间补全运动,镜头走向和角色姿态因此更可控。
参考素材方面,Kling 4.0 支持最多 10 张参考图片、5 段参考视频,单次混合输入最多 15 项,并提供 Omni 多模态参考和语音参考。它把文本生成、图片生成、参考素材和视频编辑整合在一起,适合需要稳定角色形象、指定镜头路径或对已有视频做二次编辑的项目。
2.3 Veo 3.1:原生音频与视频延长
Google 在 Gemini API 中提供两类视频生成产品。Veo 3.1 侧重原生音频生成、视频延长、末帧控制和图片引导生成,适合一次产出“有声画面”的片段;Gemini Omni Flash 侧重多模态输入、角色一致性、视频理解和多轮对话式编辑。两者分别代表原生视频领域的两个方向:生成高质量片段,以及生成后持续编辑、修改和延长。
OpenAI 方面,Sora 产品已于 2026 年 4 月 26 日停止服务,Sora 2 模型及 Videos API 于 2026 年 9 月 24 日关停,官方弃用公告注明没有一对一替代 API。OpenAI 在 2026 年 11 月 4 日发布的 Images 2.6 支持 2 到 16 帧的 GIF 动画输出,适合动态表情、角色动作循环和分镜预览,与完整 MP4 视频制作属于不同工作流。
2.4 原生视频生成的优势与成本
原生视频生成的核心优势集中在四个方面:自然的人物动作、可信的物理运动、电影化的镜头运动,以及开放式的创意表达。这些能力用代码实现需要大量动画资产和人工调校,用视频模型则可以一次生成。
成本方面,原生视频按输出规格和时长计费。以 BytePlus ModelArk 2026 年 11 月 13 日更新的 Seedance 2.5 官方价格为例:
| 输出规格 | 5 秒视频参考价格 | 每秒估算 |
|---|---|---|
| 480p | $0.514 | $0.103 |
| 720p | $1.156 | $0.231 |
| 1080p | $2.843 | $0.569 |
从 720p 到 1080p,每秒成本约增加到 2.5 倍。上表为官方典型规格估算,输入视频的长度、分辨率、帧率和实际 Token 消耗都会影响最终账单。Kling 4.0 则以平台 Unit 计费:720p 为 1 Unit/秒,1080p 为 1.5 Units/秒,Kling 4.0 Flash 720p 为 0.6 Units/秒,涉及已有视频输入时还受输入时长影响;Unit 是平台计费单位,需要按平台规则换算成实际金额。
需要注意的是,这些价格对应的是“生成一次”的成本。原生视频存在随机性,实际生产往往要多次生成再挑选,最终可用镜头的成本通常高于单次报价。
3 Agent 代码渲染路线:让 AI 成为视频制作工程师
代码渲染路线的核心是一组成熟的开源或商业工具,大模型负责把需求翻译成这些工具能执行的代码,并完成调度、检查和修复。
3.1 Remotion:React 动画与自动化视频生产
Remotion 用 React 组件描述画面,通过帧号控制元素的位置、大小、透明度和运动。开发者可以直接使用 React、HTML、CSS 和 JavaScript 制作动画,画面中可以组合文字、图表、图片、视频和音频,并精确控制每一帧。它支持 CLI 批量渲染、服务端渲染和云端 Lambda 渲染,也可以通过传入不同参数批量生成不同内容的视频。
官方渲染流程很简洁:
# 安装 Remotion
npm install remotion @remotion/cli

# 渲染指定的视频组合(Composition)并输出 MP4
npx remotion render HelloWorld out.mp4
授权方面,Remotion 对个人及不超过 3 人的小公司免费,符合条款即可商用;Automators 方案按 $0.01/次渲染计费,最低月消费 $100;Creators 方案为 $25/席位/月;Enterprise 方案 $500/月起(2026 年 11 月 14 日更新)。Remotion 的渲染许可费和 AI 模型写代码消耗的 Token 费用是两笔独立成本,核算时要分开计算。
3.2 Manim:精确的数学与科学动画
Manim 是 Python 动画引擎,专门处理数学公式演示、几何图形变换、物理运动过程、算法运行原理和科学实验解释。公式、坐标轴、几何结构和对象之间的运动关系都由代码定义,因此每个符号、每条曲线的位置都准确可控。原生视频模型生成的公式经常出现字符错误或结构错误,这正是 Manim 的优势领域。
官方快速上手示例一条命令即可输出 MP4:
manim -pql main.py CreateCircle
3.3 FFmpeg:把各种素材变成最终视频
FFmpeg 是整条代码渲染链路的“总装线”。它负责视频编码与转码、音频合并、多片段拼接、字幕烧录、裁剪缩放、帧率转换和格式转换。配套的 ffprobe 可以读取成片的分辨率、帧率、时长和音轨信息,Agent 用它做自动验收:规格不达标就回到上一步修复。
# 拼接片段(list.txt 中按行列出各片段文件)
ffmpeg -f concat -safe 0 -i list.txt -c copy merged.mp4

# 合并旁白并烧录字幕
ffmpeg -i merged.mp4 -i voice.mp3 -vf subtitles=subs.srt \
  -map 0:v -map 1:a -c:v libx264 -c:a aac final.mp4

# 检查输出规格
ffprobe -v error -show_entries stream=codec_type,width,height,r_frame_rate \
  -show_entries format=duration final.mp4
3.4 Claude Motion:代码动画成为普通产品功能
Anthropic 于 2026 年 10 月 8 日推出 Claude Motion Beta,把代码驱动动画直接交付给企业用户。用户用自然语言描述动画需求,Claude 把文字、图表、形状和图片组织成代码动画并保存在 Artifacts 中;用户可以继续通过对话修改,也可以进入编辑器手工调整,最后导出 MP4。
典型用途包括:把季度财报转成 30 秒解释动画、把定价方案做成动态对比图、把产品操作步骤做成引导动画、把会议材料做成内部宣传视频。使用条件方面,Beta 面向 Team 和 Enterprise 用户开放,Team 默认开启,Enterprise 需要组织管理员开启,使用量计入套餐额度。Claude Motion 不调用原生视频生成模型,因此不能生成真实人物或实拍风格的连续镜头。
Claude Motion 的产品价值在于门槛:企业里的运营、财务、市场人员无需搭建 Remotion 工程,就能直接获得代码动画的精确性和可修改性。
3.5 GPT + Codex:Agent 调用工具完成视频制作
另一种形态是让通用模型在 Agent 开发环境中自主调用工具。2026 年 10 月 26 日发布的 VibeVideoBench 专门评测这一能力:239 项真实视频制作任务覆盖数据故事、教育课程、论文解读、品牌营销、产品功能展示等 12 类内容,每项任务要求 AI 在沙箱中 60 分钟内自主交付可播放的 MP4、可重新生成视频的工程项目,以及时间安排和制作说明。9 个智能体系统共完成 2,151 次运行,均在各自原生开发环境、最高可用推理强度下运行,不允许中途追加人工指令。
排名前两位的系统对比如下(三评审团平均,评分范围 1–5 分):
| 指标 | GPT-6 Astra(Codex CLI) | Claude Opus 5.5(Claude Code) |
|---|---|---|
| 成功交付视频 | 238/239(99.6%) | 239/239(100%) |
| 规格符合率 | 93.7% | 99.6% |
| 任务要求通过率 | 97.1% | 97.3% |
| 综合质量得分 | 4.109 | 4.074 |
| 严格任务成功率 | 74.5% | 76.3% |
| 人类偏好 Elo | 1242 | 1203 |
| 平均任务成本 | $8.19 | $15.38 |
| 中位 / P90 任务成本 | $7.88 / $11.88 | $10.19 / $31.22 |
| 平均输出 Token | 61K | 130.7K |
| Cache Hit | 97% | 65% |
在这组测试中,GPT-6 Astra 的综合质量和人工偏好略高,平均任务成本低约 46.7%;Claude Opus 5.5 交付了全部 239 项任务,规格符合率和严格任务成功率更高。成本差异的主要来源是 Token 使用效率:Astra 的输出 Token 少约 53.3%,缓存命中率达到 97%,而 Opus 约 76% 的任务成本来自 Cache Write。尽管 Astra 的标准输入输出单价是 Opus 的 2.5 倍,完成单个任务的实际花费反而更低。
解读这组数据需要结合评测口径:评测对象是“模型 + 执行环境”组成的完整智能体系统,GPT 与 Claude 使用的 Codex CLI 和 Claude Code 本身存在差异;每项任务只运行一次,时限 60 分钟;三个评审团的系统排名相关系数为 0.933–0.950,与人工 Elo 排名的相关系数为 0.98,但单个视频的人工偏好与评审结果一致率为 73.3%。因此这些分数适合用来判断系统级的大致水平,不适合推广到所有视频任务,也不能替代原生 Text-to-Video 模型的评测。
VibeVideoBench 还揭示了 Agent 做视频的主要瓶颈:2,151 次运行中有 224 次没有交付可播放视频,其中 169 次属于时间管理问题,包括最终渲染启动太晚、运行过慢或根本没有启动,约占失败案例的 75%。视频 Agent 的难点已经从“会不会写动画代码”转向渲染调度和交付管理。
与 Claude Motion 相比,Codex、Claude Code 这类 Agent 环境面向开发者:可以自由组合 Remotion、Manim、FFmpeg、TTS 和屏幕录制,产出完整工程文件,适合接入自动化生产线;Claude Motion 面向企业终端用户,交互更简单,能力边界集中在文字、图表和形状动画。
4 原生视频生成与 Agent 代码渲染怎么选
4.1 适合原生视频生成的任务
- 人物实拍风格:真人出镜、表情和肢体动作;
- 产品使用场景:产品在真实环境中被使用的画面;
- 自然运动和镜头语言:推拉摇移、跟拍、景别切换;
- 电影感广告:光影、氛围和质感优先的品牌片;
- 角色表演和连续剧情:多角色互动、长镜头叙事;
- 复杂自然环境:天气、水流、城市街景等难以建模的场景。
4.2 适合代码驱动制作的任务
- 精确数据图表:数字、坐标、比例必须准确;
- 软件操作教程:界面录屏加标注、高亮和步骤说明;
- 数学和科学讲解:公式推导、几何变换、算法演示;
- 动态信息图:结构化信息的分步呈现;
- 产品参数对比与价格说明:每个数值都可核对、可修改;
- 模板化批量内容:同一模板替换数据批量生成上百条视频。
下表汇总两条路线在常见任务上的适配程度:
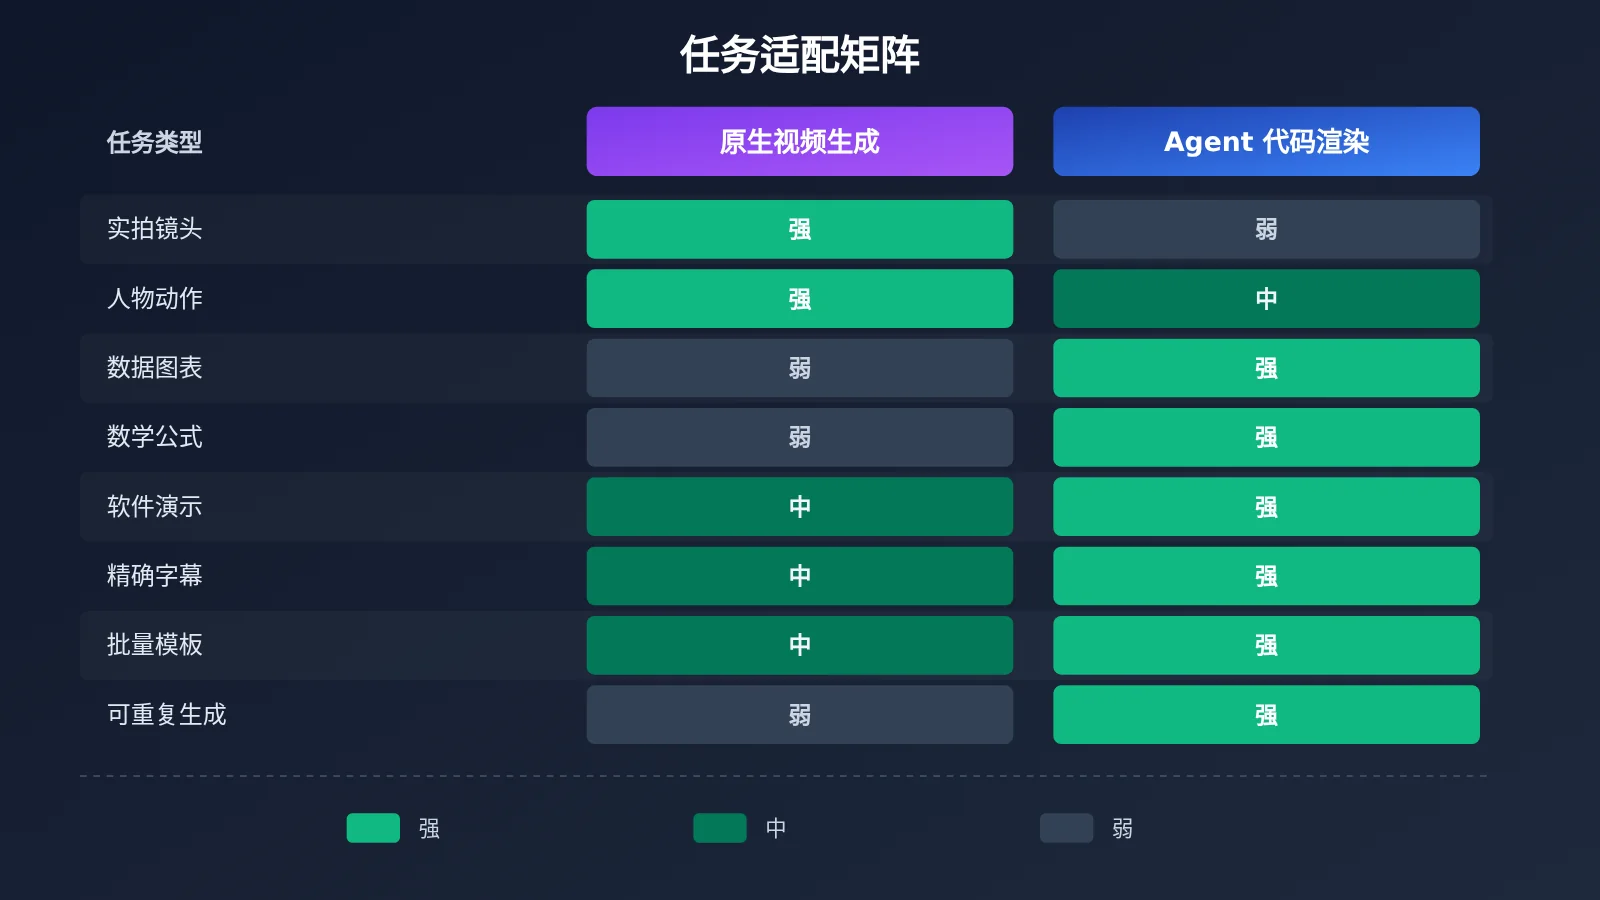
| 任务 | 原生视频生成 | Agent 代码渲染 |
|---|---|---|
| 电影感实拍镜头 | 强 | 需要现成素材或 3D 资产 |
| 人物自然动作 | 强 | 依赖动画资产 |
| 复杂镜头运动 | 强 | 可以精确编程 |
| 精确展示数据 | 较难保证 | 强 |
| 数学公式动画 | 容易出错 | 强 |
| 软件界面演示 | 需要参考和后期处理 | 强 |
| 精确字幕 | 需要后期校对 | 强 |
| 产品动态展示 | 强 | 强 |
| 统一模板批量生产 | 需多次生成和筛选 | 强 |
| 单个细节精确修改 | 依赖重新生成或编辑 | 强 |
| 可重复生成相同动画 | 受随机性影响 | 强 |
VibeVideoBench 的研究同样指出,代码渲染尤其适合准确公式、数据图表、规则一致的游戏画面和同步旁白等任务。
💡 选择建议:判断标准可以简化为一句话——画面需要“像真的”就用原生视频模型,信息需要“准确无误”就用代码渲染。代码渲染链路中的脚本、分镜和动画代码都依赖通用大模型,我们建议先通过 API易 apiyi.com 用同一个 API Key 分别测试 GPT、Claude、Gemini 在你的脚本和代码任务上的表现,再决定主力模型。
4.3 两条路线的成本结构
两条路线的成本构成差别很大,直接比较单价意义有限:
- 原生视频生成:主要按输出分辨率和时长计费,叠加参考视频输入带来的额外消耗;随机性导致的多次生成和筛选是隐性成本。
- Agent 代码渲染:包括通用模型的 Token 费用(输入、输出、缓存读写)、代码执行和渲染算力、工具许可(如 Remotion 商业授权)、TTS 和音乐音效素材费用。
比较时应以“最终可交付视频的总成本”为准:一条原生视频镜头如果要生成五次才选出一次可用结果,它的真实成本就是报价的五倍;一个 Agent 任务如果缓存命中率低、反复重渲染,Token 费用同样会快速上升。VibeVideoBench 的数据说明,单价更高的模型可以因为更少的输出 Token 和更高的缓存命中率实现更低的任务成本,模型选型时要看实测的单任务花费。
💰 成本优化:代码渲染链路的模型费用占比较高,并且多为长上下文、多轮调用。通过 API易 apiyi.com 按量调用多个主流模型,可以用同一套代码对比不同模型完成同一视频任务的实际花费,再按任务类型分配模型。
5 最有效的方案:组合两条 AI 视频技术路线
5.1 混合生产流程
把两条路线组合起来,让原生视频模型负责自然画面,让代码渲染负责精确表达,是当前最可落地的方案:
- 创意与分镜:GPT 或 Claude 负责创意、脚本和分镜,并为每个镜头标注生产方式;
- 自然镜头:Seedance、Kling 或 Veo 生成人物、场景和产品使用镜头;
- 精确画面:Remotion 负责数据图表、字幕、品牌元素和产品参数动画;
- 旁白:TTS 根据脚本生成旁白;
- 合成:FFmpeg 拼接镜头、合并音轨、烧录字幕;
- 验收与修正:AI Agent 用 ffprobe 检查规格,并检查音画同步和字幕,发现问题后回到对应环节修复。
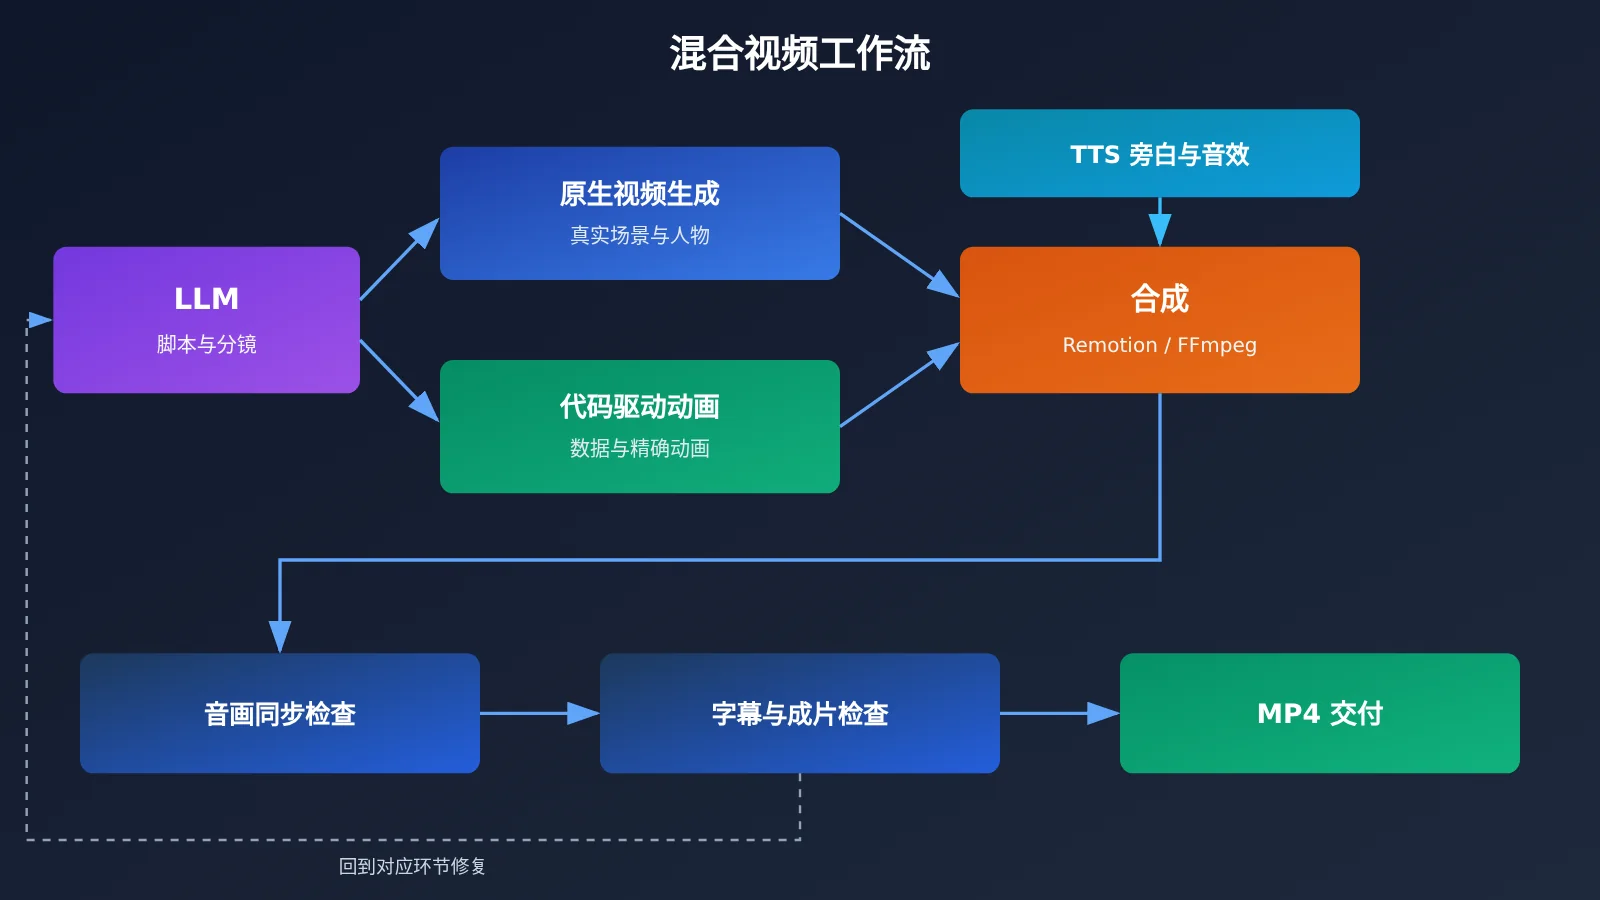
上图中,脚本分镜和成片检查两个环节都由通用大模型完成,这部分调用可以统一接入 API易 apiyi.com,用一个 OpenAI 兼容接口在 GPT、Claude、Gemini 之间切换。
5.2 贯穿示例:一条产品宣传片的分工
以一条移动应用的产品宣传片为例,各部分可以这样分工:
- 开场氛围镜头(用户在通勤、办公场景中使用产品):交给 Seedance 2.5 或 Kling 4.0。用产品照片和角色设定图作为参考,保证人物和产品外观一致;Kling 4.0 可以用关键帧锁定开场和收尾的构图。按 Seedance 2.5 官方估算,720p 每秒约 $0.231,规划预算时还要预留多次生成的余量。
- 功能演示段:录制真实应用界面,再用 Remotion 叠加高亮框、步骤编号和动态标注。界面内容来自真实录屏,不会出现模型“编造”的按钮。
- 参数与价格段:用 Remotion 组件渲染功能对比表和价格卡片。价格调整时只改数据文件重新渲染,其他画面保持不变。
- 旁白与字幕:大模型写旁白稿,TTS 生成语音,同时输出 SRT 字幕文件。
- 总装与验收:FFmpeg 拼接所有片段并合成音轨,Agent 用 ffprobe 核对时长、分辨率和音轨,再逐段检查字幕与旁白是否同步。
这种分工的结果是:真实感镜头由视频模型保证,所有可核对的信息由代码保证,后续改版只需重渲染对应片段。
5.3 用 API 生成带分流标注的分镜
混合流程的第一步是让大模型输出结构化分镜,并为每个镜头标明走哪条路线。以下示例使用 OpenAI 兼容接口完成这一步:
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

MODEL = "your-model-name"  # 替换为平台模型列表中的实际模型名

prompt = """为一款记账 App 写 30 秒宣传片分镜,输出 JSON 数组。
每个镜头包含 id、duration、description、route 字段。
route 只能是 native(真实人物与场景,交给视频模型)
或 code(数据、参数、字幕、界面标注,交给 Remotion 渲染)。"""

resp = client.chat.completions.create(
    model=MODEL,
    messages=[{"role": "user", "content": prompt}],
)
print(resp.choices[0].message.content)
查看完整实现:分镜分流 + 生成 Remotion 渲染参数
import json
import subprocess
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

PLANNER_MODEL = "your-planner-model"  # 负责创意和分镜的模型
CODER_MODEL = "your-coder-model"      # 负责生成渲染参数/代码的模型


def plan_storyboard(brief: str) -> list[dict]:
    """让模型输出带 route 标注的分镜 JSON。"""
    resp = client.chat.completions.create(
        model=PLANNER_MODEL,
        messages=[
            {"role": "system", "content": "你是视频导演,只输出合法 JSON 数组。"},
            {"role": "user", "content": brief},
        ],
    )
    return json.loads(resp.choices[0].message.content)


def build_remotion_props(shot: dict) -> dict:
    """为 code 路线的镜头生成 Remotion 组件参数。"""
    resp = client.chat.completions.create(
        model=CODER_MODEL,
        messages=[
            {"role": "system", "content": "把镜头描述转换为 Remotion 组件 props,只输出 JSON 对象。"},
            {"role": "user", "content": json.dumps(shot, ensure_ascii=False)},
        ],
    )
    return json.loads(resp.choices[0].message.content)


def render_code_shot(shot_id: str, props: dict) -> str:
    """调用 Remotion CLI 渲染单个镜头。"""
    out = f"out/{shot_id}.mp4"
    subprocess.run(
        ["npx", "remotion", "render", "InfoCard", out,
         f"--props={json.dumps(props, ensure_ascii=False)}"],
        check=True,
    )
    return out


if __name__ == "__main__":
    shots = plan_storyboard("为一款记账 App 写 30 秒宣传片分镜,"
                            "字段:id、duration、description、route(native/code)。")
    for shot in shots:
        if shot["route"] == "code":
            path = render_code_shot(shot["id"], build_remotion_props(shot))
            print("已渲染:", path)
        else:
            # native 镜头交给视频生成模型,此处记录提示词待生成
            print("待原生生成:", shot["id"], shot["description"])
🚀 快速开始:上面的分镜和参数生成步骤只需要通用大模型。建议在 API易 apiyi.com 注册后使用新用户免费测试额度,先让两三个模型各跑一遍同一份宣传片需求,对比分镜质量和 Token 消耗,再固定到生产流程中。
6 总结:AI 视频竞争的重点是完整生产工作流
两条技术路线的任务适配关系已经很清晰:原生视频生成负责真实画面、人物表演和镜头语言,Seedance 2.5、Kling 4.0、Veo 3.1 在 30 秒连续生成、多模态参考、关键帧和持续编辑上各有侧重;Agent 代码渲染负责精确信息、可重复渲染和批量生产,Remotion、Manim、FFmpeg 构成工具底座,Claude Motion 把它产品化给企业用户,Codex、Claude Code 让开发者搭建完整的自动化管线。
VibeVideoBench 的结果显示,顶尖 Agent 系统已经能稳定交付完整视频,失败的主因集中在渲染调度和时间管理;单任务成本则取决于 Token 效率和缓存命中率,而不是模型单价。这意味着视频生产的竞争正在从单个模型的画质,转向“生成、编辑、渲染、交付”整条工作流的组织能力。
核心要点回顾:
- 路线区别:原生生成由模型直接产出画面,代码渲染由模型写程序再渲染;
- 原生生成适用:人物、实拍感、自然运动、电影感广告和连续剧情;
- 代码渲染适用:数据图表、公式、软件教程、参数价格和模板化批量内容;
- 成本比较口径:以最终可交付视频的总成本为准,计入重试、Token、渲染和许可费用;
- 最佳实践:混合工作流,让视频模型负责自然画面,让代码负责精确表达;
- 多模型调用:脚本、分镜、动画代码和成片检查分别适合不同模型,统一接口能降低切换成本。
实际生产中,一条视频往往要调用多个大模型分别完成创意、编码和检查。推荐通过 API易 apiyi.com 用一个 API Key 统一调用 GPT、Claude、Gemini 等模型,按任务分配模型并按量计费,把精力集中在工作流本身。
参考资料
- VibeVideoBench 官方评测:代码驱动视频生成的智能体评测
- 链接:
vibevideobench.github.io -
说明: 239 项任务排行榜、质量分数、成本与失败原因分析
-
Seedance 2.5 官方公告:30 秒生成与多模态参考
- 链接:
seed.bytedance.com/en/blog/one-take-creation-flexible-referencing-introducing-seedance-2-5 -
说明: 参考素材上限、延长与时间戳编辑能力
-
BytePlus ModelArk Pricing:Seedance 2.5 API 价格
- 链接:
docs.byteplus.com/en/docs/modelark/model-pricing -
说明: 不同分辨率的视频生成参考价格
-
Kling API 文档:Kling 4.0 更新公告与计费
- 链接:
kling.ai/document-api/apiReference/updateNotice -
说明: 关键帧、多素材参考和 Unit 计费规则
-
Gemini API 视频生成文档:Veo 3.1 与 Gemini Omni Flash
- 链接:
ai.google.dev/gemini-api/docs/video -
说明: 原生音频、视频延长和多轮编辑能力
-
Remotion 文档与授权价格
- 链接:
remotion.dev/docs/render、remotion.dev/docs/license/pricing -
说明: 渲染命令与商业授权方案
-
Manim Community 文档
- 链接:
docs.manim.community/en/stable -
说明: 数学与科学动画引擎用法
-
FFmpeg 官方文档
- 链接:
ffmpeg.org/documentation.html -
说明: 编码、合成、字幕和 ffprobe 检查
-
Claude Motion 使用指南
- 链接:
support.claude.com/en/articles/17454997-get-started-with-claude-motion -
说明: Beta 功能流程与开放条件
-
OpenAI API Deprecations
- 链接:
developers.openai.com/api/docs/deprecations - 说明: Sora 2 及 Videos API 关停信息
- 链接:
作者: APIYI 技术团队
技术交流: 欢迎在 API易官网首页联系我们,更多接入资料可访问 docs.apiyi.com 文档中心