2026年10月27日、Google DeepMindは次世代の世界モデル Genie 4 を発表しました。最大の変化は、生成された世界に音が生まれ、登場人物が話せるようになったこと。さらに、映像を見ながらテキストを入力してシーンを変更できます。公式Xの発表投稿は、10月28日午前の時点で約170万回表示され、1万5300件の「いいね」を獲得しました。ただし、現在利用できるのは、公式が選んだ少数の信頼できるテスターだけです。
この記事のポイント:Genie 4の新機能、現在の利用状況、次にできることを3分で把握できます。
Genie 4の変化:世界が自ら声を発する
ひとことで言うと、Genie 4が生成するのは、見るだけの無音のシーンではなく、音が鳴り、応答し、気軽に変更できる世界です。
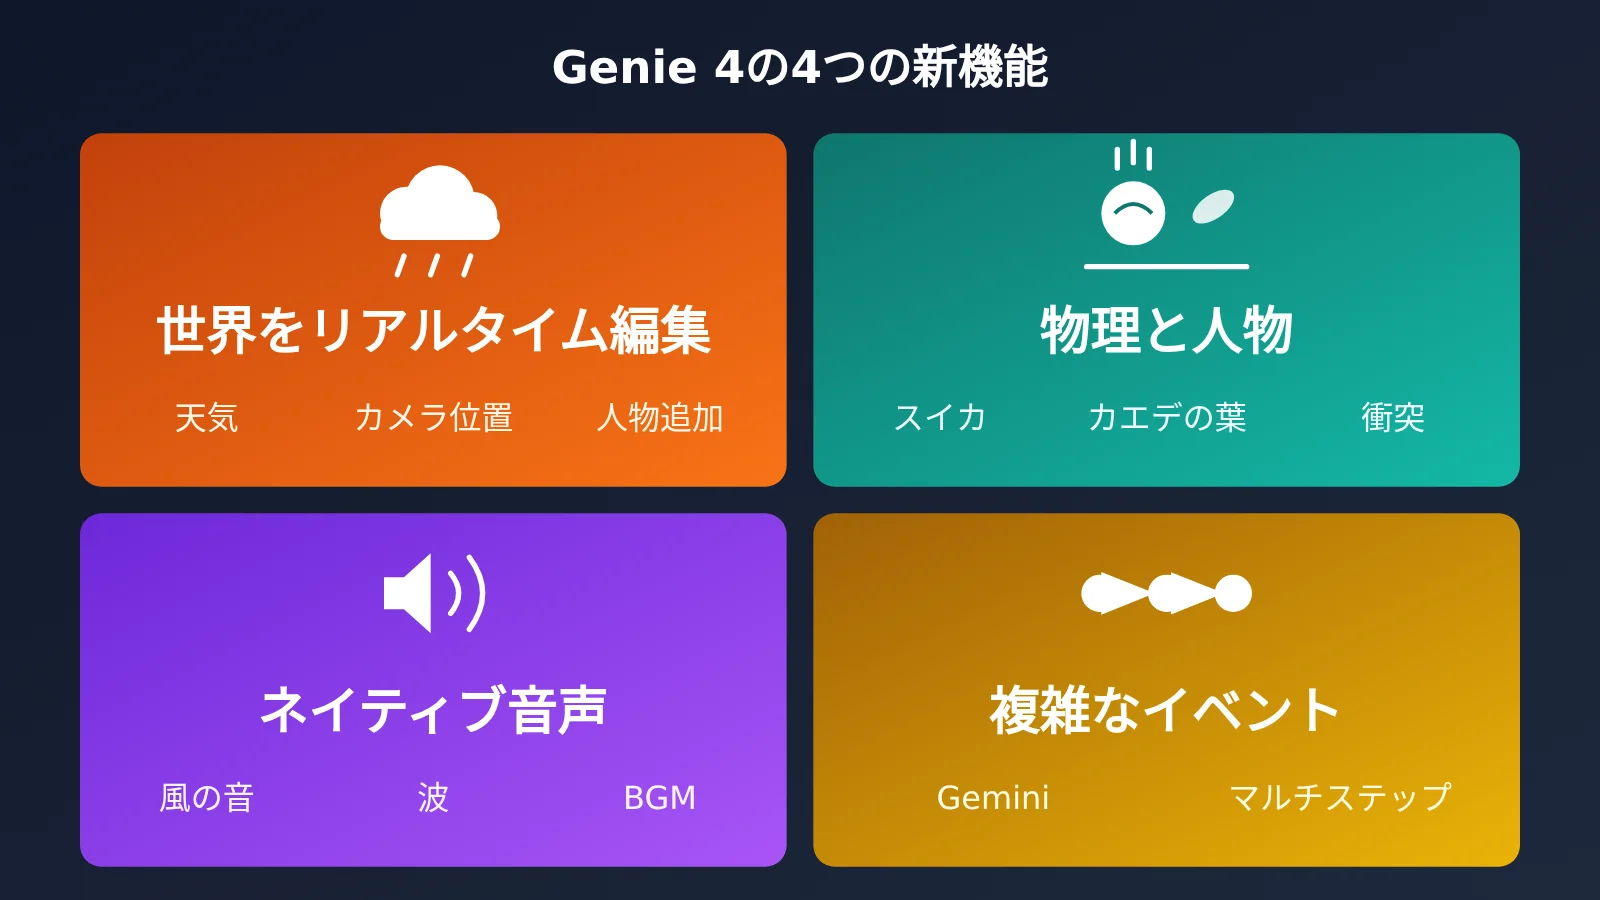
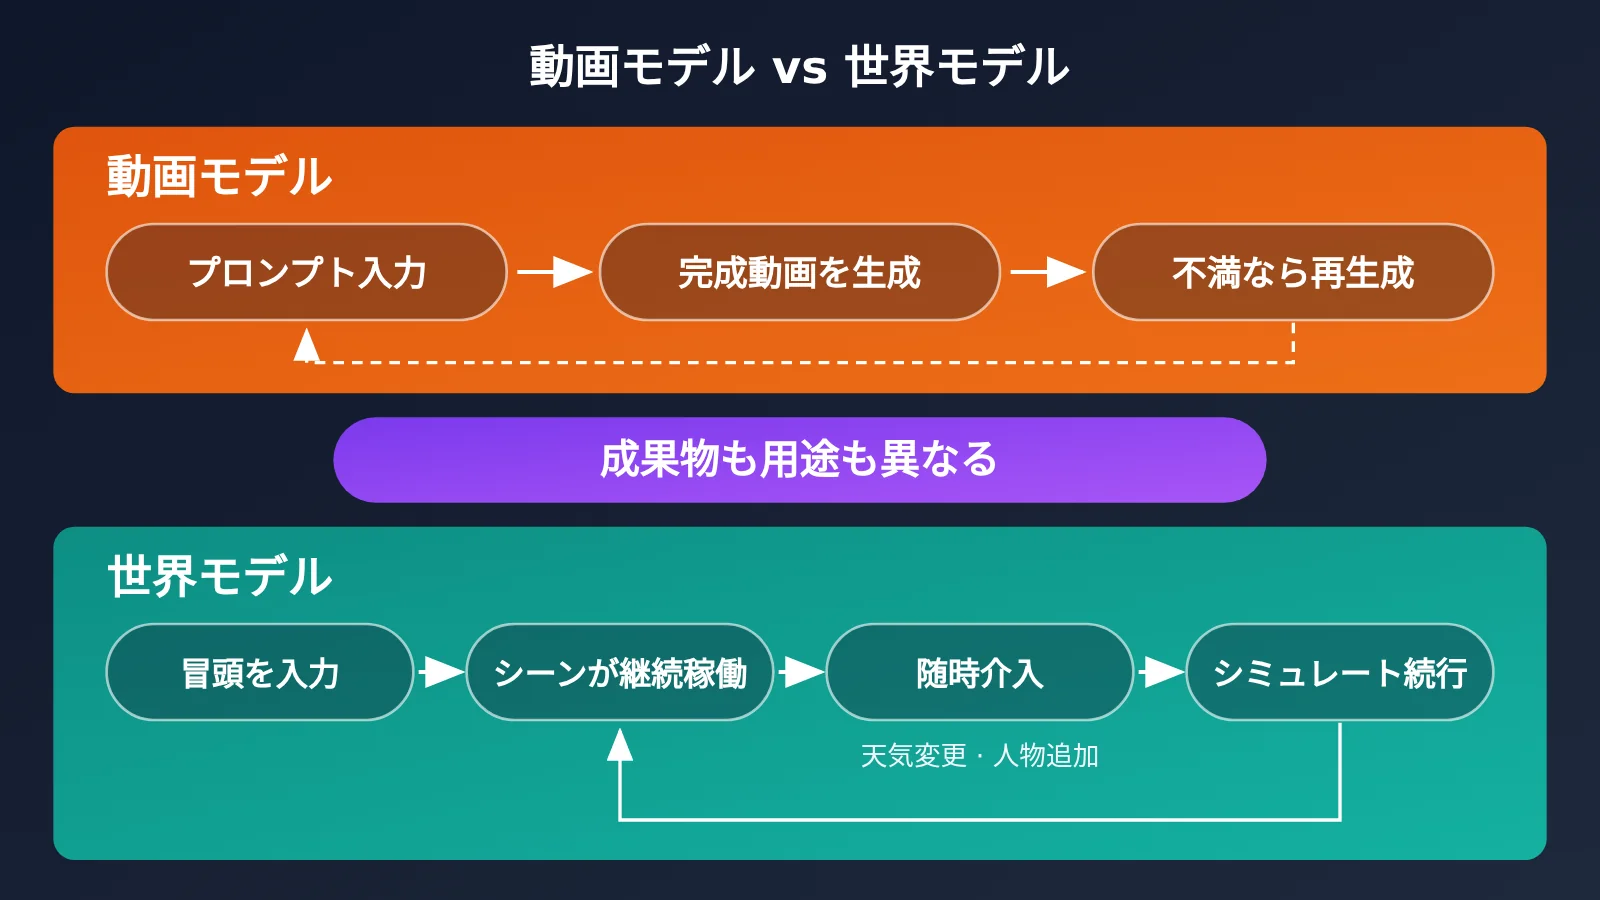
まずは「世界モデル」について説明します。動画モデルから得られるのが撮影済みの完成映像だとすれば、世界モデルはライブ公演に近いものです。俳優が舞台に立ち続け、あなたが「雨を降らせて」と声をかけると、舞台に雨が降り始め、その後の展開も変わっていきます。公式ブログでは、Genie 4の進化を4つの能力にまとめています。以下で順に見ていきましょう。
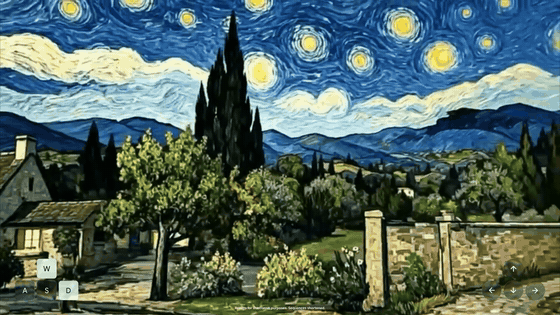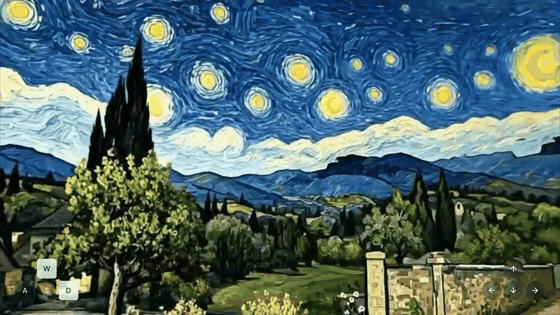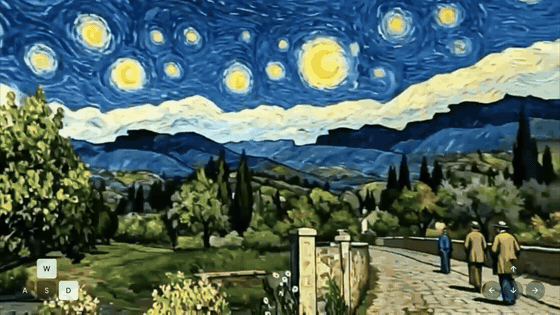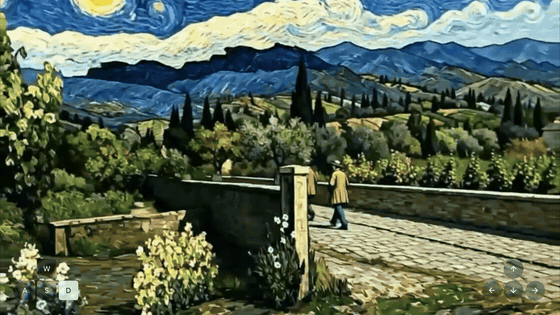
画像:公式発表動画では、人物がゴッホの『星月夜』に描かれた世界に入っていきます。出典:Google DeepMind公式発表投稿(2026-10-27)、公式デモ映像。
Genie 4の能力その1:世界をリアルタイムで変える
公式ブログによると、自然言語を使って、実行中のシミュレーションをリアルタイムで変更できます。例えば、天気を変えたり、カメラの位置を動かしたり、新しい人物や物体を追加したりできます。公式デモでは、映像の再生中に指示を入力すると、天気が変わり、カメラが移動し、場面に人物が追加されます。
重要なのは、Geminiが周囲の状況を踏まえ、入力されたプロンプトを現在の映像により適した指示に書き換えるという点です。入力と入力の間もGeminiが場面を観察し、展開を導くため、入力をやめても世界が「止まる」ことはありません。
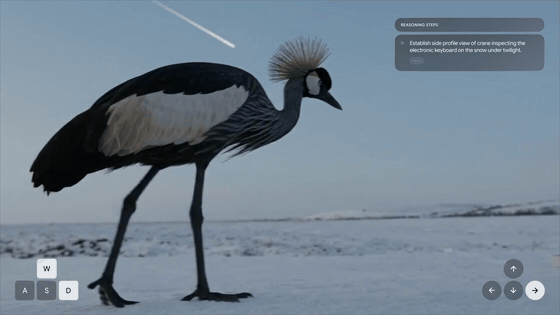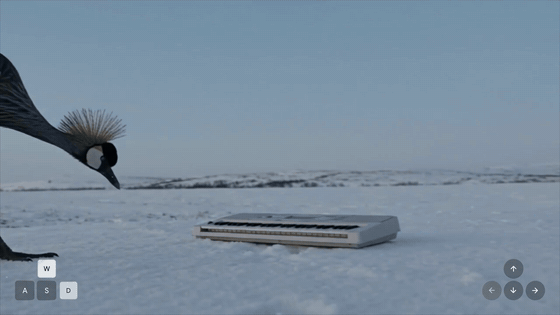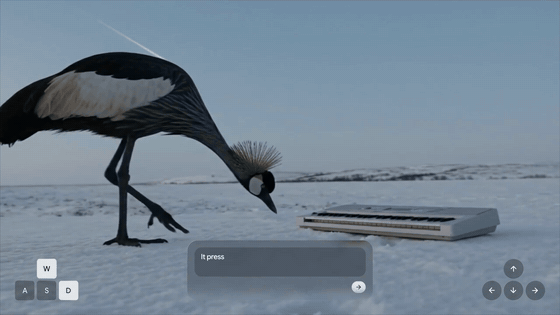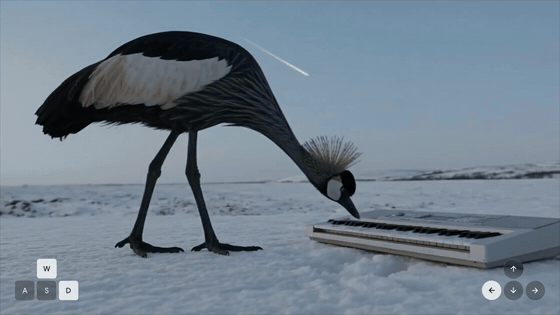
図:映像の再生中にプロンプトを入力すると、雪原にピアノが現れ、鶴が近づいて鍵盤に降り立ちます。出典:同上。
Genie 4の能力その2:物理現象と人物がよりリアルに
公式ブログによると、Genie 4は空気力学や衝突といった現実の物理現象をシミュレートできます。デモには、スイカが地面に落ちる様子や、カエデの葉が舞い落ちて互いにぶつかる様子が収められています。ただし、いずれもGoogle自身が公開したデモであることには注意が必要です。
公式によると、最も大きく進歩したのは「人」の表現です。キャラクターの動きがより自然になり、環境に反応するほか、リアルタイムで操作することもできます。前世代のGenie 3では人物の動きが比較的ぎこちなかったため、今回はこれを主要な改善点として挙げています。
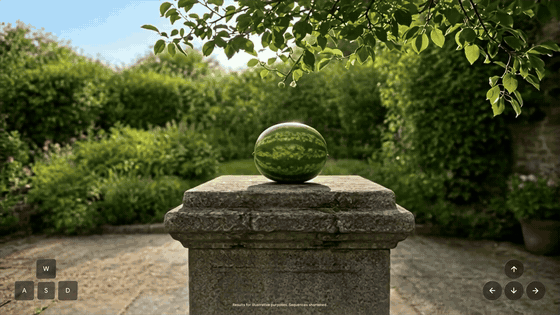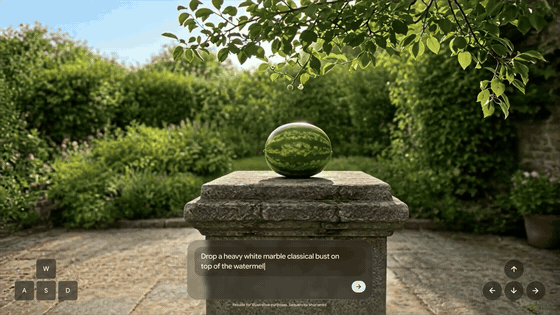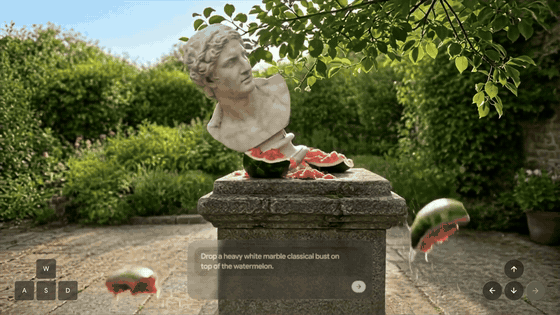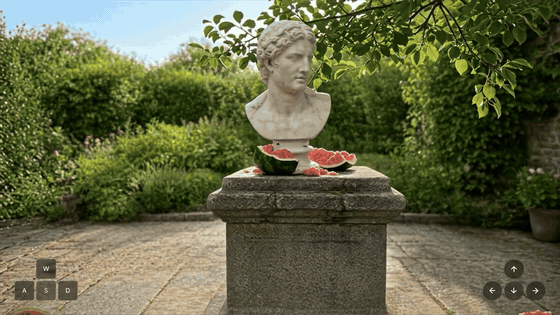
図:「大理石の胸像をスイカにたたきつける」と一文を入力するだけで、場面に胸像が生成され、スイカが砕けて果肉が飛び散ります。出典:同上。
Genie 4の能力その3:音声をネイティブ生成
公式発表によると、Genie 4は「音声をネイティブに生成する初のリアルタイム世界モデル」です。それぞれの世界には、森の風の音から波の音まで、その場に合った環境音が付き、BGMを流すこともできます。これらの音は映像と同期して生成されるもので、後から別途付け加えたものではありません。
さらに、会話も可能です。公式ブログによると、キャラクターはユーザーの入力や世界の中で起きた出来事に反応し、リアルタイムで話し始めます。早期体験者の@venturetwinsはXでこれを「大きな一歩」と評し、特に「ネイティブ音声もある」と言及しています。ただし、これは個人の感想であり、効果がすでに検証されたことを意味するものではありません。
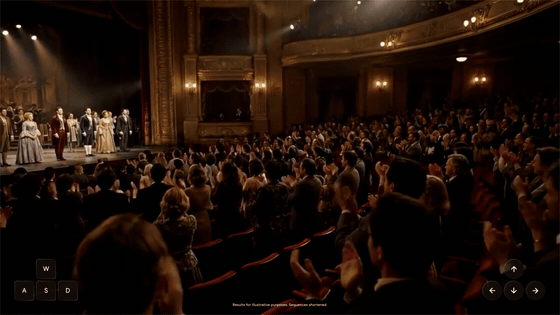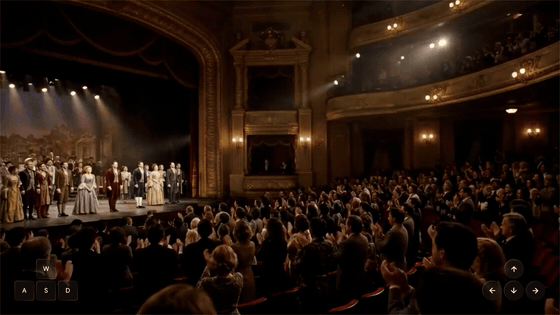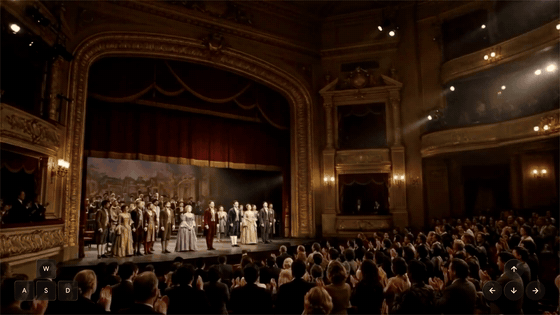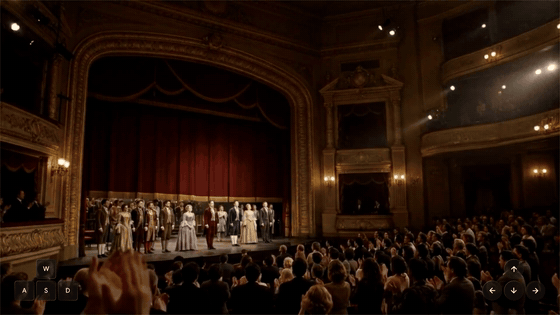
図:オペラハウスの世界でカメラが自動的に上を向き、ドーム型の天井がはっきり見えます。元の動画には環境音とキャラクターの会話がありますが、GIFには音声を収録できません。出典:同上。
Genie 4の能力その4:Geminiで複雑なイベントをシミュレーション
公式ブログによると、Genie 4はGeminiと組み合わせることで、複数のステップからなるイベントをシミュレーションできます。これにより、AIシステムを実世界で動かす前に、シミュレーション環境で対応方法を検証できます。この機能は主にロボット工学などの研究を対象としており、一般ユーザーが近いうちに利用できるものではありません。
Genie 4の二つ目の変化:実は3種類のモデルが連携している
結論を一言でいうと、Genie 4がピクセルを描き出し、複数のGeminiモデルがそれぞれ外観、進行管理、タスクの分解を担当します。
公式ブログによると、Gemini Omniはシミュレーションの外観や振る舞いを現実世界に即したものにする役割を担います。つまり、画面の中のものを本物らしく見せるということです。Omniに関するこれまでの情報は、「Gemini Omni動画モデル情報まとめ:8つの兆候からI/O 2026での発表を予測」をご覧ください。
公式が挙げた2つ目のモデルはGemini 3.8 Flashです。公式はこれを「ループ内のガイドエージェント」と呼んでいます。画像を描くのではなく、撮影現場の監督兼記録係のような役割です。画面を継続的に観察し、目標を一つひとつのアクションに分解したうえで、生成された画面を見直して各ステップが完了したかを判断します。世界の状況が変わったり、ユーザーが途中で指示を加えたりすれば、その場で計画を調整します。
3つ目はGemini 4 Argonで、Gemini Roboticsに関連する実験に登場します。公式が挙げた例では、Argonが「チャイニーズチェッカーをプレイする」というタスクをステップに分解し、テキスト字幕としてリアルタイムでGenie 4に渡します。そしてGenie 4が、ApptronikのヒューマノイドロボットApolloがゲームをプレイする映像を描画します。
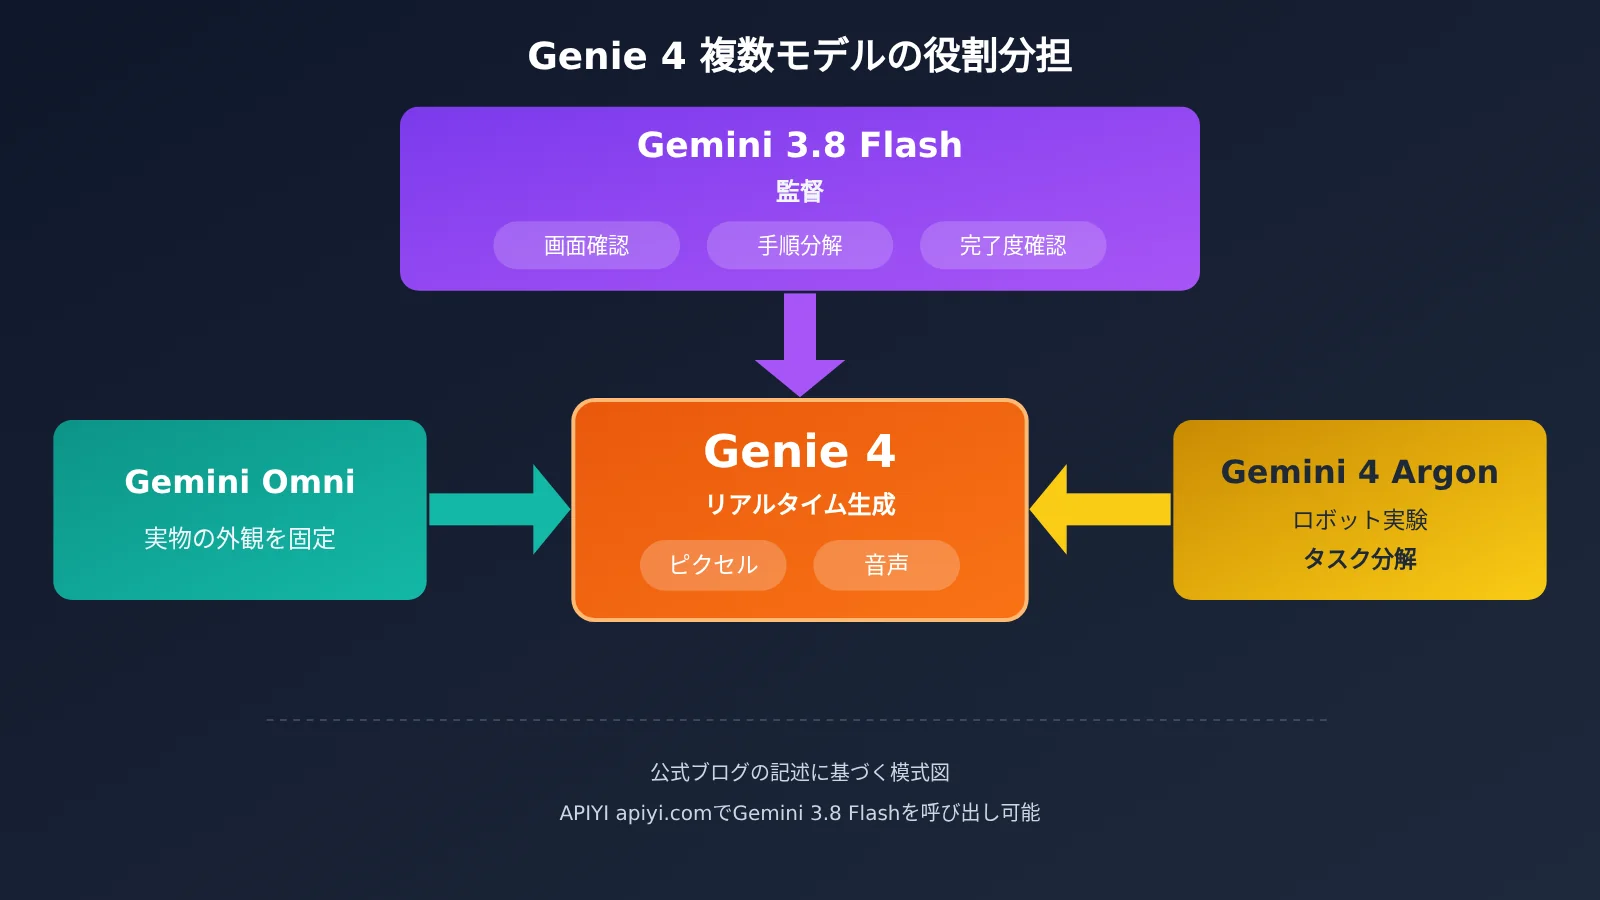
TechCrunchが引用したブリーフィングの内容によると、Googleの研究ディレクターTejas Kulkarni氏は、将来的に「ハイブリッド世界モデル」が登場すると述べています。Geminiがコードやテキストを書き、Genieがそれらをリアルタイムで受け取って現実をシミュレーションするというものです。公式ブログも同じ方向性を示しており、Geminiが構造と物語のタイムラインを担当し、Genieがピクセル単位の物理表現を担うとしています。
Genie 4の第3の変化:Veoのような動画モデルとは別物
一言でいうと、動画モデルが届けるのは完成した映像であり、世界モデルが届けるのは、動き続け、いつでも介入できる現場です。
両者が解決する課題は異なり、どちらかがもう一方に取って代わるものではありません。Veoのような動画モデルは、作品にそのまま組み込める固定された映像クリップの制作に向いています。一方、Genie 4はアイデアの検討や事前検証、インタラクティブなプロトタイプの制作に適しています。公式も完成映像の制作ツールとは位置づけておらず、ゲームエンジンを代替できるとも述べていません。
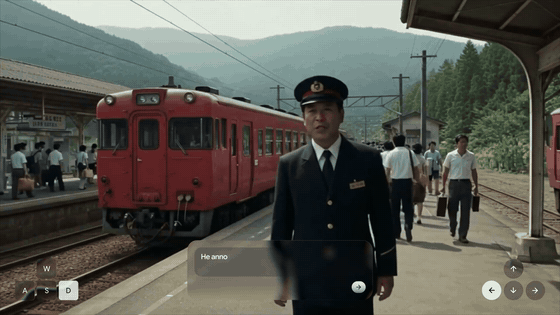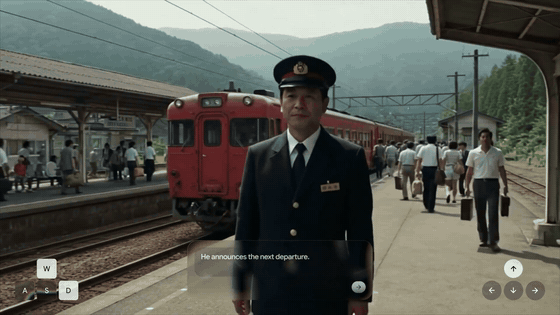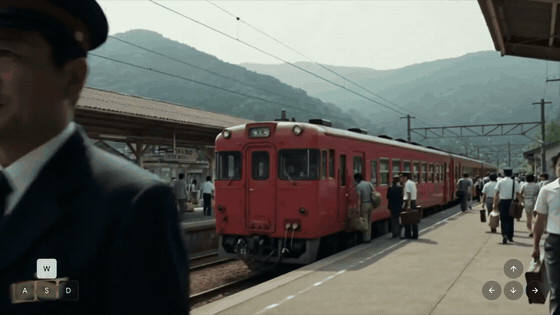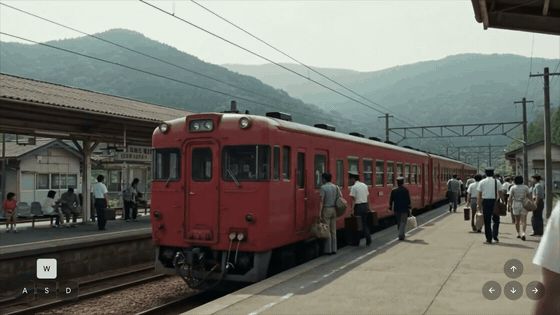
図:1980年代の日本の田舎にある駅。プラットフォームを一人称視点で歩いていくと、周囲の人々もそれぞれ動いています。これこそが、動画モデルでは実現できない部分です。出典:同上。
| 比較項目 | 動画モデル(Veoなど) | 世界モデル(Genie 4) |
|---|---|---|
| 生成されるもの | 固定された動画クリップ | 動き続ける、インタラクティブなシーン |
| 途中で変更できるか | 生成中は変更できない | いつでもテキストや操作で変更できる |
| 結果を変えるには再生成が必要か | 再生成が必要 | 不要。そのままシーンが続く |
| 適した用途 | 完成映像の素材、広告、ショート動画 | 事前検証、絵コンテの構想、インタラクティブなプロトタイプ、シミュレーション研究 |
Genie 4 はいつから使える?
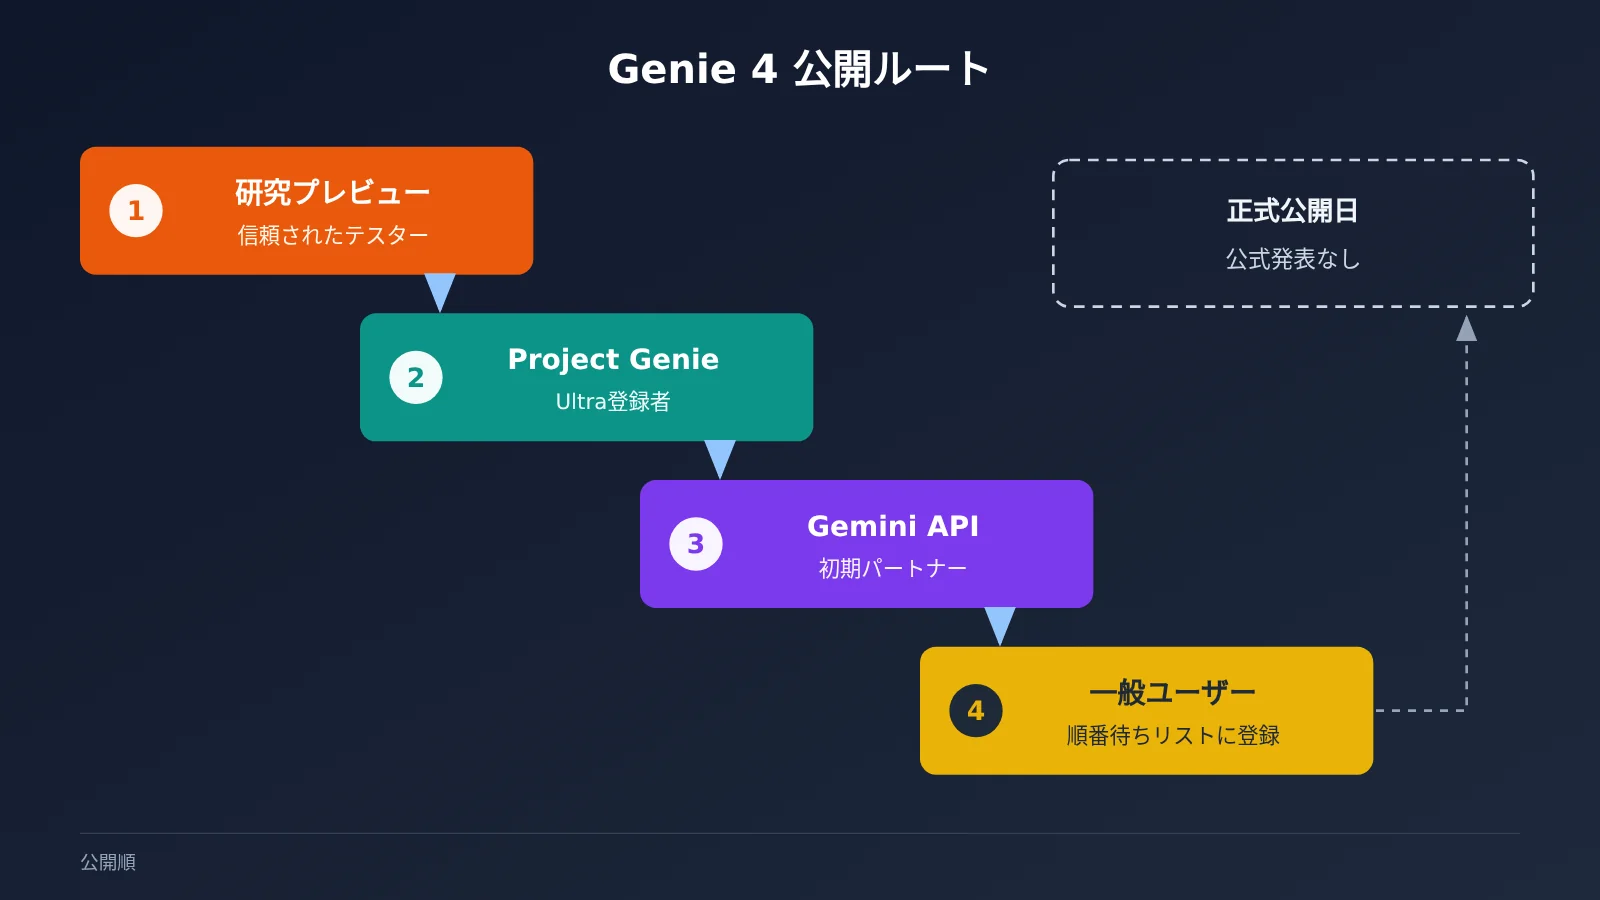
結論:現時点で利用できるのは信頼されたテスターのみ。一般ユーザーはウェイトリストに登録して待つ必要があります。
公式ブログによると、Genie 4 は研究プレビューとして信頼されたテスターに公開されています。フィードバックを収集した後、まず Google AI Ultra サブスクリプションの Project Genie で提供し、あわせて Gemini API と Google AI Studio の早期アクセスパートナーにも公開する予定です。
ここで、2つの用語を説明しておきます。Project Genie は Google Labs の実験的なウェブアプリで、いわばワールドモデルの「体験ショールーム」です。今年1月から Google AI Ultra サブスクリプションに含まれています。早期アクセスパートナーとは、先行して利用資格を得た企業や開発チームなどの協力先を指し、一般公開された登録手続きで取得できる資格ではありません。
順番待ちをしたい場合は、公式ページ上部にある Join the Genie 4 waitlist から Google フォーム(forms.gle/WQnSNEM3omF7Uruu7)にアクセスし、必要事項を入力してください。なお、10月28日時点では、Gemini のサブスクリプションページの Project Genie 欄には引き続き Genie 3 と記載されており、Genie 4 はまだ特典に含まれていません。正式な公開日も発表されていません。
Genie 4がまだできない6つのこと
結論をひと言でいうと、Genie 4はまだ研究の初期段階にあると公式も認めています。短時間ならうまく動作しますが、時間が長くなると問題が生じやすくなります。
- 映像が徐々にずれる(公式ブログ):短時間であれば一貫性を保てますが、長時間動かしたり、プロンプトを何度も変更したり、シーン内を歩き回ったりすると、細部や物体の見え方が変わることがあります。長期的な一貫性は引き続き研究中です。
- 複雑な物理的インタラクション(公式ブログ):引き続き研究課題として挙げられています。
- リアルタイム音声の精度(公式ブログ):音声は生成できますが、精度はまだ改善の途中です。
- はっきり読める文字(公式ブログ):映像内の看板や文字が不鮮明になることがあります。
- 空間精度(公式ブログ):位置や距離の関係はまだ十分に正確ではありません。
- 1回の生成でどれくらい動かせるか:公式ブログには記載がありません。TechCrunchはブリーフィングに基づき、Genie 4は最大約2分間、一貫したシーンを維持でき、前世代の2倍だと報じています。比較対象となる公式データでは、Project GenieにおけるGenie 3の1回の生成上限は60秒で、数字は一致します。ただし、「2分」という数字は現時点ではメディアの報道によるものです。
このほか、解像度、フレームレート、価格、呼び出し上限、パラメータ規模、APIの提供開始時期についても、公式からは発表されていません。
コミュニティには異なる見方もあります。Xユーザーの@dummerspast39は、Genie 4は「新しいモデルとは言えず」、実質的にはOmniのリアルタイム版に3.8 Flashをアシスタントとして組み合わせたものだと主張しています。ただし、これは一人のユーザーの見解であり、根拠は示されておらず、公式も反応していません。公式ブログでは、Genie 4は「Geminiファミリーの能力を統合し、その上に構築されている」と説明しています。
国内の読者が今できること
一言でいうと、世界モデルはまだ順番待ちですが、「今日使える動画を作る」ことは今すぐできます。
まずは興味があるという方は、ウェイティングリストに登録し、公式ブログやSynthIDに関する説明をチェックしてみましょう。SynthIDはGoogleの電子透かし技術で、目には見えませんが、検出することができます。公式によると、Genie 4が生成する動画と音声にはいずれもSynthIDが埋め込まれます。今後、Genieで生成されたと思われるコンテンツを見かけたら、SynthIDを手がかりに確認できます。
今すぐ試したい方は、Genie 4の仕組みのうち、すでに利用できる部分から始められます。公式が「監督」役として挙げている gemini-3.8-flash は、現在APIYI(apiyi.com)で呼び出せます。シーンの説明をカット、動き、セリフに分解してもらい、まずは絵コンテを具体化してみましょう。動画生成については、プラットフォーム上でSeedance 2.5などのモデルが利用でき、絵コンテから直接動画クリップを作れます。具体的なモデルと料金は、apiyi.comのモデル一覧をご確認ください。
この方法にはもう一つメリットがあります。1つのAPIキーで複数のモデルを呼び出せるため、モデルごとに個別登録する必要がありません。インターフェースはOpenAI形式と互換性があり、base_url を https://api.apiyi.com/v1 に設定するだけで既存のコードに組み込めます。Genie 4が実際に公開される頃には、「監督モデルと動画モデルを組み合わせる」ワークフローの経験を積んでいるはずです。
Genie 4 よくある質問(FAQ)
Q1:Genie 4 とは何ですか?
Google DeepMind が 2026 年 10 月 27 日に発表した世界モデルです。インタラクティブな環境をリアルタイムで生成でき、音声やキャラクター同士の会話にもネイティブで対応しています。
Q2:Genie 4 と Genie 3 の違いは何ですか?
公式ブログによると、Genie 4 ではネイティブ音声、キャラクターの会話、よりリアルな人物の動き、Gemini によるリアルタイムの誘導などが追加されています。生成時間については、TechCrunch が「2分間」と報じているのみです。一方、Project Genie での Genie 3 の上限は 60 秒でした。
Q3:Genie 4 は今すぐ使えますか?
一般ユーザーはまだ利用できません。現在は研究プレビュー段階にあり、信頼できるテスターにのみ公開されています。今後は AI Ultra の Project Genie ユーザーや API の初期パートナーにも提供される予定ですが、具体的な日付は発表されていません。
Q4:Genie 4 の API や料金は公開されていますか?
いいえ。公式は API、モデル名、料金体系を公開しておらず、現時点では購入できる製品でもありません。関連する機能を先に試したい場合は、APIYI apiyi.com で Gemini 3.8 Flash など、すでに提供されているモデルを呼び出せます。
Q5:Genie 4 は動画生成ツールの代わりになりますか?
そうとは言い切れません。両者の成果物は異なり、動画モデルは完成した映像を出力するのに対し、Genie 4 は事前のシミュレーションやプロトタイプ制作に適しています。完成した映像素材が必要な場合は、引き続き動画モデルを使う必要があります。APIYI apiyi.com なら、1つの APIキーで複数の動画モデルを呼び出せます。
Q6:公式デモの結果は信頼できますか?
デモは Google 自身が公開したもので、初期体験者の評価も個人の感想にすぎません。公式も、画面にずれが生じることや、文字と空間の精度にはまだ課題があることを認めています。結論を出す前に、より多くの公開テスト結果を待つのがよいでしょう。
まとめ
Genie 4の最大の変化は、世界モデルが初めて音声、対話、リアルタイムでの操作に同時に対応したことです。背景には、Gemini OmniやGemini 3.8 Flashなどのモデルが役割を分担して連携する仕組みがあります。ただし、現在は研究プレビューの段階で、公開日、価格、生成できる動画の長さについて公式発表はありません。「2分間」という数字も、あくまでメディア報道によるものです。
一言でまとめると、Genie 4は注目に値しますが、今はまだ使えません。コンテンツを作りたいなら、まずは既存のモデルで絵コンテや動画を作ってみましょう。 必要に応じて、APIYI apiyi.comで1つのAPIキーを使い、Gemini 3.8 Flashや動画生成モデルを試せます。
参考資料
- Google DeepMind公式ブログ:Genie 4: A new generation of world simulation
- リンク:
deepmind.google/blog/genie-4-a-new-generation-of-world-simulation - Google公式ブログ:Introducing Genie 4
- リンク:
blog.google/innovation-and-ai/models-and-research/google-deepmind/introducing-genie-4 - TechCrunchの報道:Google’s Genie 4 world model adds audio, more realistic worlds, and real-time steering
- リンク:
techcrunch.com
著者:APIYI技術チーム
技術に関するお問い合わせ:APIYI apiyi.comのトップページからお問い合わせください。詳しい資料はdocs.apiyi.comのドキュメントセンターをご覧ください。