
Résumé : la création vidéo par IA s’est désormais scindée en deux voies techniques : la génération vidéo native et le rendu par code d’Agent. La première excelle dans les images réelles et les mouvements naturels, la seconde dans l’animation précise, l’expression de données et une production industrialisée modifiable. C’est seulement en comprenant leurs différences que l’on peut bâtir un workflow de fabrication vidéo efficace.
Conclusion en premier : la génération vidéo native et le rendu par code d’Agent conviennent à des tâches différentes. Les personnages, la sensation de prise de vue réelle, les mouvements naturels et le langage visuel de la caméra reviennent à des modèles vidéo natifs comme Seedance, Kling ou Veo ; les graphiques de données, les formules, les tutoriels logiciels, les paramètres de prix et les contenus modèles produits en série reviennent à la chaîne de rendu par code composée de Remotion, Manim et FFmpeg. En combinant les deux, on obtient à la fois des images naturelles et un contrôle précis : c’est la solution de production la plus pratique aujourd’hui.
Aperçu du contenu : nous expliquerons d’abord la différence fondamentale de mécanisme de sortie entre les deux voies, puis nous démonterons séparément les capacités et les coûts des modèles vidéo natifs (Seedance 2.5, Kling 4.0, Veo 3.1) et de la chaîne d’outils de rendu par code (Remotion, Manim, FFmpeg, Claude Motion, Codex), en nous appuyant sur les données d’évaluation indépendantes de VibeVideoBench pour montrer le niveau réel des Agents en matière de vidéo. Enfin, nous proposerons un processus de production hybride prenant pour exemple un film de promotion produit, en précisant quelle partie du travail revient à chaque modèle et à chaque outil.
À savoir : glossaire des termes techniques de la vidéo IA
| Terme | Explication |
|---|---|
| Text-to-Video | Générer directement une vidéo à partir d’une invite textuelle |
| Image-to-Video | Générer une vidéo animée à partir d’une image de référence |
| Multimodal Reference | Guider la génération en combinant images, vidéos, audio et autres médias |
| Keyframe | Image clé, servant à définir l’état de l’image à un instant donné |
| Timestamp-level Editing | Modifier précisément un segment de contenu en fonction d’un point temporel de la vidéo |
| Agent | Système d’IA capable de planifier une tâche de façon autonome, d’appeler des outils, de vérifier les résultats et de les corriger |
| Remotion | Outil de création d’animations vidéo à partir de composants React et de code |
| Manim | Moteur Python pour créer des animations mathématiques et scientifiques |
| FFmpeg | Outil en ligne de commande dédié à l’encodage vidéo, à la synthèse audio, au montage et à la conversion de formats |
| ffprobe | Outil d’inspection fourni avec FFmpeg, capable de lire la résolution, la fréquence d’images, la durée et les pistes audio |
| TTS | Synthèse vocale (texte vers parole), utilisée pour générer automatiquement une narration |
| Deterministic Rendering | Rendu déterministe : un même code et des paramètres identiques produisent la même image à chaque exécution |
| Claude Motion | Fonctionnalité d’Anthropic qui transforme l’animation pilotée par code en produit, actuellement en Beta |
| Cache Hit | Taux de réussite du cache : un contexte répété est lu directement dans le cache, ce qui réduit nettement le coût en tokens |
1 Les deux approches techniques de la vidéo IA : des mécanismes de sortie radicalement différents
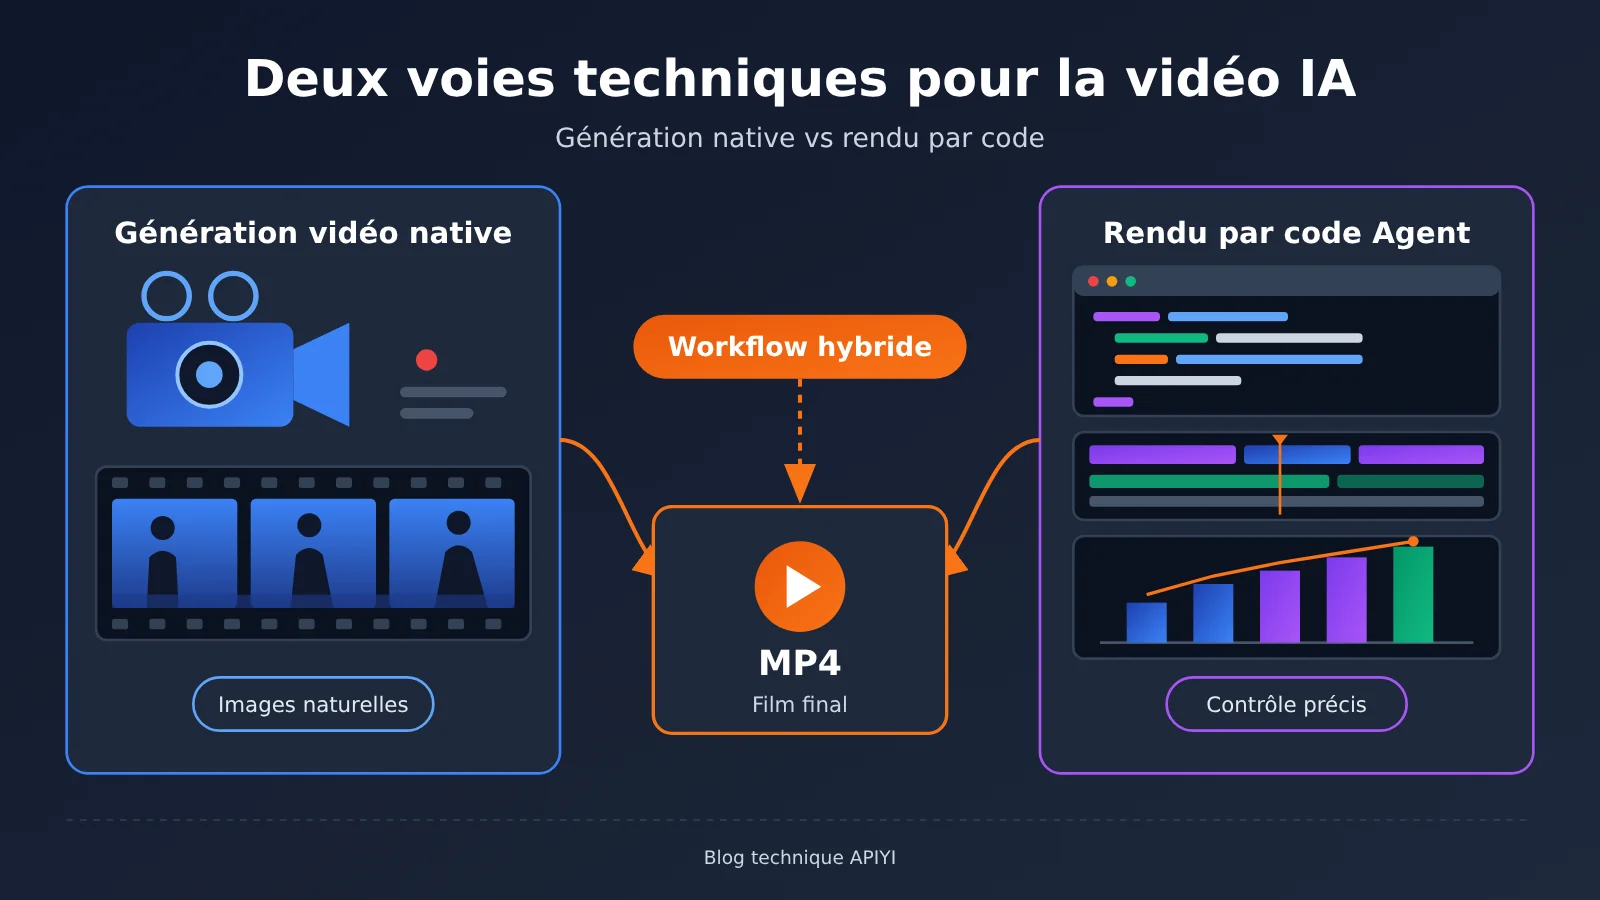
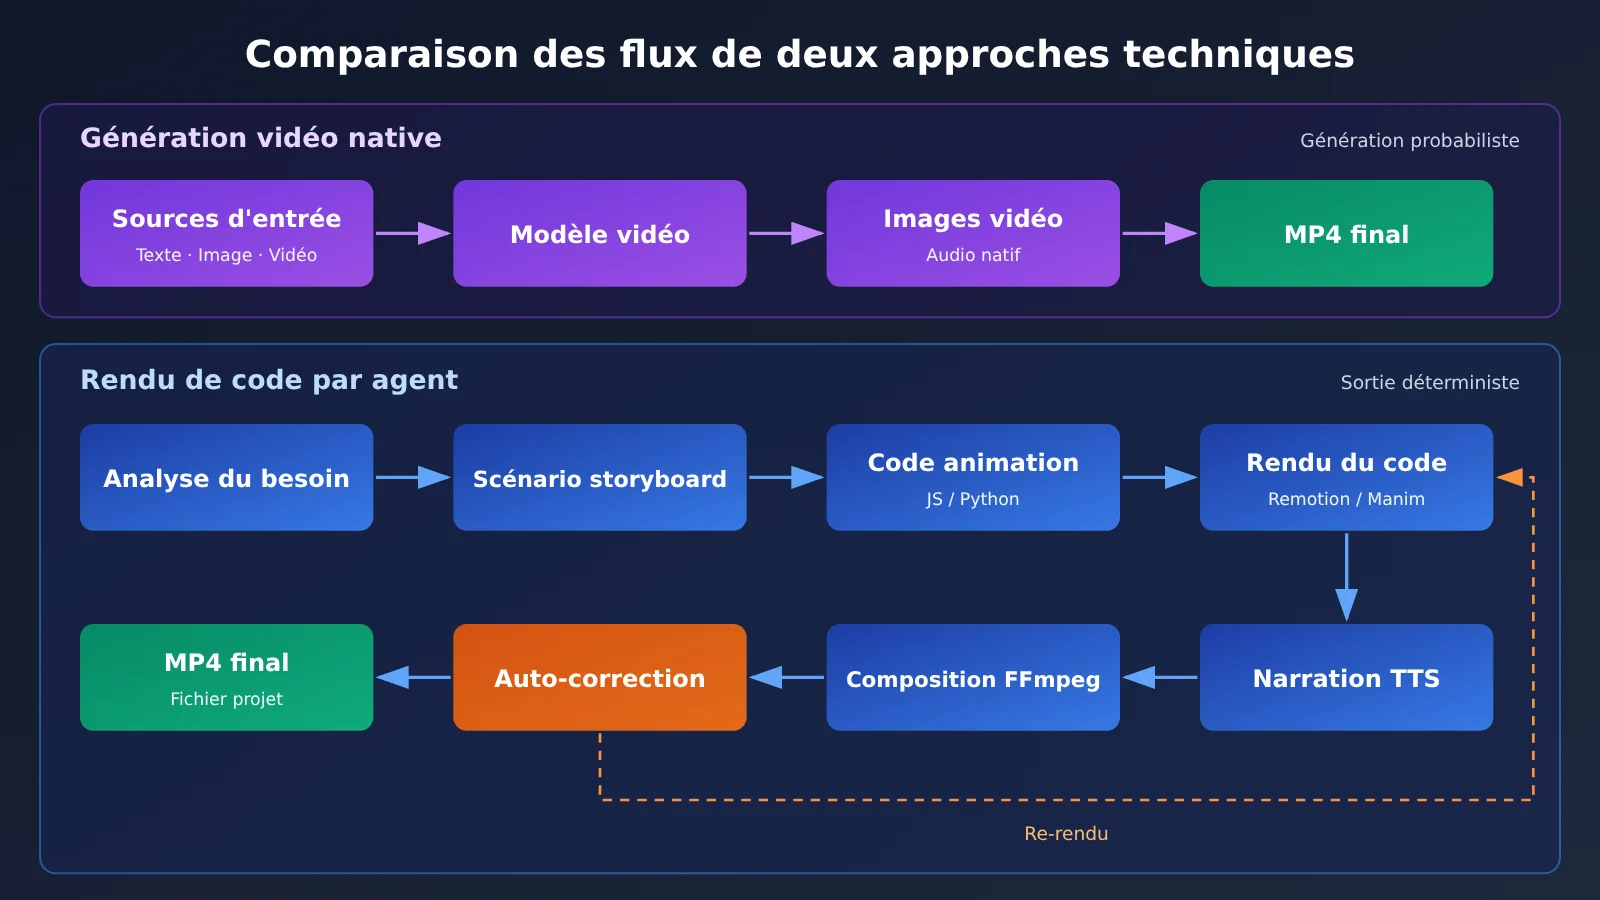
Les deux approches peuvent livrer un MP4, mais elles ne produisent pas les images de la même manière. La génération vidéo native fait directement « dessiner » chaque image par le modèle ; le rendu par code d’agent demande au modèle d’écrire un programme de fabrication vidéo, puis laisse un moteur de rendu produire les images selon ce programme. Cette différence explique tout l’écart entre les deux en matière de précision du contrôle, de facilité de modification et de coût.
1.1 Génération vidéo native : le modèle crée directement des images continues
La génération vidéo native repose sur le texte vers vidéo et l’image vers vidéo. L’utilisateur fournit une description textuelle ou une image de référence, et le modèle produit directement des images vidéo successives : personnages, objets, environnement, mouvements continus et physique sont générés d’un seul coup. Les zooms avant et arrière, les changements de cadrage et les transitions de scène peuvent aussi être décrits dans l’invite.
Les nouveaux modèles savent désormais générer en même temps un audio natif et utiliser plusieurs images ou vidéos de référence pour contrôler l’apparence des personnages, le décor et le style visuel. Leur point fort : des images naturelles et un fort sentiment de réalisme. Le revers de la médaille : chaque image provient d’une génération probabiliste ; avec une même invite, deux générations ne donnent pas le même résultat, et une modification au pixel près impose de régénérer ou de passer par une fonction d’édition dédiée.
1.2 Rendu par code d’agent : l’IA écrit elle-même son programme de fabrication vidéo
Le rendu par code d’agent confie au grand modèle de langage le double rôle de réalisateur et de programmeur. Un processus complet comprend généralement les étapes suivantes :
- Comprendre le besoin, définir le thème, le public et le style visuel ;
- Rédiger le script, la voix off, le storyboard et la chronologie ;
- Écrire le code d’animation en JavaScript et Python (Remotion, Manim, Three.js, Cairo, Blender, etc.) ;
- Appeler TTS pour générer la voix off, créer la musique et les effets sonores ;
- Appeler FFmpeg pour assembler l’audio et l’image ;
- Vérifier les images, l’audio et la synchronisation temporelle, corriger les problèmes puis relancer le rendu ;
- Produire le MP4 final et les fichiers de projet réutilisables.
La sortie de cette approche est déterministe : à code et paramètres identiques, le résultat du rendu reste identique. Pour modifier un chiffre, une ligne de sous-titre ou une couleur, il suffit de changer le code et de relancer le rendu ; le reste des images reste inchangé. Elle excelle dans la visualisation de données, les présentations produit, la vulgarisation scientifique et les infographies animées. En revanche, pour générer des personnes réelles et des prises de vue live, il faut s’appuyer sur des ressources existantes ou des actifs 3D.
2. Voie de la génération vidéo native : à quelles tâches est-elle adaptée ?
En 2026, les modèles vidéo natifs ont porté la durée d’une génération unique à 30 secondes, et la concurrence se déplace désormais vers les références multimodales, le contrôle des images clés et l’édition continue après génération. Le tableau ci-dessous récapitule les capacités publiques de trois modèles représentatifs.
| Capacité | Seedance 2.5 | Kling 4.0 | Veo 3.1 |
|---|---|---|---|
| Date de publication / d’ouverture | Publication le 2026-07-31 | Ouverture complète de l’API le 2026-10-28 | Répertorié dans la documentation de l’API Gemini |
| Durée de génération par requête | Jusqu’à 30 secondes | Jusqu’à 30 secondes | Prolongation vidéo prise en charge |
| Ressources de référence | 30 images, 10 vidéos, 10 segments audio | 10 images, 5 vidéos, jusqu’à 15 éléments en mélange | Génération guidée par image |
| Principaux modes de contrôle | Prolongation multi-tour, édition par horodatage, édition du fond vert et de la position de caméra | Jusqu’à 10 images clés, référence vocale | Contrôle de la dernière image, prolongation vidéo |
| Audio | Référence audio prise en charge | Référence vocale prise en charge | Génération audio native |
| Facturation | Selon la résolution et la durée (consommation de tokens incluse) | Par Unit/seconde | Selon les spécifications de génération |
2.1 Seedance 2.5 : génération continue de 30 secondes et références multimodales
Seedance 2.5 a été publié le 31 juillet 2026 par l’équipe Seed de ByteDance. Une génération peut durer jusqu’à 30 secondes et contenir plusieurs plans consécutifs. Ses capacités de référence sont les plus larges parmi les paramètres publics actuels : jusqu’à 30 images de référence, 10 vidéos de référence et 10 audios de référence. On peut ainsi confier au modèle la conception des personnages, des photos de décor, des références de mouvements et une bande-son, et lui demander d’organiser tout cela en une scène complexe.
Côté montage, Seedance 2.5 permet de prolonger une vidéo existante sur plusieurs passes tout en maintenant autant que possible la cohérence des personnages, des décors et des sons. Il permet aussi de modifier l’action d’un personnage et l’intrigue à un instant précis, et prend en charge le montage sur écran vert, l’édition de l’angle de caméra et la cohérence entre plusieurs personnages. On peut également utiliser une référence Clay Render (rendu argile) pour contrôler la structure spatiale, le placement des personnages et le mouvement de caméra. Les exemples officiels couvrent des performances de personnages d’opéra de Pékin, des spectacles de scène, des interactions entre plusieurs personnages et des transitions de scènes continues : ce type de contenu à personnages multiples, en plan long et en narration continue est précisément ce que le rendu par code a le plus de mal à réaliser.
2.2 Kling 4.0 : images clés et contrôle par vidéo de référence
Kling 4.0 a ouvert son API à tous le 28 octobre 2026. Il génère jusqu’à 30 secondes par requête, en 720p et 1080p, avec des ratios d’image dont 21:9 et un ratio adaptatif. Sa particularité : jusqu’à 10 images clés. Les créateurs peuvent verrouiller plusieurs états d’image sur la ligne de temps et laisser le modèle interpoler le mouvement entre les images clés, ce qui rend la trajectoire de caméra et les poses des personnages plus contrôlables.
Côté références, Kling 4.0 accepte jusqu’à 10 images de référence et 5 vidéos de référence, avec un maximum de 15 éléments en entrée mixte par requête. Il propose aussi une référence multimodale Omni et une référence vocale. Il réunit génération de texte, génération d’images, références et montage vidéo, ce qui le destine aux projets qui ont besoin d’une image de personnage stable, d’un chemin de caméra précis ou d’une réédition d’une vidéo existante.
2.3 Veo 3.1 : audio natif et prolongation vidéo
Google propose deux catégories de produits de génération vidéo dans l’API Gemini. Veo 3.1 met l’accent sur la génération d’audio natif, la prolongation vidéo, le contrôle de la dernière image et la génération guidée par image : il est adapté à la production en une seule passe de segments « avec son ». Gemini Omni Flash, de son côté, met l’accent sur les entrées multimodales, la cohérence des personnages, la compréhension vidéo et l’édition conversationnelle sur plusieurs tours. Les deux incarnent deux directions du domaine de la vidéo native : générer des segments de haute qualité, et continuer à éditer, modifier et prolonger après la génération.
Chez OpenAI, le produit Sora a cessé son service le 26 avril 2026, et le modèle Sora 2 ainsi que l’API Videos ont été arrêtés le 24 septembre 2026 ; l’annonce officielle de dépréciation précise qu’il n’existe pas d’API de remplacement un pour un. Images 2.6, publié par OpenAI le 4 novembre 2026, prend en charge la sortie d’animations GIF de 2 à 16 images, adaptée aux emojis animés, aux boucles de mouvements de personnages et aux aperçus de storyboard : cela relève d’un flux de travail différent de la production d’une vidéo MP4 complète.
2.4 Avantages et coûts de la génération vidéo native
Les avantages clés de la génération vidéo native se concentrent sur quatre aspects : des mouvements de personnages naturels, un mouvement physique crédible, des mouvements de caméra cinématographiques et une expression créative ouverte. Ces capacités, si on les implémente en code, exigent de nombreux assets d’animation et un réglage manuel considérable ; avec un modèle vidéo, elles s’obtiennent en une seule génération.
Côté coût, la vidéo native est facturée selon les spécifications de sortie et la durée. Prenons l’exemple du tarif officiel de Seedance 2.5, mis à jour par BytePlus ModelArk le 13 novembre 2026 :
| Spécification de sortie | Prix indicatif pour une vidéo de 5 secondes | Estimation par seconde |
|---|---|---|
| 480p | $0.514 | $0.103 |
| 720p | $1.156 | $0.231 |
| 1080p | $2.843 | $0.569 |
De 720p à 1080p, le coût par seconde est multiplié par environ 2,5. Le tableau ci-dessus présente des estimations sur les spécifications typiques officielles ; la longueur, la résolution et la fréquence d’images de la vidéo d’entrée, ainsi que la consommation réelle de tokens, influencent tous la facture finale. Kling 4.0, de son côté, est facturé en Unit de la plateforme : 1 Unit/seconde en 720p, 1,5 Unit/seconde en 1080p, et 0,6 Unit/seconde pour Kling 4.0 Flash en 720p ; lorsqu’une vidéo d’entrée existante est impliquée, la durée d’entrée entre aussi en jeu. L’Unit est une unité de facturation de la plateforme, qu’il faut convertir en montant réel selon les règles de celle-ci.
À noter : ces prix correspondent au coût d’« une génération ». La vidéo native comporte une part d’aléatoire ; en production réelle, on génère souvent plusieurs fois avant de sélectionner, et le coût des plans réellement utilisables est généralement supérieur au tarif d’une seule génération.
3 La voie du rendu par code d’Agent : faire de l’IA un ingénieur de production vidéo
Le cœur de la voie du rendu par code réside dans un ensemble d’outils open source ou commerciaux matures. Le grand modèle de langage se charge de traduire les besoins en code exécutable par ces outils, puis d’assurer l’orchestration, la vérification et la correction.
3.1 Remotion : animation React et production vidéo automatisée
Remotion décrit les scènes à l’aide de composants React et contrôle la position, la taille, l’opacité et le mouvement des éléments via le numéro de frame. Les développeurs peuvent créer des animations directement avec React, HTML, CSS et JavaScript ; une scène peut combiner texte, graphiques, images, vidéos et audio, avec un contrôle précis de chaque frame. Remotion prend en charge le rendu par lots en CLI, le rendu côté serveur et le rendu cloud sur Lambda, et permet aussi de générer en masse des vidéos au contenu différent en passant des paramètres différents.
Le processus de rendu officiel est très simple :
# Installer Remotion
npm install remotion @remotion/cli

# Rendre la composition vidéo spécifiée (Composition) et générer un MP4
npx remotion render HelloWorld out.mp4
Côté licence, Remotion est gratuit pour les particuliers et les petites entreprises de 3 personnes maximum, l’usage commercial étant autorisé si les conditions sont respectées ; la formule Automators facture $0.01 par rendu, avec un minimum mensuel de $100 ; la formule Creators est à $25/siège/mois ; la formule Enterprise à partir de $500/mois (mise à jour du 14 novembre 2026). La redevance de licence de rendu de Remotion et les frais de tokens consommés par le modèle d’IA pour écrire le code sont deux coûts indépendants : il faut les calculer séparément.
3.2 Manim : animations mathématiques et scientifiques précises
Manim est un moteur d’animation Python, spécialisé dans la démonstration de formules mathématiques, les transformations de formes géométriques, les processus de mouvement physique, le fonctionnement d’algorithmes et l’explication d’expériences scientifiques. Les formules, les axes de coordonnées, les structures géométriques et les relations de mouvement entre les objets sont tous définis par du code, de sorte que la position de chaque symbole et de chaque courbe est précise et contrôlable. Les formules générées par les modèles vidéo natifs comportent souvent des erreurs de caractères ou de structure, et c’est précisément le domaine où Manim excelle.
L’exemple officiel de démarrage rapide permet de générer un MP4 en une seule commande :
manim -pql main.py CreateCircle
3.3 FFmpeg : transformer toutes sortes de matériaux en vidéo finale
FFmpeg est la « ligne d’assemblage finale » de toute la chaîne de rendu par code. Il est responsable de l’encodage et du transcodage vidéo, de la fusion audio, de l’assemblage de plusieurs segments, de l’incrustation de sous-titres, du recadrage et du redimensionnement, de la conversion de fréquence d’images et de la conversion de format. Le ffprobe qui l’accompagne permet de lire la résolution, la fréquence d’images, la durée et les informations de piste audio du film final ; l’Agent s’en sert pour la validation automatique : si les spécifications ne sont pas conformes, on revient à l’étape précédente pour corriger.
# Assemblage des segments (list.txt liste les fichiers de segments ligne par ligne)
ffmpeg -f concat -safe 0 -i list.txt -c copy merged.mp4

# Fusionner la narration et incruster les sous-titres
ffmpeg -i merged.mp4 -i voice.mp3 -vf subtitles=subs.srt \
  -map 0:v -map 1:a -c:v libx264 -c:a aac final.mp4

# Vérifier les spécifications de sortie
ffprobe -v error -show_entries stream=codec_type,width,height,r_frame_rate \
  -show_entries format=duration final.mp4
3.4 Claude Motion : l’animation par code devient une fonctionnalité produit comme les autres
Le 8 octobre 2026, Anthropic a lancé Claude Motion Beta, qui met les animations pilotées par code directement entre les mains des utilisateurs en entreprise. L’utilisateur décrit son besoin d’animation en langage naturel ; Claude organise textes, graphiques, formes et images sous forme d’animation codée et l’enregistre dans Artifacts. Il peut ensuite continuer à la modifier par la conversation, ou passer dans l’éditeur pour des ajustements manuels, puis exporter en MP4.
Les usages typiques : transformer un rapport trimestriel en une animation explicative de 30 secondes, présenter une grille tarifaire sous forme de graphique comparatif animé, transformer les étapes d’utilisation d’un produit en animation de tutoriel, ou faire des supports de réunion une vidéo de communication interne. Côté conditions d’accès, la Beta est ouverte aux utilisateurs Team et Enterprise : elle est activée par défaut pour Team, tandis que Enterprise demande l’activation par un administrateur de l’organisation ; la consommation est décomptée du quota du forfait. Claude Motion n’appelle pas de modèle natif de génération vidéo : il ne peut donc pas produire de personnes réelles ni de séquences continues de style prise de vue réelle.
La valeur de Claude Motion tient à son seuil d’entrée : les équipes opérations, finance et marketing peuvent obtenir directement la précision et la capacité de modification d’une animation par code, sans avoir à monter un projet Remotion.
3.5 GPT + Codex : un Agent qui appelle des outils pour produire une vidéo
Une autre approche consiste à laisser un modèle généraliste appeler des outils de façon autonome dans un environnement de développement d’Agent. VibeVideoBench, publié le 26 octobre 2026, évalue précisément cette capacité : 239 tâches réelles de production vidéo couvrant 12 catégories de contenu — récits basés sur des données, cours pédagogiques, décryptage d’articles de recherche, marketing de marque, présentation de fonctionnalités produit, etc. Chaque tâche demande à l’IA de livrer de manière autonome, dans un bac à sable et en 60 minutes, un MP4 lisible, un projet d’ingénierie permettant de régénérer la vidéo, ainsi qu’un planning de production et des notes explicatives. Neuf systèmes agents ont réalisé au total 2 151 exécutions, chacune dans son environnement de développement natif et à la plus haute intensité de raisonnement disponible, sans possibilité d’ajouter des instructions humaines en cours de route.
Comparaison des deux systèmes les mieux classés (moyenne de trois jurys, notes de 1 à 5) :
| Indicateur | GPT-6 Astra (Codex CLI) | Claude Opus 5.5 (Claude Code) |
|---|---|---|
| Vidéos livrées avec succès | 238/239 (99.6%) | 239/239 (100%) |
| Taux de conformité aux spécifications | 93.7% | 99.6% |
| Taux de réussite aux exigences de la tâche | 97.1% | 97.3% |
| Score de qualité globale | 4.109 | 4.074 |
| Taux de réussite stricte des tâches | 74.5% | 76.3% |
| Elo de préférence humaine | 1242 | 1203 |
| Coût moyen par tâche | $8.19 | $15.38 |
| Coût médian / P90 par tâche | $7.88 / $11.88 | $10.19 / $31.22 |
| Tokens de sortie moyens | 61K | 130.7K |
| Cache Hit | 97% | 65% |
Dans ce test, GPT-6 Astra obtient une qualité globale et une préférence humaine légèrement supérieures, pour un coût moyen par tâche inférieur d’environ 46.7 % ; Claude Opus 5.5 a livré les 239 tâches dans leur intégralité, avec un taux de conformité aux spécifications et un taux de réussite stricte plus élevés. L’écart de coût vient principalement de l’efficacité d’utilisation des tokens : Astra produit environ 53.3 % de tokens de sortie en moins et atteint un taux de cache hit de 97 %, alors que chez Opus, environ 76 % du coût d’une tâche provient du Cache Write. Bien que le tarif unitaire standard entrée/sortie d’Astra soit 2.5 fois celui d’Opus, la dépense réelle pour terminer une tâche reste plus faible.
Pour interpréter ces données, il faut tenir compte du cadre de l’évaluation : l’objet évalué est un système agent complet composé du « modèle + environnement d’exécution », et les Codex CLI et Claude Code utilisés respectivement par GPT et Claude présentent déjà des différences entre eux ; chaque tâche n’est exécutée qu’une seule fois, avec une limite de 60 minutes ; la corrélation de classement entre les trois jurys est de 0.933–0.950, et la corrélation avec le classement Elo humain de 0.98, mais le taux de concordance entre la préférence humaine pour une vidéo donnée et le résultat du jury n’est que de 73.3 %. Ces scores servent donc à situer le niveau approximatif à l’échelle d’un système ; ils ne sont pas généralisables à toutes les tâches vidéo et ne remplacent pas l’évaluation des modèles natifs Text-to-Video.
VibeVideoBench met aussi en évidence le principal goulot d’étranglement des Agents qui produisent de la vidéo : sur 2 151 exécutions, 224 n’ont pas livré de vidéo lisible, et parmi elles 169 relèvent de problèmes de gestion du temps — rendu final lancé trop tard, exécution trop lente ou pas lancée du tout — soit environ 75 % des cas d’échec. Pour un Agent vidéo, la difficulté n’est plus de « savoir écrire du code d’animation », mais de gérer l’ordonnancement du rendu et la livraison.
Par rapport à Claude Motion, les environnements Agent comme Codex et Claude Code s’adressent aux développeurs : ils permettent de combiner librement Remotion, Manim, FFmpeg, la TTS et l’enregistrement d’écran, produisent des fichiers de projet complets et sont adaptés à une intégration dans des chaînes de production automatisées. Claude Motion, lui, cible les utilisateurs finaux en entreprise : l’interaction y est plus simple, et ses capacités se limitent aux animations de texte, de graphiques et de formes.
4 Génération vidéo native ou rendu de code par Agent : comment choisir ?
4.1 Tâches adaptées à la génération vidéo native
- Style tournage réel : personnes filmées en direct, expressions et gestes corporels ;
- Scènes d’utilisation d’un produit : produit utilisé dans un environnement réel ;
- Mouvements naturels et langage cinématographique : travelling avant/arrière, panoramique, suivi, changements de cadrage ;
- Publicité à l’esthétique cinématographique : films de marque où priment la lumière, l’ambiance et la texture ;
- Jeu d’acteur et récit continu : interactions entre plusieurs personnages, narration en plan-séquence ;
- Environnements naturels complexes : météo, écoulements d’eau, rues urbaines et autres scènes difficiles à modéliser.
4.2 Tâches adaptées à la production pilotée par code
- Graphiques de données précis : chiffres, coordonnées et proportions doivent être exacts ;
- Tutoriels de manipulation logicielle : capture d’écran de l’interface avec annotations, surlignages et explications étape par étape ;
- Explications mathématiques et scientifiques : démonstrations de formules, transformations géométriques, présentation d’algorithmes ;
- Infographies animées : présentation progressive d’informations structurées ;
- Comparaison de caractéristiques produit et explication des prix : chaque valeur est vérifiable et modifiable ;
- Contenus modèles en série : générer en masse des centaines de vidéos à partir d’un même modèle en remplaçant les données.
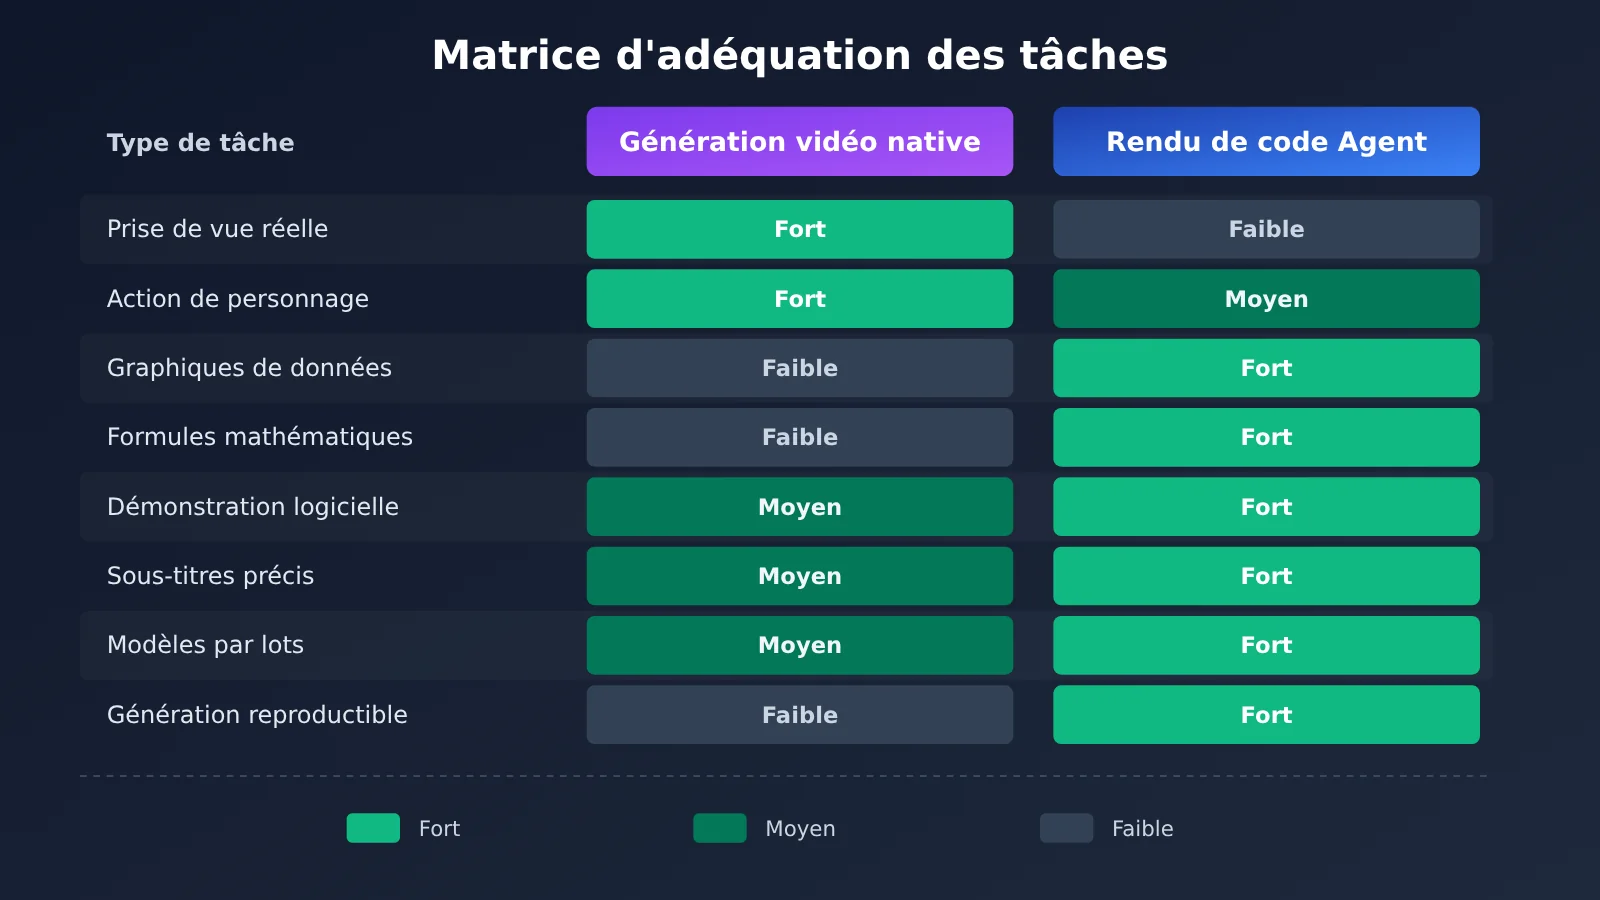
Le tableau ci-dessous résume le degré d’adéquation des deux approches sur les tâches courantes :
| Tâche | Génération vidéo native | Rendu par code d’Agent |
|---|---|---|
| Prises de vue réelles à l’esthétique cinématographique | Fort | Nécessite des images existantes ou des actifs 3D |
| Mouvements naturels de personnages | Fort | Dépend d’actifs d’animation |
| Mouvements de caméra complexes | Fort | Reprogrammable avec précision |
| Présentation précise de données | Difficile à garantir | Fort |
| Animation de formules mathématiques | Risque d’erreurs | Fort |
| Démonstration d’interface logicielle | Nécessite des références et un post-traitement | Fort |
| Sous-titres précis | Nécessite une relecture en post-production | Fort |
| Présentation dynamique de produit | Fort | Fort |
| Production en série sur un modèle unifié | Multiples générations et filtrages nécessaires | Fort |
| Modification précise d’un seul détail | Dépend d’une régénération ou d’une édition | Fort |
| Génération répétable de la même animation | Sensible au hasard | Fort |
L’étude VibeVideoBench souligne également que le rendu par code est particulièrement adapté aux formules exactes, aux graphiques de données, aux scènes de jeu cohérentes en termes de règles et aux commentaires audio synchronisés.
💡 Conseil de sélection : le critère peut se résumer en une phrase — si l’image doit « paraître réelle », utilisez un modèle de génération vidéo native ; si l’information doit être « exacte et sans erreur », utilisez le rendu par code. Dans la chaîne de rendu par code, les scripts, le storyboard et le code d’animation reposent tous sur des grands modèles de langage génériques. Nous vous conseillons de tester d’abord, via APIYI apiyi.com et avec une même clé API, les performances de GPT, Claude et Gemini sur vos tâches de script et de code, avant de choisir votre modèle principal.
4.3 La structure de coûts des deux approches
Les deux approches ont des structures de coûts très différentes, et comparer directement les prix unitaires n’a qu’une valeur limitée :
- Génération vidéo native : la facturation se fait principalement selon la résolution et la durée de sortie, à laquelle s’ajoutent les surcoûts liés à l’entrée d’une vidéo de référence ; les générations multiples et le tri qu’impose le caractère aléatoire constituent des coûts cachés.
- Rendu par code d’un agent : cela comprend les frais de Token du modèle général (entrée, sortie, lecture/écriture du cache), la puissance de calcul pour l’exécution du code et le rendu, les licences d’outils (comme la licence commerciale Remotion), ainsi que les frais de TTS et de matériel musical et sonore.
La comparaison doit se faire sur le « coût total de la vidéo finalement livrable » : si un plan vidéo natif doit être généré cinq fois pour n’en retenir qu’un seul utilisable, son coût réel est cinq fois le prix annoncé ; de même, pour une tâche d’agent, si le taux de réussite du cache est faible et que le rendu est répété, les frais de Token augmentent tout aussi rapidement. Les données de VibeVideoBench montrent qu’un modèle au prix unitaire plus élevé peut, grâce à moins de Tokens de sortie et à un meilleur taux de réussite du cache, aboutir à un coût de tâche plus faible ; au moment de choisir un modèle, il faut donc se baser sur le coût réel par tâche mesuré.
💰 Optimisation des coûts : dans le pipeline de rendu par code, les frais de modèle représentent une part importante et correspondent souvent à des contextes longs et à des appels multi-tours. En appelant à la demande plusieurs modèles majeurs via le service APIYI apiyi.com, on peut, avec le même code, comparer le coût réel de différents modèles pour réaliser la même tâche vidéo, puis répartir les modèles selon le type de tâche.
5 La solution la plus efficace : combiner les deux approches techniques de la vidéo par IA
5.1 Flux de production hybride
Combiner les deux approches — confier les images naturelles aux modèles vidéo natifs et l’expression précise au rendu par code — c’est la solution la plus concrètement applicable aujourd’hui :
- Idée et storyboard : GPT ou Claude se charge de la créativité, du script et du storyboard, et annonce pour chaque plan son mode de production ;
- Plans naturels : Seedance, Kling ou Veo génère les personnages, les scènes et les plans d’utilisation du produit ;
- Images précises : Remotion se charge des graphiques de données, des sous-titres, des éléments de marque et des animations de paramètres produit ;
- Voix off : le TTS génère la voix off à partir du script ;
- Composition : FFmpeg assemble les plans, fusionne les pistes audio et incruste les sous-titres ;
- Validation et correction : l’agent IA vérifie les spécifications avec ffprobe, contrôle la synchronisation audio-vidéo et les sous-titres, puis revient à l’étape concernée pour corriger en cas de problème.
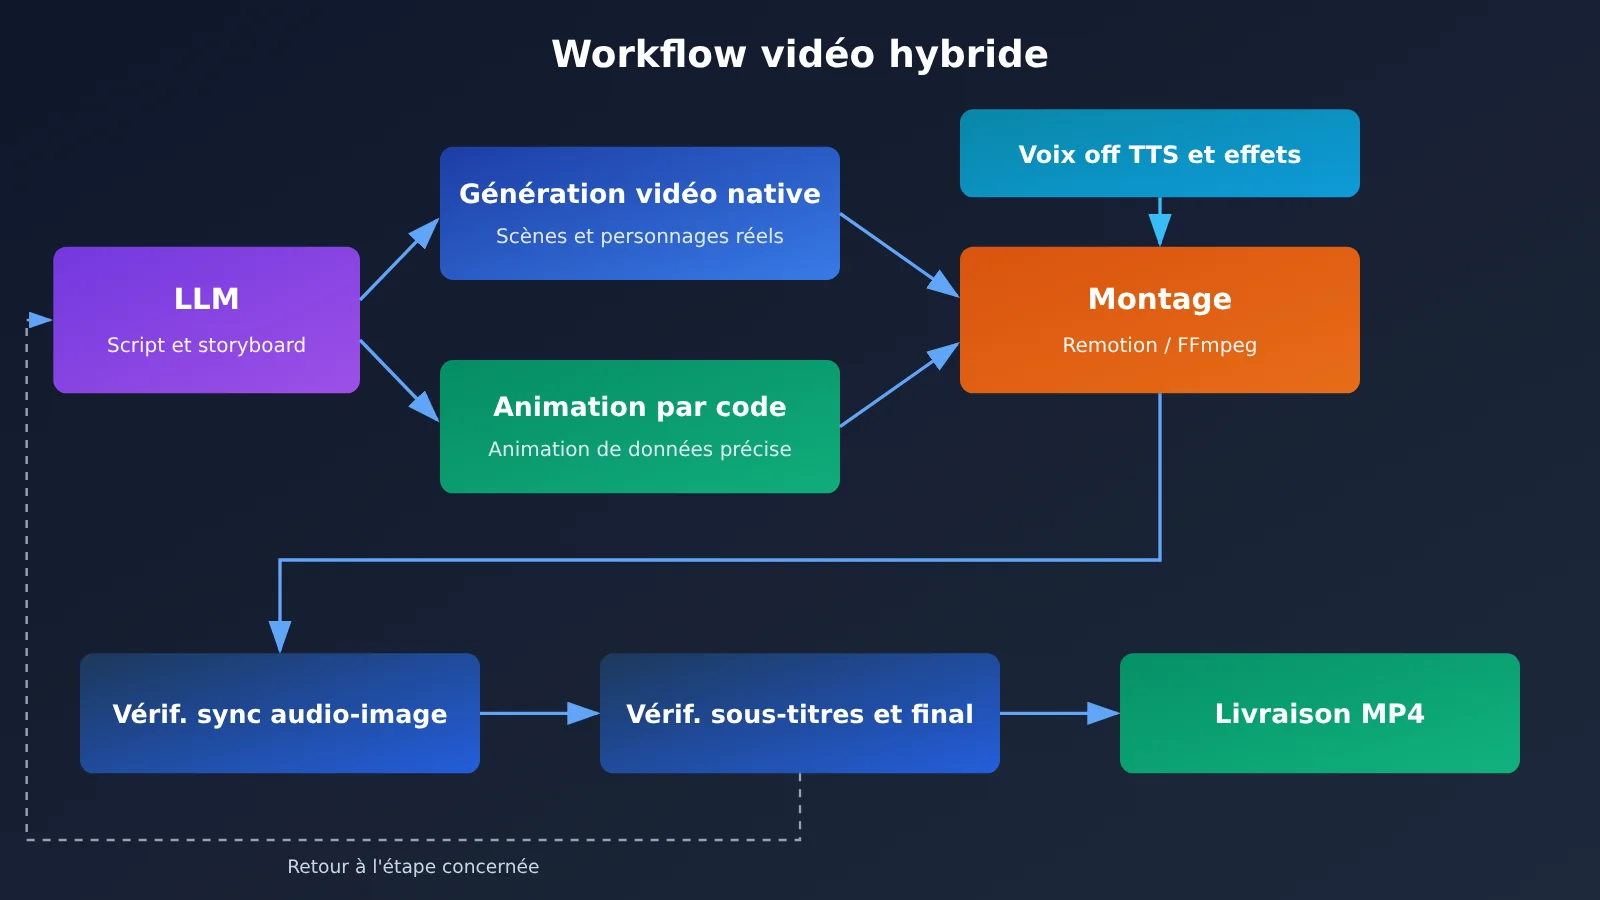
Dans le schéma ci-dessus, les deux étapes de script/storyboard et de vérification du montage final sont assurées par un grand modèle de langage généraliste. Ces appels peuvent tous passer par APIYI apiyi.com, avec une seule interface compatible OpenAI pour basculer entre GPT, Claude et Gemini.
5.2 Exemple fil rouge : la répartition des tâches pour une vidéo promotionnelle produit
Prenons une vidéo promotionnelle pour une application mobile. Voici comment les tâches peuvent être réparties :
- Plans d’ambiance en ouverture (utilisateur qui se sert du produit dans les transports ou au bureau) : à confier à Seedance 2.5 ou Kling 4.0. On utilise des photos du produit et des fiches de personnage comme références pour garantir la cohérence de l’apparence des personnages et du produit ; avec Kling 4.0, on peut verrouiller la composition de l’ouverture et de la fin grâce aux images clés. Selon les estimations officielles de Seedance 2.5, comptez environ $0,231 par seconde en 720p, et prévoyez une marge budgétaire pour plusieurs générations.
- Séquence de démonstration des fonctionnalités : enregistrez la véritable interface de l’application, puis ajoutez avec Remotion des cadres de surbrillance, des numéros d’étape et des annotations animées. Le contenu de l’interface provient d’un enregistrement d’écran réel : aucun bouton « inventé » par le modèle ne peut apparaître.
- Séquence des caractéristiques et des prix : utilisez des composants Remotion pour afficher le tableau comparatif des fonctionnalités et les cartes de prix. En cas d’ajustement tarifaire, il suffit de modifier le fichier de données et de relancer le rendu ; le reste de l’image ne change pas.
- Voix off et sous-titres : un grand modèle de langage rédige le script de la voix off, la synthèse vocale (TTS) génère l’audio et produit en même temps le fichier de sous-titres SRT.
- Montage final et validation : FFmpeg assemble tous les segments et mixe la piste audio ; l’agent vérifie avec ffprobe la durée, la résolution et la piste audio, puis contrôle segment par segment la synchronisation entre sous-titres et voix off.
Résultat de cette répartition : les plans réalistes sont garantis par le modèle vidéo, toutes les informations vérifiables le sont par le code, et les révisions ultérieures ne demandent que le re-rendu des segments concernés.
5.3 Générer un storyboard annoté avec routage via l’API
La première étape du flux hybride consiste à demander au grand modèle de langage de produire un storyboard structuré, en indiquant pour chaque plan quelle route suivre. L’exemple ci-dessous utilise l’interface compatible OpenAI pour réaliser cette étape :
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatible OpenAI d'APIYI
)

MODEL = "your-model-name"  # Remplacez par le nom réel du modèle dans la liste des modèles de la plateforme

prompt = """为一款记账 App 写 30 秒宣传片分镜,输出 JSON 数组。
每个镜头包含 id、duration、description、route 字段。
route 只能是 native(真实人物与场景,交给视频模型)
或 code(数据、参数、字幕、界面标注,交给 Remotion 渲染)。"""

resp = client.chat.completions.create(
    model=MODEL,
    messages=[{"role": "user", "content": prompt}],
)
print(resp.choices[0].message.content)
Voir l’implémentation complète : routage du storyboard + génération des paramètres de rendu Remotion
import json
import subprocess
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

PLANNER_MODEL = "your-planner-model"  # Modèle responsable de la créativité et du storyboard
CODER_MODEL = "your-coder-model"      # Modèle responsable de la génération des paramètres de rendu / du code


def plan_storyboard(brief: str) -> list[dict]:
    """Demande au modèle de produire un JSON de storyboard avec des annotations de route."""
    resp = client.chat.completions.create(
        model=PLANNER_MODEL,
        messages=[
            {"role": "system", "content": "你是视频导演,只输出合法 JSON 数组。"},
            {"role": "user", "content": brief},
        ],
    )
    return json.loads(resp.choices[0].message.content)


def build_remotion_props(shot: dict) -> dict:
    """Génère les props du composant Remotion pour les plans de la route code."""
    resp = client.chat.completions.create(
        model=CODER_MODEL,
        messages=[
            {"role": "system", "content": "把镜头描述转换为 Remotion 组件 props,只输出 JSON 对象。"},
            {"role": "user", "content": json.dumps(shot, ensure_ascii=False)},
        ],
    )
    return json.loads(resp.choices[0].message.content)


def render_code_shot(shot_id: str, props: dict) -> str:
    """Appelle la CLI Remotion pour effectuer le rendu d’un plan individuel."""
    out = f"out/{shot_id}.mp4"
    subprocess.run(
        ["npx", "remotion", "render", "InfoCard", out,
         f"--props={json.dumps(props, ensure_ascii=False)}"],
        check=True,
    )
    return out


if __name__ == "__main__":
    shots = plan_storyboard("为一款记账 App 写 30 秒宣传片分镜,"
                            "字段:id、duration、description、route(native/code)。")
    for shot in shots:
        if shot["route"] == "code":
            path = render_code_shot(shot["id"], build_remotion_props(shot))
            print("已渲染:", path)
        else:
            # Les plans native sont confiés au modèle de génération vidéo ; on enregistre ici l’invite en attente de génération
            print("待原生生成:", shot["id"], shot["description"])
🚀 Démarrage rapide : les étapes ci-dessus de génération du storyboard et des paramètres ne nécessitent qu’un grand modèle de langage général. Je vous conseille de vous inscrire sur APIYI apiyi.com pour utiliser le crédit d’essai gratuit réservé aux nouveaux utilisateurs : faites d’abord tourner deux ou trois modèles sur la même demande de vidéo promotionnelle, comparez la qualité du storyboard et la consommation de tokens, puis fixez cela dans le processus de production.
6 Conclusion : l’enjeu de la compétition dans la vidéo IA est le workflow de production complet
La correspondance entre les deux approches techniques et les tâches est désormais très claire : la génération vidéo native prend en charge les images réalistes, le jeu d’acteur et le langage cinématographique — Seedance 2.5, Kling 4.0 et Veo 3.1 ont chacun leurs points forts sur la génération continue de 30 secondes, les références multimodales, les images clés et l’édition continue. Le rendu par code des agents prend en charge les informations précises, le rendu reproductible et la production en série — Remotion, Manim et FFmpeg en constituent la base d’outils, Claude Motion le transforme en produit pour les utilisateurs professionnels, et Codex comme Claude Code permettent aux développeurs de construire des pipelines d’automatisation complètes.
Les résultats de VibeVideoBench montrent que les meilleurs systèmes d’agents parviennent désormais à livrer de manière fiable des vidéos complètes, les principales causes d’échec se concentrant sur l’ordonnancement du rendu et la gestion du temps ; le coût par tâche dépend de l’efficacité des tokens et du taux de réussite du cache, et non du prix unitaire du modèle. Cela signifie que la concurrence dans la production vidéo se déplace de la qualité d’image d’un modèle unique vers la capacité d’organisation de l’ensemble du workflow « génération, édition, rendu, livraison ».
Récapitulatif des points clés :
- Différence d’approche : la génération native produit les images directement via le modèle, le rendu par code fait écrire un programme au modèle puis le rend ;
- Quand utiliser la génération native : personnages, rendu de type prise de vue réelle, mouvements naturels, publicités cinématographiques et récits continus ;
- Quand utiliser le rendu par code : graphiques de données, formules, tutoriels logiciels, tarifs et prix, et contenus modulaires produits en série ;
- Base de comparaison des coûts : se baser sur le coût total de la vidéo finale livrable, en incluant les frais de nouvelle tentative, de tokens, de rendu et de licence ;
- Meilleure pratique : un workflow hybride, où le modèle vidéo gère les images naturelles et le code gère l’expression précise ;
- Appels multi-modèles : le script, le storyboard, le code d’animation et la vérification de la vidéo finale conviennent chacun à des modèles différents, et une interface unifiée réduit les coûts de bascule.
Dans la production réelle, une vidéo doit souvent faire appel à plusieurs grands modèles de langage pour réaliser respectivement la création, le codage et la vérification. Il est recommandé de passer par APIYI apiyi.com pour appeler GPT, Claude, Gemini et autres modèles de manière unifiée avec une seule clé API, d’attribuer les modèles selon les tâches et de facturer à l’usage, afin de concentrer l’effort sur le workflow lui-même.
Références
- Évaluation officielle VibeVideoBench : benchmark d’agents pour la génération vidéo pilotée par code
- Lien :
vibevideobench.github.io -
Description : classement de 239 tâches, scores de qualité, analyse des coûts et des causes d’échec
-
Annonce officielle Seedance 2.5 : génération en 30 secondes et références multimodales
- Lien :
seed.bytedance.com/en/blog/one-take-creation-flexible-referencing-introducing-seedance-2-5 -
Description : nombre maximal de références, extension et édition par horodatage
-
BytePlus ModelArk Pricing : tarifs de l’API Seedance 2.5
- Lien :
docs.byteplus.com/en/docs/modelark/model-pricing -
Description : prix indicatifs de génération vidéo selon les résolutions
-
Documentation de l’API Kling : annonce de mise à jour Kling 4.0 et facturation
- Lien :
kling.ai/document-api/apiReference/updateNotice -
Description : images clés, références multi-sources et règles de facturation à l’unité
-
Documentation Gemini API sur la génération vidéo : Veo 3.1 et Gemini Omni Flash
- Lien :
ai.google.dev/gemini-api/docs/video -
Description : audio natif, extension vidéo et édition multi-tours
-
Documentation et tarifs de licence Remotion
- Lien :
remotion.dev/docs/render,remotion.dev/docs/license/pricing -
Description : commandes de rendu et offres de licence commerciale
-
Documentation Manim Community
- Lien :
docs.manim.community/en/stable -
Description : utilisation du moteur d’animation mathématique et scientifique
-
Documentation officielle FFmpeg
- Lien :
ffmpeg.org/documentation.html -
Description : encodage, composition, sous-titres et vérification avec ffprobe
-
Guide d’utilisation de Claude Motion
- Lien :
support.claude.com/en/articles/17454997-get-started-with-claude-motion -
Description : déroulement de la fonctionnalité bêta et conditions d’accès
-
Dépréciations de l’API OpenAI
- Lien :
developers.openai.com/api/docs/deprecations - Description : informations sur l’arrêt de Sora 2 et de l’API Videos
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site officiel APIYI ; vous trouverez davantage de ressources d’intégration dans le centre de documentation docs.apiyi.com


