Zusammenfassung: Die KI-Videokreation hat sich in zwei technische Routen aufgeteilt: native Videogenerierung und Agent-basiertes Code-Rendering. Erstere glänzt bei realistischen Bildern und natürlichen Bewegungen, letztere bei präziser Animation, überzeugender Datenvisualisierung und veränderbarer, engineering-orientierter Produktion. Wer die Unterschiede versteht, kann einen effizienten Workflow für die Videoproduktion aufbauen.
Fazit vorweg: Native Videogenerierung und Agent-basiertes Code-Rendering eignen sich für unterschiedliche Aufgaben. Charaktere, Realbild-Anmutung, natürliche Bewegungen und die Bildsprache überlassen Sie nativen Videomodellen wie Seedance, Kling und Veo; Datencharts, Formeln, Software-Tutorials, Preisangaben und templatebasierte Masseninhalte überlassen Sie der Code-Rendering-Pipeline aus Remotion, Manim und FFmpeg. Kombiniert liefern beide sowohl natürliche Bilder als auch präzise Kontrolle – der derzeit praktikabelste Produktionsansatz.
Inhaltsvorschau: Im Folgenden erkläre ich zunächst den grundlegenden Unterschied der beiden Routen im Ausgabemechanismus. Danach schlüssle ich die Fähigkeiten und Kosten der nativen Videomodelle (Seedance 2.5, Kling 4.0, Veo 3.1) sowie der Code-Rendering-Toolchain (Remotion, Manim, FFmpeg, Claude Motion, Codex) auf. Anschließend zeige ich anhand der unabhängigen Benchmark-Daten von VibeVideoBench, wie gut Agenten bei der Videoproduktion tatsächlich abschneiden. Zum Schluss stelle ich einen hybriden Produktionsablauf am Beispiel eines Produktwerbefilms vor und erkläre, welches Modell und welches Tool jeweils welchen Abschnitt übernimmt.
Wissenswert: Glossar der technischen Ansätze für KI-Video
| Begriff | Erklärung |
|---|---|
| Text-to-Video | Erzeugt direkt ein Video aus einer Texteingabeaufforderung |
| Image-to-Video | Erzeugt aus einem Referenzbild ein animiertes Video |
| Multimodal Reference | Nutzt gleichzeitig Bilder, Videos, Audio und weitere Materialien, um die Generierung zu steuern |
| Keyframe | Schlüsselbild, das den Bildzustand zu einem bestimmten Zeitpunkt festlegt |
| Timestamp-level Editing | Präzise Änderung eines Abschnitts anhand des Zeitpunkts im Video |
| Agent | Ein KI-System, das Aufgaben selbstständig plant, Werkzeuge aufruft, Ergebnisse prüft und korrigiert |
| Remotion | Werkzeug zur Erstellung von Videoanimationen mit React-Komponenten und Code |
| Manim | Engine zur Erstellung mathematischer und wissenschaftlicher Animationen mit Python |
| FFmpeg | Kommandozeilenwerkzeug für Videokodierung, Audiomischung, Schnitt und Formatkonvertierung |
| ffprobe | Von FFmpeg mitgeliefertes Prüfwerkzeug, das Auflösung, Bildrate, Dauer und Tonspuren ausliest |
| TTS | Text-to-Speech, zur automatischen Erzeugung von Off-Kommentaren |
| Deterministic Rendering | Deterministisches Rendering: gleicher Code und gleiche Parameter erzeugen jedes Mal dasselbe Bild |
| Claude Motion | Funktion von Anthropic, die codegesteuerte Animationen als Produkt verpackt, derzeit Beta |
| Cache Hit | Cache-Trefferquote: wiederholter Kontext wird direkt aus dem Cache gelesen, was die Token-Kosten deutlich senkt |
1 Zwei technische Wege für KI-Videos: völlig unterschiedliche Ausgabemechanismen
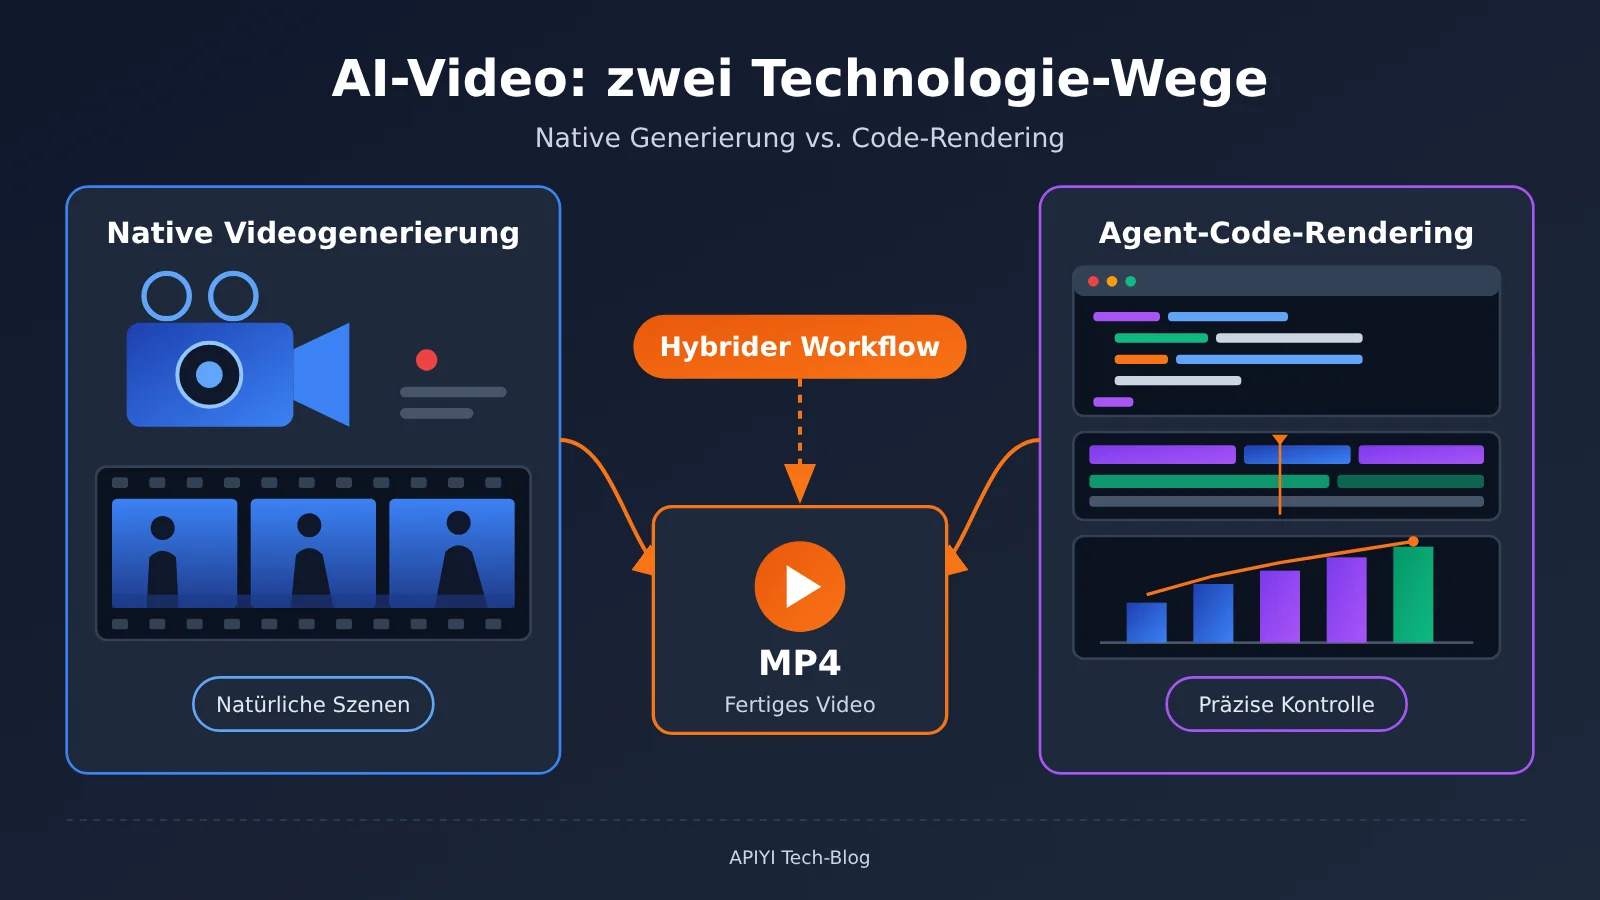
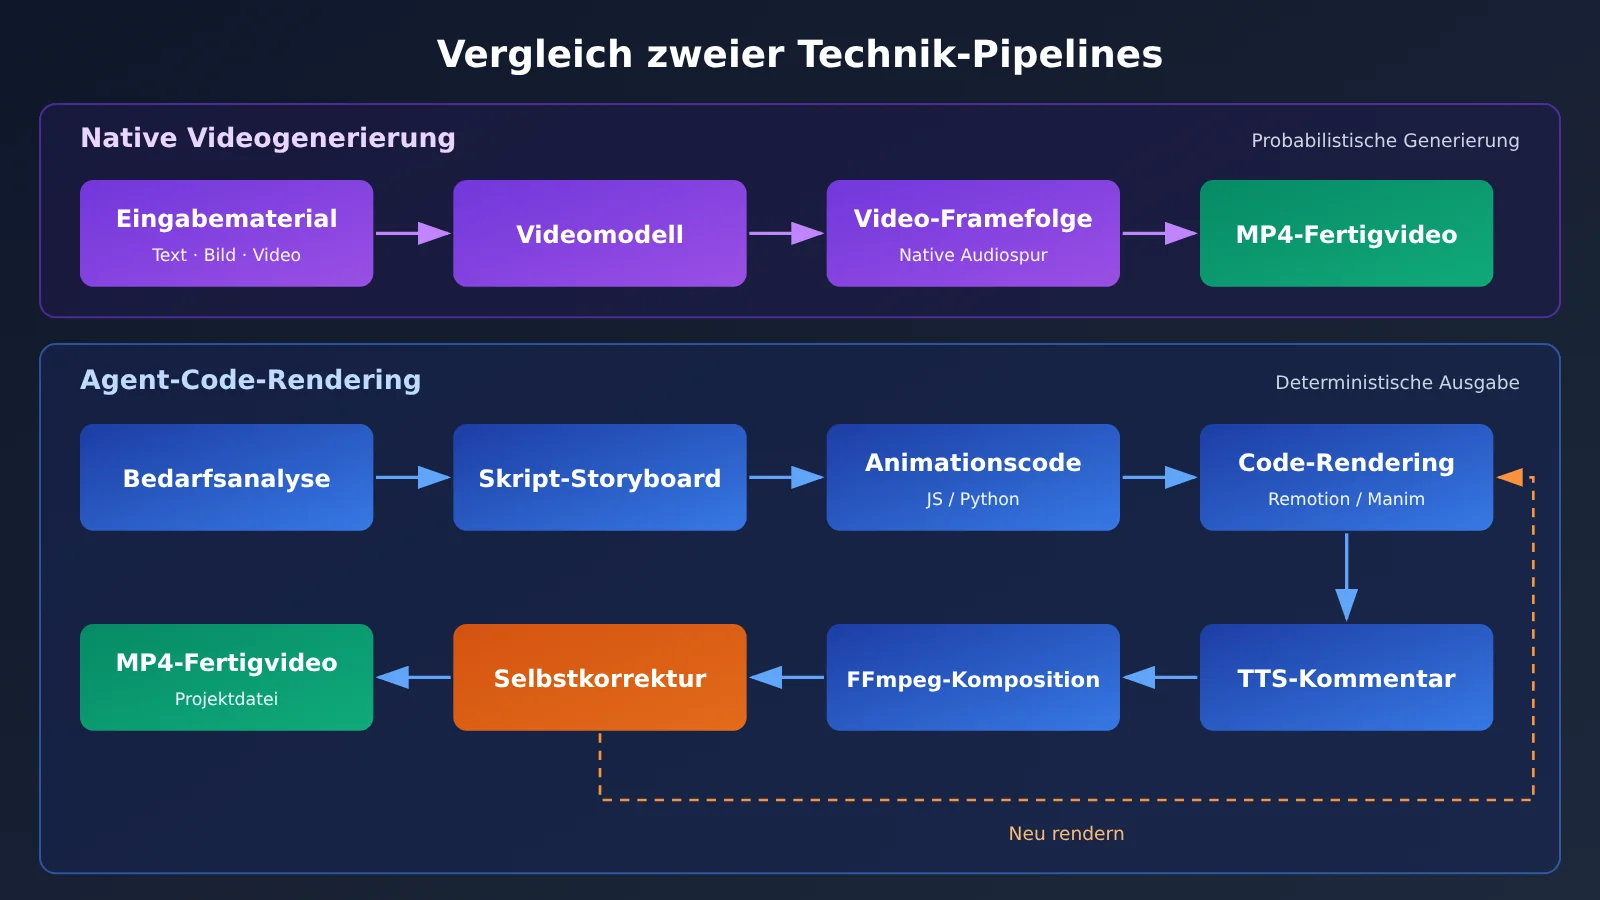
Beide Wege liefern am Ende eine MP4-Datei. Doch die Art und Weise, wie die Bilder entstehen, unterscheidet sich grundlegend. Bei der nativen Videogenerierung „zeichnet“ das Modell jedes Einzelbild direkt. Beim Agent-Code-Rendering schreibt das Modell ein Videoproduktionsprogramm, das anschließend eine Rendering-Engine ausführt, um die Bilder zu erzeugen. Dieser Unterschied bestimmt sämtliche Abweichungen bei Steuerungsgenauigkeit, Änderbarkeit und Kosten.
1.1 Native Videogenerierung: Das Modell erzeugt die fortlaufenden Bilder selbst
Native Videogenerierung basiert auf Text-zu-Video und Bild-zu-Video. Nutzer geben eine Textbeschreibung oder ein Referenzbild vor, und das Modell erzeugt direkt aufeinanderfolgende Videoframes. Personen, Objekte, Umgebung, zusammenhängende Bewegungen und physikalische Bewegungsabläufe entstehen in einem Durchgang. Kamerafahrten und Zooms, Wechsel der Einstellungsgröße und Szenenwechsel lassen sich ebenfalls in der Eingabeaufforderung festlegen.
Die neue Modellgeneration kann bereits nativen Ton synchron dazu erzeugen und unterstützt mehrere Referenzbilder und Referenzvideos, mit denen sich das Aussehen der Personen, die Szene und der visuelle Stil steuern lassen. Der Vorteil: Die Bilder wirken natürlich und sehr realistisch. Der Preis dafür: Jedes Einzelbild entsteht durch probabilistische Generierung. Zwei Läufe mit derselben Eingabeaufforderung liefern nicht dasselbe Ergebnis, und pixelgenaue Änderungen erfordern eine Neugenerierung oder eine spezielle Bearbeitungsfunktion.
1.2 Agent-Code-Rendering: Die KI schreibt ihr Videoproduktionsprogramm selbst
Beim Agent-Code-Rendering übernimmt das Große Sprachmodell gleichzeitig die Rolle des Regisseurs und des Programmierers. Ein vollständiger Ablauf umfasst typischerweise folgende Schritte:
- die Anforderung verstehen und Thema, Zielgruppe sowie visuellen Stil festlegen;
- Skript, Off-Kommentar, Storyboard und Zeitachse schreiben;
- Animationscode mit JavaScript und Python schreiben (Remotion, Manim, Three.js, Cairo, Blender usw.);
- TTS aufrufen, um den Off-Kommentar zu erzeugen, und Musik sowie Soundeffekte erstellen;
- FFmpeg aufrufen, um Bild und Ton zusammenzuführen;
- Bild, Ton und Timing auf Synchronität prüfen, Probleme beheben und neu rendern;
- eine fertige MP4-Datei und wiederverwendbare Projektdateien ausgeben.
Die Ausgabe dieses Wegs ist deterministisch: Bleiben Code und Parameter unverändert, ändert sich auch das Rendering-Ergebnis nicht. Wenn man eine Zahl, eine Untertitelzeile oder eine Farbgebung ändert, passt man einfach den Code an und rendert neu; alle anderen Bilder bleiben unverändert. Dieser Weg eignet sich gut für Datenvisualisierung, Produktpräsentationen, Wissensvermittlung und animierte Infografiken. Für echte Personen und Realaufnahmen ist man dagegen auf vorhandenes Material oder 3D-Assets angewiesen.
2 Der native Videogenerierungs-Ansatz: Für welche Aufgaben er geeignet ist
Die nativen Videomodelle des Jahres 2026 haben die maximale Dauer einer einzelnen Generierung bereits auf 30 Sekunden erhöht. Der Wettbewerb verlagert sich zunehmend auf multimodale Referenzen, Keyframe-Steuerung und die kontinuierliche Bearbeitung nach der Generierung. Die folgende Tabelle fasst die öffentlich bekannten Fähigkeiten von drei repräsentativen Modellen zusammen.
| Fähigkeit | Seedance 2.5 | Kling 4.0 | Veo 3.1 |
|---|---|---|---|
| Veröffentlichung/Verfügbarkeit | Veröffentlicht am 2026-07-31 | API seit 2026-10-28 vollständig verfügbar | In der Gemini-API-Dokumentation aufgeführt |
| Dauer pro Generierung | Bis zu 30 Sekunden | Bis zu 30 Sekunden | Unterstützt Videoverlängerung |
| Referenzmaterial | 30 Bilder, 10 Videoclips, 10 Audioclips | 10 Bilder, 5 Videoclips; maximal 15 Elemente kombiniert | Generierung mit Bildführung |
| Zentrale Steuerungsfunktionen | Mehrfache Verlängerung, Zeitstempelbearbeitung, Greenscreen- und Kamerapositionsbearbeitung | Bis zu 10 Keyframes, Sprachreferenz | Endbild-Steuerung, Videoverlängerung |
| Audio | Audio-Referenzen unterstützt | Sprachreferenzen unterstützt | Native Audiogenerierung |
| Abrechnung | Nach Auflösung und Dauer (inkl. Token-Verbrauch) | Nach Unit/Sekunde | Nach Generierungsspezifikation |
2.1 Seedance 2.5: 30-Sekunden-Dauergenerierung und multimodale Referenzen
Seedance 2.5 wurde am 31. Juli 2026 vom Seed-Team bei ByteDance veröffentlicht. Eine einzelne Generierung kann bis zu 30 Sekunden lang sein und mehrere aufeinanderfolgende Einstellungen umfassen. Die Referenzmöglichkeiten sind die breitesten unter den derzeit öffentlich bekannten Parametern: bis zu 30 Referenzbilder, 10 Referenzvideos und 10 Referenzaudios. So lassen sich Charakterdesign, Szenenfotos, Bewegungsreferenzen und Filmmusik gemeinsam an das Modell übergeben, das daraus komplexe Szenen zusammensetzt.
Auf der Bearbeitungsebene unterstützt Seedance 2.5 das mehrfache Verlängern bestehender Videos bei möglichst weitgehender Konsistenz von Figuren, Szenen und Ton. Außerdem lassen sich Figurenbewegungen und Handlung zu festgelegten Zeitpunkten ändern, und es gibt Green-Screen-Bearbeitung, Kameraperspektiv-Bearbeitung sowie Konsistenz über mehrere Figuren hinweg. Mit Clay Render (Ton-Rendering) als Referenz können zudem Raumstruktur, Figurenpositionierung und Kamerabewegung gesteuert werden. Die offiziellen Beispiele decken Peking-Oper-Darstellungen, Bühnenauftritte, Interaktionen mehrerer Figuren und aufeinanderfolgende Szenenwechsel ab – genau jene Inhalte mit vielen Figuren, langen Einstellungen und fortlaufender Erzählung, die beim Code-Rendering am schwierigsten umzusetzen sind.
2.2 Kling 4.0: Keyframes und Videoreferenz-Steuerung
Kling 4.0 hat am 28. Oktober 2026 die API vollständig geöffnet. Eine Generierung dauert maximal 30 Sekunden, unterstützt 720p und 1080p, und die Seitenverhältnisse umfassen 21:9 sowie ein adaptives Format. Das Besondere: bis zu 10 Keyframes – Creator können mehrere Bildzustände auf der Timeline festlegen, und das Modell füllt die Bewegung zwischen den Keyframes aus. Dadurch lassen sich Kameraführung und Figurenposen deutlich kontrollierter steuern.
Beim Referenzmaterial unterstützt Kling 4.0 bis zu 10 Referenzbilder und 5 Referenzvideos, mit bis zu 15 Elementen pro gemischtem Eingang, und bietet Omni-multimodale Referenzen sowie Sprachreferenzen. Es bündelt Textgenerierung, Bilderzeugung, Referenzmaterial und Videobearbeitung in einem – ideal für Projekte, die eine stabile Figurendarstellung, einen vorgegebenen Kamerapfad oder eine Nachbearbeitung bestehender Videos benötigen.
2.3 Veo 3.1: Native Audio und Videoverlängerung
Google bietet in der Gemini API zwei Kategorien von Videogenerierungsprodukten. Veo 3.1 legt den Fokus auf native Audiogenerierung, Videoverlängerung, Endbild-Steuerung und bildgesteuerte Generierung – passend, wenn in einem Durchgang ein Clip mit „Ton und Bild“ entstehen soll; Gemini Omni Flash konzentriert sich auf multimodale Eingaben, Figurenkonsistenz, Videoverständnis und mehrrundige dialogbasierte Bearbeitung. Die beiden stehen für zwei Richtungen im Bereich nativer Videos: hochwertige Clips generieren sowie nach der Generierung kontinuierlich bearbeiten, ändern und verlängern.
Bei OpenAI: Das Sora-Produkt wurde am 26. April 2026 eingestellt, das Sora-2-Modell und die Videos API wurden am 24. September 2026 abgeschaltet; die offizielle Deprecation-Ankündigung weist darauf hin, dass es keine 1:1-Ersatz-API gibt. Die am 4. November 2026 veröffentlichten Images 2.6 unterstützen GIF-Animationen mit 2 bis 16 Frames, geeignet für animierte Emojis, Loops für Figurenbewegungen und Storyboard-Vorschauen – ein anderer Workflow als die vollständige MP4-Video-Produktion.
2.4 Vorteile und Kosten der nativen Videogenerierung
Der Kernvorteil der nativen Videogenerierung lässt sich auf vier Bereiche konzentrieren: natürliche menschliche Bewegungen, glaubwürdige physikalische Bewegungen, filmische Kamerabewegungen und offener kreativer Ausdruck. Diese Fähigkeiten mit Code umzusetzen, erfordert eine Menge Animationsassets und manuelle Abstimmung; mit einem Videomodell lassen sie sich in einem Durchgang erzeugen.
Bei den Kosten wird native Videogenerierung nach Ausgabespezifikation und Dauer abgerechnet. Ein Beispiel sind die offiziellen Preise von Seedance 2.5, die BytePlus ModelArk am 13. November 2026 aktualisiert hat:
| Ausgabespezifikation | Referenzpreis für 5-Sekunden-Video | Schätzung pro Sekunde |
|---|---|---|
| 480p | $0.514 | $0.103 |
| 720p | $1.156 | $0.231 |
| 1080p | $2.843 | $0.569 |
Von 720p auf 1080p steigen die Kosten pro Sekunde etwa auf das 2.5-Fache. Die obige Tabelle ist eine offizielle Schätzung für typische Spezifikationen; Länge, Auflösung und Bildrate des Eingabevideos sowie der tatsächliche Token-Verbrauch beeinflussen die endgültige Rechnung. Kling 4.0 wird dagegen nach Plattform-Units abgerechnet: 720p sind 1 Unit/Sekunde, 1080p sind 1.5 Units/Sekunde, Kling 4.0 Flash 720p sind 0.6 Units/Sekunde; wenn bereits Videomaterial als Eingabe vorliegt, hängt die Abrechnung zusätzlich von der Eingabedauer ab. Ein Unit ist eine Abrechnungseinheit der Plattform und muss nach den Plattformregeln in einen tatsächlichen Betrag umgerechnet werden.
Zu beachten ist, dass diese Preise den Kosten für „eine Generierung“ entsprechen. Native Videogenerierung ist mit Zufälligkeit behaftet; in der Praxis wird oft mehrfach generiert und anschließend ausgewählt, sodass die Kosten für die letztlich verwendbaren Aufnahmen in der Regel höher liegen als der Preis für einen einzelnen Durchlauf.
3 Agent-Code-Rendering-Ansatz: KI zum Video-Produktionsingenieur machen
Der Kern des Code-Rendering-Ansatzes ist eine Reihe ausgereifter Open-Source- oder kommerzieller Tools. Das Große Sprachmodell übersetzt die Anforderungen in Code, den diese Tools ausführen können, und übernimmt die Steuerung, Prüfung und Fehlerbehebung.
3.1 Remotion: React-Animation und automatisierte Videoproduktion
Remotion beschreibt das Bild mit React-Komponenten und steuert über die Frame-Nummer Position, Größe, Transparenz und Bewegung der Elemente. Entwickler können Animationen direkt mit React, HTML, CSS und JavaScript erstellen. Im Bild lassen sich Text, Diagramme, Bilder, Videos und Audio kombinieren, und jeder einzelne Frame kann präzise kontrolliert werden. Es unterstützt CLI-Batch-Rendering, serverseitiges Rendering und Cloud-Lambda-Rendering; außerdem lassen sich durch Übergabe unterschiedlicher Parameter Videos mit unterschiedlichen Inhalten in Batches erzeugen.
Der offizielle Rendering-Ablauf ist sehr schlicht:
# Remotion installieren
npm install remotion @remotion/cli

# Angegebene Videokomposition (Composition) rendern und als MP4 ausgeben
npx remotion render HelloWorld out.mp4
Zur Lizenzierung: Remotion ist für Einzelpersonen und kleine Unternehmen mit bis zu 3 Personen kostenlos, eine kommerzielle Nutzung ist zulässig, sofern die Bedingungen erfüllt sind. Das Automators-Paket wird mit $0.01 pro Rendering abgerechnet, bei einem Mindestumsatz von $100 pro Monat; das Creators-Paket kostet $25 pro Lizenzplatz/Monat; das Enterprise-Paket ab $500/Monat (aktualisiert am 14. November 2026). Die Rendering-Lizenzgebühren von Remotion und die Token-Kosten, die das KI-Modell beim Schreiben des Codes verbraucht, sind zwei getrennte Kostenposten – bei der Kalkulation müssen sie getrennt berechnet werden.
3.2 Manim: präzise Animationen für Mathematik und Naturwissenschaften
Manim ist eine Python-Animations-Engine, die speziell für die Darstellung mathematischer Formeln, geometrischer Transformationen, physikalischer Bewegungsabläufe, der Funktionsweise von Algorithmen sowie die Erklärung wissenschaftlicher Experimente ausgelegt ist. Formeln, Koordinatenachsen, geometrische Strukturen und die Bewegungsbeziehungen zwischen Objekten werden allesamt durch Code definiert – dadurch sind die Positionen jedes Symbols und jeder Kurve exakt kontrollierbar. Von nativen Videomodellen erzeugte Formeln weisen häufig Zeichen- oder Strukturfehler auf – genau hier liegt die Stärke von Manim.
Das offizielle Schnellstart-Beispiel erzeugt mit einem einzigen Befehl eine MP4-Datei:
manim -pql main.py CreateCircle
3.3 FFmpeg: aus unterschiedlichem Material das finale Video machen
FFmpeg ist die „Montagelinie“ entlang der gesamten Code-Rendering-Kette. Es übernimmt Videokodierung und -transkodierung, das Zusammenführen von Audio, das Aneinanderreihen mehrerer Segmente, das Einbrennen von Untertiteln, Zuschneiden und Skalieren, Framerate-Umwandlung sowie Formatkonvertierung. Das dazugehörige ffprobe kann die Auflösung, Framerate, Dauer und Audiospur-Informationen der fertigen Datei auslesen – der Agent nutzt es für die automatische Abnahme: Werden die Spezifikationen nicht erfüllt, geht es zurück zum vorherigen Schritt zur Korrektur.
# Segmente zusammenfügen (in list.txt sind die jeweiligen Segmentdateien zeilenweise aufgelistet)
ffmpeg -f concat -safe 0 -i list.txt -c copy merged.mp4

# Voiceover zusammenführen und Untertitel einbrennen
ffmpeg -i merged.mp4 -i voice.mp3 -vf subtitles=subs.srt \
  -map 0:v -map 1:a -c:v libx264 -c:a aac final.mp4

# Ausgabespezifikationen prüfen
ffprobe -v error -show_entries stream=codec_type,width,height,r_frame_rate \
  -show_entries format=duration final.mp4
3.4 Claude Motion: Code-Animation wird zur normalen Produktfunktion
Anthropic hat am 8. Oktober 2026 Claude Motion Beta vorgestellt und stellt damit codegesteuerte Animationen direkt Unternehmensnutzern zur Verfügung. Nutzer beschreiben ihre Animationsanforderungen in natürlicher Sprache, Claude setzt Text, Diagramme, Formen und Bilder zu einer Code-Animation zusammen und speichert sie in Artifacts; anschließend lässt sich das Ergebnis weiter im Dialog anpassen, in den Editor wechseln und dort manuell feilen, um schließlich MP4 zu exportieren.
Typische Anwendungsfälle sind: Quartalsberichte in 30-sekündige Erklärvideos verwandeln, Preispläne als dynamische Vergleichsgrafiken aufbereiten, Produktschritte als geführte Animationen darstellen und Meeting-Materialien als internes Werbevideo nutzen. Zu den Nutzungsbedingungen: Die Beta richtet sich an Team- und Enterprise-Nutzer, bei Team ist sie standardmäßig aktiviert, bei Enterprise muss ein Organisationsadministrator sie freischalten, und die Nutzung wird auf das Kontingent des jeweiligen Tarifs angerechnet. Claude Motion ruft kein natives Videogenerierungsmodell auf und kann daher keine echten Personen oder durchgehende Aufnahmen im Live-Action-Stil erzeugen.
Der Produktwert von Claude Motion liegt in der niedrigen Einstiegshürde: Mitarbeiter aus Betrieb, Finanzen und Marketing können die Präzision und Anpassbarkeit von Code-Animationen direkt nutzen, ohne ein Remotion-Projekt aufsetzen zu müssen.
3.5 GPT + Codex: Agenten rufen Werkzeuge auf und produzieren so Videos
Eine weitere Ausprägung besteht darin, ein Allzweckmodell in einer Agent-Entwicklungsumgebung eigenständig Werkzeuge aufrufen zu lassen. Genau diese Fähigkeit bewertet VibeVideoBench, veröffentlicht am 26. Oktober 2026: 239 echte Videoproduktionsaufgaben aus 12 Inhaltskategorien – Datengeschichten, Lehrkurse, Paper-Erklärungen, Markenmarketing, Produktfunktions-Demos und mehr. Jede Aufgabe verlangt, dass die KI innerhalb von 60 Minuten in einer Sandbox selbstständig ein abspielbares MP4 abliefert, dazu ein Projekt, aus dem sich das Video neu erzeugen lässt, sowie Zeitplan und Produktionsnotizen. 9 Agentensysteme absolvierten zusammen 2,151 Läufe – jeweils in ihrer eigenen nativen Entwicklungsumgebung und mit der höchsten verfügbaren Inferenz-Intensität; menschliche Zwischenanweisungen waren nicht erlaubt.
Der Vergleich der beiden bestplatzierten Systeme sieht so aus (Mittel über drei Jurorenteams, Bewertungsskala 1–5):
| Kennzahl | GPT-6 Astra (Codex CLI) | Claude Opus 5.5 (Claude Code) |
|---|---|---|
| Erfolgreich gelieferte Videos | 238/239 (99.6%) | 239/239 (100%) |
| Einhaltung der Spezifikation | 93.7% | 99.6% |
| Bestehensquote der Aufgabenanforderungen | 97.1% | 97.3% |
| Gesamtqualitätswert | 4.109 | 4.074 |
| Strikte Erfolgsquote | 74.5% | 76.3% |
| Menschliche Präferenz (Elo) | 1242 | 1203 |
| Durchschnittliche Kosten pro Aufgabe | $8.19 | $15.38 |
| Median- / P90-Kosten pro Aufgabe | $7.88 / $11.88 | $10.19 / $31.22 |
| Durchschnittliche Ausgabe-Token | 61K | 130.7K |
| Cache-Trefferquote | 97% | 65% |
In diesem Testset lag GPT-6 Astra bei Gesamtqualität und menschlicher Präferenz leicht vorn und kostete pro Aufgabe rund 46.7 % weniger; Claude Opus 5.5 lieferte alle 239 Aufgaben ab und erzielte eine höhere Spezifikationstreue sowie eine höhere strikte Erfolgsquote. Der Kostenunterschied kommt vor allem aus der Token-Effizienz: Astra braucht rund 53.3 % weniger Ausgabe-Token und erreicht eine Cache-Trefferquote von 97 %, während bei Opus etwa 76 % der Aufgabenkosten aus Cache-Writes stammen. Obwohl Astra beim Standardpreis für Ein- und Ausgabe das 2,5-Fache von Opus kostet, ist die tatsächliche Ausgabe pro Aufgabe unterm Strich günstiger.
Diese Zahlen muss man im Kontext des Bewertungsrahmens lesen: Bewertet wird ein vollständiges Agentensystem aus „Modell + Ausführungsumgebung“, und Codex CLI und Claude Code, die GPT bzw. Claude nutzen, unterscheiden sich schon für sich genommen; jede Aufgabe läuft nur einmal, mit 60 Minuten Zeitlimit; die Rangkorrelation zwischen den drei Jurorenteams liegt bei 0.933–0.950 und die mit dem menschlichen Elo-Ranking bei 0.98 – aber die Übereinstimmung zwischen menschlicher Präferenz und Jury-Ergebnis beträgt bei einzelnen Videos nur 73.3 %. Die Werte taugen also für eine grobe Einschätzung des Systemniveaus, nicht für eine Übertragung auf alle Videotasks und schon gar nicht als Ersatz für die Bewertung nativer Text-to-Video-Modelle.
VibeVideoBench legt außerdem den zentralen Engpass von Agenten bei der Videoproduktion offen: Von den 2,151 Läufen lieferten 224 kein abspielbares Video, und 169 dieser Fälle waren Zeitmanagement-Probleme – das finale Rendering startete zu spät, lief zu langsam oder wurde gar nicht erst gestartet – also rund 75 % aller Fehlerfälle. Die eigentliche Schwierigkeit für Video-Agenten hat sich damit verschoben: weg von der Frage „Kann das System überhaupt Animationscode schreiben?“ hin zu Rendering-Scheduling und Liefermanagement.
Im Vergleich zu Claude Motion richten sich Agent-Umgebungen wie Codex und Claude Code an Entwickler: Remotion, Manim, FFmpeg, TTS und Bildschirmaufzeichnung lassen sich frei kombinieren, um vollständige Projektdateien zu erzeugen – ideal für die Anbindung an automatisierte Produktionslinien. Claude Motion hingegen ist auf Endanwender in Unternehmen ausgelegt, die Interaktion ist einfacher, und die Fähigkeiten beschränken sich auf Text-, Diagramm- und Formanimationen.
4 Native Videogenerierung oder Agent-Code-Rendering – was ist die richtige Wahl?
4.1 Aufgaben, die sich für native Videogenerierung eignen
- Realistischer Personen-Look: echte Menschen vor der Kamera, Mimik und Körperbewegungen;
- Produktnutzungsszenarien: Szenen, in denen ein Produkt in einer realen Umgebung verwendet wird;
- Natürliche Bewegung und Bildsprache: Zoom, Schwenk, Kamerafahrten, Mitlaufen, Wechsel der Bildgröße;
- Werbespots mit Kinofeeling: Markenfilme, bei denen Licht, Atmosphäre und Textur im Vordergrund stehen;
- Schauspiel und fortlaufende Handlung: Interaktion mehrerer Figuren, Erzählung in langen Einstellungen;
- Komplexe natürliche Umgebungen: Wetter, Wasserströmungen, Stadtansichten und andere schwer zu modellierende Szenen.
4.2 Aufgaben, die sich für codegesteuerte Produktion eignen
- Präzise Datenvisualisierungen: Zahlen, Koordinaten und Proportionen müssen exakt stimmen;
- Software-Tutorials: Bildschirmaufnahmen mit Beschriftungen, Hervorhebungen und Schrittbeschreibungen;
- Mathematik- und Wissenschaftserklärungen: Formelherleitungen, geometrische Transformationen, Algorithmus-Demos;
- Dynamische Infografiken: schrittweise Darstellung strukturierter Informationen;
- Produktparameter-Vergleiche und Preisangaben: jeder Wert lässt sich nachprüfen und anpassen;
- Vorlagenbasierte Massenproduktion: hunderte Videos aus derselben Vorlage mit ausgetauschten Daten.
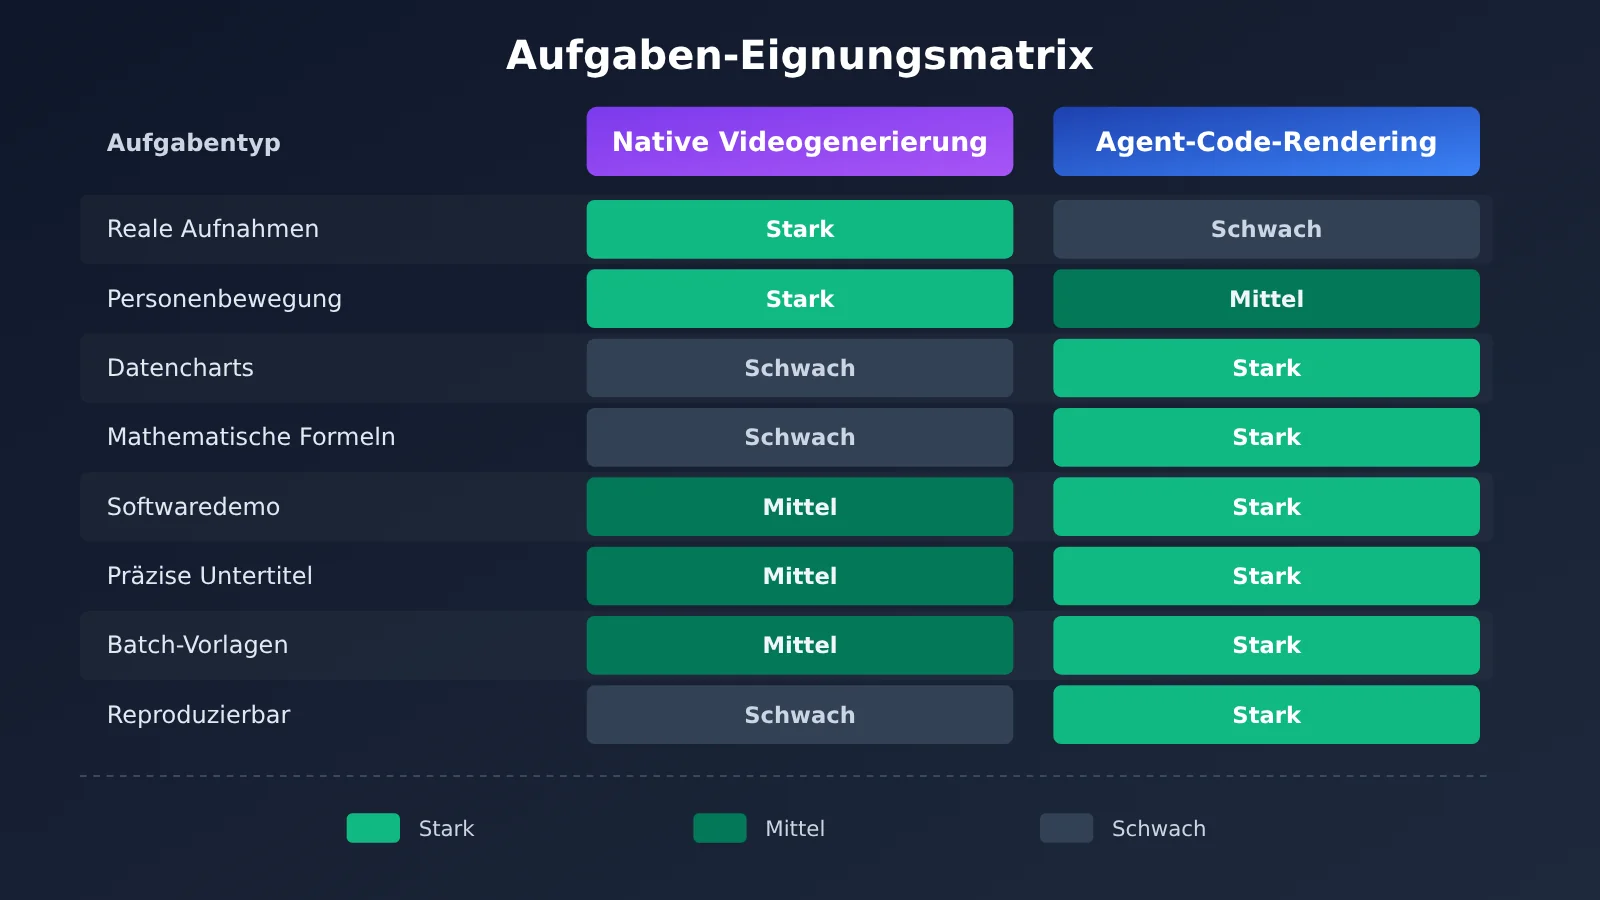
Die folgende Tabelle fasst zusammen, wie gut die beiden Ansätze bei gängigen Aufgaben passen:
| Aufgabe | Native Videogenerierung | Agent-Code-Rendering |
|---|---|---|
| Kinoreife Realdreh-Aufnahmen | Stark | Benötigt vorhandenes Material oder 3D-Assets |
| Natürliche Bewegungen von Personen | Stark | Abhängig von Animations-Assets |
| Komplexe Kamerabewegungen | Stark | Lässt sich präzise programmieren |
| Präzise Datenpräsentation | Schwer zuverlässig | Stark |
| Animation mathematischer Formeln | Fehleranfällig | Stark |
| Demonstration von Software-Oberflächen | Benötigt Referenzmaterial und Nachbearbeitung | Stark |
| Präzise Untertitel | Benötigt Nachbearbeitung und Prüfung | Stark |
| Dynamische Produktpräsentation | Stark | Stark |
| Massenproduktion mit einheitlicher Vorlage | Mehrfache Generierung und Auswahl nötig | Stark |
| Präzise Korrektur einzelner Details | Abhängig von Neu-Generierung oder Bearbeitung | Stark |
| Reproduzierbare Generierung identischer Animationen | Durch Zufälligkeit beeinflusst | Stark |
Auch die Studie zu VibeVideoBench weist darauf hin, dass sich Code-Rendering besonders für exakte Formeln, Datenvisualisierungen, Spielszenen mit konsistenten Regeln und synchronisierte Off-Kommentare eignet.
💡 Auswahlempfehlung: Das Kriterium lässt sich in einem Satz zusammenfassen – wenn das Bild „echt aussehen“ soll, verwenden Sie ein natives Videomodell; wenn die Informationen „exakt stimmen“ müssen, nutzen Sie Code-Rendering. Skripte, Storyboards und Animationscodes in der Code-Rendering-Pipeline hängen alle von universellen großen Sprachmodellen ab. Wir empfehlen, zunächst über APIYI apiyi.com mit demselben API-Schlüssel GPT, Claude und Gemini für Ihre Skript- und Code-Aufgaben zu testen und erst dann das Hauptmodell zu bestimmen.
4.3 Kostenstruktur der beiden Ansätze
Die Kostenbestandteile der beiden Ansätze unterscheiden sich stark, ein direkter Vergleich der Stückpreise ist daher nur bedingt aussagekräftig:
- Native Videogenerierung: Die Abrechnung erfolgt hauptsächlich nach Ausgabeauflösung und Dauer, hinzu kommt der zusätzliche Verbrauch durch Referenzvideo-Eingaben. Versteckte Kosten entstehen durch die Zufälligkeit, die mehrere Generierungen und Auswahlprozesse nötig macht.
- Agent-basiertes Code-Rendering: Dazu zählen die Token-Kosten des allgemeinen Modells (Eingabe, Ausgabe, Cache-Lesen und -Schreiben), Rechenleistung für Codeausführung und Rendering, Tool-Lizenzen (etwa eine kommerzielle Remotion-Lizenz) sowie Kosten für TTS- und Musik-/Soundeffekt-Assets.
Beim Vergleich sollte man die „Gesamtkosten des letztlich lieferbaren Videos“ zugrunde legen: Muss ein nativer Video-Shot fünfmal generiert werden, um einmal ein brauchbares Ergebnis zu liefern, betragen die tatsächlichen Kosten das Fünffache des Angebotspreises. Bei einer Agent-Aufgabe steigen die Token-Kosten ebenfalls schnell, wenn die Cache-Trefferquote niedrig ist und wiederholt neu gerendert wird. Die Daten von VibeVideoBench zeigen, dass ein Modell mit höherem Stückpreis durch weniger Ausgabe-Token und eine höhere Cache-Trefferquote niedrigere Aufgabenkosten erzielen kann. Bei der Modellauswahl sollte man daher auf die gemessenen Kosten pro Aufgabe achten.
💰 Kostenoptimierung: In der Code-Rendering-Pipeline haben die Modellkosten einen hohen Anteil, und es handelt sich häufig um Aufrufe mit langem Kontext und mehreren Runden. Mit APIYI apiyi.com lassen sich mehrere gängige Modelle nutzungsbasiert aufrufen, sodass man mit demselben Code vergleichen kann, was die einzelnen Modelle für dieselbe Vide oaufgabe tatsächlich kosten, und die Modelle anschließend nach Aufgabentyp zuordnen kann.
5 Die effektivste Lösung: die beiden KI-Video-Technikpfade kombinieren
5.1 Hybrider Produktionsablauf
Die beiden Ansätze zu verbinden – native Videomodelle für natürliche Aufnahmen, Code-Rendering für präzise Darstellung – ist derzeit die praktikabelste Lösung:
- Kreativität und Storyboard: GPT oder Claude übernimmt Idee, Skript und Storyboard und kennzeichnet für jede Szene die Produktionsmethode;
- Natürliche Szenen: Seedance, Kling oder Veo erzeugen Personen, Schauplätze und Aufnahmen zur Produktnutzung;
- Präzise Bilder: Remotion übernimmt Datencharts, Untertitel, Markenelemente und Animationen von Produktparametern;
- Voice-over: TTS erzeugt anhand des Skripts die Erzählstimme;
- Komposition: FFmpeg fügt die Szenen zusammen, führt die Audiospuren zusammen und brennt Untertitel ein;
- Abnahme und Korrektur: Der KI-Agent prüft mit ffprobe die Spezifikationen, kontrolliert Bild-Ton-Synchronität und Untertitel und kehrt bei Problemen in den entsprechenden Schritt zurück, um sie zu beheben.
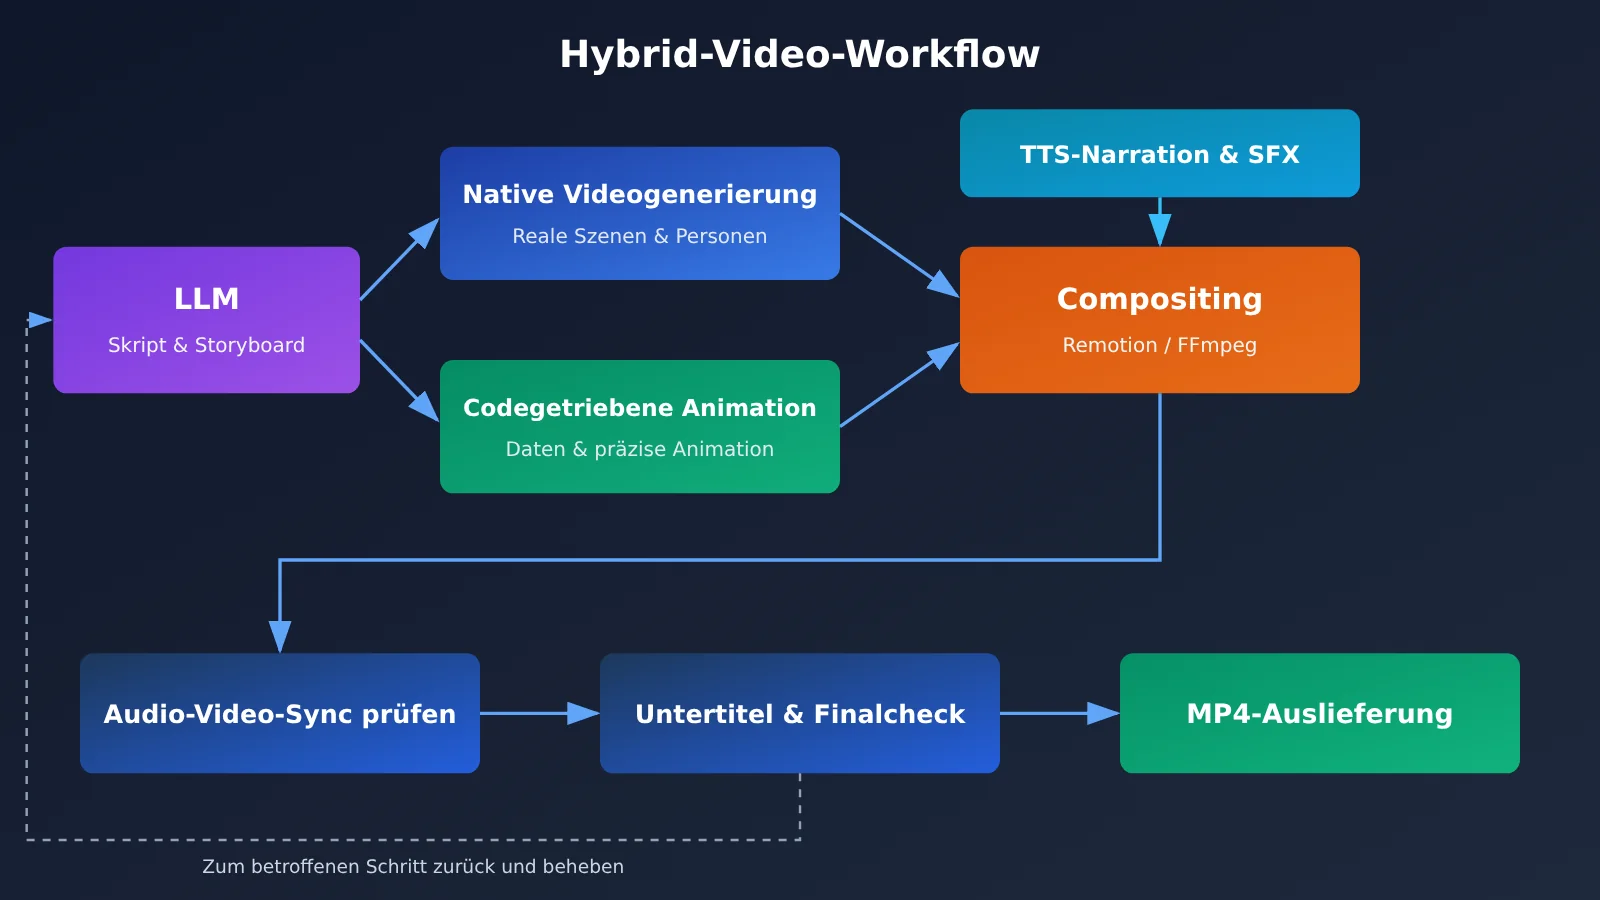
Im obigen Diagramm werden sowohl das Skript-Storyboard als auch die Prüfung des fertigen Videos von einem allgemeinen großen Sprachmodell erledigt. Diese Aufrufe lassen sich einheitlich über APIYI apiyi.com abwickeln: Mit einer einzigen OpenAI-kompatiblen Schnittstelle wechseln Sie flexibel zwischen GPT, Claude und Gemini.
5.2 Durchgängiges Beispiel: Arbeitsteilung bei einem Produktwerbefilm
Am Beispiel eines Produktwerbefilms für eine mobile App lässt sich die Arbeit so aufteilen:
- Eröffnungs- und Stimmungsaufnahmen (Nutzer in Pendel- und Bürosituationen): an Seedance 2.5 oder Kling 4.0 übergeben. Produktfotos und Charakter-Referenzbilder dienen als Referenz, damit Personen und Produkt konsistent aussehen; Kling 4.0 kann mit Keyframes die Bildkomposition für Anfang und Ende fixieren. Laut offizieller Schätzung von Seedance 2.5 kostet 720p etwa $0.231 pro Sekunde – bei der Budgetplanung sollte man zusätzlichen Spielraum für mehrere Generierungsdurchläufe einplanen.
- Funktionsdemo-Abschnitt: die echte App-Oberfläche aufzeichnen und anschließend mit Remotion Hervorhebungsrahmen, Schrittnummern und dynamische Beschriftungen überlagern. Die Oberflächeninhalte stammen aus echten Screencasts, sodass keine vom Modell „erfundenen“ Buttons auftauchen.
- Abschnitt mit Spezifikationen und Preisen: Funktionsvergleichstabellen und Preiskarten mit Remotion-Komponenten rendern. Bei Preisänderungen ändert man nur die Datendatei und rendert neu; die übrigen Bilder bleiben unverändert.
- Off-Kommentar und Untertitel: Ein großes Sprachmodell schreibt den Off-Kommentar-Text, TTS erzeugt die Vertonung und gibt gleichzeitig eine SRT-Untertiteldatei aus.
- Zusammenbau und Abnahme: FFmpeg fügt alle Segmente zusammen und erstellt die Tonspur; ein Agent prüft mit ffprobe Dauer, Auflösung und Tonspur und kontrolliert dann Abschnitt für Abschnitt, ob Untertitel und Off-Kommentar synchron sind.
Das Ergebnis dieser Arbeitsteilung: Für realistische Aufnahmen sorgt das Videomodell, für alle überprüfbaren Informationen der Code; bei späteren Änderungen müssen nur die entsprechenden Segmente neu gerendert werden.
5.3 Storyboards mit Routing-Kennzeichnung per API erzeugen
Der erste Schritt der Hybrid-Pipeline besteht darin, ein großes Sprachmodell ein strukturiertes Storyboard ausgeben zu lassen und für jede Einstellung anzugeben, welche Route sie nimmt. Das folgende Beispiel nutzt eine OpenAI-kompatible Schnittstelle für diesen Schritt:
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI-kompatible Schnittstelle
)

MODEL = "your-model-name"  # Durch den tatsächlichen Modellnamen aus der Modellliste der Plattform ersetzen

prompt = """为一款记账 App 写 30 秒宣传片分镜,输出 JSON 数组。
每个镜头包含 id、duration、description、route 字段。
route 只能是 native(真实人物与场景,交给视频模型)
或 code(数据、参数、字幕、界面标注,交给 Remotion 渲染)。"""

resp = client.chat.completions.create(
    model=MODEL,
    messages=[{"role": "user", "content": prompt}],
)
print(resp.choices[0].message.content)
Vollständige Implementierung ansehen: Storyboard-Routing + Generierung der Remotion-Renderparameter
import json
import subprocess
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

PLANNER_MODEL = "your-planner-model"  # Modell für Kreativkonzept und Storyboard
CODER_MODEL = "your-coder-model"      # Modell für die Generierung von Rendering-Parametern/Code


def plan_storyboard(brief: str) -> list[dict]:
    """Lässt das Modell ein Storyboard-JSON mit route-Kennzeichnung ausgeben."""
    resp = client.chat.completions.create(
        model=PLANNER_MODEL,
        messages=[
            {"role": "system", "content": "你是视频导演,只输出合法 JSON 数组。"},
            {"role": "user", "content": brief},
        ],
    )
    return json.loads(resp.choices[0].message.content)


def build_remotion_props(shot: dict) -> dict:
    """Erzeugt die Remotion-Komponenten-Props für eine Einstellung auf der code-Route."""
    resp = client.chat.completions.create(
        model=CODER_MODEL,
        messages=[
            {"role": "system", "content": "把镜头描述转换为 Remotion 组件 props,只输出 JSON 对象。"},
            {"role": "user", "content": json.dumps(shot, ensure_ascii=False)},
        ],
    )
    return json.loads(resp.choices[0].message.content)


def render_code_shot(shot_id: str, props: dict) -> str:
    """Rendert eine einzelne Einstellung über die Remotion-CLI."""
    out = f"out/{shot_id}.mp4"
    subprocess.run(
        ["npx", "remotion", "render", "InfoCard", out,
         f"--props={json.dumps(props, ensure_ascii=False)}"],
        check=True,
    )
    return out


if __name__ == "__main__":
    shots = plan_storyboard("为一款记账 App 写 30 秒宣传片分镜,"
                            "字段:id、duration、description、route(native/code)。")
    for shot in shots:
        if shot["route"] == "code":
            path = render_code_shot(shot["id"], build_remotion_props(shot))
            print("已渲染:", path)
        else:
            # native-Einstellungen werden an das Videogenerierungsmodell übergeben; hier wird die Eingabeaufforderung für die spätere Generierung protokolliert
            print("待原生生成:", shot["id"], shot["description"])
🚀 Schnellstart: Die oben beschriebenen Schritte zur Storyboard- und Parametererzeugung benötigen nur ein allgemeines großes Sprachmodell. Nach der Registrierung bei APIYI apiyi.com empfiehlt es sich, das kostenlose Testkontingent für neue Nutzer zu nutzen, zunächst zwei oder drei Modelle dieselbe Werbefilm-Anforderung durchlaufen zu lassen, Storyboard-Qualität und Token-Verbrauch zu vergleichen und erst danach den Ablauf für die Produktion festzulegen.
6 Fazit: Der Wettbewerb bei KI-Videos dreht sich um den vollständigen Produktions-Workflow
Die Aufgabenverteilung der beiden technischen Ansätze ist inzwischen klar: Die native Videogenerierung übernimmt realistische Bilder, schauspielerische Darstellung und Bildsprache – Seedance 2.5, Kling 4.0 und Veo 3.1 setzen jeweils eigene Schwerpunkte bei der 30-sekündigen kontinuierlichen Generierung, multimodalen Referenzen, Keyframes und fortlaufender Bearbeitung. Das agentenbasierte Code-Rendering übernimmt präzise Informationen, reproduzierbares Rendering und Massenproduktion – Remotion, Manim und FFmpeg bilden die Werkzeugbasis, Claude Motion macht das Ganze als Produkt für Unternehmenskunden verfügbar, und Codex sowie Claude Code ermöglichen Entwicklern den Aufbau vollständiger Automatisierungspipelines.
Die Ergebnisse von VibeVideoBench zeigen, dass Spitzen-Agentensysteme inzwischen zuverlässig komplette Videos liefern; die Hauptursachen für Fehlschläge liegen beim Rendering-Scheduling und im Zeitmanagement. Die Kosten pro Aufgabe hängen von der Token-Effizienz und der Cache-Trefferquote ab, nicht vom Stückpreis des Modells. Das bedeutet, dass der Wettbewerb in der Videoproduktion sich von der Bildqualität eines einzelnen Modells hin zur Organisationsfähigkeit des gesamten Workflows – „Generierung, Bearbeitung, Rendering, Auslieferung“ – verschiebt.
Die wichtigsten Punkte im Rückblick:
- Unterschied der Ansätze: Bei der nativen Generierung erzeugt das Modell die Bilder direkt, beim Code-Rendering schreibt das Modell ein Programm und rendert es anschließend;
- Native Generierung eignet sich für: Personen, Real-Film-Look, natürliche Bewegung, filmische Werbung und fortlaufende Handlung;
- Code-Rendering eignet sich für: Datenvisualisierungen, Formeln, Software-Tutorials, Parameter und Preise sowie vorlagenbasierte Masseninhalte;
- Basis für den Kostenvergleich: Maßgeblich sind die Gesamtkosten des final ablieferbaren Videos, einschließlich Wiederholungsversuchen, Token, Rendering und Lizenzgebühren;
- Best Practice: Hybrider Workflow – das Videomodell übernimmt natürliche Bilder, der Code die präzise Darstellung;
- Multi-Modell-Aufrufe: Skript, Storyboard, Animationscode und die Prüfung des fertigen Films eignen sich jeweils für unterschiedliche Modelle; eine einheitliche Schnittstelle senkt die Wechselkosten.
In der Praxis muss ein Video oft mehrere große Sprachmodelle aufrufen, um Ideenfindung, Codierung und Prüfung getrennt zu erledigen. Empfohlen wird, über APIYI apiyi.com mit einem einzigen API-Schlüssel einheitlich GPT, Claude, Gemini und andere Modelle aufzurufen, Modelle je nach Aufgabe zuzuweisen und nach Verbrauch abzurechnen – so bleibt die Energie auf den Workflow selbst konzentriert.
Referenzen
- Offizieller VibeVideoBench-Benchmark: Evaluierung von Agenten für codegesteuerte Videogenerierung
- Link:
vibevideobench.github.io -
Beschreibung: Rangliste mit 239 Aufgaben, Qualitätswerte, Analyse von Kosten und Fehlerursachen
-
Offizielle Ankündigung zu Seedance 2.5: 30-Sekunden-Generierung und multimodale Referenzierung
- Link:
seed.bytedance.com/en/blog/one-take-creation-flexible-referencing-introducing-seedance-2-5 -
Beschreibung: Obergrenze für Referenzmaterial, Verlängerung und Zeitstempel-Bearbeitung
-
BytePlus ModelArk Pricing: Preise für die Seedance 2.5 API
- Link:
docs.byteplus.com/en/docs/modelark/model-pricing -
Beschreibung: Referenzpreise für die Videogenerierung in verschiedenen Auflösungen
-
Kling API-Dokumentation: Ankündigung des Kling 4.0 Updates und Abrechnung
- Link:
kling.ai/document-api/apiReference/updateNotice -
Beschreibung: Keyframes, Referenzierung mehrerer Materialien und Unit-Abrechnungsregeln
-
Gemini API-Dokumentation zur Videogenerierung: Veo 3.1 und Gemini Omni Flash
- Link:
ai.google.dev/gemini-api/docs/video -
Beschreibung: native Audiospur, Verlängerung von Videos und mehrrundige Bearbeitung
-
Remotion-Dokumentation und Lizenzpreise
- Link:
remotion.dev/docs/render,remotion.dev/docs/license/pricing -
Beschreibung: Render-Befehle und kommerzielle Lizenzmodelle
-
Manim Community-Dokumentation
- Link:
docs.manim.community/en/stable -
Beschreibung: Verwendung der Engine für Mathematik- und Wissenschaftsanimationen
-
Offizielle FFmpeg-Dokumentation
- Link:
ffmpeg.org/documentation.html -
Beschreibung: Kodierung, Zusammenführung, Untertitel und ffprobe-Prüfung
-
Leitfaden zur Verwendung von Claude Motion
- Link:
support.claude.com/en/articles/17454997-get-started-with-claude-motion -
Beschreibung: Ablauf der Beta-Funktion und Freigabebedingungen
-
OpenAI API Deprecations
- Link:
developers.openai.com/api/docs/deprecations - Beschreibung: Informationen zur Einstellung von Sora 2 und der Videos API
- Link:
Autor: APIYI-Team
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite der APIYI-Website; weitere Integrationsunterlagen finden Sie im Dokumentationszentrum unter docs.apiyi.com