作者注:以 openJiuwen WorkSwarm 的上下文切换机制为案例,解读“交接摘要 + 归档检索”模式,梳理长时间运行的智能体在上下文窗口上限前的设计选项与取舍。
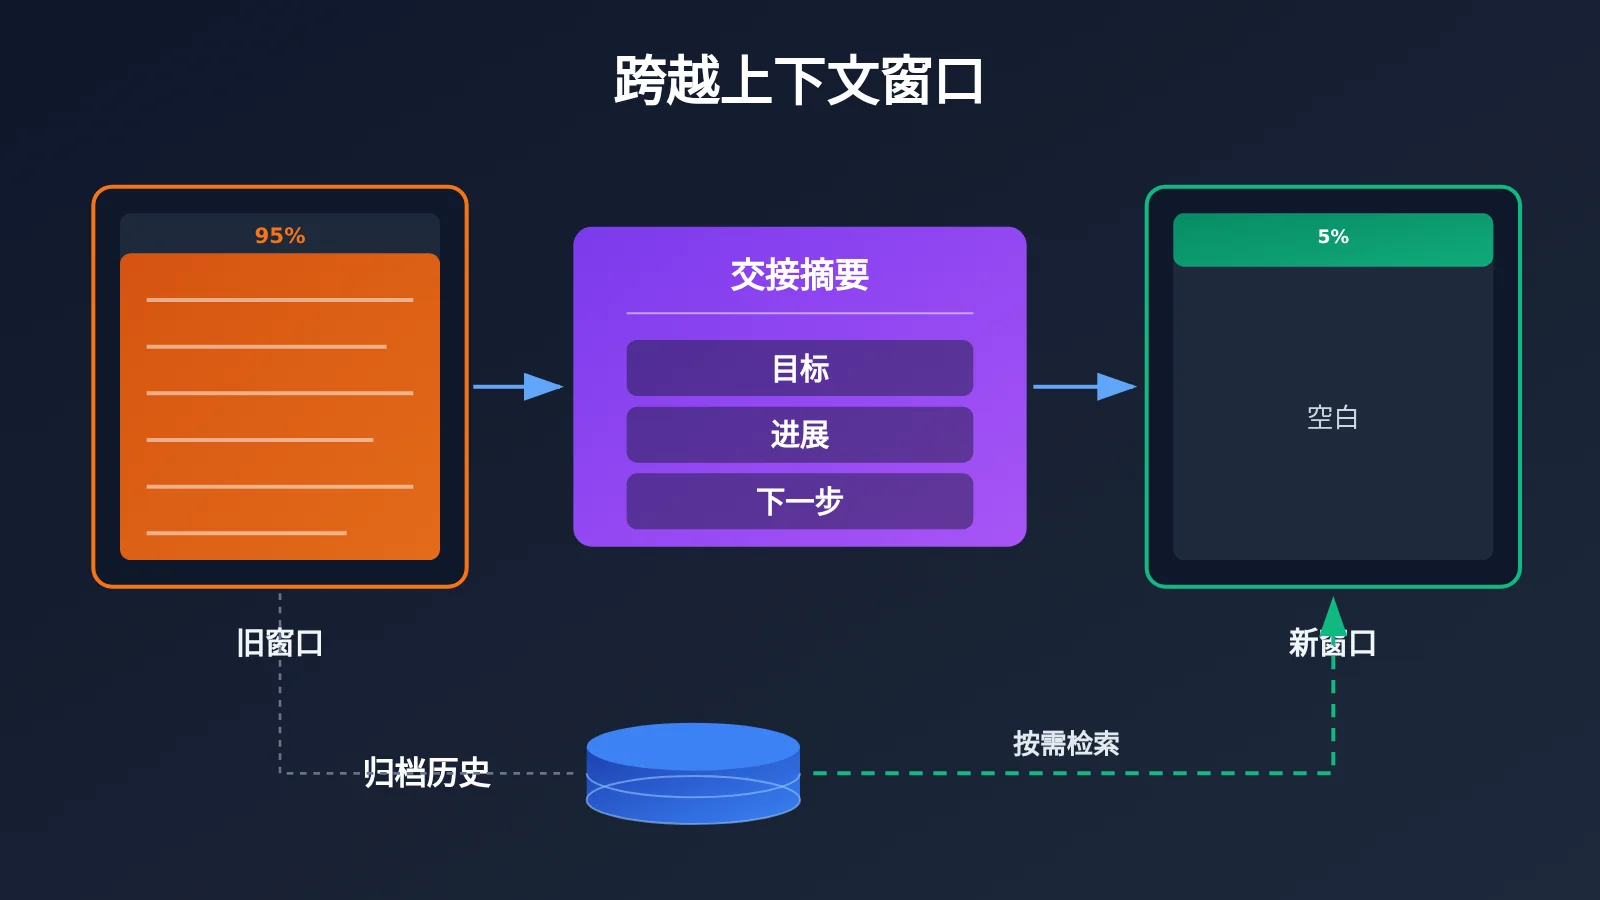
华为支持的开源智能体社区 openJiuwen 近期发布了 Hyper-Agent 集群架构。其中一个细节值得开发者关注:当智能体的上下文窗口接近上限时,它会切换到新窗口,带上一份包含目标、进展和下一步的交接摘要,需要细节时再去检索归档历史。这个机制只用一句话就讲完了,背后却是所有长周期智能体都要面对的工程问题。
这不是坊间传言。相关能力已随 openJiuwen WorkSwarm 发布,代码以 JiuwenSwarm 的名称在 GitHub 开源。本文以这一机制为案例,展开讨论交接摘要应包含什么、何时触发切换、何时回查归档这三个设计问题,并比较“依赖更长上下文”和“摘要交接 + 检索”两种思路的取舍。
核心价值:读完本文,你可以对照自己的智能体应用,梳理出处理上下文窗口上限的可选方案和各自的风险。
交接摘要 + 归档检索:核心信息速览
先把参考资料中能确认的事实整理清楚,再看它对开发者意味着什么。下表中的信息均来自公开报道,未经报道确认的实现细节会在后文单独标注。
| 信息项 | 详情 |
|---|---|
| 发布方 | openJiuwen,华为支持的开源智能体社区 |
| 发布内容 | Hyper-Agent 集群架构,能力落地在 openJiuwen WorkSwarm |
| 开源情况 | 代码以 JiuwenSwarm 名称在 GitHub 开源 |
| 核心变化 | 持久化智能体(Persistent Agent)保有自身身份与状态,会话变为系统调度的底层资源 |
| 上下文机制 | 窗口接近上限时切换新窗口,携带“目标、进展、下一步”的交接摘要,需要细节时检索归档历史 |
| 报道时间 | 2026 年 11 月初 |
为什么持久化智能体必须解决上下文窗口上限
WorkSwarm 的设计思路是让智能体脱离单个聊天会话,作为“数字员工”长期驻留在飞书、钉钉等工作群里。同一个智能体可以跟进多个第三方群聊中的多项任务,在一个渠道接收请求,在另一个渠道交付结果。系统由网关连接即时通讯应用和 Web 界面,再由 AgentServer 调度智能体与工作会话。
在这种形态下,上下文窗口上限不再是偶发问题,而是必然会发生的事件。一个只回答单轮问题的聊天机器人很少把窗口用满,但一个持续数天跟进项目的智能体,对话记录、工具调用结果和文件内容会不断累积。报道还提到 WorkSwarm 的活动面板会显示每个智能体的 token 用量,这说明上下文消耗本身就是这类系统需要持续观察的运行指标。
会话作为资源:交接摘要的前提
理解交接摘要机制的关键,在于 WorkSwarm 把“智能体”和“会话”拆开了。智能体的身份与状态是持续存在的,会话只是系统分配、并发调度、并可带着上下文恢复的资源。既然会话可以被替换,那么“窗口满了就换一个新窗口”就成为自然的设计选择。
交接摘要扮演的角色,就是在旧会话和新会话之间传递最少但足够的工作状态。归档历史则保证旧会话里的细节不会真正丢失,只是从“随时在场”变成了“按需调取”。
交接摘要设计问题一:应该包含什么
报道给出的三要素是目标、进展和下一步。这个结构简洁,但实际落地时每一项都需要进一步拆解。下表是我们基于这三要素展开的设计参考,属于工程层面的建议,并非 JiuwenSwarm 的已确认实现。
| 字段 | 建议内容 | 遗漏时的风险 |
|---|---|---|
| 目标 | 原始任务描述、交付要求、发起人和交付渠道 | 新窗口偏离原始需求,交付到错误的群或格式 |
| 进展 | 已完成的子任务、已做出的关键决策及理由 | 重复劳动,或推翻之前已确认的方案 |
| 下一步 | 待办事项、阻塞点、等待中的外部回复 | 任务停滞,智能体不知道该从哪里继续 |
| 约束(扩展) | 用户明确提出的禁忌、权限范围、格式偏好 | 违反用户已表达过的偏好,体验断裂 |
| 索引(扩展) | 关键信息在归档中的位置或关键词 | 需要细节时检索不到,归档形同虚设 |
其中“约束”和“索引”是我们额外补充的两项。约束之所以重要,是因为用户在长对话中零散表达的偏好(如“报告不要超过一页”)最容易在摘要压缩时被丢掉。索引则是连接交接摘要与归档检索的桥梁:摘要越短,就越需要告诉新窗口“细节在哪里”。
在 WorkSwarm 的场景中,还要注意多群、多渠道带来的复杂性。报道提到跨群分享需要用户审批,可授予一次性或永久权限,并且可以撤销。如果这类授权状态没有写进交接摘要,新窗口里的智能体可能会对权限状态产生误判,这类信息更适合作为结构化字段而不是自由文本保存。
交接摘要设计问题二:何时触发上下文切换
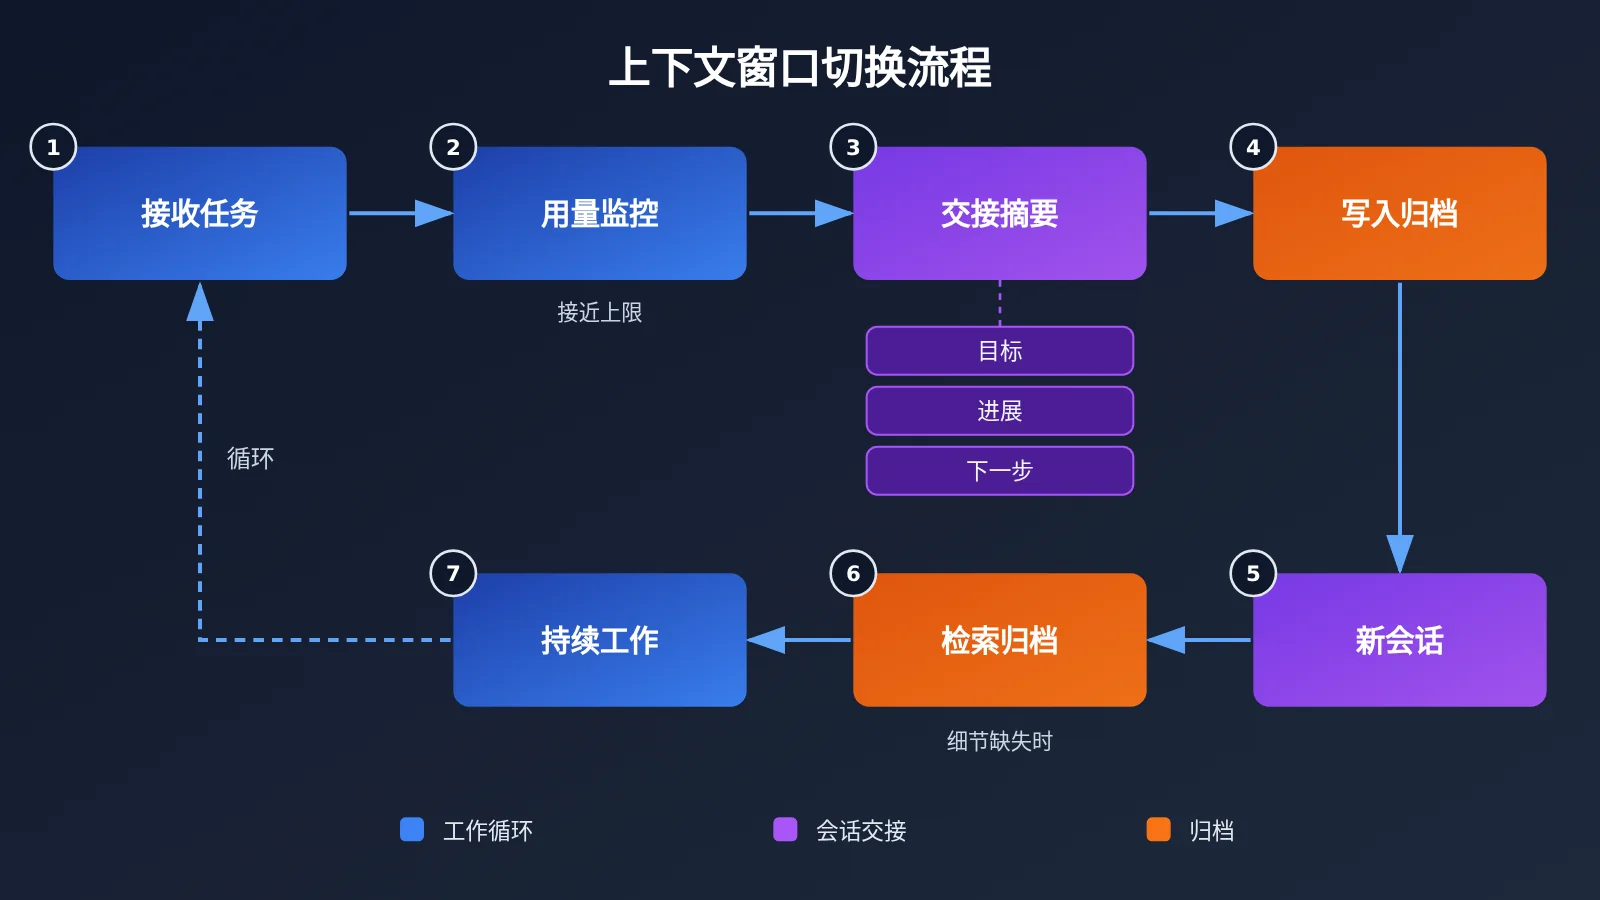
报道只说明了“接近上限时”切换,具体阈值以及摘要由模型生成还是规则生成,目前公开资料没有披露,需要查阅 JiuwenSwarm 源码或文档确认。从工程角度看,触发时机通常有以下几种选择。
| 触发策略 | 实现方式 | 优点 | 风险 |
|---|---|---|---|
| 固定比例阈值 | token 用量达到窗口的某个比例时切换 | 实现简单,行为可预测 | 可能在任务关键步骤中途切换 |
| 预留空间阈值 | 剩余空间不足以容纳下一轮输入加摘要生成时切换 | 保证摘要生成本身有足够空间 | 需要预估下一轮输入规模 |
| 任务边界触发 | 在子任务完成、等待用户回复等自然断点切换 | 摘要更完整,切换代价低 | 断点不一定在窗口用满前出现 |
| 混合策略 | 优先在任务边界切换,超过硬阈值时强制切换 | 兼顾完整性与安全性 | 逻辑更复杂,需要更多测试 |
需要特别注意的是,生成交接摘要本身也要消耗上下文。如果等到窗口完全用满才触发,模型可能已经没有空间读完历史并写出高质量摘要。因此无论采用哪种策略,都应为摘要生成预留余量。
关于摘要的生成方式,由模型生成的摘要更灵活,能理解任务语义;由规则生成的摘要(例如直接提取任务清单的状态字段)更稳定,但难以捕捉对话中的隐含决策。实践中常见的做法是两者结合:结构化状态由程序维护,模型只负责补充自然语言的进展说明。
如何实现交接摘要 + 归档检索:一个极简原型
下面是一个演示该模式思路的极简原型,并非 JiuwenSwarm 的实现。它在估算的 token 用量接近阈值时,让模型生成交接摘要,并把旧消息写入归档。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

HANDOFF_PROMPT = "请将以上工作记录整理为交接摘要,包含:目标、进展、下一步、约束、关键信息索引。"

def make_handoff(messages, model="gpt-4o-mini"):
    resp = client.chat.completions.create(
        model=model,
        messages=messages + [{"role": "user", "content": HANDOFF_PROMPT}]
    )
    return resp.choices[0].message.content
查看完整原型代码(含切换判断与归档检索)
import openai
from typing import List, Dict

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MODEL = "gpt-4o-mini"
CONTEXT_LIMIT = 100_000      # 示例值,按所用模型实际窗口调整
SWITCH_RATIO = 0.7           # 预留空间给摘要生成
HANDOFF_PROMPT = (
    "请将以上工作记录整理为交接摘要,分为五部分:"
    "1.目标 2.进展(含关键决策及理由)3.下一步 4.用户约束 5.关键信息索引(关键词列表)"
)

class LongRunningAgent:
    def __init__(self, system_prompt: str):
        self.system_prompt = system_prompt
        self.messages: List[Dict] = [{"role": "system", "content": system_prompt}]
        self.archive: List[Dict] = []   # 归档历史,生产环境可换成数据库或向量库

    def estimate_tokens(self) -> int:
        # 粗略估算,生产环境应使用对应模型的分词器
        return sum(len(m["content"]) for m in self.messages)

    def maybe_switch(self):
        if self.estimate_tokens() < CONTEXT_LIMIT * SWITCH_RATIO:
            return
        resp = client.chat.completions.create(
            model=MODEL,
            messages=self.messages + [{"role": "user", "content": HANDOFF_PROMPT}]
        )
        summary = resp.choices[0].message.content
        self.archive.extend(self.messages[1:])      # 旧会话写入归档
        self.messages = [
            {"role": "system", "content": self.system_prompt},
            {"role": "system", "content": f"【交接摘要】\n{summary}"}
        ]

    def search_archive(self, keyword: str, top_k: int = 5) -> str:
        hits = [m["content"] for m in self.archive if keyword in m["content"]]
        return "\n---\n".join(hits[-top_k:]) or "归档中未找到相关记录"

    def chat(self, user_input: str) -> str:
        self.maybe_switch()
        self.messages.append({"role": "user", "content": user_input})
        resp = client.chat.completions.create(model=MODEL, messages=self.messages)
        answer = resp.choices[0].message.content
        self.messages.append({"role": "assistant", "content": answer})
        return answer

agent = LongRunningAgent("你是负责跟进项目周报的数字员工。")
print(agent.chat("请记录:本周报告不要超过一页。"))
这个原型的归档检索只是简单的关键词匹配。报道没有说明 JiuwenSwarm 使用向量检索还是其他方式,实际项目中可以根据归档规模选择全文检索、向量检索或两者混合,也可以把 search_archive 注册为工具,让模型自行决定何时调用。
🚀 快速开始:搭建此类原型时,摘要生成和主任务可以使用不同模型,例如用轻量模型生成摘要、用强模型处理主任务。通过 API易 apiyi.com 一个 API Key 即可调用 OpenAI、Claude、Gemini 等模型,方便在同一套代码里切换对比,新用户有免费测试额度。
交接摘要设计问题三:何时回查归档历史
归档检索解决的是“摘要必然有损”这个根本问题。任何压缩都会丢信息,关键在于丢失后能否找回。何时回查归档,大致有三种设计取向:
- 模型自主调用:把检索作为工具交给模型,模型发现信息不足时主动查询。灵活,但依赖模型对“自己不知道什么”的判断。
- 规则触发:当用户提到摘要中没有的实体、文件名或时间点时,程序自动检索并注入结果。可控性强,但规则覆盖面有限。
- 索引引导:交接摘要中保留关键信息的索引,新窗口遇到相关话题时按索引精确调取。依赖摘要阶段的索引质量。
我们认为最大的风险在于“不知道自己遗漏了什么”。如果摘要漏掉了某个用户偏好,而新窗口里也没有任何线索提示它存在,模型就不会想到去检索。这正是前面建议在摘要中加入“约束”和“索引”字段的原因,它们为回查归档提供了入口。
依赖更长上下文 vs 交接摘要:影响分析
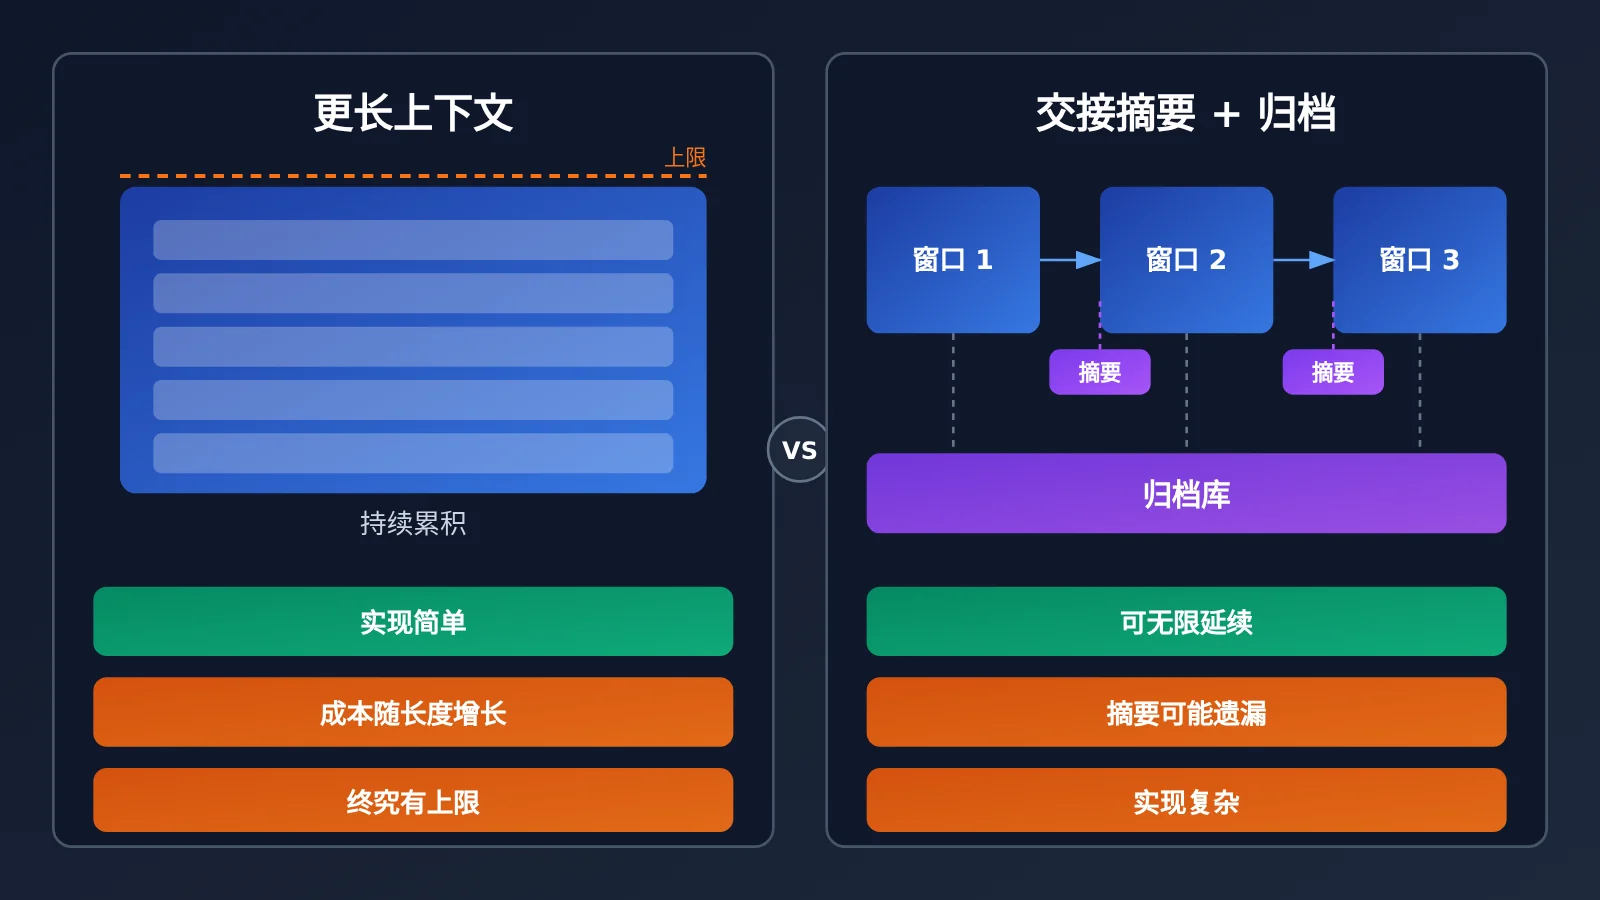
面对上下文窗口上限,另一条路是直接换用上下文更长的模型。两种思路并不互斥,但适用条件不同。下表是判断性分析,不附带效果数据。
| 维度 | 依赖更长上下文 | 交接摘要 + 归档检索 |
|---|---|---|
| 实现复杂度 | 低,基本无需改造 | 高,需要摘要、归档、检索三套逻辑 |
| 信息完整性 | 原始信息全部在场 | 摘要有损,依赖检索补齐 |
| 任务持续时长 | 受模型窗口规格限制 | 理论上可持续延续 |
| 单次调用开销 | 随历史增长持续上升 | 每次切换后回落 |
| 主要风险 | 超长输入中关键信息被淹没 | 摘要遗漏细节且未被检索找回 |
| 适合场景 | 中等时长、需要全文对照的任务 | 数天到数周的持续性工作 |
| 可用平台 | API易 apiyi.com 等提供多种上下文规格的模型 | 任意模型均可,与平台无关 |
💡 选择建议:如果任务通常能在一个长窗口内完成,优先换用长上下文模型更省事;如果智能体需要像 WorkSwarm 的数字员工那样长期驻留,交接摘要几乎是必选项。可以先在 API易 apiyi.com 上用不同上下文规格的模型跑同一任务,观察实际用量后再决定是否投入摘要机制的开发。
对开发者的影响
- 上下文管理成为架构层问题:WorkSwarm 把会话作为可调度资源,意味着上下文切换被纳入系统设计,而不是出错后的补救。
- 状态需要显式建模:交接摘要的质量取决于智能体是否清楚记录了目标、决策和待办,这反过来要求开发者在设计阶段就规划好状态结构。
- 可观测性更重要:WorkSwarm 在活动面板展示 token 用量和响应时间,长周期智能体同样需要监控切换频率和检索命中情况。
对行业的影响
- 从会话型到常驻型:智能体从“一问一答”走向“长期驻留工作群”,上下文跨窗口能力会成为这类产品的基础设施。
- 开源实现提供参考:JiuwenSwarm 开源后,开发者可以直接研究其切换阈值、摘要生成和检索实现,而不必从零摸索。
常见问题 FAQ
Q1: 什么是“交接摘要 + 归档检索”模式?
它是长时间运行的智能体跨越上下文窗口的一种做法:窗口接近上限时,智能体切换到新窗口,只携带一份包含目标、进展和下一步的交接摘要,完整历史被归档,需要细节时再按需检索。openJiuwen WorkSwarm 采用了这一思路。
Q2: 换一个上下文更长的模型不就解决了吗?
对中等时长的任务,换长上下文模型确实是最省事的方案。但对长期驻留的智能体,历史会持续增长,任何窗口终究会用满,而且超长输入中的关键信息也可能被淹没。建议先通过 API易 apiyi.com 用不同上下文规格的模型测试实际任务,再判断是否需要引入摘要机制。
Q3: WorkSwarm 的切换阈值和摘要生成方式是什么?
目前公开报道没有披露具体阈值、摘要由模型还是规则生成,以及归档检索采用向量检索还是其他方式。这些实现细节需要查阅 GitHub 上的 JiuwenSwarm 开源代码或官方文档确认。本文的相关讨论属于通用工程分析。
Q4: 如何通过 API 快速验证交接摘要方案?
可以按以下步骤搭建原型:
1. 在 API易 apiyi.com 注册并获取 API Key 和免费测试额度
2. 使用本文的原型代码,base_url 设为 `https://api.apiyi.com/v1`
3. 用一段真实的长对话测试,切换后检查智能体是否还记得关键约束
Q5: 这种模式有哪些已知风险?
最主要的风险是摘要遗漏细节,并且新窗口没有线索去检索找回。其次是在任务关键步骤中途切换,导致状态不一致。此外,该机制对任务质量的实际影响目前没有公开测试数据,上线前应在自己的场景中充分验证。
交接摘要与上下文窗口核心要点 Key Takeaways
- 核心机制:窗口近满时切换新窗口,携带目标、进展、下一步的交接摘要
- 前提条件:智能体身份与会话分离,会话成为可调度、可恢复的资源
- 摘要设计:在三要素之外补充用户约束和归档索引,降低遗漏风险
- 触发时机:为摘要生成预留空间,优先在任务边界切换
- 归档回查:摘要必然有损,检索入口决定信息能否找回
- 路线选择:中等任务可换长上下文模型,长期驻留任务更需要摘要交接
- 快速验证:可通过 API易 apiyi.com 多模型统一接口搭建原型对比
总结
openJiuwen WorkSwarm 的上下文切换机制,为长时间运行的智能体提供了一个清晰的参考模式:
- 交接摘要承载工作状态:目标、进展和下一步是最小集合,约束与索引是实用补充。
- 切换时机需要预留余量:摘要生成本身消耗上下文,不能等窗口完全用满才处理。
- 归档检索兜底信息损失:摘要只负责“记住要点”,细节交给按需检索。
如果你的智能体正在从单次会话走向长期运行,建议先梳理状态结构,再决定是换长上下文模型还是引入交接摘要。推荐通过 API易 apiyi.com 快速搭建原型,用多种模型对比摘要质量和上下文消耗。
📚 参考资料
- Pandaily 报道:openJiuwen Hyper-Agent 集群架构与 WorkSwarm 数字员工
- 链接:
pandaily.com/openjiuwen-hyper-agent-swarm-architecture-persistent-agents-workswarm-digital-employees -
说明: 介绍持久化智能体、上下文切换与交接摘要机制的英文报道
-
JiuwenSwarm 开源代码:openJiuwen WorkSwarm 的开源实现
- 链接:
github.com(搜索 JiuwenSwarm) - 说明: 查阅切换阈值、摘要生成与归档检索的具体实现
作者: APIYI 技术团队
技术交流: 欢迎在 API易 apiyi.com 网站首页联系我们,更多资料可访问 docs.apiyi.com 文档中心