Note de l’auteur : à partir du mécanisme de changement de contexte d’openJiuwen WorkSwarm, cet article explique le modèle « résumé de passation + recherche dans les archives » et examine les options et compromis possibles lorsqu’un agent de longue durée approche de la limite de sa fenêtre de contexte.
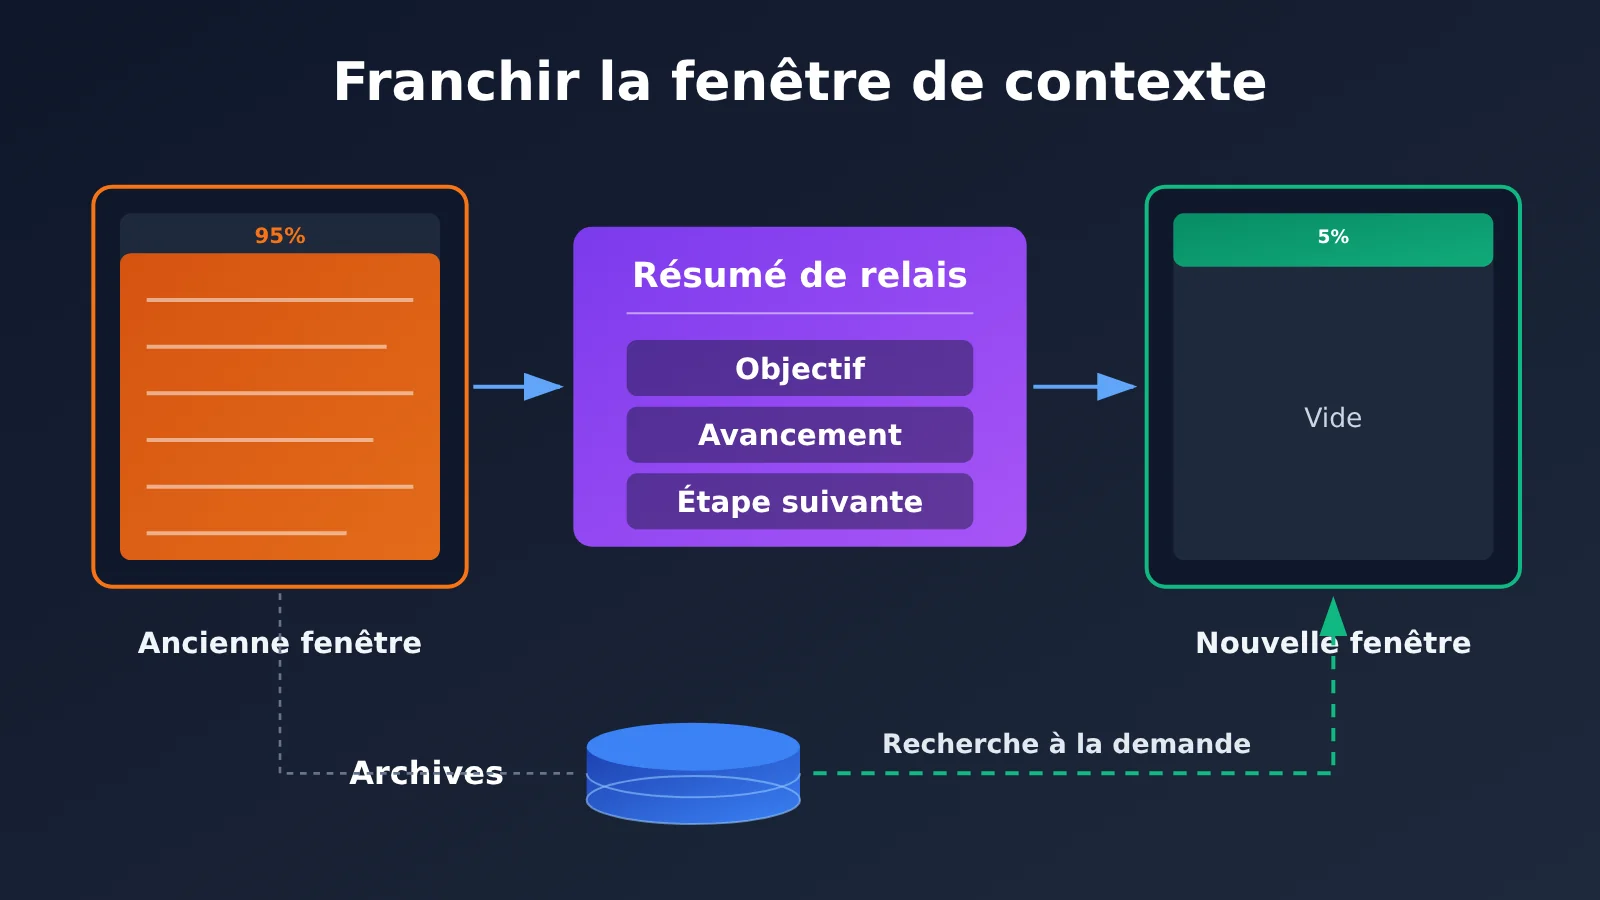
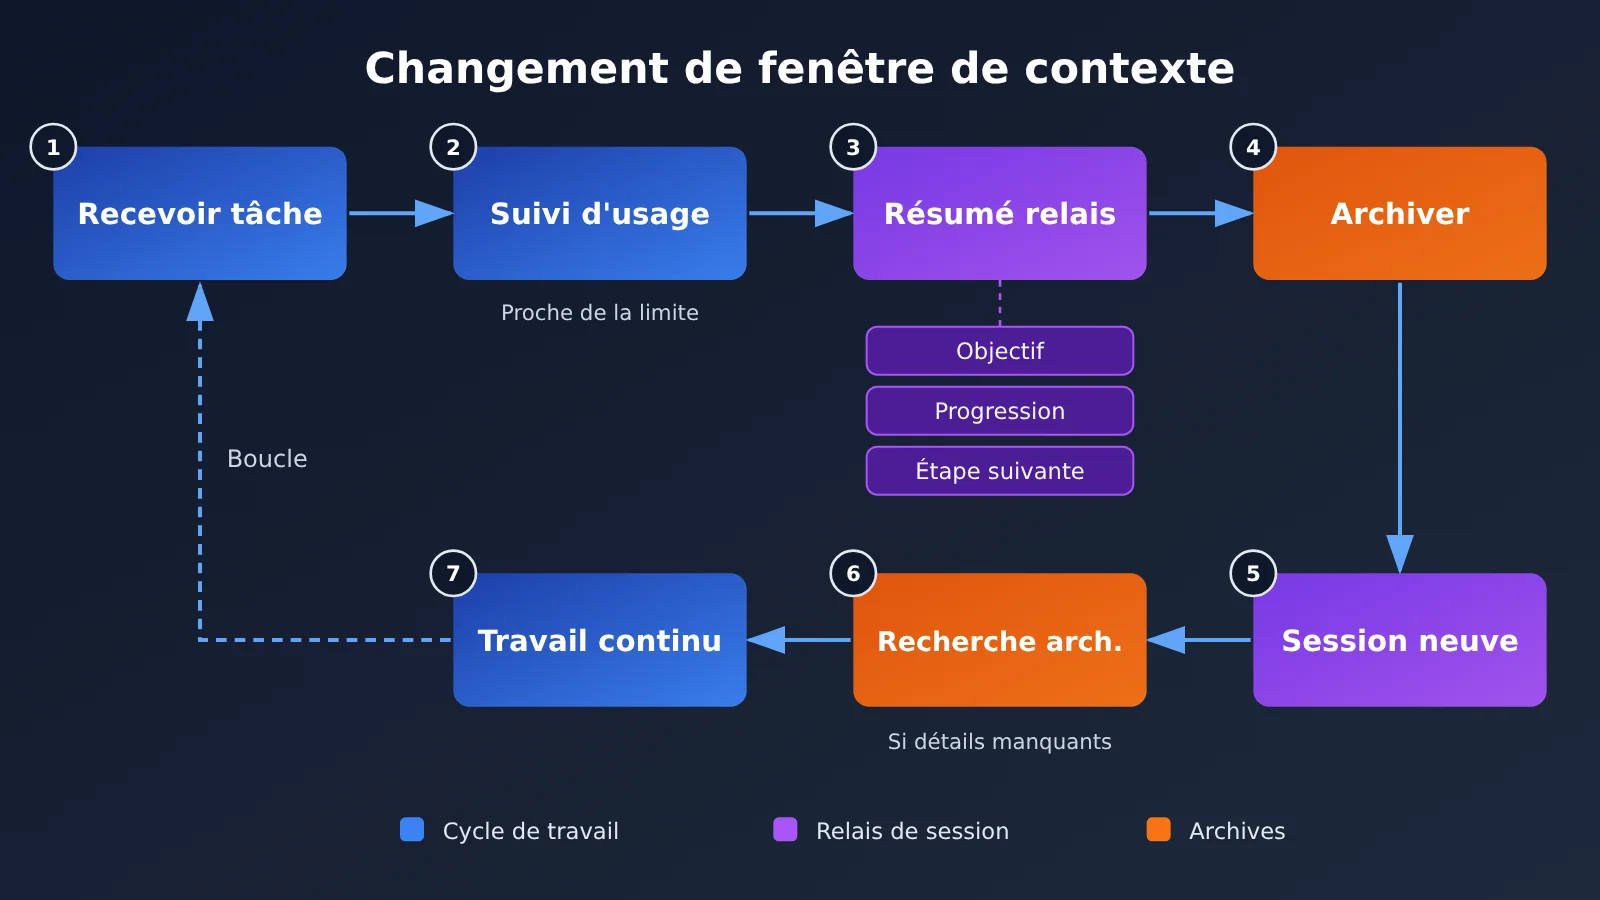
La communauté open source d’agents openJiuwen, soutenue par Huawei, a récemment publié une architecture de cluster Hyper-Agent. Un détail mérite l’attention des développeurs : lorsqu’un agent approche de la limite de sa fenêtre de contexte, il passe à une nouvelle fenêtre avec un résumé de passation contenant l’objectif, l’avancement et les prochaines étapes. S’il a besoin de détails, il consulte l’historique archivé. Ce mécanisme tient en une phrase, mais il soulève un problème d’ingénierie auquel tous les agents de longue durée sont confrontés.
Ce n’est pas une simple rumeur. Cette fonctionnalité a été publiée avec openJiuwen WorkSwarm, et son code est disponible en open source sur GitHub sous le nom JiuwenSwarm. En prenant ce mécanisme comme exemple, nous examinerons trois questions de conception : que doit contenir le résumé de passation, quand faut-il déclencher le changement de fenêtre et quand consulter les archives ? Nous comparerons aussi les compromis entre deux approches : « s’appuyer sur un contexte plus long » et « résumé de passation + recherche ».
Ce que vous allez en retirer : vous pourrez examiner les options de gestion de la limite de la fenêtre de contexte dans votre propre application d’agent, ainsi que les risques associés à chacune.
Résumé de passation et recherche dans les archives : l’essentiel
Commençons par les faits confirmés dans les sources, avant de voir ce qu’ils impliquent pour les développeurs. Les informations du tableau proviennent de publications accessibles au public. Les détails d’implémentation non confirmés seront signalés séparément plus loin.
| Élément | Détails |
|---|---|
| À l’origine | openJiuwen, communauté open source d’agents soutenue par Huawei |
| Annonce | Architecture de cluster Hyper-Agent, mise en œuvre dans openJiuwen WorkSwarm |
| Open source | Code publié sur GitHub sous le nom JiuwenSwarm |
| Changement central | L’agent persistant (Persistent Agent) conserve sa propre identité et son état ; la session devient une ressource sous-jacente gérée par le système |
| Mécanisme de contexte | À l’approche de la limite, passage à une nouvelle fenêtre avec un résumé de passation (« objectif, progression, prochaine étape ») ; recherche dans l’historique archivé si des détails sont nécessaires |
| Date des publications | Début novembre 2026 |
Pourquoi un agent persistant doit gérer la limite de la fenêtre de contexte
WorkSwarm est conçu pour détacher les agents d’une session de discussion unique et leur permettre de rester durablement présents, comme des « employés numériques », dans des groupes de travail sur Feishu, DingTalk et d’autres plateformes. Un même agent peut suivre plusieurs tâches dans différentes conversations de groupe, recevoir une demande sur un canal et livrer le résultat sur un autre. Une passerelle relie les applications de messagerie instantanée et l’interface Web au système, puis AgentServer coordonne les agents et les sessions de travail.
Dans ce contexte, atteindre la limite de la fenêtre de contexte n’est plus un problème occasionnel, mais une éventualité inévitable. Un chatbot qui répond à une question en un seul échange remplit rarement sa fenêtre. En revanche, pour un agent qui suit un projet pendant plusieurs jours, l’historique des conversations, les résultats des appels d’outils et le contenu des fichiers s’accumulent. Les publications indiquent aussi que le tableau d’activité de WorkSwarm affiche la consommation de tokens de chaque agent : cette consommation est donc une métrique à surveiller en continu dans ce type de système.
La session comme ressource : le principe derrière le résumé de passation
Pour comprendre le mécanisme de passation, il faut d’abord voir que WorkSwarm sépare l’« agent » de la « session ». L’identité et l’état de l’agent persistent, tandis que la session est une ressource que le système attribue, gère en parallèle et peut reprendre avec son contexte. Puisqu’une session peut être remplacée, passer à une nouvelle fenêtre lorsque la précédente est pleine devient un choix naturel.
Le résumé de passation sert à transmettre entre l’ancienne et la nouvelle session un état de travail minimal, mais suffisant. L’historique archivé permet quant à lui de conserver les détails de l’ancienne session : ils ne sont plus « toujours présents », mais restent accessibles à la demande.
Première question de conception du résumé de passation : que doit-il contenir ?
L’article mentionne trois éléments : l’objectif, l’avancement et les prochaines étapes. Cette structure est simple, mais sa mise en pratique demande de préciser chacun de ces points. Le tableau ci-dessous propose des pistes de conception à partir de ces trois éléments. Il s’agit de recommandations d’ingénierie, et non de fonctionnalités dont l’implémentation dans JiuwenSwarm est confirmée.
| Champ | Contenu recommandé | Risque en cas d’omission |
|---|---|---|
| Objectif | Description de la tâche initiale, exigences de livraison, demandeur et canal de livraison | La nouvelle fenêtre s’écarte de la demande initiale, ou le livrable est envoyé au mauvais groupe ou dans le mauvais format |
| Avancement | Sous-tâches terminées, décisions clés et leurs justifications | Travail effectué en double ou remise en cause d’une solution déjà validée |
| Prochaines étapes | Tâches à faire, points de blocage, réponses externes en attente | La tâche stagne, car l’agent ne sait pas où reprendre |
| Contraintes (extension) | Interdictions explicites de l’utilisateur, périmètre des autorisations, préférences de format | Les préférences déjà exprimées ne sont pas respectées, ce qui nuit à la continuité de l’expérience |
| Index (extension) | Emplacement des informations clés dans les archives ou mots-clés associés | Les détails nécessaires restent introuvables et les archives perdent leur utilité |
Les champs « contraintes » et « index » sont deux ajouts de notre part. Les contraintes sont importantes parce que les préférences exprimées au fil d’une longue conversation, comme « le rapport ne doit pas dépasser une page », risquent particulièrement de disparaître lors de la compression du résumé. L’index, lui, fait le lien entre le résumé de passation et la recherche dans les archives : plus le résumé est court, plus il est important d’indiquer à la nouvelle fenêtre où trouver les détails.
Dans le cas de WorkSwarm, il faut aussi tenir compte de la complexité liée aux multiples groupes et canaux. L’article indique que le partage entre groupes nécessite l’approbation de l’utilisateur, qui peut accorder une autorisation ponctuelle ou permanente, puis la révoquer. Si l’état de ces autorisations ne figure pas dans le résumé de passation, l’agent de la nouvelle fenêtre risque de mal l’interpréter. Ce type d’information se prête mieux à un champ structuré qu’à du texte libre.
Deuxième question de conception du résumé de transfert : quand déclencher le changement de contexte
L’article indique seulement que le changement intervient « à l’approche de la limite ». Les sources publiques ne précisent ni le seuil exact, ni si le résumé est généré par le modèle ou par des règles. Il faut consulter le code source ou la documentation de JiuwenSwarm pour le confirmer. D’un point de vue technique, plusieurs stratégies de déclenchement sont possibles.
| Stratégie | Mise en œuvre | Avantages | Risques |
|---|---|---|---|
| Seuil proportionnel fixe | Changer de contexte lorsque l’utilisation des tokens atteint une certaine proportion de la fenêtre | Mise en œuvre simple, comportement prévisible | Le changement peut survenir au milieu d’une étape critique |
| Seuil d’espace réservé | Changer de contexte lorsque l’espace restant ne suffit plus pour l’entrée suivante et la génération du résumé | Garantit assez d’espace pour générer le résumé | Nécessite d’estimer la taille de l’entrée suivante |
| Déclenchement aux limites d’une tâche | Changer de contexte à une pause naturelle, par exemple après une sous-tâche ou en attendant une réponse de l’utilisateur | Résumé plus complet, coût de changement réduit | Une pause naturelle peut ne pas se présenter avant que la fenêtre soit pleine |
| Stratégie hybride | Privilégier les limites des tâches, mais forcer le changement au-delà d’un seuil strict | Combine exhaustivité et sécurité | Logique plus complexe, nécessitant davantage de tests |
Un point mérite une attention particulière : la génération du résumé de transfert consomme elle aussi de l’espace dans la fenêtre de contexte. Si l’on attend qu’elle soit entièrement remplie, le modèle risque de ne plus avoir assez de place pour lire tout l’historique et rédiger un résumé de qualité. Quelle que soit la stratégie retenue, il faut donc réserver une marge pour cette génération.
Quant à la méthode de génération, un résumé produit par le modèle est plus souple et peut comprendre le sens des tâches. Un résumé généré par des règles — par exemple en extrayant directement les champs d’état de la liste des tâches — est plus stable, mais capte difficilement les décisions implicites dans la conversation. En pratique, on combine souvent les deux : le programme maintient l’état structuré et le modèle se charge seulement d’ajouter une description de l’avancement en langage naturel.
Résumé de passation et recherche dans les archives : un prototype minimaliste
Voici un prototype minimaliste qui illustre cette approche, mais ne correspond pas à l’implémentation de JiuwenSwarm. Lorsque l’utilisation estimée de tokens approche du seuil, il demande au modèle de générer un résumé de passation et archive les anciens messages.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface APIYI compatible avec OpenAI
)

HANDOFF_PROMPT = "请将以上工作记录整理为交接摘要,包含:目标、进展、下一步、约束、关键信息索引。"

def make_handoff(messages, model="gpt-4o-mini"):
    resp = client.chat.completions.create(
        model=model,
        messages=messages + [{"role": "user", "content": HANDOFF_PROMPT}]
    )
    return resp.choices[0].message.content
Voir le code complet du prototype (avec déclenchement de la transition et recherche dans les archives)
import openai
from typing import List, Dict

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MODEL = "gpt-4o-mini"
CONTEXT_LIMIT = 100_000      # Valeur d'exemple, à adapter à la fenêtre réelle du modèle utilisé
SWITCH_RATIO = 0.7           # Réserve de l'espace pour la génération du résumé
HANDOFF_PROMPT = (
    "请将以上工作记录整理为交接摘要,分为五部分:"
    "1.目标 2.进展(含关键决策及理由)3.下一步 4.用户约束 5.关键信息索引(关键词列表)"
)

class LongRunningAgent:
    def __init__(self, system_prompt: str):
        self.system_prompt = system_prompt
        self.messages: List[Dict] = [{"role": "system", "content": system_prompt}]
        self.archive: List[Dict] = []   # Historique archivé ; en production, peut être remplacé par une base de données ou une base vectorielle

    def estimate_tokens(self) -> int:
        # Estimation approximative ; en production, utiliser le tokenizer du modèle correspondant
        return sum(len(m["content"]) for m in self.messages)

    def maybe_switch(self):
        if self.estimate_tokens() < CONTEXT_LIMIT * SWITCH_RATIO:
            return
        resp = client.chat.completions.create(
            model=MODEL,
            messages=self.messages + [{"role": "user", "content": HANDOFF_PROMPT}]
        )
        summary = resp.choices[0].message.content
        self.archive.extend(self.messages[1:])      # Archivage de l'ancienne conversation
        self.messages = [
            {"role": "system", "content": self.system_prompt},
            {"role": "system", "content": f"【交接摘要】\n{summary}"}
        ]

    def search_archive(self, keyword: str, top_k: int = 5) -> str:
        hits = [m["content"] for m in self.archive if keyword in m["content"]]
        return "\n---\n".join(hits[-top_k:]) or "归档中未找到相关记录"

    def chat(self, user_input: str) -> str:
        self.maybe_switch()
        self.messages.append({"role": "user", "content": user_input})
        resp = client.chat.completions.create(model=MODEL, messages=self.messages)
        answer = resp.choices[0].message.content
        self.messages.append({"role": "assistant", "content": answer})
        return answer

agent = LongRunningAgent("你是负责跟进项目周报的数字员工。")
print(agent.chat("请记录:本周报告不要超过一页。"))
Dans ce prototype, la recherche dans les archives repose sur une simple correspondance de mots-clés. L’article ne précise pas si JiuwenSwarm utilise la recherche vectorielle ou une autre méthode. Dans un projet réel, vous pouvez choisir entre la recherche en texte intégral, la recherche vectorielle ou une combinaison des deux, selon la taille des archives. Vous pouvez aussi enregistrer search_archive comme outil et laisser le modèle décider quand l’appeler.
🚀 Pour commencer : lors de la création d’un tel prototype, vous pouvez utiliser des modèles différents pour générer le résumé et traiter la tâche principale : un modèle léger pour le résumé et un modèle plus puissant pour la tâche principale. Avec APIYI apiyi.com, une seule clé API permet d’accéder à des modèles comme OpenAI, Claude et Gemini, et de les comparer facilement dans le même code. Les nouveaux utilisateurs disposent d’un crédit de test gratuit.
Troisième question de conception du résumé de transfert : quand consulter l’historique archivé
La recherche dans les archives répond à un problème fondamental : un résumé implique forcément une perte d’information. Toute compression élimine des éléments ; l’essentiel est de pouvoir les retrouver ensuite. Il existe trois grandes approches pour décider quand consulter les archives :
- Appel autonome par le modèle : la recherche est mise à disposition du modèle comme outil, qu’il utilise lorsqu’il constate un manque d’information. C’est flexible, mais cela dépend de sa capacité à savoir ce qu’il ignore.
- Déclenchement par des règles : lorsqu’un utilisateur mentionne une entité, un nom de fichier ou une date absents du résumé, le programme lance automatiquement une recherche et injecte les résultats. Cette approche offre plus de contrôle, mais les règles ne couvrent qu’un nombre limité de cas.
- Recherche guidée par un index : le résumé de transfert conserve un index des informations importantes. Lorsque le sujet revient dans la nouvelle fenêtre, l’index permet de récupérer précisément les éléments pertinents. Cette approche dépend de la qualité de l’index créé lors du résumé.
À notre avis, le plus grand risque est de « ne pas savoir ce qu’on a oublié ». Si le résumé omet une préférence de l’utilisateur et que rien dans la nouvelle fenêtre ne laisse supposer son existence, le modèle ne pensera pas à la rechercher. C’est précisément pourquoi nous recommandions d’ajouter les champs « contraintes » et « index » au résumé : ils fournissent des points d’entrée pour consulter les archives.
Contexte plus long ou résumé de passation : analyse des implications
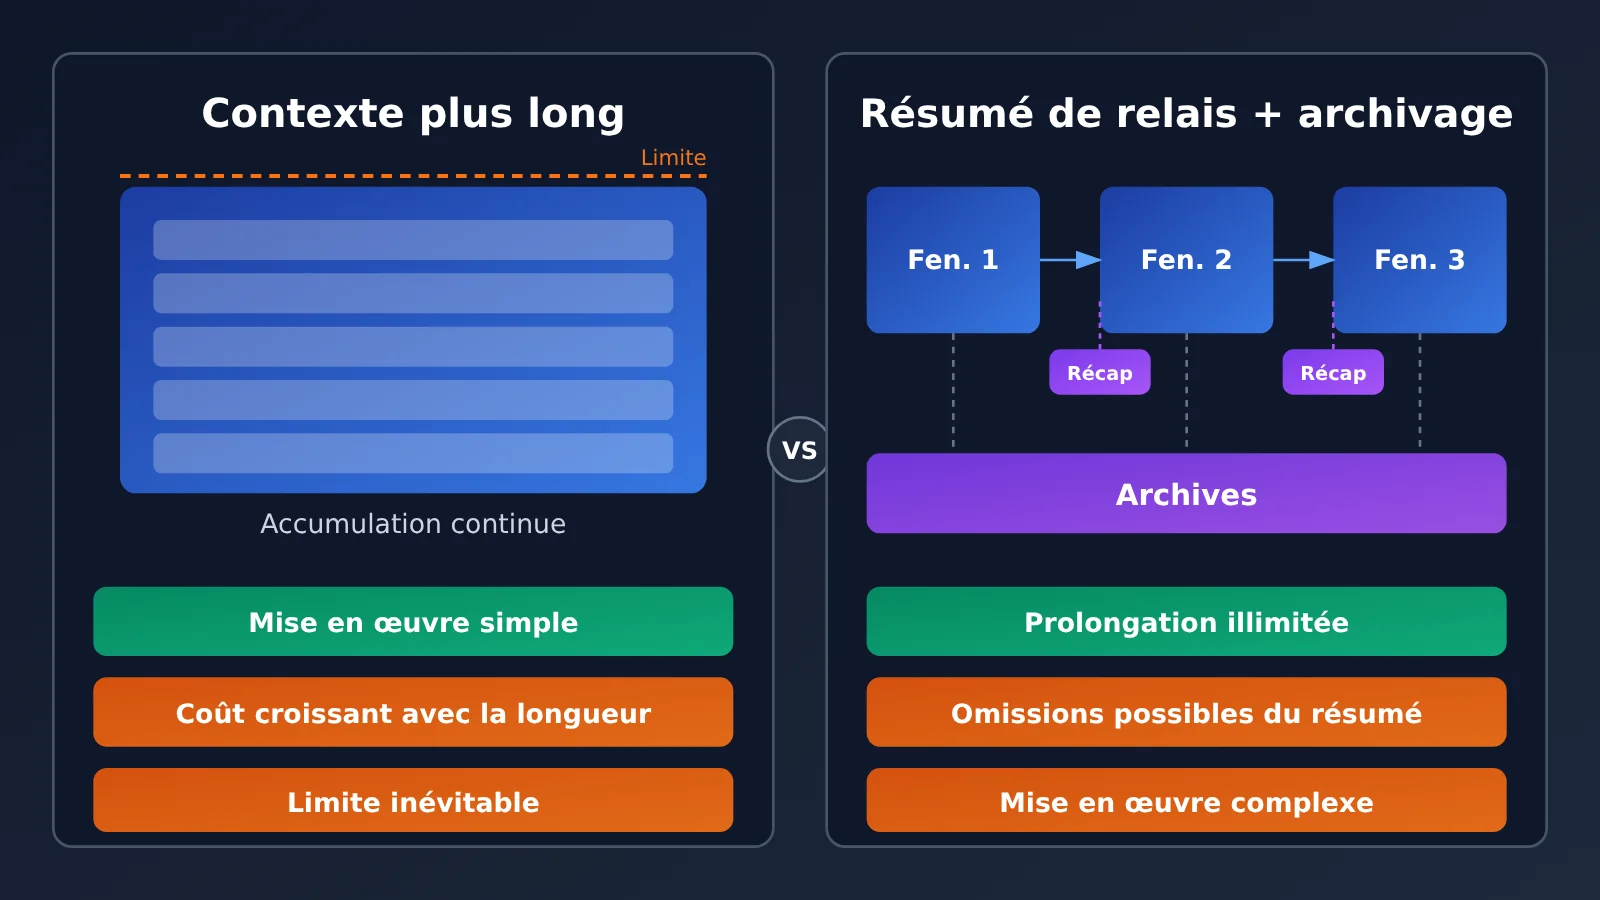
Face à la limite de la fenêtre de contexte, une autre solution consiste à passer directement à un modèle doté d’un contexte plus long. Les deux approches ne s’excluent pas, mais elles répondent à des besoins différents. Le tableau ci-dessous présente une analyse qualitative, sans données de performance.
| Critère | Contexte plus long | Résumé de passation + recherche dans les archives |
|---|---|---|
| Complexité de mise en œuvre | Faible, presque aucune modification nécessaire | Élevée : nécessite trois mécanismes pour le résumé, l’archivage et la recherche |
| Exhaustivité des informations | Toutes les informations d’origine sont présentes | Le résumé perd des informations ; la recherche permet de les compléter |
| Durée de la tâche | Limitée par la taille de la fenêtre du modèle | Théoriquement illimitée |
| Coût par invocation | Augmente continuellement avec l’historique | Redescend après chaque bascule |
| Risque principal | Les informations clés se perdent dans une entrée très longue | Des détails omis par le résumé ne sont pas retrouvés dans les archives |
| Cas d’usage adaptés | Tâches de durée moyenne nécessitant de comparer le texte intégral | Travail continu sur plusieurs jours ou semaines |
| Plateformes disponibles | APIYI apiyi.com et d’autres proposent des modèles avec différentes tailles de contexte | Fonctionne avec n’importe quel modèle, indépendamment de la plateforme |
💡 Conseil : si la tâche peut généralement être menée à bien dans une seule fenêtre de contexte étendue, passer à un modèle à long contexte est plus simple. Si l’agent doit rester actif sur la durée, comme les employés numériques de WorkSwarm, le résumé de passation devient presque indispensable. Vous pouvez d’abord exécuter la même tâche sur APIYI apiyi.com avec des modèles aux fenêtres de contexte différentes, puis observer la consommation réelle avant de décider s’il faut développer un mécanisme de résumé.
Implications pour les développeurs
- La gestion du contexte devient un enjeu d’architecture : WorkSwarm traite les sessions comme des ressources que l’on peut planifier. Le changement de contexte est donc intégré à la conception du système, plutôt que traité comme une solution de secours après une erreur.
- L’état doit être modélisé explicitement : la qualité du résumé de passation dépend de la façon dont l’agent consigne les objectifs, les décisions et les tâches à accomplir. Les développeurs doivent donc prévoir la structure de cet état dès la conception.
- L’observabilité gagne en importance : WorkSwarm affiche la consommation de tokens et les temps de réponse dans son panneau d’activité. Les agents qui travaillent sur de longues périodes doivent aussi surveiller la fréquence des bascules et les résultats de recherche dans les archives.
Implications pour le secteur
- Des agents conversationnels aux agents permanents : les agents ne se limitent plus à un échange de questions-réponses ; ils travaillent durablement au sein de groupes. La capacité à conserver le contexte d’une fenêtre à l’autre deviendra une infrastructure essentielle pour ces produits.
- Une implémentation open source comme référence : avec l’ouverture du code de JiuwenSwarm, les développeurs peuvent étudier directement ses seuils de bascule, sa génération de résumés et son mécanisme de recherche, sans avoir à tout explorer à partir de zéro.
Questions fréquentes (FAQ)
Q1 : Qu’est-ce que le modèle « résumé de transmission + recherche dans les archives » ?
C’est une façon pour un agent de longue durée de passer d’une fenêtre de contexte à une autre. Lorsque la fenêtre approche de sa limite, l’agent en ouvre une nouvelle en n’emportant qu’un résumé de transmission contenant l’objectif, l’avancement et les prochaines étapes. L’historique complet est archivé, puis consulté à la demande lorsque des détails sont nécessaires. openJiuwen WorkSwarm adopte cette approche.
Q2 : Ne suffit-il pas de choisir un modèle avec une fenêtre de contexte plus longue ?
Pour les tâches de durée moyenne, c’est effectivement la solution la plus simple. Mais pour un agent actif en permanence, l’historique continue de grandir et finit par remplir n’importe quelle fenêtre. Les informations importantes peuvent aussi se perdre dans une entrée très longue. Commencez par tester vos tâches réelles avec des modèles aux fenêtres de contexte de différentes tailles via APIYI apiyi.com, puis déterminez si un mécanisme de résumé est nécessaire.
Q3 : Quel est le seuil de bascule de WorkSwarm et comment le résumé est-il généré ?
Les informations publiques disponibles ne précisent ni le seuil exact, ni si le résumé est généré par un modèle ou par des règles, ni si la recherche dans les archives utilise une recherche vectorielle ou une autre méthode. Pour confirmer ces détails d’implémentation, il faut consulter le code source ouvert de JiuwenSwarm sur GitHub ou la documentation officielle. Les passages de cet article sur le sujet relèvent d’une analyse technique générale.
Q4 : Comment valider rapidement une solution de résumé de transmission via une API ?
Vous pouvez créer un prototype en suivant ces étapes :
1. Inscrivez-vous sur APIYI apiyi.com pour obtenir une clé API et un crédit de test gratuit
2. Utilisez le code du prototype présenté dans cet article, en définissant base_url sur `https://api.apiyi.com/v1`
3. Testez-le avec une longue conversation réelle et vérifiez qu’après la bascule, l’agent se souvient toujours des contraintes importantes
Q5 : Quels sont les risques connus de ce modèle ?
Le principal risque est que le résumé omette des détails sans laisser à la nouvelle fenêtre d’indice permettant de les retrouver dans les archives. Une bascule au milieu d’une étape critique peut aussi rendre l’état incohérent. Enfin, aucune donnée de test publique ne permet actuellement de mesurer l’effet réel de ce mécanisme sur la qualité des tâches. Il faut donc le valider soigneusement dans votre propre contexte avant la mise en production.
Points clés : résumé de transfert et fenêtre de contexte
- Mécanisme central : lorsque la fenêtre est presque pleine, l’agent passe à une nouvelle fenêtre avec un résumé de transfert indiquant l’objectif, l’avancement et les prochaines étapes.
- Prérequis : l’identité de l’agent est dissociée de la session, qui devient une ressource planifiable et récupérable.
- Conception du résumé : ajoutez aux trois éléments de base les contraintes de l’utilisateur et un index des archives pour limiter les omissions.
- Moment du transfert : réservez de l’espace pour générer le résumé et privilégiez les transitions entre les tâches.
- Consultation des archives : un résumé entraîne forcément une perte d’information ; les points d’accès aux archives déterminent si elle peut être retrouvée.
- Choix de l’approche : pour les tâches de durée moyenne, un modèle à contexte long peut suffire ; pour les tâches de longue durée, le transfert par résumé est plus adapté.
- Vérification rapide : l’interface unifiée multimodèle d’APIYI, apiyi.com, permet de créer et de comparer des prototypes.
Conclusion
Le mécanisme de changement de contexte d’openJiuwen WorkSwarm offre un modèle de référence clair pour les agents qui fonctionnent sur de longues périodes :
- Le résumé de transfert conserve l’état du travail : l’objectif, l’avancement et les prochaines étapes constituent le minimum ; les contraintes et l’index sont des compléments utiles.
- Le changement doit être anticipé : la génération du résumé consomme elle aussi du contexte. Il ne faut donc pas attendre que la fenêtre soit entièrement remplie.
- La recherche dans les archives compense la perte d’information : le résumé sert à « retenir l’essentiel », tandis que les détails sont recherchés au besoin.
Si votre agent passe d’une session unique à un fonctionnement de longue durée, commencez par définir la structure de son état, puis choisissez entre un modèle à contexte long et un système de transfert par résumé. Vous pouvez créer rapidement un prototype avec APIYI, apiyi.com, et comparer la qualité des résumés ainsi que la consommation de contexte de plusieurs modèles.
📚 Références
- Article de Pandaily : architecture en essaim Hyper-Agent d’openJiuwen et employés numériques WorkSwarm
- Lien :
pandaily.com/openjiuwen-hyper-agent-swarm-architecture-persistent-agents-workswarm-digital-employees -
Description : article en anglais sur les agents persistants, le changement de contexte et le mécanisme de résumé de transfert
-
Code open source de JiuwenSwarm : implémentation open source d’openJiuwen WorkSwarm
- Lien :
github.com(rechercher JiuwenSwarm) - Description : consulter l’implémentation des seuils de basculement, de la génération de résumés et de la recherche dans les archives
Auteur : l’équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil d’APIYI sur apiyi.com. Pour en savoir plus, consultez le centre de documentation sur docs.apiyi.com.