作者メモ: 独立開発者向けに、タスク階層化、統一インターフェース、ルーティングフォールバック、コスト管理、可観測性・評価という5つの段階で、一人プロジェクトの AI Agent と Workflow における複数モデル接続の設計方案を整理します。
一人で AI プロダクトを作っていると、最も詰まりやすいのは案外 Prompt ではなく、複数モデルの接続だったりします。Agent や Workflow を設計し始めると、すぐにいくつかの問題に直面します。どのモデルを選ぶのか、複数社を同時に接続すべきか、APIキーはどう管理するのか、請求はどう抑えるのか、特定のサービスが不安定になったときはどうするのか。本記事では、「タスク階層化 + 統一インターフェース + ルーティングフォールバック」による複数モデル接続の設計手法を紹介します。一人プロジェクトでも、手間を抑えつつ拡張しやすい形で進められるはずです。
これは大企業アーキテクチャの縮小版ではありません。チームにはゲートウェイ、監視、財務突合を専任で維護する人がいますが、一人プロジェクトにはそんな余裕はありません。以下の提案はすべて、一つの原則に基づいています。それは、最小の保守コストで十分な柔軟性を得ることです。
核心価値:本記事を読めば、自分の AI Agent と Workflow に対して、モデル階層をどう分けるか、接続方法をどう統一するか、フォールバック経路をどう設計するかが分かり、さらに呼び出しごとにいくら使ったのかも把握できるようになります。
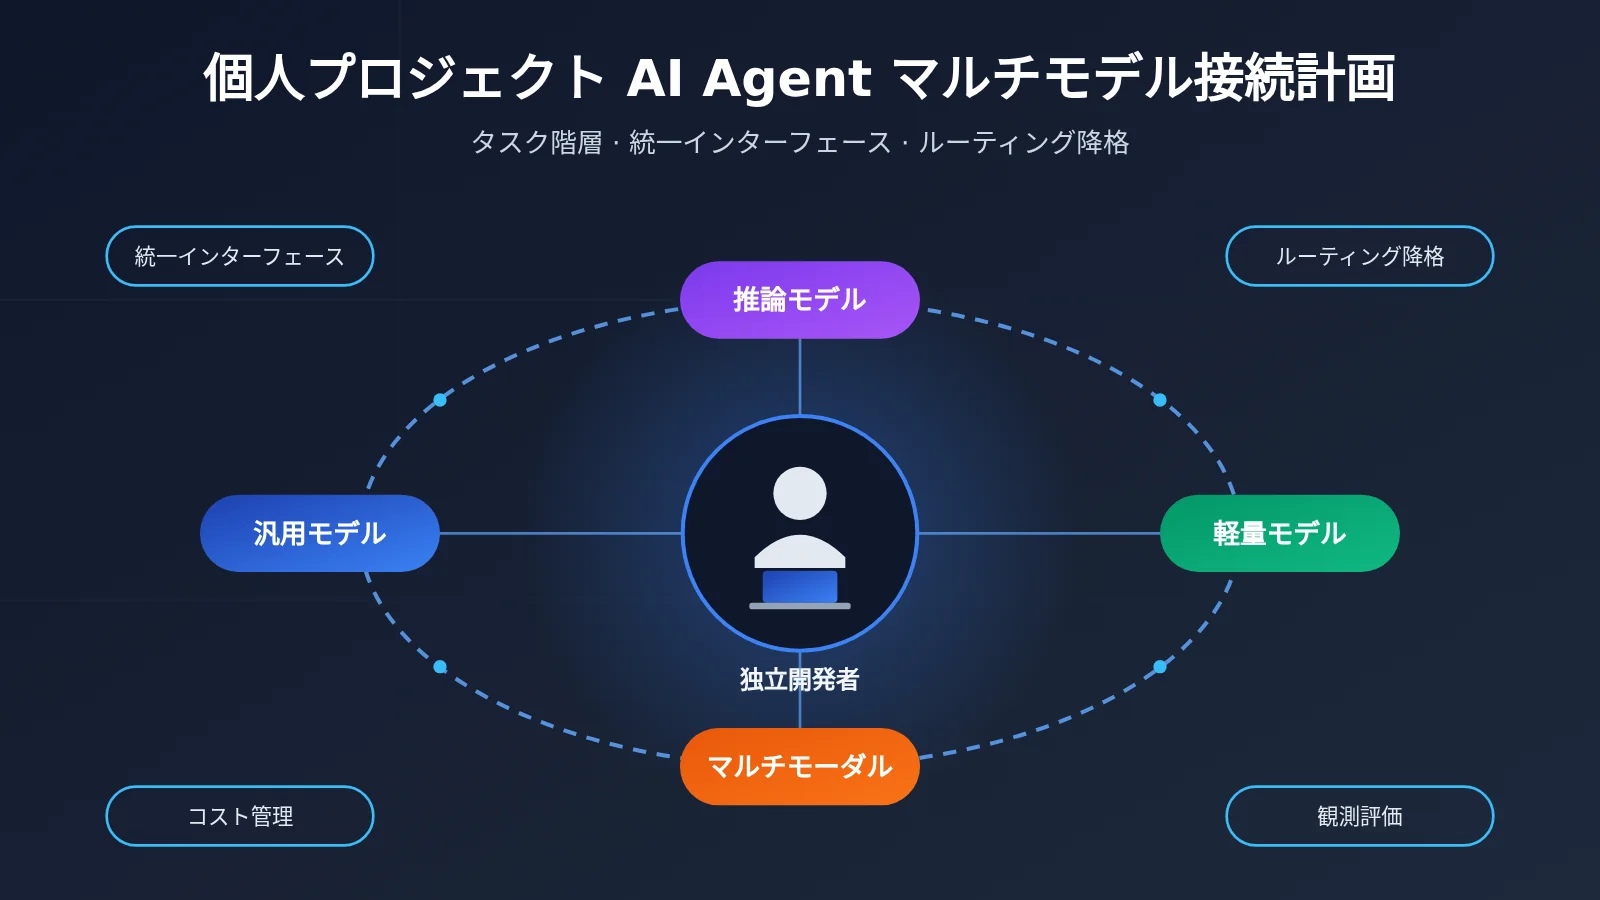
個人開発プロジェクトにおけるAI Agent マルチモデル接続の核心ポイント
コードを書き始める前に、以下の5つのポイントをしっかり考えておきましょう。これらが、その後3か月間でプロダクトを改善し続けられるか、それとも接続レイヤーの修正に追われるかを決めます。
| ポイント | 説明 | 個人開発プロジェクトにとっての価値 |
|---|---|---|
| タスクの階層化 | AgentとWorkflow内の呼び出しを、難易度と頻度に応じて3〜4層に分ける | 高価なモデルは重要な場面だけに使い、全体コストを抑えられる |
| 統一インターフェース | すべてのモデルを1つのリクエスト形式(たとえばOpenAI互換形式)で扱う | モデル切り替えはパラメータ1つの変更だけで済み、ビジネスコードを書き直さなくてよい |
| ルーティングとフォールバック | 各層にメインモデルとバックアップモデルを設定する | 単一サービスに障害が起きても、プロダクト全体が使えなくなることを防げる |
| コストの把握基準 | 入力・出力・キャッシュなどの課金項目を区別し、プラットフォームの料金ページを基準にする | 月末の請求が想定外に膨らむのを防げる |
| 観測と評価 | 呼び出しごとにモデル・所要時間・Token・結果の品質を記録する | 感覚ではなくデータでモデルを切り替えるか判断できる |
マルチモデル接続の計画ポイント詳細
タスクの階層化は、計画全体の出発点です。 典型的なAI Agentは、ユーザーの意図を理解する、手順を計画する、ツールを呼び出す、結果を要約する、出力をフォーマットするなど、性質の異なる多くの処理を行います。これらの工程では、モデルに求められる能力に大きな差があります。意図分類やフィールド抽出のようなタスクは、軽量モデルで十分なことがほとんどです。一方、多段階の計画、複雑なコード生成、長文書の推論にはフラッグシップモデルが必要です。フロー全体を最強のモデルで処理すると、コストとレイテンシが倍以上に膨らみます。逆にすべてを軽量モデルで済ませると、重要な場面でミスが起きやすくなります。まず階層化してからモデルを選ぶのが、個人開発プロジェクトで最もコスト効率のよい方法です。
統一インターフェースは、メンテナンスコストを左右します。 各社のモデル公式SDKは、パラメータ名・ストリーミング返却形式・ツール呼び出しの構造が完全には一致していません。3〜4社の公式APIに直接接続すると、3〜4セットのアダプターコード、3〜4個のアカウント、3〜4通りの請求を管理することになります。個人で開発している場合、その労力は本来プロダクトに向けるべきです。より現実的な方法は、OpenAI形式とAnthropic形式の両方に対応した集約型の接続レイヤーを選ぶことです。ビジネス側は1つのプロトコルだけを扱えばよく、モデルは差し替え可能な設定項目になります。
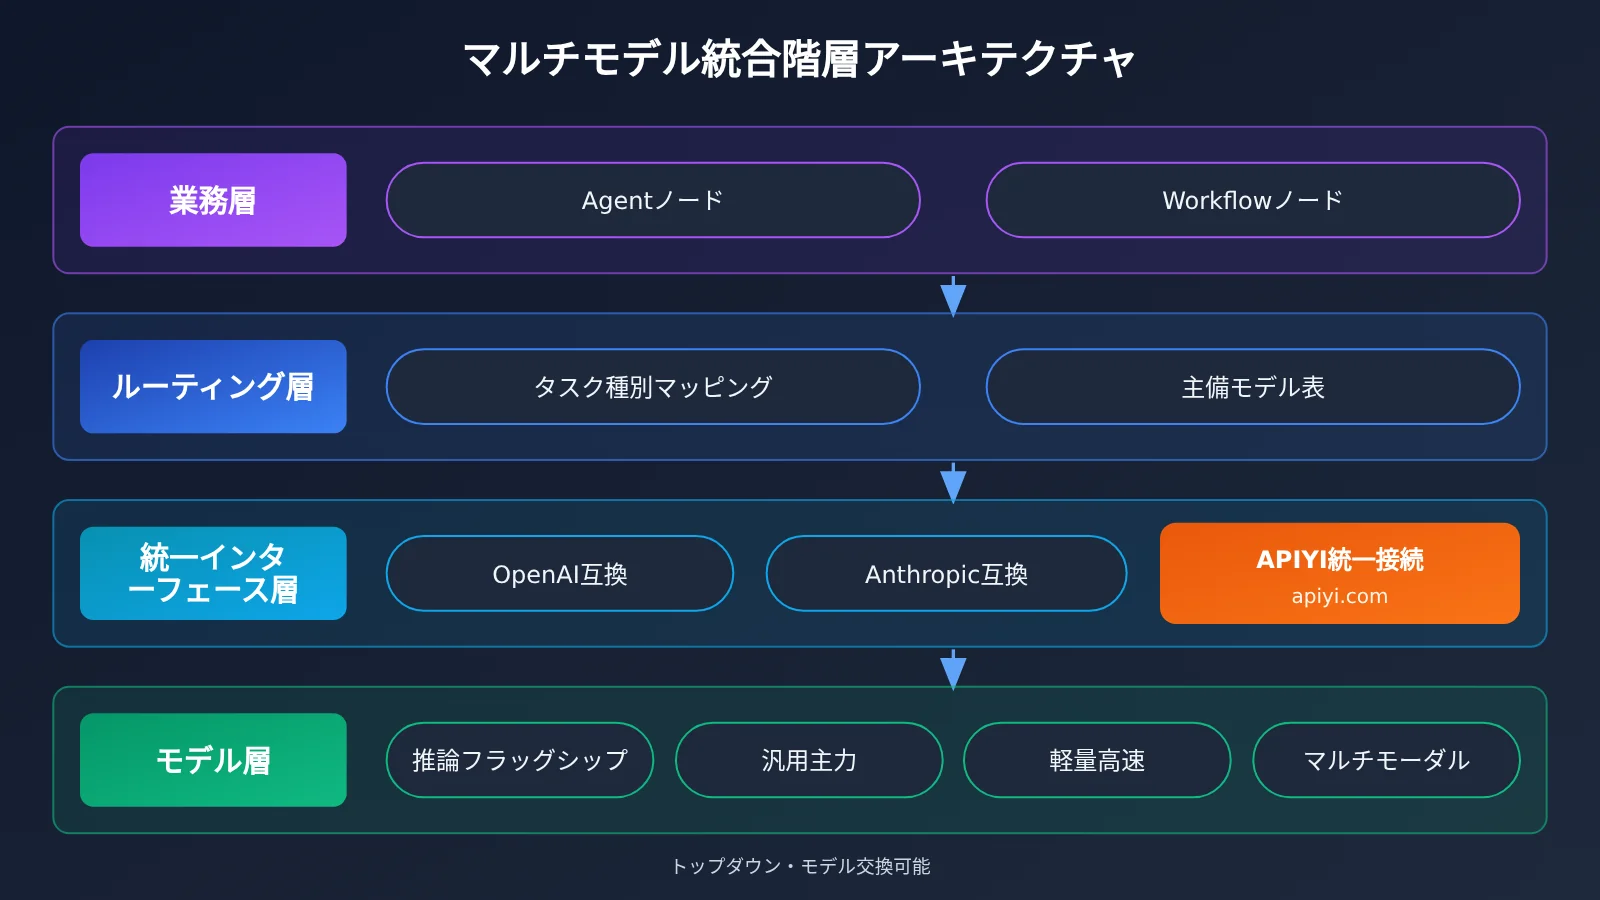
個人プロジェクトの AI Agent はタスクごとにどうモデルを階層選択するか
階層化のポイントは、モデル名ではなくタスクの特徴で区分することです。以下は、ほとんどの AI Agent と Workflow に当てはまる4層の区分で、そのまま出発点として使い、自分の業務に合わせて調整できます。
| 階層 | 典型的なタスク | モデルに求められる能力 | 選定の考え方 |
|---|---|---|---|
| L1 推論層 | 多段階の計画、複雑なコード、長文書の分析 | 推論が深い、指示追従が強い、長いコンテキスト | 各社のフラッグシップまたは推論特化モデル、呼び出し頻度は低い |
| L2 主力層 | 通常の対話、コンテンツ生成、ツール呼び出し | 総合能力がバランス良く、ツール呼び出しが安定 | 主要な汎用モデル、トラフィックの大部分を担う |
| L3 軽量層 | 意図分類、フィールド抽出、要約、リライト | 高速、低価格、フォーマットが安定 | 軽量または mini 級モデル、高頻度の呼び出し |
| L4 特化層 | 画像理解、画像生成、音声、ベクトル化 | 特定モダリティの能力 | 機能ごとに個別選定し、テキストの処理経路とは切り離す |
個人プロジェクトの Workflow で階層化を実践する3つの原則
階層の表を描くのは難しくありません。難しいのは、それを Workflow の中で実際に運用し続けることです。次の3つの原則を押さえれば、遠回りを避けられます。
- まずは下の層に任せ、検証してから上に上げる。 新しいノードを追加するときは、まず L3 の軽量モデルで試験運用し、効果が基準に届かなければ L2 や L1 に上げます。これにより、何でも習慣的に最も高いモデルを使ってしまうのを防げます。
- 計画と実行を分ける。 Agent の「何をするかをじっくり考える」部分は L1 に、「具体的に実行する」部分は L2 または L3 に任せます。多くの Agent フレームワークは、プランナーとエグゼキューターに異なるモデルを設定できるため、ここはコストパフォーマンスが最も高い最適化ポイントです。
- 構造化出力では、フォーマットが安定したモデルを優先する。 Workflow の下流では JSON を解析することが多く、モデルがたまに余計なテキストを出力するだけで経路全体が失敗してしまいます。この種のノードでは、「賢さ」だけでなくフォーマットの安定性を基準に選びましょう。
ひとつ注意したいのは、モデルのバージョンは非常に速く更新されるため、上の表ではあえて具体的な型番を固定していない点です。より確実な方法は、接続するプラットフォームのモデル一覧から各層の候補を2〜3個選び、自分の実際のサンプルで一度実行してから決めることです。APIYI のモデル一覧は主要ベンダーのテキスト・推論・マルチモーダルモデルを網羅しており、同じアカウント内で横並び比較ができるため、個人プロジェクトの選定テストに適しています。
一人プロジェクトの Workflow マルチモデル接続クイックスタート
この節では、実装までの手順を順番に示します。読みやすさを優先し、設定項目はすべて表と文章で説明し、コードは展開しません。
ステップ1:統一アクセスプロトコルを決める
業務側では、OpenAI 互換の Chat Completions 形式に統一することをおすすめします。主要な Agent フレームワークや Workflow オーケストレーションツール、そして多くのオープンソースプロジェクトがこの形式を標準でサポートしており、エコシステムとの互換性が最も高いからです。Claude 系の機能、たとえばネイティブのツール呼び出し構造やプロンプトキャッシュを多用する場合は、該当するノードで Anthropic Messages 形式を使うこともできます。APIYI は OpenAI と Anthropic の両方のインターフェース形式に対応しており、2 つのプロトコルで 1 つのアカウント、1 つのキーを共有できます。
ステップ2:モデルパラメータを設定として切り出す
モデル名を業務ロジックにハードコードしないでください。モデルに関わるパラメータは、すべて設定ファイルや環境変数に外出しします。次の表は、切り出しておくことを推奨する設定項目です。
| 設定項目 | 役割 | 推奨する進め方 |
|---|---|---|
base_url |
インターフェースのアドレス | APIYI のドキュメント docs.apiyi.com に記載されている接続先を記入し、プロジェクト全体でここ 1 か所だけにする |
api_key |
認証キー | 環境変数に入れ、開発用と本番用で別々のキーを使う |
model |
モデル名 | 階層ごとに命名する(例:MODEL_L1、MODEL_L2、MODEL_L3) |
fallback_model |
予備モデル | 各層に最低 1 つ設定し、できれば異なるベンダーのものを選ぶ |
timeout |
タイムアウト時間 | L3 は短く、L1 は長めに設定し、推論モデルがタイムアウトと誤判定されるのを避ける |
max_tokens |
出力の上限 | ノードごとに設定し、異常に長い出力でコストが膨らむのを防ぐ |
こうしておけば、モデルを替えるときは設定を変えるだけで済み、Agent のロジックや Workflow のオーケストレーションには一切手を入れる必要がありません。
ステップ3:Workflow のノードに階層をラベル付けする
Workflow のオーケストレーション図を開き、モデルを呼び出す各ノードに L1〜L4 のラベルを付けます。ビジュアルなオーケストレーションツールでも、自作のフローコードでも、ノードの説明やパラメータに階層を書き、設定から対応するモデルを読み込めばOKです。この作業はすぐに終わりますが、コストがどのノードに集中しているかを一目で把握できるようになります。
ステップ4:フォールバックとリトライを設定する
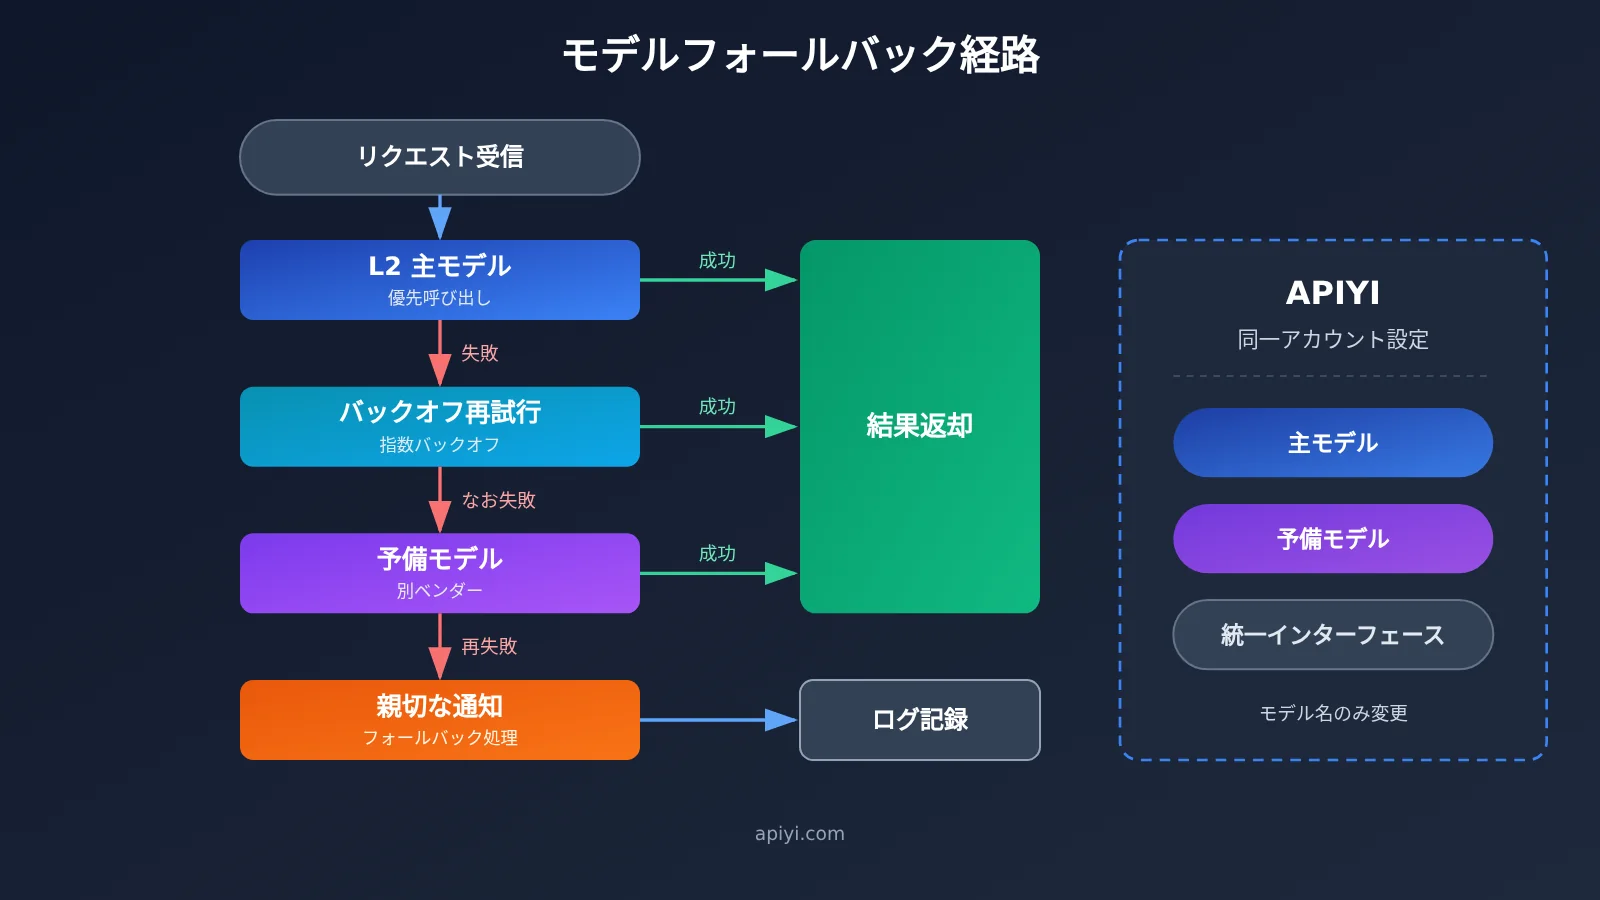
各層に「メインモデル → 予備モデル」の順序を設定します。メインモデルがレート制限、タイムアウト、サーバーエラーを返したときは、まず 1〜2 回のバックオフ付きリトライを行い、それでも失敗する場合は予備モデルに切り替えます。予備モデルは、同じサービスの集中障害を避けられるよう、できれば異なるベンダーの同クラス製品を選びましょう。
ステップ5:すべての呼び出しを記録する
少なくとも次の項目を記録します。時刻、ノード名、階層、モデル名、入力トークン、出力トークン、所要時間、フォールバックが発生したか、最終的に成功したか。シンプルなログテーブルか、軽量な可観測性ツールで十分です。大切なのは、記録を続けることです。
🚀 クイックスタートのヒント:一人プロジェクトなら、まず APIYI apiyi.com で登録してテスト用の枠を取得し、同じキーで L1 から L3 までの候補モデルにそれぞれ実サンプルを流してみるのがおすすめです。選定が固まってから設定に書き込むほうが、先に接続してからコードを何度も直すよりずっと楽です。
一人プロジェクトのAI Agent マルチモデル接続プラン比較
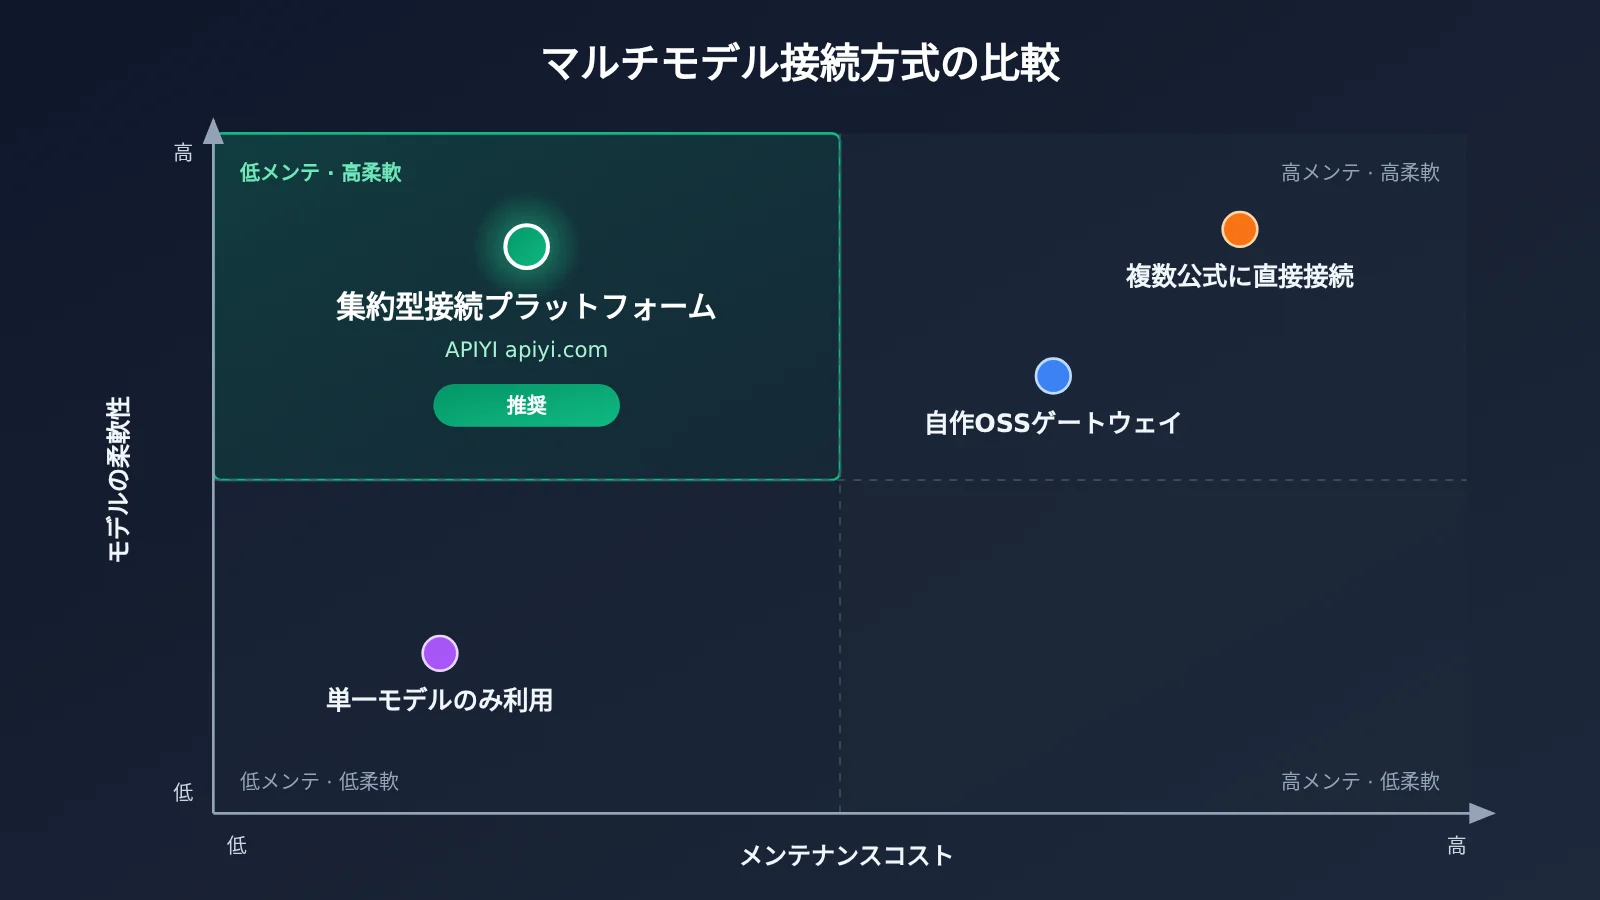
マルチモデルの接続方法は大きく4つのルートに分かれ、それぞれ保守コストが大きく異なります。
| プラン | 主な特徴 | 適する場面 | 一人プロジェクトの保守負担 |
|---|---|---|---|
| 単一モデルのみ利用 | 1社1モデルで最もシンプル | プロトタイプ検証、機能が単一の小さなツール | 低いが、フォールバック手段がない |
| 複数の公式APIに直接接続 | 各ベンダーの公式APIに個別に接続 | 特定社の機能に強く依存している | 高い。複数セットのSDK、アカウント、請求管理が必要 |
| オープンソースゲートウェイの自前構築 | 統一プロキシ層を自らデプロイ | 運用経験があり、プライベート化が必要 | 中〜高。デプロイ、アップグレード、トラブルシューティングを自分で行う必要 |
| 集約型接続プラットフォーム | 1つのインターフェースで複数モデルに接続 | マルチモデルが必要だが接続層を保守したくない | 低い。APIYI apiyi.com などのプラットフォームが統一インターフェースを提供 |
マルチモデル接続プランの比較分析
単一モデルプランの比較:1つのモデルだけを使う方法は、立ち上げ段階では最も効率的で、ルーティング設計も不要です。ただし可用性とコストを完全に1社のサービスに委ねることになり、相手側がレート制限をかけたり価格を変更したりすると、ほぼ打つ手がなくなります。それに比べて、あらかじめ統一インターフェースと設定可能なモデルパラメータを用意しておけば、開発量はほとんど増えず、その後の拡張の余地を十分に残せます。
複数の公式API直結プランの比較:公式APIへの直結は、新機能の追随スピードに優れ、某社が発表したばかりの機能をいち早く使えます。しかし複数セットの適合コード、複数のチャージアカウント、複数の突合処理を同時に保守することは、1人の精力を継続的に消耗します。多くの一人プロジェクトにとっては、公式独自機能に本当に依存するノードだけ直結し、それ以外は統一インターフェース経由にするほうが現実的です。
自前ゲートウェイ構築の比較:自前で構築するオープンソースゲートウェイは制御性が最も高く、プライベート化のニーズがある場面に適しています。ただしデプロイ、アップグレード、監視、障害調査をすべて自分で担う必要があり、サービスを1つ余分に保守するのと同じです。製品をできるだけ早く届けることが主目的なら、集約型プラットフォームのほうが堅実な出発点になることが多く、事業規模が大きくなってから自前構築を検討すればよいでしょう。
💡 選択のヒント:まだ迷っているなら、まず APIYI で全ノードを通し、そのうえでビジネス側は OpenAI 互換フォーマットだけに依存するようにしておくとよいでしょう。そうすれば将来、自前ゲートウェイや公式直結へ移行する際も、変更は設定層に集中します。
個人プロジェクトにおけるマルチモデル接続のコストと安定性の管理
個人プロジェクトでは、帳票をチェックしてくれる財務担当の同僚はいません。だからこそ、コスト管理はアーキテクチャに組み込んでおく必要があります。次の表は、よく使われるコスト削減のレバーをまとめたものです。
| コストレバー | 取り組み | 課金基準の説明 |
|---|---|---|
| 階層ごとのダウングレード | 高頻度のノードには L3 の軽量モデルを使用する | モデルごとに単価の差が大きいため、APIYI の料金ページを基準にしてください |
| 出力長の制御 | 各ノードに max_tokens を設定する |
多くのモデルでは出力単価が入力単価より高いため、詳細は料金ページを基準にしてください |
| キャッシュの活用 | 固定のシステムプロンプトやツール定義をリクエストの先頭に置く | キャッシュに対応しているか、またキャッシュの課金方式はモデルによって異なるため、料金ページを基準にしてください |
| コンテキストの圧縮 | Agent のマルチターン対話は定期的に要約し、履歴を無限に積み上げない | 入力 Token はターン数に比例して増えていき、隠れたコストの主要因になります |
| 予算アラートの設定 | 日単位で Token 使用量を集計し、しきい値を超えたら通知する | 呼び出しログとプラットフォームの請求書を突き合わせて確認しましょう |
価格については、この記事ではあえて具体的な数字を一切挙げていません。 モデルの入力単価、出力単価、キャッシュの読み書き価格、課金基準は、ベンダーの方針によって随時変わります。記憶や古い資料をもとに見積もると、簡単に誤ってしまいます。コスト計画を立てるときは、APIYI の料金ページ docs.apiyi.com/models にある実際のデータを基準にし、「各階層の1日あたりの平均呼び出し回数 × 平均入力 Token × 入力単価 + 平均出力 Token × 出力単価」という考え方で月額費用を見積もり、キャッシュヒットの状況用に別の列を用意しておきましょう。
安定性については、リリース前にやっておく価値のあることが3つあります。
- フォールバック経路の演習:メインモデル名を手動で無効な値に書き換えて、Workflow が自動的にバックアップモデルへ切り替わり、正常に処理を完了できるか確認します。
- タイムアウトの階層化:推論型モデルは思考時間が長くなるため、タイムアウトのしきい値は軽量モデルより明らかに高く設定する必要があります。そうしないと「賢いモデルほどタイムアウトしやすい」という状況が起きます。
- 冪等性の設計:メール送信やデータベースへの書き込みなど、副作用を伴うツール呼び出しは、リトライ時に二重実行されないようにしておきましょう。
よくある質問 FAQ
Q1: 一人プロジェクトにおけるマルチモデル接続の計画とは?
個人開発の場面で、AIエージェントとワークフローのどの工程にどの種類のモデルを使うか、どのインターフェース経由で接続するか、エラー時にどうフォールバックするか、コストをどう集計するかをあらかじめ決めておくことです。目的は、メンテナンスの負担をあまり増やさずに、コスト面の優位性と可用性の確保を同時に手に入れることにあります。
Q2: モデル接続において AIエージェントとワークフローはどう違いますか?
ワークフローは手順があらかじめ組み立てられており、各ノードのモデルを静的に指定できるので、レイヤー分けも分かりやすいです。一方、エージェントは呼び出しの順序や回数を自分で決めるため、呼び出し量の見積もりが難しくなります。そのため、計画と実行でモデルを分ける設計がより重要になり、1タスクあたりの最大ターン数とトークン予算を設定しておく必要があります。
Q3: 始めたばかりでも複数モデルを接続すべきですか?
最初から多くのベンダーを接続する必要はありませんが、インターフェース設計は最初から統一しておくべきです。最初のバージョンでモデル名を設定値にし、OpenAI互換フォーマットを採用し、主要ノード用に予備モデルを1つ用意しておくことをおすすめします。開発量の増加はごくわずかで、その後の拡張はずっとスムーズになります。
Q4: マルチモデル接続が最も向いている一人プロジェクトの用途は?
– **AIライティング・コンテンツツール**:アウトラインに L1、本文に L2、タイトルの書き換えに L3。
– **スマートカスタマーサポートエージェント**:意図認識に L3、複雑な問題は L2 または L1 にエスカレーション。
– **データ処理ワークフロー**:バッチ抽出と分類に L3、異常サンプルは L2 で再確認。
– **プログラミング支援ツール**:コード計画に L1、補完とコメントに L2 または L3。
Q5: 統一インターフェースで複数モデルをすばやく呼び出すには?
OpenAI と Anthropic のインターフェース形式に互換性のある APIYI を利用できます。
1. APIYI apiyi.com にアクセスしてアカウントを登録し、APIキーを取得します。
2. APIYI のドキュメント docs.apiyi.com に従って `base_url` とキーを設定します。
3. `model` パラメータを変更するだけで、各ベンダーのモデルを切り替えられます。ビジネスコードを変更する必要はありません。
本記事で扱う推論モデル、汎用モデル、軽量モデル、マルチモーダルモデルは、いずれも APIYI の統一インターフェースで呼び出しと比較ができます。
Q6: マルチモデル構成の月額費用はどう見積もればよいですか?
まず呼び出しログからレイヤーごとの1日あたりの呼び出し回数と平均トークン数を集計し、次に APIYI の料金ページ docs.apiyi.com/models にある各モデルの入力・出力・キャッシュの単価と照らし合わせて計算します。古い記事や記憶の中の価格に頼らず、料金ページの実際のデータを基準にし、月に一度は見直しましょう。
Q7: マルチモデル構成にはどのような既知の制約がありますか?
同じプロンプトに対する応答スタイルはモデルごとに異なるため、予備モデルに切り替えたときに出力フォーマットが微妙に変わることがあり、下流のパースにはエラー耐性が必要です。また、一部ベンダー固有の機能は互換フォーマットでは完全には使えない場合があります。さらに、モデルが増えるほど評価の作業量も増えるため、各レイヤーの候補モデルは2〜3個に抑えることをおすすめします。
一人プロジェクトのAI Agent マルチモデル接続 核心ポイント Key Takeaways
- まずレイヤー分けしてから選定:タスクの難易度と頻度でL1〜L4に分け、モデル名では分けない。
- インターフェースを統一:業務側は1つのプロトコルだけに依存し、モデル名は差し替え可能な設定項目にする。
- 計画と実行を分離:Agentの計画には強力なモデル、実行は主力モデルか軽量モデルに任せる。
- フォールバックは必ず訓練:メインとバックアップのモデルは異なるベンダーから選び、リリース前に手動で障害をシミュレートして検証。
- 価格は価格ページを正とする:すべての単価とキャッシュ課金は docs.apiyi.com/models で確認。
- ログが意思決定の根拠:モデル、Token、所要時間、フォールバック状況を記録し、データでモデル切り替えを判断。
- 導入はアグリゲーションプラットフォームから:APIYI は OpenAI と Anthropic 形式に互換、1つのKeyでマルチモデルテストが完了。
まとめ
一人プロジェクトでAI AgentとWorkflowを構築する際、マルチモデル接続の計画は3点に集約できます:
- タスクのレイヤー分け:各工程にちょうど十分なモデルを使い、コストと効果を同時に制御。
- 統一インターフェース+設定化:モデルを差し替え可能なパラメータにし、メンテナンス負担を一人で耐えられる範囲に保つ。
- フォールバックと観測:可用性にバックアップがあり、意思決定にデータがあり、初めてプロジェクトは長期的に安定してイテレーションできる。
まず1つの統一インターフェースですべてのノードを通し、その後ログデータに基づいて段階的に選定を最適化することをおすすめします。接続層を自分でメンテナンスしたくない場合は、APIYI apiyi.com を通じて主要モデルを統一的に呼び出せます。インターフェースはOpenAIとAnthropic形式に互換です。接続説明はAPIYIドキュメント docs.apiyi.com、モデル価格と課金基準は価格ページ docs.apiyi.com/models を正とします。
📚 参考資料
- APIYI ドキュメントセンター:接続先アドレス、認証方式、インターフェース形式の説明
- リンク:
docs.apiyi.com -
説明:
base_urlや Key の設定、OpenAI 形式と Anthropic 形式の切り替え時に参照してください -
APIYI モデル・価格ページ:モデル一覧、入出力の単価、キャッシュ課金
- リンク:
docs.apiyi.com/models -
説明:本記事のコストに関する内容は、すべてこのページの実際のデータに基づいています
-
OpenAI API ドキュメント:Chat Completions インターフェース形式のリファレンス
- リンク:
platform.openai.com/docs -
説明:OpenAI 互換形式のパラメータやツール呼び出しの構造を理解したいときに
-
Anthropic 公式ドキュメント:Messages インターフェースとプロンプトキャッシュの説明
- リンク:
docs.anthropic.com - 説明:Claude ノードで Anthropic 形式を使用する際の参考として
著者:APIYI 技術チーム
技術交流:APIYI 公式サイトのトップページからお気軽にお問い合わせください。その他の接続資料は docs.apiyi.com ドキュメントセンターでご覧いただけます