作者注:Gemini 4 の Argon と Carbon について、推論への投入量、応答速度、タスクあたりのコストの違いを比較します。タスクの難易度に応じてモデルを選ぶ際の参考にしてください。
Google は 2026 年 10 月 13 日に Gemini 4 Argon を発表しました。続いて 10 月 28 日に Gemini 4 Carbon を初めて公開し、11 月 10 日には開発者、企業、一般ユーザー向けに Carbon を正式に開放しています。多くの開発者がまず思い浮かべるのは、「Carbon は Argon の上位互換なのでは?」という疑問でしょう。本記事では、推論への投入量、応答レイテンシ、タスクコスト、適した用途、推論レベルの 5 つの観点から、Gemini 4 Argon と Carbon の実際の違いを比較します。
これは「ハイスペックなほうが必ず優れている」という単純な話ではありません。 Google 公式の開発者ドキュメントでは、ほとんどのエンジニアリング業務やナレッジワークでは、引き続き Argon が推奨されると明記されています。一方の Carbon は、より深い推論や長い検証サイクルが必要なタスク向けのモデルです。本記事は Google 公式ドキュメントを主な根拠としており、サードパーティのデータを引用する場合は、評価バージョンと推論レベルを併記します。
この記事で得られること:どのタスクを Argon に任せ、どのタスクなら Carbon を使う価値があるのかが分かります。さらに、Thinking Level を使って品質、速度、コストをコントロールする方法も紹介します。
Gemini 4 ArgonとCarbonを比較する前に知っておきたい7つの用語
2つの推論モデルを比べるときは、混同しやすい概念がいくつかあります。先にここを整理しておくと、後ろのデータを読み違えずに済みます。
- 推論レベル(Thinking Level):モデルが思考にかける労力を制御する設定です。Carbonでは LOW、MEDIUM、HIGH の3段階を選べます。
- 思考トークン:モデルが推論する際に生成するトークンです。出力トークンとして課金されます。
- タスクコスト:1つのタスクを完了するまでに行ったすべてのモデル呼び出しの費用です。単一リクエストの費用とは異なります。
- 推論レイテンシ:モデルがリクエストを受け取ってから結果を出すまでにかかる時間です。本記事では、最初の回答トークンが返るまでの遅延に注目します。
- キャッシュ読み取り:既存の入力コンテキストを再利用する課金方式です。通常の入力よりも大幅に安くなります。
- Agent:ツールを使って複数ステップのタスクをこなすエージェントです。たとえば、コードを書き、テストを実行し、不具合を修正するといった作業を行います。
- ベンチマークテスト:固定のタスク群を使ってモデルを評価・比較する手法です。得られた結論は、そのテスト設定でのみ成り立ちます。
GoogleがGemini 4 ArgonとCarbonを同時に投入した理由
Google DeepMindが公開しているCarbonのモデルカードによると、Gemini 4 CarbonはGemini 4 Argonをベースに構築されています。つまり、両者は共通のモデル基盤を持ち、Carbonはその上に、高難度の推論、複雑なソフトウェアエンジニアリング、長期にわたるAgentワークフロー、科学研究、サイバーセキュリティ防御に向けてさらに強化を加えたバージョンです。ただし、GoogleはCarbonのパラメータ数を公表しておらず、両者の内部の計算アーキテクチャの違いも明らかにしていません。そのため、「CarbonはArgonの何倍の大きさ」といった言い方には根拠がありません。
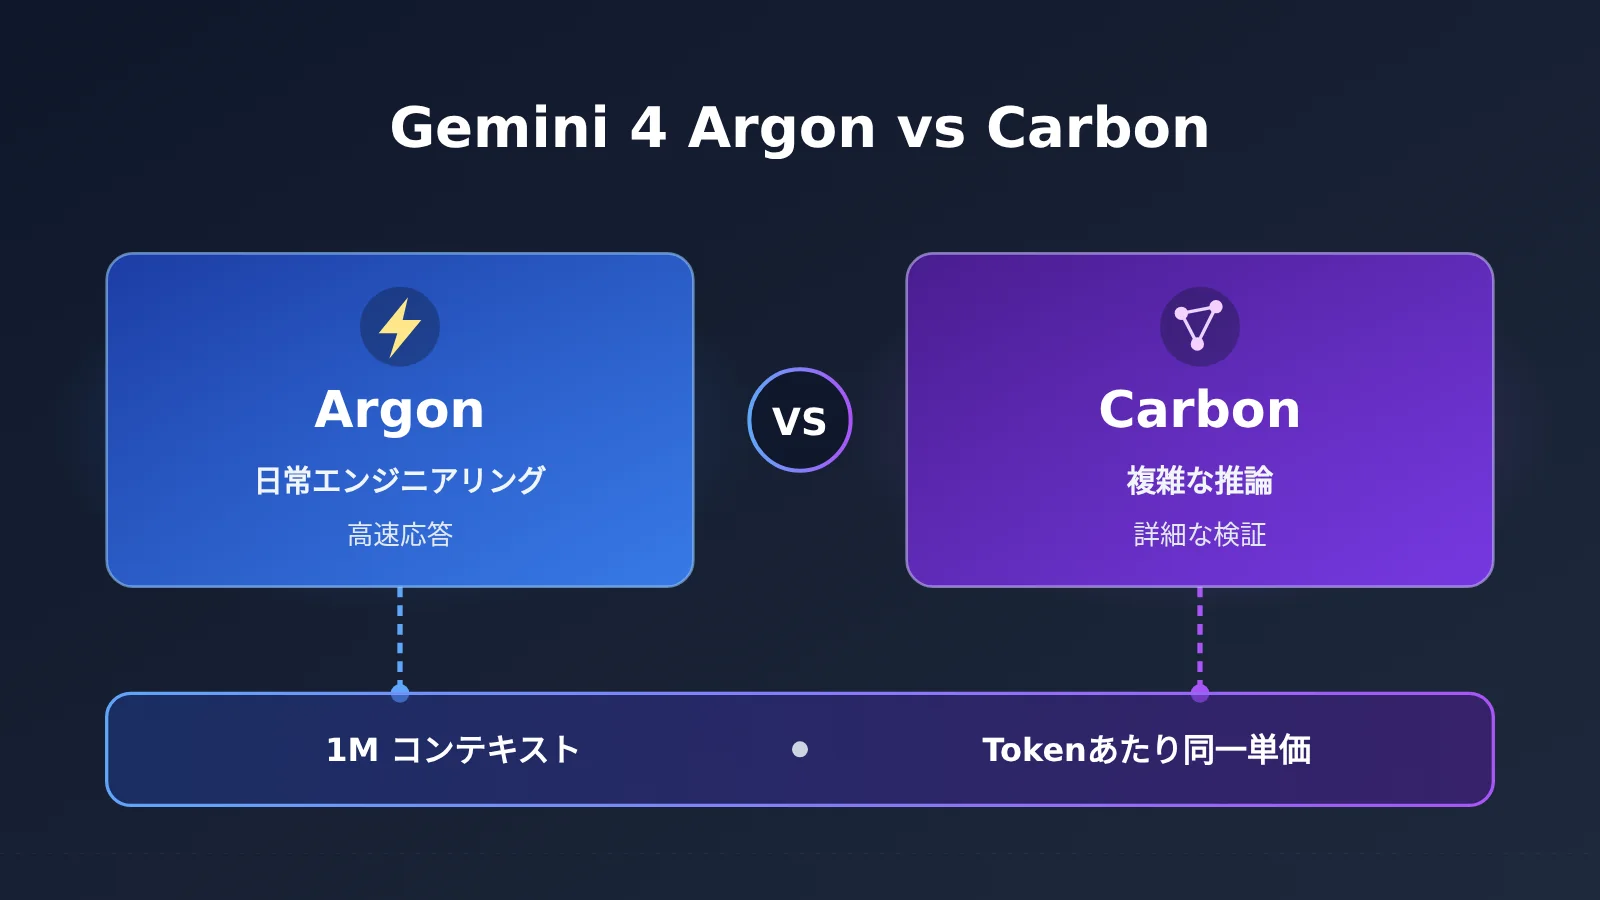
では、Carbonのほうが強いのなら、なぜArgonを置き換えないのでしょうか。それは、両者が得意とする仕事の種類が違うからです。日常的な機能開発や、頻繁にやり取りするコード修正では、応答速度と1ターンあたりのトークン消費が重視されます。一方、アーキテクチャ設計、サブシステムをまたぐ根本原因の調査、科学的な証明といったタスクでは、仮説を立て、検証し、修正することを何度も繰り返せるかどうかが重要になります。Googleが開発者向けドキュメントで示している選び方も、置き換えではなく役割分担です。大半の日常的なエンジニアリングはArgon、より難しく長期にわたる推論タスクはCarbonが担当します。
この役割分担は、Google自身のプロダクトにも表れています。Antigravityの /swarm マルチAgentプレビュー機能では、全体のアーキテクチャ設計、タスクの調整、セキュリティレビューをCarbonに任せ、通常のコード実装や複数ファイルの並列修正は、より高速で軽量なモデルに任せることをGoogleは推奨しています。一般ユーザー向けでも同様です。Google AI Proのサブスクリプションで使えるモデルは主にArgonで、Carbonが含まれるのはUltraのサブスクリプションからです。
Gemini 4 ArgonとCarbonの核心的な違い:1ターンあたりの推論投入量
Googleは、Carbon開発者ガイドの「Choosing between Carbon and Argon」の章で、最もわかりやすい説明をしています。Carbonは1ターンごとに多くの思考トークンを使い、自分の作業をより十分に探索・検証します。一方のArgonは、応答が速く、1ターンあたりのトークン消費も少ないため、インタラクティブなコーディングや日常的な機能開発に向いています。どちらも1Mトークンの統一コンテキストウィンドウ(1,048,576トークン、入力と出力で共有)を備え、内蔵ツール機能も共通で、トークン単価も同じです。
| 比較項目 | Gemini 4 Argon | Gemini 4 Carbon | 向いているのは |
|---|---|---|---|
| 製品の位置づけ | 高性能・高効率の汎用推論モデル | より深い複雑な推論に特化したモデル | タスク次第 |
| 1ターンあたりの思考トークン | 比較的少ない | 1ターンでより多く使う | Argonのほうが節約できる |
| 応答速度 | 速い | 複雑なタスクでは遅くなる | Argon |
| インタラクティブな開発 | より向いている | 高難度タスクに利用可能 | Argon |
| 日常的な機能開発 | 推奨 | 通常は不要 | Argon |
| アーキテクチャ設計、根本原因の調査 | 対応可能 | 極めて複雑で深い調査により向いている | Carbon |
| 科学的証明、セキュリティ監査 | 対応可能/サポート | 複雑な推論と検証により向いている | Carbon |
| コンテキストとトークン単価 | 1M共有コンテキスト、単価は同じ | 1M共有コンテキスト、単価は同じ | 同等 |
この表からわかるように、Gemini 4 ArgonとCarbonの分かれ目は「できるかどうか」ではなく、「じっくり考える価値があるかどうか」です。Argonもアーキテクチャ設計や根本原因の調査をこなせます。ただ、問題が複雑で何度も仮説を立てて検証する必要がある場合には、Carbonがより多くの思考トークンを投じて、より信頼できる結果を引き出してくれます。
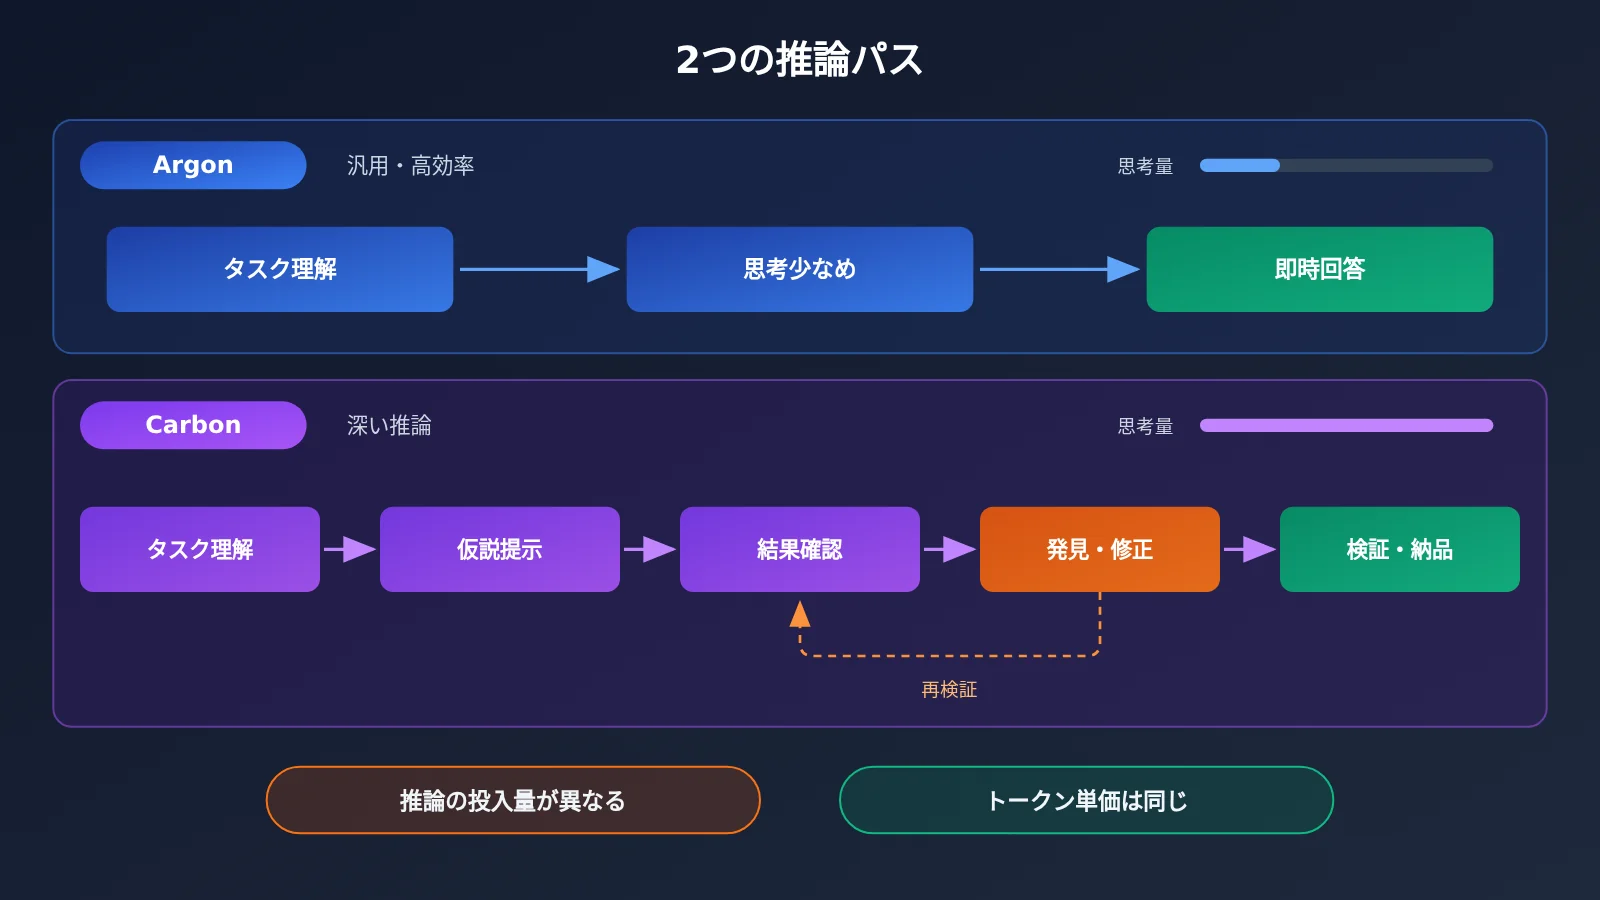
Carbonの働き方は、完結した実行ループに近いものです。目標と制約を理解し、タスクを分解して計画を立て、ツールを呼び出し、途中結果をチェックし、誤りを見つけて修正し、再検証したうえで成果物を届けます。このループがあるからこそ、長期間にわたるタスクで強みを発揮します。同時に、最初の回答までの待ち時間が長くなる理由でもあります。
Gemini 4 Argon と Carbon の独立ベンチマーク比較
公式の主張を検証するには、第三者のデータが欠かせません。Artificial Analysis は Intelligence Index v5.0.1 で、Carbon と Argon を直接比較できるページを公開しています。以下のデータはいずれも High 推論設定での結果です。
| 指標(AA v5.0.1、High 推論) | Carbon High | Argon High | 差 |
|---|---|---|---|
| 総合能力指数 | 60 | 50 | Carbon +10 |
| AutomationBench-AA | 77.8% | 77.5% | ほぼ同等 |
| Terminal-Bench 4.0 | 65.2% | 57.1% | Carbon がリード |
| FrontierCode 2.0 | 40.6% | 25.7% | Carbon が大きくリード |
| AA-Omniscience(知識の信頼性スコア) | 54 | 46 | Carbon がリード |
| HLE-Diamond | 69.1% | 56.7% | Carbon がリード |
| タスクあたりのコスト | $7.76 | $9.95 | Carbon の方が低い |
| タスクあたりの所要時間 | 25.6 分 | 28.9 分 | Carbon の方が短い |
| 最初の回答トークンまでの遅延 | 約 68 秒 | 約 37 秒 | Argon の方が速い |
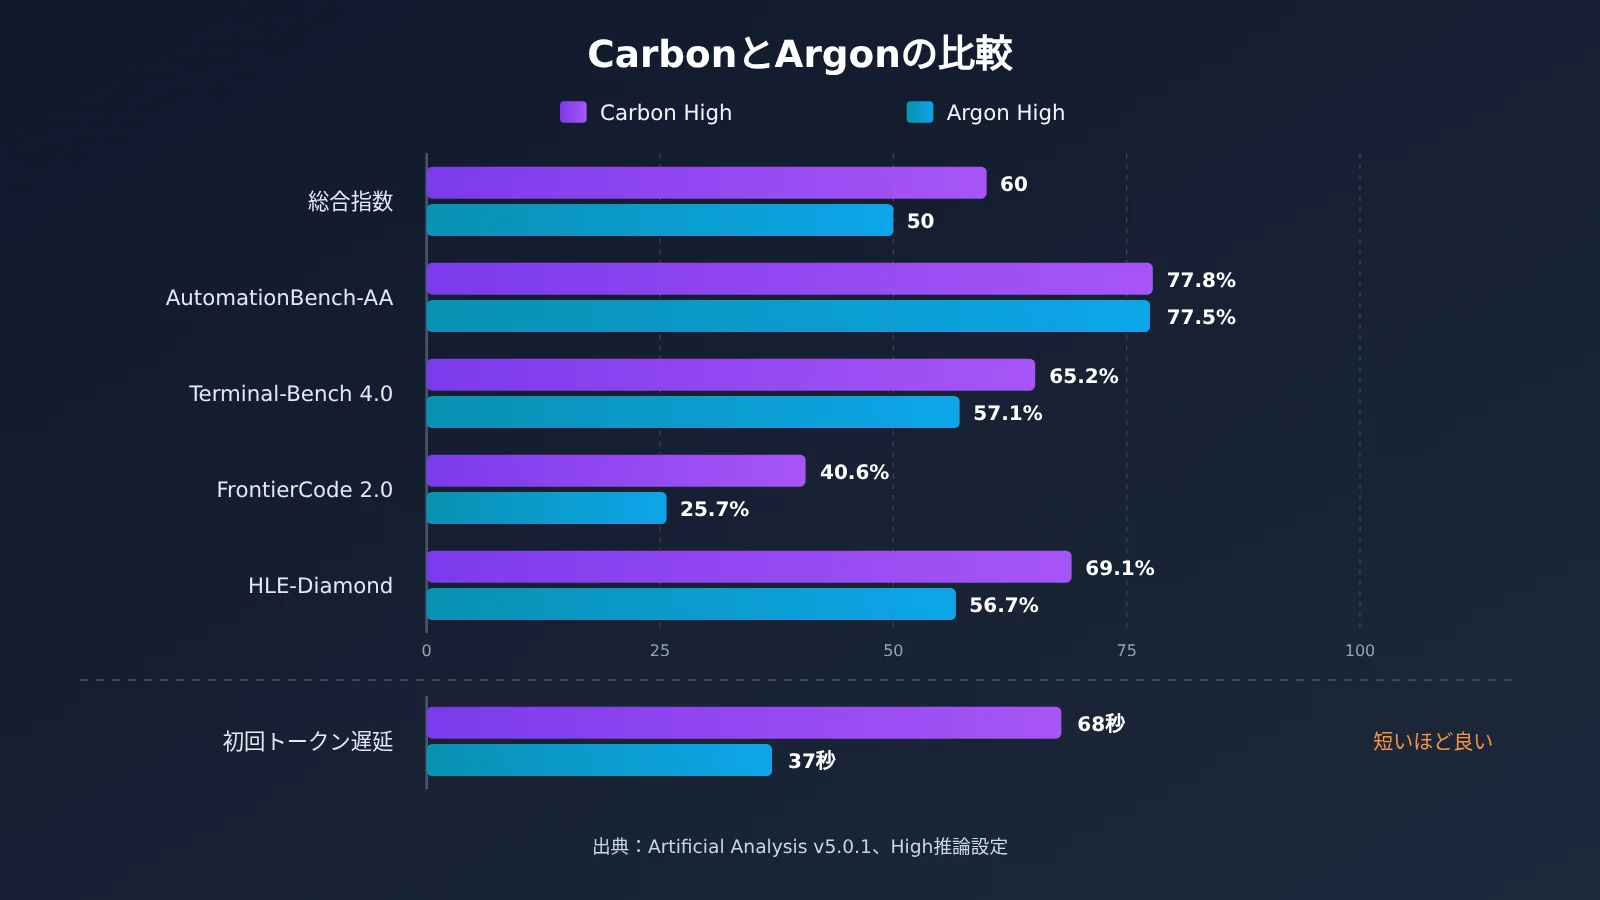
注目したいポイントは次のとおりです。
- 複雑なエンジニアリングと高度な推論で差が最も大きい:FrontierCode 2.0 では約 15 ポイント、HLE-Diamond では約 12 ポイント、Terminal-Bench 4.0 では約 8 ポイント、Carbon がリードしています。
- 定型的な自動化タスクでは差がごくわずか:AutomationBench-AA の差は 0.3 ポイントのみです。ワークフロー型の自動タスクであれば、Argon で十分といえます。
- 知識の信頼性が向上:AA-Omniscience のスコアは 54 対 46 です。Google のモデルカードに記載された Agentic Honesty Benchmark でも、Carbon が 92%、Argon が 70% となっています。
- Argon は最初の応答が明らかに速い:約 37 秒対約 68 秒。これは Carbon が推論により多くのリソースを投じていることの直接的な代償です。
Google 公式のモデルカード(評価時期は 2026 年 10 月と記載。通常は Pass@1 で、利用可能な最高の推論レベルを使用)でも、同様の傾向が示されています。SWE-sweep では Carbon が 9.6%、Argon が 4.3%。GraphWalks(256k〜1M、BFS F1)では Carbon が 96.2%、Argon が 84.2%。Terminal-Bench Science 0.1 では Carbon が 64.8%、Argon が 52.9% です。ただし、公式モデルカードと Artificial Analysis は評価体系も時期も異なるため、混ぜて順位付けするのは避けたほうがよいでしょう。また、Carbon のモデルページには High のタスクあたり所要時間が 24.9 分と表示されており、比較ページの 25.6 分とわずかに異なります。本記事の比較表では、比較ページのデータを採用しています。
ベンチマークの成績がすべてではありません。Google DeepMind と Artificial Analysis が共同で公開した、マルチモーダルな知識業務の評価「MKA」では、全 10 業界で首位に立ったモデルはありませんでした。Argon は科学分野で、Carbon はヘルスケア分野でそれぞれ首位です。Carbon の総合スコアが高いからといって、あらゆる個別分野で Argon を上回るとは限らない、ということです。
💡 比較に関する補足:ベンチマークが示すのは、あくまで決まったタスクセットでの成績です。自社の業務に Carbon が必要かどうかを確かめる最も確実な方法は、実際のタスクを両モデルで一度ずつ実行してみることです。APIYI(apiyi.com)なら、同じ APIキーと OpenAI 互換のコードで 2 つのモデルを切り替えられるので、小規模な比較テストも手軽に行えます。
なぜ Gemini 4 Carbon は1ターンあたりのトークン消費が多いのに、必ずしも高くならないのか
ここは最も誤解されやすいポイントです。Gemini 4 Argon と Carbon のトークン単価は同じです。2026年11月30日までのローンチ価格は、入力100万トークンあたり2ドル、出力100万トークンあたり10ドル。12月1日からは4ドルと20ドルに改定されます。キャッシュ入力の価格は、通常の入力価格から95%割引した水準です。思考トークンは出力トークンの料金に含まれるため、Carbon がターンごとにじっくり考える分、1ターンあたりの請求額は通常高くなります。
ただし、タスク単位の請求額は1ターンの請求額とは別物です。Artificial Analysis v5.0.1 の High 設定の比較では、1タスクあたりのコストは Carbon が7.76ドル、Argon が9.95ドルで、Carbon のほうが約22%安く、所要時間も約3分短くなっています。考えられる説明はこうです。タスク全体のコストは、完了までに何ターンかかったか、どれだけ遠回りしたか、何回やり直したかで決まります。Carbon が最初にしっかり考えてミスが減れば、その後のリトライや修正のターンも減らせる可能性があります。
| 設定(AA v5.0.1) | 総合スコア | 1タスクあたりのコスト | 1タスクあたりの所要時間 | 初回回答までの遅延 |
|---|---|---|---|---|
| Carbon Low | 54 | $7.19 | 22.3分 | 12.37秒 |
| Carbon Medium | 58 | $6.59 | 23.3分 | 23.16秒 |
| Carbon High | 60 | $7.76 | 24.9分 | 67.54秒 |
| Argon High | 50 | $9.95 | 28.9分 | 約37秒 |
このデータには、直感に反する発見がもうひとつあります。Carbon Medium のタスクコストは Low よりも低いのです。推論レベルを下げると1ターンあたりは安く済みますが、タスクを終えるまでにより多くのターンが必要になる場合があります。ただし、比較できる範囲には特に注意してください。
- これらのコストは、この評価体系における1タスクあたりの平均コストです。標準価格(4ドル/20ドル)で計算した値であり、通常のAPIリクエスト1回の価格ではありません。ローンチ価格で見積もると、同じトークン使用量でコストは約半分になります。
- 24.9分といった所要時間は、Agent 評価タスクの加重所要時間です。通常の質問に25分待たされるという意味ではありません。
- 結論は AA Index のこのタスク群に限られます。タスク自体が単純で、1〜2ターンで終わるのであれば、Argon やより低いレベルの設定のほうが1ターンあたりのコストが低い分、そのまま請求額の安さにつながります。
💰 コストのヒント:モデルを評価するときは、単価だけを比べるのではなく、「1つのタスクを完了するまでの合計トークン数と合計時間」を記録してください。APIYI(apiyi.com)は従量課金制で、コンソールから呼び出しごとの使用量の詳細を確認できます。Argon と Carbon が自社の業務で実際にどれだけのタスクコストになるのかを算出するのに便利です。
Gemini 4 ArgonとCarbon、どちらを選ぶべきか
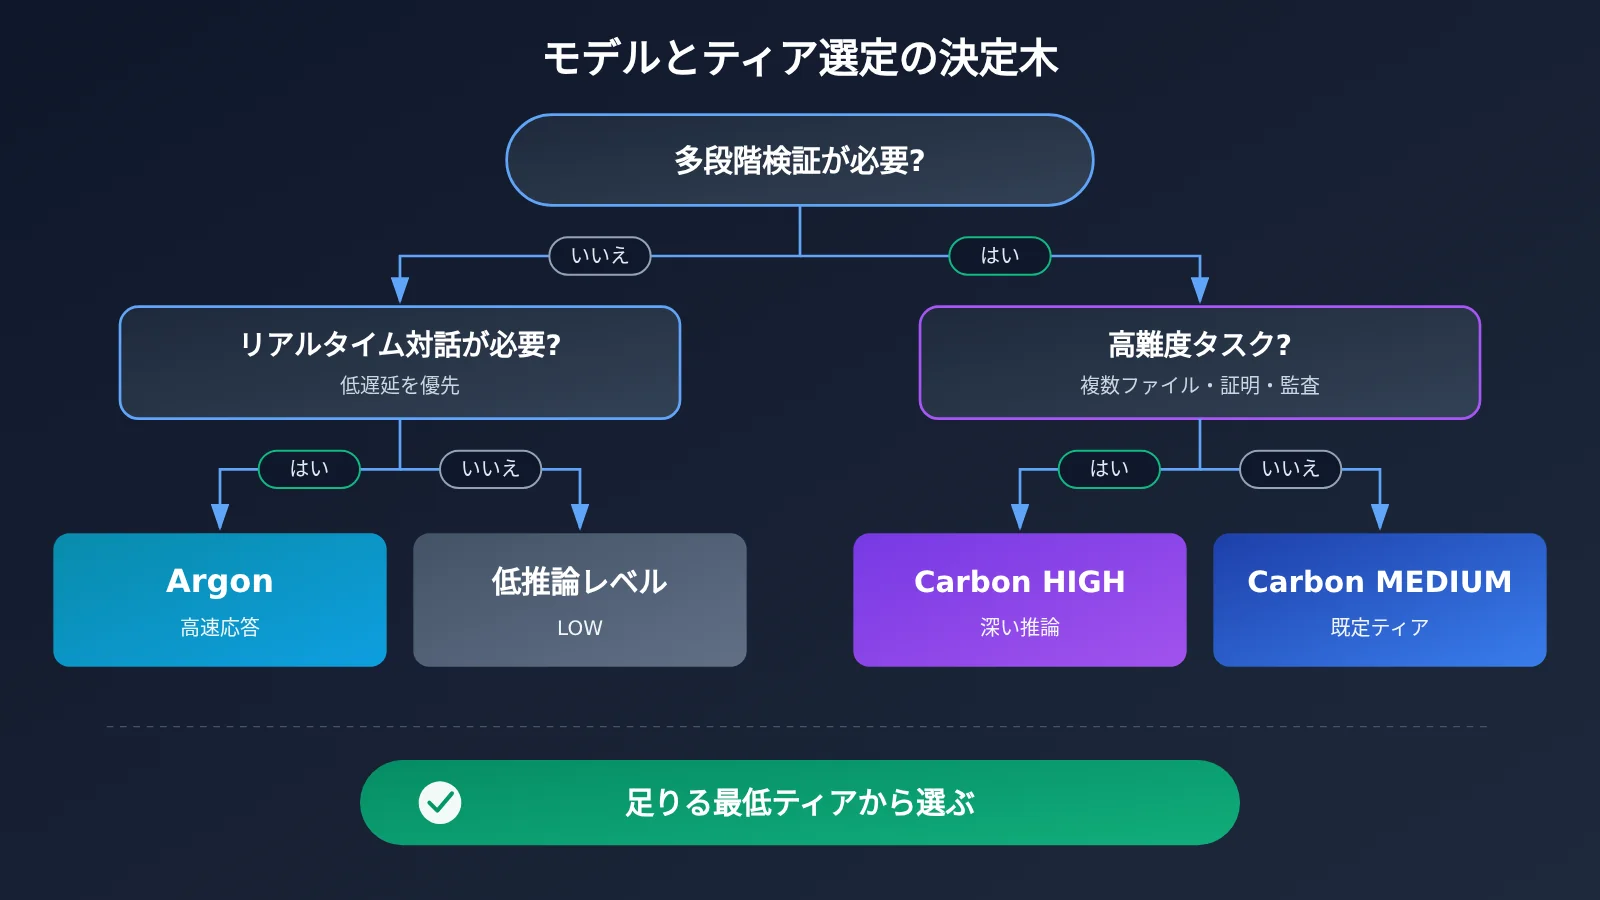
Google公式の位置づけと前述のデータを踏まえると、タスクの難易度に応じて使い分けられます。基本の考え方は、まず「そのタスクにより深い推論をかける価値があるか」を考え、そのうえでモデルと推論レベルを決めることです。
| タスクの種類 | 推奨モデル | 推奨レベル | 理由 |
|---|---|---|---|
| 日常的な機能開発、通常のコード修正 | Argon | デフォルトまたはMEDIUM | 応答が速く、1ターンあたりのコストが低いため、頻繁なやり取りに向いている |
| インタラクティブなプログラミング、IDEでのリアルタイム支援 | Argon | MEDIUM | 最初の応答までの遅延が明らかに短い |
| 複数ファイルにまたがる複雑な開発、アーキテクチャ設計 | Carbon | HIGH | FrontierCode、Terminal-Benchで差がはっきり出ている |
| サブシステムをまたぐ根本原因の詳細調査 | Carbon | MEDIUM / HIGH | 複数の仮説の探索と繰り返しの検証が必要 |
| 難度の高い科学的推論、形式的証明 | Carbon | HIGH | 公式が形式的証明をHIGHの用途として挙げている |
| セキュリティ監査、脆弱性の発見 | Carbon | HIGH | 公式の位置づけとして、複雑な監査により適している |
| 単純な分類、要約、メタデータ抽出 | 低推論レベル | LOW | コストを重視するタスクで、深い推論は不要 |
Gemini 4 Argonを選ぶ場面
- 頻繁にやり取りする開発作業:単一の関数を書く、スタイルを直す、テストを補う、といった作業では、37秒待つか68秒待つかで体感がまったく違います。
- 一般的なナレッジワークと自動化ワークフロー:AutomationBench-AAでは両者がほぼ互角なので、差額にお金をかける必要はありません。
- 科学分野のナレッジワーク:MKAの評価ではArgonが科学分野でリードしているため、まずArgonから試すのがおすすめです。
Gemini 4 Carbonを選ぶ場面
- バックグラウンドで動かす長時間のエージェントタスク:最初の応答までの遅延は気にならず、一発で正しく仕上げることのほうが重要な場合です。
- 複雑な開発とアーキテクチャ上の意思決定:複数ファイルにわたる移行、システムのリファクタリング、複雑なコード監査などが該当します。
- 結果の検証可能性が強く求められるタスク:科学的推論、セキュリティ監査、自己チェックが必要な分析レポートなどです。
コミュニティの初期のフィードバックも、この使い分けを裏づけています。Hacker NewsやRedditでは、Carbonは他のモデルが見落とした問題を見つけられるという声がある一方、最初の回答までの待ち時間が長い、クォータの消費が早いといった不満も出ています。あるRedditユーザーは、GoプロジェクトでCarbon Mediumを使い、230ファイルにまたがるライブラリを移行して、初回の実行で成功させたそうです。ただし、投稿者自身も、サンプルは4つのフェーズのみで対照実験でもないと述べているため、あくまで参考事例として見ておくのがよいでしょう。
Thinking Level で Gemini 4 Carbon の品質・速度・コストをコントロールする方法
Carbon には LOW、MEDIUM、HIGH の 3 段階の推論レベルがあります。公開モデル gemini-4-carbon のデフォルトは MEDIUM です。公式が推奨する用途の分け方は次のとおりです。
- LOW:分類、要約、メタデータ抽出
- MEDIUM:一般的なコーディング、ツール呼び出し、ドキュメントQA、動画理解
- HIGH:複数ファイルにまたがるソフトウェアエンジニアリング、アーキテクチャ設計、形式的証明、脆弱性の発見
デフォルトが MEDIUM なのには理由があります。AA v5.0.1 では、Carbon Medium の総合スコアは 58 で、High よりわずか 2 ポイント低いだけです。それでいてタスクあたりのコストは最も低く、最初の回答が返るまでのレイテンシは High の約 3 分の 1 です。また、AA-Omniscience の事実信頼性テストでは、Medium が誤った答えをでっち上げた割合は 4.2% で、High の 11.4% や Low の 20.0% を下回っています(これは特定のテストにおける指標であり、一般的なハルシネーション率ではありません)。Google も、開発者にさまざまなレベルを試すよう勧めており、無条件で HIGH を使うのではなく、品質要件を満たす最も低いレベルを選ぶことを推奨しています。
呼び出しの際には、Carbon の技術的な制約にもいくつか注意が必要です。
thinking_budgetはサポートされておらず、使用すると HTTP 400 が返ります。- MINIMAL レベルはサポートされていません。
temperature、top_p、top_kは無視されます。- 明示的な Context Caching はサポートされていませんが、共通のプロンプト接頭辞が 4096 トークン以上になると、自動の暗黙的キャッシュが適用される場合があります。
最小構成のサンプル
OpenAI互換インターフェースで Gemini 4 Carbon を呼び出す例です。10行ほどのコードで動かせます。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の統一インターフェース
)

response = client.chat.completions.create(
    model="gemini-4-carbon",  # モデルIDはプラットフォームのモデル一覧を参照してください
    messages=[{"role": "user", "content": "分析这段服务超时日志的可能根因"}]
)
print(response.choices[0].message.content)
完全な実装コードを見る:タスクの難易度に応じて Argon と Carbon を切り替える
import time
import openai
from typing import Literal

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# モデル名はあくまで例です。プラットフォームのモデル一覧にある実際のIDを使用してください
ARGON_MODEL = "gemini-4-argon"
CARBON_MODEL = "gemini-4-carbon"

Difficulty = Literal["simple", "daily", "complex", "extreme"]

def route(difficulty: Difficulty) -> tuple[str, str]:
    """タスクの難易度に応じて (モデル, 推論レベル) を返す"""
    if difficulty == "simple":
        return CARBON_MODEL, "low"      # 分類、要約、メタデータ抽出
    if difficulty == "daily":
        return ARGON_MODEL, "medium"    # 日常的な開発、頻繁なやり取り
    if difficulty == "complex":
        return CARBON_MODEL, "medium"   # 根本原因の調査、通常のAgentタスク
    return CARBON_MODEL, "high"         # 複数ファイルにまたがる開発、証明、セキュリティ監査

def run_task(prompt: str, difficulty: Difficulty) -> dict:
    model, effort = route(difficulty)
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        # 推論レベルのパラメータの対応方法は、プラットフォームのドキュメントを参照してください。
        # Carbon は thinking_budget に対応しておらず、指定すると 400 エラーになります
        reasoning_effort=effort,
    )
    usage = resp.usage
    return {
        "model": model,
        "effort": effort,
        "seconds": round(time.time() - start, 1),
        "prompt_tokens": usage.prompt_tokens,
        "completion_tokens": usage.completion_tokens,  # 思考トークンを含む
        "answer": resp.choices[0].message.content,
    }

if __name__ == "__main__":
    result = run_task("为订单服务设计分库分表迁移方案,并列出验证步骤", "extreme")
    print(result["model"], result["effort"], result["seconds"], "s")
    print("输出 Token:", result["completion_tokens"])
🚀 はじめるためのヒント:まず APIYI(apiyi.com)に登録して、無料のテスト枠を受け取りましょう。上のルーティング関数を使い、同じ実際のタスクを Argon と Carbon の各レベルで実行して、所要時間と
completion_tokensを記録してみてください。APIキーが1つあれば比較検証がすべて完結し、複数のSDKを個別に導入する必要もありません。
Gemini 4 Argon と Carbon の選び方
ひとつだけルールを覚えるなら、デフォルトは Argon、じっくり考える価値のあるタスクだけ Carbon にアップグレード、これが基本です。具体的には次の3ステップで進めます。
- 振り分けルールを作る:前述のシナリオ表を参考に、タスクを「簡単」「日常」「複雑」「超難関」の4種類に分けます。日常タスクはデフォルトで Argon に回します。
- 小規模サンプルで比較する:各カテゴリから実際のタスクを 10〜20 件選び、Argon と Carbon の各設定で合格率、合計トークン数、合計所要時間を比べます。
- タスクのコストに合わせて設定を決める:品質ラインを満たせる最も低い設定を選びます。モデルや価格、ランキングは更新される可能性があるため、定期的に再テストしましょう。
マルチエージェントシステムでは、Google の /swarm の考え方も参考になります。Carbon に計画・調整・レビューを任せ、Argon やより軽量なモデルにバッチ処理を担当させる方法です。こうすれば Carbon の深い推論力を活かしつつ、すべての工程でそのレイテンシを負担せずに済みます。
💡 選び方のヒント:2つのモデルはトークン単価が同じなので、本当に差が出るのはタスクの構成です。APIYI(apiyi.com)では OpenAI 互換インターフェースで Argon と Carbon を同時に利用できます。コード側でルーティングを切り替える形にしておけば、あとから方針を変えても業務コードを修正する必要はありません。
よくある質問 FAQ
Q1:Gemini 4 Argon と Carbon はどのような関係ですか?
Google DeepMind のモデルカードによると、Gemini 4 Carbon は Gemini 4 Argon をベースに構築されています。どちらも Gemini 4 の推論モデルシリーズに属し、1M トークンのコンテキストウィンドウと組み込みツール機能を共有しています。Carbon は 1 ターンあたりにより多くの思考トークンを使い、探索と検証を行います。一方の Argon は、応答速度と 1 ターンの効率を重視しています。なお、Google は両者のパラメータ数やアーキテクチャの違いを公開していません。
Q2:Carbon は Argon を完全に置き換えるのでしょうか?
いいえ、置き換えません。Google は、エンジニアリングやナレッジワークの大半のタスクでは Argon が引き続き最適だと明言しており、Carbon はより難度が高く、より長期にわたるタスク向けとしています。AutomationBench-AA ではほぼ互角であり、MKA では Argon が科学分野でリードしています。こうしたデータを見ても、Argon は多くの場面で十分に競争力があります。
Q3:2 つのモデルの価格は同じですか? 価格改定はいつですか?
Google の開発者ドキュメントによると、どちらも同じトークン単価です。ローンチ価格は入力/出力 100 万トークンあたり 2/10 ドルで、2026 年 11 月 30 日まで有効です。12 月 1 日からは 4/20 ドルに改定されます。思考トークンは出力料金に含まれるため、単価が同じでもタスクあたりのコストが同じになるとは限りません。
Q4:Carbon は最初の回答が遅いようですが、チャットアプリには向いていますか?
リアルタイム性が求められる場面にはあまり向いていません。AA v5.0.1 では、最初の回答トークンまでのレイテンシは Carbon High で約 68 秒、Argon High で約 37 秒、Carbon Low で約 12 秒でした。リアルタイムのやり取りには Argon をおすすめします。Carbon は、バックグラウンドでの複雑な分析や、長期にわたる Agent タスクに向いています。
Q5:API で Argon と Carbon を手軽に比較するにはどうすればよいですか?
複数のモデルに対応した API 集約プラットフォームの利用がおすすめです。
1. APIYI(apiyi.com)にアクセスしてアカウントを登録し、APIキーと無料のテスト枠を取得します。
2. コード内の base_url を `https://api.apiyi.com/v1` に設定します。
3. `model` パラメータを変更するだけで 2 つのモデルを切り替えられます。さらに推論レベルを組み合わせれば、条件をそろえた比較もできます。
Q6:Google AI Ultra を契約していなくても Carbon を使えますか?
使えます。Ultra の契約で決まるのは、コンシューマー向け(Gemini アプリなど)で Carbon を直接選択できるかどうかです。AI Pro で主に利用できるのは Argon です。開発者は Gemini API の有料プランから Carbon を呼び出せるため、Ultra を購入する必要はありません。ただし、Google 公式の Carbon API には無料枠がない点にご注意ください。
Q7:Carbon には既知の制限がありますか?
モデルカードでは、次の点が明らかにされています。ハルシネーションが発生する可能性があること、高い推論レベルでは大量のトークンを消費する場合があること、応答が遅くなったりタイムアウトしたりする可能性があること、知識のカットオフが 2026 年 3 月であること、そして Prompt Injection への防御にはまだ改善の余地があることです。加えて、`thinking_budget` はサポートされておらず、サンプリングパラメータは無視されます。以前のコードを移行する際は、確認が必要です。
Gemini 4 Argon と Carbon の重要ポイント Key Takeaways
- 位置づけ:Carbon は Argon をベースに構築されており、両者は役割分担で補い合う関係です。上位モデルと下位モデルという置き換え関係ではありません。
- 主な違い:Carbon は1ターンあたりの思考量が多く、検証も丁寧です。一方 Argon はレスポンスが速く、1ターンあたりのコストを抑えられます。
- ベンチマーク:AA v5.0.1 の High 設定では、Carbon の総合スコアは 60 点、Argon は 50 点でした。
- コストの実態:単価は同じです。AA のタスクでは、Carbon High のほうが Argon High よりも1タスクあたりのコストが低くなりました。
- レベルの選び方:Carbon のデフォルトは MEDIUM です。「足りる範囲で最も低いレベル」を基準に、LOW / MEDIUM / HIGH から選びます。
- 始め方:APIYI(apiyi.com)を使えば、OpenAI 互換のコード1セットで2つのモデルを同時にテストできます。
まとめ
Gemini 4 の Argon と Carbon の違いは、次の3点に整理できます。
- 推論にかける量が違う:Argon は効率を担当し、Carbon はより多くの思考トークンを使って、複雑な推論の限界に挑みます。
- レイテンシとコストは分けて考える:Carbon は最初のレスポンスが遅めですが、特定の評価ではタスク全体のコストが低くなることがあります。
- 選択の基準はタスクの難易度:日常的なエンジニアリング作業は Argon を優先し、複雑なエンジニアリング、科学的推論、セキュリティ監査には Carbon を使いましょう。
すべてのリクエストを最高の推論レベルで処理するのは避けましょう。まず実際のタスクで、作業の種類ごとに「足りるレベル」を測定することが、品質・速度・コストをコントロールするカギです。2つのモデルが自社の業務でどの程度の性能を発揮するかは、APIYI(apiyi.com)で手軽に検証できます。このプラットフォームは従量課金制で、複数のモデルを統一インターフェースで利用できます。
📚 参考資料
- Gemini 4 Carbon Model Card:Google DeepMind 公式モデルカード
- リンク:
deepmind.google/models/model-cards/gemini-4-carbon -
内容:Carbon が Argon をベースに構築されている点、コンテキストの仕様、公式評価、既知の制限事項
-
Choosing between Carbon and Argon:Google AI Studio 開発者ドキュメント
- リンク:
aistudio.google.com/docs/whats-new-gemini-4-carbon -
内容:2つのモデルの公式な位置づけの違いと、Thinking Level の選び方のポイント
-
Gemini 4 Carbon Developer Guide:Google Cloud 開発者ガイド
- リンク:
docs.cloud.google.cn/gemini-enterprise-agent-platform/models/guides/gemini-4-carbon -
内容:推論レベル、API パラメータの制限、長いデコードに関する説明
-
Gemini API 料金:Google AI for Developers
- リンク:
ai.google.dev/gemini-api/docs/pricing -
内容:ローンチ時の価格、12月の価格改定、キャッシュおよび思考トークンの課金ルール
-
Gemini 4 Carbon vs Gemini 4 Argon:Artificial Analysis 比較ページ
- リンク:
artificialanalysis.ai/zh/models/comparisons/gemini-4-carbon-vs-gemini-4-argon -
内容:AA Index v5.0.1 の High 設定における、性能・コスト・レイテンシの比較
-
MKA マルチモーダル知識労働評価:Artificial Analysis
- リンク:
artificialanalysis.ai/zh/evaluations/mka - 内容:業種別のトップモデルとタスクごとのコストデータ
著者:APIYI 技術チーム
技術交流:APIYI のサイトトップページからお気軽にお問い合わせください。そのほかのモデル接続に関する資料は、ドキュメントセンター docs.apiyi.com でご覧いただけます