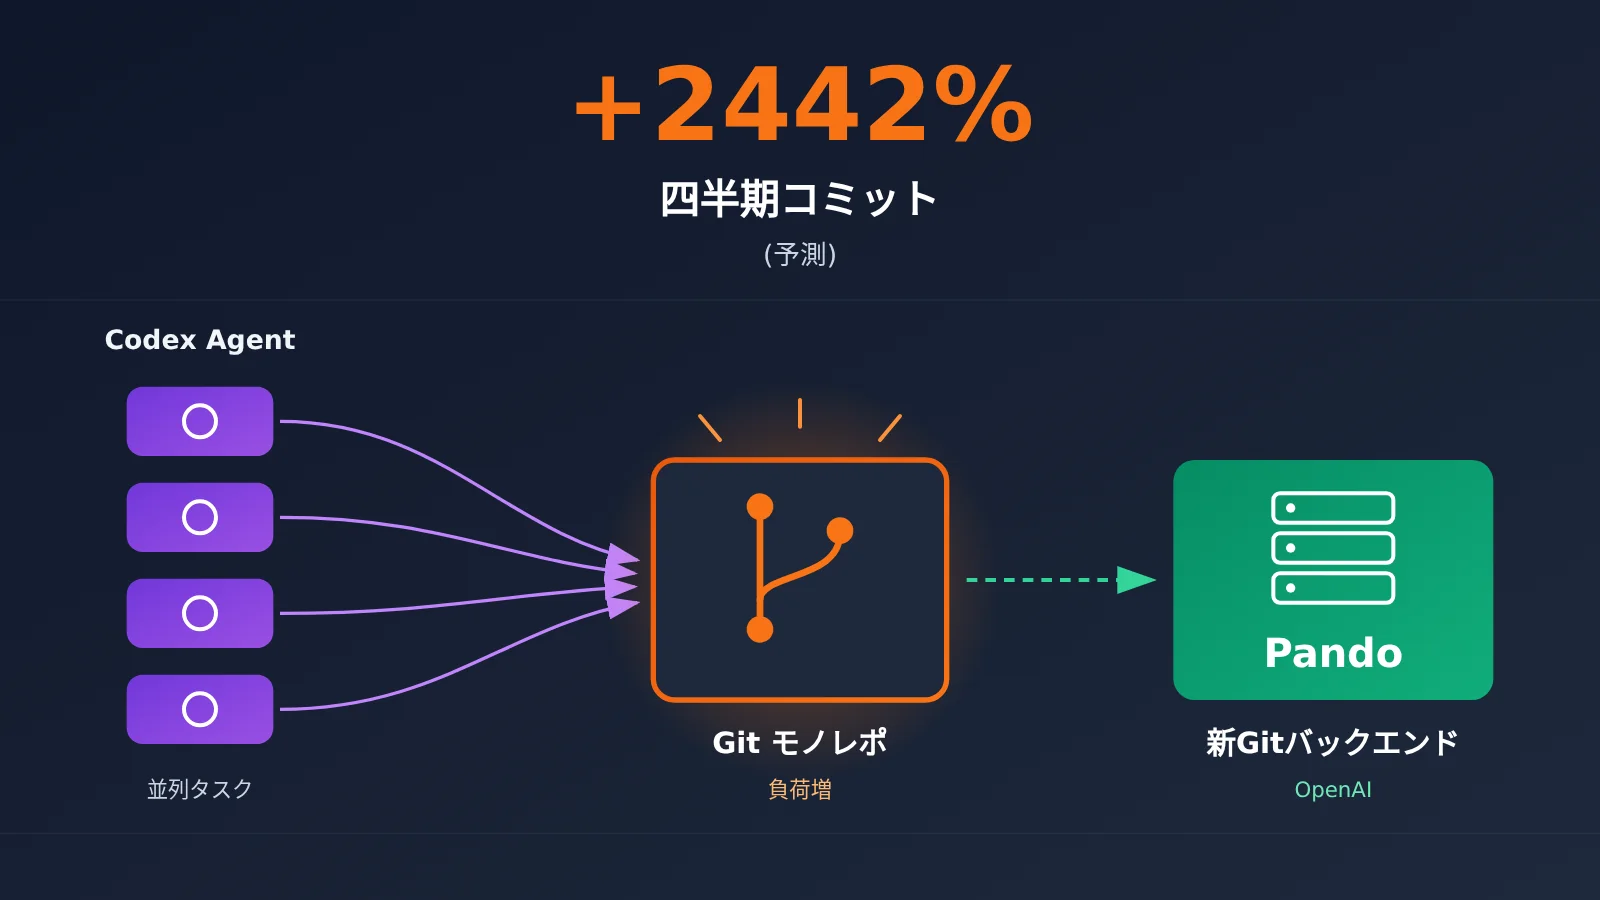
著者注:OpenAI が新しい Git バックエンド「Pando」を公開しました。Codex の利用拡大により、モノレポの四半期あたりのコミット数は、2024年第1四半期と比べて2442%増加すると予測されています。この記事では、AI コーディングの影響がコード生成から Git、CI、コードレビューへとどのように広がっているのかを整理します。
2026年11月2日、OpenAI は技術記事《Scaling Git at OpenAI》を公開しました。記事中のグラフによると、OpenAI のモノレポにおける2026年第4四半期のコミット数は、2024年第1四半期と比べて2442%増加すると予測されています。Codex による並行開発の負荷に対応するため、OpenAI は Git バックエンドを再構築し、「Pando」と名付けました。
これはうわさ話でも、「AI でコード量が24倍に急増した」という宣伝文句でもありません。 これらのデータは OpenAI の公式エンジニアリングブログに掲載されたもので、記事の著者は Aaron Friel、Taylor Blau、Ted Nyman の3人です。まず、2点を押さえておきましょう。2442%は予測値であり、第4四半期はまだ終わっていません。また、集計対象は master ブランチにマージされたコミット数であり、コードの行数でも、生産性でもありません。
この記事でわかること:Codex が「並行タスク」によって OpenAI のソフトウェア開発の規模をどう変えたのか、なぜ Git インフラに負荷がかかっているのか、そしてソフトウェア開発のボトルネックがどこに移りつつあるのかを解説します。
Codex と OpenAI の Git インフラ:主要情報のまとめ
まずは、ニュースの事実関係を表で整理します。以下はすべて OpenAI が公式に公表した情報で、未公開の情報はその旨を明記しています。
| 項目 | 詳細 |
|---|---|
| 公開日 | 2026 年 11 月 2 日、「Scaling Git at OpenAI」 |
| 発表者 | OpenAI のエンジニアリングチーム(Aaron Friel、Taylor Blau、Ted Nyman) |
| 主な内容 | 新しい Git サーバーバックエンド「Pando」。標準の Git プロトコルとクライアントに対応 |
| 直接の背景 | Codex によって開発の並列度が高まり、従来の Git システムで性能と信頼性の問題が発生 |
| 本番稼働 | 2026 年 4 月から本番トラフィックの処理を開始。着手から稼働開始まで約 10 週間 |
| 主な効果 | Push レイテンシーの中央値が約 80% 低下。1 日あたり約 1 PB の Git データを配信 |
| 外部公開の状況 | OpenAI 内部でのみ使用。サーバーの公開、料金、提供開始日は未発表 |
Codex が後押しした四半期ごとの Commit 増加の全体像
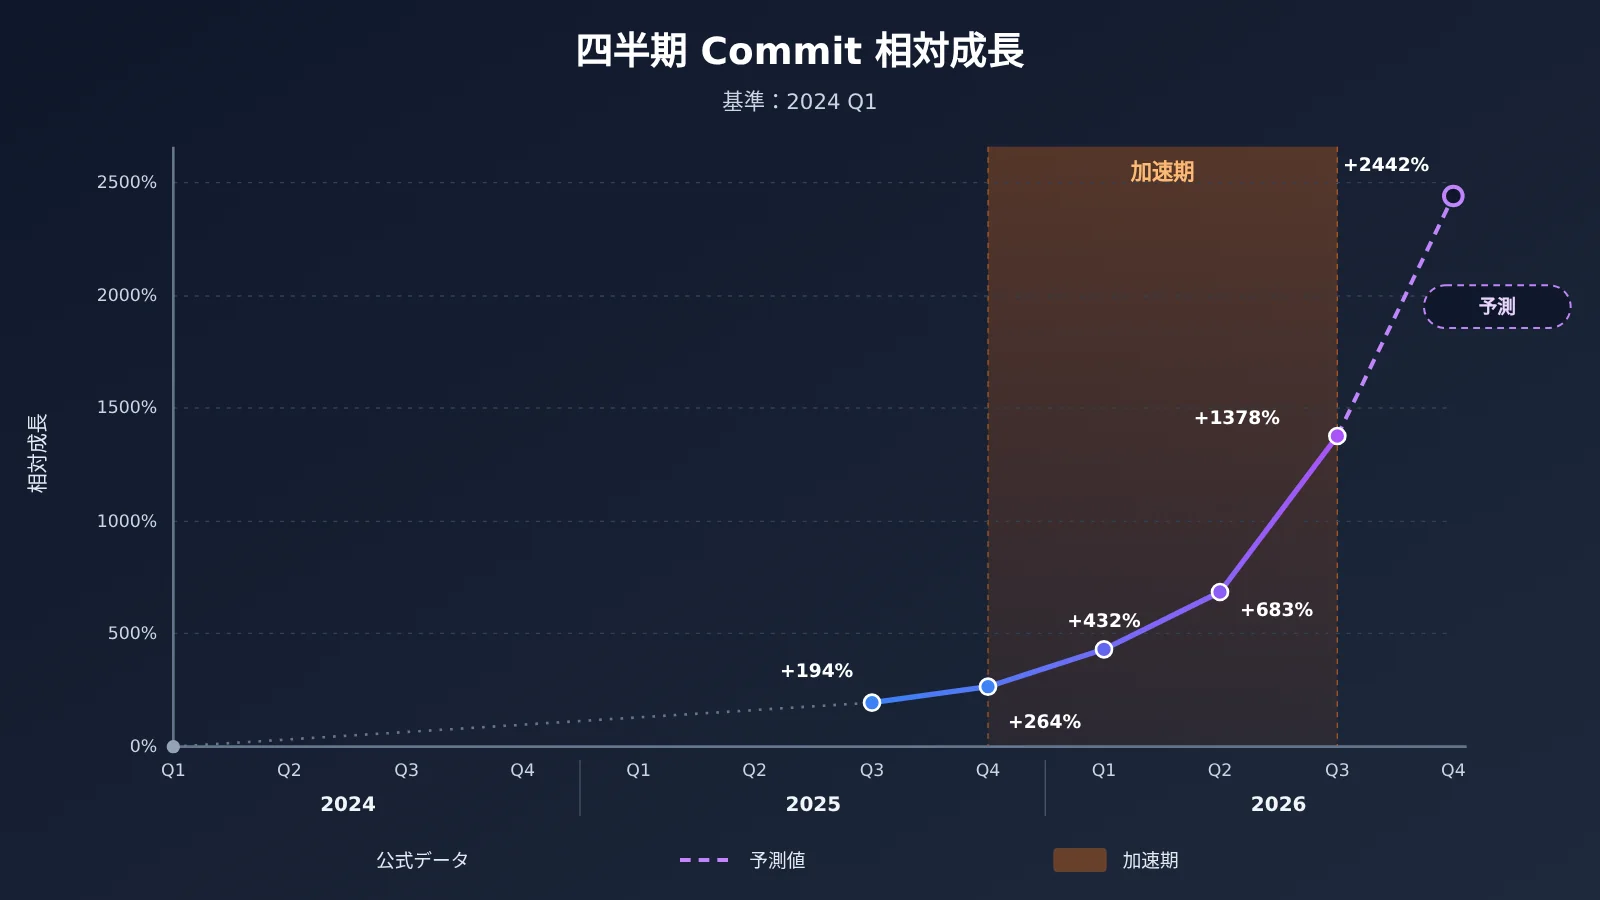
多くの報道では 2442% という数字だけが引用されていますが、四半期ごとの推移を追うと、より全体像が見えてきます。以下の表は、2024 Q1 を基準として、OpenAI のモノリポの master ブランチにマージされた四半期ごとの Commit 数を示したものです。
| 四半期 | 2024 Q1 比の増加率 | 基準期の約何倍か |
|---|---|---|
| 2024 Q2 | +35% | 1.35 |
| 2024 Q4 | +98% | 1.98 |
| 2025 Q2 | +194% | 2.94 |
| 2025 Q4 | +264% | 3.64 |
| 2026 Q1 | +432% | 5.32 |
| 2026 Q2 | +683% | 7.83 |
| 2026 Q3 | +1,378% | 14.78 |
| 2026 Q4 | +2,442%(予測) | 25.42 |
このデータからは、3 つのことが読み取れます。第一に、2024 年から 2025 年にかけても増加しているため、すべての増加を Codex に帰することはできません。第二に、2025 Q4 の +264% から 2026 Q3 の +1,378% にかけて増加が明らかに加速しており、OpenAI が説明するエージェントによる並列開発の傾向と一致しています。第三に、公式が公表したのは相対的な増加率のみで、各四半期の Commit 数の実数は公表されていません。
集計基準の異なる別のデータも、同じ方向を示しています。2026 年 7 月 20 日、OpenAI の開発者ブログは Codex Code Review を紹介する中で、社内の週間 Pull Request 数が前の第 4 四半期と比べて 2 倍以上に増えたと述べています。このデータは、四半期ごとの Commit 増加率とは集計基準も対象期間も異なるため、足し合わせたり相互に換算したりすることはできません。ただし、どちらもコード変更の活動が急速に拡大していることを示しています。
Codex はどのように Git インフラに負荷をかけるのか
「AI によってコードを書くのが速くなる」と聞くと、影響を受けるのは開発者本人だけだと思うかもしれません。しかし、OpenAI の説明は別の側面を示しています。Codex が高めるのは、エンジニアリングシステム全体で同時に実行されるタスクの数です。1 人のエンジニアが複数の Agent にそれぞれ異なる機能の開発を並行して進めさせると、各 Agent がブランチを作り、Commit や Push を行います。その操作がさらに一連の自動読み取りを引き起こします。
以下の表は、OpenAI の公式説明に基づき、この因果関係を整理したものです。
| 段階 | 何が起きるか | Git インフラへの影響 |
|---|---|---|
| A. 作業コストの低下 | エンジニアが複数の Agent に独立した機能を同時に変更させる | 開発タスクの数が増える |
| B. 並列度の上昇 | ブランチ、Commit、Git Push が増える | 書き込みリクエストとブランチ更新が増える |
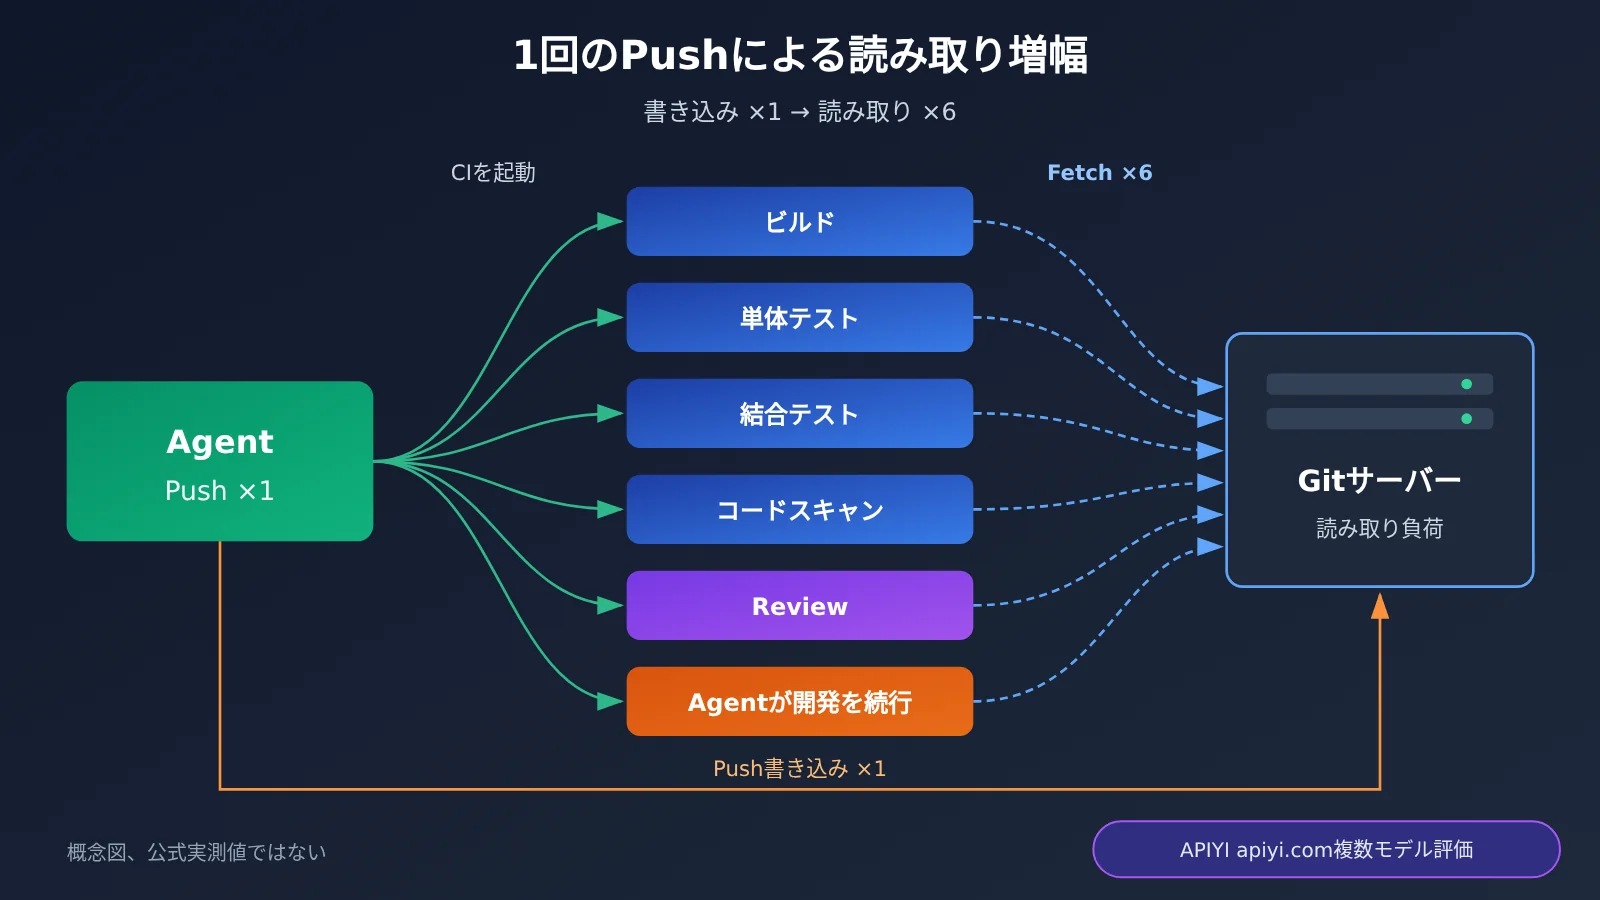
| C. パイプラインによる増幅 | 1 回の Push が複数の CI ビルド、テスト、スキャンを引き起こす | 同じコミットが繰り返し Fetch される |
| D. 共有インフラへの負荷 | マージ、ステータス同期、バージョンデータの配信が同時に増える | Push / Fetch が遅くなり、Merge が失敗する |
| E. ボトルネックの移動 | モデルがコードを書く速度は上がる一方、Git、CI、Review の処理能力はそれに追いつかない | 下流の工程がデリバリー速度を制約する |
負荷が増幅される仕組みの例
理解を助けるために、あくまでイメージとして例を挙げます。数字は OpenAI の実測値ではありません。1 回の Push が 6 つの CI ジョブを引き起こし、各ジョブがそれぞれ 1 回ずつコードを Fetch するとします。この場合、100 回の Push によって、約 600 回のコード読み取りが発生する可能性があります。Agent によって Push の回数が数倍になれば、読み取り量もそれに伴って増えます。
実際のリクエスト量は CI のキャッシュ、ジョブの再利用、ビルドアーキテクチャの影響を受けますが、増加の方向性は明らかです。書き込みの増加は、読み取り側で増幅されます。これが、Git サーバーが最初に限界を迎える要因です。OpenAI の原文でも、同じコミットが複数の CI ジョブ、研究タスク、開発環境によって繰り返し取得される可能性に言及しています。
OpenAI の旧 Git システムに何が起きたのか
OpenAI によると、2025 年末から、モノレポを支えるシステムが新たな負荷をさばくことが次第に難しくなっていました。具体的には、Git Fetch や Push の遅延、Merge の失敗などが発生し、インフラの信頼性が 90% を下回ることもありました。
ここで「90% 未満」の意味を正確に理解しておく必要があります。これは一部の期間におけるシステムの信頼性を表したもので、具体的な集計基準や全期間の時系列データは公開されていません。「コードの 10% に欠陥がある」ことを意味するわけでも、「OpenAI のコミットの 10% 以上が失敗した」と解釈できるわけでもありません。
技術的に見ると、旧アーキテクチャには 2 つの構造的なボトルネックがありました。
- ブランチの更新に全体的な調整が必要:従来の分散型 Git サービスの多くは、リポジトリ内のすべての参照について、一貫した状態を維持する必要があります。そのため、2 つの Agent がまったく関係のないブランチを変更していても、同じ調整処理に集中してしまうことがあります。
- ダウンロード用パックが繰り返し生成される:クライアントがそれぞれ保持する Git 履歴は異なるため、サーバーはクライアントごとにオブジェクトを走査し、パックを生成して圧縮する必要があることが少なくありません。複数の Agent が同じバージョンを読み込む場合でも、こうした負荷の高い処理が繰り返されます。
人間のエンジニアが主導していた時代には、この 2 つの問題は許容範囲内でした。しかし、大量の Agent と CI ジョブが同時に流れ込むようになると、システムのボトルネックになりました。
Pando は Codex による Git の負荷にどう対応したか
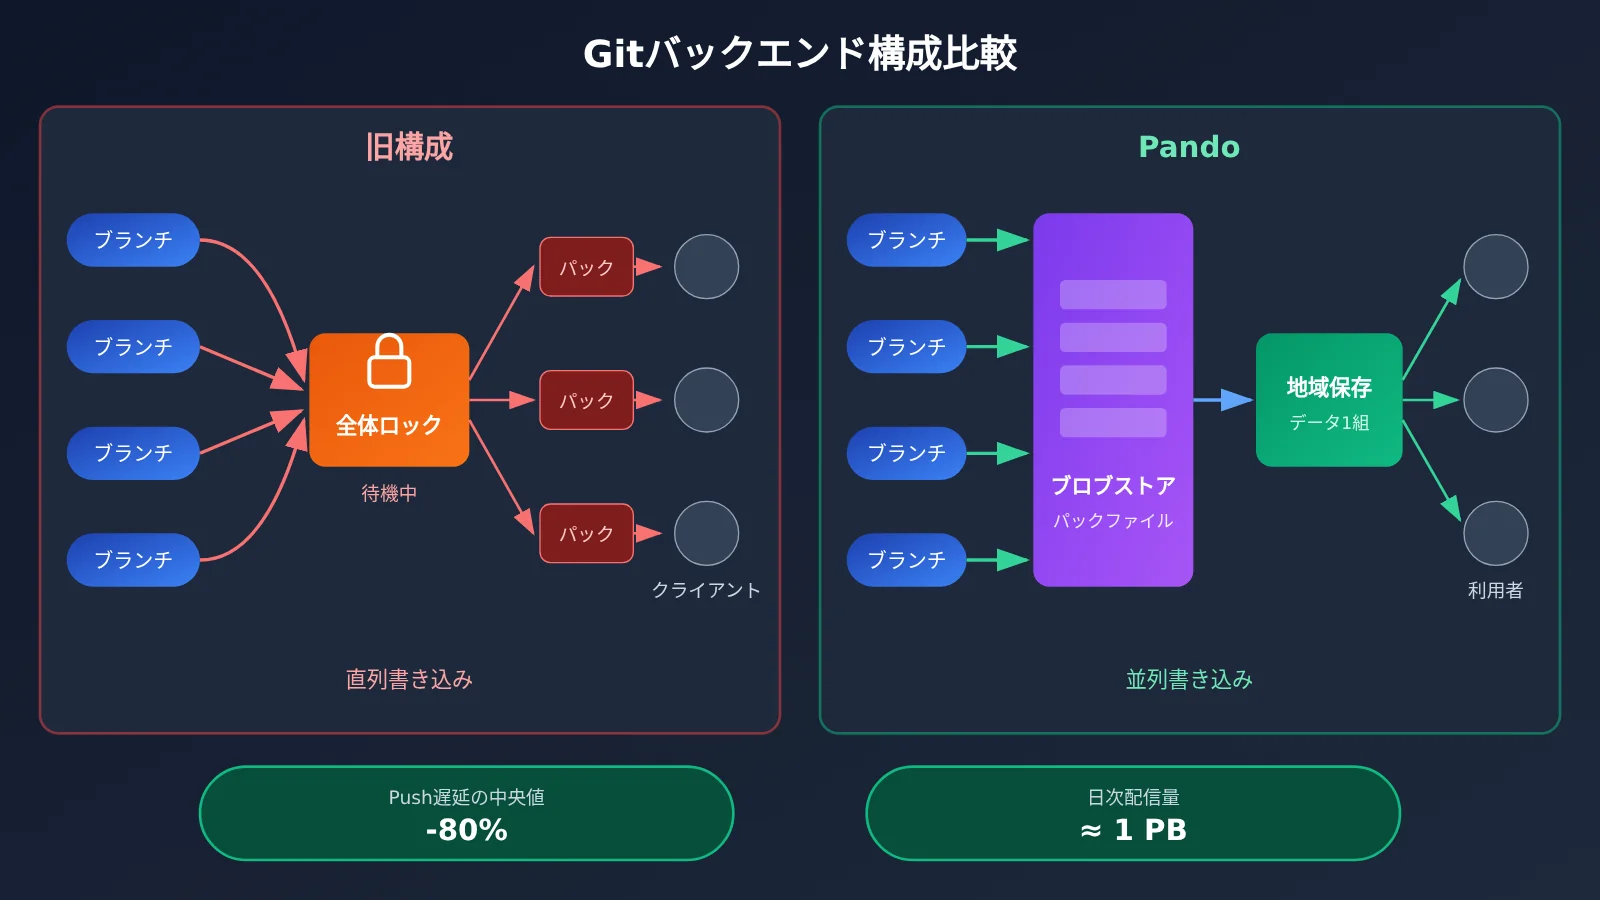
OpenAI は Git の利用をやめたわけではありません。Pando は引き続き標準の Git プロトコルとクライアントを使用しており、エンジニアが使うコマンドやワークフローも基本的に変わりません。再設計されたのは、サーバー側のストレージ、参照の更新、データの配信方法です。以下の表で、従来の方式と Pando の主な違いを比較します。
| 比較項目 | 従来の Git サーバー | Pando |
|---|---|---|
| ブランチへの書き込み | リポジトリ全体で強い調整が必要で、無関係なブランチ同士でも待ちが発生しうる | 各ブランチを独立して更新し、同じ Ref の更新時のみ調整が必要 |
| 一貫性モデル | リポジトリ全体で一貫したスナップショット | 因果的一貫性を採用し、同一ブランチでは順序と自分の書き込みの読み取りを保証 |
| 読み取りデータの配信 | クライアントの状態に応じて再パック・圧縮 | Push 時に保存した Packfile を再利用し、キャッシュ経由で配信 |
| キャッシュ | 実装に依存 | リージョン単位のキャッシュサービスを使用し、Packfile のキャッシュヒット率は 99% 超 |
| クライアントの互換性 | 標準 Git | 標準 Git に対応し、packfile-uri の仕組みを利用して配信 |
Pando の2つの基本的な考え方
1つ目は書き込みの並行処理です。Pando は、リポジトリ全体について単一時点の一貫したスナップショットを維持することをやめ、ブランチごとに独立してバージョンを管理します。異なるブランチへの Push は並行して実行でき、競合への対処が必要なのは同じ Ref を変更するリクエストだけです。その代わり、複数のブランチを一度に読み取る際、クライアントには異なる時点のブランチが見える可能性があります。OpenAI は、自社の用途にはこのトレードオフが適していると判断しています。
2つ目は読み取り時のデータ再利用です。Pando は、Push のたびに受け取る Packfile を不変データとして Blob Store に保存します。ほかのクライアントが Fetch する際は、サーバーがクライアントの保持する Commit と必要な Commit に基づいて既存の Packfile を選び、再パックせずに配信します。また、バックグラウンドで多数の小さな Packfile を階層的にまとめ、長期間更新していないクライアントが過剰な数のファイルをダウンロードせずに済むようにしています。
公式が公表した本番環境のデータによると、Push のレイテンシ中央値は約 80% 低下し、毎日 1 PB 近い Git データを配信しています。1 時間あたりの Packfile 配信量のピークは 57 TB を超えました。なお、1 PB は配信量であり、同じデータを繰り返し読み取った場合も計上されます。毎日 1 PB の新しいコードが生成されているわけではありません。
また、Pando 自体も Agent が開発に参加した成果物です。OpenAI によると、コアアーキテクチャは1人のエンジニアが設計し、複数の Agent チームが実装に参加しました。検証には Git の互換性テストスイートと決定的シミュレーションテストを活用したとしています。ただし、すべてのコードを AI が書いたとは公表していません。
AIプログラミングの影響分析:ボトルネックはコーディングから下流へ
開発者とチームへの影響
Pando の事例で本当に注目すべきなのは、OpenAI が独自の Git バックエンドを構築したことではありません。そこから見えてくるのは、AIプログラミングによってコード生成のコストが下がると、負荷は開発工程の下流へ移るという傾向です。Git は最初に課題が表面化した工程にすぎず、コードレビュー、テスト、統合にも同様に負荷がかかっています。
OpenAI は Codex Code Review に関する記事の中で、レビュー待ちの PR が増えていることを認めています。レビュアーが過去からの制約を把握し、API の互換性リスクをタイムリーに判断するのは容易ではありません。そこで Codex Code Review は、リポジトリ内の AGENTS.md に定義されたレビュールールを読み込み、既存の API 契約の保護、顧客データを漏えいするおそれのあるログの検出、既存サービスとの連携の破壊防止に役立てられるようになっています。
一般的な AI 開発チームにとっては、具体的に次のような見直しが必要です。
- レビュールールを明文化する:チーム内の暗黙の制約を AGENTS.md のようなルールファイルにまとめ、AI レビューの判断根拠にします。
- CI に余裕を持たせる:エージェントを並列実行すると、人件費より先に CI ジョブ数が増える可能性があります。キャッシュや並行実行の割り当てを事前に評価しましょう。
- 評価指標を見直す:コミット数や PR 数だけでなく、リードタイムや変更失敗率にも目を向けます。
- 成果物を検証する能力を優先する:テストカバレッジ、モックを使ったテスト、互換性テストの充実度が、エージェントの成果を安心してマージできるかどうかを左右します。
複数モデルで AI コードレビューを行う最小サンプル
自分のリポジトリで「ルールに沿って Diff をレビューする」フローを試すなら、OpenAI 互換インターフェースを使って素早くプロトタイプを作れます。以下のサンプルは、ローカルの Diff を読み込み、モデルにルールに沿ったレビューを依頼します。
import openai, subprocess

client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")
diff = subprocess.run(["git", "diff", "HEAD~1"], capture_output=True, text=True).stdout

resp = client.chat.completions.create(
    model="YOUR_MODEL",  # プラットフォームで利用可能なプログラミングモデルに置き換える
    messages=[{"role": "user", "content": f"请审查以下改动,重点关注 API 兼容性和日志泄露风险:\n{diff}"}],
)
print(resp.choices[0].message.content)
完全な実装コードを見る(AGENTS.md のルール読み込み+複数モデルの比較)
import subprocess
from pathlib import Path
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # 1つのキーで複数社のモデルを呼び出す
)

def load_rules(path: str = "AGENTS.md") -> str:
    """リポジトリ内のレビュールールを読み込み、存在しない場合はデフォルトのルールを返す"""
    p = Path(path)
    if p.exists():
        return p.read_text(encoding="utf-8")
    return "1. 不得破坏已有 API 契约\n2. 日志中不得输出客户数据\n3. 不得破坏已有服务集成"

def get_diff(base: str = "HEAD~1") -> str:
    """レビュー対象の Diff を取得する"""
    return subprocess.run(
        ["git", "diff", base], capture_output=True, text=True
    ).stdout

def review(diff: str, rules: str, model: str) -> str:
    """ルールに沿ってコードの変更をレビューするようモデルに依頼する"""
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": f"你是严格的代码审查者,请依据以下仓库规则审查:\n{rules}"},
            {"role": "user", "content": f"待审查 Diff:\n{diff}\n请逐条列出风险点和修改建议。"},
        ],
        max_tokens=1500,
    )
    return resp.choices[0].message.content

if __name__ == "__main__":
    rules, diff = load_rules(), get_diff()
    # 比較したいモデル名に置き換え、モデルごとのレビューの違いを確認する
    for model in ["MODEL_A", "MODEL_B"]:
        print(f"===== {model} =====")
        print(review(diff, rules, model))
🚀 すぐに試すためのヒント:AI Review のプロトタイプを構築する際は、APIYI apiyi.com で無料テスト枠を取得できます。同じ APIキーで OpenAI、Claude、Gemini などのモデルを呼び出せるため、リポジトリのルールに照らした各モデルのレビュー品質を比較するのに便利です。
業界への影響
The New Stack は報道の中で、OpenAI は Agent Coding を早い段階から集中的に活用しており、同社が直面したインフラへの負荷は、他の大企業やコードホスティングプラットフォームが将来直面する問題の予兆かもしれないと指摘しています。これはメディアによるトレンドの見立てであり、GitHub や GitLab ですでに同様の障害が発生していることを示すものではありません。
開発者コミュニティの見方も分かれています。楽観的な人は、コーディングコストの低下によって、これまで採算が合わなかった小規模なプロジェクトにも取り組めるようになると考えています。一方、懐疑的な人は、Commit が増えてもソフトウェアの価値が高まるとは限らず、レビューやテストが追いつかなければ、全体としてのデリバリーが速くなるとは限らないと指摘しています。また、大規模な Monorepo のスケールに関する問題は、AI 時代になって初めて生じたものではないという意見もあります。
Codex のデータを読み解く:混同してはいけない5つの指標
AI プログラミングの効果を論じる際に最もよくある間違いは、異なる指標を混同することです。以下の表は、それぞれのデータから何が分かり、何が分からないのかを判断するためのものです。
| 指標 | 何を測るか | 今回のニュースでの状況 |
|---|---|---|
| Commit 数 | バージョンのコミット頻度 | 四半期の増加率は +2,442% と予測されており、相対値のみ |
| PR 数 | 変更提案とマージの活動 | 週あたりの PR 数は、それ以前の Q4 と比べて2倍以上に増加 |
| コード行数 | コードの規模 | 非公開。Commit の増加から推算することはできない |
| Lead Time | 変更開始からデリバリーまでの時間 | 非公開 |
| 変更失敗率 | リリース後に障害を引き起こした変更の割合 | 非公開 |
Pando の事例が示しているのは、OpenAI のコード開発に伴う負荷が大幅に増加し、従来の Git インフラにボトルネックが生じたということです。ソフトウェアの品質や開発者の生産性が同じ倍率で向上したことを示すものではなく、Codex が何人のエンジニアを代替したかを推定することもできません。
なお、OpenAI が2026年2月に発表した Harness Engineering は、これとは別の独立した実験です。空のリポジトリから始め、約5か月で100万行規模のプロジェクトを完成させ、PR の累計は約1,500件に達しました。これは Pando とは無関係の別プロジェクトのデータですが、同じくある傾向を反映しています。エンジニアの仕事の重点が、アーキテクチャ、ツールチェーン、フィードバックループ、コードの受け入れ確認へと移りつつあるということです。
💡 選定のヒント:チームで Coding Agent の導入を進めているなら、まずは小規模な範囲で、モデルごとのコード生成とレビューの性能を比較してみましょう。APIYI apiyi.com の統一インターフェースを使えば、モデルを素早く切り替え、同じテストケースで横断的に評価したうえで、メインとなるモデルを選べます。
よくある質問 FAQ
Q1:Codex によって OpenAI のコード量は本当に24倍になったのですか?
そういう意味ではありません。公式データは「master にマージされた四半期あたりの Commit 数が、2024年 Q1 と比べて2442%増加すると予測される」というものです。これは予測値であり、集計対象はコード行数ではなく Commit 数です。Commit 1件あたりの変更規模はさまざまなので、この数値はコード量を示すものでも、生産性を示すものでもありません。
Q2:Pando は GitHub の代替サービスですか?
いいえ。Pando は標準の Git プロトコルに対応したサーバー側のバックエンドで、OpenAI 内部でのみ使用されています。2026年11月3日時点で、サーバー側の実装、料金、公開予定日は公表されていません。OpenAI が公開したのは改良版 Git クライアントのリポジトリで、一部の変更は上流の Git にも貢献されていますが、Pando のサーバー側がオープンソース化されたわけではありません。
Q3:一般的なチームも OpenAI のように Git インフラを再構築する必要がありますか?
ほとんどのチームには必要ありません。OpenAI が直面しているのは、超大規模なモノレポと多数の Agent による高負荷な同時実行です。中小規模のチームでは、CI の利用枠、テストカバレッジ、コードレビューの人手がボトルネックになることが多いため、まずはこれらの強化を優先するとよいでしょう。
Q4:AI コードレビューや Coding Agent のワークフローを低コストで試すには?
まずは OpenAI 互換インターフェースで最小限のプロトタイプを作り、この記事のコード例に沿って Diff とルールファイルを読み込み、モデルにレビューを依頼できます。APIYI apiyi.com に登録すると無料のテスト枠を利用できます。base_url を `https://api.apiyi.com/v1` に変更すれば、同じ Key で複数のモデルのレビュー結果を比較できます。
Q5:AI プログラミングは低品質なコードを増やしているだけではありませんか?
これはコミュニティで議論されている中心的な論点で、現時点では結論が出ていません。OpenAI は欠陥率、ロールバック率、開発コストの実質的な変化を公開していないため、品質が全面的に低下したとも向上したとも言えません。自分のチームで、納品までの期間と変更の失敗率をあわせて追跡するのが堅実な方法です。APIYI apiyi.com を通じて複数のモデルを利用し、相互にレビューさせることで、単一モデルの見逃しリスクを減らすこともできます。
Codex と Git インフラの変化:要点
- 数値の意味を正確に把握:2442% は 2026 年第 4 四半期のコミット数の予測増加率であり、コード行数の増加率ではありません。
- 成長が明らかに加速:2025 年第 4 四半期以降、曲線は急勾配になっていますが、増加は 2024 年から続いていました。
- 負荷の原因は並行処理:Codex によってタスクの並列実行が増え、書き込みの増加が CI 側の読み取り負荷をさらに増幅させました。
- 旧システムは限界に:2025 年末から Push や Fetch が遅くなり、信頼性が 90% を下回ることもありました。
- Pando による解決策:ブランチごとの独立した書き込み、Packfile の再利用とキャッシュにより、Push レイテンシの中央値は約 80% 低下しました。
- ボトルネックは下流へ:コードレビュー、テスト、統合、デリバリーが新たな制約になっています。
- 始め方のヒント:APIYI apiyi.com の統一インターフェースを使えば、複数モデルによるレビューのプロトタイプを素早く構築できます。
まとめ
Codex が OpenAI にもたらした変化は、大きく次の 3 点にまとめられます。
- 規模の変化:モノリポの四半期あたりのコミット数は、2024 年第 1 四半期と比べて 2442% 増加すると予測されています。PR 数も倍増し、コードの変更が大幅に活発化しています。
- インフラの変化:エージェントの並列実行によってブランチ、Push、CI の読み取りが増え、旧 Git バックエンドで性能と信頼性の問題が発生しました。OpenAI はその対応として、約 10 週間で Pando を構築しました。
- 開発プロセスの変化:コードを書くことはもはや最も時間のかかる工程ではありません。AI コーディングを実際の価値につなげられるかは、レビュー、テスト、デリバリーの能力にかかっています。
多くのチームにとっては、コミット数を追い求めるよりも、まず受け入れ確認とレビューの体制を整え、エージェントの並列実行規模を段階的に拡大するのがよいでしょう。AI レビューやコーディングエージェントのワークフローをすぐに検証したい場合は、APIYI apiyi.com の無料枠を使って、複数のモデルの実際の性能を比較する方法もおすすめです。
📚 参考資料
- Scaling Git at OpenAI:OpenAI 公式の Pando 技術記事(2026-11-02)
- リンク:
openai.com/index/scaling-git-at-openai -
説明: 本記事のニュース情報と四半期ごとの Commit 増加データの主な出典
-
Custom Code Review rules for Codex:OpenAI 開発者ブログ(2026-07-20)
- リンク:
developers.openai.com/blog/custom-code-review-rules-for-codex -
説明: 週あたりの PR 数の倍増と AGENTS.md の審査ルールの出典
-
Harness engineering:OpenAI による独立した Agent 開発実験(2026-02-11)
- リンク:
openai.com/index/harness-engineering -
説明: エンジニアの役割の変化を理解するための独立した事例。Pando プロジェクトとは無関係
-
OpenAI Git Fork:OpenAI が管理する Git クライアントの公開リポジトリ
- リンク:
github.com/openai/git -
説明: packfile-uri などのクライアント側の改善を確認できます
-
The New Stack の報道:外部メディアによる Pando の解説(2026-11-02)
- リンク:
thenewstack.io - 説明: 業界動向を判断するための参考資料
著者:APIYI 技術チーム
技術交流:APIYI 公式サイトのトップページからお気軽にお問い合わせください。モデル接続に関する詳しい資料は docs.apiyi.com のドキュメントセンターをご覧ください。