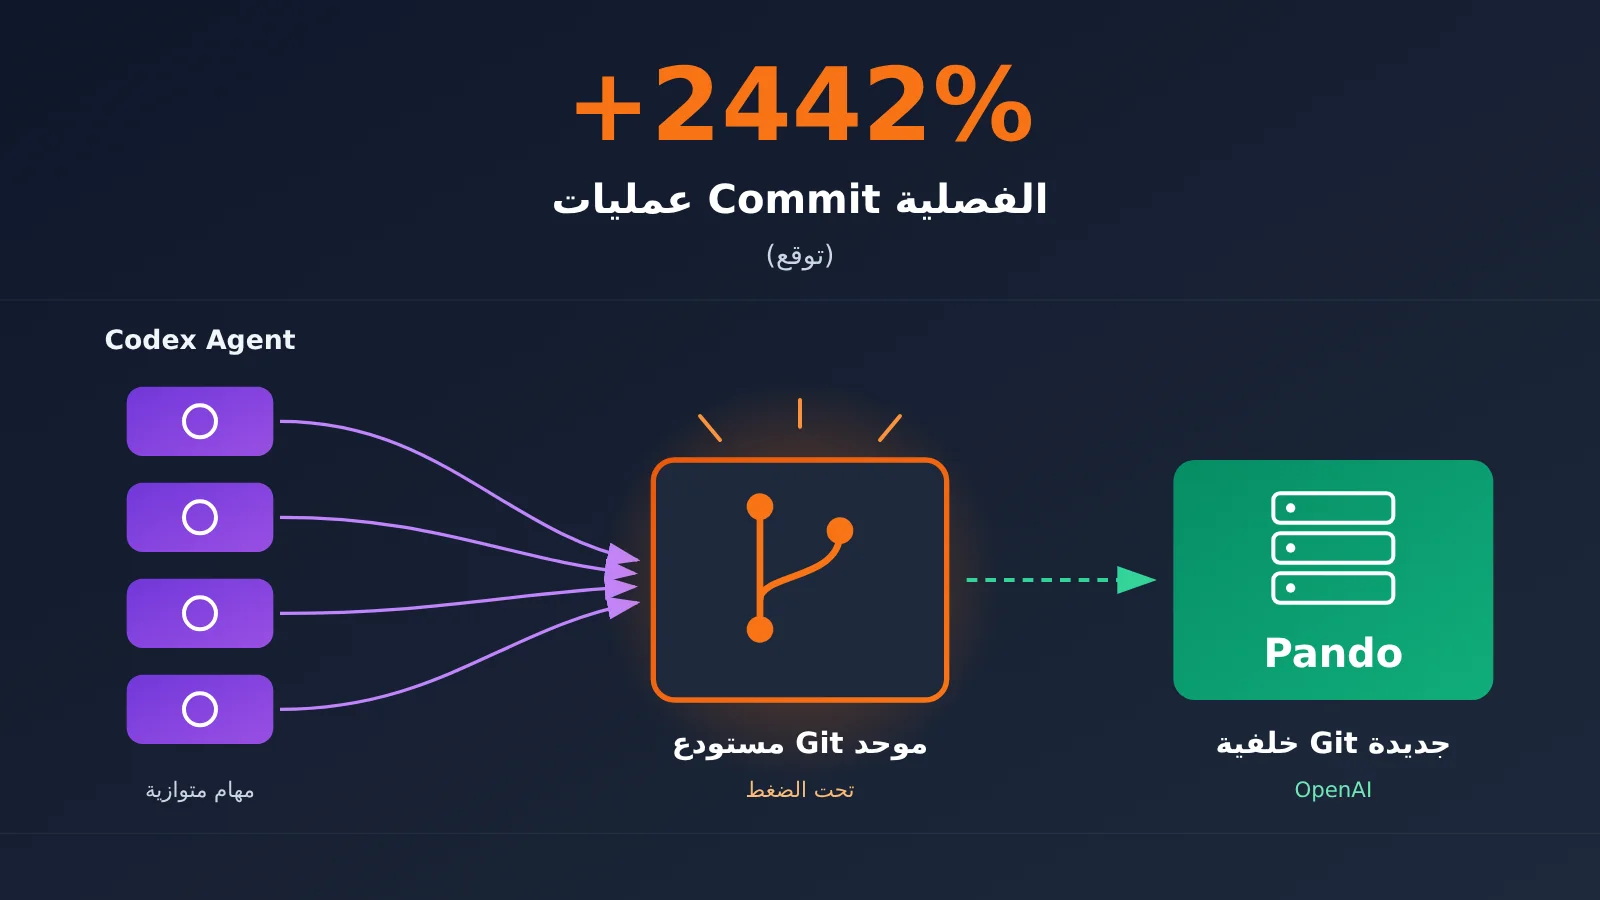
ملاحظة الكاتب: كشفت OpenAI عن Pando، وهي بنية خلفية جديدة لـ Git. ومن المتوقع أن يرتفع عدد الـ Commit الفصلية في المستودع الأحادي بنسبة 2442% مقارنة بالربع الأول من 2024، مدفوعًا باستخدام Codex. يستعرض هذا المقال كيف يمتد أثر البرمجة بالذكاء الاصطناعي من توليد الشيفرة إلى Git والتكامل المستمر (CI) ومراجعة الشيفرة.
في 2 نوفمبر 2026، نشرت OpenAI مقالًا تقنيًا بعنوان «Scaling Git at OpenAI». ويُظهر الرسم البياني في المقال أن عدد الـ Commit الفصلية في مستودع OpenAI الأحادي خلال الربع الرابع من 2026 يُتوقع أن يرتفع بنسبة 2442% مقارنة بالربع الأول من 2024. ولاستيعاب ضغط التطوير المتزامن الذي أحدثه Codex، أعادت OpenAI بناء بنية خلفية لـ Git وأطلقت عليها اسم Pando.
هذه ليست شائعة، ولا شعارًا تسويقيًا من قبيل «الذكاء الاصطناعي يضاعف حجم الشيفرة 24 مرة». تأتي هذه البيانات من مدونة OpenAI الهندسية الرسمية، وكتب المقال ثلاثة مختصين تقنيين هم Aaron Friel وTaylor Blau وTed Nyman. ومن المهم توضيح نقطتين: نسبة 2442% هي توقع، إذ لم ينتهِ الربع الرابع بعد؛ وما يُقاس هو عدد الـ Commit المدمجة في فرع master، وليس عدد أسطر الشيفرة، وبالتأكيد ليس الإنتاجية.
ما ستتعلمه: بعد قراءة هذا المقال، ستفهم كيف يغيّر Codex حجم تطوير البرمجيات في OpenAI من خلال «المهام المتوازية»، ولماذا يضع ذلك البنية التحتية لـ Git تحت الضغط، وإلى أين تنتقل الاختناقات في تطوير البرمجيات.
Codex والبنية التحتية لـ Git في OpenAI: أهم المعلومات
لنبدأ بجدول يلخص الحقائق. تستند جميع المعلومات أدناه إلى إفصاحات OpenAI الرسمية، مع الإشارة بوضوح إلى ما لم يُعلن عنه.
| البند | التفاصيل |
|---|---|
| تاريخ النشر | 2 نوفمبر 2026، في مقال «Scaling Git at OpenAI» |
| الجهة الناشرة | فريق الهندسة في OpenAI (Aaron Friel وTaylor Blau وTed Nyman) |
| المحتوى الأساسي | Pando، واجهة خلفية جديدة لخادم Git متوافقة مع بروتوكول Git القياسي وعملائه |
| الخلفية المباشرة | رفع Codex مستوى العمل المتوازي في التطوير، ما أدى إلى ظهور مشكلات في أداء نظام Git القديم وموثوقيته |
| بدء التشغيل الفعلي | بدأ استقبال حركة الإنتاج في أبريل 2026، واستغرق الانتقال من بدء المشروع إلى تشغيله نحو 10 أسابيع |
| النتائج الرئيسية | انخفض وسيط زمن استجابة Push بنحو 80%، مع تسليم ما يقارب 1 PB من بيانات Git يوميًا |
| الإتاحة الخارجية | للاستخدام الداخلي في OpenAI فقط، ولم يُعلن عن إتاحة الخادم أو التسعير أو موعد الإطلاق |
الصورة الكاملة لنمو عمليات Commit الفصلية مع استخدام Codex
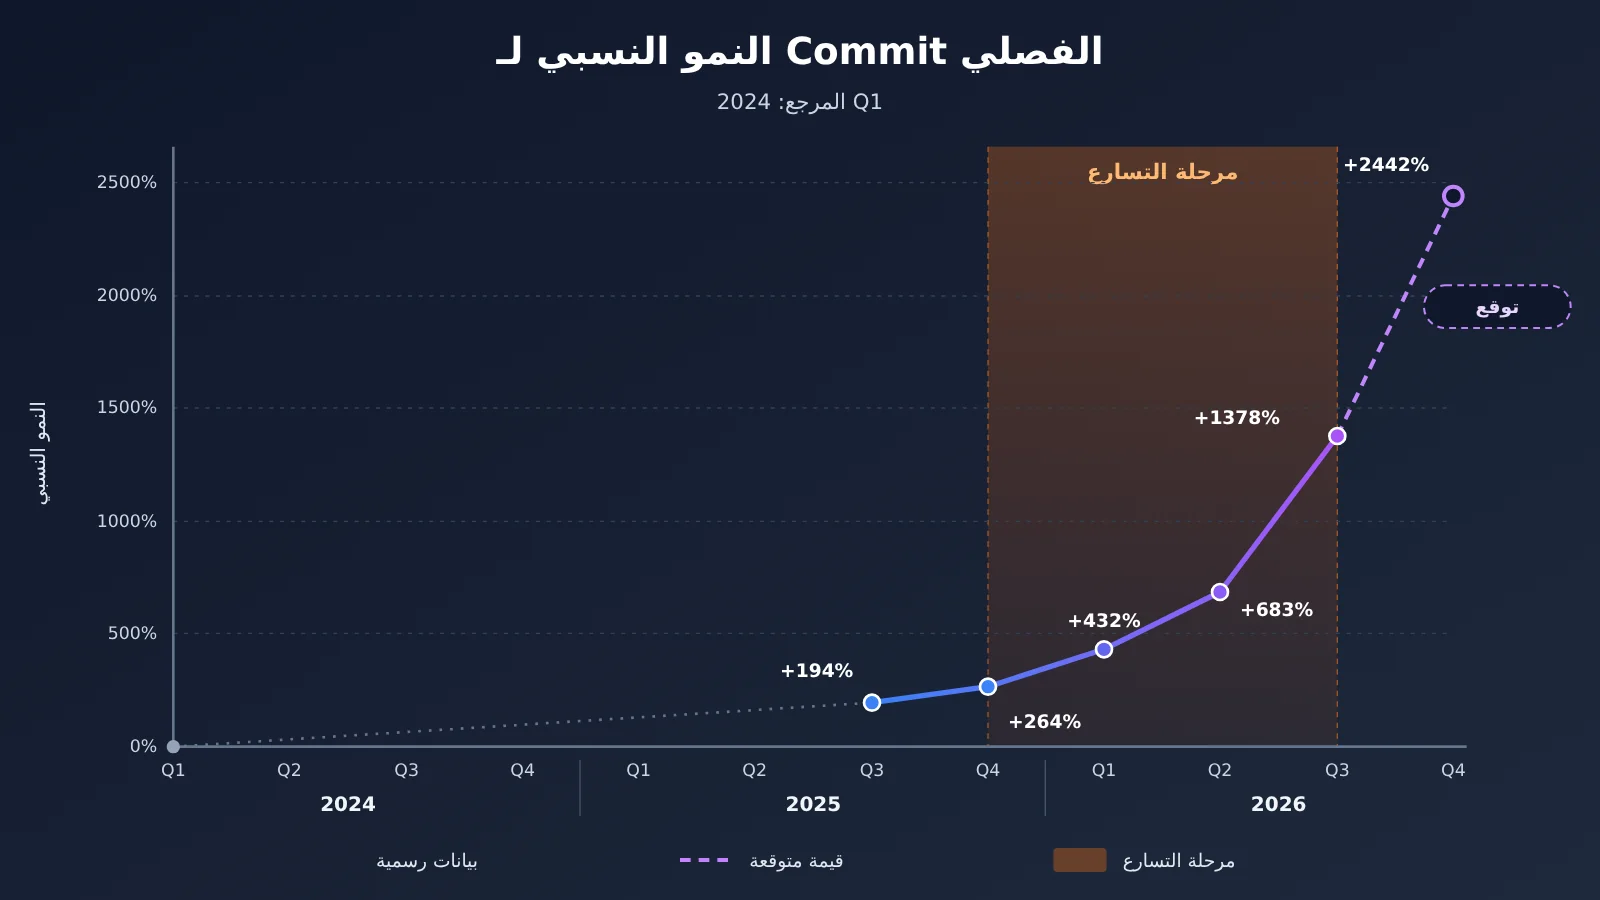
تكتفي تقارير كثيرة بذكر نسبة 2442%، لكن التسلسل الفصلي الكامل يوضح الصورة بصورة أفضل. يستخدم الجدول التالي الربع الأول من 2024 أساسًا للمقارنة، ويعرض عدد عمليات Commit الفصلية المدمجة في فرع master للمستودع الموحد في OpenAI.
| الربع | النمو مقارنة بالربع الأول من 2024 | المضاعف التقريبي للفترة المرجعية |
|---|---|---|
| 2024 Q2 | +35% | 1.35 |
| 2024 Q4 | +98% | 1.98 |
| 2025 Q2 | +194% | 2.94 |
| 2025 Q4 | +264% | 3.64 |
| 2026 Q1 | +432% | 5.32 |
| 2026 Q2 | +683% | 7.83 |
| 2026 Q3 | +1,378% | 14.78 |
| 2026 Q4 | +2,442%(توقع) | 25.42 |
تكشف هذه البيانات ثلاثة أمور. أولًا، كان النمو قائمًا بالفعل بين عامي 2024 و2025، لذلك لا يمكن نسبته بالكامل إلى Codex. ثانيًا، أصبح المنحنى أكثر انحدارًا بوضوح بين +264% في 2025 Q4 و+1,378% في 2026 Q3، وهو تسارع يتوافق مع اتجاه التطوير المتوازي باستخدام الوكلاء الذي وصفته OpenAI. ثالثًا، أعلنت الشركة معدلات النمو النسبية فقط، ولم تنشر الأعداد الفعلية لعمليات Commit في كل ربع.
وتشير مجموعة أخرى من البيانات، رغم اختلاف طريقة قياسها، إلى الاتجاه نفسه. ففي 20 يوليو 2026، ذكرت مدونة مطوري OpenAI عند تقديم Codex Code Review أن العدد الأسبوعي لطلبات Pull Request الداخلية زاد إلى أكثر من الضعف مقارنة بالربع الرابع السابق. يختلف هذا المؤشر عن نمو عمليات Commit الفصلية من حيث طريقة القياس والفترة الزمنية، لذا لا يمكن جمعهما أو تحويل أحدهما إلى الآخر. لكن كليهما يشير إلى تسارع كبير في نشاط تغيير الشفرة البرمجية.
كيف ينقل Codex الضغط إلى البنية التحتية لـ Git
قد يبدو للوهلة الأولى أن «كتابة الذكاء الاصطناعي للشيفرة بسرعة أكبر» تؤثر فقط في المطوّر نفسه. لكن تفسير OpenAI يشير إلى جانب آخر: يزيد Codex عدد المهام التي ينفذها النظام الهندسي بالتوازي. فيستطيع مهندس واحد تكليف عدة وكلاء بالعمل في الوقت نفسه على ميزات مستقلة، وينشئ كل وكيل فروعًا وعمليات Commit وPush، تؤدي بدورها إلى سلسلة من عمليات القراءة الآلية.
يلخّص الجدول التالي هذه السلسلة وفقًا لوصف OpenAI الرسمي.
| المرحلة | ماذا يحدث؟ | التأثير في البنية التحتية لـ Git |
|---|---|---|
| A. انخفاض تكلفة التنفيذ | يكلّف المهندس عدة وكلاء بتعديل ميزات مستقلة بالتوازي | زيادة عدد مهام التطوير |
| B. زيادة العمل المتوازي | المزيد من الفروع وعمليات Commit وGit Push | زيادة طلبات الكتابة وتحديثات الفروع |
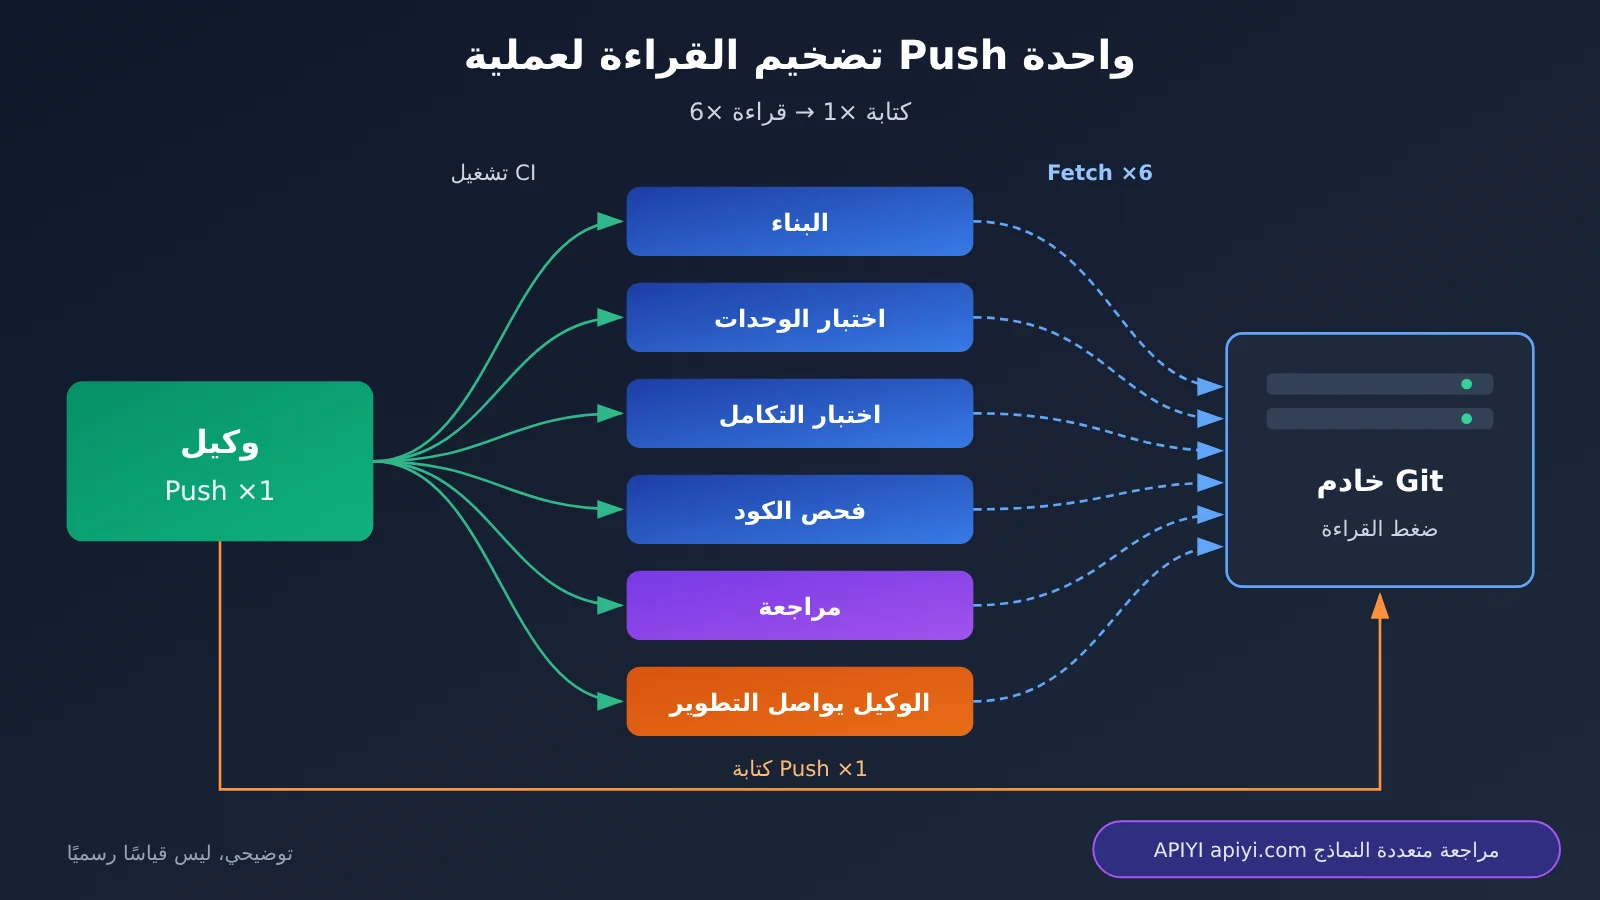
| C. تضاعف الحمل عبر مسار العمل | تؤدي عملية Push واحدة إلى تشغيل عدة عمليات بناء واختبار وفحص في CI | جلب التغيير نفسه عبر Fetch مرات متكررة |
| D. الضغط على البنية المشتركة | تتزايد عمليات الدمج ومزامنة الحالة وتوفير بيانات الإصدارات في الوقت نفسه | تباطؤ Push وFetch وفشل عمليات Merge |
| E. انتقال عنق الزجاجة | تصبح كتابة النموذج للشيفرة أسرع، لكن سعة Git وCI وعمليات المراجعة لا تتوسع بالقدر نفسه | تتعطل سرعة التسليم عند المراحل اللاحقة |
مثال توضيحي لتضاعف الحمل
يساعدنا المثال التالي على فهم الفكرة، وأرقامه توضيحية بحتة وليست قياسات فعلية من OpenAI. لنفترض أن عملية Push واحدة تشغّل 6 مهام CI، وتجلب كل مهمة الشيفرة مرة واحدة عبر Fetch. عندئذٍ قد تؤدي 100 عملية Push إلى نحو 600 عملية قراءة للشيفرة. وإذا زادت الوكلاء عدد عمليات Push عدة أضعاف، فسيزداد حجم القراءة بالنسبة نفسها.
يتأثر حجم الطلبات الفعلي بالتخزين المؤقت في CI، وإعادة استخدام المهام، وبنية عملية البناء، لكن الاتجاه واضح: تتضاعف الزيادة في عمليات الكتابة على جانب القراءة، وهنا يبدأ خادم Git في مواجهة الضغط أولًا. وتذكر OpenAI تحديدًا أن مهام CI والمهام البحثية وبيئات التطوير قد تجلب التغيير نفسه مرات متكررة.
ما المشكلة التي واجهها نظام Git القديم لدى OpenAI؟
كشفت OpenAI أنه منذ أواخر عام 2025، أصبحت الأنظمة الداعمة للمستودع الموحّد تواجه صعوبة متزايدة في تحمّل الحمل الجديد. ومن الأعراض التي ظهرت بطء عمليتَي Git Fetch وPush، وفشل عمليات Merge، وانخفاض موثوقية البنية التحتية أحيانًا إلى أقل من 90%.
من المهم فهم عبارة «أقل من 90%» بدقة. فهي تصف موثوقية النظام خلال بعض الفترات، ولم تُنشر طريقة حسابها بالتفصيل أو بياناتها الكاملة عبر الزمن. ولا تعني أن «10% من الشفرة معيبة»، كما لا يصح القول إن «أكثر من 10% من عمليات الإيداع لدى OpenAI فشلت».
من الناحية التقنية، كان في البنية القديمة عنقا زجاجة أساسيان:
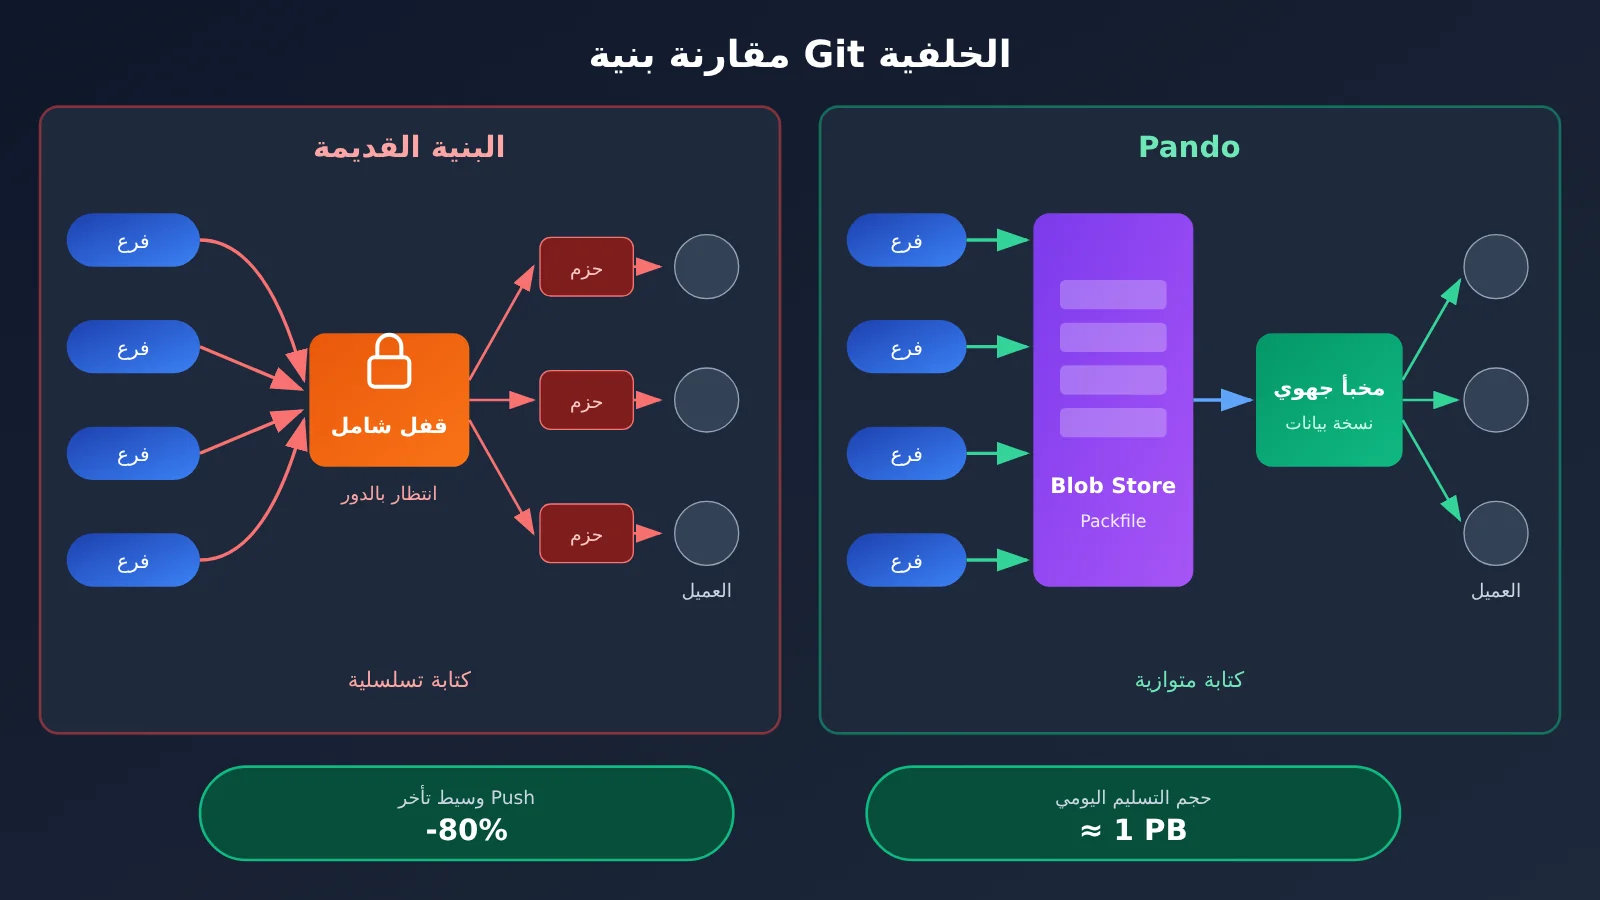
- تحديث الفروع يتطلب تنسيقًا شاملًا: تحتاج كثير من خدمات Git الموزعة التقليدية إلى الحفاظ على حالة متسقة لجميع مراجع المستودع. وحتى إذا عدّل وكيلان فرعين لا علاقة بينهما، فقد يتزاحمان على مسار التنسيق نفسه.
- إعادة حساب حزم التنزيل: يختلف سجل Git الموجود لدى كل عميل، لذلك يضطر الخادم كثيرًا إلى استعراض الكائنات وتجميعها وضغطها لكل عميل على حدة. وعندما يقرأ عدة وكلاء الإصدار نفسه، تتكرر هذه العمليات المكلفة.
عندما كان المهندسون البشر يقودون العمل، كان بالإمكان تحمّل هاتين المشكلتين. لكن مع تدفق أعداد كبيرة من الوكلاء ومهام التكامل المستمر (CI) في الوقت نفسه، أصبحتا عنقَي زجاجة للنظام.
كيف يخفف Pando الضغط الذي يفرضه Codex على Git
لم تتخلَّ OpenAI عن Git. فما زال Pando يستخدم بروتوكول Git وعملاءه القياسيين، وتبقى أوامر المهندسين وسير عملهم دون تغيير يُذكر. أما ما أُعيد تصميمه فهو التخزين على الخادم، وتحديث المراجع، وطريقة تسليم البيانات. يقارن الجدول التالي أبرز الفروق بين الحل القديم وPando.
| الجانب | خادم Git التقليدي | Pando |
|---|---|---|
| الكتابة إلى الفروع | تنسيق صارم على مستوى المستودع كله، وقد تنتظر الفروع غير المرتبطة بعضها | يُحدَّث كل فرع بصورة مستقلة، ولا يلزم التنسيق إلا عند تعديل المرجع نفسه (Ref) |
| نموذج الاتساق | لقطة متسقة للمستودع كله | اتساق سببي، مع ضمان الترتيب وإمكانية قراءة التغييرات المكتوبة على الفرع نفسه |
| تسليم البيانات للقراءة | إعادة تجميع البيانات وضغطها وفق حالة العميل | إعادة استخدام ملفات Packfile المحفوظة عند Push وتوزيعها عبر ذاكرة التخزين المؤقت |
| التخزين المؤقت | يعتمد على التنفيذ | خدمة تخزين مؤقت إقليمية، بمعدل إصابة يتجاوز 99% لملفات Packfile |
| توافق العملاء | Git القياسي | Git القياسي، مع تسليم البيانات باستخدام آلية packfile-uri |
الفكرتان الأساسيتان وراء Pando
الأولى هي الكتابة المتزامنة. تخلى Pando عن الاحتفاظ بلقطة متسقة للمستودع كله عند نقطة زمنية واحدة، وأصبح يدير إصدار كل فرع بصورة مستقلة. يمكن تنفيذ عمليات Push لفروع مختلفة بالتوازي، ولا تحتاج إلى معالجة التعارضات إلا الطلبات التي تعدّل المرجع نفسه. والمقابل هو أن الفروع التي يراها العميل عند قراءة عدة فروع في عملية واحدة قد تعود إلى نقاط زمنية مختلفة. وترى OpenAI أن هذه المقايضة مناسبة لاحتياجاتها.
الثانية هي إعادة استخدام البيانات عند القراءة. يحفظ Pando ملف Packfile الذي يتلقاه مع كل عملية Push بوصفه بيانات غير قابلة للتغيير في Blob Store. وعندما ينفذ عميل آخر عملية Fetch، يختار الخادم ملفات Packfile جاهزة لتسليمها بناءً على سجلات Commit الموجودة لدى العميل وتلك التي يريدها، بدلًا من إعادة تجميع البيانات. كما يدمج النظام في الخلفية أعدادًا كبيرة من ملفات Packfile الصغيرة تدريجيًا في مجموعات أكبر، حتى لا تضطر العملاء التي لم تُحدَّث منذ مدة طويلة إلى تنزيل عدد كبير من الملفات.
تشمل بيانات الإنتاج الرسمية انخفاض زمن استجابة Push الوسيط بنحو 80%، وتسليم ما يقارب 1 PB من بيانات Git يوميًا، وتجاوز ذروة تسليم ملفات Packfile خلال ساعة واحدة 57 TB. وتجدر الإشارة إلى أن 1 PB تمثل حجم البيانات المُسلَّمة؛ إذ تُحتسب القراءة المتكررة للبيانات نفسها ضمنه، ولا يعني ذلك إنتاج 1 PB من الشفرة الجديدة يوميًا.
ومن اللافت أن Pando نفسه نتاج تطوير شارك فيه وكلاء ذكاء اصطناعي. تقول OpenAI إن مهندسًا واحدًا صمم بنيته الأساسية، وشاركت عدة فرق من الوكلاء في تنفيذها، مع الاستعانة بمجموعة اختبارات توافق Git واختبارات المحاكاة الحتمية للتحقق منها. لكنها لم تدّعِ أن الذكاء الاصطناعي كتب الشفرة كلها.
تحليل أثر البرمجة بالذكاء الاصطناعي: عنق الزجاجة ينتقل من كتابة الشفرة
الأثر على المطورين والفرق
ما يستحق الاهتمام في قصة Pando ليس أن OpenAI بنت نظام Git خلفيًا خاصًا بها، بل النمط الذي تكشفه: البرمجة بالذكاء الاصطناعي تخفض تكلفة توليد الشفرة، وتنقل الضغط إلى المراحل اللاحقة من سلسلة العمل الهندسي. لم يكن Git سوى أول مرحلة ظهرت فيها المشكلة؛ فمراجعة الشفرة والاختبار والتكامل تواجه ضغوطًا أيضًا.
أقرت OpenAI صراحةً في مقالتها عن Codex Code Review بأن عدد طلبات الدمج (PR) التي تنتظر المراجعة آخذ في الازدياد. ويصعب على المراجعين فهم القيود التاريخية وتقييم مخاطر توافق API في الوقت المناسب. لذلك يدعم Codex Code Review قراءة قواعد المراجعة المحددة في ملف AGENTS.md داخل المستودع، لحماية عقود API القائمة، واكتشاف السجلات التي قد تسرّب بيانات العملاء، وتجنب تعطيل التكامل مع الخدمات الحالية.
بالنسبة إلى فرق التطوير التي تستخدم الذكاء الاصطناعي، يعني ذلك إجراء بعض التعديلات العملية:
- دوّن قواعد المراجعة: وثّق قيود الفريق غير المكتوبة في ملف قواعد مثل AGENTS.md، ليكون للمراجعة بالذكاء الاصطناعي أساس واضح تستند إليه.
- اترك هامشًا لسعة CI: عند تشغيل وكلاء الذكاء الاصطناعي بالتوازي، قد يزداد عدد مهام CI قبل أن ترتفع تكاليف القوى العاملة، لذا قيّم التخزين المؤقت وحدود التشغيل المتزامن مسبقًا.
- أعد اختيار مقاييس الأداء: لا تكتفِ بعدد عمليات Commit أو طلبات PR؛ راقب أيضًا دورة التسليم ومعدل فشل التغييرات.
- أعطِ الأولوية للقدرة على التحقق: تحدد تغطية الاختبارات والاختبارات بالمحاكاة واختبارات التوافق ما إذا كان يمكن دمج مخرجات الوكلاء بثقة.
مثال مبسط لمراجعة الشفرة بالذكاء الاصطناعي باستخدام نماذج متعددة
إذا أردت تجربة مراجعة التغييرات (Diff) وفق قواعد محددة في مستودعك، يمكنك إنشاء نموذج أولي سريع باستخدام واجهة متوافقة مع OpenAI. يقرأ المثال التالي التغييرات المحلية ويطلب من النموذج مراجعتها وفق القواعد:
import openai, subprocess

client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")
diff = subprocess.run(["git", "diff", "HEAD~1"], capture_output=True, text=True).stdout

resp = client.chat.completions.create(
    model="YOUR_MODEL",  # استبدله بنموذج برمجة متاح على المنصة
    messages=[{"role": "user", "content": f"请审查以下改动,重点关注 API 兼容性和日志泄露风险:\n{diff}"}],
)
print(resp.choices[0].message.content)
عرض شفرة التنفيذ الكاملة (قراءة قواعد AGENTS.md ومقارنة نماذج متعددة)
import subprocess
from pathlib import Path
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # استدعاء نماذج من مزودين متعددين بمفتاح واحد
)

def load_rules(path: str = "AGENTS.md") -> str:
    """يقرأ قواعد المراجعة في المستودع، ويعيد القواعد الافتراضية إذا لم تكن موجودة"""
    p = Path(path)
    if p.exists():
        return p.read_text(encoding="utf-8")
    return "1. 不得破坏已有 API 契约\n2. 日志中不得输出客户数据\n3. 不得破坏已有服务集成"

def get_diff(base: str = "HEAD~1") -> str:
    """يجلب التغييرات المطلوب مراجعتها"""
    return subprocess.run(
        ["git", "diff", base], capture_output=True, text=True
    ).stdout

def review(diff: str, rules: str, model: str) -> str:
    """يستدعي النموذج لمراجعة تغييرات الشفرة وفق القواعد"""
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": f"你是严格的代码审查者,请依据以下仓库规则审查:\n{rules}"},
            {"role": "user", "content": f"待审查 Diff:\n{diff}\n请逐条列出风险点和修改建议。"},
        ],
        max_tokens=1500,
    )
    return resp.choices[0].message.content

if __name__ == "__main__":
    rules, diff = load_rules(), get_diff()
    # استبدل الأسماء بأسماء النماذج التي تريد مقارنتها، ولاحظ الاختلافات في مراجعاتها
    for model in ["MODEL_A", "MODEL_B"]:
        print(f"===== {model} =====")
        print(review(diff, rules, model))
🚀 اقتراح للبدء سريعًا: عند إنشاء نموذج أولي لمراجعة الشفرة بالذكاء الاصطناعي، يمكنك الحصول على رصيد تجريبي مجاني عبر APIYI على apiyi.com. يتيح لك مفتاح API واحد استدعاء نماذج مثل OpenAI وClaude وGemini، ما يسهّل مقارنة جودة مراجعاتها وفق قواعد مستودعك.
التأثير على القطاع
ترى The New Stack في تقريرها أن OpenAI من أوائل المؤسسات التي تستخدم وكلاء البرمجة بكثافة، وأن الضغط الذي واجهته بنيتها التحتية قد ينذر بمشكلات ستواجهها مؤسسات كبيرة أخرى ومنصات استضافة الشفرة مستقبلًا. هذا تقدير إعلامي لاتجاه محتمل، ولا يثبت أن GitHub أو GitLab شهدتا الأعطال نفسها بالفعل.
وتختلف الآراء أيضًا في مجتمع المطورين. يرى المتفائلون أن انخفاض تكلفة البرمجة سيجعل كثيرًا من المشاريع الصغيرة، التي لم تكن تستحق التنفيذ سابقًا، قابلة للتنفيذ. في المقابل، يشير المشككون إلى أن زيادة عدد عمليات Commit لا تعني زيادة قيمة البرمجيات، وأن وتيرة التسليم قد لا تتحسن إذا لم تواكبها المراجعة والاختبارات. وتذكّر تعليقات أخرى بأن مشكلات حجم مستودعات Monorepo الكبيرة لم تبدأ مع عصر الذكاء الاصطناعي.
فهم بيانات Codex: خمسة مؤشرات لا ينبغي الخلط بينها
من أكثر الأخطاء شيوعًا عند مناقشة أثر البرمجة بالذكاء الاصطناعي الخلط بين المؤشرات المختلفة. يساعدك الجدول التالي على فهم ما يمكن لكل مؤشر أن يوضحه وما لا يمكنه توضيحه.
| المؤشر | ما الذي يقيسه؟ | الوضع في هذا الخبر |
|---|---|---|
| عدد عمليات Commit | وتيرة تسجيل التغييرات في نظام التحكم بالإصدارات | يُتوقع نمو فصلي بنسبة +2,442%، والمتاح هو القيمة النسبية فقط |
| عدد طلبات السحب PR | مقترحات التغيير وعمليات الدمج | تضاعف عدد طلبات PR الأسبوعية مقارنة بالربع الرابع السابق |
| عدد أسطر الشفرة | حجم الشفرة | لم يُعلن عنه، ولا يمكن استنتاجه من نمو عمليات Commit |
| Lead Time | الوقت من بدء التغيير إلى تسليمه | لم يُعلن عنه |
| معدل فشل التغييرات | نسبة التغييرات التي تتسبب في أعطال بعد النشر | لم يُعلن عنه |
تُظهر حالة Pando أن عبء تطوير الشفرة لدى OpenAI ازداد بشكل ملحوظ، وأن البنية التحتية الأصلية لـ Git واجهت اختناقات. لكنها لا تثبت أن جودة البرمجيات أو إنتاجية المطورين نمت بالنسبة نفسها، ولا يمكن استخدامها لتقدير عدد المهندسين الذين حلّ Codex محلهم.
من ناحية أخرى، كانت Harness Engineering، التي نشرتها OpenAI في فبراير 2026، تجربة مستقلة أخرى: بدأ المشروع بمستودع فارغ، ووصل خلال نحو خمسة أشهر إلى مليون سطر من الشفرة تقريبًا، مع إجمالي نحو 1,500 طلب PR. هذه بيانات مشروع آخر لا علاقة له بـ Pando، لكنها تعكس الاتجاه نفسه: ينتقل تركيز عمل المهندسين نحو المعمارية وسلسلة الأدوات وحلقات التغذية الراجعة وقبول الشفرة.
💡 نصيحة للاختيار: إذا كان فريقك يبدأ أيضًا باستخدام وكلاء البرمجة، فمن الأفضل أن تقارن أولًا بين أداء النماذج المختلفة في توليد الشفرة ومراجعتها على نطاق صغير. تتيح لك الواجهة الموحدة من APIYI على apiyi.com التبديل سريعًا بين النماذج وتقييمها بالمقارنة باستخدام مجموعة حالات الاختبار نفسها، قبل اختيار النموذج الأساسي.
الأسئلة الشائعة FAQ
س1: هل زاد Codex حجم الشفرة البرمجية لدى OpenAI بمقدار 24 ضعفًا فعلًا؟
لا يمكن تفسير الرقم بهذه الطريقة. تشير البيانات الرسمية إلى أن «عدد عمليات Commit الفصلية المدمجة في master يُتوقع أن يرتفع بنسبة 2442% مقارنة بالربع الأول من 2024». هذا الرقم تقديري، ويقيس عدد عمليات Commit لا عدد أسطر الشفرة. وقد تكون التغييرات في كل عملية كبيرة أو صغيرة، لذا لا يعادل هذا الرقم حجم الشفرة أو الإنتاجية.
س2: هل Pando بديل عن GitHub؟
لا. Pando نظام خلفي للخادم متوافق مع بروتوكول Git القياسي، ويُستخدم داخليًا في OpenAI فقط. وحتى 3 نوفمبر 2026، لم يُعلن عن إتاحة الخادم للعامة أو عن أسعار أو موعد لإتاحته. ما نشرته OpenAI هو مستودع لنسخة محسّنة من عميل Git، وقد ساهمت ببعض التغييرات في مشروع Git الأصلي، لكن هذا لا يعني أن خادم Pando أصبح مفتوح المصدر.
س3: هل تحتاج الفرق العادية إلى إعادة بناء بنية Git التحتية مثل OpenAI؟
معظم الفرق لا تحتاج إلى ذلك. تواجه OpenAI مستودعًا أحاديًا ضخمًا جدًا وتشغيلًا متزامنًا مكثفًا للوكلاء. أما لدى الفرق الصغيرة والمتوسطة، فعادةً ما تتمثل العقبات الأكثر واقعية في حصص التكامل المستمر (CI)، وتغطية الاختبارات، والموارد البشرية المتاحة لمراجعة الشفرة. لذلك من الأفضل إعطاء الأولوية لتحسين هذه الجوانب.
س4: كيف يمكن تجربة مراجعة الشفرة بالذكاء الاصطناعي أو سير عمل وكيل برمجي بتكلفة منخفضة؟
يمكنك البدء ببناء نموذج أولي بسيط باستخدام واجهة متوافقة مع OpenAI، وقراءة ملف Diff وملف القواعد وفق مثال الشفرة في هذا المقال، ثم إرسالهما إلى النموذج للمراجعة. بالتسجيل عبر APIYI على apiyi.com، يمكنك الحصول على رصيد مجاني للتجربة. غيّر `base_url` إلى `https://api.apiyi.com/v1`، وستتمكن من استخدام المفتاح نفسه لمقارنة نتائج المراجعة بين نماذج مختلفة.
س5: هل تؤدي البرمجة بالذكاء الاصطناعي إلى إنتاج المزيد من الشفرة منخفضة الجودة فحسب؟
هذا هو محور النقاش في المجتمع، ولا توجد إجابة حاسمة حتى الآن. لم تنشر OpenAI معدلات العيوب أو التراجع عن التغييرات، ولا التغير في صافي تكلفة التطوير. لذلك لا يمكن الجزم بأن الجودة تراجعت أو تحسنت على نحو شامل. والأفضل أن يتابع فريقك دورة التسليم ومعدل فشل التغييرات معًا. ويمكنك أيضًا استخدام APIYI على apiyi.com للوصول إلى عدة نماذج وإجراء مراجعات متقاطعة، مما يقلل خطر إغفال نموذج واحد لبعض المشكلات.
Codex وتغيّرات البنية التحتية لـ Git: أبرز النقاط
- دقة الأرقام مهمة: نسبة 2442% هي النمو المتوقع في عدد عمليات Commit خلال الربع الرابع من 2026، وليست زيادة في عدد أسطر الشفرة.
- النمو يتسارع بوضوح: أصبح منحنى النمو أكثر حدة بعد الربع الرابع من 2025، لكنه كان في تصاعد منذ عام 2024.
- التزامن هو مصدر الضغط: زاد Codex من عدد المهام المتوازية، وتضاعف أثر زيادة عمليات الكتابة على جانب القراءة في CI.
- النظام القديم لم يعد يواكب المتطلبات: منذ أواخر 2025، أصبحت عمليات Push وFetch أبطأ، وانخفضت الموثوقية أحيانًا إلى أقل من 90%.
- حل Pando: الكتابة المستقلة لكل فرع، وإعادة استخدام ملفات Packfile والتخزين المؤقت، خفّضت زمن استجابة Push الوسيط بنحو 80%.
- انتقال الاختناقات إلى المراحل اللاحقة: أصبحت مراجعة الشفرة والاختبار والدمج والتسليم نقاط التقييد الجديدة.
- اقتراح للبدء: استخدم الواجهة الموحدة من APIYI على apiyi.com لبناء نموذج أولي سريع لمراجعة الشفرة باستخدام عدة نماذج.
الخلاصة
يمكن تلخيص التغييرات التي أحدثها Codex لدى OpenAI في ثلاث نقاط رئيسية:
- على مستوى الحجم: يُتوقع أن ينمو عدد عمليات Commit الفصلية في المستودع الموحد بنسبة 2442% مقارنة بالربع الأول من 2024، كما يتضاعف عدد طلبات السحب (PR)، ما يعكس زيادة كبيرة في نشاط تغيير الشفرة.
- على مستوى البنية التحتية: أدت الوكلاء المتوازيون إلى زيادة عدد الفروع وعمليات Push والقراءة في CI، فظهرت مشكلات في أداء خلفية Git القديمة وموثوقيتها. ولمواجهتها، بنت OpenAI نظام Pando في نحو 10 أسابيع.
- على مستوى سير العمل الهندسي: لم تعد كتابة الشفرة أبطأ مرحلة؛ بل أصبحت القدرة على المراجعة والاختبار والتسليم هي ما يحدد ما إذا كانت البرمجة بالذكاء الاصطناعي ستتحول إلى قيمة حقيقية.
بالنسبة إلى معظم الفرق، من الأفضل تعزيز قدرات التحقق والمراجعة أولًا بدلًا من ملاحقة عدد عمليات Commit، ثم زيادة عدد الوكلاء الذين يعملون بالتوازي تدريجيًا. وإذا أردت التحقق سريعًا من سير عمل لمراجعة الشفرة بالذكاء الاصطناعي أو لوكيل برمجة، فنوصي باستخدام الرصيد المجاني عبر APIYI على apiyi.com لمقارنة الأداء الفعلي لعدة نماذج.
📚 المراجع
- Scaling Git at OpenAI: المقال التقني الرسمي من OpenAI عن Pando (2026-11-02)
- الرابط:
openai.com/index/scaling-git-at-openai -
الوصف: المصدر الرئيسي للوقائع الواردة في المقال وبيانات نمو عمليات Commit الفصلية
-
Custom Code Review rules for Codex: مدونة مطوري OpenAI (2026-07-20)
- الرابط:
developers.openai.com/blog/custom-code-review-rules-for-codex -
الوصف: مصدر المعلومات حول تضاعف عدد طلبات الدمج PR أسبوعيًا وقواعد المراجعة في AGENTS.md
-
Harness engineering: تجربة مستقلة من OpenAI لتطوير وكيل برمجي (2026-02-11)
- الرابط:
openai.com/index/harness-engineering -
الوصف: مثال مستقل لفهم تحوّل دور المهندسين، ولا صلة له بمشروع Pando
-
OpenAI Git Fork: المستودع العام لعميل Git الذي تطوره OpenAI
- الرابط:
github.com/openai/git -
الوصف: للاطلاع على تحسينات العميل، مثل packfile-uri
-
تقرير The New Stack: تغطية إعلامية خارجية لمشروع Pando (2026-11-02)
- الرابط:
thenewstack.io - الوصف: مرجع لتقييم اتجاهات القطاع
الكاتب: الفريق التقني في APIYI
التواصل التقني: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI الرسمي. وللمزيد من الموارد حول دمج النماذج، يمكنكم زيارة مركز التوثيق على docs.apiyi.com