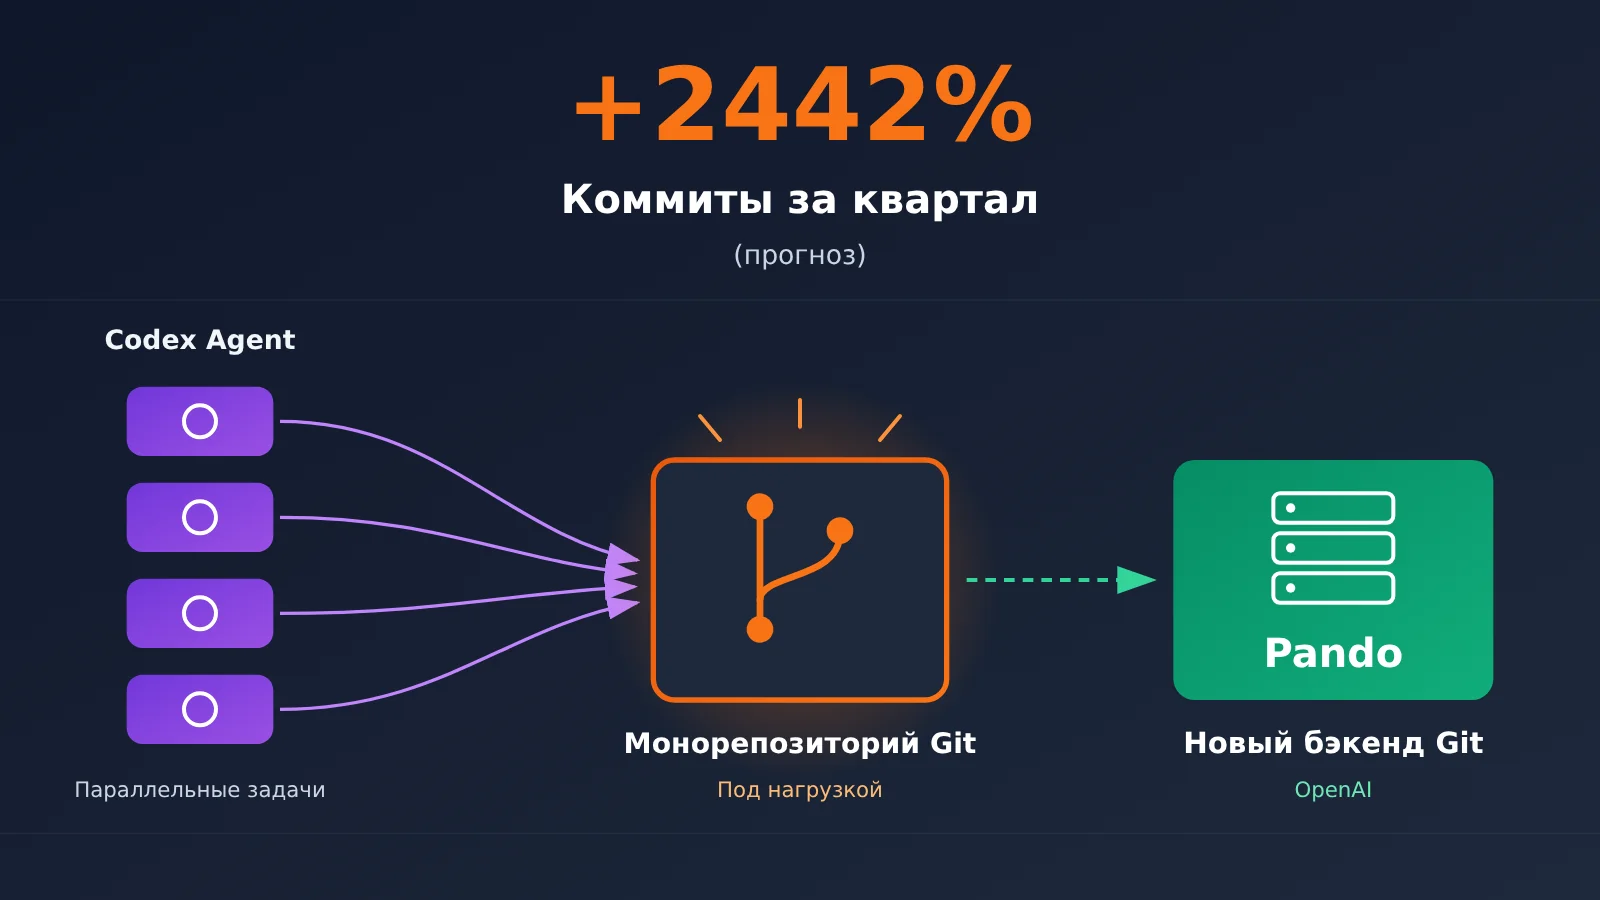
Примечание автора: OpenAI рассказала о новом бэкенде Git под названием Pando. По прогнозу, благодаря Codex число коммитов в монорепозитории за квартал вырастет на 2442% по сравнению с I кварталом 2024 года. В статье разбираемся, как влияние ИИ-программирования распространяется от генерации кода на Git, CI и ревью кода.
2 ноября 2026 года OpenAI опубликовала техническую статью «Scaling Git at OpenAI». Согласно графику в статье, число коммитов в монорепозитории OpenAI за IV квартал 2026 года, по прогнозу, вырастет на 2442% по сравнению с I кварталом 2024 года. Чтобы справиться с нагрузкой от параллельной разработки с помощью Codex, OpenAI с нуля создала бэкенд Git под названием Pando.
Это не слух и не маркетинговый лозунг в духе «ИИ увеличил объём кода в 24 раза». Данные взяты из официального инженерного блога OpenAI, а авторы статьи — Aaron Friel, Taylor Blau и Ted Nyman. Сразу уточним два момента: 2442% — это прогноз, поскольку IV квартал ещё не закончился; речь идёт о числе коммитов, объединённых с веткой master, а не о количестве строк кода и тем более не о производительности.
Что вы узнаете: как Codex меняет масштабы разработки в OpenAI за счёт параллельных задач, почему из-за этого растёт нагрузка на инфраструктуру Git и куда смещаются узкие места в разработке ПО.
Codex и Git-инфраструктура OpenAI: главное
Начнём с таблицы фактов. Все данные ниже взяты из официальных публикаций OpenAI; там, где информация не раскрыта, это указано отдельно.
| Пункт | Подробности |
|---|---|
| Дата публикации | 2 ноября 2026 года, «Scaling Git at OpenAI» |
| Авторы | Инженерная команда OpenAI (Aaron Friel, Taylor Blau, Ted Nyman) |
| Главное | Новый серверный бэкенд Git под названием Pando, совместимый со стандартным протоколом и клиентами Git |
| Предыстория | Codex повысил параллелизм разработки, и прежняя система Git столкнулась с проблемами производительности и надёжности |
| Запуск в продакшен | Обслуживает продакшен-трафик с апреля 2026 года; от начала работы до запуска прошло около 10 недель |
| Результат | Медианная задержка Push снизилась почти на 80%, ежедневно передаётся около 1 PB данных Git |
| Доступность | Используется только внутри OpenAI; серверная часть, цены и дата публичного запуска пока не объявлены |
Как росло квартальное число коммитов с развитием Codex
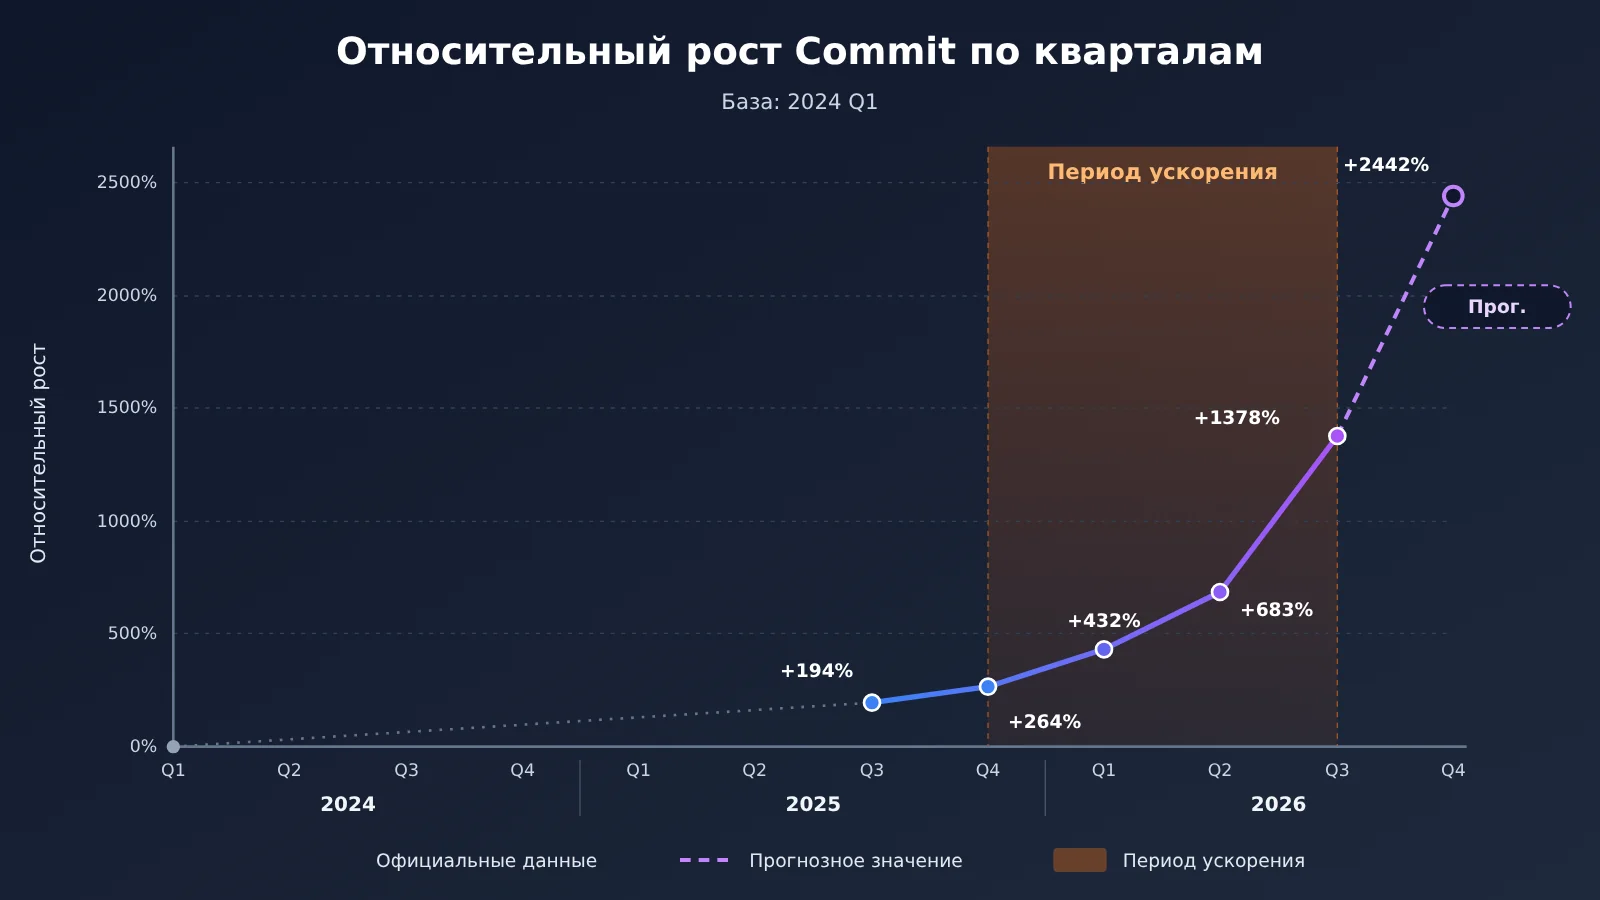
Многие публикации приводят только итоговую цифру — 2442%. Полная квартальная динамика показывает картину подробнее. В таблице за базовый период взят 2024 Q1; учитываются коммиты, слитые в ветку master монорепозитория OpenAI за каждый квартал.
| Квартал | Рост относительно 2024 Q1 | Примерное соотношение с базовым периодом |
|---|---|---|
| 2024 Q2 | +35% | 1.35 |
| 2024 Q4 | +98% | 1.98 |
| 2025 Q2 | +194% | 2.94 |
| 2025 Q4 | +264% | 3.64 |
| 2026 Q1 | +432% | 5.32 |
| 2026 Q2 | +683% | 7.83 |
| 2026 Q3 | +1,378% | 14.78 |
| 2026 Q4 | +2,442% (прогноз) | 25.42 |
Из этих данных можно сделать три вывода. Во-первых, рост наблюдался уже в 2024–2025 годах, поэтому нельзя целиком приписывать его Codex. Во-вторых, от +264% в 2025 Q4 до +1,378% в 2026 Q3 кривая заметно пошла вверх. Это ускорение совпадает с описанной OpenAI тенденцией к параллельной разработке с помощью агентов. В-третьих, компания опубликовала только относительные темпы роста, не раскрыв абсолютное число коммитов за каждый квартал.
Другие данные, рассчитанные по иной методике, указывают на ту же тенденцию. 20 июля 2026 года в блоге для разработчиков OpenAI рассказала о Codex Code Review и отметила, что еженедельное число внутренних Pull Request выросло более чем вдвое по сравнению с предыдущим четвёртым кварталом. Методика подсчёта и временной интервал здесь отличаются от данных о квартальном росте коммитов, поэтому эти показатели нельзя складывать или пересчитывать один в другой. Тем не менее оба говорят о стремительном росте активности по изменению кода.
Как Codex увеличивает нагрузку на Git-инфраструктуру
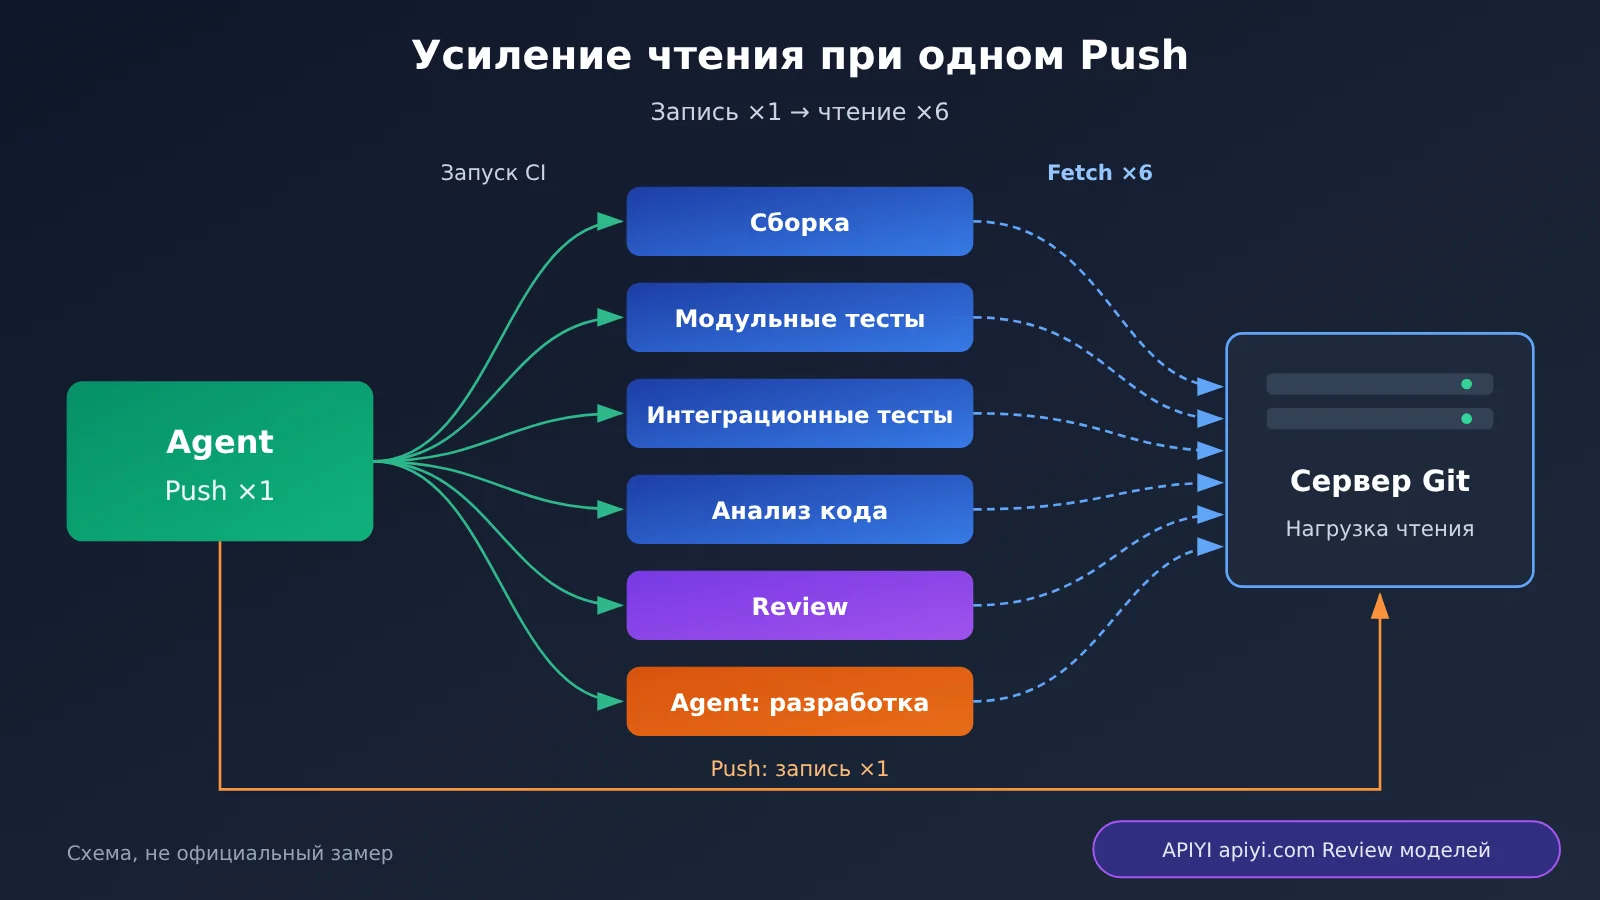
На первый взгляд, то, что «ИИ быстрее пишет код», влияет только на самого разработчика. Но OpenAI указывает на другой эффект: Codex повышает количество задач, которые параллельно выполняются во всей инженерной системе. Один инженер может одновременно поручить нескольким агентам работу над независимыми функциями. Каждый агент создаёт ветки, делает коммиты и отправляет изменения через Push, а эти операции запускают целую цепочку автоматических чтений.
В таблице ниже показано, как это происходит, согласно объяснению OpenAI.
| Этап | Что происходит | Влияние на Git-инфраструктуру |
|---|---|---|
| A. Снижение затрат на выполнение | Инженер поручает нескольким агентам одновременно работать над независимыми функциями | Количество задач разработки растёт |
| B. Рост параллелизма | Появляется больше веток, коммитов и операций Git Push | Растёт число запросов на запись и обновлений веток |
| C. Усиление нагрузки в пайплайне | Один Push запускает несколько сборок CI, тестов и проверок | Один и тот же коммит многократно запрашивается через Fetch |
| D. Нагрузка на общую инфраструктуру | Одновременно растёт число слияний, операций синхронизации статуса и запросов данных о версиях | Push и Fetch замедляются, Merge завершается с ошибками |
| E. Смещение узкого места | Модель пишет код быстрее, но мощности Git, CI и процесса Review не увеличиваются пропорционально | Скорость поставки ограничивается последующими этапами |
Пример усиления нагрузки
Рассмотрим условный пример — эти цифры не являются результатами измерений OpenAI. Допустим, один Push запускает 6 заданий CI, и каждое из них один раз получает код через Fetch. Тогда 100 операций Push могут привести примерно к 600 чтениям кода. Если агенты увеличат число операций Push в несколько раз, объём чтений вырастет пропорционально.
Фактическое число запросов зависит от кэширования CI, повторного использования заданий и архитектуры сборки, но общая тенденция ясна: рост числа записей усиливается на стороне чтения. Именно с этой нагрузкой Git-серверу становится сложнее справляться в первую очередь. OpenAI отдельно отмечает, что один и тот же коммит могут многократно получать разные задания CI, исследовательские задачи и среды разработки.
Что не так со старой Git-системой OpenAI
OpenAI рассказала, что с конца 2025 года инфраструктуре монорепозитория становилось всё сложнее справляться с растущей нагрузкой. Среди конкретных симптомов — замедление Git Fetch и Push, ошибки Merge, а также надёжность инфраструктуры, которая временами опускалась ниже 90%.
Важно правильно понимать формулировку «ниже 90%». Она описывает надёжность системы в отдельные периоды; точная методика расчёта и полная временная последовательность показателей не раскрыты. Это не означает, что «10% кода содержит ошибки» или что «более 10% коммитов OpenAI завершались неудачно».
С технической точки зрения у старой архитектуры было два структурных узких места:
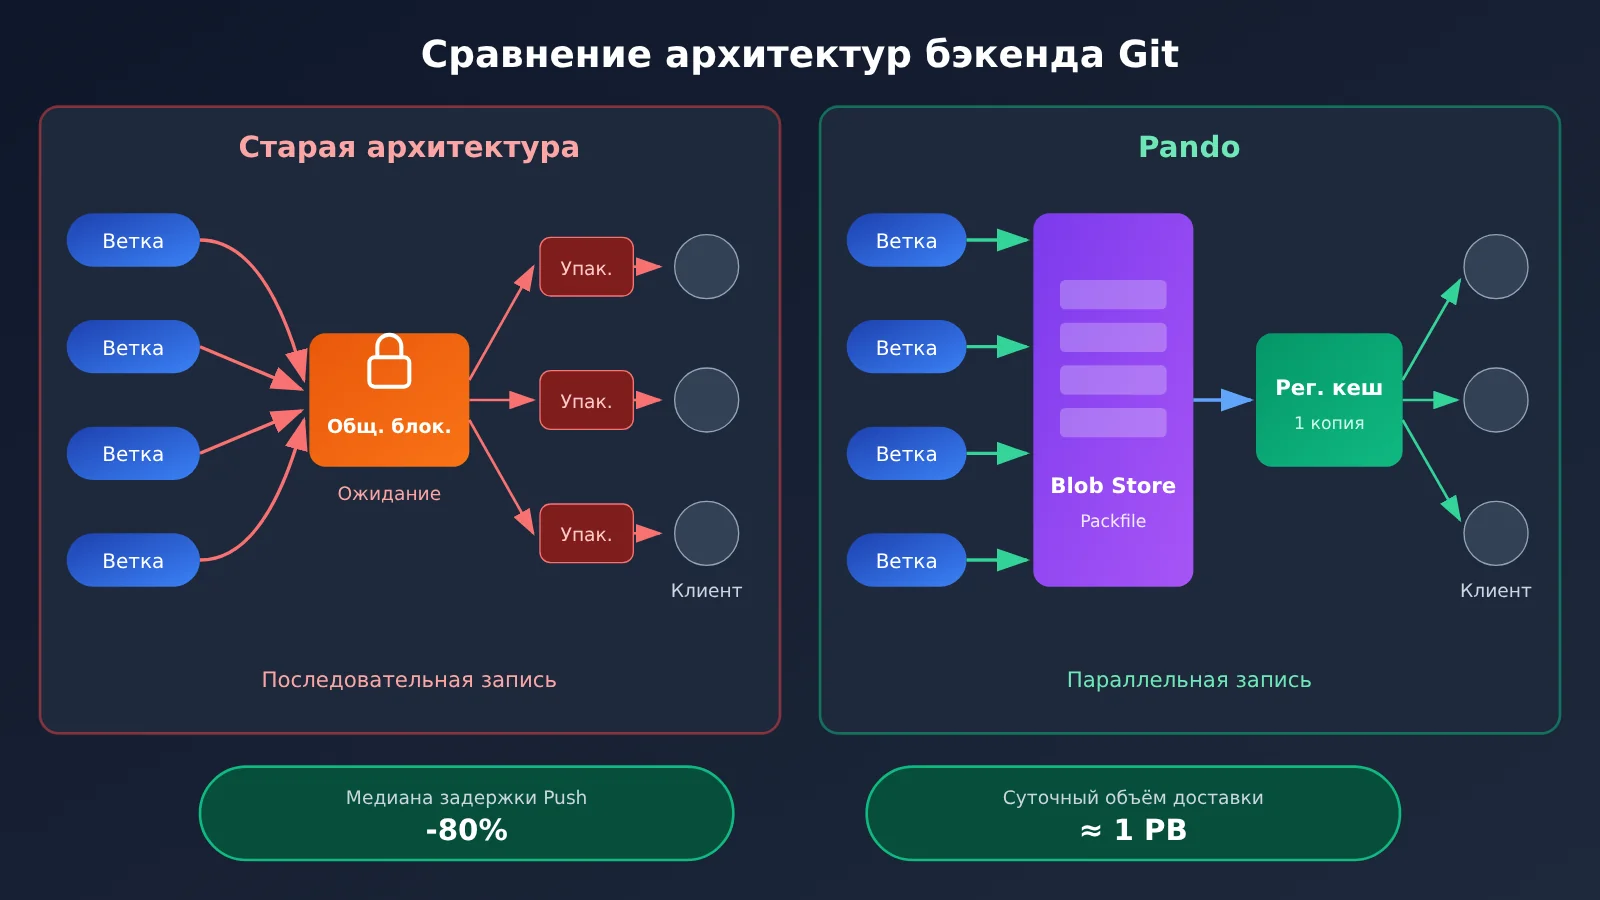
- Обновление веток требовало глобальной координации: многим традиционным распределённым Git-сервисам необходимо поддерживать согласованное состояние всех ссылок во всём репозитории. Даже если два агента изменяли совершенно не связанные друг с другом ветки, их операции могли конкурировать за один и тот же механизм координации.
- Пакеты для скачивания формировались повторно: у разных клиентов уже имелась разная история Git, поэтому серверу часто приходилось отдельно для каждого клиента обходить объекты, упаковывать и сжимать их. Когда несколько агентов считывали одну и ту же версию, эти затратные операции выполнялись снова и снова.
Пока основную работу выполняли инженеры-люди, с этими ограничениями можно было мириться. Но когда в систему одновременно хлынуло множество агентов и заданий CI, они превратились в узкие места.
Как Pando справляется с нагрузкой на Git от Codex
OpenAI не отказалась от Git. Pando по-прежнему использует стандартный протокол и клиенты Git, а привычные команды и рабочие процессы инженеров практически не изменились. Переработали серверную часть: хранение данных, обновление ссылок и доставку данных. В таблице ниже приведены ключевые отличия старого решения от Pando.
| Характеристика | Традиционный сервер Git | Pando |
|---|---|---|
| Запись в ветки | Строгая координация на уровне всего репозитория: даже не связанные друг с другом ветки могут ждать друг друга | Ветки обновляются независимо; координация нужна только при работе с одной и той же ссылкой Ref |
| Модель согласованности | Согласованный снимок всего репозитория | Причинная согласованность; в пределах одной ветки гарантируется порядок операций и чтение собственных изменений |
| Доставка данных | Повторная упаковка и сжатие с учётом состояния клиента | Повторное использование Packfile, сохранённых при Push, с доставкой через кеш |
| Кеширование | Зависит от реализации | Региональный сервис кеширования; доля попаданий в кеш Packfile превышает 99% |
| Совместимость с клиентами | Стандартный Git | Стандартный Git; доставка через механизм packfile-uri |
Две ключевые идеи Pando
Первая — параллельная запись. Pando отказывается от поддержания единого согласованного снимка всего репозитория на определённый момент времени. Вместо этого версии каждой ветки ведутся независимо. Push в разные ветки могут выполняться параллельно, а конфликты нужно разрешать только для запросов, изменяющих одну и ту же ссылку Ref. Обратная сторона такого подхода: при одновременном чтении нескольких веток клиент может увидеть их состояния на разные моменты времени. В OpenAI считают этот компромисс подходящим для своих задач.
Вторая — повторное использование данных при чтении. Pando сохраняет каждый полученный при Push Packfile в Blob Store как неизменяемые данные. Когда другой клиент выполняет Fetch, сервер выбирает готовые Packfile на основе коммитов, которые у клиента уже есть и которые ему нужны, вместо того чтобы заново упаковывать данные. В фоновом режиме множество небольших Packfile также объединяются по уровням в более крупные наборы. Благодаря этому клиентам, которые долго не обновлялись, не приходится скачивать слишком много файлов.
По официальным данным эксплуатации, медианная задержка Push снизилась почти на 80%; ежедневно доставляется около 1 PB данных Git; пиковый объём доставки Packfile за час превышает 57 TB. Важно, что 1 PB — это объём доставленных данных: повторное чтение тех же данных тоже учитывается. Это не значит, что каждый день создаётся 1 PB нового кода.
Примечательно, что сам Pando тоже разрабатывался при участии агентов. По словам OpenAI, его основную архитектуру спроектировал один инженер, а в реализации участвовали несколько команд агентов. Для проверки использовались набор тестов на совместимость с Git и детерминированные симуляционные тесты. При этом компания не утверждала, что весь код был написан ИИ.
Влияние AI-программирования: узкое место смещается за пределы написания кода
Что это значит для разработчиков и команд
Самое интересное в истории Pando — не то, что OpenAI создала собственный бэкенд Git, а закономерность, которую это выявило: AI-программирование снижает стоимость генерации кода, а нагрузка перемещается дальше по цепочке разработки. Git стал лишь первым звеном, где это проявилось; ревью кода, тестирование и интеграция тоже испытывают нагрузку.
В статье о Codex Code Review OpenAI прямо признаёт, что всё больше PR ждут ревью. Ревьюерам сложно вовремя разобраться в исторически сложившихся ограничениях и оценить риски совместимости API. Поэтому Codex Code Review умеет читать правила ревью, заданные в файле AGENTS.md в репозитории. Это помогает защищать существующие контракты API, выявлять логи, которые могут раскрыть данные клиентов, и предотвращать нарушения интеграции с действующими сервисами.
Для обычных команд, использующих ИИ в разработке, это означает несколько конкретных изменений:
- Записывайте правила ревью: фиксируйте неявные ограничения команды в файлах правил, например AGENTS.md, чтобы AI-ревью могло на них опираться.
- Оставляйте запас мощностей для CI: когда агенты работают параллельно, количество задач CI может вырасти раньше, чем затраты на персонал. Заранее оцените возможности кэширования и лимиты параллельного выполнения.
- Пересмотрите метрики: учитывайте не только число коммитов и PR, но и время доставки изменений, а также долю неудачных изменений.
- Ставьте приёмку на первое место: от покрытия тестами, тестирования с имитацией зависимостей и тестов совместимости зависит, можно ли с уверенностью принимать изменения, созданные агентами.
Минимальный пример AI-ревью кода с несколькими моделями
Если вы хотите попробовать в своём репозитории ревью Diff по заданным правилам, можно быстро собрать прототип через OpenAI-совместимый API. Пример ниже считывает локальный Diff и просит модель проверить изменения по правилам:
import openai, subprocess

client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")
diff = subprocess.run(["git", "diff", "HEAD~1"], capture_output=True, text=True).stdout

resp = client.chat.completions.create(
    model="YOUR_MODEL",  # Замените на доступную на платформе модель для работы с кодом
    messages=[{"role": "user", "content": f"请审查以下改动,重点关注 API 兼容性和日志泄露风险:\n{diff}"}],
)
print(resp.choices[0].message.content)
Посмотреть полный код реализации (чтение правил из AGENTS.md и сравнение моделей)
import subprocess
from pathlib import Path
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Один ключ для вызова моделей разных поставщиков
)

def load_rules(path: str = "AGENTS.md") -> str:
    """Читает правила ревью из репозитория или возвращает правила по умолчанию"""
    p = Path(path)
    if p.exists():
        return p.read_text(encoding="utf-8")
    return "1. 不得破坏已有 API 契约\n2. 日志中不得输出客户数据\n3. 不得破坏已有服务集成"

def get_diff(base: str = "HEAD~1") -> str:
    """Получает Diff для ревью"""
    return subprocess.run(
        ["git", "diff", base], capture_output=True, text=True
    ).stdout

def review(diff: str, rules: str, model: str) -> str:
    """Вызывает модель для ревью изменений кода по правилам"""
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": f"你是严格的代码审查者,请依据以下仓库规则审查:\n{rules}"},
            {"role": "user", "content": f"待审查 Diff:\n{diff}\n请逐条列出风险点和修改建议。"},
        ],
        max_tokens=1500,
    )
    return resp.choices[0].message.content

if __name__ == "__main__":
    rules, diff = load_rules(), get_diff()
    # Замените названия моделей на те, которые хотите сравнить, и посмотрите, чем отличаются результаты ревью
    for model in ["MODEL_A", "MODEL_B"]:
        print(f"===== {model} =====")
        print(review(diff, rules, model))
🚀 Совет для быстрого старта: при создании прототипа AI-ревью можно получить бесплатный тестовый лимит через APIYI apiyi.com. С одним API-ключом можно вызывать модели OpenAI, Claude, Gemini и других поставщиков и сравнивать качество их ревью по правилам вашего репозитория.
Влияние на отрасль
The New Stack отмечает, что OpenAI одной из первых начала интенсивно использовать ИИ-агентов для программирования. Нагрузка на инфраструктуру, с которой столкнулась компания, может указывать на проблемы, ожидающие другие крупные предприятия и платформы для хостинга кода. Это прогноз издания, а не доказательство того, что GitHub и GitLab уже столкнулись с такими же сбоями.
Мнения сообщества разработчиков тоже разделились. Оптимисты считают, что снижение стоимости разработки сделает возможными многие небольшие проекты, за которые раньше не стоило браться. Скептики возражают: большее число коммитов не означает, что ПО стало ценнее, а если ревью и тестирование не успевают за разработкой, поставка продукта может и не ускориться. Другие комментаторы напоминают, что проблемы масштаба в больших монорепозиториях появились задолго до эпохи ИИ.
Как понимать данные о Codex: пять показателей, которые нельзя смешивать
Обсуждая результаты ИИ-программирования, чаще всего ошибаются, смешивая разные показатели. Таблица ниже поможет разобраться, что каждый из них показывает, а чего по нему заключить нельзя.
| Показатель | Что измеряет | Данные в этой новости |
|---|---|---|
| Число коммитов | Частоту фиксации изменений в системе контроля версий | Ожидаемый квартальный рост — +2,442%; доступно только относительное значение |
| Число PR | Активность по предложению и слиянию изменений | Число PR в неделю выросло более чем вдвое по сравнению с предыдущим Q4 |
| Число строк кода | Объём кода | Не раскрыто; его нельзя рассчитать по росту числа коммитов |
| Lead Time | Время от начала работы над изменением до его поставки | Не раскрыто |
| Доля неудачных изменений | Долю изменений, вызвавших сбои после выпуска | Не раскрыта |
Случай Pando показывает, что нагрузка на инфраструктуру разработки OpenAI значительно выросла, а существующая инфраструктура Git стала узким местом. Но он не доказывает, что качество ПО или продуктивность разработчиков выросли во столько же раз, и не позволяет оценить, сколько инженеров заменил Codex.
Кроме того, Harness Engineering, о котором OpenAI рассказала в феврале 2026 года, — это отдельный эксперимент: примерно за пять месяцев команда создала проект объёмом порядка миллиона строк, начав с пустого репозитория, и за это время накопилось около 1,500 PR. Эти данные относятся к другому проекту и не связаны с Pando, но тоже отражают тенденцию: фокус работы инженеров смещается в сторону архитектуры, инструментов, циклов обратной связи и приёмки кода.
💡 Совет по выбору: если ваша команда тоже внедряет ИИ-агентов для программирования, сначала сравните работу разных моделей на небольшой выборке задач по генерации и ревью кода. Через единый интерфейс APIYI apiyi.com можно быстро переключаться между моделями и оценивать их на одном наборе тестовых случаев, прежде чем выбрать основную модель.
Частые вопросы FAQ
Q1: Codex действительно увеличил объём кода OpenAI в 24 раза?
Не совсем. Согласно официальным данным, «ожидается, что квартальное число коммитов, слитых в master, вырастет на 2442% по сравнению с первым кварталом 2024 года». Это прогноз, причём речь идёт о количестве коммитов, а не строк кода. Изменения в одном коммите могут быть как большими, так и маленькими, поэтому этот показатель не равен ни объёму кода, ни производительности.
Q2: Pando — это замена GitHub?
Нет. Pando — серверная платформа, совместимая со стандартным протоколом Git, которая используется только внутри OpenAI. По состоянию на 3 ноября 2026 года серверная часть, цены и дата её открытия не опубликованы. OpenAI открыла репозиторий с улучшенной версией Git-клиента, а часть изменений внесла в основной проект Git. Но это не означает, что серверная часть Pando стала открытой.
Q3: Нужно ли обычным командам перестраивать инфраструктуру Git, как это сделала OpenAI?
Большинству команд это не нужно. OpenAI работает с монорепозиторием огромного масштаба и высокой параллельной нагрузкой от агентов. Для малых и средних команд более вероятные узкие места — квоты CI, покрытие тестами и нехватка людей для ревью кода. Именно эти проблемы стоит решать в первую очередь.
Q4: Как недорого попробовать AI-ревью кода или рабочий процесс с Coding Agent?
Для начала можно собрать минимальный прототип с помощью OpenAI-совместимого интерфейса: прочитать Diff и файл с правилами по примеру кода из статьи, а затем передать их модели на проверку. Зарегистрируйтесь на APIYI apiyi.com, чтобы получить бесплатный лимит для тестирования, и замените base_url на `https://api.apiyi.com/v1`. С одним API-ключом вы сможете сравнить качество ревью у моделей разных разработчиков.
Q5: Не приведёт ли AI-программирование лишь к увеличению объёма некачественного кода?
Это один из главных вопросов в дискуссии сообщества, и окончательного ответа пока нет. OpenAI не опубликовала данные об изменении частоты дефектов, откатов или общих затрат на разработку, поэтому нельзя утверждать ни что качество повсеместно снизилось, ни что оно выросло. Разумнее всего отслеживать в своей команде и сроки поставки, и долю изменений, которые приводят к сбоям. Также можно подключить через APIYI apiyi.com несколько моделей для перекрёстного ревью — это снизит риск того, что одна модель пропустит проблему.
Codex и изменения в Git-инфраструктуре: главное
- Важно правильно понимать цифры: 2442% — это прогнозируемый рост числа коммитов за квартал в Q4 2026 года, а не рост количества строк кода.
- Рост заметно ускорился: после Q4 2025 года кривая резко пошла вверх, но рост начался ещё в 2024 году.
- Нагрузка связана с параллелизмом: Codex позволяет выполнять больше задач одновременно, а рост числа операций записи многократно увеличивает нагрузку на чтение со стороны CI.
- Старая система перестала справляться: с конца 2025 года Push и Fetch замедлились, а надёжность порой падала ниже 90%.
- Решение Pando: независимая запись в ветки, повторное использование и кэширование Packfile снизили медианную задержку Push почти на 80%.
- Узкие места сместились дальше по цепочке: новыми ограничениями стали ревью кода, тестирование, интеграция и доставка.
- С чего начать: используйте единый интерфейс APIYI apiyi.com, чтобы быстро создать прототип ревью с несколькими моделями.
Итоги
Изменения, которые Codex принёс в OpenAI, можно свести к трём пунктам:
- Масштаб: ожидается, что число коммитов за квартал в монорепозитории вырастет на 2442% по сравнению с Q1 2024 года. Количество PR тоже удваивается — активность по изменению кода значительно выросла.
- Инфраструктура: параллельная работа агентов приводит к появлению большего числа веток, операций Push и запросов на чтение со стороны CI. У старого Git-бэкенда возникли проблемы с производительностью и надёжностью, поэтому OpenAI примерно за 10 недель создала Pando.
- Инженерные процессы: написание кода больше не самый медленный этап. Именно возможности команды по ревью, тестированию и доставке определяют, принесёт ли AI-программирование реальную пользу.
Большинству команд вместо погони за количеством коммитов стоит сначала усилить приёмку и ревью, а затем постепенно увеличивать число параллельно работающих агентов. Если вы хотите быстро проверить процесс AI-ревью или работу Coding Agent, попробуйте через APIYI apiyi.com сравнить реальные результаты нескольких моделей в рамках бесплатного лимита.
📚 Источники
- Scaling Git at OpenAI: официальная техническая статья OpenAI о Pando (2026-11-02)
- Ссылка:
openai.com/index/scaling-git-at-openai -
Описание: основной источник фактов и данных о поквартальном росте числа коммитов
-
Custom Code Review rules for Codex: блог разработчиков OpenAI (2026-07-20)
- Ссылка:
developers.openai.com/blog/custom-code-review-rules-for-codex -
Описание: источник данных об удвоении числа PR в неделю и правил ревью в AGENTS.md
-
Harness engineering: отдельный эксперимент OpenAI по разработке с автономным агентом (2026-02-11)
- Ссылка:
openai.com/index/harness-engineering -
Описание: отдельный пример, который помогает понять, как меняется роль инженера; не связан с проектом Pando
-
OpenAI Git Fork: публичный репозиторий Git-клиента, поддерживаемого OpenAI
- Ссылка:
github.com/openai/git -
Описание: здесь можно изучить улучшения клиента, включая packfile-uri
-
Статья The New Stack: взгляд внешнего издания на Pando (2026-11-02)
- Ссылка:
thenewstack.io - Описание: источник для оценки отраслевых тенденций
Автор: техническая команда APIYI
Обсуждение технических вопросов: свяжитесь с нами на главной странице сайта APIYI. Дополнительные материалы по подключению моделей доступны в центре документации docs.apiyi.com