Anmerkung des Autors: OpenAI stellt mit Pando ein neues Git-Backend vor. Durch Codex soll die Zahl der vierteljährlichen Commits im Monorepo gegenüber Q1 2024 voraussichtlich um 2442 % steigen. Dieser Artikel zeigt, wie sich die Auswirkungen der KI-gestützten Programmierung von der Codegenerierung auf Git, CI und Code-Reviews übertragen.
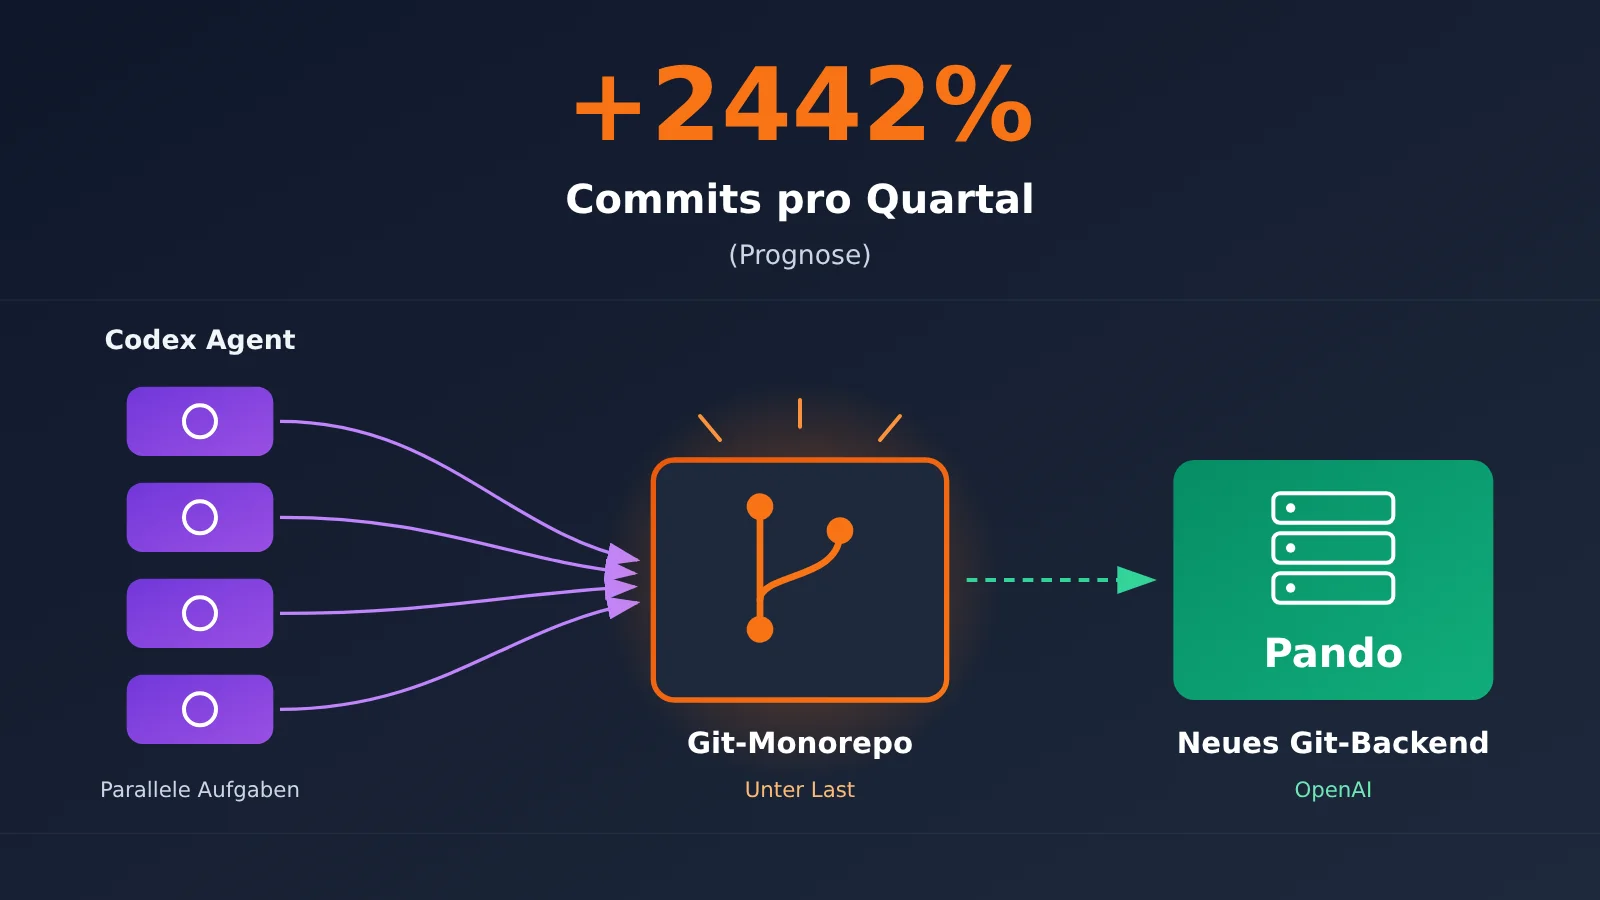
Am 2. November 2026 veröffentlichte OpenAI den technischen Artikel „Scaling Git at OpenAI“. Eine Grafik darin zeigt: Die Zahl der vierteljährlichen Commits im Monorepo von OpenAI soll in Q4 2026 gegenüber Q1 2024 voraussichtlich um 2442 % steigen. Um dem Druck durch die vielen gleichzeitigen Entwicklungsaufgaben mit Codex standzuhalten, entwickelte OpenAI ein neues Git-Backend namens Pando.
Das ist weder ein Gerücht noch ein Marketing-Slogan à la „KI vervielfacht die Codemenge um das 24-Fache“. Die Zahlen stammen aus dem offiziellen Engineering-Blog von OpenAI. Verfasst wurde der Artikel von Aaron Friel, Taylor Blau und Ted Nyman. Zwei Einschränkungen sind wichtig: Die 2442 % sind eine Prognose, Q4 ist noch nicht abgeschlossen. Gezählt werden Commits, die in den master-Branch zusammengeführt wurden – nicht Codezeilen und erst recht nicht die Produktivität.
Das nehmen Sie mit: Sie erfahren, wie Codex durch parallele Aufgaben den Umfang der Softwareentwicklung bei OpenAI verändert, warum dadurch die Git-Infrastruktur unter Druck gerät und wohin sich die Engpässe in der Softwareentwicklung verlagern.
Codex und die Git-Infrastruktur von OpenAI: Das Wichtigste im Überblick
Die folgende Tabelle fasst die wichtigsten Fakten zusammen. Alle Angaben stammen aus offiziellen Veröffentlichungen von OpenAI; nicht veröffentlichte Informationen sind entsprechend gekennzeichnet.
| Information | Details |
|---|---|
| Veröffentlichungsdatum | 2. November 2026, „Scaling Git at OpenAI“ |
| Herausgeber | OpenAI-Engineering-Team (Aaron Friel, Taylor Blau, Ted Nyman) |
| Kerninhalt | Neues Git-Server-Backend Pando, kompatibel mit dem Standard-Git-Protokoll und gängigen Clients |
| Hintergrund | Codex erhöhte die Parallelität in der Entwicklung, das bisherige Git-System bekam Performance- und Zuverlässigkeitsprobleme |
| Produktionsstart | Seit April 2026 im Produktionseinsatz, vom Projektstart bis zur Inbetriebnahme rund 10 Wochen |
| Wichtigste Ergebnisse | Mediane Push-Latenz um fast 80 % gesunken, täglich fast 1 PB Git-Daten ausgeliefert |
| Öffentliche Verfügbarkeit | Nur intern bei OpenAI im Einsatz; keine Angaben zu einem öffentlichen Server, Preisen oder einem Veröffentlichungstermin |
Quartalsweises Commit-Wachstum durch Codex im Überblick
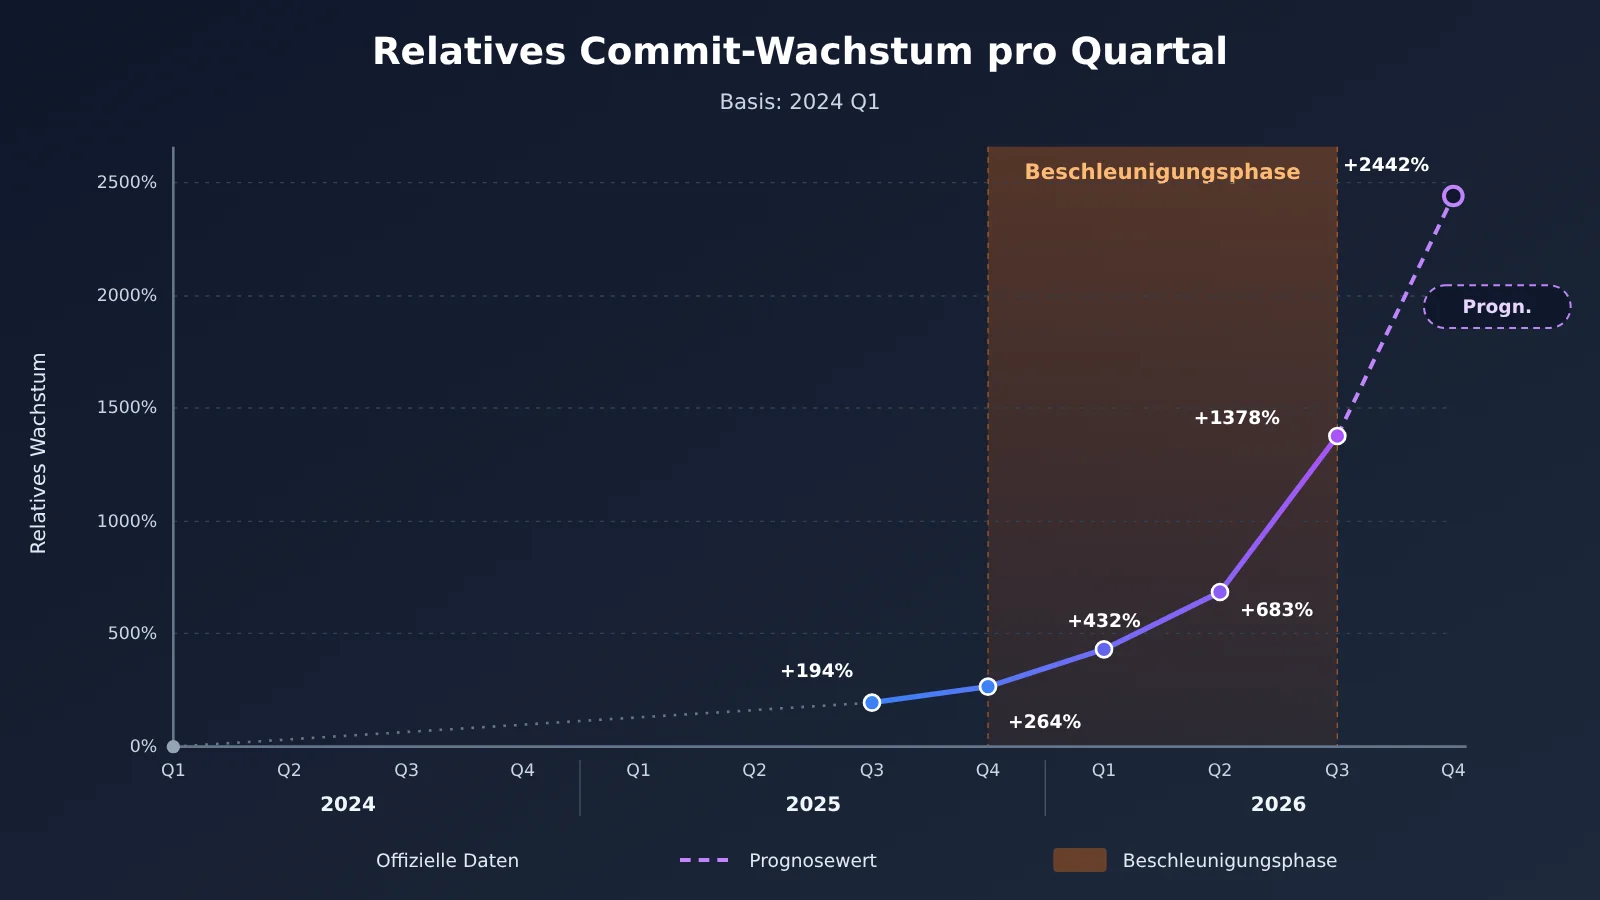
Viele Berichte nennen nur den Wert von 2.442 %. Die vollständige Quartalsreihe zeigt ein differenzierteres Bild. Die folgende Tabelle verwendet Q1 2024 als Basis und erfasst die Zahl der Commits pro Quartal, die in den master-Branch des Monorepos von OpenAI gemergt wurden.
| Quartal | Wachstum gegenüber Q1 2024 | Ungefähres Vielfaches des Basiswerts |
|---|---|---|
| 2024 Q2 | +35 % | 1,35 |
| 2024 Q4 | +98 % | 1,98 |
| 2025 Q2 | +194 % | 2,94 |
| 2025 Q4 | +264 % | 3,64 |
| 2026 Q1 | +432 % | 5,32 |
| 2026 Q2 | +683 % | 7,83 |
| 2026 Q3 | +1.378 % | 14,78 |
| 2026 Q4 | +2.442 % (Prognose) | 25,42 |
Aus diesen Daten lassen sich drei Dinge ablesen. Erstens gab es schon von 2024 bis 2025 Wachstum, sodass sich nicht der gesamte Anstieg auf Codex zurückführen lässt. Zweitens steigt die Kurve von +264 % in Q4 2025 auf +1.378 % in Q3 2026 deutlich steiler an. Diese Beschleunigung passt zu dem von OpenAI beschriebenen Trend paralleler Entwicklung durch Agenten. Drittens hat OpenAI nur relative Wachstumsraten veröffentlicht, nicht die absoluten Commit-Zahlen pro Quartal.
Eine weitere Kennzahl weist trotz anderer Berechnungsgrundlage in dieselbe Richtung. Am 20. Juli 2026 erwähnte OpenAI im Entwicklerblog zur Einführung von Codex Code Review, dass sich die Zahl der internen Pull Requests pro Woche gegenüber dem vorherigen vierten Quartal mehr als verdoppelt hatte. Diese Kennzahl und das quartalsweise Commit-Wachstum unterscheiden sich sowohl in ihrer Berechnungsgrundlage als auch im betrachteten Zeitraum. Sie lassen sich weder addieren noch ineinander umrechnen. Beide zeigen aber, dass die Aktivitäten rund um Codeänderungen schnell zunehmen.
Wie Codex die Git-Infrastruktur stärker belastet
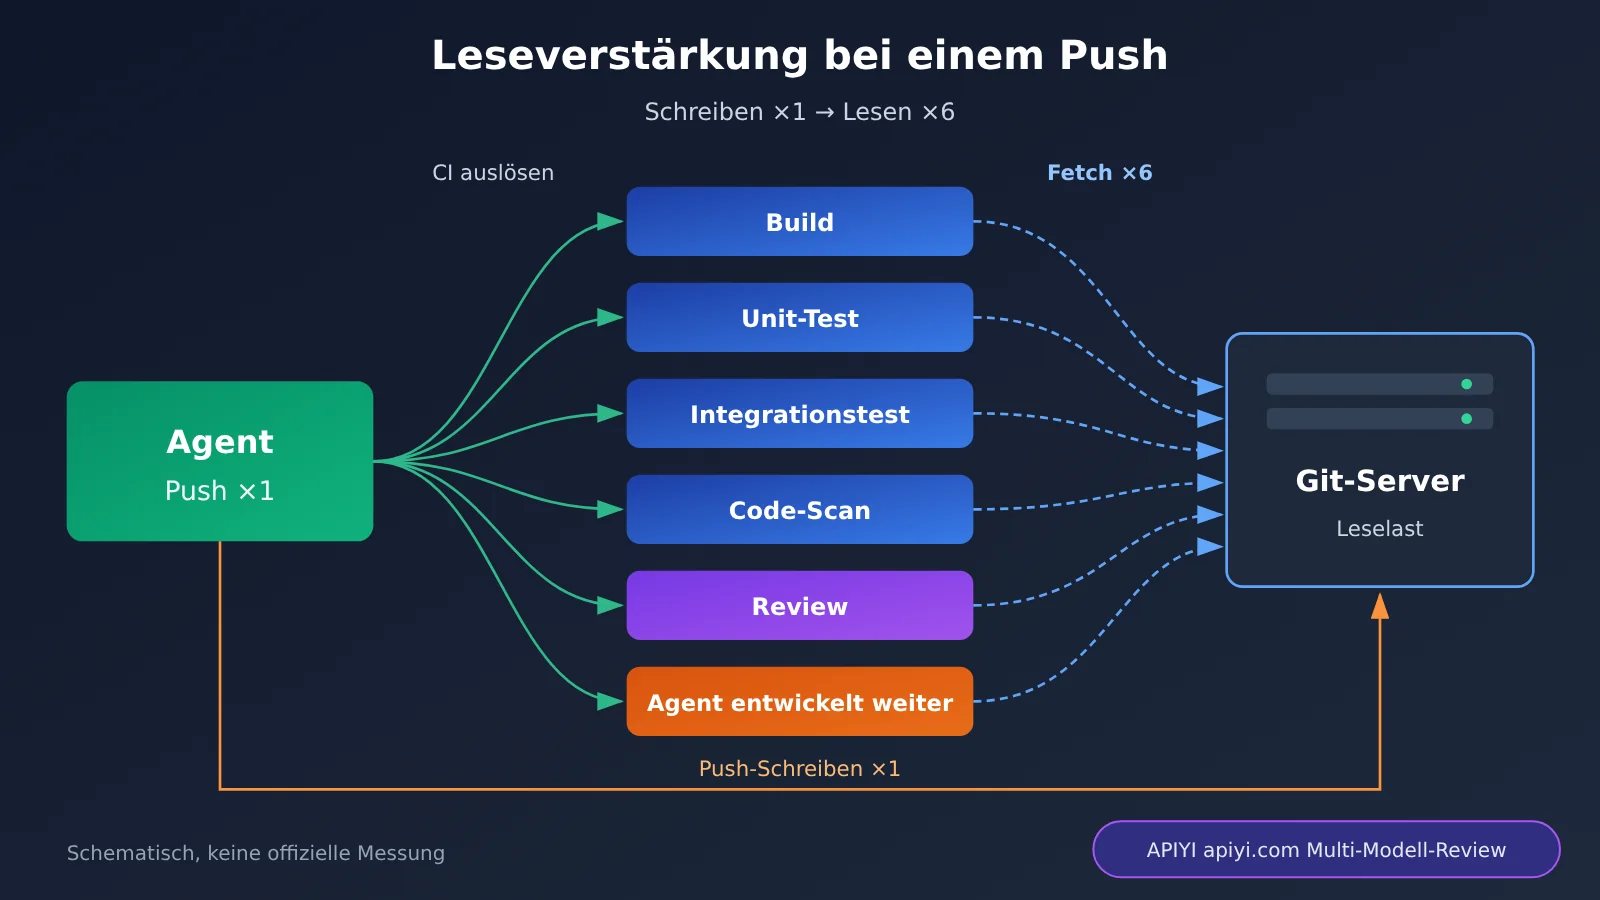
Auf den ersten Blick betrifft „KI schreibt schneller Code“ nur die Entwickler selbst. OpenAI beschreibt jedoch eine weitere Dimension: Codex erhöht die Anzahl gleichzeitig laufender Aufgaben im gesamten Entwicklungssystem. Ein Entwickler kann mehrere Agents parallel an voneinander unabhängigen Funktionen arbeiten lassen. Jeder Agent erzeugt Branches und Commits und führt Pushes aus. Diese Aktionen lösen wiederum eine Reihe automatisierter Lesevorgänge aus.
Die folgende Tabelle fasst diese Kausalkette anhand der Beschreibung von OpenAI zusammen.
| Phase | Was passiert? | Auswirkung auf die Git-Infrastruktur |
|---|---|---|
| A. Geringerer Ausführungsaufwand | Entwickler lassen mehrere Agents gleichzeitig unabhängige Funktionen bearbeiten | Die Zahl der Entwicklungsaufgaben steigt |
| B. Mehr Parallelität | Mehr Branches, Commits und Git-Pushes | Mehr Schreibanfragen und Branch-Updates |
| C. Verstärkung durch Pipelines | Ein Push löst mehrere CI-Builds, Tests und Scans aus | Derselbe Commit wird wiederholt per Fetch abgerufen |
| D. Gemeinsame Infrastruktur unter Druck | Merges, Statussynchronisierung und Bereitstellung von Versionsdaten nehmen gleichzeitig zu | Push und Fetch werden langsamer, Merges schlagen fehl |
| E. Verschiebung des Engpasses | Modelle schreiben schneller Code, aber Git, CI und Review werden nicht im gleichen Maße skaliert | Nachgelagerte Schritte bremsen die Auslieferung |
Ein Szenario zur Veranschaulichung der Lastverstärkung
Das folgende Beispiel dient nur der Veranschaulichung; die Zahlen sind keine Messwerte von OpenAI. Angenommen, ein Push löst 6 CI-Jobs aus und jeder Job ruft den Code einmal per Fetch ab. Dann können 100 Pushes rund 600 Codeabrufe nach sich ziehen. Wenn Agents die Zahl der Pushes vervielfachen, steigt auch das Lesevolumen entsprechend.
Die tatsächliche Zahl der Anfragen hängt von CI-Caches, der Wiederverwendung von Jobs und der Build-Architektur ab. Die Richtung ist jedoch klar: Mehr Schreibvorgänge führen zu einem verstärkten Anstieg der Lesevorgänge. Genau hier stößt der Git-Server zuerst an seine Grenzen. OpenAI weist ausdrücklich darauf hin, dass derselbe Commit von mehreren CI-Jobs, Forschungsaufgaben und Entwicklungsumgebungen wiederholt abgerufen werden kann.
Was mit OpenAIs altem Git-System nicht mehr funktionierte
OpenAI berichtete, dass die Systeme hinter dem Monorepo ab Ende 2025 zunehmend Schwierigkeiten hatten, die steigende Last zu bewältigen. Konkret wurden Git-Fetch und -Push langsamer, Merges schlugen fehl und die Zuverlässigkeit der Infrastruktur lag zeitweise unter 90 %.
Wichtig ist dabei, „unter 90 %“ richtig einzuordnen: Die Angabe beschreibt die Zuverlässigkeit des Systems in bestimmten Zeiträumen. Wie genau sie gemessen wurde und wie der vollständige zeitliche Verlauf aussah, wurde nicht veröffentlicht. Daraus lässt sich weder ableiten, dass „10 % des Codes fehlerhaft“ waren, noch dass „mehr als 10 % der Commits bei OpenAI fehlschlugen“.
Aus technischer Sicht hatte die alte Architektur zwei strukturelle Engpässe:
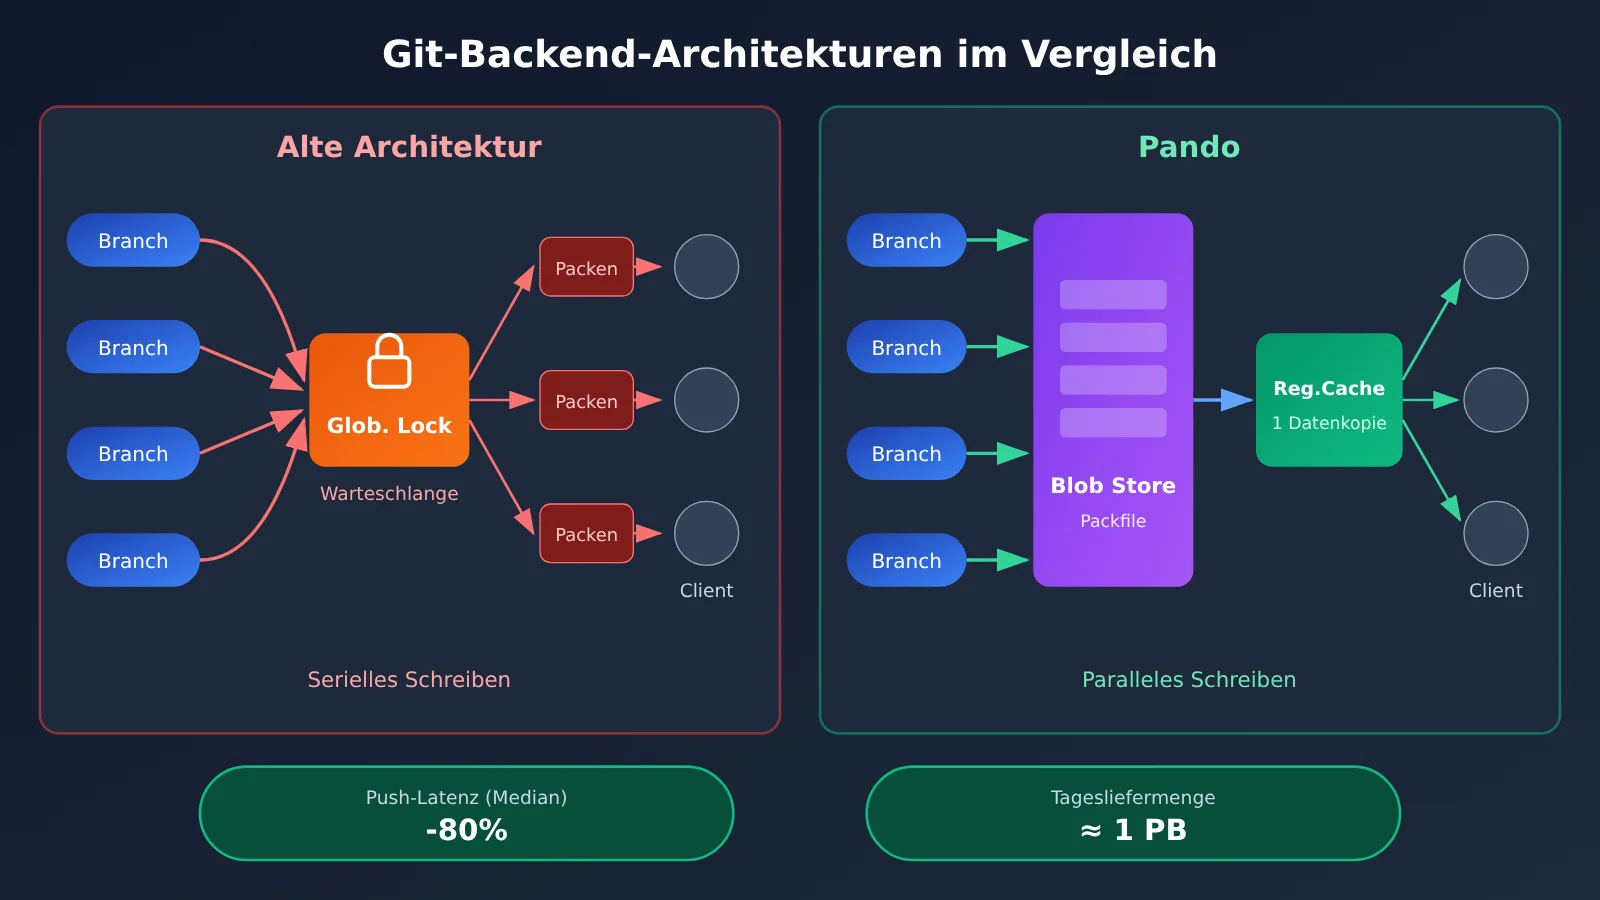
- Branch-Updates erfordern eine globale Koordination: Viele herkömmliche verteilte Git-Dienste müssen einen konsistenten Zustand aller Referenzen im gesamten Repository aufrechterhalten. Selbst wenn zwei Agenten völlig unabhängige Branches ändern, können sie sich auf demselben Koordinationspfad gegenseitig ausbremsen.
- Download-Pakete werden mehrfach berechnet: Da die Clients unterschiedliche Teile der Git-Historie bereits vorliegen haben, muss der Server die Objekte häufig für jeden Client einzeln durchlaufen, bündeln und komprimieren. Wenn mehrere Agenten dieselbe Version lesen, werden diese aufwendigen Schritte wiederholt ausgeführt.
Solange menschliche Entwickler die Arbeit dominierten, waren diese beiden Einschränkungen noch hinnehmbar. Sobald aber zahlreiche Agenten und CI-Jobs gleichzeitig auf das System zugreifen, werden sie zu Engpässen.
Wie Pando den Git-Druck durch Codex abfedert
OpenAI hat Git nicht abgeschafft. Pando nutzt weiterhin das Standard-Git-Protokoll und herkömmliche Clients; die gewohnten Befehle und Arbeitsabläufe der Entwickler bleiben weitgehend unverändert. Neu gestaltet wurden die serverseitige Speicherung, die Aktualisierung von Referenzen und die Datenbereitstellung. Die folgende Tabelle zeigt die wichtigsten Unterschiede zwischen der bisherigen Lösung und Pando.
| Aspekt | Herkömmlicher Git-Server | Pando |
|---|---|---|
| Schreiben in Branches | Starke Koordination über das gesamte Repository; auch unabhängige Branches können aufeinander warten | Unabhängige Aktualisierung der Branches; Koordination nur bei derselben Ref |
| Konsistenzmodell | Konsistenter Snapshot des gesamten Repositorys | Kausale Konsistenz; innerhalb eines Branches sind Reihenfolge und Lesen eigener Schreibvorgänge garantiert |
| Datenbereitstellung beim Lesen | Daten werden je nach Clientzustand neu gepackt und komprimiert | Beim Push gespeicherte Packfiles werden wiederverwendet und über Caches verteilt |
| Cache | Abhängig von der Implementierung | Regionaler Cache-Dienst mit einer Packfile-Trefferquote von über 99 % |
| Client-Kompatibilität | Standard-Git | Standard-Git, Bereitstellung über den packfile-uri-Mechanismus |
Die zwei Grundideen von Pando
Erstens: parallele Schreibvorgänge. Pando verzichtet auf einen konsistenten Snapshot des gesamten Repositorys zu einem einzigen Zeitpunkt. Stattdessen verwaltet jeder Branch seine Version unabhängig. Pushes auf unterschiedliche Branches können parallel laufen; Konflikte müssen nur bei Anfragen behandelt werden, die dieselbe Ref ändern. Der Nachteil: Liest ein Client mehrere Branches auf einmal, können diese aus unterschiedlichen Zeitpunkten stammen. Für den eigenen Anwendungsfall hält OpenAI diesen Kompromiss für angemessen.
Zweitens: Wiederverwendung beim Lesen. Pando speichert jedes beim Push empfangene Packfile als unveränderliche Daten im Blob Store. Wenn andere Clients einen Fetch ausführen, wählt der Server anhand der bereits vorhandenen und der angeforderten Commits passende Packfiles aus und liefert sie aus, statt die Daten neu zu packen. Im Hintergrund werden zudem viele kleine Packfiles stufenweise zu grösseren Einheiten zusammengeführt. So müssen Clients, die längere Zeit nicht aktualisiert wurden, nicht zu viele Dateien herunterladen.
OpenAI nennt folgende Produktionszahlen: Die mediane Push-Latenz sank um fast 80 %; täglich werden knapp 1 PB an Git-Daten ausgeliefert; der Spitzenwert bei der Packfile-Auslieferung lag bei über 57 TB in einer Stunde. Wichtig: Die 1 PB bezeichnen das ausgelieferte Datenvolumen. Auch wiederholte Lesezugriffe auf dieselben Daten zählen dazu – es entstehen also nicht täglich 1 PB neuer Code.
Bemerkenswert ist auch, dass Pando selbst unter Beteiligung von Agenten entwickelt wurde. Laut OpenAI entwarf ein einzelner Entwickler die Kernarchitektur, während mehrere Agenten-Teams an der Implementierung mitwirkten. Zur Überprüfung kamen eine Git-Kompatibilitätstestsuite und deterministische Simulationstests zum Einsatz. OpenAI behauptet allerdings nicht, dass der gesamte Code von KI geschrieben wurde.
Auswirkungen von KI-gestützter Programmierung: Der Engpass verschiebt sich vom Codeschreiben
Auswirkungen auf Entwickler und Teams
An der Geschichte von Pando ist weniger interessant, dass OpenAI ein eigenes Git-Backend gebaut hat. Entscheidend ist das Muster dahinter: KI-gestützte Programmierung senkt die Kosten der Codeerstellung, während sich der Druck auf nachgelagerte Schritte der Entwicklung verlagert. Git ist nur die erste Stelle, an der das sichtbar wird. Auch Code-Reviews, Tests und Integration stehen unter Druck.
OpenAI räumt im Artikel zu Codex Code Review ein, dass immer mehr PRs auf eine Prüfung warten. Für Reviewer ist es schwierig, historische Randbedingungen rechtzeitig nachzuvollziehen und Risiken für die API-Kompatibilität einzuschätzen. Deshalb kann Codex Code Review die in AGENTS.md definierten Review-Regeln eines Repositories lesen. Sie helfen dabei, bestehende API-Verträge zu schützen, Logs mit möglichen Kundendatenlecks zu erkennen und Störungen bestehender Service-Integrationen zu vermeiden.
Für KI-Entwicklungsteams bedeutet das einige konkrete Anpassungen:
- Review-Regeln dokumentieren: Implizite Vorgaben des Teams in Regeldateien wie AGENTS.md festhalten, damit KI-gestützte Reviews eine verlässliche Grundlage haben.
- Reserven für CI einplanen: Wenn Agenten parallel arbeiten, kann die Zahl der CI-Jobs schneller steigen als die Personalkosten. Cache und Parallelitätskontingente sollten daher frühzeitig überprüft werden.
- Kennzahlen neu auswählen: Nicht nur die Anzahl der Commits oder PRs betrachten, sondern auch die Lieferzeit und die Fehlerrate bei Änderungen.
- Abnahmefähigkeit priorisieren: Testabdeckung, Tests mit simulierten Komponenten und Kompatibilitätstests entscheiden darüber, ob sich die Ergebnisse der Agenten mit gutem Gewissen zusammenführen lassen.
Minimalbeispiel für KI-Code-Reviews mit mehreren Modellen
Wenn Sie in Ihrem eigenen Repository ausprobieren möchten, wie sich ein Diff anhand von Regeln überprüfen lässt, können Sie mit einer OpenAI-kompatiblen Schnittstelle schnell einen Prototyp erstellen. Das folgende Beispiel liest den lokalen Diff und lässt das Modell ihn anhand von Regeln überprüfen:
import openai, subprocess

client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")
diff = subprocess.run(["git", "diff", "HEAD~1"], capture_output=True, text=True).stdout

resp = client.chat.completions.create(
    model="YOUR_MODEL",  # Durch ein auf der Plattform verfügbares Programmiermodell ersetzen
    messages=[{"role": "user", "content": f"请审查以下改动,重点关注 API 兼容性和日志泄露风险:\n{diff}"}],
)
print(resp.choices[0].message.content)
Vollständige Implementierung anzeigen (AGENTS.md-Regeln einlesen und mehrere Modelle vergleichen)
import subprocess
from pathlib import Path
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Modelle verschiedener Anbieter mit einem Schlüssel aufrufen
)

def load_rules(path: str = "AGENTS.md") -> str:
    """Liest die Review-Regeln aus dem Repository oder gibt Standardregeln zurück."""
    p = Path(path)
    if p.exists():
        return p.read_text(encoding="utf-8")
    return "1. 不得破坏已有 API 契约\n2. 日志中不得输出客户数据\n3. 不得破坏已有服务集成"

def get_diff(base: str = "HEAD~1") -> str:
    """Ruft den zu überprüfenden Diff ab."""
    return subprocess.run(
        ["git", "diff", base], capture_output=True, text=True
    ).stdout

def review(diff: str, rules: str, model: str) -> str:
    """Ruft das Modell auf, um Codeänderungen anhand der Regeln zu überprüfen."""
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": f"你是严格的代码审查者,请依据以下仓库规则审查:\n{rules}"},
            {"role": "user", "content": f"待审查 Diff:\n{diff}\n请逐条列出风险点和修改建议。"},
        ],
        max_tokens=1500,
    )
    return resp.choices[0].message.content

if __name__ == "__main__":
    rules, diff = load_rules(), get_diff()
    # Durch die Namen der zu vergleichenden Modelle ersetzen und die Review-Ergebnisse vergleichen
    for model in ["MODEL_A", "MODEL_B"]:
        print(f"===== {model} =====")
        print(review(diff, rules, model))
🚀 Tipp für den schnellen Einstieg: Für einen KI-Review-Prototyp können Sie über APIYI apiyi.com kostenloses Testguthaben erhalten. Mit demselben API-Schlüssel lassen sich Modelle wie OpenAI, Claude und Gemini aufrufen. So können Sie vergleichen, wie gut die Modelle Ihre Repository-Regeln beim Review berücksichtigen.
Auswirkungen auf die Branche
The New Stack ordnet OpenAI als frühen Intensivnutzer von Coding Agents ein. Der Druck auf die Infrastruktur könnte demnach ein Vorgeschmack auf Probleme sein, mit denen künftig auch andere grosse Unternehmen und Code-Hosting-Plattformen konfrontiert werden. Das ist eine Trendprognose des Mediums und kein Beleg dafür, dass bei GitHub oder GitLab bereits dieselben Störungen aufgetreten sind.
Auch in der Entwickler-Community gehen die Meinungen auseinander. Optimisten erwarten, dass sinkende Kosten für die Programmierung viele kleine Projekte möglich machen, die sich bisher nicht gelohnt hätten. Kritiker halten dagegen, dass mehr Commits nicht automatisch mehr Softwarewert bedeuten. Wenn Reviews und Tests nicht Schritt halten, wird die Auslieferung insgesamt nicht unbedingt schneller. Andere weisen darauf hin, dass Skalierungsprobleme grosser Monorepos schon vor dem KI-Zeitalter existierten.
Codex-Zahlen richtig verstehen: Fünf Kennzahlen, die man nicht verwechseln sollte
Bei der Diskussion über die Wirkung von KI-gestützter Programmierung werden häufig unterschiedliche Kennzahlen vermischt. Die folgende Tabelle zeigt, was die einzelnen Zahlen aussagen können – und was nicht.
| Kennzahl | Was sie misst | Situation in dieser Meldung |
|---|---|---|
| Anzahl der Commits | Häufigkeit von Versions-Commits | Für das Quartal wird ein Wachstum von +2.442 % erwartet; es liegt nur ein relativer Wert vor |
| Anzahl der PRs | Änderungsvorschläge und Merge-Aktivitäten | Die Zahl der wöchentlichen PRs hat sich gegenüber dem vorherigen Q4 mehr als verdoppelt |
| Codezeilen | Umfang des Codes | Nicht veröffentlicht; lässt sich nicht aus dem Wachstum der Commits ableiten |
| Lead Time | Zeit vom Beginn einer Änderung bis zur Auslieferung | Nicht veröffentlicht |
| Änderungsfehlerrate | Anteil der Änderungen, die nach dem Deployment Störungen verursachen | Nicht veröffentlicht |
Der Pando-Fall belegt, dass die Arbeitslast durch die Codeentwicklung bei OpenAI deutlich gestiegen ist und die bestehende Git-Infrastruktur an ihre Grenzen gestossen ist. Er belegt nicht, dass Softwarequalität oder Entwicklerproduktivität im gleichen Verhältnis gestiegen sind. Auch lässt sich daraus nicht abschätzen, wie viele Entwickler Codex ersetzt hat.
Das im Februar 2026 von OpenAI vorgestellte Harness Engineering war ein weiteres, unabhängiges Experiment: Ausgehend von einem leeren Repository entstand in rund fünf Monaten ein Projekt in der Grössenordnung von einer Million Codezeilen mit insgesamt etwa 1.500 PRs. Diese Zahlen stammen aus einem anderen Projekt und haben keinen Bezug zu Pando. Sie spiegeln aber denselben Trend wider: Der Schwerpunkt der Arbeit von Entwicklern verlagert sich hin zu Architektur, Toolchain, Feedbackschleifen und Codeabnahme.
💡 Empfehlung zur Auswahl: Wenn euer Team ebenfalls Coding Agents einführt, vergleicht zunächst in kleinem Rahmen, wie verschiedene Modelle bei der Codegenerierung und beim Review abschneiden. Über die einheitliche Schnittstelle von APIYI auf apiyi.com könnt ihr schnell zwischen Modellen wechseln und sie mit denselben Testfällen vergleichen, bevor ihr euch für ein Hauptmodell entscheidet.
Häufige Fragen (FAQ)
Q1: Hat Codex die Menge an Code bei OpenAI wirklich um das 24-Fache erhöht?
So lässt sich das nicht sagen. Die offizielle Angabe lautet: „Die Anzahl der pro Quartal in master zusammengeführten Commits wird voraussichtlich um 2442 % gegenüber Q1 2024 steigen.“ Das ist eine Prognose und zählt Commits, nicht Codezeilen. Ein Commit kann kleine oder grosse Änderungen enthalten. Die Zahl sagt daher weder direkt etwas über die Codemenge noch über die Produktivität aus.
Q2: Ist Pando eine Alternative zu GitHub?
Nein. Pando ist ein Server-Backend, das mit dem Standard-Git-Protokoll kompatibel ist und nur intern bei OpenAI eingesetzt wird. Stand 3. November 2026 gibt es weder einen öffentlich verfügbaren Server noch Preise oder einen Termin für die Freigabe. OpenAI hat das Repository eines verbesserten Git-Clients veröffentlicht und einige Änderungen an das Git-Projekt zurückgegeben. Das bedeutet aber nicht, dass der Pando-Server als Open Source verfügbar ist.
Q3: Müssen gewöhnliche Teams ihre Git-Infrastruktur wie OpenAI neu aufbauen?
Die meisten Teams müssen das nicht. OpenAI arbeitet mit einem extrem grossen Monorepo und vielen gleichzeitig aktiven Agents. Bei kleinen und mittleren Teams liegen die Engpässe meist eher bei CI-Kontingenten, Testabdeckung und verfügbaren Kapazitäten für die Code-Review. Dort sollten sie zuerst ansetzen.
Q4: Wie lassen sich KI-Code-Reviews oder Coding-Agent-Abläufe kostengünstig ausprobieren?
Ein guter Anfang ist ein minimaler Prototyp mit einer OpenAI-kompatiblen Schnittstelle. Er liest wie im Codebeispiel dieses Artikels den Diff und die Regeldatei ein und übergibt sie zur Prüfung an ein Modell. Nach der Registrierung bei APIYI über apiyi.com erhalten Sie ein kostenloses Testguthaben. Setzen Sie `base_url` auf `https://api.apiyi.com/v1`, um mit demselben API-Schlüssel die Review-Ergebnisse verschiedener Modelle zu vergleichen.
Q5: Produziert KI-gestütztes Programmieren am Ende nur mehr Code von geringer Qualität?
Genau darüber wird in der Community diskutiert; eine endgültige Antwort gibt es bisher nicht. OpenAI hat weder Fehlerraten und Rollback-Raten noch Änderungen der Netto-Entwicklungskosten veröffentlicht. Deshalb lässt sich weder eine generelle Verschlechterung noch eine generelle Verbesserung der Qualität behaupten. Ein sinnvoller Ansatz ist, im eigenen Team sowohl die Durchlaufzeit als auch die Fehlerrate von Änderungen zu beobachten. Über APIYI auf apiyi.com lassen sich zudem mehrere Modelle für gegenseitige Reviews einbinden. Das verringert das Risiko, dass ein einzelnes Modell Fehler übersieht.
Codex und Veränderungen der Git-Infrastruktur: Das Wichtigste in Kürze
- Zahlen richtig einordnen: 2442 % ist das prognostizierte Wachstum der Commits im Quartal Q4 2026, nicht der Codezeilen.
- Das Wachstum beschleunigt sich deutlich: Nach Q4 2025 steigt die Kurve steil an, gewachsen ist sie aber bereits seit 2024.
- Der Druck entsteht durch Parallelität: Codex ermöglicht mehr parallele Aufgaben. Das Wachstum der Schreibzugriffe verstärkt sich bei den Lesezugriffen der CI.
- Das alte System stieß an seine Grenzen: Ab Ende 2025 wurden Push und Fetch langsamer, die Zuverlässigkeit lag zeitweise unter 90 %.
- Pandos Lösung: Branches unabhängig voneinander beschreiben, Packfiles wiederverwenden und cachen. Dadurch sank die mediane Push-Latenz um knapp 80 %.
- Der Engpass verlagert sich: Code-Review, Tests, Integration und Auslieferung werden zu den neuen begrenzenden Faktoren.
- Tipp für den Einstieg: Über die einheitliche Schnittstelle von APIYI apiyi.com lässt sich schnell ein Review-Prototyp mit mehreren Modellen aufbauen.
Zusammenfassung
Die Veränderungen, die Codex bei OpenAI ausgelöst hat, lassen sich auf drei Punkte reduzieren:
- Größenordnung: Die Zahl der Commits pro Quartal im Monorepo wird gegenüber Q1 2024 voraussichtlich um 2442 % steigen. Auch die Zahl der PRs verdoppelt sich – die Aktivität rund um Codeänderungen nimmt also stark zu.
- Infrastruktur: Parallele Agenten erzeugen mehr Branches, Pushes und CI-Lesezugriffe. Das alte Git-Backend bekam Leistungs- und Zuverlässigkeitsprobleme. OpenAI entwickelte deshalb in rund 10 Wochen Pando.
- Entwicklungsprozess: Das Schreiben von Code ist nicht mehr der langsamste Schritt. Die Kapazität für Reviews, Tests und Auslieferung entscheidet darüber, ob KI-gestützte Programmierung tatsächlich Mehrwert bringt.
Für die meisten Teams ist es sinnvoller, zunächst ihre Abnahme- und Review-Kapazitäten auszubauen, statt möglichst viele Commits anzustreben. Anschließend können sie die Zahl paralleler Agenten schrittweise erhöhen. Wer AI-Review- oder Coding-Agent-Prozesse schnell testen möchte, kann über APIYI apiyi.com mit dem kostenlosen Guthaben die Leistung verschiedener Modelle vergleichen.
📚 Quellen
- Scaling Git at OpenAI: Offizieller technischer Beitrag von OpenAI zu Pando (2026-11-02)
- Link:
openai.com/index/scaling-git-at-openai -
Hinweis: Hauptquelle für die Fakten und die Daten zum quartalsweisen Commit-Wachstum in diesem Artikel
-
Custom Code Review rules for Codex: Entwicklerblog von OpenAI (2026-07-20)
- Link:
developers.openai.com/blog/custom-code-review-rules-for-codex -
Hinweis: Quelle für die Verdopplung der wöchentlichen PR-Zahl und die Review-Regeln in AGENTS.md
-
Harness engineering: Eigenständiges OpenAI-Experiment zur Agent-Entwicklung (2026-02-11)
- Link:
openai.com/index/harness-engineering -
Hinweis: Eigenständiges Beispiel für den Wandel der Rolle von Entwicklern, ohne Bezug zum Pando-Projekt
-
OpenAI Git Fork: Öffentliches Repository des von OpenAI gepflegten Git-Clients
- Link:
github.com/openai/git -
Hinweis: Informationen zu Client-Verbesserungen wie packfile-uri
-
Bericht von The New Stack: Einordnung von Pando durch ein externes Medium (2026-11-02)
- Link:
thenewstack.io - Hinweis: Referenz für die Einschätzung von Branchentrends
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI. Weitere Informationen zur Modellanbindung finden Sie im Dokumentationszentrum unter docs.apiyi.com.