作者注:OpenAI 披露新 Git 后端 Pando。Codex 推动单体仓库季度提交量预计较 2024 Q1 增长 2442%。本文梳理 AI 编程的影响如何从代码生成一路传导到 Git、CI 与代码审查。
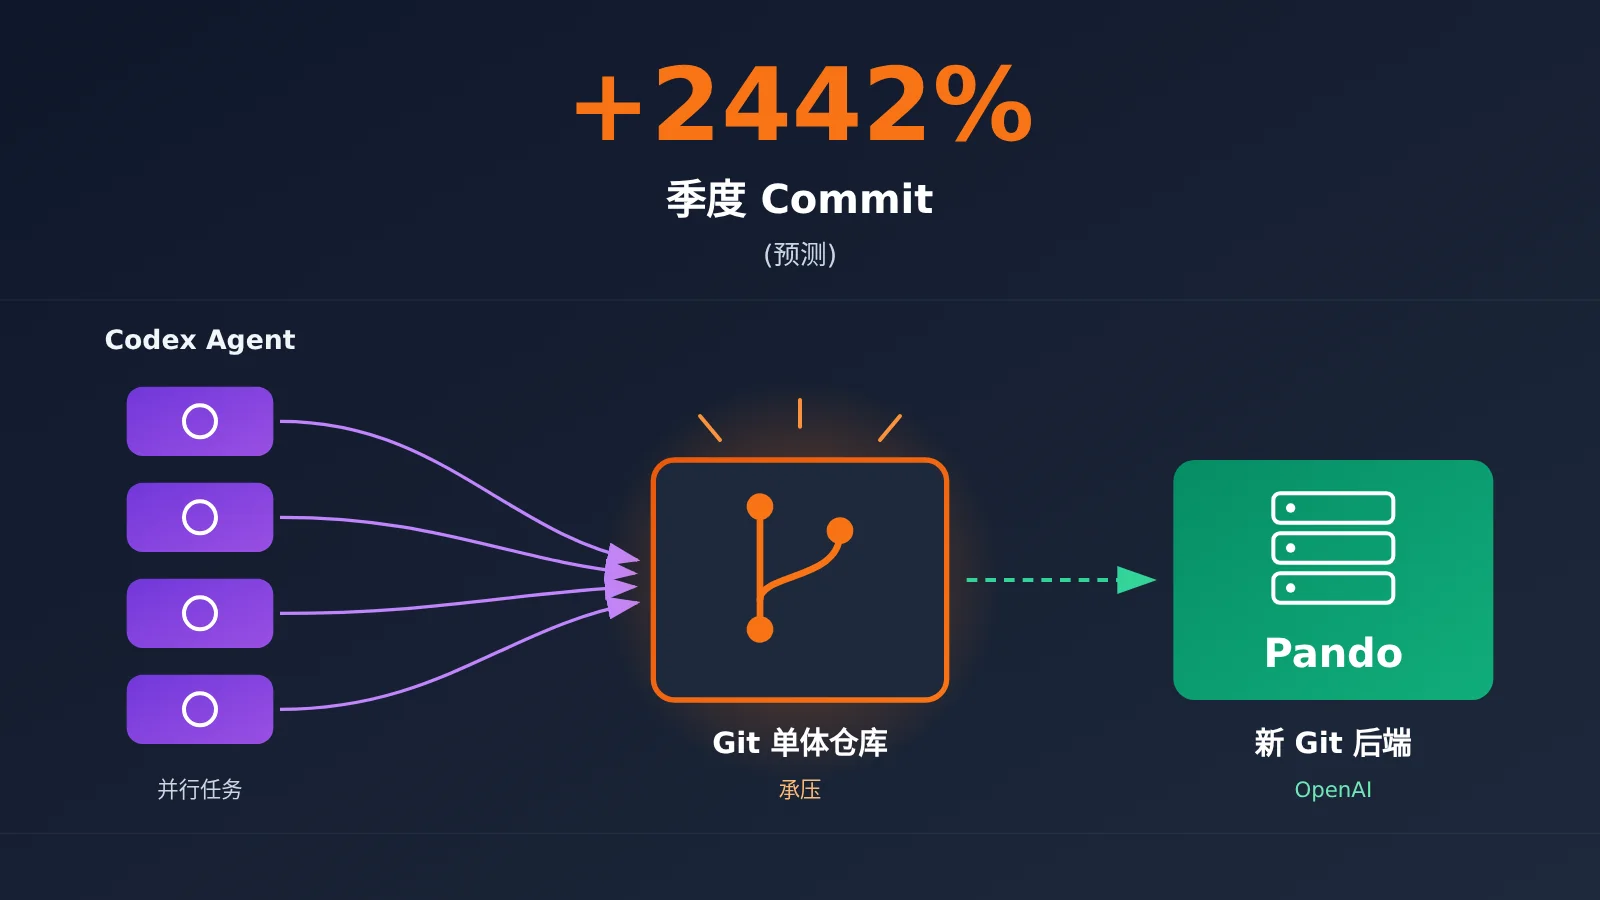
2026 年 11 月 2 日,OpenAI 发表技术文章《Scaling Git at OpenAI》。文中图表显示,OpenAI 单体仓库 2026 Q4 的季度 Commit 量预计较 2024 Q1 增长 2442%。为了接住 Codex 带来的并发开发压力,OpenAI 重建了一套 Git 后端,命名为 Pando。
这不是坊间传言,也不是“AI 让代码量暴涨 24 倍”的营销口号。 这些数据来自 OpenAI 官方工程博客,作者是 Aaron Friel、Taylor Blau 和 Ted Nyman 三位技术人员。需要先说明两点:2442% 是预测值,Q4 尚未结束;统计对象是合并到 master 分支的 Commit 数量,不是代码行数,更不是生产率。
核心价值:读完本文,你会弄清 Codex 如何通过“并行任务”改变 OpenAI 的软件开发规模,Git 基础设施为什么会因此承压,以及软件开发的瓶颈正在向哪里转移。
Codex 与 OpenAI Git 基础设施:核心信息速览
先用一张表把新闻事实摆清楚。下表内容全部来自 OpenAI 官方披露,未公开的信息会明确标注。
| 信息项 | 详情 |
|---|---|
| 发布时间 | 2026 年 11 月 2 日,《Scaling Git at OpenAI》 |
| 发布方 | OpenAI 工程团队(Aaron Friel、Taylor Blau、Ted Nyman) |
| 核心内容 | 新 Git 服务端后端 Pando,兼容标准 Git 协议和客户端 |
| 直接背景 | Codex 推高开发并行度,旧 Git 系统出现性能和可靠性问题 |
| 生产时间 | 2026 年 4 月开始承载生产流量,从启动到上线约 10 周 |
| 关键效果 | Push 延迟中位数下降近 80%,每天交付接近 1 PB Git 数据 |
| 对外状态 | 仅 OpenAI 内部使用,暂无公开服务端、定价和开放日期 |
Codex 推动的季度 Commit 增长全貌
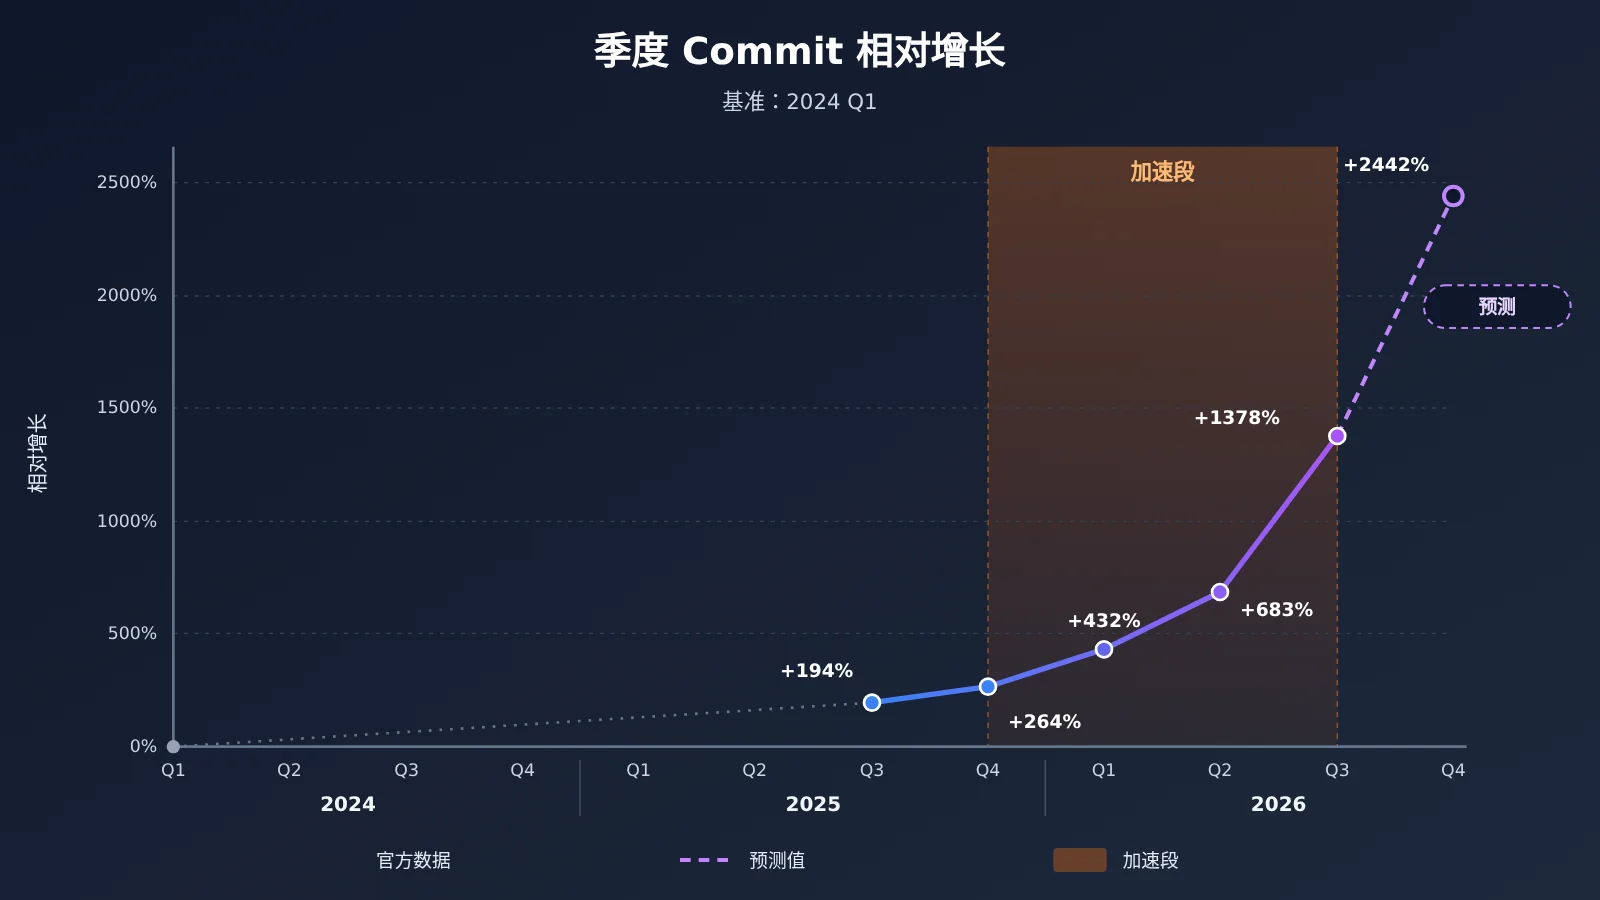
很多报道只引用了 2442% 这个结论。完整的季度序列更能说明问题。下表以 2024 Q1 为基准,统计合并到 OpenAI 单体仓库 master 分支的季度 Commit 数量。
| 季度 | 相对 2024 Q1 增长 | 约为基期倍数 |
|---|---|---|
| 2024 Q2 | +35% | 1.35 |
| 2024 Q4 | +98% | 1.98 |
| 2025 Q2 | +194% | 2.94 |
| 2025 Q4 | +264% | 3.64 |
| 2026 Q1 | +432% | 5.32 |
| 2026 Q2 | +683% | 7.83 |
| 2026 Q3 | +1,378% | 14.78 |
| 2026 Q4 | +2,442%(预测) | 25.42 |
从这组数据可以读出三件事。第一,2024 到 2025 年已经在增长,所以不能把全部增长都归因于 Codex。第二,从 2025 Q4 的 +264% 到 2026 Q3 的 +1,378%,曲线明显陡峭,这段加速与 OpenAI 描述的 Agent 并行开发趋势吻合。第三,官方只公布了相对增长率,没有公布每季度的绝对 Commit 数。
另一组口径不同的数据也指向同一方向。2026 年 7 月 20 日,OpenAI 开发者博客介绍 Codex Code Review 时提到,内部每周 Pull Request 数量较此前第四季度增长了一倍以上。这个数据和季度 Commit 增长的统计口径、时间窗口都不同,不能相加,也不能互相换算,但两者都说明代码变更活动在快速放大。
Codex 如何把压力传导到 Git 基础设施
直觉上,“AI 写代码更快”只影响开发者本人。OpenAI 的解释却指向另一个维度:Codex 提高的是整个工程系统的任务并发度。一个工程师可以同时让多个 Agent 推进互不相关的功能,每个 Agent 都会产生分支、Commit 和 Push,这些操作随后又会触发一连串自动化读取。
下表按 OpenAI 官方描述梳理了这条因果链。
| 阶段 | 发生了什么 | 对 Git 基础设施的影响 |
|---|---|---|
| A. 执行成本下降 | 工程师让多个 Agent 同时修改独立功能 | 开发任务数量上升 |
| B. 并行度提高 | 更多分支、Commit 和 Git Push | 写入请求和分支更新增多 |
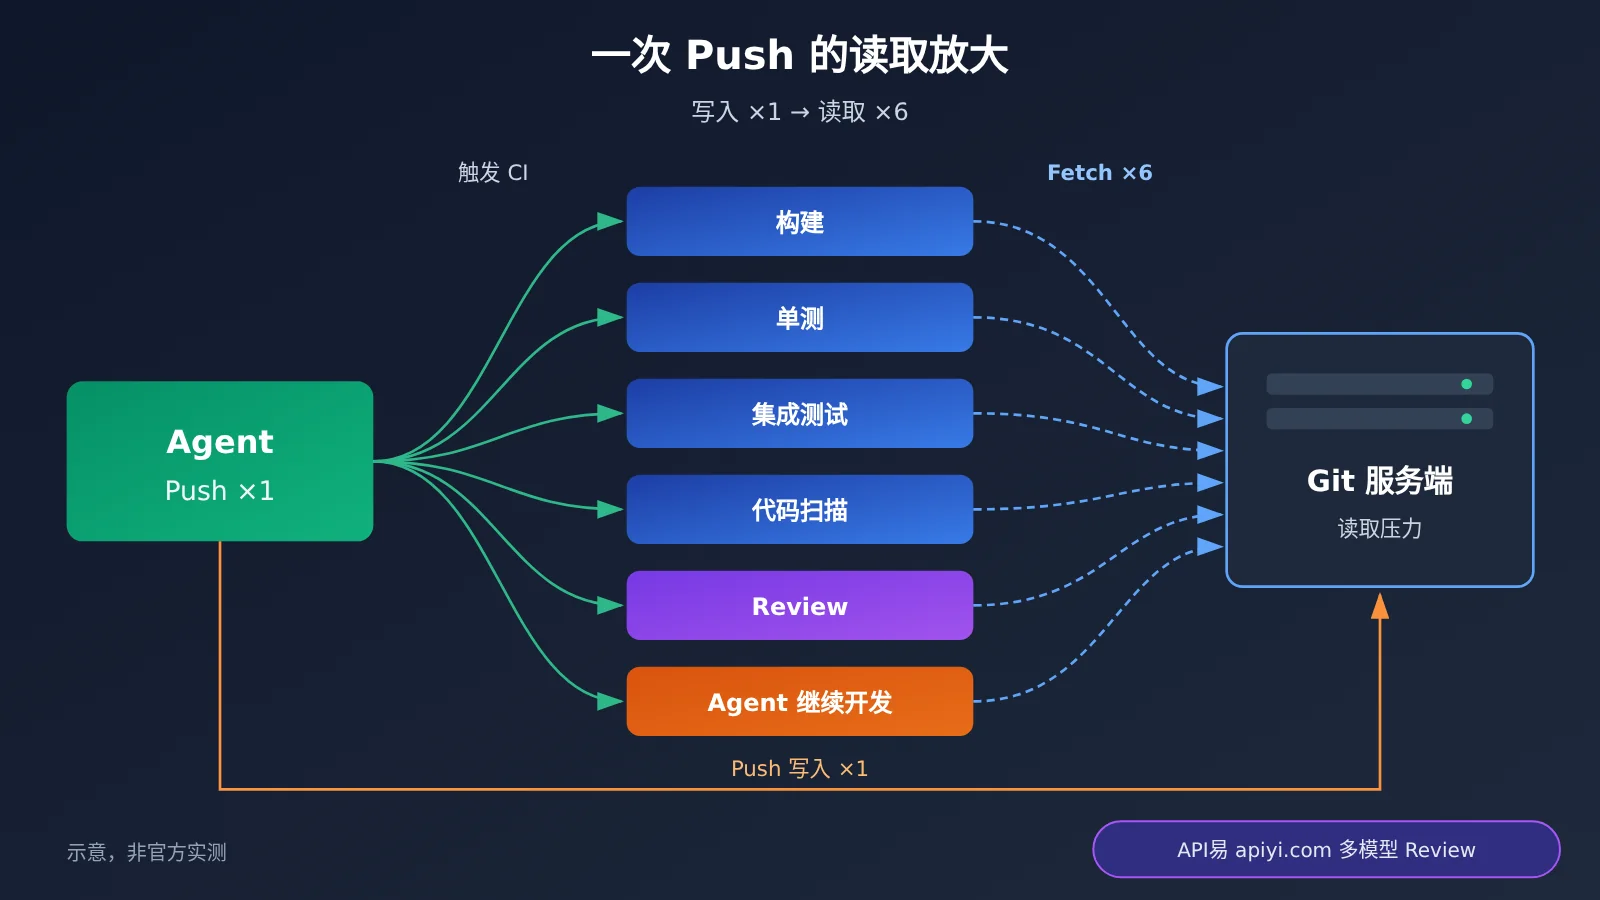
| C. 流水线放大 | 一次 Push 触发多个 CI 构建、测试、扫描 | 同一个提交被反复 Fetch |
| D. 共享设施承压 | 合并、状态同步、版本数据交付同时增加 | Push / Fetch 变慢,Merge 失败 |
| E. 瓶颈转移 | 模型写代码变快,但 Git、CI、Review 未同步扩容 | 交付速度被下游环节卡住 |
一个负载放大的示意场景
下面用一个纯示意的例子帮助理解,数字不是 OpenAI 的实测值。假设一次 Push 会触发 6 个 CI 作业,每个作业各 Fetch 一次代码。那么 100 次 Push 就可能带来约 600 次代码读取。如果 Agent 让 Push 次数翻几倍,读取量也会跟着成倍增长。
实际请求量会受 CI 缓存、任务复用和构建架构的影响,但方向是确定的。写入的增长会在读取侧被放大,这正是 Git 服务端最先吃不消的地方。OpenAI 原文也专门提到,同一个提交可能被多个 CI 作业、研究任务和开发环境反复获取。
OpenAI 旧 Git 系统出了什么问题
OpenAI 披露,从 2025 年末开始,单体仓库的支撑系统越来越难承载新的负载。具体症状包括 Git Fetch 和 Push 变慢、Merge 失败,基础设施可靠性有时低于 90%。
这里要准确理解“低于 90%”。它描述的是部分时期的系统可靠性表现,具体统计口径和完整时间序列没有公开。它不能被解读成“10% 的代码有缺陷”,也不能写成“OpenAI 超过 10% 的提交失败”。
从技术角度看,旧架构有两处结构性瓶颈:
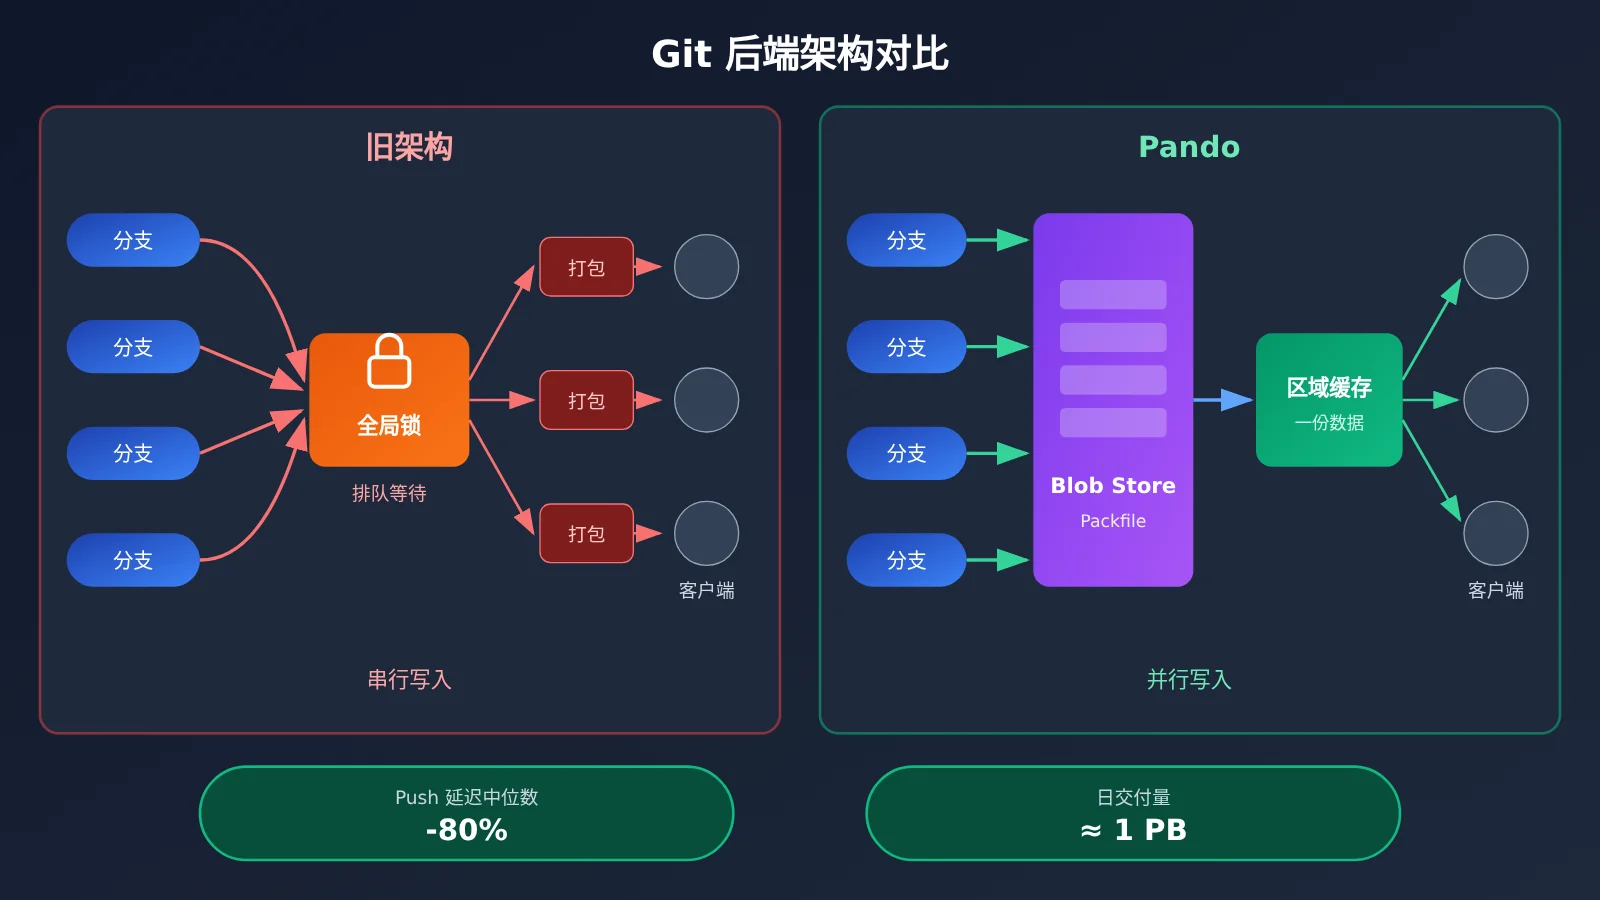
- 分支更新需要全局协调:很多传统分布式 Git 服务要维护整个仓库所有引用的一致状态。即使两个 Agent 修改完全无关的分支,也可能挤在同一条协调路径上。
- 下载包被重复计算:不同客户端已有的 Git 历史不同,服务端经常要为每个客户端单独遍历对象、打包、压缩。多个 Agent 读取同一版本时,这些昂贵的工作会被重复执行。
在人类工程师主导的时代,这两点问题尚可接受。一旦大量 Agent 和 CI 作业同时涌入,它们就成了系统瓶颈。
Pando 如何回应 Codex 带来的 Git 压力
OpenAI 并没有弃用 Git。Pando 仍然使用标准 Git 协议和客户端,工程师原有的命令和工作流基本不变,重新设计的是服务端的存储、引用更新和数据交付方式。下表对比了旧方案与 Pando 的关键差异。
| 维度 | 传统 Git 服务端 | Pando |
|---|---|---|
| 分支写入 | 全仓库强协调,无关分支也可能互相等待 | 各分支独立更新,只有同一 Ref 才需协调 |
| 一致性模型 | 全仓库一致快照 | 因果一致性,同一分支保证顺序和读己所写 |
| 读取交付 | 按客户端状态重新打包压缩 | 复用 Push 时保存的 Packfile,通过缓存分发 |
| 缓存 | 依赖实现 | 区域缓存服务,Packfile 缓存命中率超过 99% |
| 客户端兼容 | 标准 Git | 标准 Git,借助 packfile-uri 机制下发 |
Pando 的两项核心思路
第一是写入并发。Pando 放弃为整个仓库维护单一时间点的一致快照,改为让每个分支独立维护版本。不同分支的 Push 可以并行,只有修改同一个 Ref 的请求才需要处理冲突。代价是:同一次多分支读取中,客户端看到的不同分支可能来自不同时间点,OpenAI 认为这种取舍对其场景是合适的。
第二是读取复用。Pando 把每次 Push 收到的 Packfile 作为不可变数据存入 Blob Store。其他客户端 Fetch 时,服务端根据它已有和想要的 Commit,挑选现成的 Packfile 下发,而不是重新打包。后台还会把大量小 Packfile 分层合并成更大的集合,避免长期未更新的客户端要下载过多文件。
官方给出的生产数据包括:Push 延迟中位数下降近 80%;每天交付接近 1 PB Git 数据;单小时 Packfile 交付峰值超过 57 TB。需要注意,1 PB 是交付量,重复读取同一数据也会计入,并不代表每天产生 1 PB 新代码。
值得一提的是,Pando 本身也是 Agent 参与开发的产物。OpenAI 称其核心架构由一名工程师设计,多个 Agent 团队参与实现,并借助 Git 兼容性测试集和确定性模拟测试做验证。不过官方没有宣称所有代码都由 AI 编写。
AI 编程带来的影响分析:瓶颈正在从写代码转移
对开发者和团队的影响
Pando 的故事真正值得关注的,不是 OpenAI 自建了一套 Git 后端,而是它揭示的规律:AI 编程降低了代码生成的成本,压力会沿着工程链路向下游转移。Git 只是第一个暴露出来的环节,代码审查、测试和集成同样在承压。
OpenAI 在 Codex Code Review 的文章中直接承认,越来越多 PR 在等待审查。审查者很难及时理解历史约束、判断 API 兼容风险。因此 Codex Code Review 支持读取仓库中 AGENTS.md 定义的审查规则,用于保护既有 API 契约、识别可能泄露客户数据的日志、避免破坏已有服务集成。
对于普通 AI 开发团队,这意味着几项具体调整:
- 把审查规则写下来:将团队的隐性约束沉淀到 AGENTS.md 一类的规则文件中,让 AI Review 有据可依。
- 给 CI 留出余量:Agent 并行后,CI 作业数量可能先于人力成本增长,需要提前评估缓存和并发配额。
- 重新选择度量指标:不要只看 Commit 或 PR 数量,要同时关注交付周期和变更失败率。
- 验收能力优先:测试覆盖、模拟测试和兼容性测试决定了 Agent 产出能否被放心合并。
用多模型做 AI 代码审查的最小示例
如果你想在自己的仓库里试一试“按规则审查 Diff”的流程,可以用 OpenAI 兼容接口快速搭一个原型。下面的示例读取本地 Diff,让模型按规则给出审查意见:
import openai, subprocess

client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")
diff = subprocess.run(["git", "diff", "HEAD~1"], capture_output=True, text=True).stdout

resp = client.chat.completions.create(
    model="YOUR_MODEL",  # 替换为平台上可用的编程模型
    messages=[{"role": "user", "content": f"请审查以下改动,重点关注 API 兼容性和日志泄露风险:\n{diff}"}],
)
print(resp.choices[0].message.content)
查看完整实现代码(读取 AGENTS.md 规则 + 多模型对照)
import subprocess
from pathlib import Path
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # 一个 Key 调用多家模型
)

def load_rules(path: str = "AGENTS.md") -> str:
    """读取仓库中的审查规则,不存在时返回默认规则"""
    p = Path(path)
    if p.exists():
        return p.read_text(encoding="utf-8")
    return "1. 不得破坏已有 API 契约\n2. 日志中不得输出客户数据\n3. 不得破坏已有服务集成"

def get_diff(base: str = "HEAD~1") -> str:
    """获取待审查的 Diff"""
    return subprocess.run(
        ["git", "diff", base], capture_output=True, text=True
    ).stdout

def review(diff: str, rules: str, model: str) -> str:
    """按规则调用模型审查代码改动"""
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": f"你是严格的代码审查者,请依据以下仓库规则审查:\n{rules}"},
            {"role": "user", "content": f"待审查 Diff:\n{diff}\n请逐条列出风险点和修改建议。"},
        ],
        max_tokens=1500,
    )
    return resp.choices[0].message.content

if __name__ == "__main__":
    rules, diff = load_rules(), get_diff()
    # 替换为你要对比的模型名称,观察不同模型的审查差异
    for model in ["MODEL_A", "MODEL_B"]:
        print(f"===== {model} =====")
        print(review(diff, rules, model))
🚀 快速上手建议:搭建 AI Review 原型时,可以通过 API易 apiyi.com 获取免费测试额度。同一个 API Key 即可调用 OpenAI、Claude、Gemini 等模型,方便对比不同模型在你的仓库规则下的审查质量。
对行业的影响
The New Stack 在报道中认为,OpenAI 是 Agent Coding 的早期高强度使用者,它遇到的基础设施压力可能预示其他大型企业和代码托管平台未来会面对的问题。这是媒体的趋势判断,不能证明 GitHub、GitLab 已经出现同样的故障。
开发者社区的看法也存在分歧。乐观者认为编码成本下降,会让很多原本不值得做的小项目变得可行。质疑者则指出,更多 Commit 不代表更高的软件价值,如果审查和测试跟不上,整体交付未必更快。还有评论提醒,大型 Monorepo 的规模问题并非 AI 时代才出现。
读懂 Codex 数据:五个不能混用的指标
讨论 AI 编程的效果时,最常见的错误是把不同指标混为一谈。下表帮助你判断每个数据能说明什么、不能说明什么。
| 指标 | 衡量什么 | 本次新闻中的情况 |
|---|---|---|
| Commit 数量 | 版本提交频率 | 季度增长预计 +2,442%,仅有相对值 |
| PR 数量 | 变更提案与合并活动 | 每周 PR 较此前 Q4 增长超过一倍 |
| 代码行数 | 代码规模 | 未公开,不能用 Commit 增长推算 |
| Lead Time | 从变更开始到交付的时间 | 未公开 |
| 变更失败率 | 上线后导致故障的比例 | 未公开 |
Pando 案例证明的是:OpenAI 的代码开发负载显著增长,原有 Git 基础设施出现了瓶颈。它没有证明软件质量或开发者生产率按同样倍数增长,也无法用来估算 Codex 替代了多少工程师。
另外,OpenAI 在 2026 年 2 月发表的 Harness Engineering 是另一个独立实验:从空仓库开始,约五个月完成百万行量级的项目,累计约 1,500 个 PR。这是另一个项目的数据,与 Pando 无关,但它同样反映了一个趋势:工程师的工作重心正在向架构、工具链、反馈循环和代码验收转移。
💡 选择建议:如果你的团队也在引入 Coding Agent,建议先在小范围内对比不同模型的代码生成与审查表现。通过 API易 apiyi.com 的统一接口可以快速切换模型,用同一套测试用例做横向评估,再决定主力模型。
常见问题 FAQ
Q1:Codex 真的让 OpenAI 的代码量增长了 24 倍吗?
不能这样理解。官方数据是“合并到 master 的季度 Commit 数量预计较 2024 Q1 增长 2442%”。这是预测值,统计的是 Commit 数而不是代码行数。一次 Commit 的改动可大可小,所以这个数据既不等于代码量,也不等于生产率。
Q2:Pando 是 GitHub 的替代品吗?
不是。Pando 是兼容标准 Git 协议的服务端后端,只在 OpenAI 内部使用。截至 2026 年 11 月 3 日,没有公开的服务端、定价或开放日期。OpenAI 公开的是改进版 Git 客户端仓库,部分改动已贡献到上游 Git,这不等于 Pando 服务端已经开源。
Q3:普通团队需要像 OpenAI 一样重建 Git 基础设施吗?
大多数团队不需要。OpenAI 面对的是超大规模单体仓库和高强度 Agent 并发。对中小团队来说,更现实的瓶颈通常是 CI 配额、测试覆盖和代码审查人力,应该优先在这些环节补齐能力。
Q4:如何低成本试用 AI 代码审查或 Coding Agent 流程?
可以先用 OpenAI 兼容接口搭一个最小原型,按本文代码示例读取 Diff 和规则文件,然后交给模型审查。通过 API易 apiyi.com 注册即可获得免费测试额度,把 base_url 换成 `https://api.apiyi.com/v1`,就能用同一个 Key 对比多家模型的审查效果。
Q5:AI 编程会不会只是制造了更多低质量代码?
这正是社区争论的焦点,目前没有定论。OpenAI 没有公开缺陷率、回滚率或净开发成本变化,因此既不能说质量全面下降,也不能说全面提升。比较稳妥的做法是在自己的团队里同时跟踪交付周期和变更失败率。也可以借助 API易 apiyi.com 接入多个模型做交叉审查,降低单一模型的漏判风险。
Codex 与 Git 基础设施变化:Key Takeaways
- 数据口径要准确:2442% 是 2026 Q4 季度 Commit 的预测增长,不是代码行数。
- 增长明显加速:2025 Q4 之后曲线陡峭,但 2024 年起已在增长。
- 压力来自并发:Codex 提高了任务并行度,写入的增长在 CI 读取侧被放大。
- 旧系统已失灵:2025 年末起 Push、Fetch 变慢,可靠性有时低于 90%。
- Pando 的解法:分支独立写入、Packfile 复用与缓存,Push 延迟中位数降近 80%。
- 瓶颈向下游转移:代码审查、测试、集成和交付成为新的约束点。
- 上手建议:用 API易 apiyi.com 统一接口快速搭建多模型 Review 原型。
总结
Codex 给 OpenAI 带来的变化,核心可以归结为三点:
- 规模层面:单体仓库季度 Commit 预计较 2024 Q1 增长 2442%,PR 数量也在翻倍,代码变更活动被大幅放大。
- 基础设施层面:并行 Agent 带来更多分支、Push 和 CI 读取,旧 Git 后端出现性能与可靠性问题,OpenAI 用约 10 周构建了 Pando 来应对。
- 工程流程层面:写代码不再是最慢的环节,审查、测试和交付能力决定了 AI 编程能否真正转化为价值。
对大多数团队来说,与其追逐 Commit 数量,不如先补齐验收和审查能力,再逐步扩大 Agent 的并行规模。如果你想尽快验证 AI Review 或 Coding Agent 流程,推荐通过 API易 apiyi.com 用免费额度对比多个模型的实际表现。
📚 参考资料
- Scaling Git at OpenAI:OpenAI 官方 Pando 技术文章(2026-11-02)
- 链接:
openai.com/index/scaling-git-at-openai -
说明: 本文新闻事实与季度 Commit 增长数据的主要来源
-
Custom Code Review rules for Codex:OpenAI 开发者博客(2026-07-20)
- 链接:
developers.openai.com/blog/custom-code-review-rules-for-codex -
说明: 每周 PR 数量翻倍与 AGENTS.md 审查规则的出处
-
Harness engineering:OpenAI 独立 Agent 开发实验(2026-02-11)
- 链接:
openai.com/index/harness-engineering -
说明: 理解工程师角色转变的独立案例,与 Pando 项目无关
-
OpenAI Git Fork:OpenAI 维护的 Git 客户端公开仓库
- 链接:
github.com/openai/git -
说明: 查看 packfile-uri 等客户端改进
-
The New Stack 报道:外部媒体对 Pando 的解读(2026-11-02)
- 链接:
thenewstack.io - 说明: 行业趋势判断参考
作者:APIYI 技术团队
技术交流:欢迎在 API易 官网首页联系我们,更多模型接入资料可访问 docs.apiyi.com 文档中心