
要約:モデル、コーディングエージェント、APIチャネルの3層から中国国内で利用できる組み合わせを比較し、実際のコーディングタスク、コスト、互換性をもとに、自分に合った再現プランを選びます。
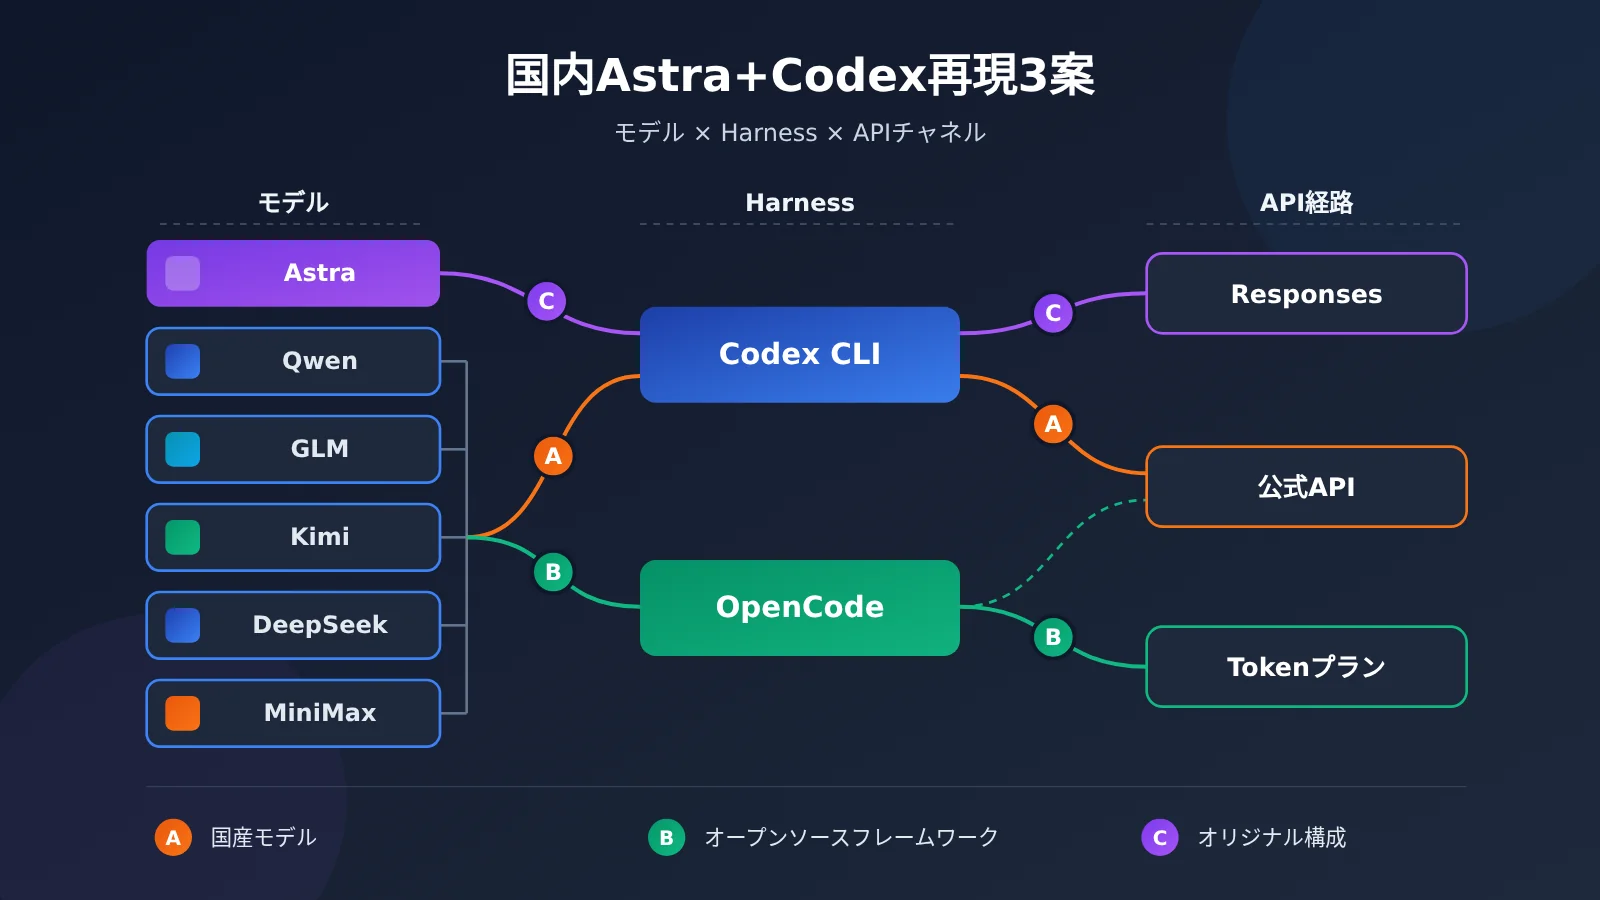
中国国内でAstra + Codexを最大限再現するには、試す価値のある3つのルートがあります。ルートA:オリジナルのCodex CLIを維持し、Alibaba Cloud BailianまたはTencent Cloud TokenHubのResponses互換インターフェース経由で中国製フラッグシップモデルを接続する。このルートはCodexの実行体験を維持します。ルートB:OpenCodeなどのオープンなハーネスに切り替え、複数の中国国内モデルを接続する。このルートでは、モデル選択の自由度を最大限に確保できます。ルートC:法令を遵守し、サービスが実際に利用可能であることを前提に、GPT-6 Astraモデルを維持し、Responsesプロトコルを完全にサポートするAPIチャネル経由でオリジナルのCodexに接続する。このルートは元の組み合わせへの再現度が最も高いです。
モデルの中国国産化が求められる場合、ルートAが出発点です。ただしQwen4-Max-Previewは2026年11月25日24:00までしか提供されないため、評価には適していますが、唯一の長期的な依存先には向きません。中国国内のネットワーク環境での利用だけが要件で、モデルの中国国産化を求めない場合は、ルートCがモデルのインテリジェンス面で最もオリジナルに近いです。3つのルートから最終的にどれを選ぶかは、同じ実コーディングタスク群の成功率、所要時間、コスト、ツール互換性によって決めるべきであり、ベンチマークランキングやトークン単価で決めるべきではありません。
以下ではまず、Astra + Codexを5つの能力コンポーネントに分解し、「再現」とは具体的に何を再現するのかを説明します。次に、ルートAの2種類の公式接続構成と料金プランの比較、ルートBの4種類のハーネス、優先的にテストすべき中国製モデルをそれぞれ示します。続いて、3つのルートのトレードオフを1つの総合表にまとめます。最後に、再現可能な5種類のタスクテスト手法を提示し、「成功したタスク1回あたりのコスト」を選定の中心指標にします。
To Know:用語の基礎知識
| 用語 | 説明 |
|---|---|
| GPT-6 Astra | OpenAI のフラッグシップ推論モデル。複雑な推論、ソフトウェアエンジニアリング、長期的な Agent タスクに位置づけられ、モデル ID は gpt-6-astra です。 |
| Codex | OpenAI のコーディングエージェント。プロジェクトを読み込み、コードを変更し、コマンドを実行して結果を検証できます。 |
| Harness | モデルの決定を実際のツールに接続する実行フレームワーク。ツールループ、コンテキスト、権限、失敗からの復旧を担います。 |
| Responses API | OpenAI がモデル出力、推論、ツール呼び出しをサポートするインターフェースプロトコル。新版の Codex はこれに依存して動作します。 |
| Chat Completions | OpenAI の比較的初期の対話インターフェースプロトコル。旧版の Codex が使用します。 |
| Provider | Agent ツールにモデルサービスを提供するサプライヤー。設定ファイル上では一連の接続パラメータとして表現されます。 |
| Base URL | モデルサービス API の基本アクセスアドレス。チャネルを切り替えるときに主に変更するのはこれです。 |
| Token Plan | クラウド事業者が月額プランでモデル呼び出し枠を提供する課金方式。 |
| Credits / クレジット | プラン内で呼び出し枠を差し引くための計量単位。事業者ごとに単位が異なり、直接交換はできません。 |
| コンテキストウィンドウ | モデルが1回のリクエストで処理できる内容の上限。Token で数えます。 |
| 推論レベル | モデルの思考の深さを制御するパラメータ。Astra は low から max までの5段階を提供します。 |
| キャッシュヒット | 繰り返し送信された入力がサーバー側で再利用され、より低いレートで課金されること。 |
| MCP | モデルアプリケーションと外部ツール、データソースを接続するオープンプロトコル。 |
| Function Calling | モデルが構造化された呼び出しリクエストを出力し、アプリケーションが関数を実行して結果を返す仕組み。 |
| ピーク・オフピーク課金 | 時間帯によって価格を区別し、ピーク時間帯はより多くの枠を消費します。 |
本文正文
1 Astra + Codex の強みはどこにあるのか?
1.1 Astra が提供するもの
GPT-6 Astra は OpenAI のフラッグシップ推論モデルであり、公式の位置づけは複雑な推論、ソフトウェアエンジニアリング、多段階のコード修正、ブラウザおよびコンピュータ操作、リサーチ分析、専門文書作成をカバーします。Codex に対して提供するのは「判断力」です。すなわち、未知のコードベースを理解し、変更方案を設計し、エラーメッセージを読み解いて戦略を調整する能力です。
公式モデル仕様(資料確認日 2026-11-13)は以下のとおりです:
- コンテキストウィンドウ:1,050,000 トークン;最大出力:128,000 トークン。
- 推論レベル:low、medium、high、xhigh、max。
- 標準価格(米ドル / 100万トークン):入力 $10、出力 $50、キャッシュ入力 $1、30分キャッシュ書き込み $12.50;入力が 272K トークンを超える場合は、より高い長文コンテキスト料金が適用されます。
- Responses API ツール:Web Search、File Search、Hosted Shell、Apply Patch、Computer Use、MCP など。
最後の項目は個別に理解する必要があります。これらのツールは OpenAI プラットフォームが提供する機能であり、特定のクライアントやサードパーティ製ゲートウェイで利用できるかどうかは、実際にどのツールが統合されているかに依存します。
1.2 Codex が担当するタスク
OpenAI が 2026 年 8 月に公開した Codex Harness の記事では、Codex の核心を Agent ループ、コードベース理解とファイル操作、コマンド実行、ツール呼び出しと結果の返送、マルチターンのコンテキスト管理、ユーザー承認、サンドボックスのセキュリティ境界、および実行プロセスの監視と失敗からの復旧としてまとめています。
役割分担は明確です。モデルは判断と生成を担当し、Harness はモデルの決定を実際のファイルシステムとターミナルに落とし込みます。非常に強力なチャットモデルであっても、この実行システムと組み合わせて初めて「プロジェクトを読む → コードを変更する → テストを実行する → 失敗を修正する → 再検証する」という完全なプログラミングタスクを完了できます。
1.3 再現すべきはモデルか、それとも Agent 全体か
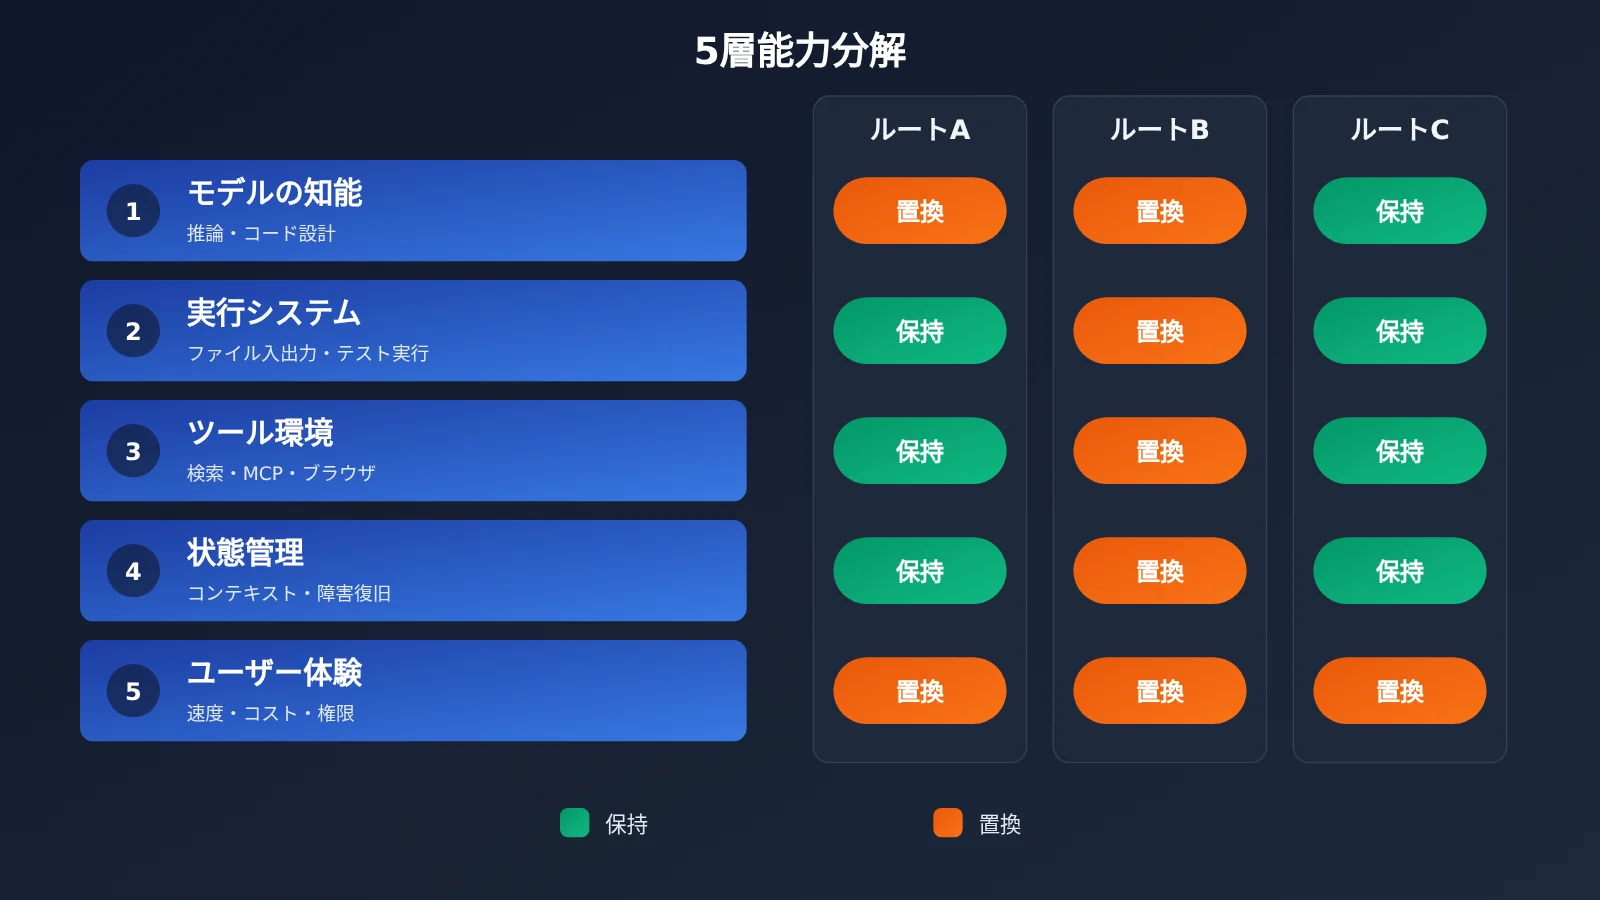
元の体験を分解すると、5 つのコンポーネントが得られます:
- モデルの知能:複雑なタスクの理解、コード設計、推論とデバッグ。
- 実行システム:プロジェクトの読み取り、ファイルの編集、コマンドの実行、テストの実行。
- ツールエコシステム:ネット検索、Web ページの読み取り、MCP、ファイル処理、ブラウザ操作。
- 状態管理:長時間タスクのコンテキスト、ツール呼び出しループ、失敗からの復旧。
- 使用体験:応答速度、安定性、コスト、権限管理、操作の利便性。
モデルを交換すると主に第 1 項が変わりますが、ユーザーが最終的に感じるのは 5 項目の合計です。これが 3 つのルートの分岐点でもあります。ルート A は第 1 項を交換し、第 2 項と第 4 項を保持します。ルート B は第 1、2、4 項を同時に交換します。ルート C はできるだけ第 1、2、4 項を保持し、差異は第 5 項と API チャネルに起因するプロトコルの詳細に集中します。
2 Codex を残し、国産モデルを接続する(ルート A)
2.1 Alibaba Cloud 百煉 Token Plan + Codex
Alibaba Cloud は Codex の公式接続ドキュメントを公開しており、Token Plan は Responses 互換インターフェースを提供しているため、新版 Codex にそのまま接続できます。~/.codex/config.toml(Windows では通常 C:\Users\<ユーザー名>\.codex\config.toml)に次のように記述します:
model_provider = "Token_Plan"
model = "auto"

[model_providers.Token_Plan]
name = "Token_Plan"
base_url = "https://token-plan.cn-beijing.maas.aliyuncs.com/compatible-mode/v1"
env_key = "OPENAI_API_KEY"
wire_api = "responses"
env_key が指す環境変数には、Token Plan のプラン専用 API Key を設定します。設定時にハマりやすい技術的なポイントがいくつかあります:
- プロトコルバージョン:Codex は 0.94.0 以降、Responses API を要求します。Alibaba Cloud の旧版 Coding Plan は Chat Completions を使用しており、公式には Codex 0.93.0 以前との組み合わせが求められます。長期的に保守する環境では Token Plan を選ぶべきです。
- Key の分離:Token Plan、Coding Plan、従量課金では、それぞれ異なる 3 種類の API Key を使用します。
- リージョン:Token Plan は現在、華北 2(北京)のみに対応しています。
- モデルメタデータ:新しいモデルはモデル ID とメタデータを正しく設定しないと、Codex のモデル選択画面で完全なサポートを受けられません。
百煉で現在もっとも注目すべきは、2026 年 11 月 11 日に提供開始された Qwen4-Max-Preview(モデル ID qwen4-max-preview)です。公式ドキュメントでは、これが新世代のフラッグシップマルチモーダルモデルであることが確認されており、コード開発、複雑なエージェントタスク、画像・動画の理解に対応し、深い思考(デフォルトで有効)、ツール呼び出し、ウェブ検索、構造化出力をサポートします。OpenAI Chat Completions、Responses、Anthropic Messages の 3 つのプロトコルと互換性があります。コンテキスト長は 1M トークン、最大出力予算は 393,216 トークンで、思考と最終回答がこの予算を共有します。
利用条件も明確です。現在は Token Plan でのみ提供され、従量課金には対応していません。プレビュー期間は北京時間 2026 年 11 月 11 日 10:00 から 11 月 25 日 24:00 までで、終了後は提供停止となります。本記事の日付時点で、テストできる残り期間は 2 週間を切っており、評価を急いで進めるのに向いています。本番環境では代替モデルもあわせて用意しておくべきです。
2.2 Tencent Cloud TokenHub + Codex
Tencent Cloud は Codex CLI 向けに専用の公式接続チュートリアルを提供しています。同じ設定ファイルの書き方は次のとおりです:
model_provider = "Tencent_Cloud_Token_Plan"
model = "$model_id"

[model_providers.Tencent_Cloud_Token_Plan]
name = "Tencent_Cloud_Token_Plan"
base_url = "https://tokenhub.tencentmaas.com/plan/v3"
env_key = "Token_Plan_API_KEY"
wire_api = "responses"
$model_id は、プランが現在サポートする正確なモデル ID に置き換える必要があります。TokenHub のモデルライブラリには GLM-5.3、Kimi K3、DeepSeek V4 シリーズ、MiniMax M3、Tencent 混元(Hunyuan)Hy シリーズ、さらに一部の軽量モデルと自動ルーティングモデルが含まれており、同じプランで Claude Code、Cline、OpenClaw などのツールも利用できます。
TokenHub の強みは「1 つの Codex 設定で複数の国産モデルを動かせる」ことです。model を 1 行書き換えるだけで、同じハーネスで GLM、Kimi、DeepSeek、MiniMax を順に動かせるため、横並び比較にぴったりです。モデルの在庫、バージョン、クォータポリシーは動的に調整されるので、テストのたびにコンソールに表示されるモデル ID を基準にしてください。
2.3 2 つのプランの違い
どちらも Token Plan という名称ですが、計量単位が異なります。百煉は Credits、TokenHub は ポイント を使用しており、両者を直接換算することはできません。以下の表のデータは 2026-11-13 時点のもので、価格の単位はすべて人民元 / 月です:
| 比較項目 | Alibaba Cloud 百炼 Token Plan(個人版) | Tencent Cloud TokenHub 汎用 Token Plan(個人版) |
|---|---|---|
| プランと月額料金 | Lite ¥39、Essential ¥79、Standard ¥139、Pro ¥312 | Lite ¥39、Standard ¥99、Pro ¥299、Max ¥599 |
| 月間クォータ | 20,000 / 45,000 / 80,000 / 200,000 Credits | 780 / 1,980 / 5,980 / 11,980 ポイント |
| 推奨同時実行エージェント数 | 1—2 / 2—3 / 3—4 / 6—8 | ドキュメントに同種の指標の記載はありません |
| 割引と特典 | Lite、Essential は新規ユーザーの初回購入が ¥19.5、¥39.5(2026-11-30 まで);Standard、Pro には AgentStudio Harness 特典付き | 一部モデルの期間限定割引の控除レート;ポイント購入の目安は ¥1 = 20ポイント |
| Codex 接続プロトコル | Responses(wire_api = "responses") |
Responses(wire_api = "responses") |
| 代表モデル | Qwenシリーズ、Token Plan 限定の Qwen4-Max-Preview を含む | GLM-5.3、Kimi K3、DeepSeek V4、MiniMax M3、混元 Hy |
| 課金方式 | Credits はモデルごとに差し引かれる | 2026-08-31 からポイント控除、モデルごとにレートが異なる |
| 利用制限 | 華北2(北京)のみ;対話型プログラミング向けプランは、任意の商用バックエンド自動化に直接使用すべきではない | モデルライブラリと割引キャンペーンは変更される可能性がある |
この2つのプランを比較するとき、月額料金の順位にあまり意味はありません。重要なのは「自分が使いたいモデルで、1つのタスクを完了するたびに、このプランでどれだけのクォータを消費するか」です。百炼の価値は Qwen エコシステムと、現在は同プラン限定で提供される Qwen4-Max-Preview に集約されています。一方、TokenHub の価値は、複数の中国製モデルが1つのクォータを共有できる点にあります。
TokenHub は各モデルのポイント控除レートを公開しています。以下は 2026-11-13 時点で確認した一部の期間限定割引レートで、¥1 = 20ポイントとして人民元 / 100万トークンに換算しています。
| モデル | 通常入力 | 出力 | キャッシュヒット入力 | 備考 |
|---|---|---|---|---|
| GLM-5.3 | ¥4.40 | ¥15.40 | ¥1.10 | 割引終了後は定価に戻る |
| GLM-5.3-Flash | ¥0.56 | ¥1.96 | ¥0.161 | 速度とコストを重視する用途 |
| Kimi K3 | ¥15.00 | ¥75.00 | ¥1.50 | 割引終了後は定価に戻る |
| Kimi K2.7 Code | ¥5.20 | ¥21.60 | ¥1.04 | コード特化モデル |
| DeepSeek V4.1 Flash(オフピーク) | ¥0.40 | ¥1.60 | ¥0.008 | ピーク・オフピーク課金 |
| DeepSeek V4.1 Flash(ピーク) | ¥0.80 | ¥3.20 | ¥0.016 | 平日 09:00—12:00、14:00—18:00 |
| MiniMax M3 | ¥2.10 | ¥8.40 | ¥0.42 | 入力 ≤ 512Kトークンの価格 |
この表は次の2点と合わせて理解する必要があります。第一に、月額サブスクリプションはプランの月額料金で課金され、表中の金額はポイントの参考価値であり、モデル間の消費レートを比較するためのものです。第二に、DeepSeek のピーク・オフピーク課金は 2026年10月30日から実施され、ピーク時の消費はオフピーク時の約2倍になります。夜間にコードチェックやテスト分析のような非同期タスクをまとめて実行すると、クォータを大幅に節約できます。
GLM-5.3 で一度試算してみます。大規模なコードタスクで通常入力 100,000 Token、キャッシュヒット 300,000 Token、出力 30,000 Token を累計で消費した場合、0.1 × ¥4.40 + 0.3 × ¥1.10 + 0.03 × ¥15.40 ≈ ¥1.232 の参考クレジット価値に相当します。キャッシュヒットが入力の大部分を占めているのは、まさに Agent タスクの典型的な形です。キャッシュの料率がプログラミング用途の総コストに大きく影響することも、ここから分かります。
3 Harness を変えれば、Astra + Codex に近づけるか?(ルート B)
3.1 OpenCode:鍵となるのはマルチモデルの自由度
OpenCode はオープンソースの AI Coding Agent で、多数の LLM Provider に対応しています。/connect でサービスプロバイダーを追加し、/models でモデルを切り替えられます。カスタム Base URL やローカルモデルにも対応し、ターミナル、デスクトップ、一部の開発環境で利用できます。ファイル検索、編集、コマンド実行、Agent ワークフローといった機能を備えています。Alibaba Cloud は公式の接続手順を公開しており、Alibaba Token Plan(China)を選択すれば百炼のパッケージを利用できます。
OpenCode の公式セキュリティ説明は、真剣に受け取るべき内容です。デフォルトのローカル Agent にはシステムレベルの安全分離がなく、権限承認はコンテナや仮想マシンの代わりにはなりません。信頼できないコードを実行する場合や、高い権限を伴う自動化タスクでは、Docker や仮想マシンの中で実行するようにしてください。
3.2 Qwen Code、Kimi Code、DeepSeek Harness
3 つのネイティブ Harness は、それぞれ対応するモデルエコシステムに資するものです。
- Qwen Code:Alibaba Cloud は CLI、デスクトップ、IDE の 3 形態を提供しています。百炼にログインし、リージョンを選択して API Key を入力すれば接続でき、コードベース検索、ファイル編集、コマンド実行が可能です。主に Qwen モデルを使い、プロトコル適合の手間をできるだけ減らしたいチームには、これを優先的に検討する価値があります。
- Kimi Code CLI:Moonshot AI が保守するターミナル向けコーディングツールです。コードの読み取りと修正、Shell の呼び出し、Web コンテンツの取得、セッションの復元、プラン/承認モード、エディタ連携に対応し、サードパーティの互換モデルも設定できます。Windows では公式の PowerShell スクリプトでインストールし、Git for Windows の Git Bash に依存します。旧版の Kimi CLI は 2026 年 9 月にメンテナンスを終了したため、新規ユーザーは Kimi Code CLI を直接使ってください。
- DeepSeek Harness:Web UI と CLI の両方を提供するオープンソースの Agent フレームワークで、カスタム Provider とツール設定に対応し、百炼のさまざまな課金プランに接続できます。
npx @deepseek-ai/dsh webで起動し、デフォルトのアドレスはhttp://127.0.0.1:3080です。選ぶ際には、ツール実行の安定性、権限管理、対象モデルのプロトコルへの適合性を重点的に確認してください。
3.3 Harness がモデルの性能に影響する理由
同じモデルでも、異なる Harness に入れると結果が大きく変わることがあります。理由は、Harness がモデルの「何を見るか、何ができるか、間違えた後にどうするか」を決めるからです。
- コード読み取り戦略:一度にいくつのファイルを読み込むか、どの順序で検索するかが、モデルがプロジェクトをどれだけ完全に理解できるかを左右します。
- ツールループの設計:ツールの結果をどう返すか、失敗時に自動リトライするかが、長いタスクを最後まで走らせられるかを決めます。
- コンテキスト圧縮:長いセッションでどの履歴を保持し、どの細部を捨てるかが、モデルが「目標を忘れるかどうか」に直接影響します。
- パッチとテスト:ファイル全体の上書きか diff パッチか、変更後にデフォルトでテストを実行するかが、変更の正確率とリグレッションのリスクを決めます。
つまりルート B で測られる成績は、「モデル + その Harness」の組み合わせとしての成績です。ルート A と比較するときは、両者の実行戦略がそもそも異なることを忘れないようにしましょう。
4 中国国内で試す価値のあるモデルはどれか?
4.1 Qwen4-Max-Preview
公開されている仕様を見ると、1Mコンテキストウィンドウ、393,216トークンの思考と出力で共有されるバジェット、ツール呼び出し、構造化出力といった特徴から、複雑なコーディング、長いコンテキストの分析、マルチターンのAgentワークフローをテストするのに適しています。また、ResponsesとAnthropic Messagesの両方に準拠しているため、CodexにもClaude Code系のツールにも接続できます。
このモデルを選ぶ際の最大の制約は提供期間です。プレビューは2026年11月25日24:00に終了し、提供終了となります。推奨されるのは、この期間内に一連のテストタスクをすべて実行し、その結果を後続の正式版Qwenモデルの参照基準とすることです。本番環境には、同時に長期的に利用可能な代替モデルも設定しておきましょう。
4.2 GLM-5.3、Kimi K3、DeepSeek V4、MiniMax M3
これら4つのシリーズはすべてTokenHubの1つのプラン内に含まれており、タスクの種類に応じて使い分けるのが最も手間がかかりません。
- 複雑なロジックと複数ファイルの修正:GLM-5.3、Kimi K3、DeepSeek V4-Proを高能力グループとして比較します。Kimi K3は出力の単価が表中で最も高いため、最も難しいタスクに投入して上限を検証するのに適しています。
- コードに特化したタスク:Kimi K2.7 Codeはコード修正シーンに特化して比較するために使い、Kimi Code CLIと組み合わせてネイティブな体験をテストすることもできます。
- 高頻度・低コストのタスク:GLM-5.3-Flash、DeepSeek V4-Flashは、コードチェックや一括リファクタリングなど、コストと速度が重要となるシーンに使用します。
- 長いコンテキストの安定性とツール呼び出しの精度:MiniMax M3を候補に加えます。ただし、512K入力の閾値を超えると価格が上昇する点に注意してください。
4.3 Astraに最も近いのはどれかをどう判断するか
コンテキスト長、パラメータ数、宣伝上の位置づけ、トークン単価のいずれも、モデルの信頼できる順位づけにはなりません。異なる情報源の宣伝用ベンチマークスコアも比較可能性に欠けます。「Astra + Codexに最も近いのはどれか」を判断する唯一の確実な方法は、同じハーネス、同じタスクセットで、タスク成功率、実行時間、トークンコスト、ツール互換性、人的介入回数を統一して記録することです。具体的な方法は第6節を参照してください。
5 三つの再現ルート、具体的にどう選ぶか?
5.1 オリジナル Codex の操作体験が欲しいなら:ルートA
Codex Harness をそのまま残し、Responses プロトコルを正式にサポートする中国国内サービスに接続します。主力を Qwen にしたいなら百炼、複数の中国製モデルを使い分けたいなら TokenHub を選びます。メリットは学習・移行コストが低く、ファイル操作も Agent 実行の仕組みもオリジナルのままであること。トレードオフとして、モデルの知能は Astra と差があり、互換インターフェースの実装度合いがツール呼び出しの体験に影響します。また、モデルごとにコンテキストや推論パラメータを個別に調整する必要があります。
5.2 中国製モデルとマルチモデルの自由度が欲しいなら:ルートB
OpenCode に中国国内のマルチモデル API を組み合わせ、必要に応じて Qwen Code、Kimi Code、DeepSeek Harness を補います。長期的に複数モデルを使い、特定ベンダーに縛られたくない開発者に最適で、同じタスクを異なるモデルがどう処理するかを横並びで比較するのも最も簡単です。代償は、実行戦略が Codex と異なること、そして複数 Provider の接続に伴う追加の設定・保守作業です。
5.3 Astra の能力を最大限に残したいなら:ルートC
ルートC の組み合わせは「オリジナル Codex CLI + GPT-6 Astra + 利用可能な API 接続サービス」です。チャネルが本当にオリジナルの GPT-6 Astra を提供し、Codex に必要な Responses API、ストリーミングイベント、ツール呼び出し、コンテキスト管理を完全にサポートしていれば、モデルと Harness という二つの中核コンポーネントを同時に維持できます。このルートが解決するのはネットワークの可用性であり、中国製モデルによる代替とは別の話です。
APIYI を例にすると、接続方法はルートAとまったく同じで、Provider の設定を差し替えるだけです。
model_provider = "APIYI"
model = "gpt-6-astra"            # APIYI コンソールに実際に表示されているモデル ID を基準にしてください
model_reasoning_effort = "high"  # タスクの難易度に応じて low ~ max の間で調整

[model_providers.APIYI]
name = "APIYI"
base_url = "https://api.apiyi.com/v1"
env_key = "APIYI_API_KEY"
wire_api = "responses"
接続前に、まずスクリプトでそのチャネルが本当に Responses プロトコルとツール呼び出しをサポートしているか(単に通常のテキストを返すだけではないか)を確認しておくと安心です。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)

resp = client.responses.create(
    model="gpt-6-astra",  # コンソールで利用可能なモデル ID に置き換えてください
    reasoning={"effort": "medium"},
    input="读取 src/app.py 并告诉我入口函数名",
    tools=[{
        "type": "function",
        "name": "read_file",
        "description": "读取项目中的文件内容",
        "parameters": {
            "type": "object",
            "properties": {"path": {"type": "string"}},
            "required": ["path"],
        },
    }],
)

# 正常であれば function_call タイプの出力項目が返り、構造化された引数が付与されます
for item in resp.output:
    print(item.type, getattr(item, "arguments", None))
print("usage:", resp.usage)  # 入力・出力・キャッシュ・推論トークンが項目別に集計されているか確認
このプローブは Codex が最も依存する三つの要素、すなわち Responses プロトコル、Function Calling の返却、使用量の項目別集計をカバーしています。スクリプトが通ったら Codex に接続し、「コード修正 + テスト実行」を含む一連のタスクを走らせて、ストリーミングイベントと複数ターンのツールループが正常に動作することを確認します。
同じモデルであっても、ルートCの体験は実際のモデルルーティング、推論レベル、API の遅延と出力スループット、キャッシュヒット率、ゲートウェイのプロトコル互換性、チャネルの費用に左右されます。Codex デスクトップ版、クラウドタスク、ChatGPT アカウント専用機能は OpenAI 自身の認可体系に依存しており、APIキー経由で使うのは Codex CLI + モデル API の組み合わせです。計画を立てる際には、これらの機能は対象外と考えるべきです。
🚀 クイックスタートのヒント:ルート A とルート C を比較したい場合は、APIYI apiyi.com に登録して無料テスト枠を受け取り、同じ Codex 環境で国産モデルと GPT シリーズモデルをそれぞれ実行してみてください。APIYI の具体的なモデル掲載状況とプロトコル対応は、コンソールおよび docs.apiyi.com のドキュメントを参照してください。
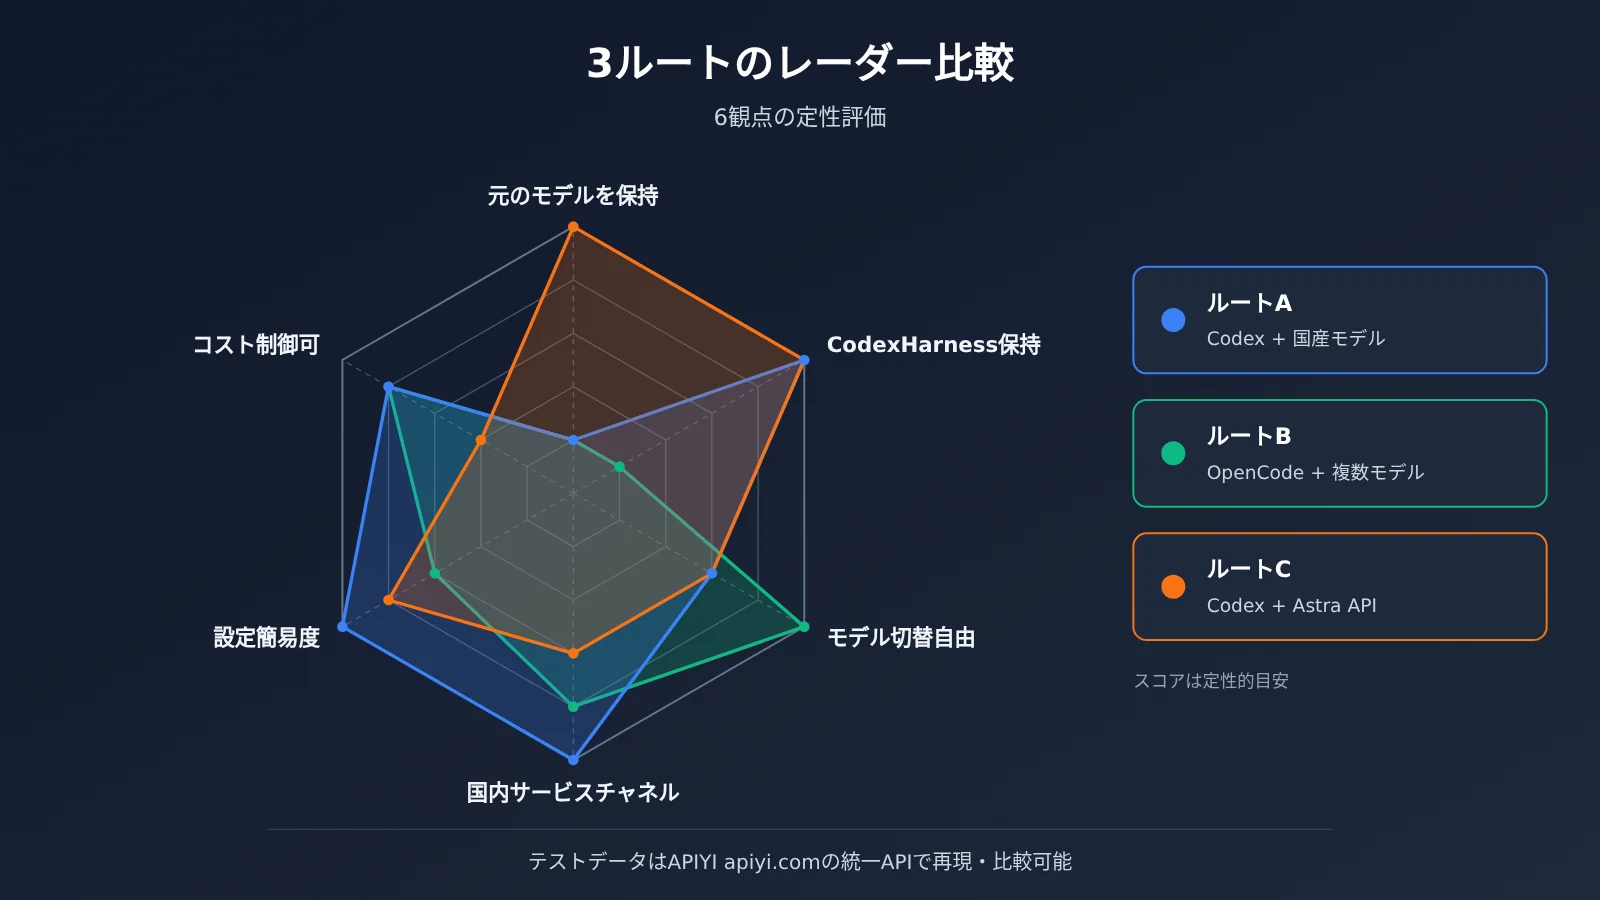
3つのルートのトレードオフをまとめると、次のとおりです。
| 比較軸 | ルート A:Codex + 国産モデル | ルート B:OpenCode など + 中国国内マルチモデル | ルート C:Codex + Astra API |
|---|---|---|---|
| 元のモデルを維持 | いいえ、Qwen / GLM / Kimi などに変更 | いいえ | はい(チャネル側で検証可能であることが前提) |
| Codex Harness を維持 | はい | いいえ、オープンな Harness に変更 | はい |
| モデル切り替え | 同一プラットフォーム内でモデル ID を変更 | 複数 Provider を自由に切り替え | チャネルがサポートするモデル間で切り替え |
| 中国国内のサービスチャネル | Alibaba Cloud 百炼、Tencent Cloud TokenHub | 百炼、TokenHub およびその他の互換サービス | Responses をサポートするサードパーティチャネル(例:APIYI apiyi.com) |
| 設定の複雑さ | 低、公式が既成の設定を提供 | 中、複数の Provider を維持する必要 | 低、プロトコルを先に検証することが前提 |
| コストの形態 | 月額パッケージ(Credits / ポイント) | パッケージまたは従量課金、Provider 次第 | 従量課金、Astra の単価は多くの国産モデルより高い |
| 適するニーズ | オリジナル Codex 体験 + モデルの国産化 | 長期的なマルチモデルワークフロー | 元の能力を最大限維持 |
5.4 中国国内で使う場合のネットワークとセキュリティの境界
モデル API が中国国内からアクセス可能なアドレスを使うだけでは、モデル呼び出しという一区間の経路しか解決できません。Agent は作業中に GitHub、npm、PyPI などのソフトウェアソース、外部の公式ドキュメント、サードパーティの MCP サービス、Web 検索にもアクセスします。これらの経路の到達性は個別に確認する必要があります。ネット検索も独立した機能です。クラウド事業者組み込みの検索、Harness 標準のネット接続ツール、自前で構築する Search API / MCP には、それぞれアクセス・課金・呼び出しの制限があります。
セキュリティ面では、コーディング Agent はファイルの変更、Shell の実行、環境変数の読み取りが可能です。次の点を実践することをおすすめします。
- APIキーは環境変数や資格情報管理ツールに保存し、ソースコードや Git リポジトリには絶対に書き込まない。
- 複雑な変更は独立した Git ブランチで行い、プロジェクトではバージョン管理と復元可能なバックアップを維持する。
- Agent が作業ディレクトリ外の機密ファイルにアクセスするのを制限し、信頼できないコードはコンテナや仮想マシン内に置く。
- 削除、デプロイ、課金などの高リスク操作には人による承認を残す。
6 実タスクでのテストはモデルのランキングよりも価値がある
6.1 5種類のテストタスクを設定する
フロントエンド、バックエンド、テスト、依存関係の設定を含む実プロジェクトを使い、5種類のタスクを設計して、モデル能力と Harness 能力をそれぞれ検証します。
- プロジェクト理解:アーキテクチャと主要モジュール間の関係を説明するよう求め、ファイルの特定、ファイルをまたぐ依存関係の理解、そして検証可能なパス参照を示せるかを観察します。
- ファイルをまたぐ開発:複数箇所の変更が必要な新機能を追加し、修正の正確さ、機能の完全性、回帰を引き起こさないかを観察します。
- バグ修正:再現可能な失敗テスト付きのプロジェクトを用意し、根本原因を特定できるか、正しい箇所を修正できるか、自らテストを実行するか、他のテストケースを壊さないかを観察します。
- 長距離 Agent ワークフロー:「要件理解 → コード修正 → テスト実行 → 失敗の発見 → 修正 → 再検証」という連続した流れを完遂し、目標を維持できるか、エラーに応じて戦略を調整できるかを観察します。
- ネット経由のドキュメント参照:最新の SDK ドキュメントを読んだうえで古い API コードを移行し、実際にネットから本文を取得できるか、新しい API をコードに反映できるか、「ツールが使えない」と「検索結果が空」を区別できるかを観察します。
6.2 成功率・所要時間・コストを記録する
各「モデル + Harness」の組み合わせで同じタスクセットを実行し、少なくとも3回繰り返して平均を取ったうえで、以下の指標を統一して記録します。
| 指標 | 計算または観察方法 |
|---|---|
| タスク成功率 | 成功したタスク数 / 総タスク数 |
| 初回通過率 | 人手による修正なしで一発成功した割合 |
| 総タスク所要時間 | タスク発行から最終検証成功まで |
| モデル呼び出し回数 | 各タスクで累計した API リクエスト数 |
| ツール呼び出し回数 | 読み取り、編集、Shell、検索などの呼び出し回数 |
| Token 使用量 | 入力、出力、キャッシュヒット、推論の内訳 |
| 実タスクコスト | 1つの成功タスクを完了するまでの実費用 |
| 人手介入回数 | ユーザーが手動で調整・修正した回数 |
実験を再現可能にするため、次の変数を固定します。同一のコードリポジトリのスナップショット、同一バージョンの Harness、同一の推論設定または思考(thinking)設定、同一の時間帯(DeepSeek のようにピーク・オフピークで課金が変わるモデルでは特に重要)。各タスクを開始する前にリポジトリをスナップショットへ戻し、前回の変更が次の回に影響しないようにします。
6.3 1回の成功タスクにかかるコストを中核の調達指標にする
推奨する計算方法は、1成功タスクあたりのコスト = 全試行の総費用 ÷ 成功タスク数です。失敗した試行の費用も必ず計上します。なぜなら、それらも同じように枠を消費しているからです。
単価の安いモデルが必ずしも安いとは限りません。あるモデルがより多くの推論ラウンド、繰り返しの修正や再試行を必要としたり、頻繁に人手の介入を要したりする場合、1タスクを完了するトータルの消費は、単価が高くても一発で正しくこなすモデルを上回る可能性があります。逆に、単純で頻度の高いタスクでは、Flash クラスのモデルの低い単価と高い速度が確実な節約につながります。コストを「成功タスクあたり」で計算してこそ、この2種類のモデルを同じ物差しで比較できるのです。
💰 コスト評価のヒント:従量課金のチャネルは、こうした実験に最も適しています。リクエストごとの Token 内訳と費用を1件ずつ照合できるからです。APIYI apiyi.com を使えば1つのキーで複数のモデルを呼び出せるので、異なるモデルの請求を同じ管理画面にまとめて集計し、1成功タスクあたりのコストを算出できます。
7 APIYI のシナリオ:モデルを交換可能なコンポーネントにする
これまでの分析はすべて同じ結論を指し示しています。安定した AI プログラミング環境を実現するには、Harness を固定し、モデルを交換可能なコンポーネントとして扱うべきです。Codex や OpenCode が実行と状態管理を担当し、API チャネルがモデルを提供し、タスクの難易度と予算に応じてモデルを柔軟に切り替えます。
APIYI apiyi.com はこのアーキテクチャにおいて統一アクセス層の役割を担います。1つの APIキーで OpenAI、Claude、Gemini などの主要モデルを呼び出せ、インターフェースは OpenAI プロトコルに準拠し、従量課金制です。プログラミングに携わるユーザーは、どの API チャネル(APIYI を含む)を選ぶ場合でも、事前に以下の項目を一つずつ確認することをおすすめします:
- 現在の Codex バージョンが要求する Responses API とストリーミングイベントをサポートしているか。
- コンソールに表示される実際のモデル ID、および目的のモデルが提供中かどうか。
- ツール呼び出しと Function Calling が完全に往復できるか。
- レイテンシと持続的な出力速度が長時間タスクのニーズを満たすか。
- キャッシュ使用量が正しく認識され、項目別に課金されるか。
これらの情報はサービスコンソールと技術ドキュメントに基づくもので、5.3節の検出スクリプトで直接検証できます。実際に導入する際の一般的な方法として、ルート A の月額プランを日常の高頻度タスクに使い、従量課金チャネルをより強力なモデルが必要な難問や比較テストに使うというものがあります。2つの Provider を同じ config.toml に記述し、--profile または model_provider を変更して切り替えます。
8 よくある質問
Q1:Astra + Codex を中国国内で再現する場合、どのルートが最も忠実度が高いですか?
忠実度が最も高いのはルートCです。オリジナルの Codex CLI に、実際に利用可能な GPT-6 Astra API を組み合わせることで、モデルと Harness という2つの中核コンポーネントがどちらも維持されます。前提として、そのチャネルがオリジナルモデルを提供できることが検証され、Responses プロトコルとツール呼び出しを完全にサポートしている必要があります。モデルの国産化が求められる場合は、ルートAが Codex の実行体験を再現する最良の選択肢です。
Q2:Qwen4-Max-Preview は Codex で長期的に使うのに適していますか?
現在の評価には適しています。このモデルは百炼の Token Plan でのみ提供され、プレビュー期間が2026年11月25日24:00に終了すると同時にサービスを終了します。プレビュー期間中にテストタスクを完了させ、同時に本番環境向けに長期的に利用可能な代替モデルを用意しておくことをおすすめします。
Q3:なぜ新しい Codex は Alibaba Cloud の旧バージョン Coding Plan に接続できないのですか?
Codex は 0.94.0 から Responses API を要求しますが、旧バージョンの Coding Plan は Chat Completions プロトコルを使用しており、公式には Codex 0.93.0 以前のバージョンとの組み合わせが求められています。Token Plan に切り替えて `wire_api = “responses”` を設定すれば新しい Codex に接続できます。なお、Token Plan は独立した APIキーを使用します。
Q4:百炼の Credits と TokenHub のポイントは直接比較できますか?
直接比較はできません。両者はそれぞれのプラットフォームの計量単位であり、モデル間の差し引きレートも異なります。より信頼できる方法は、同じタスクを両方で実行し、「1つの成功タスクを完了するために消費したプラン枠の、月額に対する割合」を比較することです。
Q5:サードパーティチャネルが Codex を実行できるか素早く検証するには?
まず5.3節の Python スクリプトで、function ツール付きの Responses リクエストを1回送信し、`function_call` 出力項目が返され、使用量の内訳統計が正常であることを確認してから、Codex に接続してテストを含む完全なタスクを実行します。APIYI apiyi.com に登録すると無料のテスト枠を受け取ってこのステップの検証を完了できます。利用可能なモデルの詳細はコンソールを基準にしてください。
Q6:同じモデルが OpenCode と Codex で異なる動作をするのは正常ですか?
正常です。Harness はコード読み取り戦略、ツールループ、コンテキスト圧縮、テスト習慣を決定し、これらがモデルの実際のパフォーマンスを変化させます。比較する際は Harness を固定してモデルを測定するか、モデルを固定して Harness を測定し、2つの変数が同時に変化するのを避けるべきです。
Q7:APIキーで Codex を使う場合、ChatGPT サブスクリプションの Codex 機能を利用できますか?
APIキー方式が提供するのは、Codex CLI とモデル API の組み合わせです。Codex のクラウドタスク、デスクトップ版、ChatGPT アカウント専用機能は OpenAI のアカウント認可に依存しており、サードパーティ API チャネルはこの部分の権益を提供できません。
Q8:複数モデルを切り替える際、総コストをどうコントロールしますか?
タスクごとに階層化します。難題には高能力モデル、バッチチェックや単純なリファクタリングには Flash 級モデル、ピーク・オフピーク課金に対応するモデルは非同期タスクを夜間に回します。統一して「1回の成功タスクコスト」で評価し、APIYI apiyi.com のような従量課金チャネルなら、各モデルの実際の消費を1件ずつ照合しやすいです。
9 まとめ:Key Takeaways
- 3つのルート、それぞれの重点:ルートAはCodexの体験を保ち、ルートBはモデルの自由を保ち、ルートCはオリジナルモデルを保ちます。
- Astra + Codex は5層の組み合わせ:モデル、実行システム、ツールエコシステム、状態管理、利用体験がそろって結果を決めます。
- ルートAには既成の設定がある:BailianとTokenHubはどちらも公式のCodex設定を提供しており、要点は
wire_api = "responses"です。 - Qwen4-Max-Preview には期限がある:Token Plan限定で、2026-11-25 24:00にプレビューを終了し、サービスを停止します。
- プランの単位は混同して比較できない:Credits、ポイント、Token、人民元はそれぞれ別の計量体系に属しており、タスクごとに実測してはじめて比較できます。
- タスクで語る:5種類の実タスクと8項目の指標を用い、1回の成功タスクあたりのコストを調達の判断根拠とします。
- モデルを交換可能なコンポーネントにする:Harnessを固定し、接続チャネルを統一し、タスクに応じてモデルを切り替えることで、環境が安定し制御可能になります。
最も実用的な始め方は、同じCodex環境に2つのProviderを設定することです。1つは国内クラウドプランで日常タスクを担い、もう1つは従量課金チャネルで対照テストと高難度タスクを担います。セクション6の方法で1ラウンド実行してから、長期的な組み合わせを決めましょう。APIYI apiyi.comを通じて対照グループをすばやく構築し、統一インターフェースで中国製モデルとGPTシリーズを同じタスクセット上で検証することをおすすめします。
📚 参考資料
- GPT-6 Astra 公式モデルドキュメント:モデル仕様、推論ティア、料金
- リンク:
developers.openai.com/api/docs/models/gpt-6-astra -
説明:コンテキストウィンドウ、最大出力、ツールサポート、長コンテキストの料金体系
-
OpenAI Codex Harness:Codex 実行フレームワークの設計
- リンク:
developers.openai.com/blog/codex-as-a-platform -
説明:エージェントループ、ツール呼び出しの戻り、コンテキスト管理、サンドボックスに関する公式説明
-
Alibaba Cloud 百炼 Codex 接続:Token Plan の設定方法
- リンク:
help.aliyun.com/zh/model-studio/codex -
説明:config.toml のフィールド、Responses プロトコル、バージョン要件
-
Alibaba Cloud Token Plan 個人版:プラン価格と Credits
- リンク:
help.aliyun.com/zh/model-studio/token-plan-personal-overview -
説明:2026-11-09 調整後のティア、割当量、初回購入割引
-
Qwen4-Max-Preview 公式ドキュメント:モデル仕様とプレビュー期間
- リンク:
help.aliyun.com/zh/model-studio/qwen4-max-preview -
説明:1M コンテキスト、プロトコル互換性、提供終了時期
-
Tencent Cloud TokenHub Codex CLI 設定:公式接続チュートリアル
- リンク:
cloud.tencent.cn/document/product/1823/130071 -
説明:Provider 設定とモデル ID の置換方法
-
Tencent Cloud TokenHub のプランと積分レート:課金ルール
- リンク:
cloud.tencent.cn/document/product/1823/130060 - リンク:
cloud.tencent.com/document/product/1823/133811 -
説明:プランティア、モデル積分レート、ピーク・オフピーク課金
-
OpenCode 公式リポジトリ:オープンソースの Coding Agent
- リンク:
github.com/anomalyco/opencode -
説明:Provider 設定とセキュリティに関する説明
-
Qwen Code、Kimi Code CLI、DeepSeek Harness:ネイティブ Harness
- リンク:
help.aliyun.com/zh/model-studio/qwen-code - リンク:
github.com/MoonshotAI/kimi-code - リンク:
help.aliyun.com/zh/model-studio/deepseek-harness - 説明:インストール、接続、対応機能の範囲
著者:APIYI 技術チーム
技術交流:APIYI 公式サイトのトップページからお気軽にお問い合わせください。その他の接続資料は docs.apiyi.com のドキュメントセンターでご覧いただけます。


