Catatan penulis: Artikel ini membahas tiga kondisi pemicu kompresi otomatis konteks Agent, strategi merangkum informasi yang perlu dipertahankan, serta kode yang bisa langsung dijalankan. Tujuannya: mengontrol penggunaan token dalam percakapan panjang tanpa kehilangan informasi penting tentang tugas.
Setelah bekerja selama beberapa jam dengan coding Agent seperti Codex, banyak developer punya pertanyaan yang sama: di dekat kotak input hanya terlihat mode izin dan model yang sedang digunakan, tanpa informasi tentang pemakaian konteks. Jadi, kapan sebaiknya membuka jendela baru? Semakin panjang percakapan, semakin banyak riwayat yang harus disertakan dalam setiap permintaan, sehingga kuota pun lebih cepat habis. Artikel ini membahas kapan kompresi otomatis konteks Agent (Context Compaction) dipicu dan bagaimana strategi peringkasannya. Dengan begitu, kamu bisa memahami mekanisme di balik alat seperti Codex dan menerapkan kemampuan serupa pada Agent buatanmu sendiri.
Ini bukan sekadar saran umum untuk “ingat membersihkan riwayat chat”, melainkan solusi praktis yang disusun berdasarkan mekanisme kompresi yang telah dipublikasikan dalam dokumentasi resmi OpenAI dan Anthropic, dipadukan dengan praktik rekayasa.
Manfaat utama: Setelah membaca artikel ini, kamu akan memahami kapan kompresi otomatis konteks Agent dipicu, informasi apa yang perlu dipertahankan atau dibuang dari ringkasan, serta mendapatkan implementasi Python yang bisa langsung disesuaikan.
Poin penting kompresi konteks otomatis pada Agent
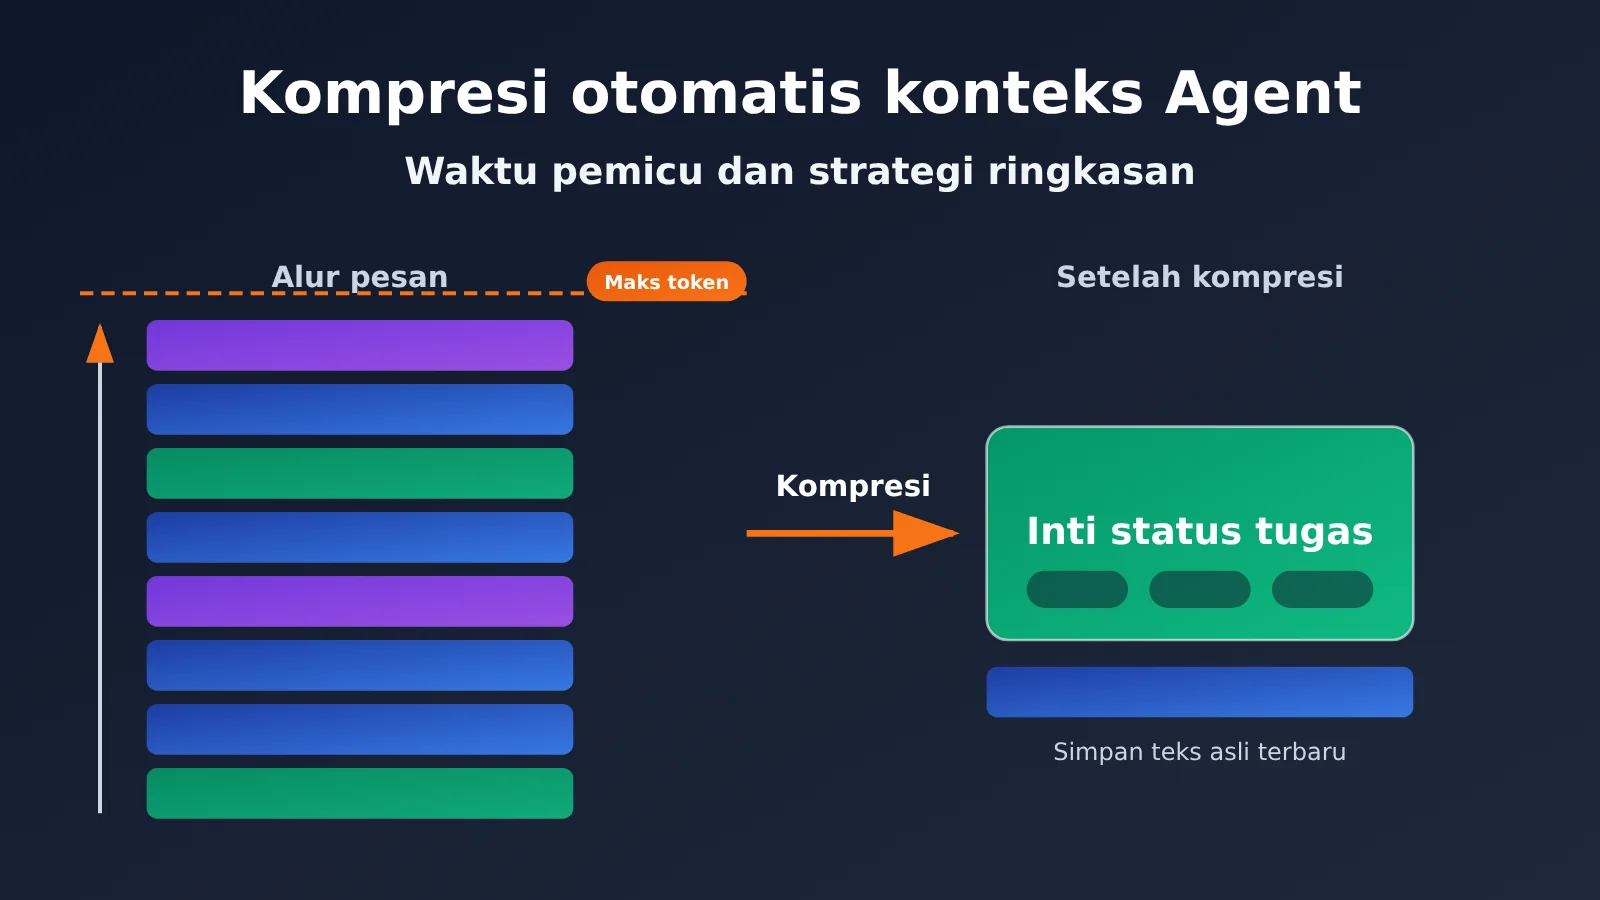
Kesimpulannya: kompresi konteks otomatis pada Agent biasanya terpicu ketika konteks mencapai ambang Token tertentu. Percakapan dan catatan pemanggilan alat yang lebih lama kemudian diringkas menjadi deskripsi keadaan yang cukup untuk melanjutkan pekerjaan. Tujuannya bukan sekadar memperpendek riwayat percakapan, melainkan mempertahankan progres tugas, fakta penting, tindakan yang sudah dilakukan, keputusan utama, dan langkah berikutnya, sambil membuang detail proses yang berulang.
| Poin | Penjelasan | Manfaat |
|---|---|---|
| Dipicu ambang Token | Kompresi otomatis saat konteks mencapai jumlah Token yang ditetapkan | Tidak perlu intervensi manual dan mencegah jendela konteks penuh |
| Kompresi proaktif | Aplikasi memanggil kompresi pada waktu tertentu, misalnya setelah satu tahap tugas selesai | Kompresi dilakukan pada batas semantik sehingga informasi yang hilang lebih sedikit |
| Dikelola otomatis oleh framework | SDK atau Agent Runtime memutuskan berdasarkan tingkat penggunaan konteks | Siap pakai dan cocok untuk pengembangan cepat |
| Merangkum, bukan memangkas | Mempertahankan progres, fakta, keputusan, dan langkah berikutnya | Agent tetap bisa melanjutkan pekerjaan setelah kompresi |
| Kompresi per tahap | Tidak disarankan melakukan kompresi pada setiap putaran | Menyeimbangkan tingkat cache hit dan kelengkapan informasi |
Mengapa Agent membutuhkan kompresi konteks otomatis
API Model Bahasa Besar pada dasarnya tidak menyimpan status. Dalam “percakapan multi-putaran”, seluruh riwayat messages dikirim ulang ke model pada setiap putaran. Jadi, permintaan pada putaran ke-50 memuat seluruh isi dari 49 putaran sebelumnya, sehingga jumlah Token input bertambah secara linear atau bahkan lebih cepat. Bagi Agent, situasinya lebih berat karena hasil pemanggilan alat—seperti isi file, output terminal, dan hasil pencarian—sering kali sangat panjang. Beberapa kali pemanggilan saja bisa mengisi lebih dari separuh jendela konteks.
Ini menimbulkan dua masalah langsung. Pertama, biaya: semakin banyak Token input pada setiap putaran, semakin cepat kuota terpakai. Kedua, kualitas: saat konteks terlalu panjang, perhatian model terhadap informasi penting di bagian awal bisa berkurang. Jika melewati batas jendela konteks, permintaan bahkan bisa langsung menghasilkan error. Kompresi konteks otomatis membantu menyeimbangkan kedua masalah ini: sebelum informasi terpotong atau jendela penuh, riwayat diringkas menjadi deskripsi keadaan yang padat agar permintaan berikutnya lebih ringan.
Tentang Codex yang tidak menampilkan penggunaan konteks
Kami belum menemukan penjelasan resmi yang jelas tentang mengapa klien tidak lagi menampilkan ukuran jendela konteks, jadi kami tidak akan berspekulasi. Yang bisa dipastikan, Codex memiliki mekanisme kompresi konteks bawaan, sehingga percakapan panjang tidak terus menumpuk seluruh riwayat aslinya tanpa batas. Jika ingin mengamati penggunaan pada setiap putaran secara tepat, cara paling andal adalah memeriksa log pemanggilan di tingkat API. Caranya akan dibahas nanti.
3 Waktu Pemicu Kompresi Konteks Otomatis pada Agent
Banyak orang mengira konteks otomatis dikompresi saat “80% kapasitas terpakai”, padahal itu bukan aturan resmi. Dokumentasi API resmi umumnya menetapkan pemicu berdasarkan ambang jumlah token, bukan persentase tetap dari jendela konteks. Kompresi juga tidak harus menunggu hingga mendekati batas: OpenAI dan Anthropic sama-sama mendukung kompresi proaktif.
Perbandingan aturan pemicu pada implementasi resmi
| Implementasi | Aturan pemicu otomatis | Keterangan resmi |
|---|---|---|
| OpenAI Responses API | Jumlah token setelah dirender mencapai compact_threshold |
Ambang dapat disesuaikan, server menanganinya secara otomatis |
| OpenAI Agents SDK | Tekanan konteks atau kebijakan ambang eksplisit | Mendukung kompresi otomatis, berdasarkan ambang tetap, dan paksa |
| Anthropic Messages API | Jumlah token input mencapai trigger.value |
Nilai bawaan 150.000, minimum 50.000 |
| Anthropic Tool Runner | Mencapai context_token_threshold |
Nilai bawaan 100.000 |
| Kompresi sesuai kebutuhan Anthropic | Dipicu secara proaktif oleh aplikasi | Dapat dipanggil setelah satu putaran percakapan selesai |
Dari tabel ini terlihat kesamaannya: hampir semua pemicu otomatis menggunakan jumlah token input sebagai acuan, dengan ambang yang dapat dikonfigurasi. Semuanya juga menyediakan cara agar aplikasi bisa menentukan sendiri kapan kompresi dilakukan.
Waktu pertama: dipicu oleh ambang token
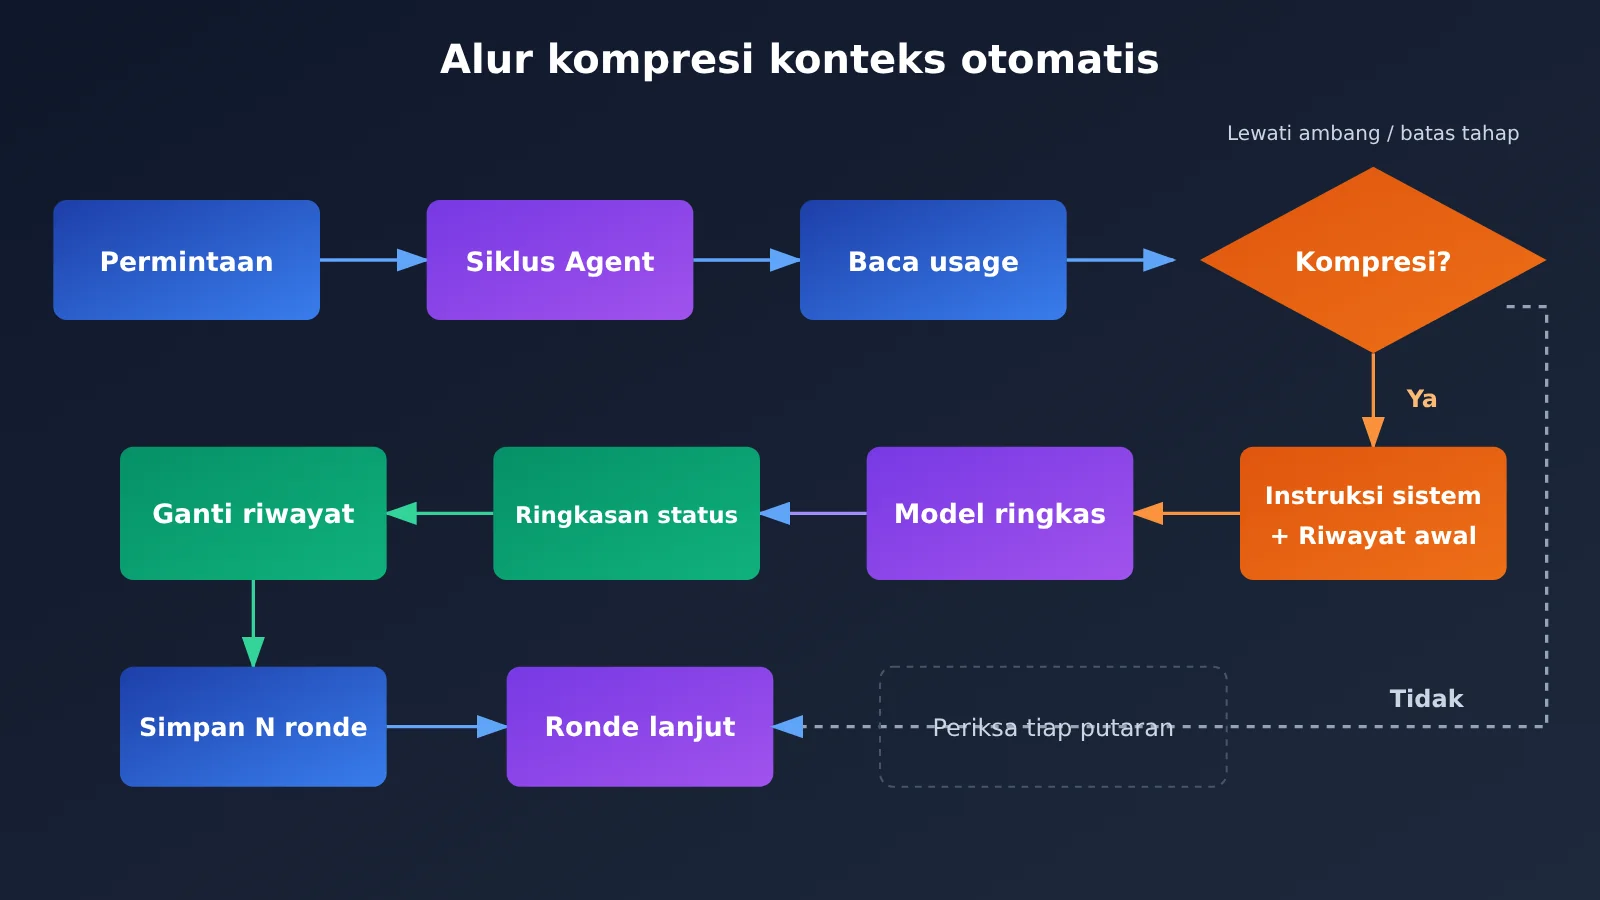
Ini adalah mekanisme pengaman yang paling dasar. Setelah setiap pemanggilan selesai, baca jumlah token input yang dikembalikan API. Begitu jumlahnya melewati ambang yang ditetapkan, lakukan kompresi. Jangan tetapkan ambang terlalu dekat dengan batas jendela konteks, karena proses kompresi perlu mengirim ulang riwayat lama ke model peringkas. Sisakan juga ruang untuk output tool pada putaran berikutnya.
Dalam praktiknya, Anda bisa mengikuti pendekatan nilai bawaan Anthropic: untuk model dengan jendela konteks panjang, tetapkan ambang di kisaran seratus ribu token dan pastikan ruang di atas ambang masih cukup untuk menampung hasil satu pemanggilan tool secara lengkap.
Waktu kedua: kompresi proaktif di batas tahap tugas
Cara ini meminimalkan kehilangan informasi. OpenAI menyarankan kompresi dilakukan setelah satu tahap pekerjaan yang bermakna selesai, bukan pada setiap putaran. Misalnya, Agent baru saja menyelesaikan rangkaian “menemukan bug → mengubah kode → menjalankan tes hingga berhasil”. Pada titik ini, proses coba-coba di tengahnya tidak lagi bernilai; yang perlu diingat hanyalah “file mana yang diubah, alasannya, dan bahwa tes sudah lulus”.
Kompresi di batas tahap memudahkan pembuatan ringkasan yang akurat karena tugas berada dalam kondisi “bersih”, tanpa pemanggilan tool yang masih menggantung.
Waktu ketiga: serahkan pengelolaan tekanan konteks kepada framework
Jika menggunakan framework seperti Agents SDK atau Tool Runner, Anda bisa langsung mengaktifkan kebijakan kompresi bawaan. Runtime akan memutuskan secara otomatis berdasarkan tekanan konteks. Cara ini lebih praktis, tetapi kendali atas isi ringkasan lebih terbatas. Pilihan ini cocok untuk tahap prototipe atau penggunaan umum.
🎯 Saran teknis: Ketiga waktu ini bisa digunakan bersamaan. Kombinasi yang disarankan adalah “utamakan kompresi proaktif di batas tahap, dengan ambang token sebagai pengaman”. Untuk memeriksa apakah pengaturan ambang sesuai pada berbagai model, Anda bisa menggunakan satu kunci yang sama di APIYI apiyi.com untuk beralih antara model OpenAI, Claude, Gemini, dan lainnya dalam pengujian perbandingan.
Strategi Ringkasan untuk Kompresi Konteks Agent Otomatis
Waktu pemicu menentukan “kapan kompresi dilakukan”, sedangkan strategi ringkasan menentukan “seperti apa hasilnya”. Kegagalan kompresi paling sering terlihat ketika Agent melupakan batasan awal pengguna atau mengulangi tindakan yang sudah dilakukan. Penyebab utamanya adalah ringkasan hanya mencatat “apa yang dibicarakan”, bukan “apa status tugasnya”.
Isi yang Perlu Dipertahankan dan Bisa Dibuang dari Ringkasan
| Kategori | Perlu dipertahankan | Bisa dibuang |
|---|---|---|
| Tujuan tugas | Permintaan awal pengguna, batasan wajib, kriteria penerimaan | Basa-basi, konfirmasi berulang |
| Progres tugas | Langkah yang sudah selesai, tahap saat ini | Proses penalaran terperinci di setiap langkah |
| Fakta penting | Jalur file, nama fungsi, nilai konfigurasi, baris penting dalam pesan kesalahan | Isi file lengkap, log yang panjang |
| Keputusan penting | Solusi yang dipilih dan alasannya | Pembahasan panjang tentang solusi yang ditolak |
| Langkah berikutnya | Daftar tugas, masalah yang belum terselesaikan | Detail yang sudah selesai dan tidak berdampak pada langkah selanjutnya |
5 Langkah Menerapkan Strategi Ringkasan
- Selalu pertahankan petunjuk sistem: Petunjuk sistem tidak ikut dikompresi dan selalu diletakkan di bagian awal messages.
- Pertahankan teks asli dari N putaran terakhir: Beberapa putaran percakapan terbaru biasanya sangat berkaitan dengan operasi saat ini. Pertahankan apa adanya dan kompres hanya bagian yang lebih lama.
- Gunakan templat ringkasan terstruktur: Minta model peringkas menghasilkan lima bagian: “tujuan / progres / fakta / keputusan / langkah berikutnya”. Dengan begitu, informasi tidak terlewat akibat peringkasan yang terlalu bebas.
- Ringkas hasil alat terlebih dahulu: Untuk respons alat yang sangat panjang, simpan hanya bagian penting, seperti beberapa baris awal dan akhir pesan kesalahan, serta judul dan kesimpulan hasil pencarian.
- Arsipkan ucapan asli pengguna secara terpisah: Sebaiknya simpan batasan eksplisit dari pengguna (seperti “jangan ubah antarmuka publik”) kata demi kata, tanpa meminta model menulisnya ulang.
Templat terstruktur adalah langkah terpenting. Saat membuat “ringkasan bebas”, model cenderung merangkum suasana percakapan. Sebaliknya, bagian-bagian terstruktur mendorong model memeriksa setiap poin dan mempertahankan informasi status yang bisa ditindaklanjuti.
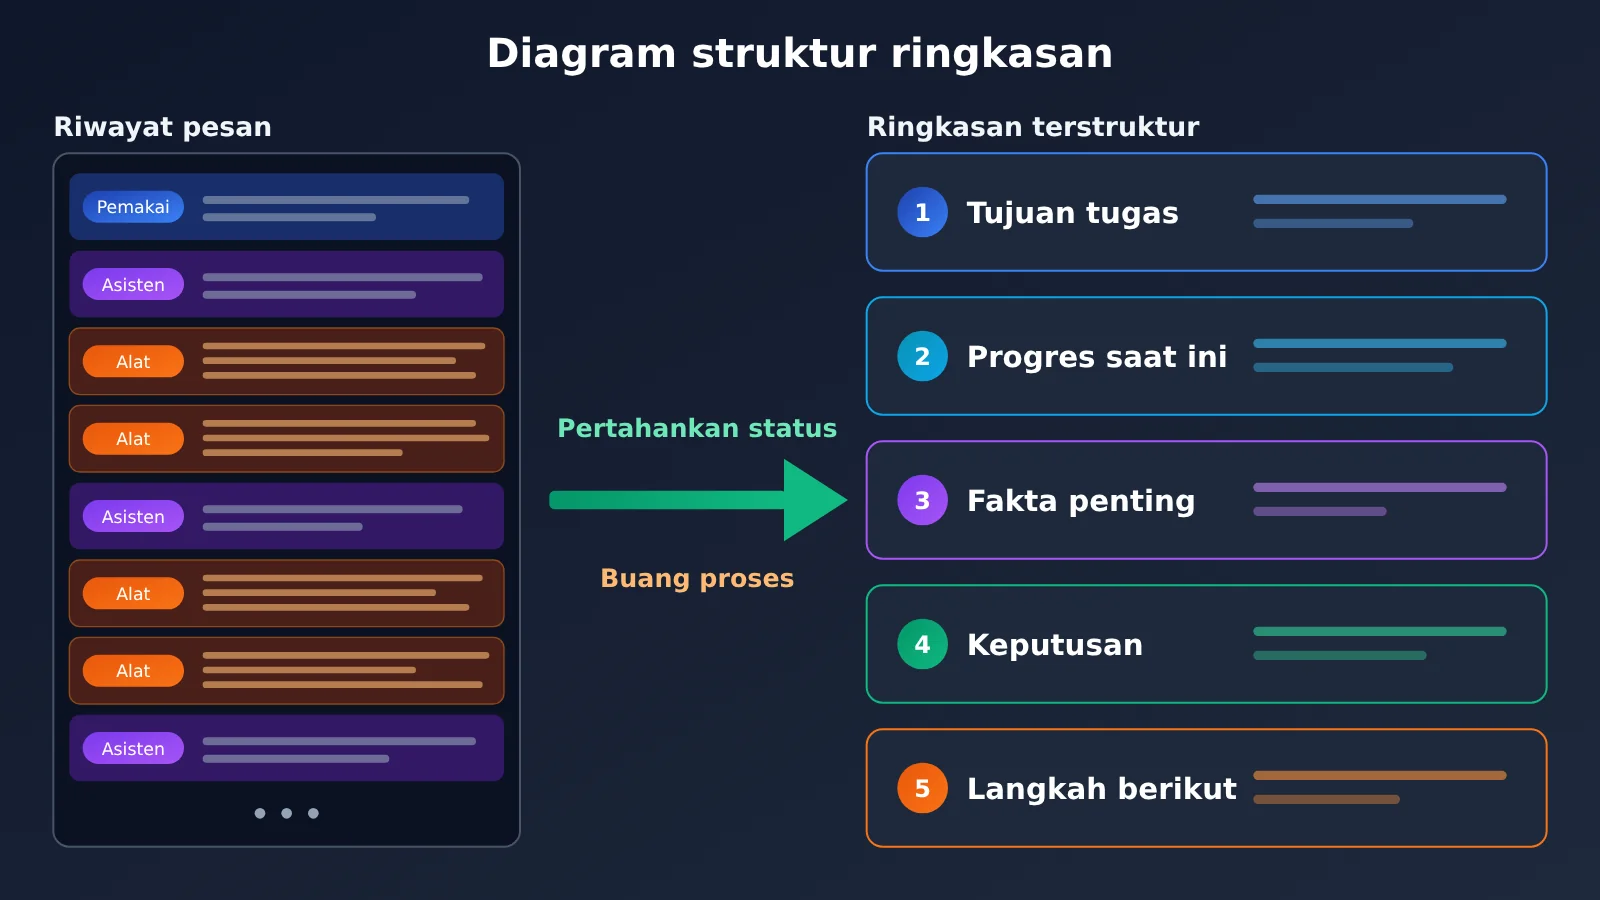
Panduan Cepat Kompresi Otomatis Konteks Agent
Berikut adalah implementasi umum dengan mengelola messages secara manual di sisi klien. Cara ini cocok untuk semua antarmuka yang kompatibel dengan OpenAI. Prinsipnya: setelah setiap pemanggilan, baca jumlah token input dari usage.prompt_tokens. Jika jumlahnya melampaui ambang batas, serahkan riwayat percakapan sebelumnya kepada model peringkas untuk dikompresi.
Contoh sederhana
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

messages = [{"role": "system", "content": "你是一个编码助手。"}]
messages.append({"role": "user", "content": "帮我检查这个函数的边界条件"})

resp = client.chat.completions.create(model="gpt-4o-mini", messages=messages)
messages.append({"role": "assistant", "content": resp.choices[0].message.content})

# 每轮记录输入 Token,作为是否压缩的判断依据
print("本轮输入 Token:", resp.usage.prompt_tokens)
Lihat kode lengkap implementasi kompresi konteks otomatis untuk agen
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MAIN_MODEL = "gpt-4o-mini"      # 主任务模型,可按需替换
SUMMARY_MODEL = "gpt-4o-mini"   # 摘要模型,可用更便宜的模型
TOKEN_THRESHOLD = 100_000       # 输入 Token 阈值,兜底触发
KEEP_RECENT = 6                 # 保留最近 N 条消息原文

SUMMARY_PROMPT = """请把以下 Agent 对话历史压缩为任务状态摘要,严格按五个栏目输出:
【任务目标】用户原始需求与硬性约束(约束请逐字保留)
【当前进度】已完成的步骤与当前阶段
【关键事实】文件路径、函数名、配置值、关键报错
【已做决策】采用的方案及原因
【下一步行动】待办事项与未解决问题
不要记录寒暄和推理过程,不要编造历史中没有的信息。"""


def compact(messages: list) -> list:
    """把早期历史压缩为一条摘要消息,保留系统提示与最近对话。"""
    system_msg = messages[0]
    old = messages[1:-KEEP_RECENT]
    recent = messages[-KEEP_RECENT:]
    if not old:
        return messages

    history_text = "\n".join(f"[{m['role']}] {m['content']}" for m in old)
    resp = client.chat.completions.create(
        model=SUMMARY_MODEL,
        messages=[
            {"role": "system", "content": SUMMARY_PROMPT},
            {"role": "user", "content": history_text},
        ],
    )
    summary = resp.choices[0].message.content
    summary_msg = {"role": "user", "content": f"(以下为之前对话的压缩摘要)\n{summary}"}
    return [system_msg, summary_msg] + recent


class CompactingAgent:
    def __init__(self, system_prompt: str):
        self.messages = [{"role": "system", "content": system_prompt}]
        self.last_prompt_tokens = 0

    def chat(self, user_input: str) -> str:
        # 时机一:上一轮输入 Token 超过阈值时先压缩
        if self.last_prompt_tokens > TOKEN_THRESHOLD:
            self.messages = compact(self.messages)

        self.messages.append({"role": "user", "content": user_input})
        resp = client.chat.completions.create(model=MAIN_MODEL, messages=self.messages)
        reply = resp.choices[0].message.content
        self.messages.append({"role": "assistant", "content": reply})
        self.last_prompt_tokens = resp.usage.prompt_tokens
        return reply

    def finish_stage(self):
        # 时机二:完成一个任务阶段后主动压缩
        self.messages = compact(self.messages)
        self.last_prompt_tokens = 0


agent = CompactingAgent("你是一个严谨的编码助手。")
print(agent.chat("帮我定位登录接口偶发 500 的原因"))
agent.finish_stage()  # 修复完成后,在阶段边界主动压缩
🚀 Mulai cepat: Daftar di APIYI apiyi.com untuk mendapatkan kuota uji coba gratis. Kode di atas bisa dijalankan cukup dengan mengganti kunci API. Platform ini menyediakan antarmuka yang kompatibel dengan OpenAI, sehingga Anda bisa memilih model utama dan model peringkas dari penyedia yang berbeda untuk mengendalikan biaya.
Perbandingan cara menerapkan kompresi konteks otomatis untuk Agent
| Solusi | Karakteristik utama | Skenario penggunaan | Platform yang tersedia |
|---|---|---|---|
| Kompresi manual di sisi klien | Menyusun messages sendiri dengan kontrol penuh atas logika peringkasan |
Agent yang dikembangkan sendiri, membutuhkan templat ringkasan khusus | APIYI apiyi.com, berbagai API resmi |
| Kompresi berdasarkan ambang batas di sisi server | Menggunakan fitur seperti compact_threshold pada Responses API |
Mengurangi pengelolaan status di sisi klien | Platform yang mendukung antarmuka tersebut |
| Kompresi bawaan framework | Dikelola otomatis oleh Agents SDK atau Tool Runner | Pembuatan prototipe, tugas umum | Bergantung pada SDK terkait |
| Langsung membuka sesi baru | Membuat ringkasan secara manual, lalu membuka jendela baru | Penggunaan sehari-hari di klien seperti Codex | Klien apa pun |
Kompresi manual di sisi klien masih unggul dalam hal kontrol, tetapi Anda perlu mengelola penghitungan token dan kualitas ringkasan sendiri. Kompresi di sisi server menghilangkan kebutuhan untuk menyusun riwayat, tetapi detail ringkasannya tidak terlihat oleh pengembang. Untuk Agent yang dikembangkan sendiri, kombinasi “ringkasan terstruktur di sisi klien + ambang batas sebagai pengaman” biasanya lebih andal.
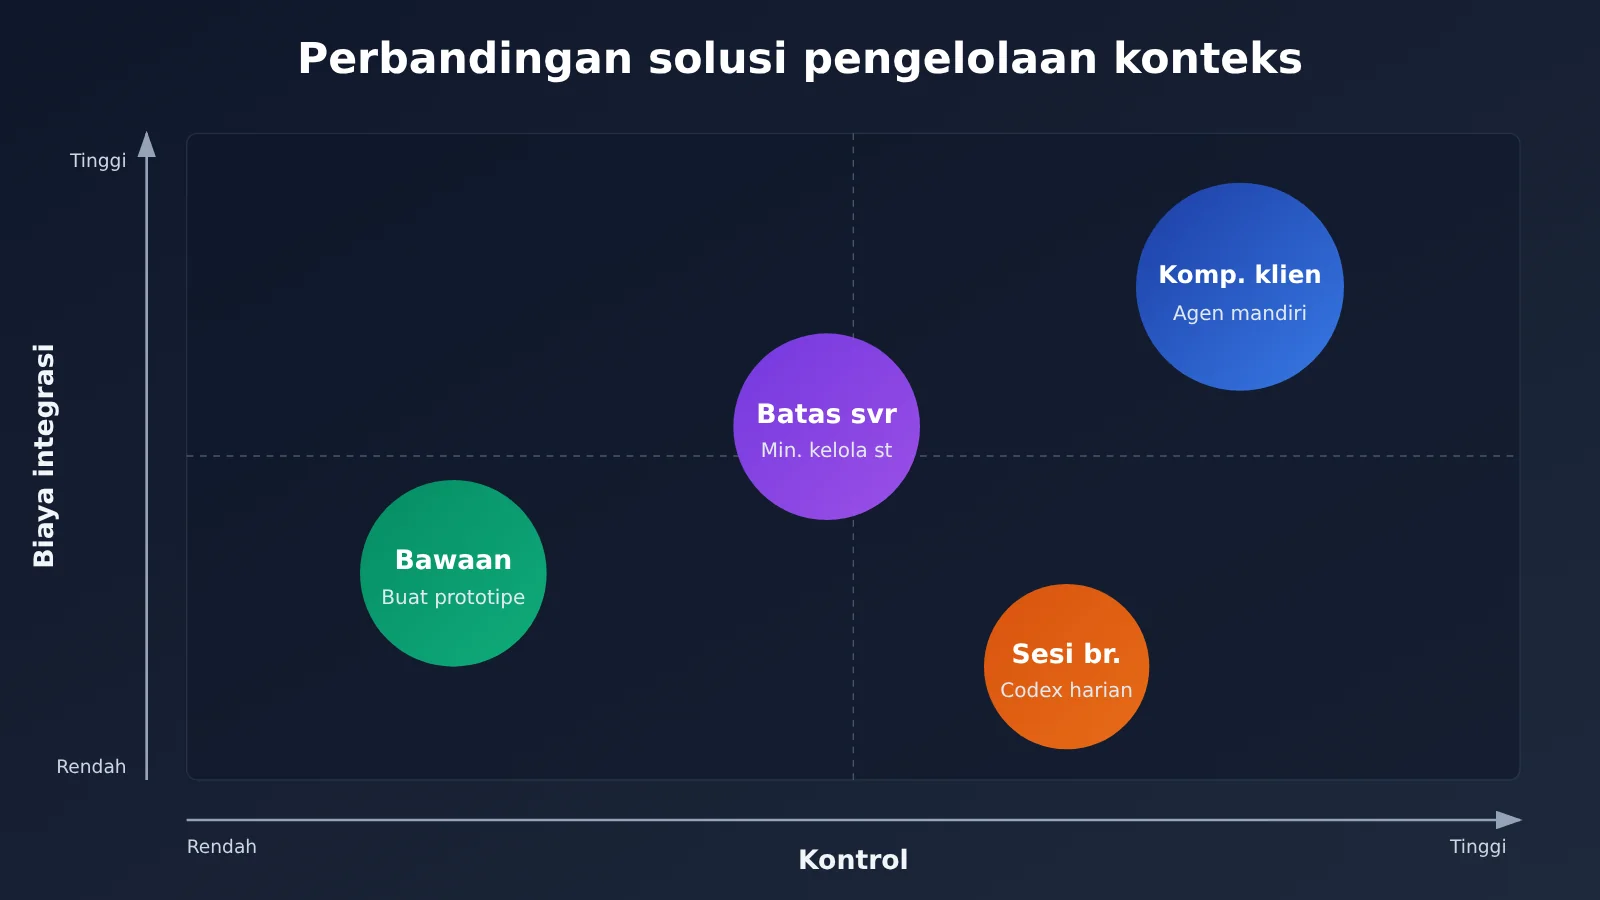
Hubungan antara kompresi konteks otomatis Agent dan biaya cache
Kompresi memang terlihat seperti cara pasti untuk menghemat biaya, tetapi Prompt Caching juga perlu diperhitungkan. Menurut penjelasan biaya cache OpenAI dari APIYI, bagian input yang terkena cache dikenakan biaya sebesar 10% dari harga input normal. Dalam percakapan panjang, cache mudah digunakan selama prefiks riwayat tidak berubah. Dengan begitu, jumlah token baru yang dikenakan harga penuh pada setiap giliran sebenarnya tidak banyak.
Saat kompresi dilakukan, prefiks pesan diganti dengan ringkasan baru. Cache untuk permintaan berikutnya pun tidak lagi berlaku, sehingga input perlu dihitung ulang dengan harga penuh. Inilah alasan pihak OpenAI tidak menyarankan kompresi pada setiap giliran: kompresi yang terlalu sering akan berulang kali mengganggu cache dan terkadang justru lebih mahal daripada tidak melakukan kompresi. Pola yang lebih masuk akal adalah membiarkan riwayat bertambah secara stabil dalam satu tahap agar cache bisa dimanfaatkan sepenuhnya, lalu melakukan kompresi saat tahap tersebut selesai atau ketika mendekati ambang batas.
Pertanyaan Umum (FAQ)
Q1: Apa itu kompresi konteks otomatis pada Agent?
Ini adalah proses merangkum percakapan dan catatan pemanggilan alat sebelumnya menjadi ringkasan status tugas, lalu menggunakan ringkasan tersebut untuk menggantikan riwayat asli. Kompresi dilakukan saat konteks mencapai jumlah Token tertentu atau ketika sebuah tahap tugas selesai. Tujuannya adalah mengurangi Token input pada setiap putaran sambil mempertahankan progres, fakta, keputusan, dan langkah selanjutnya agar Agent dapat melanjutkan tugas.
Q2: Apa bedanya kompresi konteks dengan langsung memotong riwayat?
Pemotongan hanya menghapus pesan terlama. Cara ini sederhana, tetapi dapat menghilangkan kebutuhan dan batasan awal pengguna. Kompresi menggunakan model untuk menyaring riwayat menjadi ringkasan terstruktur, sehingga jauh lebih banyak informasi yang dipertahankan. Konsekuensinya, diperlukan satu pemanggilan tambahan untuk membuat ringkasan, dan cache perlu dibangun ulang setelah kompresi.
Q3: Apakah ada aturan umum untuk melakukan kompresi saat penggunaan mencapai 80%?
Tidak ada. Dokumentasi resmi umumnya menentukan pemicu berdasarkan ambang jumlah Token. Misalnya, Anthropic Messages API menggunakan nilai default 150.000 dan nilai minimum 50.000, sedangkan Tool Runner menggunakan nilai default 100.000. Ambang batas sebaiknya disesuaikan dengan ukuran jendela konteks model dan volume output dari setiap pemanggilan alat.
Q4: Kapan sebaiknya membuka jendela baru di Codex?
Sebaiknya buka jendela baru setelah satu tahap tugas selesai, misalnya setelah sebuah fitur selesai dikembangkan dan lolos pengujian. Sebelum membuka jendela baru, Anda bisa meminta Agent membuat ringkasan dengan format “tujuan / progres / fakta / keputusan / langkah selanjutnya”, lalu menempelkannya di awal sesi baru. Jika ingin beralih ke topik baru yang tidak berkaitan dengan tugas saat ini, langsung buka jendela baru agar riwayat yang tidak relevan tidak terus menghabiskan kuota.
Q5: Bagaimana memantau konsumsi Token jika klien tidak menampilkan penggunaan konteks?
Anda bisa memeriksanya di tingkat API. Sesuai dokumentasi penggunaan OpenAI Codex, setelah antarmuka Codex dikonfigurasi ke APIYI, setiap pemanggilan akan tercatat dalam log dan statistik penggunaan di dasbor APIYI apiyi.com. Dari sana, Anda bisa melihat pertumbuhan Token input pada setiap putaran percakapan panjang dan menentukan kapan perlu melakukan kompresi atau membuka sesi baru.
Q6: Bagaimana cara cepat menguji efektivitas strategi kompresi?
Gunakan kode lengkap dalam artikel ini untuk menjalankan tugas bertahap yang sama dalam tiga mode: “tanpa kompresi”, “kompresi berdasarkan ambang batas”, dan “kompresi berdasarkan tahap”. Bandingkan total konsumsi Token dan kualitas penyelesaian tugas. Melalui APIYI apiyi.com, Anda bisa menggunakan satu kunci untuk memilih model dari penyedia yang berbeda sebagai model utama dan model peringkas. Ini memudahkan Anda menemukan keseimbangan antara biaya dan kualitas.
Q7: Apa saja keterbatasan kompresi konteks yang sudah diketahui?
Pertama, ringkasan dapat melewatkan detail, terutama nilai konfigurasi yang tampak sepele dalam kode. Kedua, setiap kompresi membuat cache tidak berlaku, sehingga kompresi yang terlalu sering dapat meningkatkan biaya. Ketiga, model peringkas terkadang “melengkapi” informasi yang sebenarnya tidak ada. Untuk mengatasinya, gunakan templat terstruktur, pertahankan batasan pengguna secara kata demi kata, dan tulis fakta penting seperti jalur file dalam catatan tugas eksternal, bukan hanya mengandalkan ringkasan.
Poin Penting Kompresi Konteks Otomatis pada Agent
- Inti kompresi: Mengubah riwayat yang panjang menjadi status tugas yang siap dilanjutkan, bukan sekadar memangkas catatan.
- Tiga waktu pemicu: Batas Token sebagai pengaman, kompresi proaktif di akhir tahap, dan pengelolaan oleh framework berdasarkan tekanan konteks.
- Tidak ada aturan 80%: Dokumentasi resmi mengacu pada ambang jumlah Token. Sesuaikan ambang dengan ukuran jendela konteks dan volume output alat.
- Ringkasan terstruktur: Gunakan lima bagian: tujuan, progres, fakta, keputusan, dan langkah berikutnya. Pertahankan batasan pengguna kata demi kata.
- Jangan kompresi setiap giliran: Kompresi yang terlalu sering dapat mengganggu cache hit. Lakukan di akhir tahap agar lebih hemat.
- Manfaatkan log: Jika klien tidak menampilkan penggunaan, amati pertumbuhan Token pada setiap giliran melalui log pemanggilan di APIYI apiyi.com.
Kesimpulan
Poin penting kompresi konteks otomatis pada Agent:
- Waktu pemicu: Utamakan kompresi proaktif di akhir tahap, gunakan ambang Token sebagai pengaman, dan manfaatkan strategi bawaan framework untuk mulai dengan cepat.
- Strategi ringkasan: Pertahankan petunjuk sistem dan beberapa giliran terakhir dalam bentuk asli, lalu kompresi riwayat sebelumnya menjadi ringkasan terstruktur dengan lima bagian.
- Keseimbangan biaya: Kompresi dapat membuat cache tidak lagi berlaku. Ritme yang disarankan adalah “biarkan konteks bertambah secara stabil selama satu tahap, lalu kompresi di akhir tahap”.
Jika sehari-hari menggunakan Codex, kamu bisa merangkum pekerjaan dan membuka jendela baru setiap kali satu tahap selesai sebagai versi manual kompresi. Jika sedang mengembangkan Agent sendiri, kamu bisa langsung menyesuaikan kode dalam artikel ini. Untuk memverifikasi hasilnya dengan cepat, coba APIYI apiyi.com. Platform ini menyediakan kuota uji coba gratis dan antarmuka terpadu untuk berbagai model. Log pemanggilannya juga memudahkan kamu melihat perubahan jumlah Token sebelum dan sesudah kompresi.
📚 Referensi
- Dokumentasi OpenAI Responses API: Penjelasan tentang kompresi konteks dan konfigurasi
compact_threshold - Tautan:
platform.openai.com/docs/api-reference/responses -
Keterangan: Panduan resmi tentang kompresi otomatis di sisi server dan pengelolaan status
-
Dokumentasi OpenAI Agents SDK: Strategi pengelolaan konteks saat agent berjalan
- Tautan:
openai.github.io/openai-agents-python -
Keterangan: Cara mengonfigurasi strategi otomatis, ambang batas tetap, dan kompresi paksa
-
Dokumentasi kompresi konteks Anthropic: Parameter pemicu kompresi untuk Messages API dan Tool Runner
- Tautan:
docs.anthropic.com - Keterangan: Nilai bawaan
trigger.valuedancontext_token_threshold, serta penggunaan kompresi sesuai kebutuhan
Penulis: Tim teknis APIYI
Diskusi teknis: Hubungi kami melalui halaman utama situs APIYI. Untuk informasi lebih lanjut tentang konfigurasi Codex, percakapan multi-putaran, dan penagihan cache, kunjungi pusat dokumentasi di docs.apiyi.com