Catatan penulis: Mengenal LongCat 2.5. Artikel ini membahas parameter dan arsitektur, 8 contoh demo resmi, posisi model dalam 25 skor pengujian internal resmi, perhitungan biaya dengan harga diskon terbatas, serta cara mengintegrasikannya ke Claude Code dan Cline.
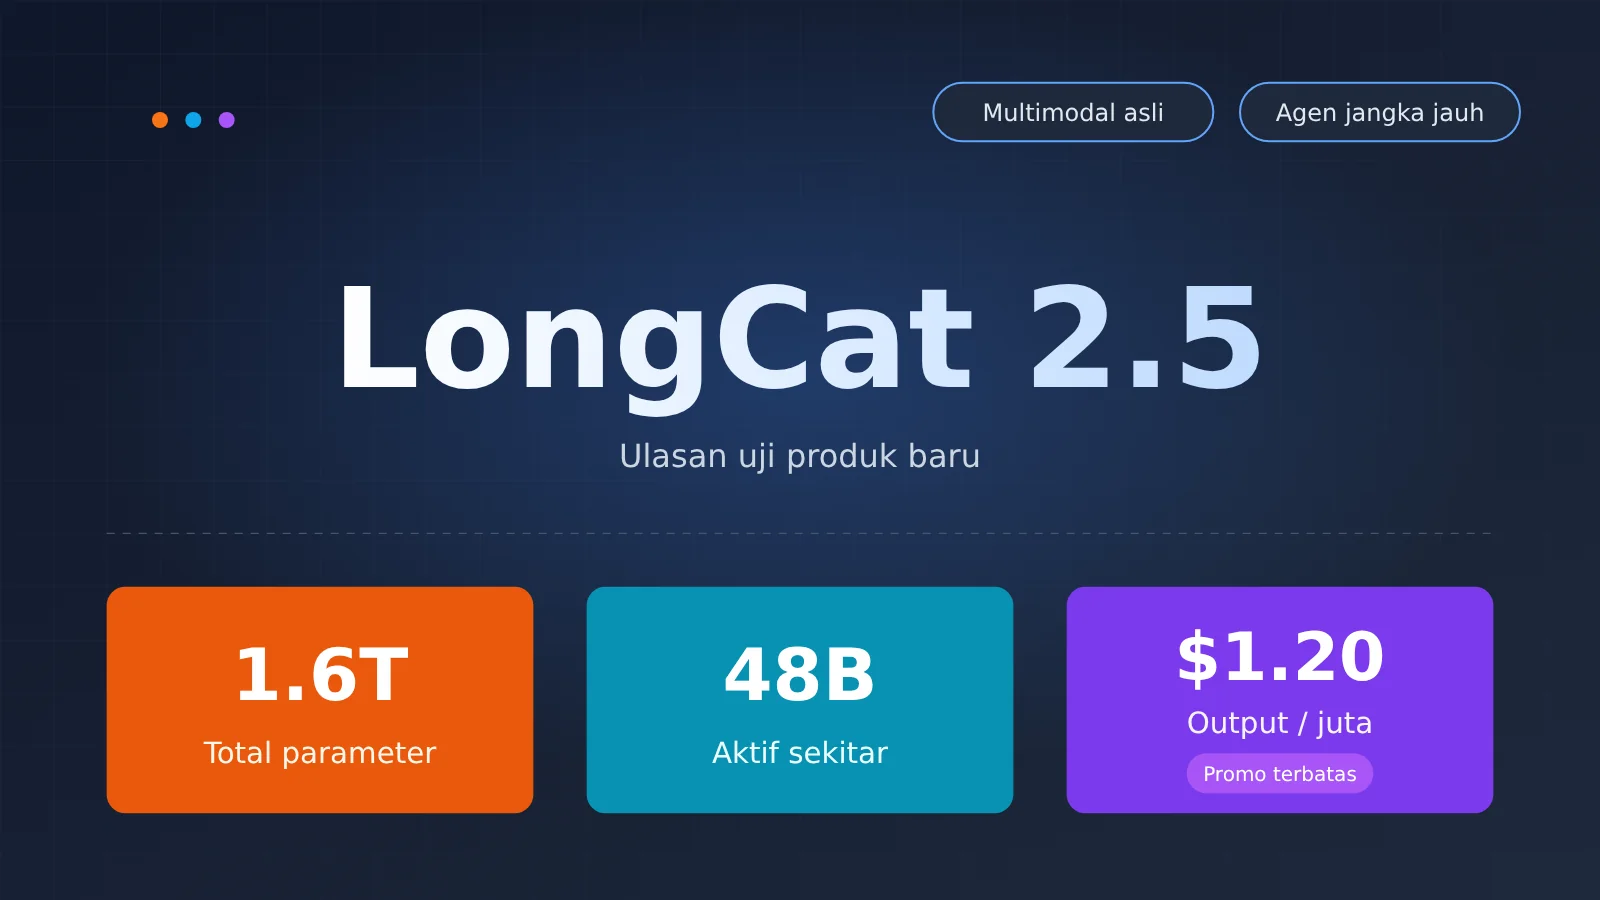
Tim LongCat dari Meituan (nama yang umum digunakan komunitas) merilis LongCat-2.5 pada 1 November. Model multimodal native ini memiliki total 1,6T parameter, dengan sekitar 48B parameter aktif per token, dan ditujukan untuk tugas agen jangka panjang. Dibandingkan dengan versi 2.0, peningkatan utamanya ada pada pemahaman visual native dan pemrograman berbasis agen. Harganya sedang mendapat diskon terbatas: output $1,20 per juta token, input tanpa cache $0,30, dan input dengan cache $0,006.
Ini bukan artikel adu model untuk menentukan pilihan. Kita hanya akan membahas tiga hal: apa itu LongCat-2.5, tugas apa yang cocok untuknya, dan berapa biaya penggunaannya. Skor benchmark hanya dipakai sebagai referensi perbandingan, bukan untuk menyimpulkan model mana yang menggantikan model lain.
Manfaat utama: Setelah membaca, kamu akan mendapat tiga hal: peta kemampuan, perhitungan biaya yang jelas, dan cara tercepat untuk mulai menggunakan model ini.
Sekilas Informasi Utama LongCat 2.5
| Informasi | Detail |
|---|---|
| Tanggal rilis | 2026-11-01 (blog resmi) |
| Posisi | Model multimodal native untuk tugas agen jangka panjang |
| Skala | Total 1,6T parameter, sekitar 48B diaktifkan per token |
| Peningkatan dari 2.0 | Pemahaman visual native, pemrograman berbasis agen |
| Konteks / keluaran maksimum | 1 juta token / 128 ribu token |
| Antarmuka | Dua protokol: format OpenAI dan Anthropic |
| Harga (diskon terbatas) | Input $0,30 (tanpa cache) / $0,006 (cache hit), output $1,20, per satu juta token |
| Bobot | GitHub dan HuggingFace sama-sama mencantumkan “segera hadir”; belum dirilis |
Ada satu hal yang mudah membingungkan soal parameter aktif. Pada hari peluncuran, sebuah unggahan komunitas menyebut angka 440B, tetapi blog resmi menyatakan sekitar 48 miliar atau 48B parameter diaktifkan per token. Artikel ini menggunakan angka 48B secara konsisten.
Apa Itu LongCat 2.5: Parameter, Arsitektur, dan Multimodal Native
Skala dan pendekatan pelatihan LongCat 2.5
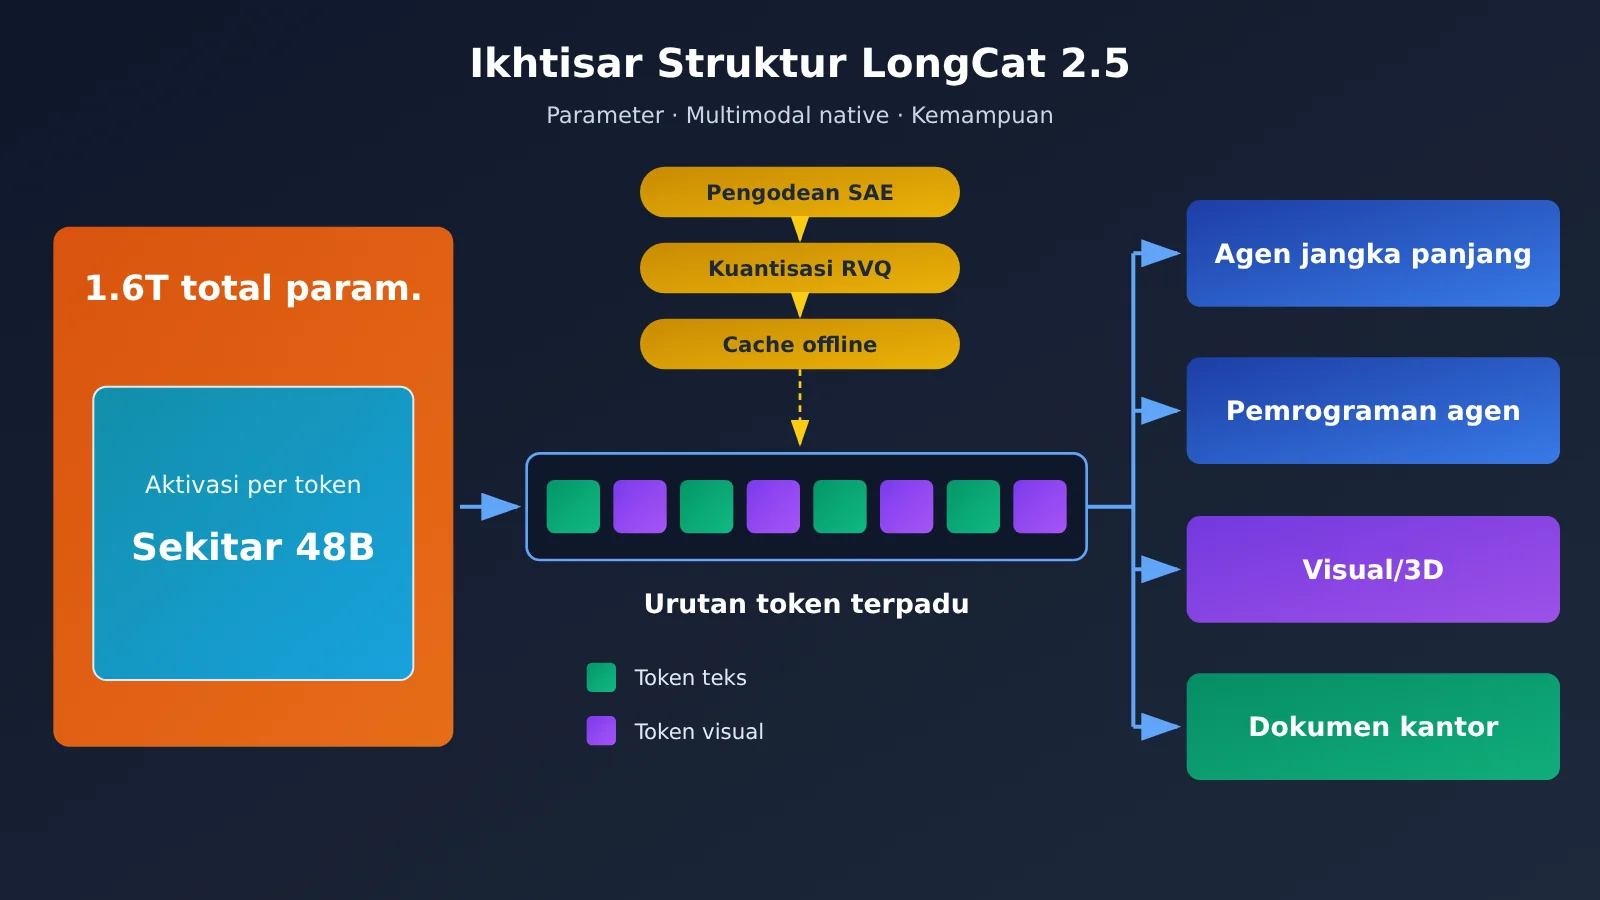
Dengan total 1,6 triliun parameter dan sekitar 48 miliar parameter yang aktif, LongCat 2.5 adalah Model Bahasa Besar dengan aktivasi sparse: ukurannya besar, tetapi hanya sebagian kecil parameter yang digunakan dalam setiap inferensi. Struktur ini memberi ruang untuk menyeimbangkan kapasitas pengetahuan dan biaya inferensi, sekaligus menjadi salah satu alasan harganya bisa ditekan.
Dalam pendekatan pelatihannya, pihak resmi menyoroti beberapa langkah yang berkaitan langsung dengan «tugas jangka panjang»:
- Lebih banyak data trajektori jangka panjang: Pelatihan sekuens panjang diperkaya dengan trajektori jangka panjang, lalu dilanjutkan dengan reinforcement learning jangka panjang berskala besar untuk melatih tugas rekayasa end-to-end, seperti pengembangan basis kode kompleks dan pembangunan proyek secara utuh.
- Mengubah trajektori kegagalan nyata menjadi tugas pelatihan: Sintesis data, pembangunan lingkungan, dan pelatihan campuran lintas Harness dikembangkan secara bersamaan untuk mengubah trajektori kegagalan Agent nyata menjadi tugas yang bisa direproduksi dan diverifikasi.
- Menekan «berpikir berlebihan» dan «pemanggilan berulang»: Pemikiran dan pemanggilan alat yang berulang diberi penalti tambahan. Untuk kasus berpikir berlebihan atau panjang respons yang meningkat terlalu cepat, reward untuk sampel positif dialokasikan ulang.
Poin ketiga cukup praktis untuk penggunaan Agent. Dalam tugas jangka panjang, biaya terbesar sering kali muncul ketika model terus berputar menggunakan alat yang sama. Menekan perilaku ini sejak tahap pelatihan berarti langsung menghemat token.
Cara kerja multimodal native di LongCat 2.5
“Multimodal native” punya arti khusus di sini. Sinyal visual direpresentasikan sebagai token diskret dalam beberapa tingkatan. Model utama memproses visual dan teks sekaligus dalam format token yang sama, tanpa mengandalkan encoder visual eksternal lalu menggabungkan fiturnya ke model.
Secara resmi, prosesnya dibagi menjadi tiga tahap:
- Diskretisasi visual pada resolusi asli: Menggunakan semantic-aligned encoder (SAE) dan residual vector quantization (RVQ) untuk mengubah gambar menjadi token diskret.
- Prapemrosesan token visual secara offline: Setelah tokenizer ditetapkan, ID token visual bisa dihitung dan disimpan dalam cache secara offline.
- Pembelajaran bersama: Embedding visual dilatih bersama model utama.
Menurut pihak resmi, desain ini membuat model unggul dalam Visual Coding dan mendukung tugas seperti desain kreatif dan 3D. Pada tabel benchmark di bagian berikutnya, 3DCodeBench dan Vision2Web mengukur kemampuan tersebut.
Mengapa LongCat 2.5 bisa ditawarkan dengan harga ini
Blog resmi membahas efisiensi rekayasa dengan cukup panjang, dan bagian ini membantu menjelaskan harganya. Pelatihan dijalankan menggunakan perangkat komputasi buatan dalam negeri Tiongkok, dengan VRAM per kartu kurang dari 80 GB. Timnya menggunakan FSDP dengan sharding ganda, paralelisme kosakata campuran, dan replikasi expert dinamis untuk menekan penggunaan VRAM. Pada tugas SFT dengan urutan panjang, konfigurasi FSDP ini menghasilkan throughput per kartu 86% lebih tinggi daripada baseline DDP.
Untuk inferensi, LongCat menggunakan W4A4: bobot dan aktivasi expert sama-sama dikuantisasi menjadi 4 bit. Dalam uji beban sistem produksi resmi, dibandingkan baseline W8A8 INT8: throughput prefill +43,3%, throughput decode +42,77%, latensi token pertama (TTFT) -15,91%, dan latensi per token (TPOT) -19,72%. Ketika throughput naik lebih dari 40%, biaya per token pun turun.
Apa keunggulan LongCat 2.5: agen untuk tugas jangka panjang dan 8 contoh resmi
Lompatan LongCat 2.5 dibandingkan 2.0
Mari mulai dengan membandingkan kedua versinya. Angka berikut berasal dari pengujian internal resmi LongCat, sementara item perbandingan bertanda bintang berasal dari papan peringkat publik. Bagian ini hanya mengutip skor dua generasi LongCat itu sendiri.
- Terminal Bench v4.0: 2.0 mendapat 3,0, sedangkan 2.5 mendapat 38,5.
- DeepSWE v1.1: 2.0 mendapat 9,7, sedangkan 2.5 mendapat 64,6.
- Program Bench Almost Resolved: 2.0 mendapat 2,5, sedangkan 2.5 mendapat 25,5.
- AutomationBench v1.0.6: 2.0 mendapat 15,8, sedangkan 2.5 mendapat 51,8.
Semua benchmark ini menguji tugas dengan rangkaian langkah panjang, seperti operasi terminal multilangkah, perbaikan tingkat repositori, dan alur otomatisasi. Versi 2.0 hampir tidak mencetak skor pada tugas-tugas ini, sementara 2.5 mencapai kisaran yang memungkinkan perbandingan dengan model lain. Ini menunjukkan bahwa peningkatan dalam pemrograman berbasis agen memang nyata. Menurut keterangan resmi, semua hasil LongCat-2.5 diperoleh dengan thinking aktif, temperature=1.0, dan top_p=0.95.
8 contoh demo resmi LongCat 2.5
LongCat merilis 8 contoh yang dibuat dari awal hingga akhir, dibagi menjadi dua kelompok. Perlu dicatat, ini adalah demo resmi dan artikel ini tidak menguji ulang setiap contohnya.
| Kategori | Contoh | Kemampuan yang diuji |
|---|---|---|
| Pengembangan perangkat lunak | Simulasi fluida real-time | Perhitungan fisika + rendering frontend real-time |
| Pengembangan perangkat lunak | Tampilan interaktif artefak 3D | Pembuatan adegan 3D dan logika interaksi |
| Pengembangan perangkat lunak | Diorama kota | Tata letak dan pengorganisasian banyak objek |
| Pengembangan perangkat lunak | Aset adegan miniatur | Kendali detail dalam pembuatan aset 3D |
| Pekerjaan profesional | Analisis operasional bisnis | Pembacaan data, penguraian metrik, dan penulisan kesimpulan |
| Pekerjaan profesional | Laporan analisis umpan balik pelanggan | Klasifikasi dan peringkasan teks tidak terstruktur |
| Pekerjaan profesional | Halaman estetika warna bergaya Tiongkok | Estetika visual dan tata letak halaman web |
| Pekerjaan profesional | Generator undangan acara | Interaksi formulir + desain tata letak |
Tiga dari empat contoh pengembangan perangkat lunak berkaitan langsung dengan 3D, sejalan dengan kemampuan visual bawaan dan Visual Coding. Sementara itu, kelompok pekerjaan profesional lebih berfokus pada “membaca materi dan menghasilkan karya jadi”, searah dengan tugas dalam benchmark seperti JobBench dan GDPVal.
Di posisi mana skor benchmark LongCat 2.5?
Tabel evaluasi resmi mencakup lebih dari 25 pengujian dalam tiga kategori: Code Agent, General Agent, dan Visual. Berikut sembilan di antaranya untuk membandingkan lima model.
| Benchmark | LongCat-2.5 | Claude Opus 5 | GPT-5.6-Sol | GLM-5.3 | Kimi K3 |
|---|---|---|---|---|---|
| Terminal Bench v2.1 | 88.4 | 89.1* | 88.8* | 88.2* | 88.3* |
| Terminal Bench v4.0 | 38.5 | 53.9* | 37.3* | 41.8* | 12.6* |
| DeepSWE v1.1 | 64.6 | 68.8* | 72.7* | 66.9* | 67.5* |
| BrowseComp | 91.9 | 90.8* | 90.4* | 81.0 | 91.2* |
| HLE w/tools | 63.1 | 64.7* | 58.0* | 62.5* | 56.0* |
| JobBench | 65.4 | 66.7* | 45.4* | 61.4* | 52.9* |
| MCP Atlas | 83.1 | 85.8* | 81.8* | 84.2* | 84.2* |
| 3DCodeBench Text to 3D | 55.4 | 54.3 | 52.3 | 53.4 | 49.3 |
| Vision2Web | 78.6 | 80.2* | 73.5* | 77.8* | 79.0* |
Tanda * menunjukkan skor yang dikutip dari papan peringkat publik atau laporan teknis. Skor lainnya berasal dari pengujian internal LongCat dan hanya digunakan sebagai perbandingan.
Dari data tersebut, ada beberapa hal yang bisa dicatat:
- Pencarian informasi: Skor BrowseComp mencapai 91.9, tertinggi di antara lima model. LongCat menggunakan harness ringan buatan sendiri, dengan hanya dua alat yang aktif, yaitu search dan browse_with_goal, serta maksimal 1024 putaran.
- Pembuatan 3D: Skor 3DCodeBench Text to 3D mencapai 55.4, tertinggi di antara lima model. Namun, tidak ada tanda bintang pada kelima skor di baris ini: semuanya berasal dari pengujian internal LongCat.
- Tugas terminal: Pada Terminal Bench v2.1, skor kelima model berdekatan, antara 88.2 dan 89.1. Pada v4.0 yang lebih sulit, LongCat-2.5 mendapat 38.5 dan Claude Opus 5 mendapat 53.9, selisih 15.4 poin.
- Perbaikan tingkat repositori: Skor DeepSWE v1.1 sebesar 64.6 adalah yang terendah di antara lima model, sedangkan GPT-5.6-Sol mendapat 72.7.
- Pemanggilan alat dan tugas perkantoran: Skor MCP Atlas 83.1 dan JobBench 65.4 masing-masing terpaut 2.7 dan 1.3 poin dari Opus 5.
Harness yang digunakan juga perlu diperhatikan. Kedua versi Terminal Bench menggunakan Claude Code harness dengan max_seq_length 512K; DeepSWE menggunakan mini-swe-agent dengan panjang sekuens 1M. Skor dari pengujian dengan harness berbeda tidak sebaiknya dibandingkan secara langsung.
Cara menghitung harga LongCat 2.5: perbandingan model dan biaya 1 juta token
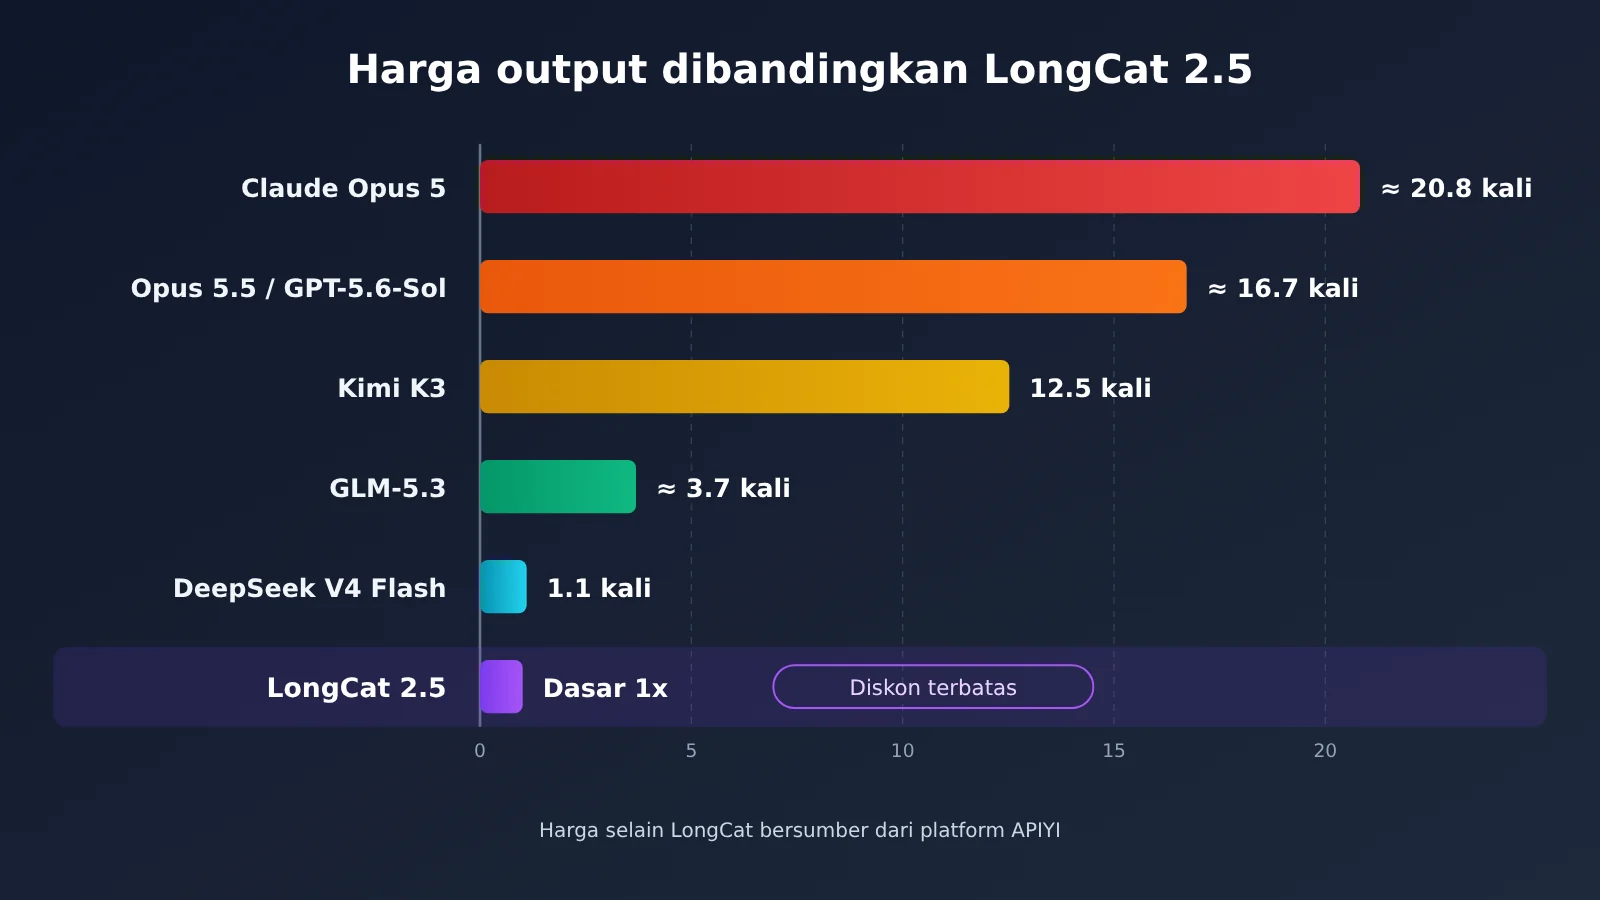
Keterangan gambar: Harga LongCat-2.5 adalah harga diskon terbatas dari platform API resmi. Harga model lainnya diambil dari daftar model platform APIYI apiyi.com.
| Model | Input (per 1 juta token) | Output (per 1 juta token) | Harga output dibandingkan LongCat |
|---|---|---|---|
| LongCat-2.5 (diskon terbatas, platform resmi) | $0.30 (cache hit $0.006) | $1.20 | 1 kali |
| Claude Opus 5 | $5 | $25 | Sekitar 20,8 kali |
| Claude Opus 5.5 | $4 | $20 | Sekitar 16,7 kali |
| GPT-5.6-Sol | $4 | $20 | Sekitar 16,7 kali |
| Kimi K3 | $3 | $15 | 12,5 kali |
| GLM-5.3 | $1.4 | $4.396 | Sekitar 3,7 kali |
| DeepSeek V4 Flash | $0.44 | $1.32 | Sekitar 1,1 kali |
Harga APIYI apiyi.com diperiksa pada 2026-11-02 berdasarkan daftar model yang ditampilkan platform pada hari tersebut. Harga LongCat-2.5 berasal dari platform LongCat API; pihak resmi menyatakan bahwa harga dapat berubah.
Perhitungan biaya untuk 1 juta token
Misalkan sebuah tugas batch menggunakan total 1 juta token: 800 ribu input dan 200 ribu output, tanpa memperhitungkan cache.
- LongCat-2.5 (diskon terbatas): 0,8 × $0.30 + 0,2 × $1.20 = $0.48
- DeepSeek V4 Flash: $0.352 + $0.264 = $0.616
- GLM-5.3: $1.12 + $0.879 ≈ $2.00
- Kimi K3: $2.40 + $3.00 = $5.40
- GPT-5.6-Sol atau Claude Opus 5.5: $3.20 + $4.00 = $7.20
- Claude Opus 5: $4.00 + $5.00 = $9.00
Untuk pekerjaan yang sama, biaya Opus 5 sekitar 18,75 kali LongCat-2.5. Jika tugas mendapat cache hit, selisihnya akan lebih besar. Contoh dari pihak resmi menggunakan 1 juta token input (400 ribu cache hit dan 600 ribu cache miss) ditambah 500 ribu token output, dengan tagihan $0.18 + $0.0024 + $0.6 = $0.7824. Harga input yang mendapat cache hit hanya $0.006 per 1 juta token, atau 1/50 dari harga cache miss.
Ada dua detail penagihan lain yang perlu diingat: biaya hanya dikenakan jika respons mengembalikan HTTP 200; permintaan gagal seperti 401, 403, 429, dan 500 tidak dikenakan biaya. Saldo dibayar di muka dan tidak kedaluwarsa; jika ada kredit bonus, kredit tersebut digunakan terlebih dahulu.
Cara praktis membandingkan beberapa model
Kenyataannya, proyek Agent jarang hanya menggunakan satu model. Kamu mungkin ingin menggunakan petunjuk yang sama untuk melihat perbedaan output LongCat-2.5, Claude, GPT, dan GLM. Di APIYI apiyi.com, kamu bisa berganti model dengan satu akun dan satu kunci API, tanpa perlu mendaftar dan mengisi saldo di setiap penyedia.
📌 Catatan: Model dan harga mengacu pada daftar model di platform APIYI apiyi.com. Saat ini LongCat-2.5 belum tersedia di APIYI, tetapi akan segera diluncurkan.
Cara mulai menggunakan LongCat 2.5: coba di situs resmi dan integrasikan lewat API
Langkah pertama: coba dulu lewat web
LongCat bisa dicoba secara online di longcat.ai/chat. Menurut postingan komunitas, selama masa peluncuran pengguna baru mendapat 10 juta token dan pengguna lama mendapat 5 juta token. Kuota ini masuk secara otomatis, dan cache hit tidak mengurangi kuota bonus. Postingan tersebut juga menyebutkan paket promo terbatas seharga 9,9 yuan yang akan segera hadir. Coba dulu tugas pencarian dan analisis gambar, karena keduanya mendapat posisi tinggi dalam benchmark.
Langkah kedua: gunakan API, ingat empat parameter
- Endpoint format OpenAI:
https://api.longcat.ai/openai - Endpoint format Anthropic:
https://api.longcat.ai/anthropic - Field model:
LongCat-2.5 - Konteks dan output: jendela konteks 1M, output maksimal 128K token
Untuk batas penggunaan, informasi resmi hanya menyebutkan bahwa permintaan yang melampaui batas akan mengembalikan HTTP 429, kode kesalahan rate_limit_exceeded, dan retry_after bernilai 60. Klien juga disarankan mencoba ulang dengan exponential backoff. Angka RPM dan TPM yang spesifik belum dipublikasikan.
Jika kode kamu sudah menggunakan OpenAI SDK untuk memanggil model lain, cukup ubah tiga bagian saat beralih: base_url, api_key, dan model. Misalnya, saat menggunakan APIYI, base_url-nya adalah https://api.apiyi.com/v1. Untuk beralih ke layanan resmi LongCat, ganti menjadi https://api.longcat.ai/openai dan ubah model menjadi LongCat-2.5.
Langkah ketiga: integrasikan ke Claude Code
- Claude Code, ubah bagian env di
~/.claude/settings.json: isiANTHROPIC_AUTH_TOKENdengan kunci API LongCat - Bagian env di file yang sama: isi
ANTHROPIC_BASE_URLdenganhttps://api.longcat.ai/anthropic - Bagian env di file yang sama: isi
ANTHROPIC_MODELdenganLongCat-2.5 - Bagian env di file yang sama: isi
CLAUDE_CODE_MAX_OUTPUT_TOKENSdengan131072 - Bagian env di file yang sama (disarankan untuk diubah juga): arahkan
ANTHROPIC_SMALL_FAST_MODEL,ANTHROPIC_DEFAULT_SONNET_MODEL, danANTHROPIC_DEFAULT_OPUS_MODELkeLongCat-2.5
Jika tiga variabel terakhir tidak diubah, subtugas internal Claude Code mungkin masih meminta model default. Akibatnya, permintaan bisa gagal atau masuk ke penagihan yang salah.
Langkah keempat: integrasikan ke Cline
- Cline, panel pengaturan di sidebar VS Code: pilih opsi yang kompatibel dengan OpenAI pada API Provider
- Di panel yang sama: isi Base URL dengan
https://api.longcat.ai/openai - Di panel yang sama: isi API Key dengan kunci LongCat dan Model ID dengan
LongCat-2.5
Dokumentasi resmi LongCat menyediakan halaman integrasi khusus untuk Cline. Ikuti nama field yang tercantum di halaman resmi. Ada juga halaman integrasi untuk lebih dari sepuluh alat lain, termasuk Codex, OpenCode, Kilo Code, Cherry Studio, Chatbox, dan CC Switch.
🚀 Saran untuk memulai: gunakan kuota bonus resmi untuk memastikan tugas berjalan dengan baik, lalu putuskan apakah perlu mengintegrasikannya untuk jangka panjang. Jika kamu juga perlu memanggil Claude, GPT, dan Gemini sebagai pembanding, kamu bisa mengelolanya lewat satu antarmuka yang kompatibel dengan OpenAI di APIYI apiyi.com. Setelah LongCat-2.5 tersedia di sana, kamu juga bisa beralih model langsung dari akun yang sama.
Tugas apa yang cocok untuk LongCat 2.5?
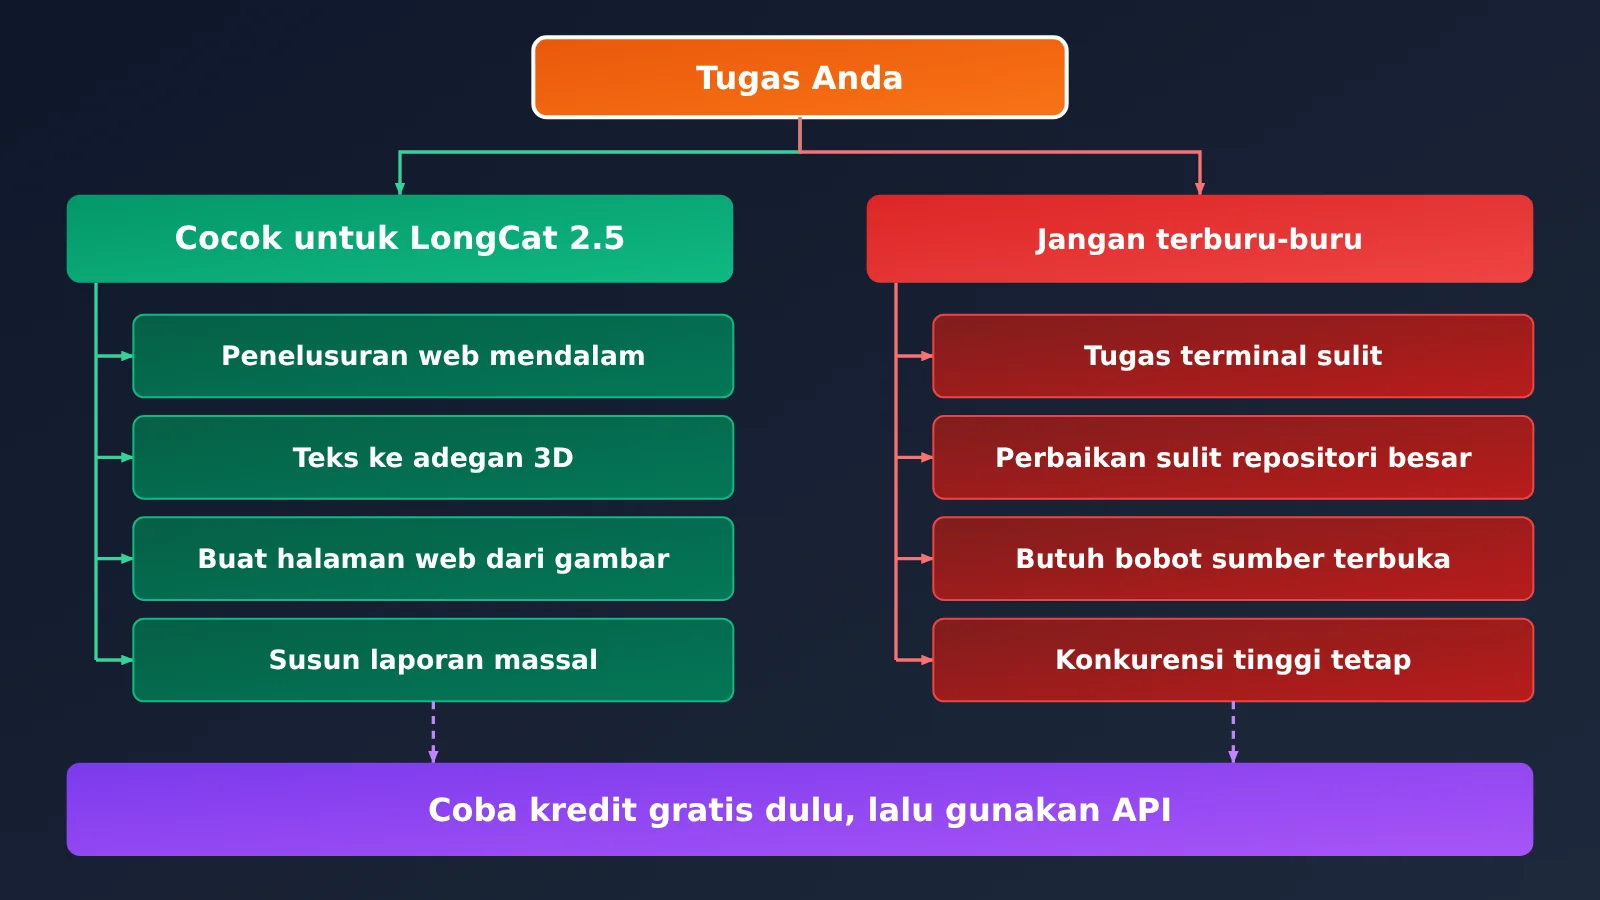
| Tugas yang cocok untuk LongCat 2.5 | Tugas yang sebaiknya tidak terburu-buru diserahkan |
|---|---|
| Penelusuran web beberapa putaran dan perangkuman informasi (BrowseComp 91.9) | Tugas operasional terminal yang sulit dan terdiri dari banyak langkah (Terminal Bench v4.0: 38.5, Opus 5: 53.9) |
| Membuat adegan 3D dengan Three.js dan sejenisnya dari deskripsi teks (3DCodeBench 55.4) | Memperbaiki bug rumit di repositori besar (DeepSWE v1.1: 64.6, terendah di antara lima kolom) |
| Membuat halaman web berdasarkan desain atau tangkapan layar (Vision2Web 78.6) | Proyek yang wajib di-deploy secara privat dan membutuhkan bobot lokal (bobotnya belum dirilis) |
| Mengolah umpan balik pelanggan dan data bisnis dalam jumlah besar menjadi laporan tertulis (JobBench 65.4, harga output diskon untuk waktu terbatas: $1.20/juta token) | Layanan produksi yang membutuhkan kuota konkurensi tinggi yang tetap (RPM/TPM belum diumumkan secara resmi) |
Tugas di kolom kiri punya kesamaan: prosesnya panjang, membutuhkan banyak token, dan sensitif terhadap harga per unit. Untuk tugas seperti ini, skor dan harga LongCat-2.5 cukup kompetitif. Bukan berarti tugas di kolom kanan tidak bisa dikerjakan, tetapi masih ada selisih skor yang terlihat atau ketentuan deployment dan kuotanya belum jelas. Sebaiknya coba dulu dalam skala kecil.
FAQ LongCat 2.5
Q1: Apakah skor benchmark LongCat 2.5 diuji oleh pihak ketiga?
Tidak. Semua skor LongCat-2.5 dalam tabel berasal dari pengujian internal resmi LongCat. Untuk model pembanding, skor bertanda bintang berasal dari laporan publik atau papan peringkat resmi, sedangkan skor tanpa bintang juga berasal dari pengujian internal LongCat. Sebaiknya gunakan skor ini sebagai referensi perbandingan.
Q2: Apakah $1,20 per juta token merupakan harga jangka panjang?
Tidak. Harga tersebut ditandai sebagai harga diskon untuk waktu terbatas, dan pihak resmi menyatakan bahwa harganya dapat berubah. Acuan utamanya adalah halaman platform LongCat API dan tagihan Anda. Untuk anggaran jangka panjang, sebaiknya siapkan model alternatif dan gunakan platform agregasi seperti APIYI apiyi.com agar Anda bisa beralih model jika diperlukan.
Q3: Apakah LongCat 2.5 sudah bersifat open source?
Belum. Tombol GitHub dan HuggingFace di blog resminya masih bertuliskan “segera hadir”. Saat ini, LongCat 2.5 hanya tersedia untuk dicoba secara online dan diakses melalui API. Pihak resmi belum memberikan jadwal rilis open source.
Q4: Apakah LongCat 2.5 bisa dipanggil melalui APIYI?
Saat ini belum bisa. APIYI akan segera menyediakan model ini. Untuk sekarang, Anda bisa langsung menggunakan API resmi LongCat. Jika ingin membandingkan Claude, GPT, dan GLM, Anda bisa menggunakan satu kunci API di APIYI apiyi.com untuk menjalankan model-model tersebut. Ketersediaan model dan harganya mengikuti daftar model di platform.
Q5: Apa yang harus dilakukan jika muncul error 429?
Error ini muncul karena batas laju permintaan terlampaui. Isi respons akan menyertakan `retry_after` dengan nilai 60. Pihak resmi menyarankan agar klien mencoba kembali dengan jeda yang meningkat secara eksponensial. Permintaan yang menghasilkan 429 tidak dikenai biaya tambahan.
Kesimpulan: Apakah LongCat 2.5 Layak Digunakan?
Poin utama LongCat 2.5:
- Posisi: Model multimodal native dengan total 1,6T parameter dan sekitar 48B parameter aktif per token, dirancang untuk tugas agen berdurasi panjang.
- Peningkatan: Dibandingkan 2.0, skor Terminal Bench v4.0 naik dari 3,0 menjadi 38,5, sedangkan DeepSWE v1.1 naik dari 9,7 menjadi 64,6.
- Keunggulan: BrowseComp 91,9 dan 3DCodeBench 55,4, tertinggi di antara lima model yang dibandingkan dalam artikel ini (berdasarkan data resmi).
- Kesenjangan: Skor Terminal Bench v4.0 dan DeepSWE v1.1 masih menunjukkan kesenjangan yang cukup jelas.
- Harga: Harga output diskon terbatas sebesar $1,20/juta token; biaya untuk 800 ribu token input dan 200 ribu token output sekitar $0,48.
- Integrasi: Mendukung protokol OpenAI dan Anthropic; cukup ubah empat variabel untuk menggunakan Claude Code.
Singkatnya: coba dulu tugas pencarian dan pemahaman gambar di longcat.ai/chat dengan kuota gratis 10M token, lalu gunakan API setelah semuanya berjalan lancar. Jika perlu beralih di antara beberapa model untuk jangka panjang, kelola semuanya melalui APIYI di apiyi.com.
📚 Referensi
- Blog resmi LongCat: Artikel peluncuran LongCat-2.5, termasuk arsitektur, pelatihan, dan tabel evaluasi
- Tautan:
longcat.ai/blog/longcat-2.5 -
Keterangan: Sumber langsung untuk jumlah parameter, 8 contoh demonstrasi, dan metodologi pengukuran skor
-
Dokumentasi platform API LongCat: Antarmuka, penagihan, dan integrasi alat
- Tautan:
longcat.ai/platform/docs -
Keterangan: Endpoint untuk dua protokol, harga diskon terbatas, serta halaman integrasi Claude Code dan Cline
-
Daftar model APIYI: Harga model di berbagai platform
- Tautan:
docs.apiyi.com/models - Keterangan: Sumber perbandingan harga dalam artikel ini; harga mengikuti informasi yang ditampilkan pada hari tersebut
Penulis: Tim Teknis APIYI
Diskusi teknis: Hubungi kami melalui halaman utama situs APIYI. Informasi selengkapnya tersedia di pusat dokumentasi docs.apiyi.com