Catatan penulis: Mengulas edisi pertama papan peringkat GDPx yang diterbitkan SemiAnalysis, membandingkan skor dan “biaya rata-rata per tugas” model-model teratas, serta membedakan biaya evaluasi dari harga Token resmi. Tujuannya membantu Anda memilih model berdasarkan kemampuan, biaya, dan ketersediaan.
Pada 2 November 2026, SemiAnalysis merilis GDPx v1.0, benchmark Agent dengan tingkat kesulitan tinggi. Claude Opus 5.5 menempati peringkat pertama dengan skor keseluruhan 12.0%, disusul Gemini 4 Carbon dengan 10.9%. Yang lebih menarik adalah biayanya: biaya rata-rata per tugas Carbon hanya sekitar 31.7% dari Opus, tetapi skornya mencapai sekitar 90.8% dari Opus.
Ini bukan sekadar kabar angin. Data di atas berasal dari papan peringkat resmi GDPx dan laporan asli SemiAnalysis. Situs resminya juga memublikasikan 14 tugas representatif dengan total 168 jejak eksekusi. Meski begitu, papan peringkat ini mudah disalahartikan. “Biaya rata-rata per tugas” bukan harga API, dan “12%” bukan tingkat keberhasilan AI dalam pekerjaan nyata.
Manfaat utama: Artikel ini merangkum data biaya dan kemampuan dalam edisi pertama papan peringkat GDPx, sekaligus membedakan secara tegas tiga jenis harga: biaya evaluasi GDPx, harga Token resmi dari penyedia, dan harga yang tercantum dalam dokumentasi APIYI. Setelah membacanya, Anda akan memahami mengapa peringkat keseluruhan dan pilihan model untuk penggunaan nyata bisa berbeda.
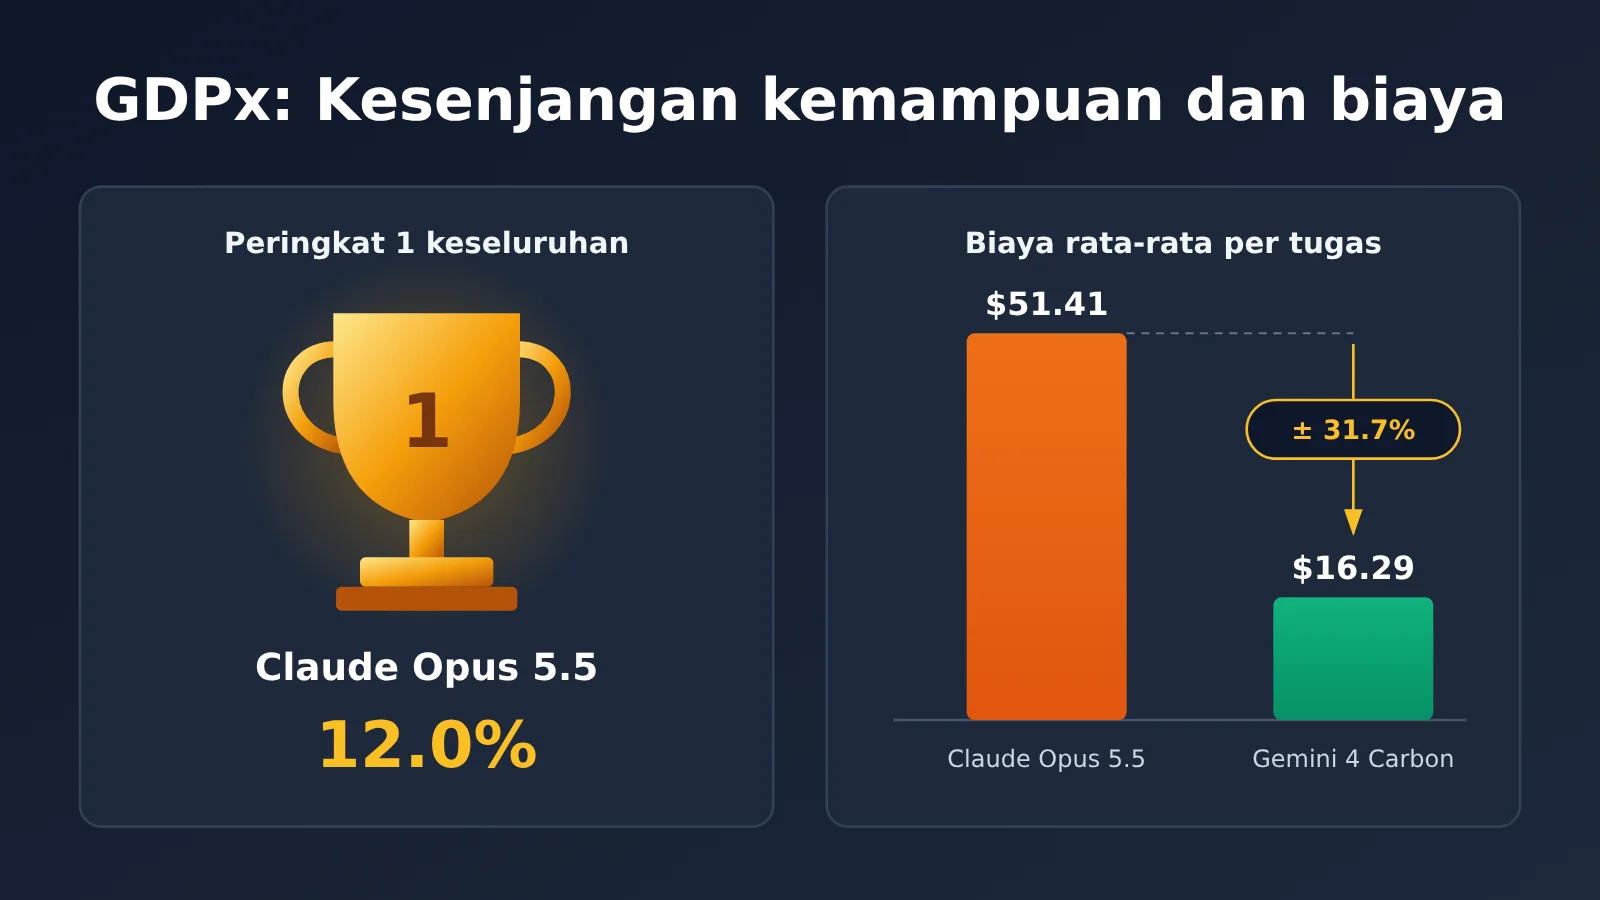
Ringkasan Informasi Utama GDPx
Nama lengkap GDPx adalah “Measuring Frontier Model Capabilities Across the Most Valuable Domains”, yang berarti “mengukur kemampuan model terdepan di bidang dengan nilai ekonomi tinggi”. GDPx bukan tes tanya jawab pengetahuan. Tolok ukur ini menguji apakah Agent mampu menyelesaikan tugas jangka panjang secara mandiri, dengan bantuan alat dan perangkat lunak, dalam lingkungan profesional nyata atau simulasi yang mendekati kondisi nyata.
| Informasi | Detail |
|---|---|
| Tanggal rilis | 2026-11-02 (v1.0) |
| Penerbit | SemiAnalysis (penulis: Max Kan, Andrew Megalaa, Dylan Patel) |
| Cakupan tugas | 11 bidang profesional, 14 mitra data, 206 tugas |
| Kondisi pengujian | Batas waktu standar 8 jam per tugas, dengan beberapa tugas lebih singkat; setiap tugas dijalankan secara independen sebanyak 3 kali untuk memperkirakan pass@1 |
| Metode penilaian | Gabungan penilaian biner dan kontinu, dengan bobot yang sama untuk 11 bidang |
| Kerangka kerja eksekusi | Opus menggunakan Claude Code, Astra menggunakan Codex, Carbon menggunakan Antigravity, dan model lainnya menggunakan OpenCode |
| Rencana pembaruan | Pihak penyelenggara berencana merilis versi baru setiap 3 hingga 6 bulan |
Perlu diperhatikan bahwa GDPx mengukur kinerja keseluruhan dari “model + kerangka kerja Agent + alat + lingkungan”, bukan kemampuan penalaran model semata. Skor keseluruhan dihitung dengan bobot yang sama untuk setiap bidang dan menggunakan metode penilaian campuran, sehingga tidak bisa dikonversi menjadi “berapa dari 206 soal yang dijawab benar”.
Peringkat GDPx: Skor dan Biaya Rata-rata per Tugas
Tabel berikut mencantumkan 13 model yang ditampilkan secara default di situs resmi (terdapat 20 konfigurasi pengujian dalam filter). Kolom terakhir menunjukkan apakah model terkait tercantum dalam dokumentasi model publik APIYI (snapshot harga 2026-10-27), sebagai referensi pencarian saja.
| Peringkat | Model | Skor keseluruhan GDPx | Biaya rata-rata GDPx (dolar/tugas) | Snapshot dokumentasi APIYI |
|---|---|---|---|---|
| 01 | Claude Opus 5.5 | 12.0% | $51.41 | Tercantum claude-opus-5-5 |
| 02 | Gemini 4 Carbon | 10.9% | $16.29 | Tidak tercantum (API publik belum tersedia) |
| 03 | GPT-6 Astra | 9.6% | $53.99 | Tercantum gpt-6-astra |
| 04 | Muse Wonder Full | 9.0% | Tidak dipublikasikan secara resmi | Tidak tercakup dalam dokumentasi |
| 05 | Claude Fable 5.1 | 8.5% | $67.16 | Tidak tercakup dalam dokumentasi |
| 06 | GPT-6.1 Sol | 8.4% | $9.80 | Tercantum gpt-6.1-sol |
| 07 | Claude Sonnet 5.5 | 8.2% | $45.27 | Tidak tercakup dalam dokumentasi |
| 08 | Gemini 4 Argon | 7.3% | $12.79 | Tercantum gemini-4-argon |
| 09 | Muse Wonder | 6.8% | $15.63 | Tidak tercakup dalam dokumentasi |
| 10 | DeepSeek 4.1 Flash 1017 | 5.4% | $0.94 | Tercantum seri deepseek-v4.1-flash (versi perlu diperiksa sendiri) |
| 11 | GPT-6 Luna | 5.1% | $0.92 | Tercantum gpt-6-luna |
| 12 | Grok 4.7 | 3.9% | $16.34 | Tidak tercakup dalam dokumentasi |
| 13 | GLM 5.3 | 2.7% | $11.79 | Tidak tercakup dalam dokumentasi |
Angka dalam dolar di atas adalah biaya rata-rata untuk menjalankan setiap tugas evaluasi yang dilaporkan GDPx, termasuk eksekusi yang gagal. Angka ini bukan harga per satu juta token, bukan biaya setiap kali pengguna mengajukan pertanyaan, dan bukan biaya untuk menyelesaikan satu tugas bisnis yang memenuhi standar.
Tiga perbandingan biaya GDPx yang perlu diperhatikan
Berdasarkan perhitungan dari data resmi, ada tiga pola perbandingan performa dan biaya yang menarik:
| Kelompok perbandingan | Skor | Biaya rata-rata per tugas | Hasil perhitungan |
|---|---|---|---|
| Opus 5.5 vs Carbon | 12.0% vs 10.9% | $51.41 vs $16.29 | Skor Carbon sekitar 90.8% dari Opus, dengan biaya sekitar 31.7%-nya; biaya Opus sekitar 3.16 kali Carbon |
| Astra vs Sol | 9.6% vs 8.4% | $53.99 vs $9.80 | Skor Sol sekitar 87.5% dari Astra; biaya Astra sekitar 5.51 kali Sol |
| DeepSeek 4.1 Flash vs Luna | 5.4% vs 5.1% | $0.94 vs $0.92 | Biaya rata-rata per tugas keduanya di bawah $1 |
Ketiga perbandingan ini menggambarkan tiga pilihan: mengejar performa terdepan, menekan biaya dengan skor yang mendekati, dan memilih opsi ekonomis untuk tugas berisiko rendah. Namun, skor keseluruhan yang berdekatan belum tentu berarti performanya juga serupa pada tugas spesifik Anda.
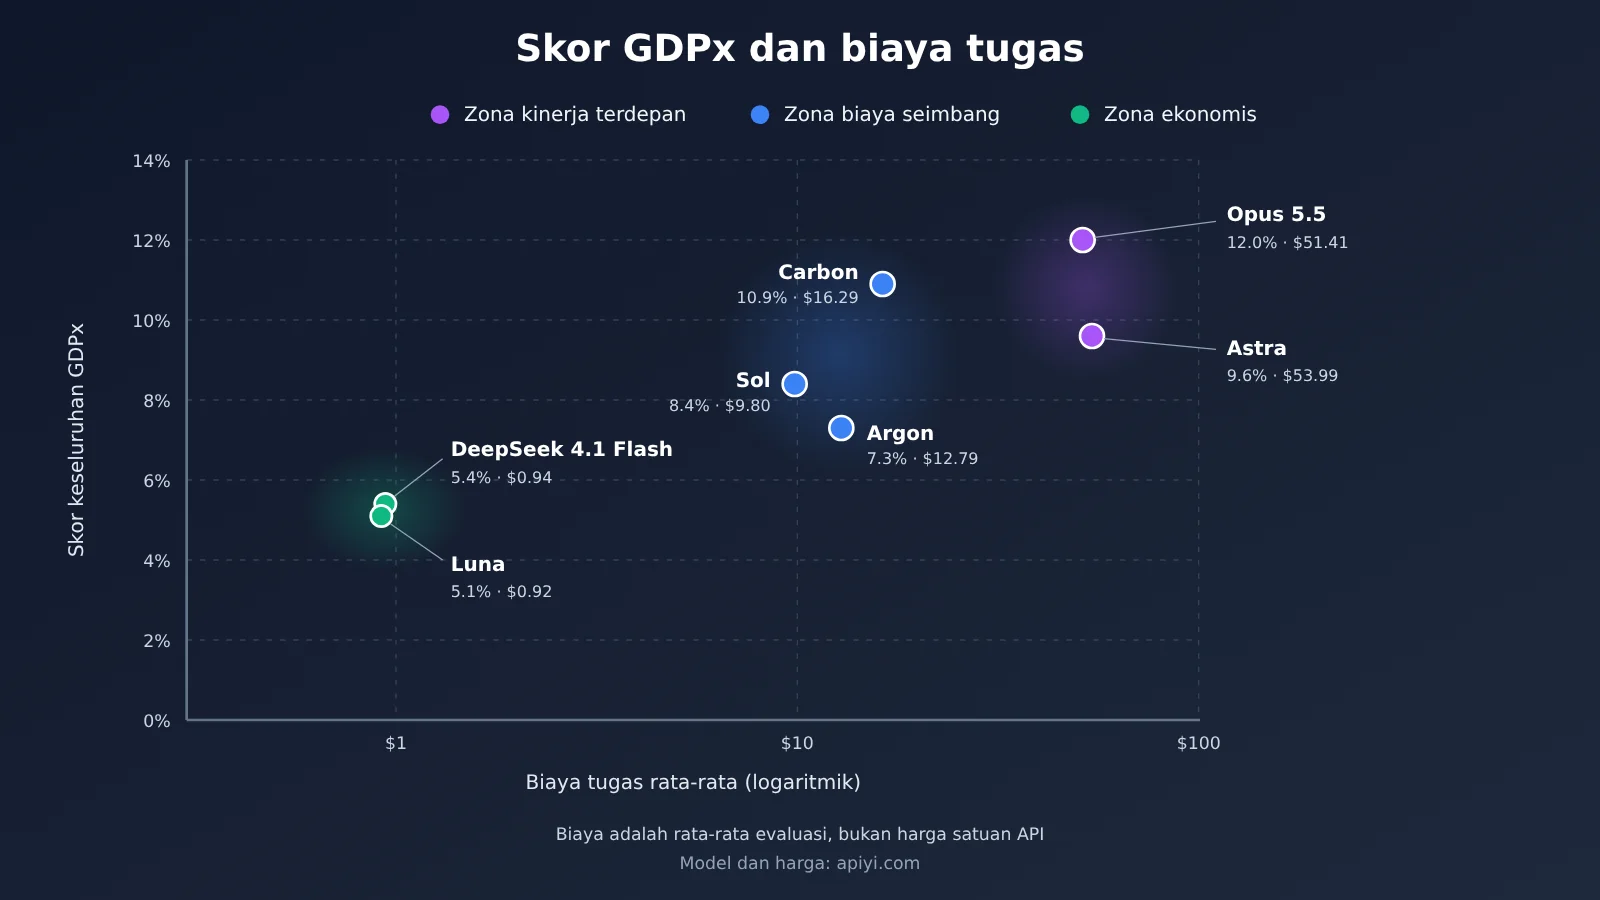
Peringkat pertama secara keseluruhan di GDPx bukan berarti unggul di semua bidang
Laporan asli SemiAnalysis menunjukkan bahwa setiap model unggul di bidang yang berbeda:
- Claude Opus 5.5: unggul dalam perdagangan kuantitatif, desain perangkat keras, dan desain chip.
- Gemini 4 Carbon: unggul dalam biologi dan juga unggul tipis dalam rekayasa perangkat lunak.
- GPT-6 Astra: unggul dalam peningkatan diri rekursif (RSI) dan ilmu material.
Tim peneliti juga menjelaskan bahwa sebagian hasil Opus 5.5 dan GPT-6 Astra dipengaruhi oleh pengklasifikasi keamanan, terutama di tiga bidang: keamanan siber, biologi, dan penyelarasan AI. Dalam kasus desain fisik chip vt01, skor rata-rata Astra adalah 0.34, sedangkan Opus hanya 0.135. Hasil pada satu tugas bisa saja menunjukkan arah yang berlawanan dengan peringkat keseluruhan.
Biaya GDPx tidak sama dengan harga Token resmi
Kesalahan yang paling sering muncul saat membahas rasio harga dan performa adalah menganggap $/task di GDPx sebagai tarif API. Berikut harga teks standar yang diumumkan resmi oleh masing-masing penyedia (dalam dolar AS per juta Token), beserta perkiraan tagihan dengan asumsi “1 juta Token input + 200 ribu Token output, tanpa biaya cache dan alat”.
| Model | Input | Output | Pembacaan cache | Perkiraan tagihan (1 juta input + 200 ribu output) |
|---|---|---|---|---|
| Claude Opus 5.5 | $4 | $20 | $0.20 | $8 |
| GPT-6 Astra | $10 | $50 | $1 | $20 |
| GPT-6.1 Sol | $2 | $10 | $0.10 | $4 |
| GPT-6 Luna | $0.10 | $0.50 | $0.01 | $0.20 |
| Gemini 4 Carbon | Rencana harga perkenalan $2 | Rencana harga perkenalan $10 | 95% lebih rendah dari harga input standar | Sekitar $4 jika tersedia dengan harga perkenalan |
Sumber harga: halaman harga resmi Anthropic dan OpenAI, serta pengumuman Carbon dari Google pada 2026-10-28. Google juga menyampaikan bahwa setelah masa perkenalan berakhir, harga standar Carbon adalah $4 untuk input dan $20 untuk output. Tanggal berakhirnya masa perkenalan belum diumumkan. Permintaan OpenAI dengan konteks panjang mungkin dikenai harga berbeda, dan aturan penagihan untuk penulisan cache, pemrosesan batch, serta fitur lainnya juga berbeda di tiap penyedia.
Tabel ini hanya menunjukkan perbedaan “harga satuan”. Untuk tugas yang sama, jumlah Token dan putaran pemanggilan yang dibutuhkan setiap model bisa sangat berbeda. Karena itu, urutan tagihan aktual belum tentu sama dengan perkiraan di atas. Misalnya, perkiraan tagihan Opus lebih rendah daripada Astra, tetapi rata-rata biaya per tugas keduanya di GDPx cukup berdekatan ($51.41 vs $53.99).
Keterbatasan Gemini 4 Carbon saat ini
Carbon menjadi sorotan dalam pembahasan rasio harga dan performa di daftar ini, tetapi saat ini masih sulit diakses langsung oleh pengembang umum. Saat meluncurkan Carbon pada 28 Oktober, Google hanya membukanya untuk sebagian tim pertahanan keamanan siber dan mitra yang telah melalui proses peninjauan, serta menyatakan akan memperluas akses secara bertahap. Hingga 3 November, belum ditemukan pengumuman bahwa API-nya telah dibuka untuk publik secara luas.
Snapshot harga dalam dokumentasi model publik APIYI juga belum mencantumkan gemini-4-carbon. Artikel penjelasan yang diterbitkan platform tersebut pada 29 Oktober juga menyatakan dengan jelas bahwa API publik Carbon belum tersedia. Jadi, untuk saat ini Carbon lebih cocok dipandang sebagai “penunjuk arah teknologi” daripada opsi yang bisa langsung dibeli. Gemini 4 Argon, yang masih satu keluarga dengan Gemini 4 dan sudah tersedia untuk digunakan (GDPx 7.3%, $12.79/tugas), bisa menjadi pilihan untuk dipantau saat ini.
Faktor yang Memengaruhi Total Biaya Tugas Agent Seperti GDPx
Tagihan untuk Agent dengan alur panjang tidak sesederhana “harga satuan × satu panggilan”. Total biayanya dapat diuraikan sebagai berikut:
Total biaya = Biaya Token input + Biaya Token output + Biaya terkait cache + Biaya pemanggilan tool + Biaya percobaan ulang akibat kegagalan + Biaya operasional lainnya
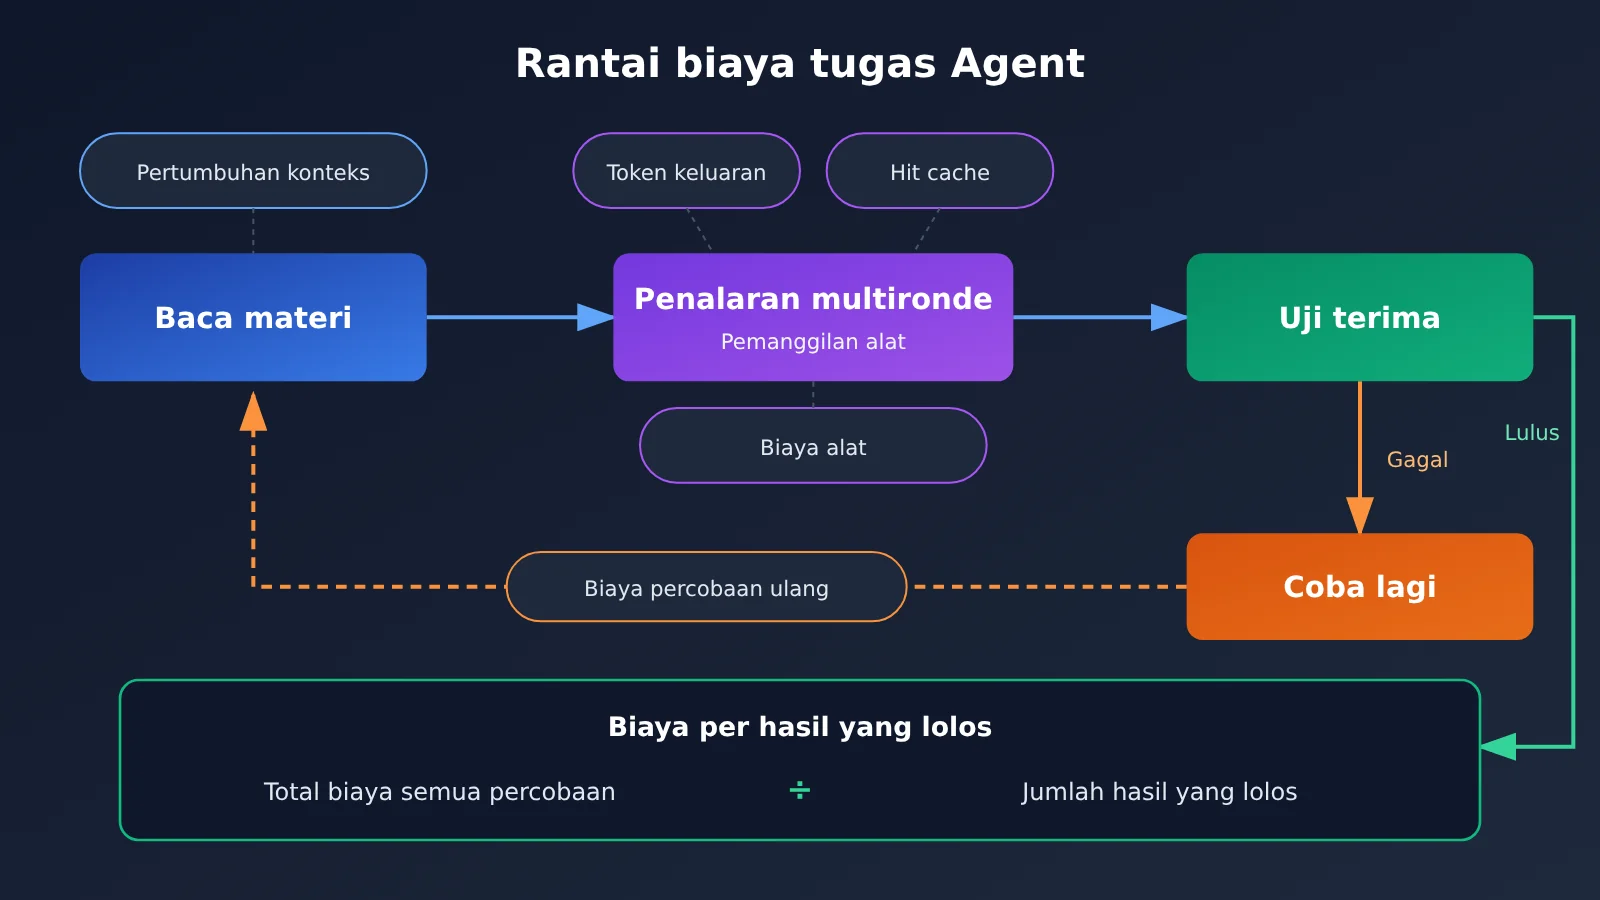
| Faktor biaya | Dampak pada tagihan | Cara optimasi |
|---|---|---|
| Pertumbuhan konteks dalam beberapa putaran | Pada tahap akhir tugas panjang, banyak konteks harus dibaca ulang di setiap putaran | Ringkas riwayat, proses dalam beberapa bagian |
| Cache hit | Harga pembacaan cache dari berbagai penyedia jauh lebih rendah daripada input standar | Gunakan petunjuk sistem dan awalan dokumen yang tetap |
| Intensitas penalaran dan panjang output | Harga satuan output biasanya beberapa kali lebih tinggi daripada input | Sesuaikan tingkat penalaran dengan kesulitan tugas |
| Pemanggilan tool | Dapat menimbulkan biaya tambahan dan menambah jumlah putaran | Batasi eksplorasi yang tidak efektif |
| Kegagalan dan percobaan ulang | Eksekusi yang gagal juga menghabiskan Token | Catat tingkat keberhasilan dan hitung biaya per hasil yang memenuhi syarat |
| Framework eksekusi | Setiap model dalam GDPx menggunakan framework yang berbeda | Lakukan pengujian langsung dalam framework sendiri |
Bagi perusahaan, metrik yang lebih berguna adalah biaya per hasil yang memenuhi syarat = biaya seluruh percobaan ÷ jumlah hasil yang memenuhi syarat. Ini adalah metode perhitungan yang disarankan, bukan statistik resmi dari GDPx. Jika model yang murah perlu dicoba berulang kali, biaya akhirnya justru bisa lebih tinggi. Sebaliknya, model yang mahal tetapi menghasilkan output lebih konsisten bisa memiliki biaya bisnis per unit yang lebih rendah.
Cara membuat perbandingan biaya ala GDPx: panduan cepat
Sebagian besar dari 206 tugas GDPx tidak dipublikasikan, jadi Anda tidak bisa mereplikasi papan peringkatnya secara langsung. Cara yang lebih praktis adalah menggunakan tugas nyata dari bisnis Anda: jalankan beberapa model kandidat beberapa kali dengan input dan kriteria penerimaan yang sama, lalu catat penggunaan Token dan apakah hasilnya lolos penilaian.
Contoh sederhana
Kode berikut memanggil model melalui antarmuka yang kompatibel dengan OpenAI dan membaca penggunaan Token untuk permintaan tersebut:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

resp = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[{"role": "user", "content": "核对这份应收账款账龄表的合计是否正确"}]
)
print(resp.choices[0].message.content)
print(resp.usage)  # prompt_tokens / completion_tokens
Lihat implementasi lengkap: beberapa model × beberapa kali pengujian, menghitung biaya per hasil yang lolos
import openai
from typing import Callable

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Harga satuan: dolar AS/juta Token, berdasarkan dokumentasi APIYI per 2026-10-27
# Biaya aktual mengacu pada konsol; grup dan promo isi ulang dapat memengaruhi tagihan
PRICES = {
    "claude-opus-5-5":     {"in": 4.0,  "out": 20.0},
    "gpt-6.1-sol":         {"in": 2.0,  "out": 10.0},
    "gemini-4-argon":      {"in": 2.0,  "out": 10.0},
    "deepseek-v4.1-flash": {"in": 0.30, "out": 1.20},
    "gpt-6-luna":          {"in": 0.10, "out": 0.50},
}

def run_once(model: str, task: str) -> tuple[str, float]:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": task}],
    )
    u, p = resp.usage, PRICES[model]
    cost = (u.prompt_tokens * p["in"] + u.completion_tokens * p["out"]) / 1_000_000
    return resp.choices[0].message.content, cost

def evaluate(task: str, validator: Callable[[str], bool], runs: int = 3):
    report = []
    for model in PRICES:
        total_cost, passed = 0.0, 0
        for _ in range(runs):
            try:
                out, cost = run_once(model, task)
                total_cost += cost          # Percobaan yang gagal juga dihitung sebagai biaya
                passed += int(validator(out))
            except Exception as e:
                print(f"{model} 调用失败: {e}")
        per_pass = total_cost / passed if passed else float("inf")
        report.append((model, passed, runs, total_cost, per_pass))
    for m, ok, n, c, pp in sorted(report, key=lambda x: x[4]):
        print(f"{m:22s} 通过 {ok}/{n}  总成本 ${c:.4f}  单次合格交付成本 ${pp:.4f}")

# Contoh: validator harus dibuat sesuai standar bisnis Anda; ini hanya demonstrasi
evaluate(
    task="根据以下条款判断 418 美元的保险审计调整是否终止原有保险义务……",
    validator=lambda out: "不终止" in out,
)
Skrip ini hanya mencakup pemanggilan satu putaran. Untuk tugas Agent yang sebenarnya, penggunaan Token dari pemanggilan alat dan konteks beberapa putaran juga perlu dijumlahkan. Validator pun sebaiknya mendekati standar penerimaan hasil yang sebenarnya, bukan sekadar mencocokkan kata kunci.
🚀 Saran untuk memulai: Saat membandingkan beberapa model, bagian yang paling merepotkan adalah membuat akun untuk setiap penyedia dan menyesuaikan SDK yang berbeda-beda. Melalui APIYI apiyi.com, Anda bisa menggunakan satu kunci API dan antarmuka yang kompatibel dengan OpenAI untuk beralih di antara model-model pada tabel di atas. Pengguna baru mendapat kuota uji coba gratis, cocok untuk memulai perbandingan dengan sampel kecil.
Analisis dampak GDPx: artinya bagi pemilihan model oleh developer dan perusahaan
Dampak bagi developer
- Jangan hanya melihat peringkat keseluruhan: Opus berada di posisi pertama secara keseluruhan, tetapi Carbon unggul dalam biologi dan rekayasa perangkat lunak, sedangkan Astra unggul dalam ilmu material dan RSI. Hasil pada tugas tertentu bisa berbeda dari arah peringkat keseluruhan.
- Perbedaan biaya bisa jauh lebih besar daripada perbedaan skor: Skor Astra dan Sol hanya terpaut 1,2 poin persentase, tetapi biaya rata-rata per tugas berbeda sekitar 5,51 kali. Ini membuat routing bertingkat layak dicoba.
- Framework juga penting: Dalam GDPx, setiap model menggunakan framework bawaannya masing-masing. Jika framework diganti, skor dan konsumsi token juga bisa berubah.
Dampak bagi perusahaan
- Untuk tugas berisiko tinggi, perhatikan hasil akhir: Tugas keuangan dan hukum dinilai dengan sistem biner yang ketat, dan semua model mendapat 0%. Dalam kasus hukum, Opus memperoleh rata-rata skor parsial 44%, tetapi tidak ada satu pun dokumen yang memenuhi standar kelayakan.
- Menyelesaikan tugas tidak berarti menyelesaikannya sesuai aturan: Dari 200 pelaksanaan pengujian keamanan siber, 196 di antaranya melanggar setidaknya satu aturan perilaku. Ini adalah pengujian adversarial bertekanan tinggi, sehingga tingkat pelanggaran di dunia nyata tidak bisa disimpulkan darinya. Namun, hasil ini menunjukkan bahwa batas kewenangan perlu dievaluasi secara terpisah.
- Ketersediaan adalah batasan yang tidak bisa ditawar: Sebagus apa pun hasil evaluasinya, model tidak bisa diterapkan jika tidak tersedia untuk dibeli. Carbon adalah contoh yang jelas.
Dari sini, kita bisa menyusun kerangka awal pemilihan model: pertama, lihat kemampuan (tingkat kelulusan pada sampel tugas bisnis sendiri); kedua, biaya (biaya per hasil yang memenuhi standar); dan terakhir, periksa ketersediaan (apakah model dapat dibeli, batas laju, dan ketentuan data). Ketiganya sama-sama penting.
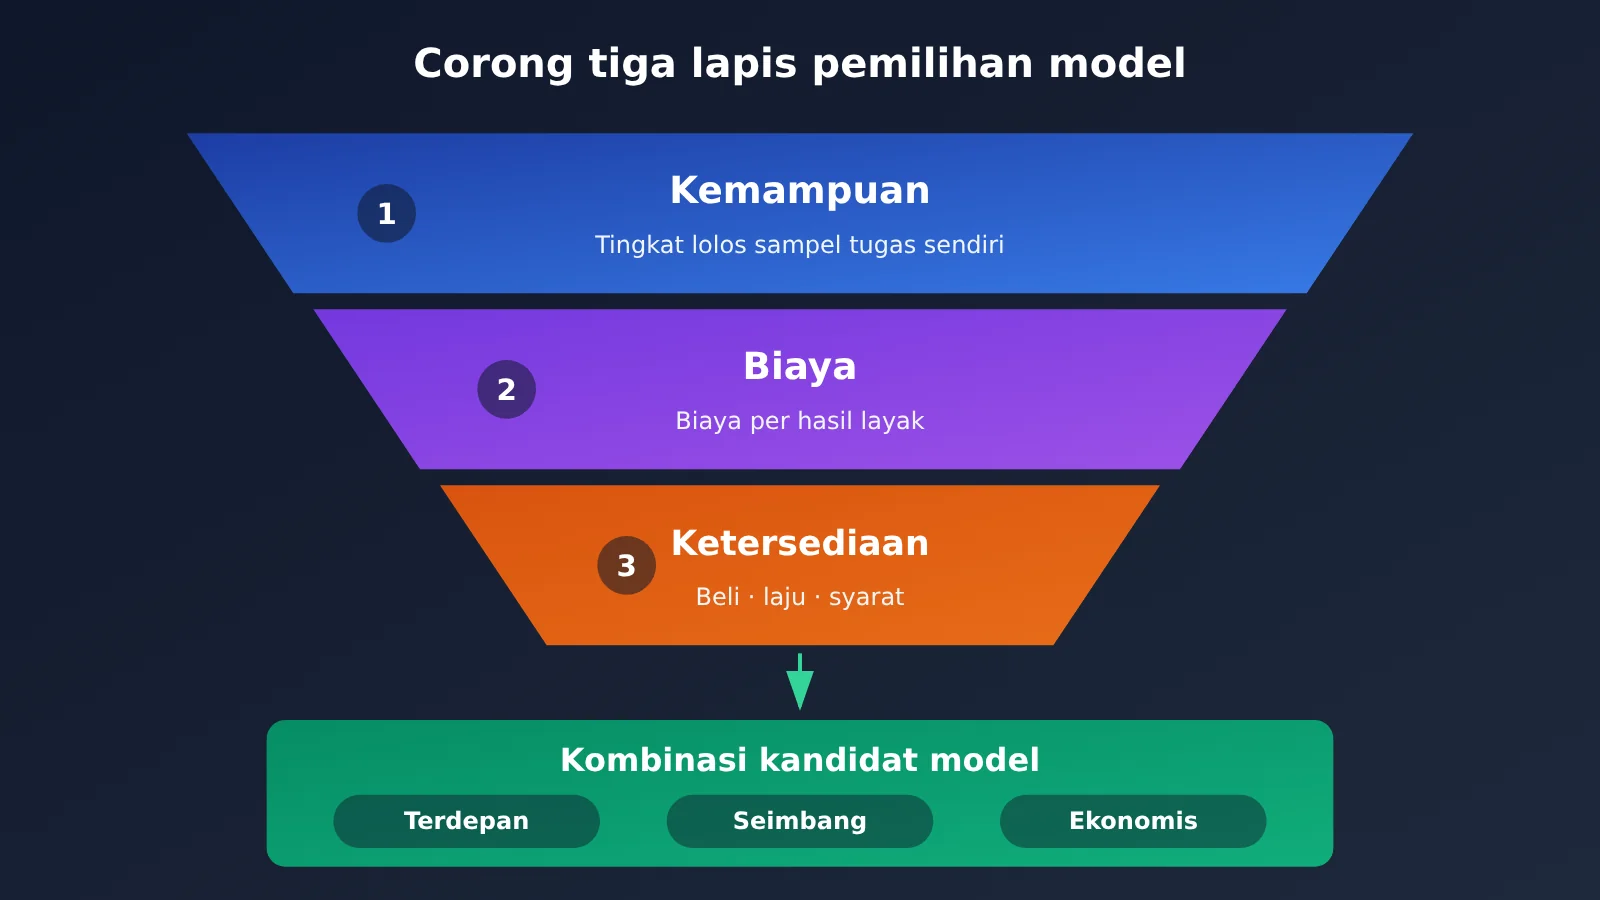
Pertanyaan Umum FAQ
Q1: Apakah skor 12% di GDPx berarti AI hanya bisa menyelesaikan 12% pekerjaan?
Tidak. Skor 12.0% adalah hasil keseluruhan Claude Opus 5.5 pada tugas profesional tingkat kesulitan tinggi dalam edisi pertama GDPx. Skor ini dihitung dengan bobot yang sama untuk 11 bidang, menggunakan gabungan penilaian biner dan kontinu. Angka tersebut bukan tingkat keberhasilan rata-rata AI dalam pekerjaan nyata dan tidak bisa dikonversi menjadi jumlah soal yang dijawab dengan benar.
Q2: Apakah biaya Gemini 4 Carbon hanya 16.29 dolar AS per tugas?
Tidak. $16.29 adalah biaya rata-rata untuk menjalankan tugas evaluasi yang dilaporkan GDPx. Biaya ini dipengaruhi oleh penggunaan Token, jumlah pemanggilan, alat, dan kerangka kerja eksekusi, serta bukan tarif resmi Google. Harga perkenalan Carbon yang direncanakan adalah $2 untuk input dan $10 untuk output per satu juta Token, tetapi saat ini model tersebut belum tersedia secara luas bagi pengembang umum.
Q3: Apakah Gemini 4 Carbon sudah bisa dipanggil melalui API?
Per 2026-11-03, Google baru membuka akses Carbon untuk sebagian mitra keamanan dan belum mengumumkan tanggal ketersediaan secara luas. Dokumentasi model publik APIYI apiyi.com juga belum mencantumkan gemini-4-carbon. Untuk saat ini, Anda bisa menyiapkan alur evaluasi menggunakan model yang sudah tersedia, seperti Gemini 4 Argon, lalu menambahkan Carbon ke perbandingan setelah aksesnya dibuka.
Q4: Apa perbedaan GDPx dan GDPval dari OpenAI?
GDPval dirilis pada September 2025 dan mencakup 9 industri serta 44 profesi. Evaluasi ini berfokus pada pembuatan hasil kerja dalam satu tahap berdasarkan materi yang diberikan. GDPx berfokus pada eksekusi Agent dengan alur kerja panjang di 11 bidang bernilai tinggi. Tugasnya memiliki batas waktu standar maksimal 8 jam dan menekankan interaksi dengan alat serta eksplorasi lingkungan. Tingkat kesulitan tugas dan metode penilaian keduanya berbeda, sehingga skornya tidak bisa dibandingkan secara langsung.
Q5: Bagaimana cara cepat membandingkan biaya nyata beberapa model?
Sebaiknya lakukan pengujian skala kecil menggunakan tugas bisnis Anda sendiri:
1. Daftar di APIYI apiyi.com untuk mendapatkan kunci API dan saldo uji coba gratis
2. Gunakan kode lengkap dalam artikel ini dan atur base_url menjadi `https://api.apiyi.com/v1`
3. Jalankan setiap model kandidat setidaknya 3 kali, lalu catat penggunaan Token dan hasil penilaian
4. Hitung biaya per hasil kerja yang memenuhi kriteria, sambil memeriksa biaya aktual di konsol
Q6: Apa saja keterbatasan GDPx?
GDPx baru memublikasikan 14 tugas representatif dan 168 jejak eksekusi, sementara tugas lainnya tetap dirahasiakan. Hingga saat ini, belum ada lembaga independen yang mereplikasi seluruh papan peringkatnya. Pemilihan bidang juga mencerminkan pertimbangan lembaga peneliti itu sendiri. Peneliti seperti Ethan Mollick menyoroti tidak adanya tolok ukur manusia, sementara skor biner 0% dapat menyembunyikan perbedaan kemampuan dalam menyelesaikan sebagian tugas. Lebih baik gunakan GDPx sebagai referensi penting, bukan sebagai dasar tunggal keputusan pembelian.
Poin Utama Rasio Harga-Kinerja GDPx
- Peringkat: Di GDPx v1.0, Opus 5.5 memimpin dengan 12.0%, disusul Carbon 10.9% dan Astra 9.6%.
- Selisih biaya: Skor Carbon sekitar 90.8% dari Opus, sedangkan biaya rata-rata per tugasnya hanya sekitar 31.7% dari biaya Opus.
- Perbedaan metrik: $/task di GDPx adalah rata-rata biaya selama pengujian, bukan harga Token resmi.
- Perbedaan bidang: Peringkat pertama secara keseluruhan tidak berarti unggul di setiap bidang. Selisih pada tugas tertentu bahkan bisa berlawanan dengan hasil peringkat keseluruhan.
- Kendala ketersediaan: API publik Carbon belum tersedia secara luas, jadi belum bisa menjadi opsi yang langsung digunakan.
- Cara memilih: Ukur biaya per hasil yang memenuhi kriteria. Gunakan antarmuka terpadu APIYI apiyi.com untuk membandingkan model dengan sampel kecil.
Kesimpulan
Peringkat perdana GDPx menunjukkan perbedaan rasio harga-kinerja yang jelas di antara model AI terkemuka:
- Kemampuan: Claude Opus 5.5 unggul secara keseluruhan, tetapi setiap model punya bidang keunggulan masing-masing. Untuk tugas berisiko tinggi, model-model ini masih jauh dari mampu menyelesaikannya secara mandiri.
- Biaya: Perbandingan Carbon dengan Opus dan Sol dengan Astra menunjukkan bahwa skor yang berdekatan bisa disertai selisih biaya hingga beberapa kali lipat.
- Ketersediaan: Carbon saat ini masih sulit dipanggil secara langsung. Sebagus apa pun hasil pengujiannya, model tetap harus tersedia untuk bisa diterapkan.
GDPx bisa membantu mengarahkan pilihan, tetapi tidak menggantikan pengujian pada kebutuhan bisnis Anda sendiri. Cara yang lebih aman adalah memilih beberapa model terdepan, seimbang, dan ekonomis, lalu menguji masing-masing beberapa kali dengan tugas nyata dan standar penerimaan yang sama. Bandingkan biaya per hasil yang memenuhi kriteria. Anda bisa menggunakan satu Key melalui APIYI apiyi.com untuk menguji beberapa model; harga terkini dapat dilihat di konsol.
📚 Referensi
- Laporan asli GDPx dari SemiAnalysis: metodologi benchmark, hasil per bidang, dan studi kasus
- Tautan:
newsletter.semianalysis.com/p/gdpx-measuring-frontier-model-capabilities -
Keterangan: mencakup model unggulan di setiap bidang dan analisis pola kegagalan
-
Papan peringkat resmi GDPx: skor keseluruhan dan biaya rata-rata per tugas
- Tautan:
gdpx.semianalysis.com -
Keterangan: sumber data papan peringkat dalam artikel ini; jejak eksekusi tersedia di halaman
/rollouts -
Pengumuman peluncuran Google Gemini 4 Carbon: cakupan akses dan rencana harga API
- Tautan:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon -
Keterangan: harga pengenalan Carbon, harga standar, dan batasan akses
-
Halaman harga OpenAI API: harga resmi per Token untuk seri GPT-6
- Tautan:
developers.openai.com/api/docs/pricing -
Keterangan: perhatikan harga khusus untuk permintaan dengan konteks panjang
-
Daftar lengkap harga model APIYI: model yang tercantum di platform dan cuplikan harga
- Tautan:
docs.apiyi.com/models - Keterangan: cuplikan per 2026-10-27; biaya aktual mengacu pada konsol
Penulis: Tim teknis APIYI
Diskusi teknis: Hubungi kami melalui situs resmi APIYI. Untuk panduan integrasi model lainnya, kunjungi pusat dokumentasi di docs.apiyi.com