Catatan penulis: Daftar Artificial Analysis Search Index per 2026-11-09 menunjukkan bahwa dengan mempertahankan satu model jawaban dan hanya mengganti konfigurasi pencarian, skor gabungan dapat berubah dari 33 menjadi 83 poin. Namun, saat memilih, Anda tetap perlu mempertimbangkan biaya tugas, waktu pengerjaan, dan cakupan evaluasi secara bersamaan.
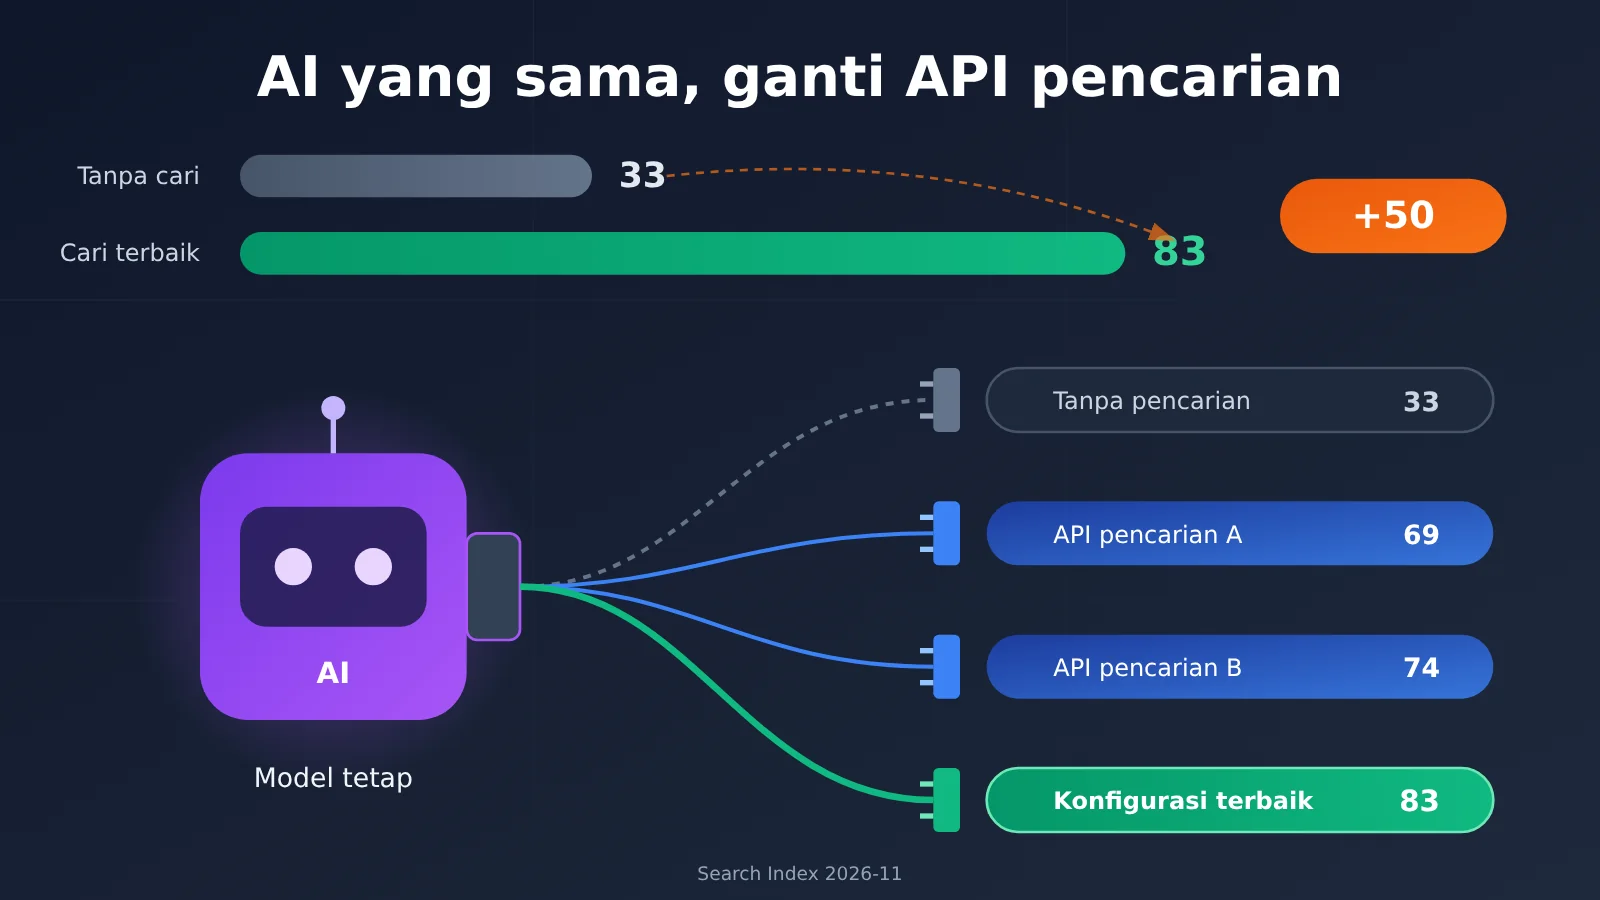
Banyak orang membangun Agent dengan memilih model lebih dulu, lalu asal menyambungkan alat pencarian. Di mata banyak tim, pencarian hanyalah pelengkap yang penting asal bisa terhubung ke internet. Search Index yang diperbarui Artificial Analysis pada 2026-11-09 menunjukkan hasil yang berbeda: Model yang sama, tanpa pencarian hanya mendapat 33 poin, sedangkan dengan konfigurasi API pencarian terbaik skornya bisa mencapai 83 poin.
Ini bukan sekadar menyalin lagi daftar peringkat yang bilang “tiap pemain punya keunggulannya sendiri”. Artikel ini akan menguraikan cara penghitungan skor 83 dan kondisi pengujiannya, lalu membandingkan kualitas, total waktu penyelesaian tugas, biaya pencarian, dan biaya model secara berdampingan. Di bagian akhir, artikel ini menjelaskan per skenario keputusan apa saja yang bisa memakai daftar tersebut dan di mana daftar itu tidak bisa langsung diterapkan.
Nilai utama: Setelah membaca artikel ini, Anda bisa menyaring kandidat API pencarian menggunakan daftar publik, lalu melakukan perbandingan lanjutan dengan tugas Anda sendiri, sehingga tidak mengambil keputusan hanya berdasarkan skor tertinggi.
Istilah yang Perlu Diketahui Sebelum Membaca Daftar Peringkat Search API
Ringkasan satu kalimat: Search Index membandingkan performa model yang sama dalam berbagai konfigurasi pencarian, dengan selisih skor mencapai 50 poin. Namun, “skor tinggi” bukan berarti “paling cocok untuk Anda”; biaya, waktu respons, dan cakupan evaluasi juga perlu dipertimbangkan.
Sebelum membaca daftar peringkat, samakan dulu pemahaman tentang beberapa istilah berikut:
- Search Index: Skor gabungan yang dihitung berdasarkan benchmark pencarian tertentu sesuai aturan yang ditetapkan. Dalam artikel ini, istilah tersebut merujuk pada indeks evaluasi Search API dari Artificial Analysis dengan skor maksimum 100.
- F1: Rata-rata harmonik dari presisi dan recall. Saat jawaban berupa “sekumpulan entitas”, metrik ini mengukur seberapa tepat dan lengkap jawaban yang diberikan.
- Harness: Kerangka pengujian yang mengatur input model, eksekusi tool, dan penilaian tugas. Loop Agent yang digunakan Artificial Analysis bernama Stirrup.
- Search API: Antarmuka yang mengembalikan hasil pencarian berdasarkan kueri, seperti tautan halaman web, judul, dan cuplikan relevan; contohnya Exa, Brave, dan Perplexity Search API.
- Token: Satuan yang digunakan model untuk memproses teks. Semakin panjang hasil pencarian, semakin banyak Token yang dikirim ke model, dan semakin tinggi biaya model.
Search API Bisa Bikin AI yang Sama Selisih 50 Poin?
Artificial Analysis meluncurkan benchmark Search API pada 18 Agustus 2026. Data publik terbaru diperbarui pada 9 November 2026 dan mencakup 14 penyedia layanan serta 26 produk atau konfigurasi Search API. Yang dievaluasi bukan modelnya, melainkan hasil nyata setelah layanan pencarian dimasukkan ke dalam Agent.
Kunci desain eksperimennya adalah “variabel kontrol”. Model kandidat jawaban dikunci ke GPT-5.6 Luna (medium), kerangka Agent juga tetap sama, dan hanya layanan pencarian yang diganti. Dalam kondisi ini, baseline tanpa tool pencarian hanya mendapat 33 poin, sedangkan Keenable Pro di peringkat pertama mencapai 83 poin—selisih 50 poin skor indeks. Bahkan di antara konfigurasi yang sudah terhubung ke layanan pencarian, selisih dari 69 poin DeepSeek Search Summary hingga 83 poin Keenable Pro tetap mencapai 14 poin.
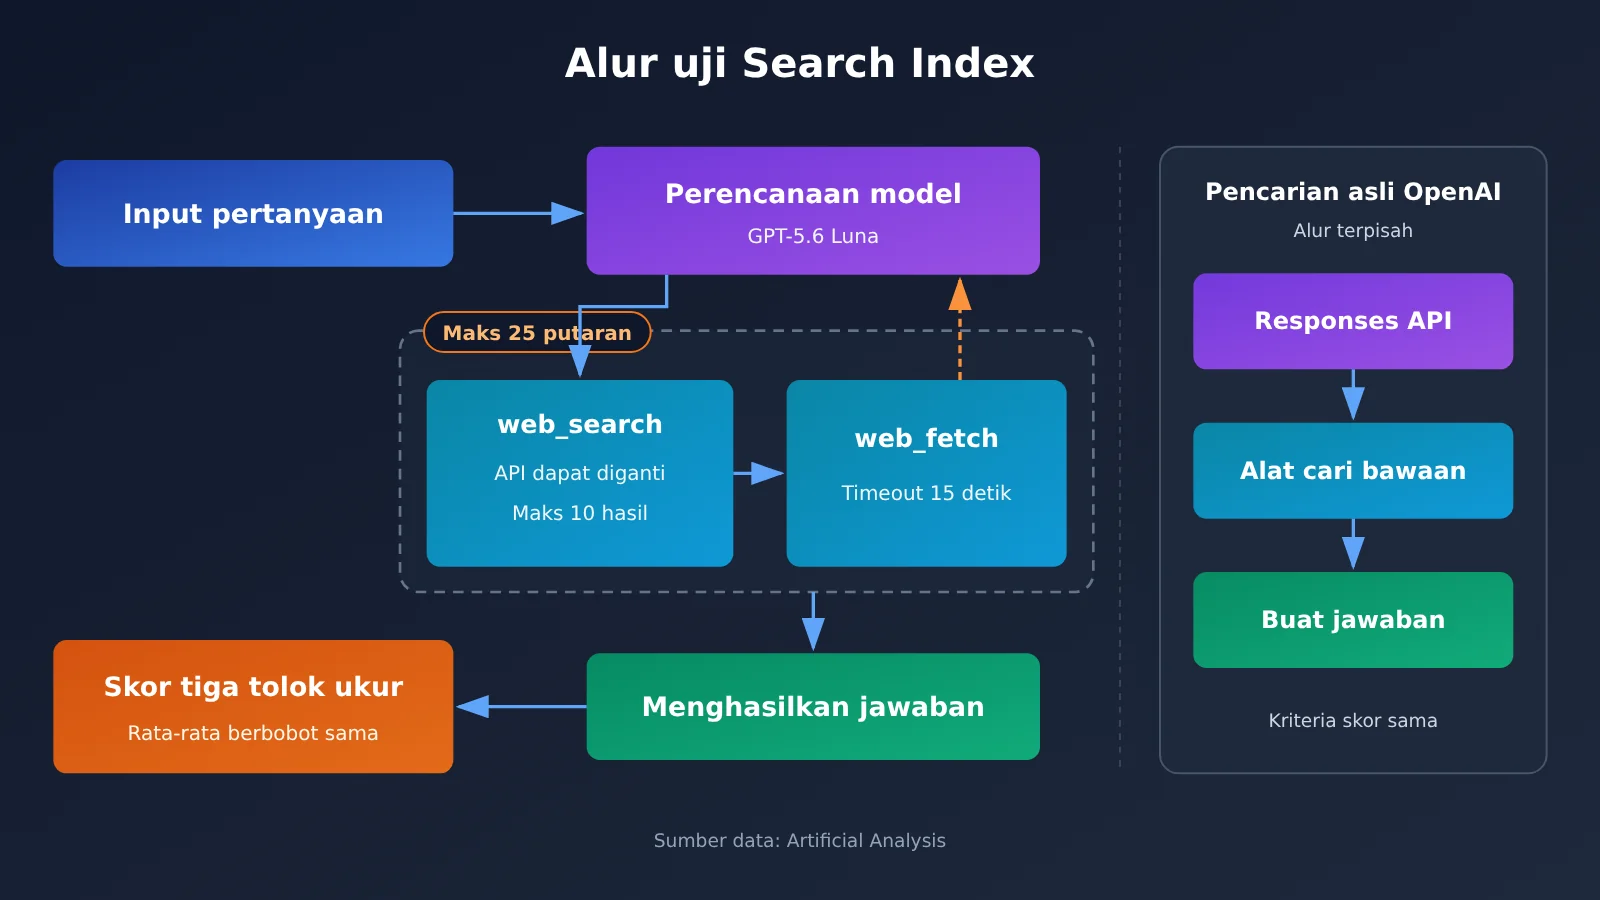
Ada satu pengecualian yang perlu penjelasan khusus: Web Search bawaan OpenAI berjalan dengan cara berbeda. Search API independen lainnya berjalan di dalam loop Agent eksternal milik Artificial Analysis. Sementara itu, Web Search OpenAI menggunakan alur tool bawaan Responses API, dengan jumlah pencarian dan cara eksekusinya ditentukan sendiri oleh OpenAI. Jadi, skor 74-nya bisa dijadikan referensi, tetapi tidak bisa dianggap sebagai eksperimen “ganti API” dengan kondisi yang sepenuhnya sama.
Perlu diingat juga bahwa 50 poin ini adalah efek peningkatan dari pencarian dalam sistem evaluasi yang sama. Ini tidak berarti siapa pun yang memakai model apa pun dan menyambungkannya ke pencarian akan mendapat peningkatan 50 poin persentase.
Bagaimana skor 83 pada Search Index sebenarnya diukur?
Tiga benchmark Search Index dan cara penilaiannya
Skor gabungan diperoleh dari rata-rata berbobot sama dari tiga benchmark, masing-masing menyumbang sepertiga:
| Benchmark | Skala tugas | Jenis tugas | Metrik penilaian |
|---|---|---|---|
| DeepSearchQA | 900 tugas | Riset fakta kompleks, jawaban sering berupa himpunan | F1 himpunan jawaban |
| BrowseComp | 200 tugas | Tanya jawab pencarian web dengan tingkat kesulitan tinggi | Akurasi jawaban tepat |
| AA-Omniscience | 600 tugas | Tanya jawab fakta | Akurasi tanya jawab fakta |
Ketiganya berjumlah 1.700 tugas, tetapi skor gabungan bukan dihitung dengan menggabungkan 1.700 soal itu lalu menghitung tingkat jawaban benar. Sebagai contoh Keenable Pro, tiga skornya berturut-turut 88, 87, 73, rata-ratanya sekitar 82,67, dan setelah dibulatkan ditampilkan sebagai 83. Jadi, skor 83 tidak sama dengan “tingkat jawaban benar 83%”.
Kondisi pengujian Search Index
Konfigurasi kunci yang diungkapkan dalam metodologi adalah sebagai berikut:
| Item eksperimen | Pengaturan aktual |
|---|---|
| Model kandidat jawaban / model penilai | GPT-5.6 Luna (medium) |
| Putaran Agent maksimum | 25 putaran, jumlah pemanggilan alat dalam satu putaran tidak dibatasi |
| Alat yang tersedia | web_search, web_fetch (pembacaan halaman web mandiri) |
| Hasil per pencarian | Maksimal 10 |
| Batas waktu pengambilan teks isi | 15 detik per halaman |
| Konten yang dikembalikan ke model | Konten respons asli dari penyedia layanan |
| Baseline tanpa pencarian | Model yang sama, tanpa menggunakan alat pencarian |
Dari tabel ini ada dua hal yang bisa dilihat. Pertama, yang dikembalikan ke model adalah “respons asli dari penyedia layanan”. Panjang fragmen, cara peringkasan, dan penyusunan sorotan semuanya masuk ke dalam konteks model, jadi skor tidak hanya mencerminkan kualitas indeks web di lapisan bawah, tetapi juga cara informasi disusun. Kedua, error fatal seperti 429, 5xx, atau timeout akan terus diulang sampai berhasil, dan error tersebut tidak dihitung dalam hasil akhir. Artinya peringkat ini mengukur kualitas “saat berhasil berjalan”, dan tidak bisa dipakai untuk membuktikan ketersediaan atau tingkat kegagalan masing-masing layanan di lingkungan produksi.
Peringkat Search Index Terbaru: Search API Siapa yang Paling Efektif?
Pada tabel di bawah, skor kualitas dan BrowseComp berasal dari peringkat 2026-11-09. Waktu tempuh memakai nilai peringkat yang dibaca pada 2026-11-13, yaitu rata-rata waktu dari awal hingga akhir sebuah tugas pengujian standar, bukan latensi jaringan satu permintaan Search API.
| Konfigurasi pencarian | Skor keseluruhan (11-09) | BrowseComp | Rata-rata waktu tugas (11-13) |
|---|---|---|---|
| Keenable Pro | 83 | 87% | 16,6 detik |
| Keenable Realtime | 82 | 86% | 16,0 detik |
| Exa Auto + Dynamic Highlights | 80 | 83% | 36,7 detik |
| Perplexity Search Medium | 80 | 87% | 31,1 detik |
| Exa Lite + Dynamic Highlights | 79 | 81% | 19,4 detik |
| Parallel Advanced | 75 | 77% | Tidak tercantum dalam pembaruan waktu kali ini |
| Brave LLM Context | 75 | 77% | Tidak tercantum dalam pembaruan waktu kali ini |
| OpenAI Web Search Medium (alur bawaan Responses) | 74 | 74% | 33,1 detik |
| DeepSeek Search Summary | 69 | 63% | 22,4 detik |
| Baseline tanpa pencarian | 33 | 17% | — |
Tiga kesenjangan khas dalam peringkat Search API
Skor sama, kecepatan berbeda. Exa Auto dan Perplexity Medium sama-sama meraih 80 poin, tetapi waktu tugas penuh masing-masing 36,7 detik dan 31,1 detik. Keenable Pro skornya lebih tinggi, namun waktunya hanya sekitar 16,6 detik. Untuk Agent yang butuh respons real-time, perbedaan ini langsung terasa oleh pengguna.
BrowseComp tidak sepenuhnya mengikuti skor keseluruhan. BrowseComp Perplexity Medium mencapai 87%, setara dengan Keenable Pro, tetapi skor keseluruhannya lebih rendah 3 poin. Selisihnya terutama muncul pada dua benchmark lainnya. Kalau bisnis Anda lebih dekat ke “pencarian web untuk soal sulit”, kolom BrowseComp bisa jadi rujukan tersendiri.
Mode berbeda dari vendor yang sama bisa sangat berbeda. Exa Lite dan Exa Auto hanya selisih 1 poin, tetapi waktu tempuhnya hampir dua kali lipat. Jadi bacalah per produk dan mode spesifik, jangan menggabungkan Exa Lite dan Exa Auto menjadi satu “skor Exa”.
💡 Catatan data: Skor di atas adalah hasil evaluasi pihak ketiga dari Artificial Analysis, dan waktu yang dicantumkan adalah waktu tugas standar. Jika ingin mereproduksi perbandingan serupa pada masalah bisnis Anda sendiri, Anda bisa memakai APIYI apiyi.com untuk menetapkan satu model penjawab, lalu menghubungkannya secara terpisah ke berbagai alat pencarian untuk melakukan uji A/B.
Apakah skor tertinggi pada API pencarian berarti paling hemat?
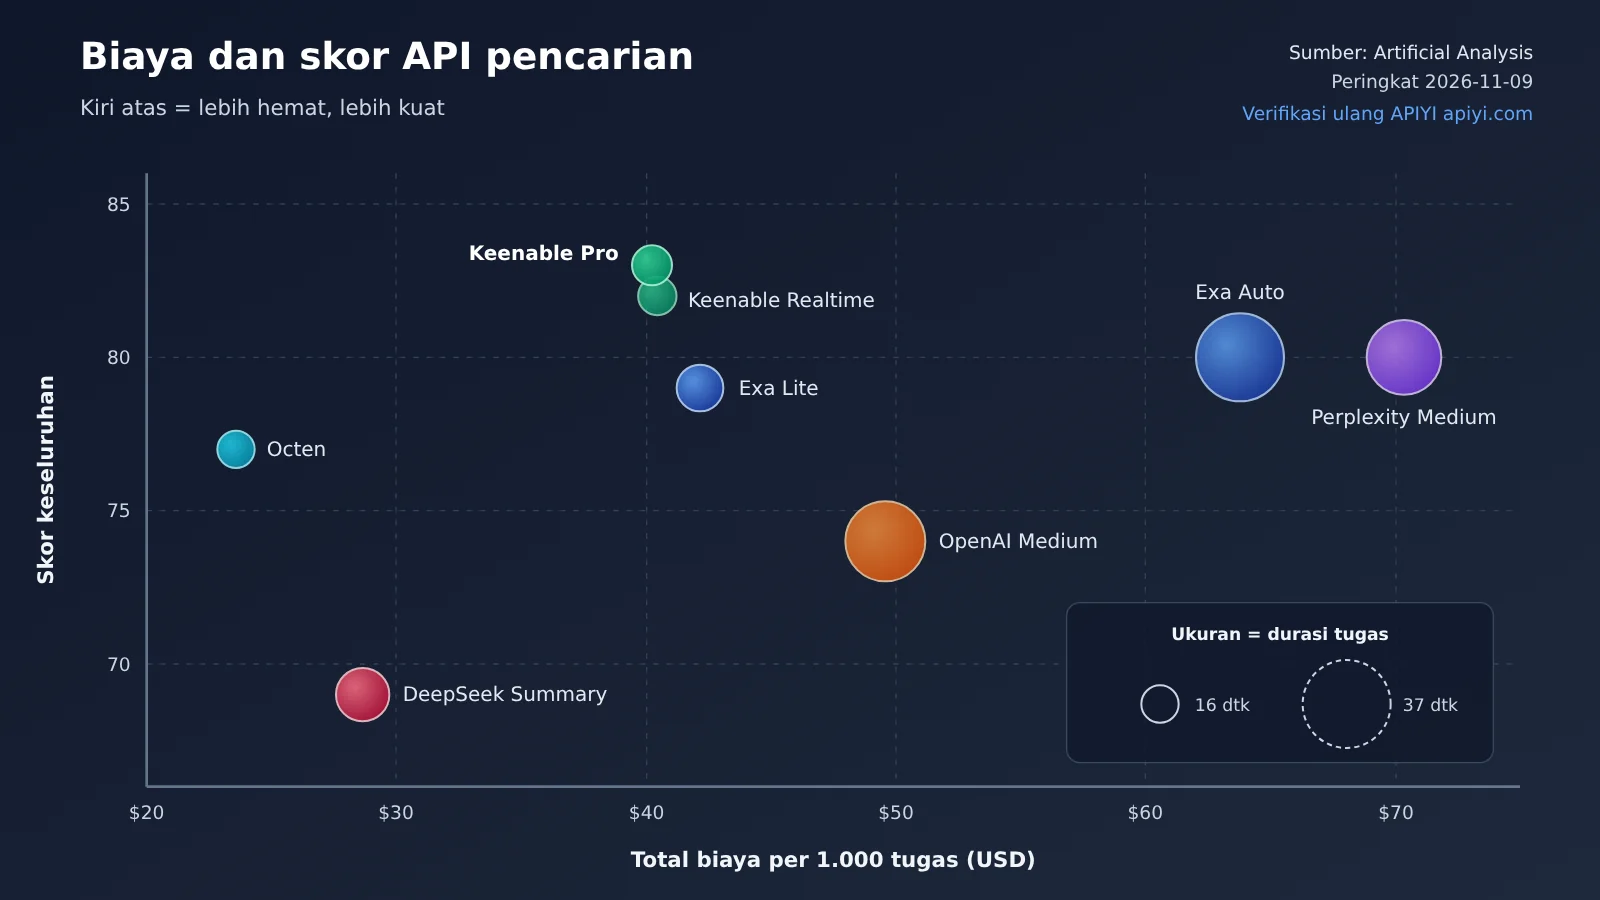
Artificial Analysis juga memublikasikan perkiraan biaya per 1.000 tugas benchmark, yang dipecah menjadi biaya pencarian dan biaya model (peringkat 2026-11-09, dolar AS). Kolom “biaya per poin” dihitung secara kasar oleh editor artikel ini menggunakan rumus “total biaya ÷ skor keseluruhan”; angka ini hanya untuk referensi perbandingan, bukan metrik resmi.
| Konfigurasi pencarian | Skor kualitas | Biaya pencarian + biaya model | Total biaya/1.000 tugas | Biaya per poin (turunan editor) | Durasi tugas (11-13) |
|---|---|---|---|---|---|
| Keenable Pro | 83 | 31.87 + 8.35 | $40.22 | sekitar $0.48 | 16.6 detik |
| Keenable Realtime | 82 | 31.94 + 8.52 | $40.46 | sekitar $0.49 | 16.0 detik |
| Exa Auto + Highlights | 80 | 53.17 + 10.60 | $63.77 | sekitar $0.80 | 36.7 detik |
| Perplexity Medium | 80 | 62.30 + 8.04 | $70.34 | sekitar $0.88 | 31.1 detik |
| Exa Lite + Highlights | 79 | 31.20 + 10.95 | $42.15 | sekitar $0.53 | 19.4 detik |
| Octen Highlights | 77 | 9.07 + 14.50 | $23.57 | sekitar $0.31 | 15.6 detik |
| OpenAI Web Search Medium | 74 | 40.19 + 9.40 | $49.59 | sekitar $0.67 | 33.1 detik |
| DeepSeek Search Summary | 69 | 8.47 + 20.19 | $28.66 | sekitar $0.42 | 22.4 detik |
Tiga kesimpulan dari tabel biaya API pencarian
Skor tertinggi belum tentu paling mahal. Keenable Pro berada di peringkat pertama dengan 83 poin, sekitar $40.22 per 1.000 tugas, atau setara dengan sekitar $0.04 per tugas, yang berada di kisaran menengah dalam sampel. Perplexity Medium skornya 3 poin lebih rendah, tetapi total biayanya sekitar 75% lebih tinggi.
Selisih 1 poin, biaya bisa berbeda lebih dari 30%. Exa Lite + Highlights memperoleh 79 poin dan $42.15/1.000 tugas, sedangkan Exa Auto + Highlights memperoleh 80 poin dan $63.77/1.000 tugas. Yang pertama sekitar 34% lebih murah dan durasi tugasnya juga lebih singkat. Mengacu pada halaman harga resmi Exa (data per 2026-11-13), tier Lite adalah $4 per 1.000 permintaan, sedangkan tier Auto adalah $7 per 1.000 permintaan. Perbedaan biaya pencarian dalam peringkat konsisten dengan struktur harga tersebut.
Biaya pencarian rendah, biaya model bisa lebih tinggi. DeepSeek Search Summary hanya mencatat biaya pencarian $8.47, tetapi biaya modelnya mencapai $20.19, tertinggi di tabel. Octen memiliki total biaya terendah, tetapi biaya modelnya juga lebih tinggi daripada Keenable, Exa, dan Perplexity. Jika hasil pencarian tidak cukup efektif, Agent akan melakukan lebih banyak putaran pencarian dan membaca lebih banyak halaman, sehingga konsumsi token ikut meningkat. Jadi, saat menghitung biaya, gunakan satuan “total biaya untuk menyelesaikan satu tugas”, bukan hanya melihat harga per panggilan API pencarian.
Daftar peringkat Search Index ini bisa memandu pilihan praktis apa saja?
Search Index adalah benchmark retrieval fakta umum yang didominasi bahasa Inggris, bukan benchmark khusus untuk internet Tiongkok. Di bawah ini saya petakan ke skenario Agent yang umum, sekaligus menandai mana yang bisa langsung dijadikan referensi dan mana yang perlu pengujian tambahan.
| Skenario Agent | Metrik paling krusial | Nilai referensi daftar | Kandidat yang disarankan |
|---|---|---|---|
| Tanya jawab faktual | Akurasi, akurasi sitasi | Tinggi, bisa langsung merujuk AA-Omniscience | Keenable, Exa Lite, Perplexity |
| Riset kompleks multi-sumber | Retrieval multi-hop, recall kumpulan hasil | Tinggi, fokus pada DeepSearchQA dan BrowseComp | Keenable Pro, Exa Auto, Perplexity Medium |
| Agent latensi rendah | Waktu penyelesaian tugas penuh, latensi P95 | Sedang, waktu tugas hanya bisa jadi referensi | Keenable Realtime, Octen, Exa Lite |
| Retrieval informasi berbahasa Mandarin | Cakupan sumber Mandarin, keterjangkauan situs domestik | Rendah, perlu membangun set pengujian Mandarin sendiri | Tambahkan Baidu Qianfan, Bocha, Alibaba Cloud Bailian sebagai pembanding |
| Retrieval dokumentasi pemrograman | Cakupan dokumen resmi, informasi versi | Rendah hingga sedang, perlu uji ulang dengan pertanyaan teknis nyata | Exa, Perplexity, Parallel |
Cara memakai Search Index untuk perbandingan sekunder API pencarian
Pendekatan yang lebih masuk akal adalah menjadikan daftar publik sebagai “alat penyaring awal”, lalu melakukan perbandingan putaran kedua dengan tugas Anda sendiri:
- Pilih 3–4 konfigurasi kandidat dari daftar berdasarkan tiga aspek: kualitas, waktu, dan total biaya;
- Siapkan 50–100 pertanyaan bisnis Anda sendiri, mencakup fakta sederhana, berita terkini, pertanyaan multi-hop, kueri berbahasa Mandarin, dan lintas bahasa;
- Gunakan model jawaban yang sama, jumlah putaran maksimum yang sama, dan jumlah hasil yang sama; hanya ganti alat pencariannya;
- Catat akurasi, akurasi sitasi, total biaya per tugas, latensi P50/P95, serta jumlah hasil kosong dan timeout;
- Stabilitas di lingkungan produksi perlu diuji beban secara terpisah, karena daftar peringkat sudah mengecualikan kesalahan fatal setelah percobaan ulang.
Rekomendasi Pemilihan API Pencarian dan Panduan Memulai Cepat
🎯 Saran pemilihan: Kalau kamu mengutamakan kualitas dan kecepatan secara menyeluruh, uji dulu Keenable Pro/Realtime; kalau sensitif terhadap biaya tapi tetap ingin kualitas mendekati 80 poin, Exa Lite + Highlights dan Octen layak diuji lebih serius; tim yang sudah mendalam memakai ekosistem OpenAI bisa langsung memakai Web Search bawaan, tapi harus menerima bahwa alur eksekusinya tidak bisa dikendalikan. Untuk implementasi nyata, kami sarankan memanggil model penjawab secara terpadu lewat APIYI apiyi.com, lalu menjadikan alat pencarian sebagai modul yang bisa dipasang-lepas, sehingga saat mengganti API pencarian kode di sisi model tidak perlu diubah.
Contoh Minimal: Sisi Model Lewat Antarmuka Terpadu
Kode di bawah ini mematok model penjawab, mendeklarasikan alat pencarian sebagai sebuah function, dan penyedia Search API mana yang mengimplementasikannya cukup diganti di kode lokal:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka terpadu APIYI, model bisa diganti
)

tools = [{"type": "function", "function": {
    "name": "web_search",
    "description": "联网搜索,返回最多10条结果",
    "parameters": {"type": "object",
                   "properties": {"query": {"type": "string"}},
                   "required": ["query"]}}}]

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # Ganti dengan model yang ingin kamu evaluasi
    messages=[{"role": "user", "content": "Exa 3.0 是哪天发布的?"}],
    tools=tools,
)
print(resp.choices[0].message)
Lihat kode lengkap: model yang sama, A/B membandingkan beberapa API pencarian
import json
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MODEL = "gpt-4o-mini"   # Model penjawab tetap, menjaga variabel kontrol
MAX_TURNS = 25          # Batas giliran yang sama dengan Search Index

# Fungsi adaptor untuk masing-masing API pencarian, implementasikan sendiri sesuai dokumentasi resmi
def search_provider_a(query: str) -> list:
    return []  # Mengembalikan [{"title":..., "url":..., "snippet":...}]

def search_provider_b(query: str) -> list:
    return []

TOOLS = [{"type": "function", "function": {
    "name": "web_search",
    "description": "联网搜索,返回最多10条结果",
    "parameters": {"type": "object",
                   "properties": {"query": {"type": "string"}},
                   "required": ["query"]}}}]

def run_task(question: str, search_fn) -> dict:
    messages = [{"role": "user", "content": question}]
    start, searches = time.time(), 0
    for _ in range(MAX_TURNS):
        resp = client.chat.completions.create(
            model=MODEL, messages=messages, tools=TOOLS)
        msg = resp.choices[0].message
        if not msg.tool_calls:
            return {"answer": msg.content, "searches": searches,
                    "seconds": round(time.time() - start, 1)}
        messages.append(msg)
        for call in msg.tool_calls:
            query = json.loads(call.function.arguments)["query"]
            results = search_fn(query)[:10]
            searches += 1
            messages.append({"role": "tool", "tool_call_id": call.id,
                             "content": json.dumps(results, ensure_ascii=False)})
    return {"answer": None, "searches": searches,
            "seconds": round(time.time() - start, 1)}

for name, fn in [("A", search_provider_a), ("B", search_provider_b)]:
    print(name, run_task("Perplexity 何时推出独立 Search API?", fn))
🚀 Mulai cepat: Pengguna baru bisa mengambil kuota uji gratis di APIYI apiyi.com, jalankan dulu skrip A/B di atas dengan beberapa pertanyaan bisnis, baru kemudian putuskan API pencarian mana yang akan dimasukkan ke rencana resmi.
Tanya Jawab Umum (FAQ)
Q1: Apa itu Search Index?
Search Index adalah indeks evaluasi API pencarian yang diluncurkan oleh Artificial Analysis. Indeks ini memfiksasi model penjawab dan kerangka Agent, hanya mengganti layanan pencariannya, lalu mengukur efektivitas pencarian menggunakan rata-rata berbobot setara dari tiga benchmark: DeepSearchQA, BrowseComp, dan AA-Omniscience, dengan skor maksimal 100.
Q2: Apakah skor 83 berarti tingkat jawaban benar 83%?
Bukan. 83 adalah nilai rata-rata dari skor tiga benchmark, dan metrik ketiganya pun berbeda: DeepSearchQA memakai F1, dua lainnya memakai akurasi. Keenable Pro berturut-turut mencetak 88, 87, dan 73, dengan rata-rata sekitar 82,67, yang ditampilkan sebagai 83.
Q3: Data peringkat ini dari kapan?
Skor kualitas dan data biaya berasal dari pembaruan peringkat tanggal 2026-11-09, sedangkan waktu penyelesaian tugas lengkap memakai nilai yang dibaca pada 2026-11-13. Peringkat terus diperbarui, jadi tanggalnya perlu dicantumkan saat mengutip.
Q4: Apakah waktu tempuh dalam peringkat bisa dianggap sebagai kecepatan respons API pencarian?
Tidak bisa. Waktu tempuh dalam tabel adalah waktu penyelesaian lengkap untuk satu tugas standar, mencakup pencarian multi-putaran, pembacaan halaman web, dan inferensi model. Latensi HTTP sekali panggil perlu diukur secara terpisah, sebaiknya catat sekaligus P50 dan P95.
Q5: Bagaimana cara cepat membandingkan efektivitas berbagai API pencarian di bisnis saya?
Fiksasikan satu model penjawab, lalu hanya ganti alat pencariannya. Anda bisa memanggil model melalui APIYI apiyi.com menggunakan antarmuka yang kompatibel dengan OpenAI, atur base_url menjadi `https://api.apiyi.com/v1`, kemudian terapkan skrip A/B dalam artikel ini. Jika Anda juga ingin melihat perubahan efektivitas pencarian setelah model diganti, Key yang sama bisa dipakai untuk beralih antara model OpenAI, Claude, Gemini, dan lainnya.
Q6: Apa saja keterbatasan Search Index?
Ada empat poin utama: ini bukan benchmark khusus untuk internet berbahasa Mandarin; alur eksekusi pencarian native OpenAI berbeda dari konfigurasi lainnya; error seperti 429, 5xx, dan timeout tidak dihitung dalam hasil setelah dicoba ulang, sehingga tidak mencerminkan stabilitas di lingkungan produksi; biaya dihitung berdasarkan estimasi tugas evaluasi dan bisa jadi tidak sesuai dengan tagihan Anda yang sebenarnya. Untuk pencarian berita berbahasa Mandarin dan dokumentasi teknis domestik, disarankan membangun set pengujian sendiri dan memverifikasinya bersama model domestik melalui APIYI apiyi.com.
Poin Penting Pemilihan API Pencarian Search Index
- Pencarian adalah variabel independen: model yang sama naik dari 33 poin ke 83 poin, pilihan API pencarian langsung memengaruhi kualitas Agent.
- 83 poin bukan akurasi: ini adalah rata-rata berbobot sama dari tiga benchmark, dengan metode penilaian yang berbeda-beda.
- Durasi dilihat dari tugas keseluruhan: Keenable sekitar 16 detik, Exa Auto sekitar 37 detik, keduanya bukan latensi satu kali panggilan API.
- Biaya perlu diurai: biaya pencarian rendah bisa berarti biaya model tinggi, jadi bandingkan dengan total biaya per tugas.
- 1 poin bisa berarti selisih 34%: Exa Lite dan Auto hanya berbeda 1 poin, yang pertama sekitar 30% lebih murah.
- Peringkat hanya untuk penyaringan awal: skenario seperti bahasa Mandarin dan dokumentasi pemrograman perlu melakukan perbandingan A/B kedua dengan tugas Anda sendiri.
Ringkasan
Nilai paling berharga dari peringkat Search Index ini adalah desain “model sama, alat pencarian berbeda” yang mengisolasi pengaruh kualitas pencarian terhadap Agent:
- Kualitas: tanpa pencarian 33 poin, tertinggi 83 poin. Bahkan ketika semuanya sudah terhubung ke pencarian, ada selisih sekitar 14 poin antar konfigurasi;
- Kecepatan: dengan skor sama 80 poin, waktu tugas lengkap bisa berbeda lebih dari 5 detik; konfigurasi skor tinggi juga bisa cepat;
- Biaya: Keenable Pro kualitas tertinggi, biaya menengah; Exa Lite dan Octen menonjol dalam efisiensi biaya; contoh DeepSeek Summary menunjukkan biaya pencarian rendah tidak berarti total biaya rendah.
Disarankan gunakan peringkat untuk memilih 3–4 kandidat terlebih dahulu, lalu lakukan uji A/B dengan model tetap pada kumpulan pertanyaan Anda sendiri. Direkomendasikan memanggil model jawaban secara terpusat melalui APIYI apiyi.com, menjadikan alat pencarian sebagai modul yang dapat diganti, dan menentukan solusi akhir berdasarkan tiga data: kualitas, kecepatan, dan biaya.
Referensi
- Peringkat Artificial Analysis Search API: data skor kualitas, biaya, dan waktu
- Tautan:
artificialanalysis.ai/agents/search-api -
Keterangan: sumber utama skor, biaya, dan waktu dalam artikel ini
-
Metodologi evaluasi Artificial Analysis Search API: konfigurasi pengujian dan aturan penilaian
- Tautan:
artificialanalysis.ai/methodology/search-api -
Keterangan: mencakup penjelasan model, putaran, jumlah hasil, aturan percobaan ulang, dan lain-lain
-
Exa Pricing: harga untuk tier Lite, Auto, dan lainnya
- Tautan:
exa.ai/pricing -
Keterangan: digunakan untuk memahami perbedaan biaya pencarian antar mode Exa dalam peringkat
-
Pengumuman Exa 3.0: mode Lite dan Dynamic Highlights
- Tautan:
exa.ai/blog/exa-3 -
Keterangan: dirilis pada 2026-10-19, berisi data pengujian mandiri dari vendor
-
Dokumentasi OpenAI Web Search: alat pencarian bawaan Responses API
- Tautan:
developers.openai.com/api/docs/guides/tools-web-search -
Keterangan: memahami cara eksekusi dan parameter pencarian native OpenAI
-
Harga Perplexity Search API: tier Standard dan Fast
- Tautan:
docs.perplexity.ai/docs/getting-started/pricing - Keterangan: memahami aturan penagihan per permintaan
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui halaman utama situs APIYI, informasi integrasi lebih lanjut dapat diakses di pusat dokumentasi docs.apiyi.com