Catatan penulis: Berangkat dari tugas Agent pengembangan perangkat lunak selama 30 menit, artikel ini menguraikan komponen biaya dalam beberapa kali pemanggilan Agent—input biasa, penulisan cache, pembacaan cache, output, dan bolak-balik penggunaan alat. Artikel ini juga membandingkan biaya cache dari tiga penyedia dan menggunakan contoh 12 kali pemanggilan untuk menjelaskan kapan cache benar-benar bisa menghemat biaya.
Pada 9 November 2026, Google Cloud meluncurkan dua sistem TPU generasi kedelapan, TPU 8tx dan TPU 8i Max, sekaligus membuka kode sumber TPU Sync untuk transfer KV Cache. “Dinding memori di era Agent” kembali menjadi topik pembicaraan. Banyak developer pun bertanya: karena KV Cache di lapisan dasar semakin cepat, apakah tagihan API Agent saya juga akan makin murah?
Manfaat utama: Setelah membaca artikel ini, Anda akan mendapatkan rumus lengkap untuk menghitung biaya Agent, perbandingan biaya cache dari tiga penyedia, serta daftar optimasi biaya yang bisa langsung diterapkan.
Biaya API untuk Pemanggilan Agent Berulang: Ringkasan Informasi Utama
| Informasi | Detail |
|---|---|
| Peristiwa yang melatarbelakangi | Pada 2026-11-09, Google merilis TPU 8tx, TPU 8i Max, dan TPU Sync, dengan fokus pada hambatan memori dan KV Cache pada Agent |
| Pertanyaan yang ingin dijawab developer | Apakah optimasi di tingkat infrastruktur dapat menurunkan tagihan API Agent? |
| Kesimpulan utama | Tagihan ditentukan bersama oleh input reguler, penulisan cache, pembacaan cache, token output, jumlah pemanggilan, dan biaya penggunaan alat |
| Variabel utama | Apakah prefiks stabil, apakah TTL cache cukup untuk mencakup waktu tunggu alat, dan apakah konteks percakapan sebelumnya terus membengkak |
| Cakupan dampak | Skenario pemanggilan berulang, seperti Agent coding, Agent dokumen panjang, dan kolaborasi multi-Agent |
Seperti Apa Tugas Agent Berulang Selama 30 Menit?
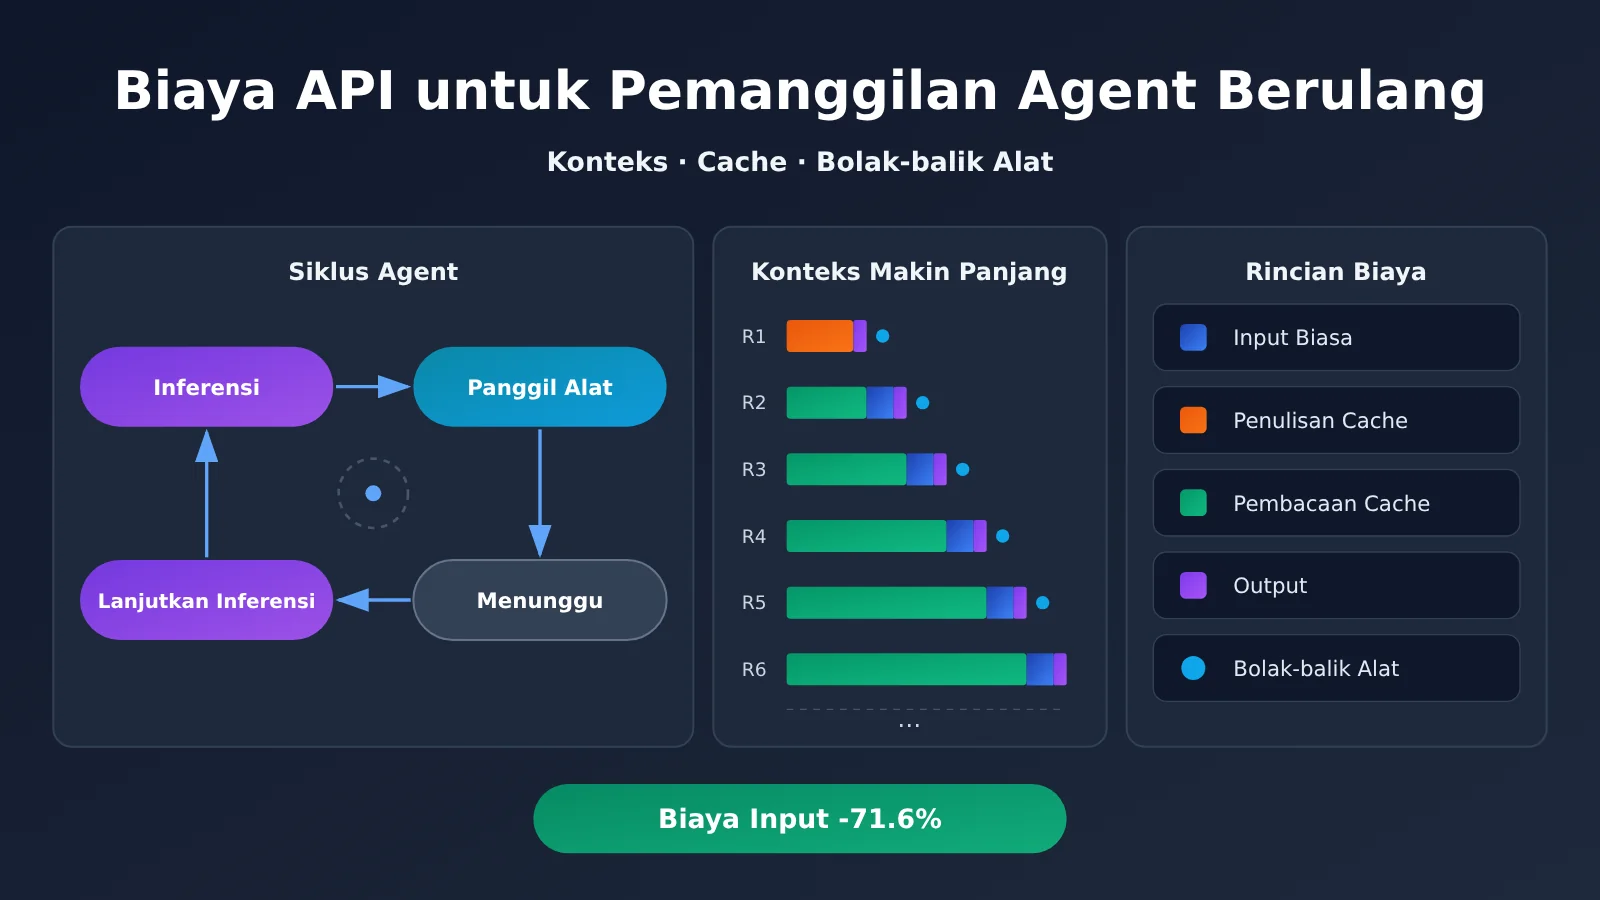
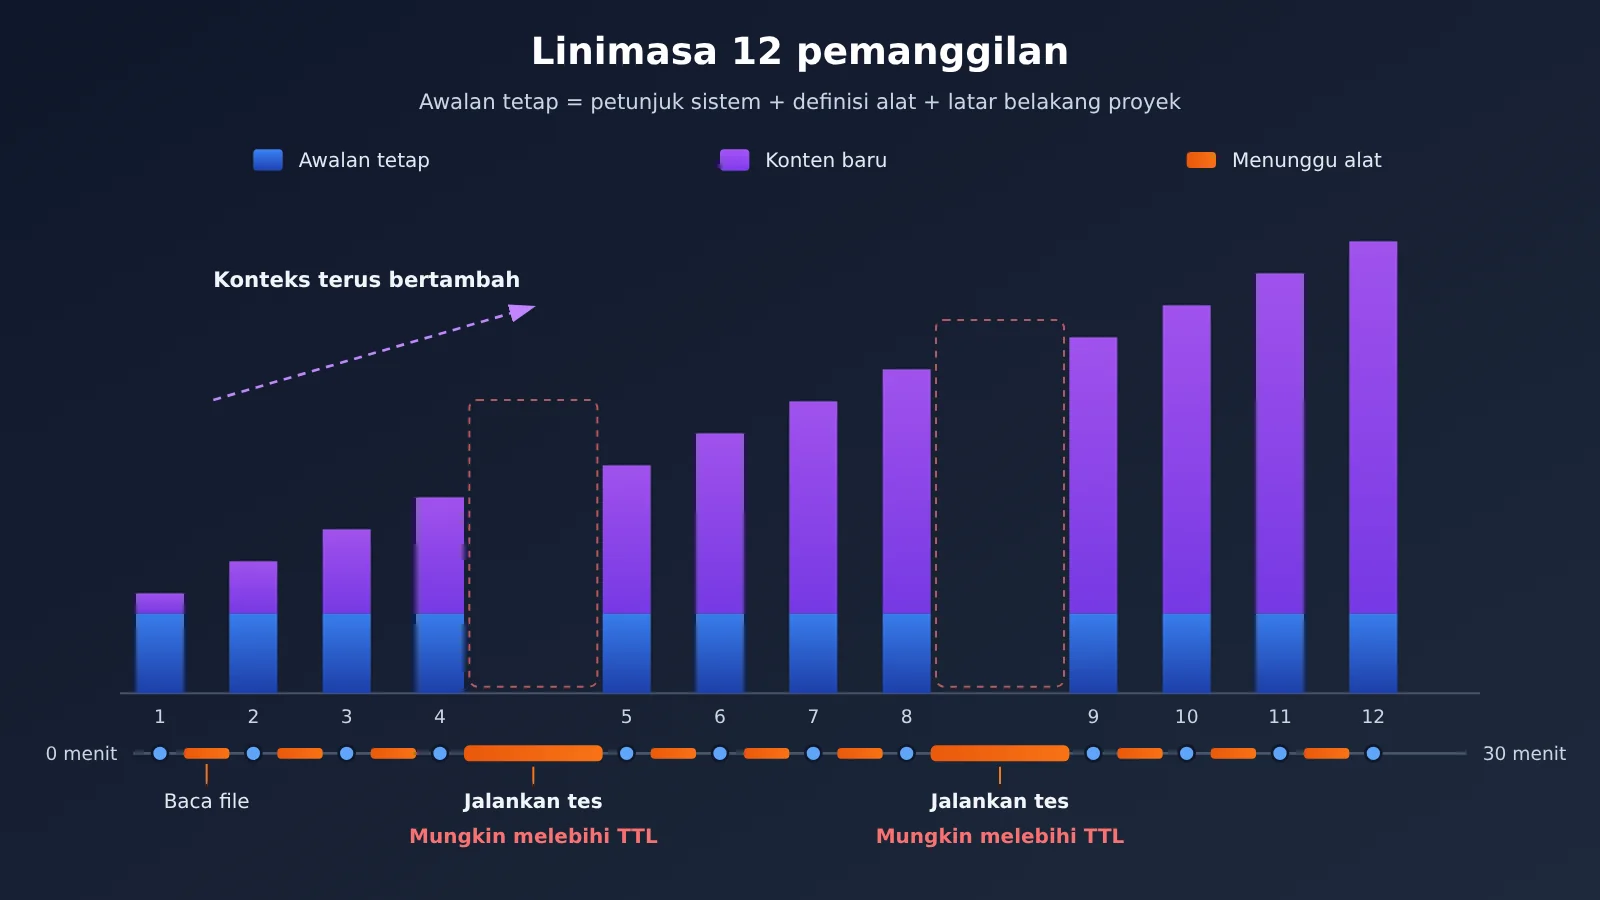
Bayangkan sebuah Agent pengembangan perangkat lunak menerima tugas untuk memperbaiki pengujian yang gagal di suatu modul. Agent terlebih dahulu membaca struktur proyek dan kode sumber terkait, lalu menyusun rencana perubahan. Setelah itu, Agent menggunakan alat untuk mengubah berkas dan menjalankan pengujian, menunggu hasilnya, lalu melanjutkan penalaran berdasarkan pesan kesalahan. Dalam 30 menit, siklus “menalar—menggunakan alat—menunggu—menalar” ini bisa terjadi belasan kali.
Masalahnya, API Model Bahasa Besar pada dasarnya tidak menyimpan status. Pada setiap permintaan, Agent harus mengirim ulang petunjuk sistem, definisi alat, konteks proyek, serta percakapan dan keluaran alat sebelumnya. Permintaan ke-12 sering kali memuat hampir seluruh riwayat dari 11 putaran sebelumnya. Inilah sumber “perhitungan ulang konteks”.
Komponen Biaya API untuk Pemanggilan Agent Berulang
Jika satu tugas Agent diuraikan, biayanya setidaknya terdiri dari lima komponen. Empat komponen pertama adalah biaya Token model. Komponen kelima terjadi di luar model, tetapi sering kali terabaikan.
| Komponen biaya | Arti | Karakteristik penagihan |
|---|---|---|
| Input biasa | Token input yang tidak menggunakan cache dan dikenai harga standar | Harga input standar |
| Penulisan cache | Bagian input yang digunakan untuk membuat cache agar bisa dipakai kembali | Pada sebagian penyedia dan model, biayanya dihitung dengan tarif lebih tinggi daripada input standar |
| Pembacaan cache | Input yang menggunakan cache yang sudah ada | Biasanya jauh lebih murah daripada harga input standar |
| Token output | Konten yang dihasilkan model, termasuk parameter pemanggilan alat | Biasanya merupakan komponen dengan harga tertinggi; cache tidak dapat menguranginya |
| Alat dan eksekusi eksternal | Layanan eksternal seperti pencarian, eksekusi kode, dan basis data | Ditagih sesuai tarif masing-masing layanan dan menambah jumlah pemanggilan model |
Berdasarkan komponen tersebut, rumus biaya untuk satu tugas dapat ditulis sebagai berikut:
Total biaya tugas = Σ (input biasa × harga input + penulisan cache × harga penulisan + pembacaan cache × harga pembacaan + output × harga output) + biaya alat dan eksekusi eksternal
Simbol Σ dalam rumus ini berarti menjumlahkan biaya setiap pemanggilan model dalam tugas tersebut. Artinya, jumlah pemanggilan itu sendiri menjadi pengali: semakin sering alat digunakan bolak-balik, semakin banyak pemanggilan model yang terjadi, dan semakin sering pula prefiks tetap dikenai biaya. Pemanggilan alat tidak hanya memerlukan biaya untuk alat itu sendiri, tetapi juga memecah satu proses penalaran menjadi beberapa tahap. Setiap tahap harus menyertakan kembali konteks.
Perbedaan KV Cache, Prompt Cache, dan Kompresi Konteks dalam Pemanggilan Agent Berulang
Saat membahas biaya Agent, tiga konsep ini paling sering tertukar. Ketiganya berada pada lapisan yang berbeda dan dampaknya terhadap tagihan juga tidak sama.
| Teknologi | Lapisan | Makna spesifik | Dampak bagi pengguna API |
|---|---|---|---|
| KV Cache | Lapisan dasar inferensi model | Menyimpan status Key/Value dalam komputasi attention agar riwayat token tidak perlu dihitung ulang | Tidak dikendalikan langsung oleh pengguna; berdampak pada biaya dan latensi penyedia layanan |
| Prompt Cache | Lapisan layanan API | Penyedia layanan menggunakan kembali awalan petunjuk yang berulang, lalu menagih penulisan dan pembacaan cache secara terpisah | Terlihat langsung pada kolom cache di tagihan |
| Kompresi konteks | Lapisan aplikasi | Merangkum, menyaring, atau memangkas konten riwayat sebelum mengirimkannya | Mengurangi jumlah token yang benar-benar dikirim, tetapi bisa menghilangkan detail |
Perlu diperhatikan bahwa dokumentasi resmi OpenAI menjelaskan Prompt Cache sebenarnya menyimpan KV Tensor, bukan teks token mentah. Jadi, Prompt Caching dapat dipahami sebagai kemampuan menggunakan kembali status KV di lapisan dasar yang dikemas sebagai layanan dan sistem penagihan. Keduanya bukan hal yang sama sekali tidak berhubungan, tetapi yang dapat dirasakan pengguna hanyalah aturan penagihannya.
Kompresi konteks adalah hal yang berbeda. Kompresi mengubah “konten apa yang disertakan” dalam permintaan berikutnya, bukan “bagaimana konten itu digunakan kembali”. Semakin agresif kompresinya, semakin sedikit token yang digunakan, tetapi semakin besar pula risiko Agent melupakan detail penting.
Mengapa optimalisasi dasar untuk pemanggilan Agent berulang tidak otomatis menurunkan tagihan
TPU 8i Max yang dirilis Google kali ini menggandakan bandwidth HBM dan SRAM on-chip. Dalam pengujian internal di platform Ironwood, TPU Sync mengurangi latensi transfer KV Cache hingga lebih dari 90%. Sementara itu, Agent Compute Engine menjeda sesi saat Agent tidak aktif dan memindahkan memori kerja keluar dari chip. Optimalisasi ini meningkatkan pemanfaatan sumber daya dan mengurangi latensi inferensi penyedia layanan, misalnya TTFT. Bagi pengguna, dampaknya mungkin berupa respons yang lebih cepat.
Namun, harga API ditentukan secara komersial oleh penyedia layanan, sementara tagihan pengguna tetap dihitung berdasarkan token. Peningkatan efisiensi perangkat keras mungkin memengaruhi harga dalam jangka panjang, tetapi dampaknya tidak otomatis atau sebanding langsung. Selain itu, per 2026-11-10, TPU 8tx dan TPU 8i Max masih berstatus “Segera hadir” dan harganya belum diumumkan. Bagi developer, yang bisa langsung dikendalikan adalah struktur token yang digunakan, bukan perangkat keras di sisi penyedia.
Biaya API untuk Pemanggilan Agent Multi-Turn: Perbandingan Penagihan Cache dari Tiga Penyedia
Tiga penyedia utama menawarkan mekanisme cache, tetapi cara pemicuan, TTL, dan metode penagihannya cukup berbeda. Tabel berikut disusun berdasarkan dokumentasi resmi masing-masing penyedia. Untuk detailnya, lihat dokumentasi model dan endpoint terkait.
| Penyedia | Mekanisme cache | Opsi TTL | Biaya penulisan | Biaya pembacaan | Platform yang tersedia |
|---|---|---|---|---|---|
| OpenAI | Prompt Caching, mendukung cache prefiks otomatis pada model | Beberapa model baru menggunakan 30 menit secara default, sementara model tertentu mendukung 12 jam | Untuk model dan endpoint yang mendukung konfigurasi terkait: 30 menit dikenai biaya 1,25 kali input biasa, sedangkan 12 jam dikenai biaya 2,5 kali; mode cache lainnya mungkin tidak mengenakan biaya penulisan tambahan | Biasanya 0,1 kali biaya input biasa, bahkan lebih rendah untuk model tertentu | API resmi, APIYI apiyi.com |
| Anthropic | Prompt Caching | Default 5 menit, dapat diperpanjang hingga 1 jam | Cache 5 menit dikenai biaya 1,25 kali input biasa, sedangkan cache 1 jam dikenai biaya 2 kali | Bervariasi menurut model | API resmi, APIYI apiyi.com |
| Google Gemini | Context Caching, dengan cache implisit dan eksplisit | TTL cache eksplisit dapat diatur | Cache eksplisit memiliki biaya tambahan yang dihitung berdasarkan jumlah Token yang di-cache dan durasi penyimpanan | Cache yang digunakan dapat mengurangi biaya input berulang | API resmi, APIYI apiyi.com |
Sebagai contoh, berikut harga resmi Claude Sonnet 5.5: input biasa seharga $2.00 per satu juta Token, penulisan cache 5 menit seharga $2.50, penulisan cache 1 jam seharga $4.00, dan pembacaan cache seharga $0.10. Biaya pembacaan cache hanya 5% dari biaya input biasa. Inilah alasan prefiks yang digunakan berulang kali dapat memangkas biaya secara signifikan.
Perlu diingat bahwa OpenAI secara resmi menyatakan bahwa cache hit tidak selalu dijamin. Cache eksplisit Gemini juga bukan berarti “penyimpanan gratis”; durasi penyimpanannya sendiri dikenai biaya. Cache adalah diskon bersyarat, bukan potongan harga yang otomatis berlaku.
🎯 Saran teknis: Kemampuan cache, aturan penagihan, dan kolom respons berbeda-beda di setiap model hulu. Gateway terpadu tidak otomatis membuat semua model mendapatkan diskon cache yang sama. Sebaiknya gunakan APIYI apiyi.com untuk menguji model-model kandidat dengan kode yang sama dan kompatibel dengan OpenAI, lalu jadikan kolom
usageyang benar-benar dikembalikan dan tagihan aktual sebagai acuan.
Perhitungan Biaya Cache untuk Pemanggilan Agent Berulang: Contoh 12 Kali Pemanggilan
Kita gunakan kembali tugas pengembangan 30 menit dari bagian sebelumnya dan membuat contoh berdasarkan harga resmi Claude Sonnet 5.5. Asumsinya sebagai berikut:
- Tugas memanggil model sebanyak 12 kali, dengan 22.000 Token input setiap kali;
- Sebanyak 20.000 Token merupakan petunjuk sistem, definisi alat, dan latar belakang proyek yang berulang;
- Setiap pemanggilan menambahkan 2.000 Token baru;
- Cache berlaku selama 1 jam dan berhasil digunakan kembali pada semua permintaan berikutnya.
Tanpa cache: 12 × 22.000 × $2 / 1.000.000 = $0.528.
Dengan cache 1 jam: Penulisan pertama sebanyak 20.000 Token dikenai biaya $0.080, input biasa pertama sebanyak 2.000 Token dikenai biaya $0.004, pembacaan cache untuk 11 kali berikutnya dikenai biaya $0.022, dan input baru untuk 11 kali berikutnya dikenai biaya $0.044. Totalnya $0.150, dengan penghematan biaya input sekitar 71.6%.
Contoh ini hanya menghitung Token input, tidak termasuk Token output, pemanggilan alat, maupun biaya layanan eksternal. Dalam Agent sesungguhnya, riwayat percakapan akan terus bertambah di setiap giliran. Namun, arah kesimpulannya tetap sama: konteks berulang adalah sumber biaya yang paling mudah membengkak dalam pemanggilan Agent berulang.
Dampak Cache Kedaluwarsa, Perubahan Prefiks, dan TTL terhadap Biaya Agent
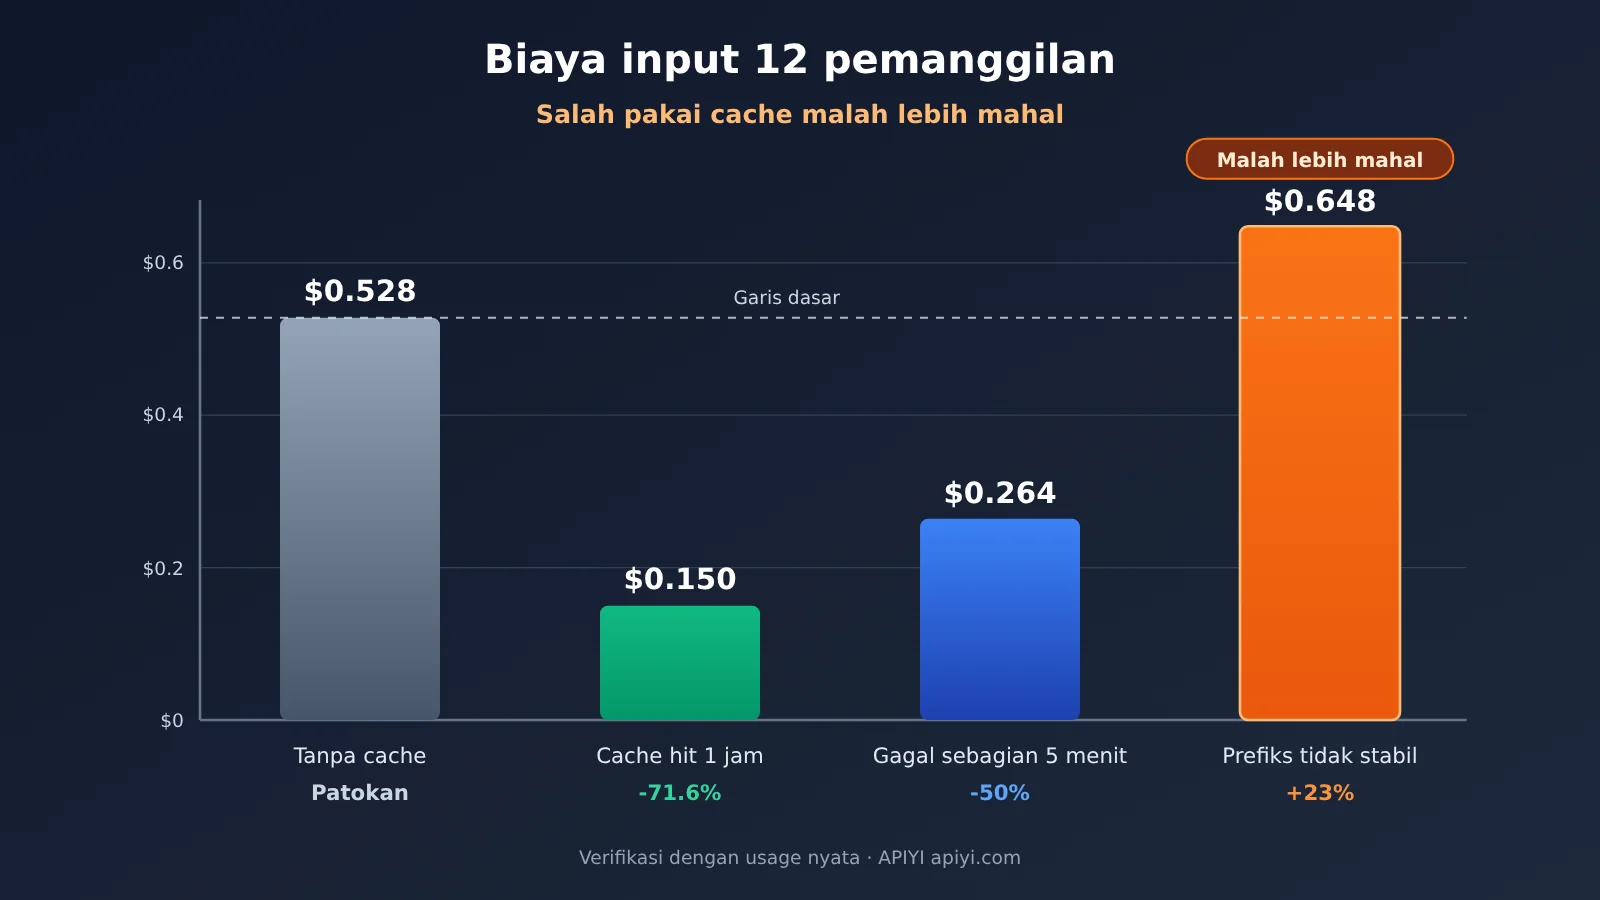
Di atas adalah skenario ideal. Berikut simulasi tambahan untuk tiga kondisi umum yang membuat hasilnya berbeda, dengan harga yang sama. (Angka berikut merupakan ilustrasi yang dihitung sendiri berdasarkan harga resmi per unit.)
| Skenario | Asumsi | Biaya input | Dibandingkan dengan tanpa cache |
|---|---|---|---|
| Tanpa cache | Semua 12 pemanggilan dikenai biaya input biasa | $0.528 | Acuan |
| Cache 1 jam, semua cache hit | Menulis 1 kali, membaca 11 kali | $0.150 | Hemat sekitar 71.6% |
| Cache 5 menit, semua cache hit | Harga penulisan $2.50, membaca 11 kali | $0.120 | Hemat sekitar 77.3% |
| Cache 5 menit, sebagian kedaluwarsa | Waktu tunggu alat habis sehingga total penulisan 4 kali dan pembacaan 8 kali | $0.264 | Hemat sekitar 50% |
| Prefiks tidak stabil | Prefiks berubah setiap kali, sehingga 12 pemanggilan semuanya dikenai biaya penulisan cache 5 menit | $0.648 | Justru menghabiskan sekitar 23% lebih banyak |
Beberapa hal berikut bisa langsung dijadikan pertimbangan:
- TTL harus mencakup waktu tunggu alat: Biaya penulisan cache 5 menit memang lebih murah, tetapi jika pengujian berjalan atau konfirmasi manual memakan waktu lebih dari 5 menit, cache akan kedaluwarsa dan perlu ditulis ulang. Penghematan pun berkurang drastis.
- Prefiks yang stabil lebih penting daripada TTL: Jika stempel waktu atau ID acak ditempatkan di awal petunjuk, setiap permintaan tidak akan cocok dengan cache. Dalam mode yang mengenakan biaya tambahan untuk penulisan, cache justru membuat tagihan lebih mahal.
- TTL yang lebih panjang belum tentu lebih baik: Harga penulisan untuk TTL 1 jam 1,6 kali lebih tinggi daripada TTL 5 menit. TTL yang lebih panjang hanya menguntungkan jika jarak antar-pemanggilan memang berpotensi melebihi 5 menit.
Cara Menurunkan Biaya API untuk Pemanggilan Agent Berkali-kali
Contoh singkat: Catat cache hit setiap kali pemanggilan
Langkah pertama untuk mengoptimalkan biaya adalah mengetahui dari mana biaya berasal. Kode berikut mengirim permintaan melalui antarmuka yang kompatibel dengan OpenAI, lalu mencetak kolom terkait cache dari usage:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka APIYI yang kompatibel dengan OpenAI
)

resp = client.chat.completions.create(
    model="your-model-name",  # Ganti dengan model yang ingin diuji
    messages=[
        {"role": "system", "content": "固定的系统提示词与工具说明……"},
        {"role": "user", "content": "本轮新增的任务内容"}
    ]
)
usage = resp.usage
details = getattr(usage, "prompt_tokens_details", None)
print("输入:", usage.prompt_tokens, "输出:", usage.completion_tokens,
      "缓存命中:", getattr(details, "cached_tokens", None))
Lihat implementasi lengkap: awalan stabil + pelacakan biaya per tugas
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Awalan tetap: instruksi sistem, definisi alat, dan konteks proyek umum diletakkan paling depan dan dijaga agar tidak berubah sedikit pun
STABLE_PREFIX = [
    {"role": "system", "content": "你是代码修复 Agent。工具定义与项目规范如下……"},
]

@dataclass
class TaskCost:
    # Harga satuan: dolar AS / sejuta Token, isi sesuai harga resmi model yang digunakan
    input_price: float
    cache_read_price: float
    output_price: float
    records: list = field(default_factory=list)

    def add(self, usage):
        details = getattr(usage, "prompt_tokens_details", None)
        cached = getattr(details, "cached_tokens", 0) or 0
        uncached = usage.prompt_tokens - cached
        cost = (uncached * self.input_price
                + cached * self.cache_read_price
                + usage.completion_tokens * self.output_price) / 1_000_000
        self.records.append({"cached": cached, "uncached": uncached,
                             "output": usage.completion_tokens, "cost": cost})

    def summary(self):
        total_in = sum(r["cached"] + r["uncached"] for r in self.records)
        hit = sum(r["cached"] for r in self.records) / max(total_in, 1)
        return {"calls": len(self.records), "cache_hit_rate": round(hit, 3),
                "total_cost": round(sum(r["cost"] for r in self.records), 4)}

def run_turn(history, new_msg, tracker, model="your-model-name"):
    # Tambahkan pesan baru saja, jangan susun ulang riwayat; letakkan informasi dinamis (seperti stempel waktu) di bagian akhir
    history.append({"role": "user", "content": new_msg})
    resp = client.chat.completions.create(
        model=model, messages=STABLE_PREFIX + history)
    tracker.add(resp.usage)
    history.append({"role": "assistant",
                    "content": resp.choices[0].message.content})
    return resp

tracker = TaskCost(input_price=2.0, cache_read_price=0.1, output_price=0.0)
history = []
run_turn(history, "测试 test_auth 失败,报错如下……", tracker)
print(tracker.summary())
Perlu diperhatikan, perkiraan di atas hanya mencakup diskon untuk pembacaan cache. Jika model yang digunakan mengenakan biaya terpisah untuk penulisan cache, tambahkan komponen tersebut berdasarkan kolom yang dikembalikan. Nama dan arti kolom usage dapat berbeda-beda antar-model, jadi gunakan hasil aktual sebagai acuan.
🚀 Mulai cepat: Sebaiknya jalankan skrip pelacakan di atas terlebih dahulu menggunakan kuota uji coba gratis di APIYI apiyi.com. Bandingkan tingkat cache hit dan biaya per tugas pada beberapa model, lalu tentukan model dan TTL yang akan digunakan di lingkungan produksi.
Lima Langkah untuk Mengoptimalkan Biaya Pemanggilan Agent dalam Beberapa Putaran
- Jaga agar awalan petunjuk tetap stabil: Letakkan instruksi sistem, definisi alat, dan referensi umum di bagian awal. Tempatkan stempel waktu dan informasi dinamis dari pengguna di bagian akhir. Jangan sembarangan mengubah urutan atau kolom dalam definisi alat.
- Pilih TTL yang tepat: Gunakan TTL singkat untuk tugas dengan pemanggilan yang padat dan jeda pendek. Untuk Agent yang menjalani pengujian, proses build, atau persetujuan manual dalam waktu lama, evaluasi apakah biaya tambahan untuk penulisan dengan TTL lebih panjang sebanding dengan penghematan dari berkurangnya penulisan ulang.
- Kelola konteks percakapan sebelumnya: Tambahkan konteks tanpa mengatur ulang urutannya agar awalan cache tidak rusak. Ringkas keluaran alat yang panjang, tetapi pertahankan kesimpulan utama, status tugas, dan bukti yang diperlukan.
- Kurangi pemanggilan model yang tidak perlu: Gabungkan alat yang dapat dijalankan sekaligus dalam satu pemanggilan. Serahkan langkah-langkah deterministik kepada kode, bukan kepada model, untuk mengurangi jumlah bolak-balik sejak awal.
- Pantau metrik aktual: Catat input biasa, penulisan cache, pembacaan cache, Token keluaran, rasio cache hit, TTFT, dan total biaya untuk setiap tugas. Evaluasi berdasarkan biaya per tugas, bukan biaya per permintaan.
Analisis Dampak Biaya API untuk Pemanggilan Agent dalam Beberapa Putaran
Dampak bagi Pengembang
- Model biaya perlu beralih dari “per permintaan” ke “per tugas”: Biaya Agent bergantung pada keseluruhan rantai pemanggilan. Jika hanya melihat harga satuan, jumlah tagihan sebenarnya bisa jauh lebih besar dari perkiraan.
- Rekayasa petunjuk kini perlu mempertimbangkan struktur penagihan: Stabilitas awalan menentukan apakah cache dapat berfungsi. Karena itu, merancang struktur petunjuk menjadi bagian dari rekayasa biaya.
- Pemilihan beberapa model perlu diuji langsung: Besaran diskon cache, TTL, dan biaya tambahan untuk penulisan berbeda-beda pada setiap model. Biaya untuk tugas yang sama bisa sangat berbeda saat menggunakan model lain.
Dampak bagi Industri
- Persaingan infrastruktur berfokus pada beban kerja Agent: Google menjadikan bandwidth memori, transfer KV Cache, serta jeda dan pemulihan Agent sebagai fokus. Ini menunjukkan bahwa penggunaan dalam beberapa putaran dengan konteks panjang telah menjadi pola beban kerja utama.
- Manfaat bagi pengguna lebih dulu terlihat pada latensi: Optimalisasi di lapisan bawah pertama-tama meningkatkan TTFT dan throughput. Penurunan harga Token bergantung pada kebijakan harga penyedia layanan, jadi pengembang sebaiknya tidak memasukkannya ke dalam anggaran terlalu dini.
Pertanyaan Umum (FAQ)
Q1: Mengapa biaya API untuk pemanggilan Agent dalam beberapa putaran lebih tinggi dari perkiraan?
Karena API bersifat stateless, setiap pemanggilan harus menyertakan kembali petunjuk sistem, definisi alat, dan konteks percakapan sebelumnya. Semakin banyak pemanggilan, semakin sering biaya untuk konten tetap ini dikenakan. Proses bolak-balik dengan alat juga menambah jumlah putaran pemanggilan.
Q2: Apakah KV Cache dan Prompt Cache sama?
Tidak sepenuhnya. KV Cache menggunakan kembali status pada tingkat dasar inferensi model. Sementara itu, Prompt Cache adalah mekanisme penyimpanan cache untuk awalan yang dapat digunakan kembali di tingkat API oleh penyedia layanan, termasuk aturan penagihannya. Dokumentasi OpenAI menjelaskan bahwa yang disimpan adalah KV Tensor. Pengguna hanya dapat mengetahui Prompt Cache melalui aturan penagihan dan tidak dapat mengontrol KV Cache secara langsung.
Q3: Apakah harga API akan langsung turun setelah TPU baru Google dirilis?
Belum ada dasar untuk menyimpulkan demikian. Per 2026-11-10, TPU 8tx dan TPU 8i Max masih berstatus Coming soon dan harganya belum diumumkan. Optimalisasi perangkat keras terutama meningkatkan pemanfaatan sumber daya dan mengurangi latensi bagi penyedia layanan. Apakah manfaat ini diteruskan ke harga Token bergantung pada kebijakan harga masing-masing penyedia.
Q4: Apakah penggunaan cache pasti menghemat biaya?
Belum tentu. Jika awalan berubah setiap kali sehingga cache tidak dapat digunakan, sementara mode yang digunakan mengenakan biaya tambahan untuk penulisan cache, biayanya justru bisa lebih tinggi daripada tanpa cache. Jika waktu tunggu alat melebihi TTL, penulisan ulang yang sering juga dapat mengurangi penghematan.
Q5: Bagaimana cara cepat membandingkan efektivitas cache pada model yang berbeda?
Sebaiknya jalankan tugas Agent yang sama dengan alur yang sama pada beberapa model, lalu catat tingkat cache hit dan total biaya per tugas. Melalui APIYI apiyi.com, Anda dapat memanggil model seperti OpenAI, Claude, dan Gemini menggunakan satu kunci API. Untuk membandingkannya, Anda hanya perlu mengganti parameter model.
Q6: Apa risiko kompresi konteks?
Kompresi mengubah konten yang disertakan dalam permintaan berikutnya. Akibatnya, detail penting bisa hilang, Agent dapat mengulangi kesalahan, dan jumlah putaran pemanggilan justru bertambah. Selain itu, jika konten hasil kompresi dibuat ulang setiap putaran, awalan cache akan berubah. Karena itu, kompresi perlu dirancang bersama strategi cache.
Q7: Saat menggunakan gateway terpadu, apakah diskon cache berlaku sama untuk semua model?
Tidak. Kemampuan cache, aturan penagihan, dan kolom respons bergantung pada model hulu yang digunakan. Saat menguji melalui APIYI apiyi.com, pastikan kolom cache dan biaya aktual setiap model diperiksa secara terpisah sebelum dimasukkan ke dalam anggaran.
Poin Utama Biaya API untuk Pemanggilan Agent Berulang
- Unit biayanya adalah tugas: Tagihan Agent merupakan akumulasi seluruh rangkaian pemanggilan, bukan biaya satu permintaan saja.
- Konteks berulang menyumbang biaya terbesar: Dalam contoh dengan 12 kali pemanggilan, cache 1 jam dapat menghemat sekitar 71,6% biaya input.
- Cache memberi diskon dengan syarat tertentu: Jika prefiks tidak stabil atau TTL terlalu singkat, penghematan bisa berkurang, bahkan biaya justru meningkat.
- Ketiga penyedia memiliki skema penagihan berbeda: Pastikan pengali biaya penulisan, diskon pembacaan, dan biaya penyimpanan untuk model yang digunakan.
- Optimasi perangkat keras ≠ penurunan tagihan: Optimasi KV di lapisan bawah lebih dulu meningkatkan latensi; harga tetap bergantung pada tarif penyedia layanan.
- Ukur dulu, baru optimalkan: Gunakan APIYI apiyi.com dengan antarmuka terpadu untuk menguji tingkat cache hit dan biaya tugas setiap model.
Ringkasan
Biaya API untuk pemanggilan Agent berulang ditentukan oleh perhitungan konteks berulang, cache hit, dan bolak-balik pemanggilan alat. Ketiganya sama-sama penting:
- Perhitungan konteks berulang menentukan biaya dasar. Semakin banyak pemanggilan, semakin banyak pula pengulangan.
- Cache hit menentukan seberapa besar diskon untuk bagian yang berulang. Stabilitas prefiks dan TTL adalah faktor kunci.
- Bolak-balik pemanggilan alat menimbulkan biaya eksternal sekaligus meningkatkan jumlah pemanggilan model.
Investasi Google pada KV Cache dan hambatan memori di lapisan infrastruktur akan membuat Agent berjalan lebih cepat. Namun, hal yang bisa langsung dikendalikan developer adalah struktur token mereka sendiri. Mulailah dengan menstabilkan prefiks, mengatur TTL secara tepat, meringkas riwayat, mengurangi jumlah pemanggilan, dan memantau biaya di tingkat tugas. Gunakan APIYI apiyi.com untuk memverifikasi dampak setiap optimasi dengan data nyata.
📚 Referensi
- Google Cloud Blog – Introducing TPU 8tx and TPU 8i Max: Pengumuman peluncuran sistem TPU generasi kedelapan
- Tautan:
cloud.google.com/blog/topics/ai-infrastructure/tpu-8tx-and-tpu-8i-max -
Keterangan: Memahami latar belakang dinding memori Agent dan KV Cache
-
Google Cloud Blog – Introducing TPU Sync: Pustaka open source untuk transfer KV Cache dan bobot
- Tautan:
cloud.google.com/blog/topics/ai-infrastructure/introducing-tpu-sync-fast-kv-cache-and-weight-transfer-on-tpu -
Keterangan: Optimasi transfer KV Cache di tingkat dasar dan tolok ukur pengujian
-
Dokumentasi API OpenAI – Prompt Caching: Mekanisme cache dan praktik terbaik
- Tautan:
platform.openai.com/docs/guides/prompt-caching -
Keterangan: Aturan cache awalan, durasi penyimpanan, dan saran pemantauan
-
Dokumentasi Anthropic – Prompt Caching: TTL cache dan informasi biaya
- Tautan:
docs.anthropic.com/en/docs/build-with-claude/prompt-caching -
Keterangan: Harga penulisan dan pembacaan cache untuk durasi 5 menit dan 1 jam
-
Google AI for Developers – Context Caching: Cache implisit dan eksplisit Gemini
- Tautan:
ai.google.dev/gemini-api/docs/caching - Keterangan: Informasi tentang TTL cache eksplisit dan biaya penyimpanan
Penulis: Tim Teknologi APIYI
Diskusi teknis: Kunjungi beranda APIYI apiyi.com untuk menghubungi kami. Informasi integrasi lainnya tersedia di pusat dokumentasi docs.apiyi.com